笔记日期: 2026-11-12(UTC)
作者: Zhongzhu Zhou
所读论文: Only Accepted Tokens Count: An Energy Accounting of Speculative Decoding Under Latency Targets
论文作者: Bole Ma、Ayesha Afzal、Jan Eitzinger、Harald Koestler、Gerhard Wellein
arXiv: 2610.40287v1,2026-10-29
先看一组同模型的反转
在论文的代码任务里,Qwen3-4B 用 DSpark-7 在 H100 上服务 64 路请求,仍能省下每个输出 token 的能耗。把相同模型和方案换到 H200,同一批量下却更耗能。H200 的实测显存带宽更高,两块卡的 BF16 算力却接近。前者让读权重这一步变快,同时也让验证较早碰到算力上限。理解这个结果,要同时数清楚 GPU 算了多少位置,以及这些位置最终为用户提交了多少 token。
作者在 SGLang 中测了十一款模型、四类注意力架构和五种草稿方案。实验主体打开 CUDA graph capture,把每个推测配置与同 GPU、同并发、同任务和同设置的普通解码配对。在这个口径下,单流各模型最佳节能幅度的中位数为 54%。到并发 64,能跑到该点的模型仍各有一个方案省 15%–52%,但若照搬单流表现好的某个方案,可能已经出现能耗惩罚。
我读这篇论文时把两个工程问题分开看。其一是已有固定并发,问引入草稿后变了多少。其二是给定延迟要求,可以在批量和草稿之间重新选配置。前者需要严格配对,后者需要同一行配置的时间和能耗,以及确认所选的批量在真实流量里能否形成。
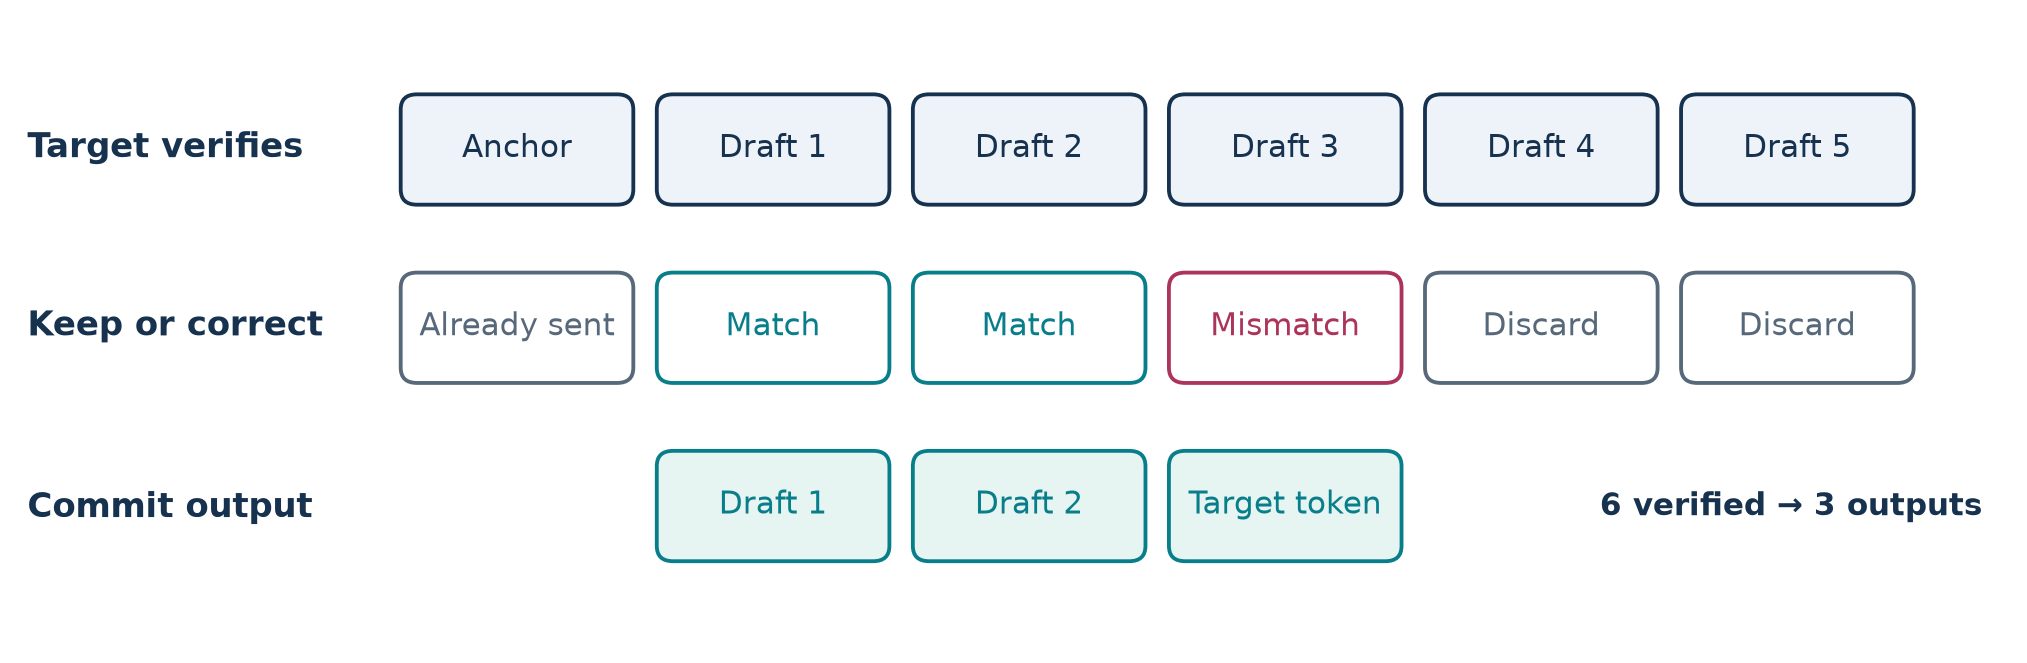
图 1. 依据论文第 2–3 节自绘。验证器处理一个已发出的开头 token 和五个草稿位置。图中保留两个草稿 token,加上目标模型给的一个 token,总推进量为三个。
前置知识
普通批处理与推测验证共享的是哪部分工作
Prefill 把输入提示词送入模型,建立历史 KV 或循环状态。Decode 再逐步生成输出。对一个稠密线性层,单流的一步可近似理解为一次权重矩阵乘一个输入向量。把 个用户的输入排成 行后,可以让它们共享权重搬运。每个用户在这一步仍然只推进一个 token。批变大以后,整机每秒输出更多,并不保证同一个用户也拿得更快。论文报告的稠密模型从并发 1 到 32,单用户间隔增加 9%–34%。MoE 的对应幅度是 2.5–4.0 倍,专家读流量会随实际路由变化。
推测解码则尝试把同一用户的多个位置放进一次目标前向。设 为实际在跑的并发数, 为草稿提议位置数, 为验证宽度。多出来的一个是这轮输入的开头 token。论文的 DFlash-16 指验证 16 个位置,提议其中 15 个。批量验证形状含 个位置。在本实验的默认模式下,各请求接受长度不同,验证形状仍是预先规定的宽度。第一个错误后面的提议不会提交,但其验证计算已经做完。
五种方案的成本来自不同地方。n-gram 在已有上下文中查找相同片段,在本文的 SGLang 设置中由 CPU 负责匹配。MTP、EAGLE3 和 Gemma 助手逐个做短前向,后一个草稿位置依赖前一个。DFlash 与 DSpark 属于一次输出一块的方案。块方案少了多次串行草稿前向,但如果固定块很长,目标模型要支付更宽的验证成本。Gemma 的助手走 MTP 路径,训练时间却在目标模型之后。论文比较低资源语言时,这个区分比名称更重要。
数清候选、接受和提交
用 表示目标模型保留的草稿前缀长度。不考虑结束截断,一轮实际提交量是 。如果草稿第 个位置不匹配,就输出该位置的目标预测。如果草稿全对,就输出目标多算出的下一个 token。开头那个已发出的 token 只作为本轮输入,不再计作输出。论文图中从约 1 起步的 accepted length 我按原图读作推进统计量,引用实测值时沿用作者口径。本文推导中的 专指保留的草稿位置。
贪心验证为何能够保留目标的输出?假定当前已经提交的前缀与普通贪心解码相同。草稿第一项只有在等于目标当前预测时才接收,于是接收后前缀仍相同。后面的接收逐步满足同一条件。在第一次不一致处,用目标预测代替草稿,前缀继续一致。整个草稿都一致时,额外输出也是目标在同一前缀下的预测。因果掩码保证后面候选不会影响先前位置。实际系统里的不同数值路径、近似并列的 logits 与 tie-breaking 会造成细微差异。概率采样的拒绝和校正另有规则,本实验的验证按贪心语义理解即可。
算法 1:贪心验证及状态回退
1. 记录每个请求已经提交的前缀和当前状态。
2. 由草稿器为每个请求提议最多 k 个后续 token。
3. 目标模型在一次因果前向中处理开头和草稿位置。
4. 从第一个位置起,将候选与目标贪心预测逐项比对。
5. 遇到第一个不一致时停止,保留此前的匹配前缀。
6. 加上目标修正 token。全部匹配时加入额外目标 token。
7. 使后续 KV 失效,或选出与接受边界相符的循环状态。
8. 按下一轮的开头输入约定处理修正 token。
9. 记录验证宽度和真实新增输出,结束轮按实际截断计数。
以上是依据论文第 2、3、6 节整理的逻辑。注意力缓存的尾部通常可以标为无效。循环状态已经吸收了多个输入,如果直接继续使用最后一个状态,已经拒绝的 token 仍会影响下一轮。论文第 6 节描述按草稿位置保留状态快照,然后回到匹配边界。修正 token 的输出时刻与它作为输入更新状态的时刻也应分清。作者观察到混合模型中若一直未推进循环状态,几步之后就可能输出不连贯文本,能耗表格表面上仍正常。
接受长度是前缀生存概率的和
令 。当某个前缀实际保留了 个位置时,从 到 的指示函数都为一。因此把 写成这些指示函数的和,再逐项取期望。
如果前 个位置已经通过,定义条件接受概率 。于是 ,从 逐步乘开。这里不要求位置之间独立。作为算例,令每步的条件概率都等于 ,把等比数列乘上 ,只剩首末两项。
取 ,6 个草稿位置期望提交约 3.06 个输出,15 个约 3.32 个。多算 9 个位置只带来约 0.26 个输出。真实流量里的 不是常数。代码模板、复制片段和多语言内容会改变整条生存曲线。对加宽验证而言,最有用的是当前末端再往后一位还会接受的概率。
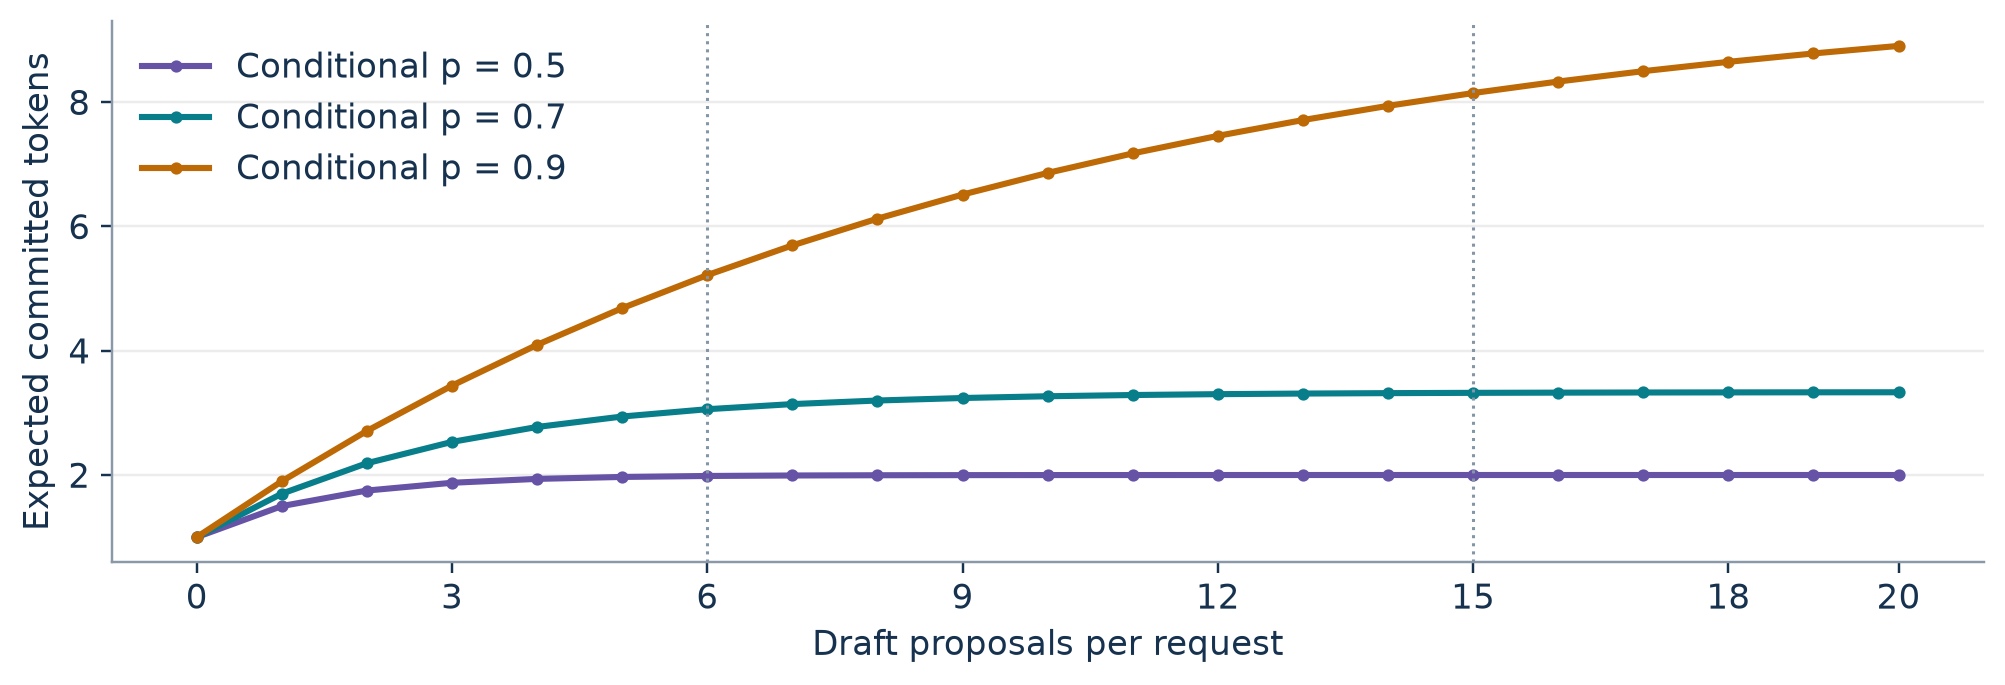
图 2. 式(2)的说明性曲线,非实测数据。条件概率较低时,草稿再加宽,平均提交量变化很小。
一轮验证的能耗怎样摊到输出
从表计差值到盈亏条件
设 是 GPU 板卡累计能量计数器。读出起止差,再除以这段时间里所有请求真实提交的输出 token 数。只要分子和分母窗口一致,实际批量有波动也能用这个定义。
接下来为理解机制,假设同一比较点保持 个请求在跑,且两组都在匹配的 decode 窗口内。以 表示推测和普通解码的平均每轮能量。推测每轮总提交约 ,普通解码每轮提交 。将两者先各自除以提交量,再求比值。
因而当 才省电。每轮多花 1.9 倍的能量、产出 2.6 倍的 token,算下来约为原能耗的 73%。即便另一个方案每轮产出 3.2 倍,如果轮能量涨到 3.6 倍,结果却为 112.5%。这是图 3 的两组算例。实际统计时不能把每轮的能耗比直接平均,因为短轮次的输出权重更小。先加总焦耳和 token,再算比值,才能对应表计口径。
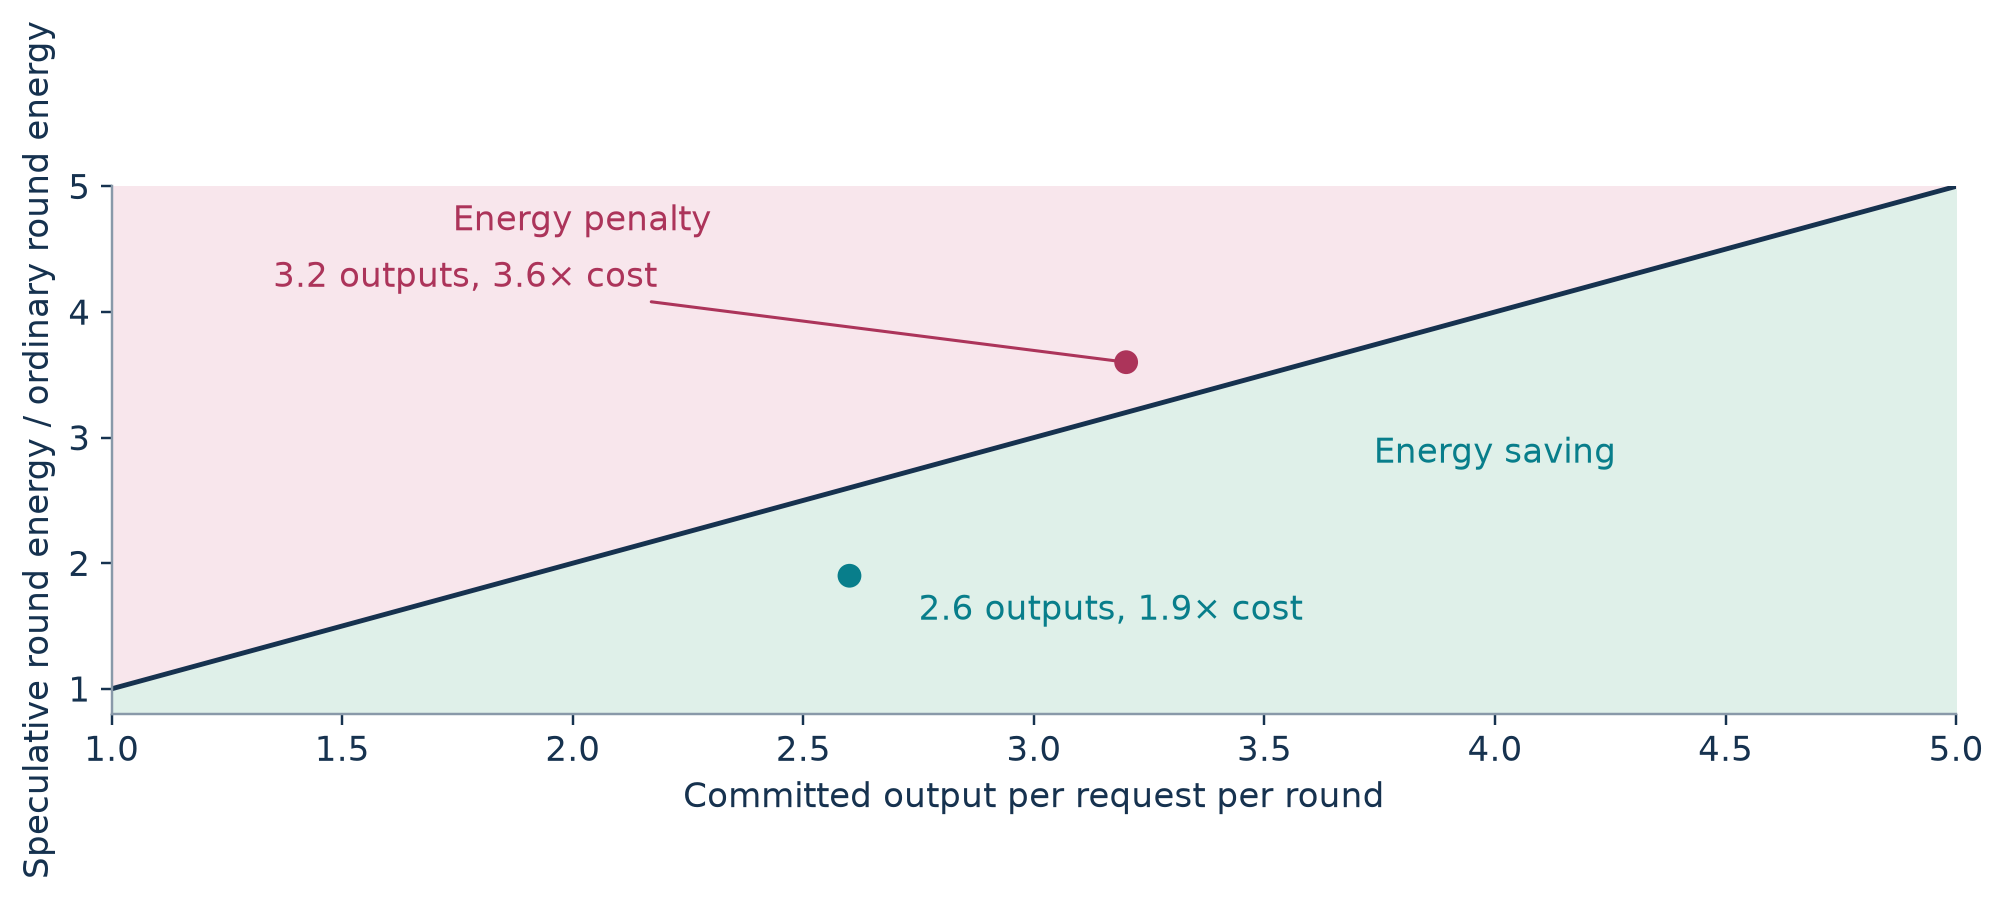
图 3. 按式(4)自绘。横轴是每个请求的平均推进,纵轴是推测轮相对普通轮的能量倍数。对角线上的配置刚好持平。
草稿多一位的边际收益
若把草稿从 个加到 个,并假定前 个位置的提议分布没有变化,则平均提交增加 。将新旧的焦耳每 token 相比,约掉相同的并发,再交叉相乘。
继续用上面的算例。 时,,大约为 0.08235,除以 3.0588,得到 2.69%。这表示如果增加第七个草稿位置会把一轮成本抬高 3%,按这个例子就不该加宽。若换宽度等于更换整个草稿模型,前六项的联合分布也会变。此时需要实测 的完整差值。论文中两种 DFlash 长度来自不同训练团队,表中的宽度对照要带着这个限制看。
为什么更快仍可能更耗电
令 分别为平均轮时间, 为各自窗口的平均板卡功率。单用户每 token 的时间随平均轮时间增加,也随提交量增加而下降。定义速度倍数 。把轮能量写成平均功率乘时间,再代入式(4)。
一个说明性例子是速度提高 20%,平均功率提高 35%,每 token 能量随之提高 12.5%。短跑时间和省电是两种可同时记录的结果。测到更短的平均间隔后,还要知道对应的功率与输出总量。
GPU 平衡点与验证成本
先推一个简化的稠密层模型
记每轮从显存搬运的权重为 字节,每个请求在上下文长度 时的 KV 读流量为 字节,每个验证位置做 次算术。暂时假设同一请求的多个位置能共享 KV 读流量,也忽略草稿和启动开销。分子按 个位置算,分母加上整轮共享权重和各请求历史。
在这个近似里,小批量的分母主要是 ,多验证位置可以提高算术强度。批量很大时,式子趋近于 。因此上下文越长,越难跨过同一个算力平衡点。实际 kernel 可能为额外查询再读缓存,张量核的填充也使实做 FLOP 与有效 FLOP 不同。作者用硬件计数器记录包括填充在内的执行量。实测中,单流验证配置与普通解码的强度只差几个百分点。式(7)适合看趋势,用它预测单流的具体强度会忽略核粒度。
如果显存带宽是 ,算力是 ,执行 次运算并搬运 字节,理想时间至少要满足两条下界。让两项相等,就得到强度分界。
按论文第 3 节的实测标定,H100 的比值是 FLOP/byte,H200 是 。作者正文的近似口径为 316 和 163。H200 的平衡点大约是 H100 的 52%。加大带宽相当于缩短了搬运下界,因而较早露出算术耗时。跨点的含义是瓶颈换了,绝对运行时间还要看原来两项各是多少。
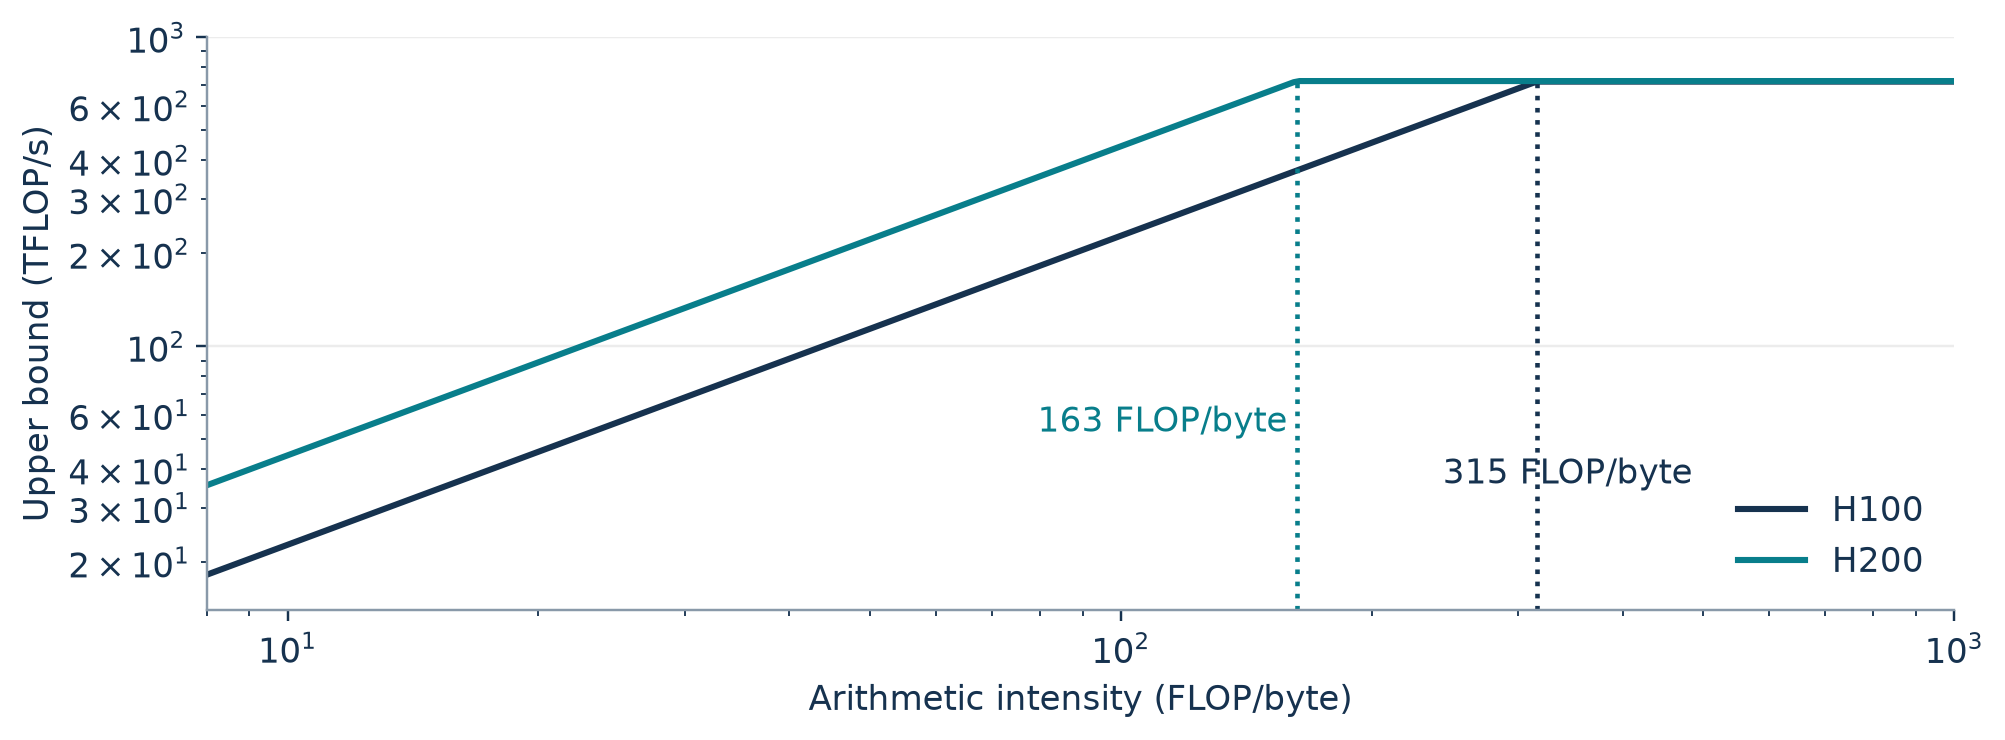
图 4. 依据论文第 3 节标定值计算的理想 Roofline。图中的折点只来自算力除以带宽,实际 decode 位置另见图 5。
将式(7)等于 ,两边乘分母,将随批量增长的 KV 项移到左边。
若分母小于或等于零,按这个简化模型,无论加多少请求都跨不过去。一个系统还可能因为核启动、访存效率、通信而低于两条理想上限。论文第 9 节举出单流时就显著低于访存上限的注意力核。把 Roofline 当作一个瓶颈检验工具更合适。给出焦耳数仍需要轮能量和提交量,也要考虑普通解码基线换 GPU 后有多少改善。
对照两块卡的实测位置
作者用 Qwen3-4B 比较约 260 和 1024 token 的上下文。前者近似代码任务生成 512 token 过程中的平均上下文。硬件计数器取的是 prefill 后的早期 decode 步,能耗则在打开 capture 的整段生成窗口计量。前者是特定上下文的局部样本,后者是跨生成过程的总量。
在约 260 token 的口径下,DFlash-16 在 H100 上到并发 32 接近平衡点,在 H200 上到 16 即到达。节能幅度在 H100 的 16 至 32 之间变号,在 H200 的 16 已经变号。DSpark-7 在 H100 的并发 64 仍低于平衡点且省能,在 H200 自 32 起跨点,64 时耗能反而较高。普通解码在这组实测始终位于两条分界之下。作者还用 n-gram 改变验证宽度,16 个位置在 H200 并发 16 同样跨线,四个位置在 64 仍未跨。该对照比仅比较两个不同训练的草稿器,更贴近验证形状这个变量。
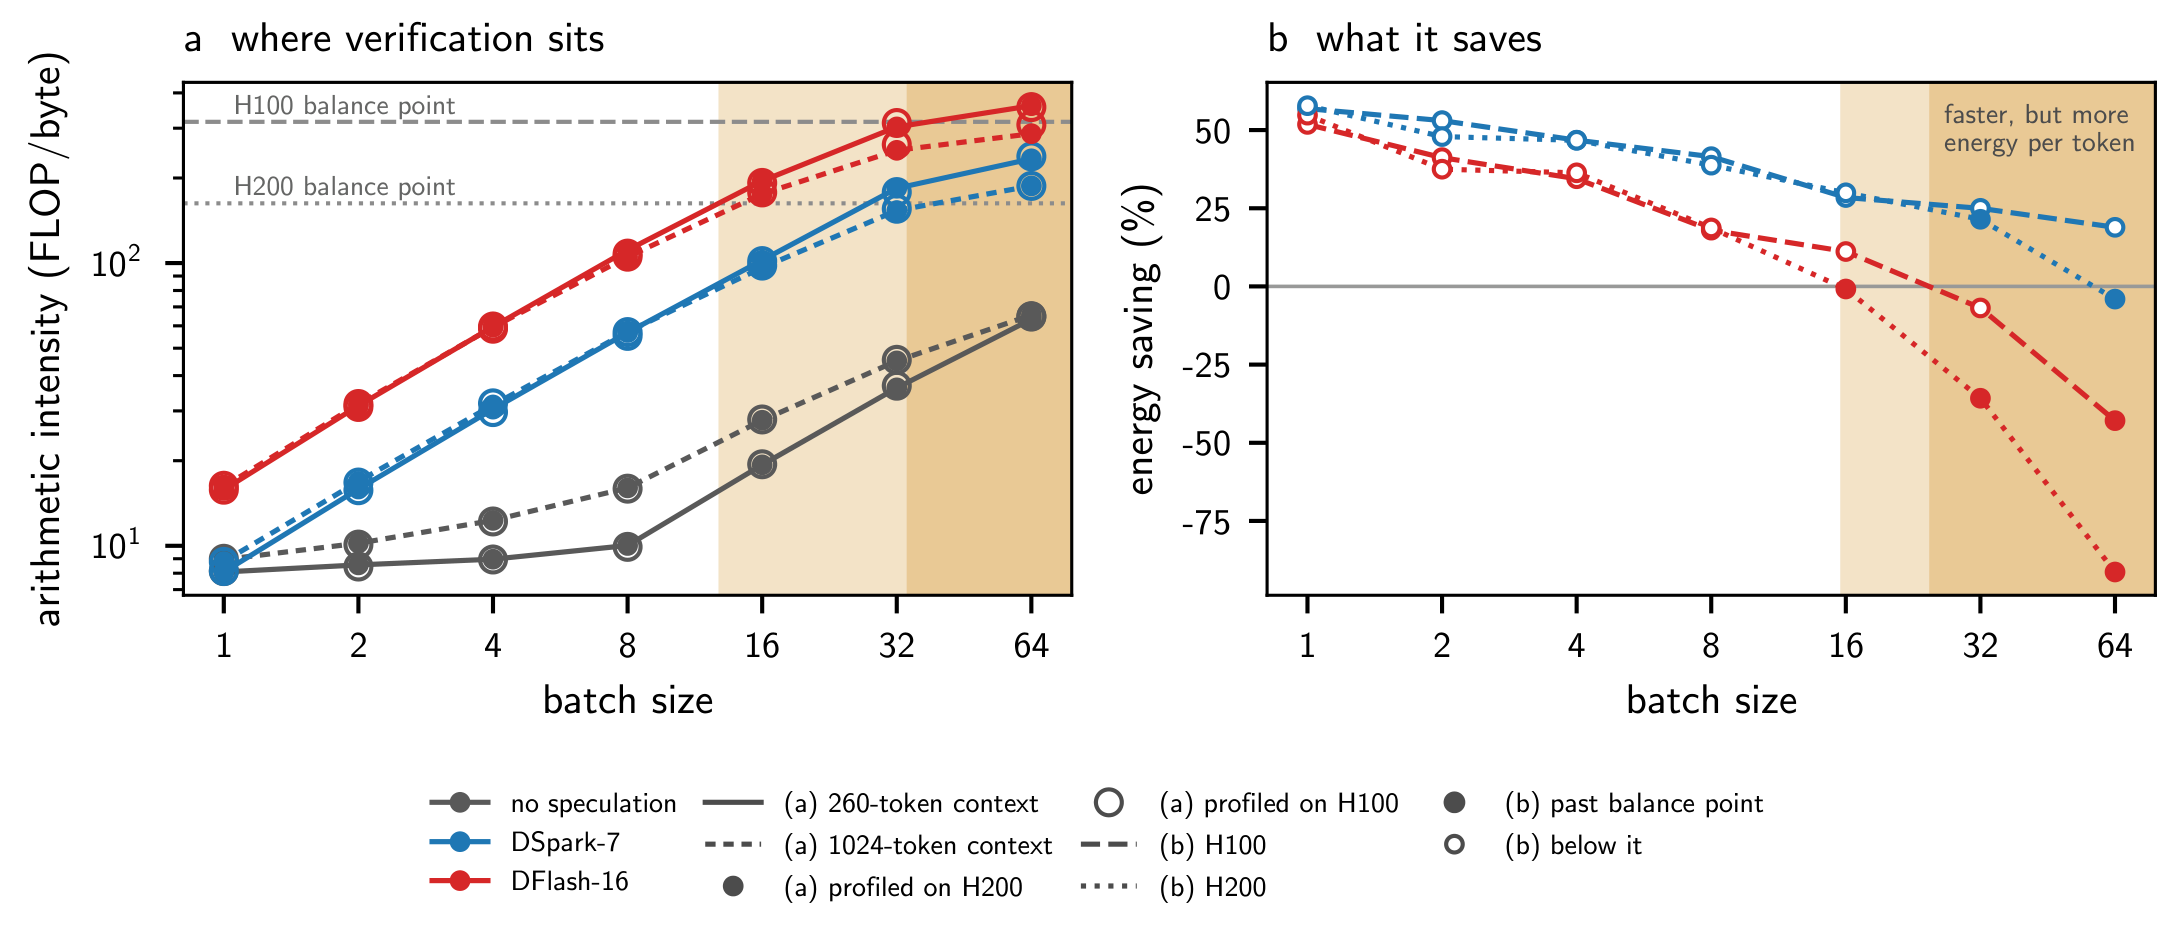
图 5. 裁自原论文图 6。仅 Qwen3-4B。左图是关闭 capture 后用计数器得到的强度,右图是打开 capture 的能耗结果。观察 DFlash-16 时应同时沿批量和 GPU 两个维度比较。
当上下文加长,作者测到相同批量的强度下降。服务若常跑数万 token,需要重新测 KV 带宽。多位置一起验证有机会复用部分 KV,也可能在布局不佳时重复读取,短上下文的分界不足以决定哪种效应更大。MagicDec 在长上下文报告的批量收益正好可以作为对照。MagicDec
显存与 MoE 带来两个额外边界
在循环模型里,若每个草稿位置为每个请求保留一份覆盖全部循环层的状态快照,记一份总大小为 字节,则附加显存近似为
边界状态和管理信息还会占空间,部分保存或重算会改变这个式子。论文报告 Qwen3.6-27B 在 H100 上以 DFlash-16 跑并发 16 时无法启动,普通解码在同一并发可运行。回退缓冲就约为草稿权重的十倍。H200 给了更多余量,但 DFlash-16 在最大批仍遇到容量限制,而验证四个位置的共训头在 Qwen3.6-35B-A3B 上可跑到 64。工程上应先判断配置能否容纳,再比较焦耳。
MoE 中还会多读专家权重。做一个极简模型,假设有 个专家,每个位置独立均匀选择一个专家。给定 个位置,一个指定专家没被选中的概率是 。将每个专家是否被选中的指示变量相加再取期望。
以八个专家为例,四个位置时平均触达约 3.31 个,十六个位置时约 7.06 个。这是帮助理解的算例。真实 top- 路由有相关性和负载偏斜,也可能存在缓存和常驻专家。批量或验证宽度增加后,新增位置是否额外引入权重流量,要看被激活的是哪些专家。
逐组读能耗与接受长度
配对实验为什么要打开 CUDA graph
每次同时提交 个请求,每个生成 512 token,中间没有新到达。每类任务的提示词池有 96 个不同样本。代码做全批量扫点,另外检查真实会话、长文档和英语/罗曼什语新闻。权重与 KV 为 BF16,贪心解码,每格至少三次种子。多数批量扫点用 700 W 功耗限制的 H100 SXM5;有三个模型的扫点改用容量更大的 H200。表 3 又有独立的一批测试,其中 Qwen3.6 的 GPU 口径和表 2 不同,应该分别读取。
论文读取 GPU 板卡累计能量,频率为 10 Hz。整段读数差可用于一个观测窗口的总能量。草稿和验证的单个阶段比采样间隔短,不能根据两个时间标记直接分配焦耳。表计范围也不含 CPU、内存、网络、制冷。举个量级例子,如果主机查找每轮多花 0.1 J,四个请求各平均提交两个 token,板卡指标就少计 0.0125 J/token。实际是否改变排序,取决于该主机开销和板卡上测到的差距。
普通 MoE 解码容易发出许多小 kernel,打开 capture 后,普通基线受益往往更大。推测步骤在不开 capture 时已经将多位置放进一次发射,额外受益有限。表 3 中,单流 Qwen3-Coder 的节能从关闭时的 71% 变成开启时的 32%。若用表里已经四舍五入的 1.60 与 1.12 J/token 直接算,结果是 30%。作者报告的是逐种子配对比值的中位数,不能从两个汇总数要求完全重现它。同一行到并发 64,关闭和开启的结果则是 43% 与 46%。这说明偏差甚至没有固定的方向。
用 与 表示普通和推测各自打开 capture 后的能耗比例。例如 。两边展开就有
当 时,开 capture 后相对基线的能耗比上升,节能变小。实际对照必须给出基线的 capture 状态。拿不同状态的两组数计算,即使日志和表格都完整,也不能回答部署中的同口径问题。
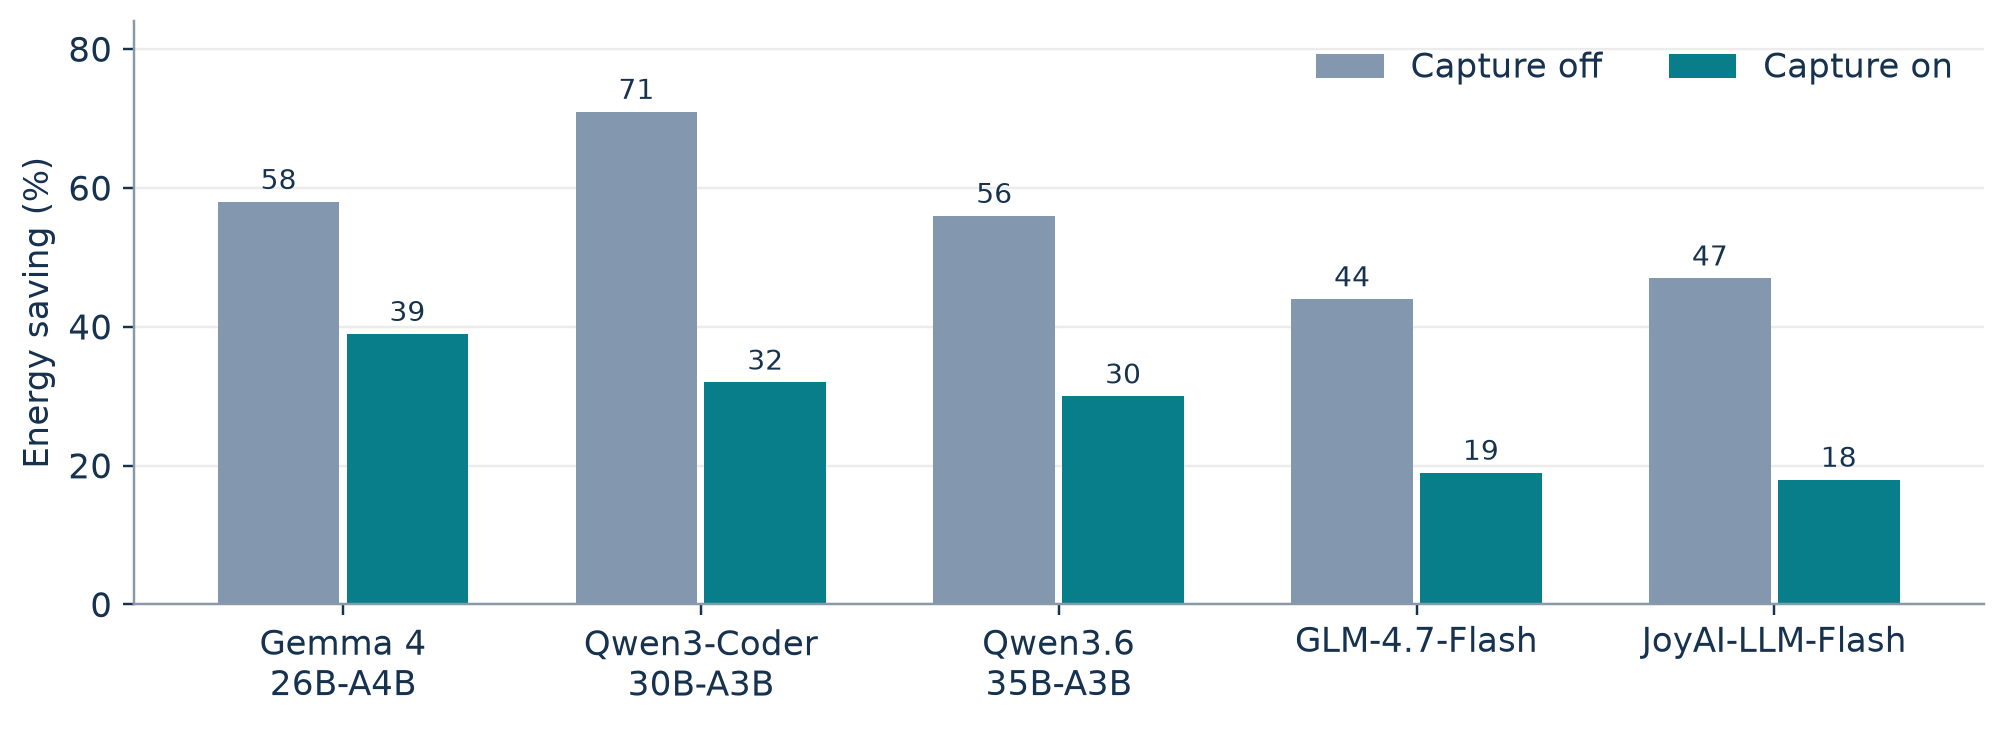
图 6. 依据论文表 3 五个 MoE 行的配对节能中位数重绘。Qwen3-Coder 的差距为 39 个百分点。JoyAI 行使用 H200。
同一批量和同一任务下的赢家
Gemma 4 12B 的代码任务里,单流最佳是 DFlash,省 75%。到 64 时助手头最佳,省 25%。DFlash 验证 16 个位置,助手验证六个。切到会话,两者报告的 accepted length 大致相同,助手在所有测过的批量下都更省电。只要验证形状仍为固定宽度,长草稿就要一直为额外位置付费。Qwen3-4B 和 8B 的两个 DFlash 方案也是这个方向,宽度七的版本在测过的点都更省电,差距随批量扩大。这里同时更换了训练产物,实测结果可用于选择已有配置,单独的宽度效应还需要控制实验。
另一个有代表性的点是 Qwen3-Coder。代码上,表 2 的最佳节能从 32% 升至 51%。会话里同一 DFlash 的报告接受长度从代码约 5.9 降为约 2.0–3.0,在并发 64 时由省能变成更耗能。该结果说明将代码的高接受长度直接用作混合服务估计,可能连收益方向都算反。五类语料中,长文档也值得单看。答案常复用输入中的内容,Gemma 的 n-gram 接受长度可能比在代码上更高。
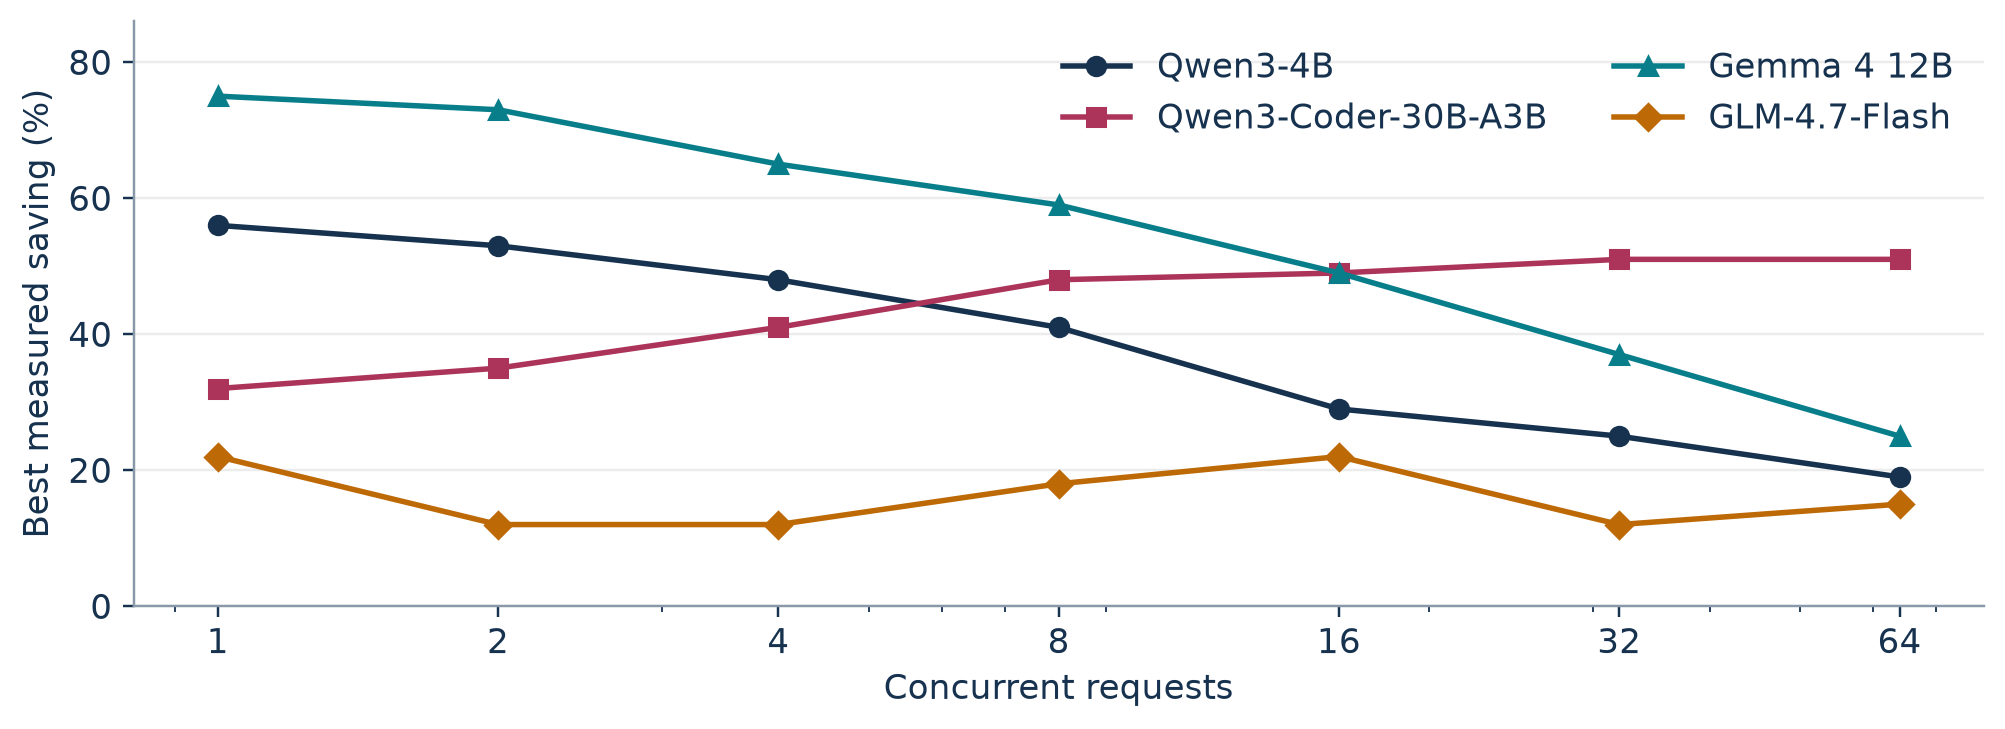
图 7. 按论文表 2 的四行重绘。每个点是该批量的最佳实测方案,跨点时可能从块草稿切换到短头,不能当作同一方案的连线。
作者还在同模型、同批量下做方案两两比较。332 对里有 287 对接受长度更高的一侧也更省电,复算为 86.4%。其余 45 对中,有 44 对接受更多的一侧也验证更多位置。最后一对是 Qwen3-8B 的单流 EAGLE3 案例,要串行跑七个草稿步。多个比较共享模型和基线,因此 332 不能当作 332 个独立样本。它提供的是误差方向的线索:只预测接受量会漏掉验证宽度和草稿串行开销。
长度扫点如何补上因果证据
第 6.1 节在三款模型和四个并发点上,将 n-gram 提议长度从 1 扫到 32。在稠密 Gemma 4 31B 上,单流加长可省更多能量。从并发 4 起,作者报告提议 4 个的配置表现最好。到服务批量,该稠密模型上扫到的各个长度都比普通解码更耗能,32 个最差。两款 MoE 在单流就出现所有扫点都耗能的情况。到并发 64,三款里代价最低的都是提议 4 个。这一小节的数值按原文的提议长度读取,表 1 的方案后缀则按验证宽度读取。由于 n-gram 由主机查找,这组对照能减少 GPU 草稿网络的混杂,但长度变化仍可能改变被验证的 token 和 CPU 工作量。
| 观察 | 论文中的对照 | 可以回答的问题 |
|---|---|---|
| 提高并发后节能变号 | 每个并发点有同模型的普通基线 | 验证增加的成本还能否被提交量摊薄 |
| 换卡后分界提前 | Qwen3-4B 在两块 GPU 上比较同宽度 | 资源平衡点如何移动 |
| 更快但每 token 更耗能 | 同设置的功率、能量与提交输出 | 加速是否盖过功率增加 |
| 请求并发无法维持 | 查看实际并发与显存容量 | 配置是否可行,不能补造能耗点 |
把草稿从轮能量里拿掉
作者让配对实验在第一轮之后跳过草稿前向,重复使用第一轮的草稿,固定每轮接受数以保持上下文推进可比。保留相同验证形状后,用两段总能量之差估草稿贡献。
这个差值要求移除草稿不会明显改动验证能量。在稠密 Qwen3-8B 上,改用随机或重复 token 验证,能耗变化小于 3%。在 GLM-4.7-Flash 上,同样处理可令只验证的能耗变化达 52%,因为 token 身份改变专家路由。论文因此只报告稠密模型的拆分。即使在稠密模型,去掉草稿也可能改变时钟、缓存驻留或同步,差值适合解读为这个干预下的边际量。
被测稠密模型的草稿占比最高 45%,块草稿最高 23%。在验证成本和提交量都固定时,把占比 23% 的部分减半,只能令总能耗少 11.5%。如果草稿换法还带来更长的接受前缀或允许减少验证宽度,才会出现这个直接节省之外的效应。作者的拆分结果也解释了为何首先检查验证形状,通常比只关注小模型算力更有收益。
罗曼什语对照说明了什么
新闻实验以英语和罗曼什语构造相近任务,作者只计入确实继续用罗曼什语的回答,通过功能词判断。GLM-4.7-Flash 和 Qwen3.6-35B-A3B 的共训头在罗曼什语上保留英语接受长度的 81%–84%,两个后训草稿约为 70%。其中 GLM 的两个方案同为验证四个位置,少了一个宽度干扰。Gemma 4 12B 的厂商助手与第三方 DFlash 都保留约 66%–69%。谁训练和何时训练是两个变量,这组结果更吻合后者的划分。
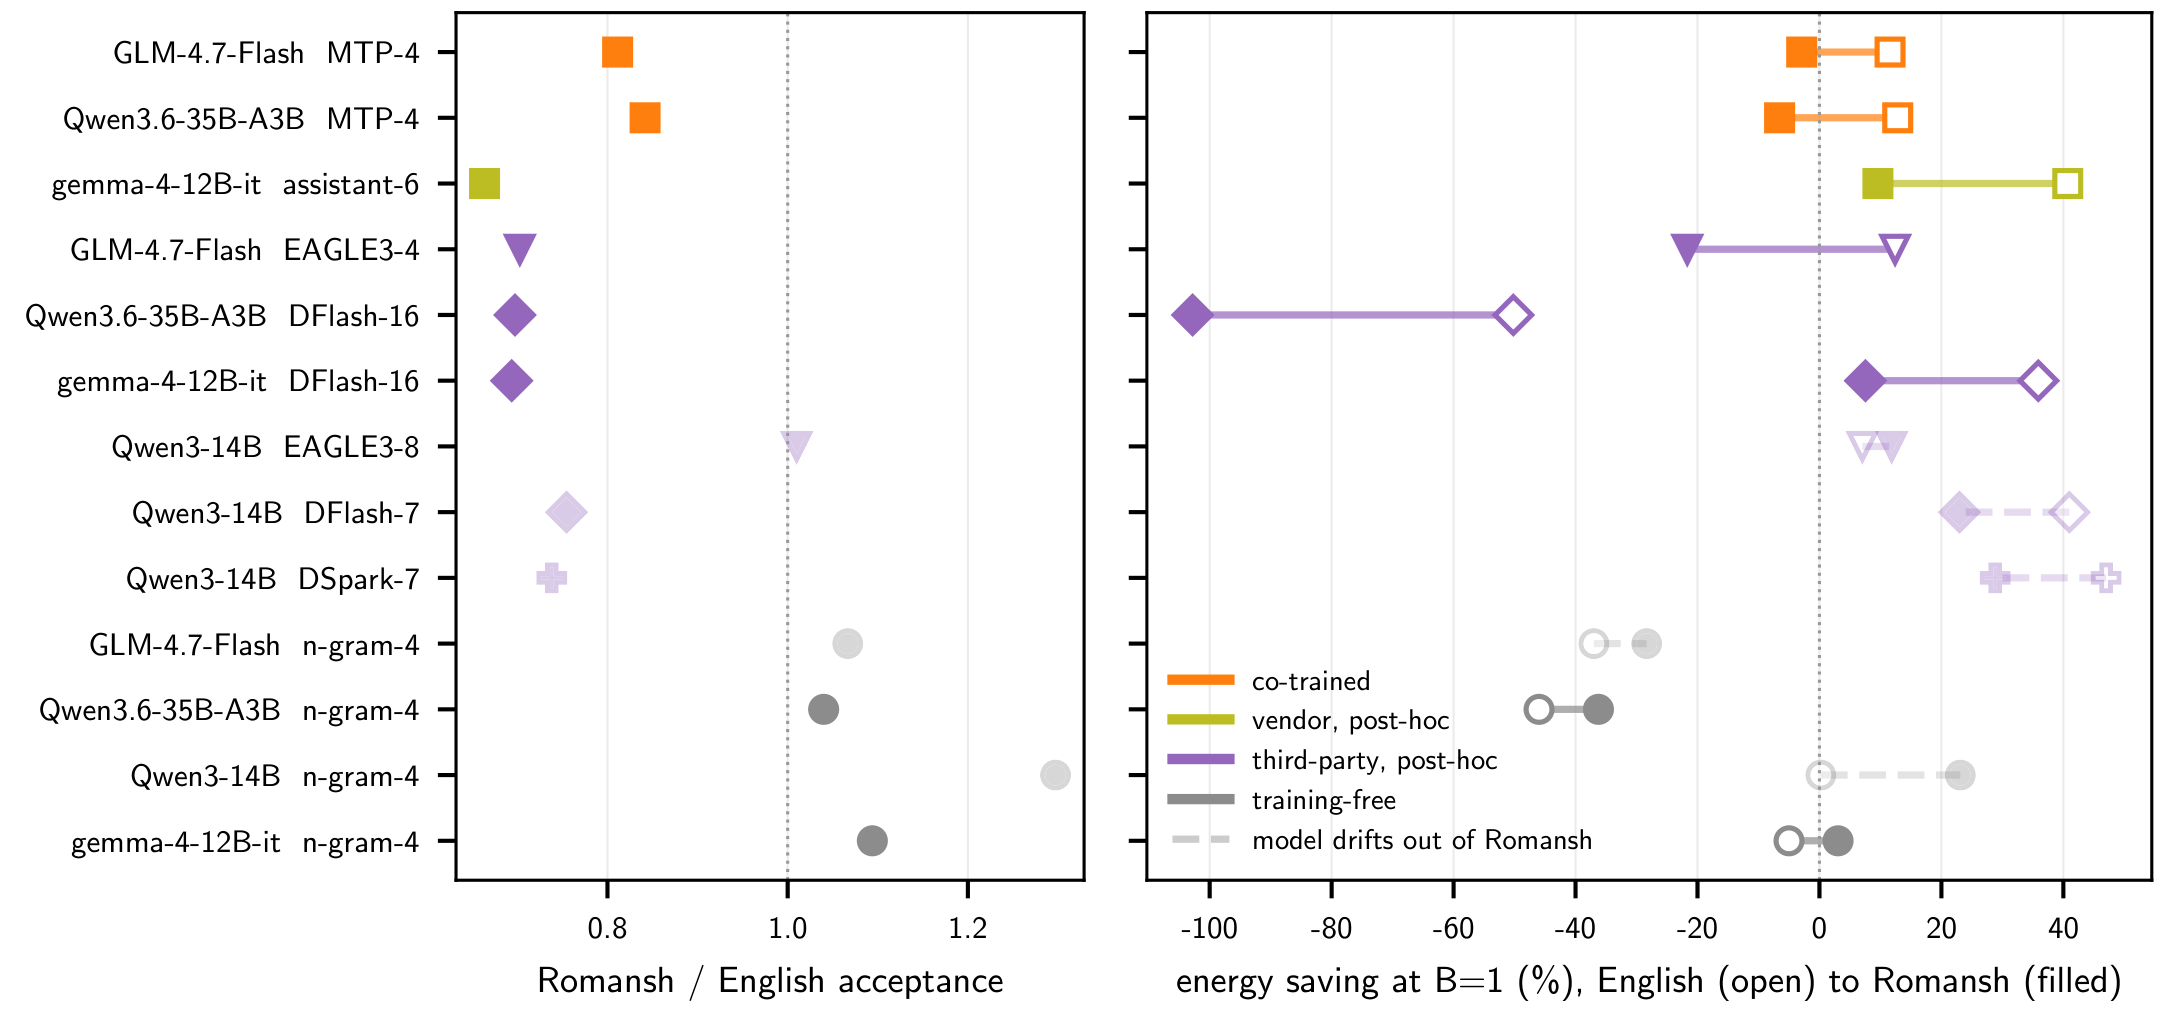
图 8. 裁自原论文图 3。左侧是相对英语的接受长度,右侧由空心到实心表示英语到罗曼什语的节能变化。浅色提醒该目标经常未能一直使用罗曼什语。
单流的合格样本每个模型和方案只有 7–11 个。Qwen3-14B 还有 23%–27% 的回答漂到意大利语。如果要估计真实罗曼什语流量上的总体能耗,必须把这些回答带回分母,并另报语言遵循情况。该试验支持把训练时机当作后续检验的变量。仅凭这组规模,难以将词元切分、目标语言能力和草稿训练数据分别量化。
有延迟目标时怎样选方案
固定批量配对回答草稿本身的作用。若线上可以改变批量,就应拿所有能满足目标的配置比较。设平均板卡功率为 、聚合吞吐为 ,每输出 token 能耗为 。同长的同步请求里, 近似为 乘以单用户平均吞吐,后者近似为平均 token 间隔的倒数。增大 可以让聚合吞吐提高,同时让单用户间隔变长。评估时两列都要保留。
Gemma 4 31B 的表 4 很直观。并发 1、32、64 时普通解码的平均间隔分别为 33.2、38.3、56.6 ms。三个批量的最快推测设置分别为 7.8 ms(DFlash)、19.0 ms(助手)、28.9 ms(助手)。对于 25 ms 的平均目标,前两个推测点可行,最后一个已经超标。表 4 选的是最快方案,表 2 选的是最省能方案。若按批量直接合并两列极值,得到的组合可能从未测过。应以实际配置为单位,用同一行的时间和能量进入筛选。
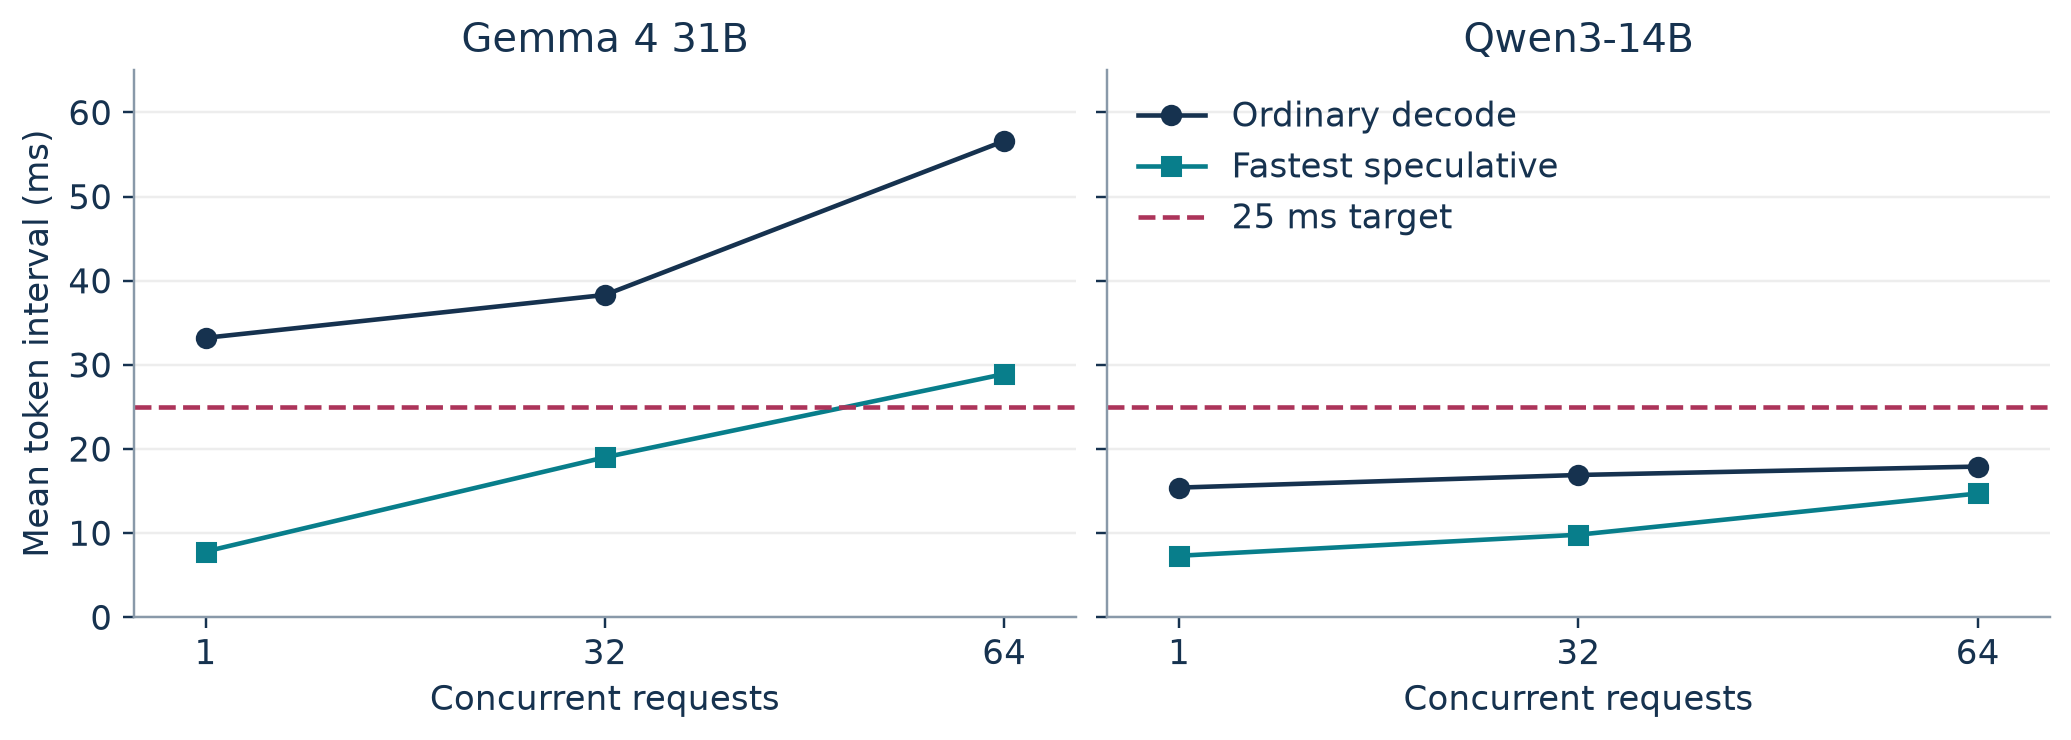
图 9. 按表 4 的 Gemma 4 31B 和 Qwen3-14B 重绘。并发轴为三个离散观测点。推测曲线取每点最快设置,虚线为平均间隔目标。
对 25 ms 平均目标,论文比较了可行配置的最低能量。在有可行普通基线的十个模型上,推测节能 18%–69%;Gemma 4 31B 的普通解码没有可行点。作者也反问普通批处理能替代多少推测收益。单流推测的能耗约等于普通并发 2–8 的水平。并发 32 的推测设置至少需要普通并发 64 去追,其中五个模型在 64 仍未追上。这是已测网格的结论,无法插值得到 48 的实测收益。线上如果没有足够到达请求,凑大批的排队时间也需要计入。
另一个可以联合调节的量是 GPU 时钟。论文在 H200 上给 Qwen3-8B 跑了 1500、1200 和 900 MHz 的锁频点。普通解码锁到 1500 MHz 时,吞吐损失 3%–7%,每 token 能耗降低 4%–11%。当并发至少 16 且开 DSpark-7 或 DFlash-16 时,默认就运行在约 1450–1700 MHz,该锁频没有带来额外节能。1200 MHz 能降低能耗,同时也降低吞吐。这个例子说明 DVFS 可以纳入同一个可行集,但它在特定模型和卡上测得,不能直接推广到其他系统。
把测得的均值约束写成实际筛选问题
把一个候选配置记作 ,其中 是草稿方案, 是时钟设置。先为每项记录实际并发、能耗和平均间隔 。对目标 ,把跑不满、显存不足和输出异常的项剔除,再要求 。于是可将论文比较的目标表达为
对普通解码与推测解码分别构造可行集。如果其中一个集合为空,应该写该类配置在已测网格下不可行,能耗比也就没有分母。Gemma 4 31B 是这种例子。并发 64 的最快推测点也要 28.9 ms,所以提高该批的能效无法把它变成 25 ms 可行点。相反,Qwen3-14B 在图 9 的三个普通解码点都低于 25 ms,可直接比较适当的大批普通解码与推测设置。用户如果只关心这个均值目标,最快点有可能消耗更多板卡能量,没必要把它选为默认。
如果观测只有三个种子,刚好达标也可能缺乏余量。可用下一批到达轨迹重新估计可行性,将不同种子或不同请求组的 和 一起保存。假设某配置三次平均间隔为 23、25 和 27 ms。它的中心值恰好 25 ms,但三次里有一次明确超限。把目标收紧到 23 ms 做灵敏度测试,可以显示最省能的选项是否依赖边界附近的一个观测点。这是说明性例子。对于真实尾部目标,应该在同一筛选式中换入实际测得的尾部分位数,并保留按请求拆分的输出正确性与覆盖率。
设备内部省能与整机吞吐是两个口径
假设只有 GPU 板卡,普通配置每秒输出 2000 token,平均耗 500 W,得 0.25 J/token。推测配置每秒输出 2500 token,平均耗 600 W,得 0.24 J/token,板卡端约省 4%。如果把一个额外的 35 W 主机开销计入后一项,且假设前者没有相应的额外负载,后一项成为 0.254 J/token。原有基线的主机功率也应加入;若两者共享 100 W 的主机基础功耗,则应比较 0.30 和 0.294 J/token,排序又会变化。这些是假设值,说明应选择和部署问题一致的计量边界,不能拿一台设备的局部结果直接估算机架容量。
持续运行的服务还可能用负载整合减少空闲卡数。较高的吞吐允许合并实例时,空闲时段减少可能比活跃窗口的节能更显著。若请求稀少且为尾延迟保留许多副本,闲置能量则在每 token 指标里占更大比例。要验证这类收益,需按固定到达轨迹和副本预算积累总能量,同时分开记录活跃、等待与预填充时间。原文同步固定批的指标恰好适合比较 decode 机制,系统容量收益要在这个更广的边界内另测。
算法 2:按可行约束选择低能耗配置
1. 按目标模型、GPU、上下文范围和请求类型整理观测。
2. 定义用户延迟目标、输出要求与表计覆盖范围。
3. 测实际并发、已提交输出、能量、均值和尾部间隔。
4. 为各草稿配置保留同并发、同工作负载的普通基线。
5. 去除超过显存、输出不合格或违反延迟目标的设置。
6. 在可行集合内比较累计焦耳除以实际提交 token 数。
7. 在留出的到达轨迹上复核,并保留可行的回退设置。
8. 当上下文、负载或捕获形状分布变化时重新标定。
这是依据论文测量框架整理的选择流程。尾部间隔是我为线上目标加入的观测要求。若做在线控制,切换需要一定滞回,避免一次估计抖动就让服务频繁更换宽度,也要计入更换已捕获图形状的成本。
局限
作者用同步的固定批测 decode,窗口内没有新的请求。这样便于比较能耗,也把连续调度、排队、prefill 干扰、提前结束等因素留在实验外。512 token 上限让分母一致。若生成跨过正常答案末尾,随后重复内容会被草稿轻易命中,配对也无法消除这一影响。论文报告代码池正常结束的中位数超过 700 token,意味着多数答案覆盖测量长度,但不能据中位数断言所有短答案都不会受影响。
大部分提示词很短,试验每轮使用一块卡。多卡的张量并行和专家并行可能让额外验证位置触发不同的通信开销。用两块卡测强度和变号的核心对照也只涉及 Qwen3-4B。跨模型移植时,平衡点只能提供待验证的解释,无法给出误差范围。作者用半极差呈现有限种子的波动。某个批量最省能配置的排名若只差一个百分点,最好保留全部配对值,并用新请求和更多重复验证排名。
批判性分析
均值会把一次长等待摊给整串输出
设一个推测流每隔 40 ms 一次吐出四个 token,串内间隔忽略不计。四个相邻间隔的均值是 10 ms,但其中一个间隔为 40 ms。另一个流每 10 ms 均匀吐一个,均值同样是 10 ms。两者用户体验显然不同。真实网络可能把多个 token 合成一个 chunk,改变可见间隔。复测应同时记录 chunk 到达时间和其中的 token 数,分别报首 token、平均、P95/P99 间隔和每请求最大停顿。这个缺口与多 token 验证机制直接相关。论文的 25 ms 是均值目标,不能从表 4 推出服务达到 P99 25 ms。
低接受量还会改变批量中剩下的请求组成。假设两类请求均需 200 个输出,平均一轮推进分别是四和二。按固定推进近似,前者约 50 轮,后者约 100 轮。连续调度时,较难的请求占用的槽位时间更长,晚些时候的批里可能更集中。此时入流时的代码占比不能直接代入稳态能耗,也要记录完成、队列与各类请求的活跃时间。同步实验可以建立机制基线,动态回放才会显现这种偏差。
把草稿质量与验证宽度分开干预
论文中 n-gram 的长度扫点让宽度变化更清楚。块草稿对照仍同时改变检查点。进一步可记录同一草稿模型的一条长提议流,在同样的目标、上下文、GPU 和 capture 设置下,给验证器不同长度的前缀,分别量出截短对目标侧的成本和接受量的影响。这种离线回放便于对齐前缀,但连续执行时提前截短会改变后续提交点与整批的进度。还应另跑按策略真的生成的服务轨迹,将成本与后续调度联系起来。
作者的 DSpark 置信度调度试验正好给出一个反例。H100 上的代价表把额外位置定得很便宜,调度后仍验证满宽度,节能还少了几个百分点。置信度本身不足以选择宽度。若图捕获需要按宽度分桶,动态缩短可能导致更多小批、更少的权重复用,甚至抵消节省。可以先估相同流量下各种可捕获形状的能耗,再在真实到达轨迹上评估不同宽度策略的整体结果。
服务流量要按输出 token 加权
分开测了两类工作负载后,先把每类的输出数 与能耗 相乘,再求总输出比值。
举例说,两类普通基线都用 1 J/token,某草稿方案让代码省 0.4 J/token、让会话多花 0.2 J/token。若两者可加,代码的输出 token 占比超过三分之一,整体才节能。这里占比来自产出,不能用请求数替代。实际的混合 MoE 批会共享专家读流量,分段测量的单价可能在混合后变化。可比较直接混跑与分段加权的差值,定位调度和专家访存的相互作用。
低频计数器也限制在线调节。一段读数内若反复改变草稿宽度,表计差值混合多种策略。短周期可先用实际并发、验证位置和提交 token 做预测,再在较长窗口用同条件能量配对定期校准。如果预估节能幅度接近种子波动和表计误差,先积累数据比频繁切换更可靠。
语言筛选与能耗拆分值得保留原始分母
语言实验可以同时报全体与成功继续指定语言的子集。对全体记录提示词、输出语言、已提交 token、能量及可用性。再按主题、目标模型与相近提示对分层。过滤语言漂移可能改变输出的重复程度,影响接受率和能耗。用多个目标、相同宽度的共训和后训头对照,更适合分辨训练时机、分词和目标自身的语言覆盖。
MoE 的草稿拆分也需要更强的对照。若能在只验证的回放中保持 token 身份、前缀以及专家分配相同,再对比启用草稿的运行,就能进一步区分专家读流量与草稿删除的影响。应同时记录激活专家数、实际权重读字节和能量。稠密模型走同一过程可作为控制,帮助估算时钟、缓存及同步因素造成的偏移。原文用随机和重复 token 得到最高 52% 的差异,正好说明仅固定宽度不够。
复现要点与复算
我用论文的标定值复算了 H100/H200 平衡点、332 对比较的比例、表 3 的汇总数之比,以及文中的接受长度和能耗算例。所有这些都是数值复算,本次没有进行 GPU 生成或板卡能耗测量。
重测时应保留实际并发而非只填请求值。论文举例,Qwen3.6-27B 的 MTP 在请求并发 16 时,H100 实际只容纳 12 路,H200 可容纳全部 16 路。每条记录还应包括 GPU、时钟和功耗上限、精度、目标与草稿、验证宽度、capture、采样设置、生成长度、输出量、EOS 和表计窗口。若比较 decode,先核对是否混入尚在接纳请求的 prefill。若比较整机,补量主机与网络能耗。若需要尾延迟,收集单请求时间戳。
第 10 节另一个值得记下的坑是提示模板。去掉聊天模板后,Gemma 的 n-gram 节能曾被高估达 117 个百分点,因为预测的输出文本变了。超过提示池的并发还会重复提示词,使前缀缓存节省被归到批处理头上。保留生成文本或必要的输出摘要、独立提示数和真实并发记录,可以解释为什么某个看似正常的能耗点偏离同一条曲线。
让配对结果能从原始读数复算
每组重复应保留四个原始量:普通侧与推测侧各自的窗口能量和提交 token 数。以两轮说明性数据为例,第一轮的窗口比值分别为 和 J/token,第二轮为 和 J/token。两轮都节能 10%。如果后一次推测恰好提前结束,表计仍是 54 J,但实际只提交 80 个 token,配对值变成 0.675 J/token,较第二轮基线增加 12.5%。将分母误填为请求上限,就会把这次能耗增加写成节能。固定输出量适合论文的实验问题,真实服务则应记录输出边界以及提前结束的原因。
再区分两个可复算的汇总。若问题是重复运行的典型相对收益,可对逐种子的配对比值取中位数。若问题是这组工作负载总共消耗多少能量,就应在每一侧各自合计焦耳和输出,再比较两侧。工作负载若因提前结束而变化,还要同时看任务完成数或输出可用性。否则较差的输出可能用更短的时间完成,在焦耳每请求上看起来反而更好。这个问题在循环状态异常或语言漂移时尤其明显。
对于研究复测,我会保留测量窗口的起止时间和累计表计读数,并把整段推测轮数与实际通过的 token 数并列。这样既能回算绝对能耗,也能从式(4)判断变化来自每轮成本还是平均推进。对每个并发点标记是稳定达到、短时不足还是无法启动。对不可行点保留原因和容量信息即可,曲线只用真实运行的观测。
结论
推测解码要为全部验证位置付费,而每轮能量只能靠实际提交的输出摊薄。短上下文下,较宽的草稿可以在小批量复用一次权重读;并发升高或 GPU 带宽改变时,验证先碰到算力边界,省下的能量可能变成额外成本。稠密模型的实测拆分把注意力引向验证端。MoE 和罗曼什语对照则提醒,路由和接受量都会随实际文本变化。选择方案时,我会先按真实 GPU、批量和文本配对计量,再按同一配置的延迟约束选最低能耗。线上若考核尾延迟,还要补量逐 chunk 的停顿分布。
参考
- Bole Ma、Ayesha Afzal、Jan Eitzinger、Harald Koestler、Gerhard Wellein。本文所读论文。实测数字见第 2–10 节、图 3 和图 6、表 2–4。arXiv v1
- Yaniv Leviathan、Matan Kalman、Yossi Matias。原始推测解码的概率采样构造。论文
- Samuel Williams、Andrew Waterman、David Patterson。Roofline 吞吐模型。论文
- Jian Chen、Yesheng Liang、Zhijian Liu。DFlash 的块扩散草稿。论文
- Xin Cheng 等。DSpark 的半自回归块生成和置信度调度。论文