笔记日期: 2026-11-11(UTC)
作者: Zhongzhu Zhou
阅读论文: Library of Layers (LoL): Adaptively Ordering Transformer Layers at Runtime
论文作者: Abdellah Rahmani、Sean McLeish、Ang Li、Sanae Lotfi、Pascal Frossard、Micah Goldblum
arXiv: 2611.03526v1,2026-11-02
从同一套权重里选下一层
设想一个解码器中间必须走十六步。过去,第几步调用哪块权重在模型搭建时已经定好。LoL 把可用的 Transformer block 放进一个共享库。在每一步,它先把序列切成窗口,再为每个窗口挑一个完整的 block。下一步可以换一块,也可以重复刚才那块。所有 token 仍然经过固定的核心深度,但不同位置可能走不同路径。同一块权重也可能在不同深度接收不同形态的表示。
读这篇论文,我最关注两个问题。第一,同一个窗口内共享 Q、K、V 投影,路由还能否随文本变化,同时保持自回归因果性?第二,如果把路径固定成某种解题策略的模板,模型是换了搜索行为,还是仅仅换了一种输出格式?论文用自然文本预训练回答架构可行性,用数独和迷宫做干预。两条证据的评测目标不同,读结果时需要保留它们各自的训练条件。
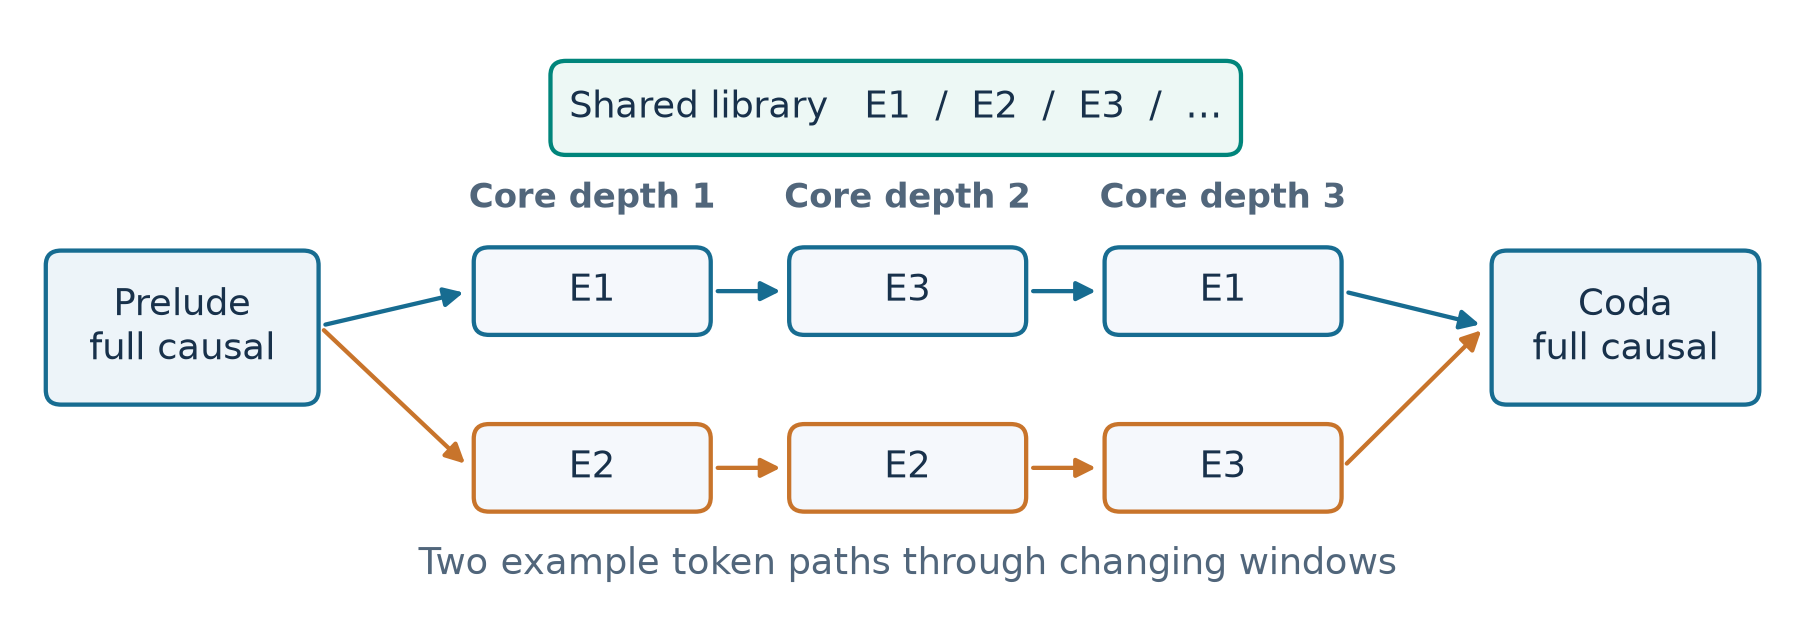
图 1. 根据论文第 3.1–3.2 节自绘。两条 token 路径都走三步,选中的块、顺序和复用次数可以不同。每个专家包含注意力和前馈网络。
前置知识:为什么整块路由比 FFN 路由麻烦
典型 MoE 只让每个 token 选择 FFN 专家。FFN 逐位置计算,同一层内的 token 已在共享注意力里交换过信息。若专家是完整 block,每块都有自己的查询、键和值投影。让相邻 token 独立选块,就会遇到一个问题:一个专家生成的查询,要怎样与另一个专家生成的键交互?
以单头注意力为例,设输入经归一化和深度调制后为列向量 。忽略此处不影响论点的旋转位置编码,来自专家 的查询与来自专家 的键相乘,分数可写成
是头维度。 时,查询和键来自同一组共同训练的投影。 时乘积仍可计算,但不同块的头可能学到不同语义,混用会改变分数的分布。作者报告,尝试让 token 独立路由整块时,训练不稳定且效果较差。共享 QKV 或显式学习对齐是可能的替代方案。LoL 选择在每个窗口内维持同一个专家,让窗口边界随深度移动,再用固定的首尾层保留全前缀因果注意力。
下面把首部叫 prelude、尾部叫 coda。核心深度 是每个 token 实际执行的 block 次数,库容量 是存储的不同 block 数。两者不必相等。深度 的输入是 ,输出是 。窗口随深度移动,沿着某个 token 跟踪它实际走过的专家,和固定某个窗口编号逐层记录专家,是两种索引方式。后面干预实验按窗口编号和深度存模板。
还有一个容易混淆的地方。若 已经包括残差连接,则 才是专家引入的净更新。用路由概率缩放净更新,恒等支路始终保留。若直接缩放整块输出,小概率会连输入一起压低。核心层数较多时,两种写法的差异会不断累积。
把因果性拆成掩码和路由
窗口如何移动
编号从零开始。令 是名义窗口宽度, 是相邻路由深度之间的位移增量。先把位置 加上当层的偏移,再做整除:
因此序号 的窗口由所有满足 的位置组成。把整除式还原成不等式,得到 。两端减去 ,再与文档范围求交,就得到实际窗口。取模只发生在偏移上。文档尾部不会卷回首部。
举例取八个 token、、。第一层是 和 。第二层是 、 和 。第三层恢复第一层的划分。位置 4 在第一层只能读自己,第二层可以读到位置 2 和 3。这个例子中它两次都在序号 1 的窗口,窗口实际覆盖的位置已经改变。
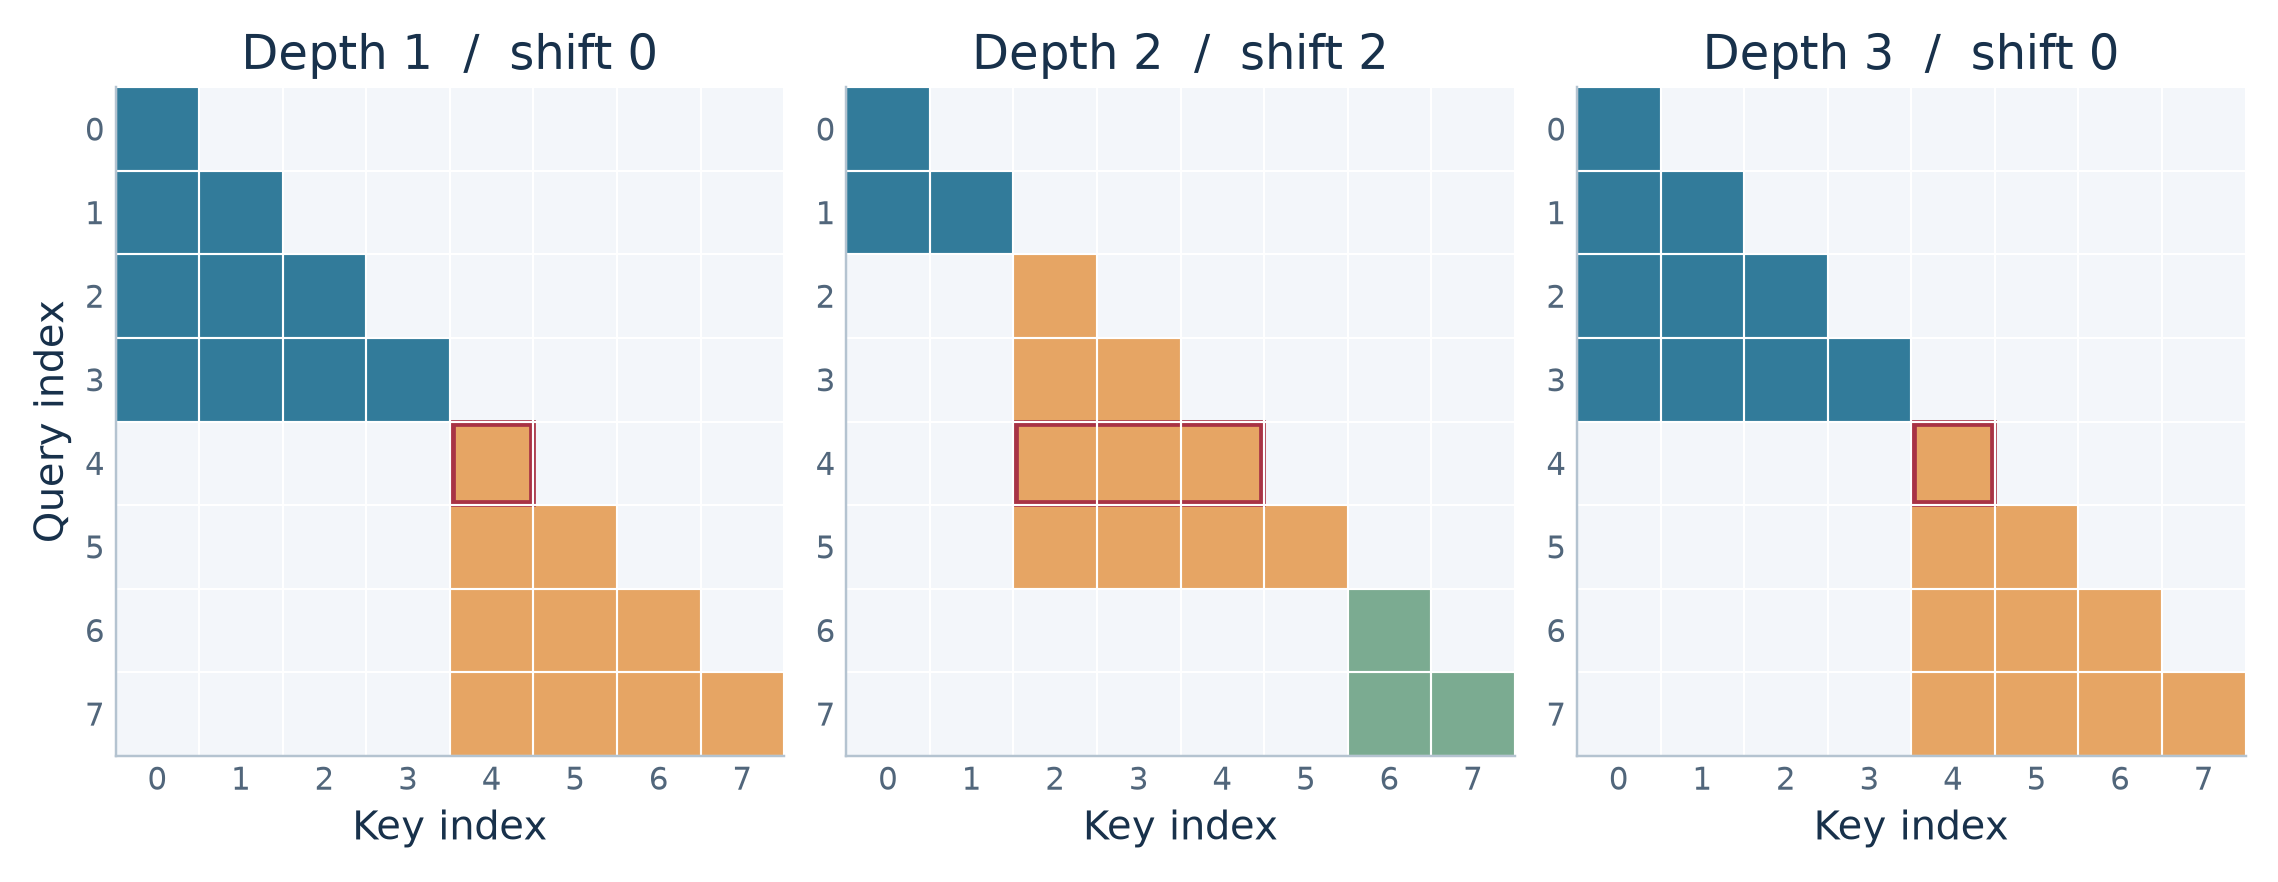
图 2. 根据第 3.2 节与论文图 2 重画。红框标出查询位置 4,第二层新出现的位置 2、3 是它能直接读取的键。
长度为 的单个因果窗口共有 对 query/key。若窗口长度分别为 ,总数就是
在 1,024 token、128 宽的配置中,对齐时八个完整窗口合计 66,048 对。偏移 64 时有七个完整窗口、两个半窗口,合计 61,952 对。全因果掩码则有 524,800 对。这是允许的注意力配对数。FFN、投影、调度和固定首尾层的成本仍在,因此不能用这组数字直接给整网预测加速比。
若只计算核心注意力与残差的依赖边,可以递推每个位置最早能接触到哪个输入位置。把 prelude 的跨位置传播和路由引入的依赖暂时排除,令 ,则
位置 4 在第一、二、三层对应的最早位置是 4、0、0。第二层读取位置 2,而位置 2 在第一层已经能读到 0。若 ,直接注意力边永远越不过原始窗口边界。此时 prelude、coda 和摘要路由依然能带来跨窗信息。递推描述的是结构上可达的位置,实际能传多少有效信息取决于模型权重和路由。
选择专家时,整个窗口只能看同一份前缀
如果用当前窗口的均值选专家,窗口中最早的 token 会间接看到后面的 token。即使注意力掩码完全正确,未来信息也已经从路由支路进来了。论文改用前面所有已完成窗口的平均摘要。第一个窗口没有历史,就用首 token 的状态与深度向量取均值:
式中 是第 层的第 个窗口。这个平均是每窗等权。仍看八 token 的例子,第二层最后一个窗口路由时,位置 0、1 各占 ,位置 2 到 5 各占 。若把前六个 token 一起做平均,权重会全部变成 。短窗会因等窗平均而获得更大的单 token 权重。换成按 token 数加权依然因果,但会改变路由。
形式化一点,假设第 层的位置 只依赖 。对非首窗,式(5)里的所有 都在窗首以前,所以门值与专家身份也只依赖窗首以前。首窗只读取位置 0 与训练好的向量,同样对窗内所有 token 可用。选中的 block 内再应用三角因果掩码,第 层的位置 就仍只依赖 。首尾的固定全因果层保持这个归纳。推导以同一模型和固定的对应窗口路由噪声为条件。数独和迷宫额外提供的策略字段属于另一套有条件训练协议。
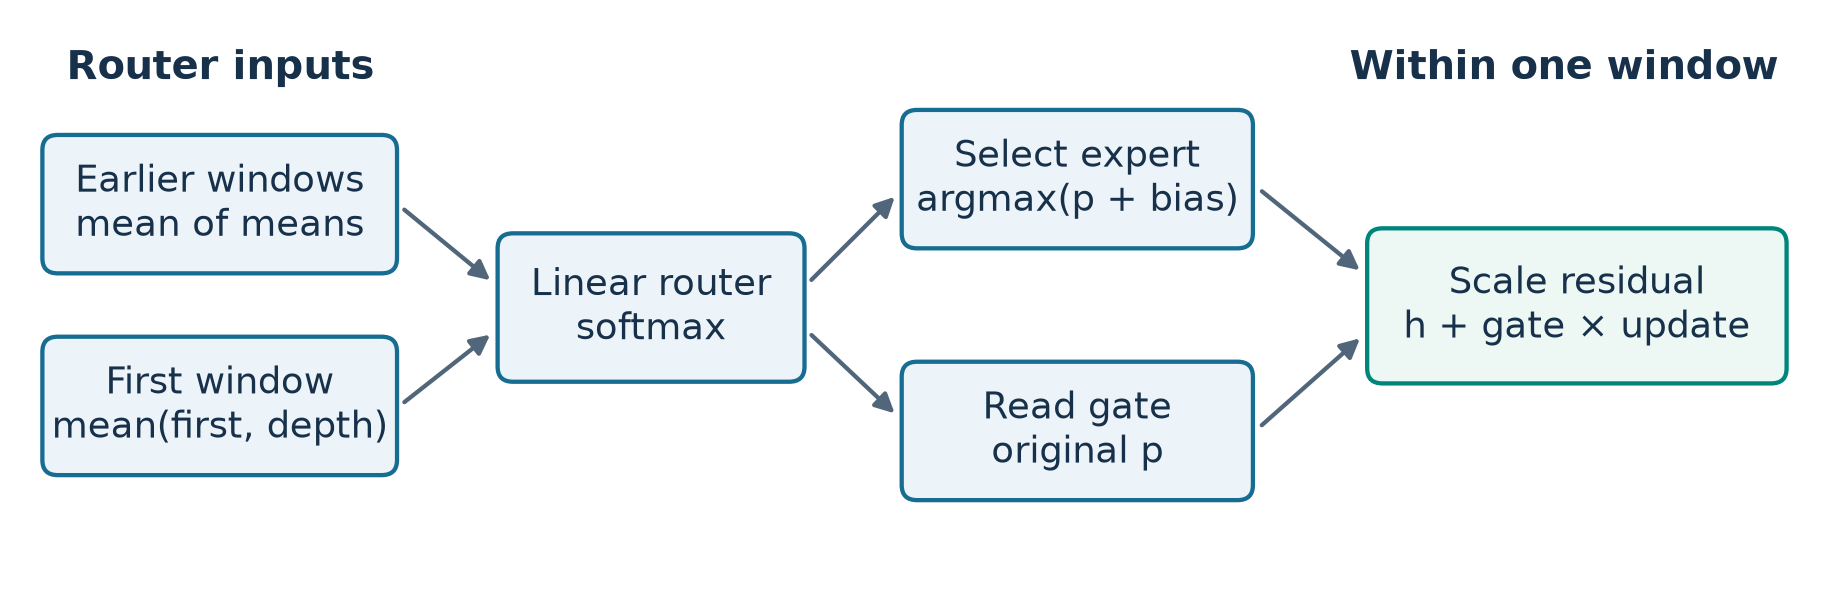
图 3. 根据第 3.2 节和附录 A 自绘。路由从上一深度读取状态。选块用带偏置的分数,写回时只使用原概率作为门值。
推理时这一因果结构允许已开启窗口保持相同选择。窗口打开时,历史窗的摘要已经齐全,首窗的输入也早已确定。分块 prefill 与逐 token 解码应沿用文档内的位置编号和各深度的窗口状态。附录明确说注意力按文档隔离。若把多个文档打包到一条张量里,路由摘要也必须按文档重置才能获得同样的独立性,测试时值得把注意力和路由分别检查。
一次选择如何参与训练
附录 A 对偏置的用法写得很具体。线性层输出 logits,训练时加入高斯扰动,随后 softmax 得到 。选择专家用 ,其中 是用于负载均衡的专家偏置。入选后的门值仍是原概率 :
例如原概率为 ,偏置为 。第二个专家凭 入选,写回时用 乘净更新。把偏置加到 softmax 前的 logits,或拿 缩放残差,都会得到另一条计算路径。附录图 8 中,无辅助损失的均衡方式在所示实验里得到较低的最终交叉熵。换一个库规模或批量时,专家访问频率和偏置更新的效果仍需观察。
固定一次前向已经选出的 。设第 个位置的上游梯度是 ,该位置的专家净更新为 。先对门值求导,由于它乘到窗口里的所有位置,各位置的梯度点积相加:
再对归一化指数求导。对 ,分子的导数仅在 时出现;分母的导数对每个 都出现。合并后得到
即使只执行一块专家,softmax 的归一化也会让其他 logits 收到梯度。这条梯度只针对已选块的输出。跨过 argmax 分界会换成另一块,式(8)没有为那块的反事实输出求导。窗口中不同 token 的梯度还可能相互抵消。如果门值接近 1,softmax 局部饱和。如果均衡偏置选中一个原概率很小的专家,残差和梯度都偏小。作者在训练中用噪声促进探索。改用 top- 会让多个专家的输出直接影响损失,但要额外执行整块注意力和 FFN,也要分别保持各条注意力路径的一致性。
同一块在不同深度还会接受 FiLM 调制。注意力和 FFN 各自做归一化,后面接深度相关的逐通道缩放和平移:
若下一步要乘投影矩阵,一个通道的缩放等价于改变相应输入方向的有效权重,平移还会改变进入投影的基线。这让共享块带着深度条件工作。完全解开权重可以更自由地分化,却会失去大部分共享。把所有深度调制都绑在一起更省参数,但共享块少了一条辨别当前计算阶段的途径。解释路径干预时也应记住:专家编号相同,深度不同,有效变换仍可能不同。
算法 1:带移位窗口的前向过程
下面按论文算法 1 和附录 A 改写,突出每一步读取的是哪个版本的隐藏状态。历史均值可通过前缀扫描得到。
01  用因果 prelude 得到当前隐藏状态 H。
02  依次处理核心深度 l = 1 到 D。
03      按 ((l-1) * S) mod W 平移窗口边界。
04      用当前 H 计算每个窗口的均值。
05      对每个窗口 k,取先前窗口均值的平均。
06          若 k 为 0,改用首 token 和深度向量的均值。
07          计算路由概率。训练时在 logits 加噪声。
08          按概率加均衡偏置后的最大项选块。
09          在深度调制下执行该块,注意力限制在窗内。
10          从块输出减去原 H,乘入选块的原概率。
11          将净更新加回原 H,写入下一层缓冲。
12      完成全部窗口后,用下一层缓冲替换 H。
13  用因果 coda 和词表读出得到预测。
第 04 行必须读该深度的输入。如果先更新前窗,再让后窗读前窗的新状态,后窗就引入了同层递归。虽然仍可能保持从左到右因果,但前向函数和并行性已经改变。按论文做法,各窗口均值可先并行算出,再扫描前缀,最后按专家把窗口分组。测试时去掉训练噪声也不影响前面的因果推导。路径干预是在第 08 行和第 10 行分别提供指定专家和门值。
用一个标量例子区分前缀摘要和注意力
仍用八个位置,考虑第二层中覆盖位置 2–5 的窗口。假设第一层输出在某一个通道上依次是 。当前窗的路由输入只能使用已完成的首窗,故该通道是 。位置 2、3、4、5 共用这个决定。窗口内的位置 4 可以用局部注意力读取位置 2、3 和自己,位置 5 仍在它的未来。如果只把位置 5 的状态从 6 改成 60,正确的路由和位置 4 的局部输出应保持一致。反过来,若错误地用当前窗做路由,这个通道的均值会从 3 变成 16.5。即使局部掩码完全正确,选块仍可能变了。
第三个窗口覆盖位置 6–7。它开启时,前两个窗的均值分别是 2 和 3,路由输入是 2.5。位置 5 的改变此时已经属于过去,第三个窗口的选择可以响应。这个例子给了两条可测的不变量:补上后缀时,前面位置的路由、门值和输出应保持一致;已经结束的窗口能影响下一窗的决定。两者一起测试,可以把“前向保持因果”与“路由确实读到了历史”分开。只检查第一条,可能让一个错误地冻结路由的实现通过。
前缀计算也可以写成状态更新。对当前深度,维护已完成窗口的均值之和 ,以及正在累加的输入向量之和 。关闭长度为 的窗口时,用它的均值更新历史:
来自当前 block 的输入缓冲。对照算法 1,这是同一加法的在线排列。这里也能看出整段 prefill 与增量解码何时能对齐:窗口切分和输入状态相同,路由噪声关闭,历史摘要在相同边界提交。若 prefill 暂时结束在半窗,不能因为本次输入耗尽就把半窗当完整历史提交给下个 decode chunk。后续 token 仍可能属于同一窗口。在低精度下,累计和舍入次序也会有小差别;当两个专家的分数差极小,应同时记录概率误差和选块翻转率。
库容量控制什么,训练增长又改变什么
取一条深度为 的 token 路径,令 为实际用到的不同专家数。可选库里有 块,路径最多占用 块。每个被使用的专家至少贡献一次首次调用,因此
、 时,至少 14 次是重复调用。、 时,每条路径至少剩八块没用。若实际只交替用两块,未用数就变成 22。这两个例子都做了十六次整块计算。库里未用的比例也不能直接当作 GPU 一次调度中未访问的比例,因为同批其他窗口可能选中那些块。
为了让利用率有一个参照,可以假设每步独立、均匀选专家。固定某块,每一步没选中它的概率为 ,连续 次均未选中就取 次方。所有专家的“出现过”指示变量相加:
当 ,这个参照在 时为 7.06,在 时为 11.85。真实路径与上下文、深度和均衡机制相关,当然不满足独立假设。这个算例用来提醒读者:同一个 比值下,活跃专家的集中程度可能截然不同。论文给出深度与专家的边际热图,若想衡量复用,最好同时画逐 token 的 分布与每个调度步的专家占用。
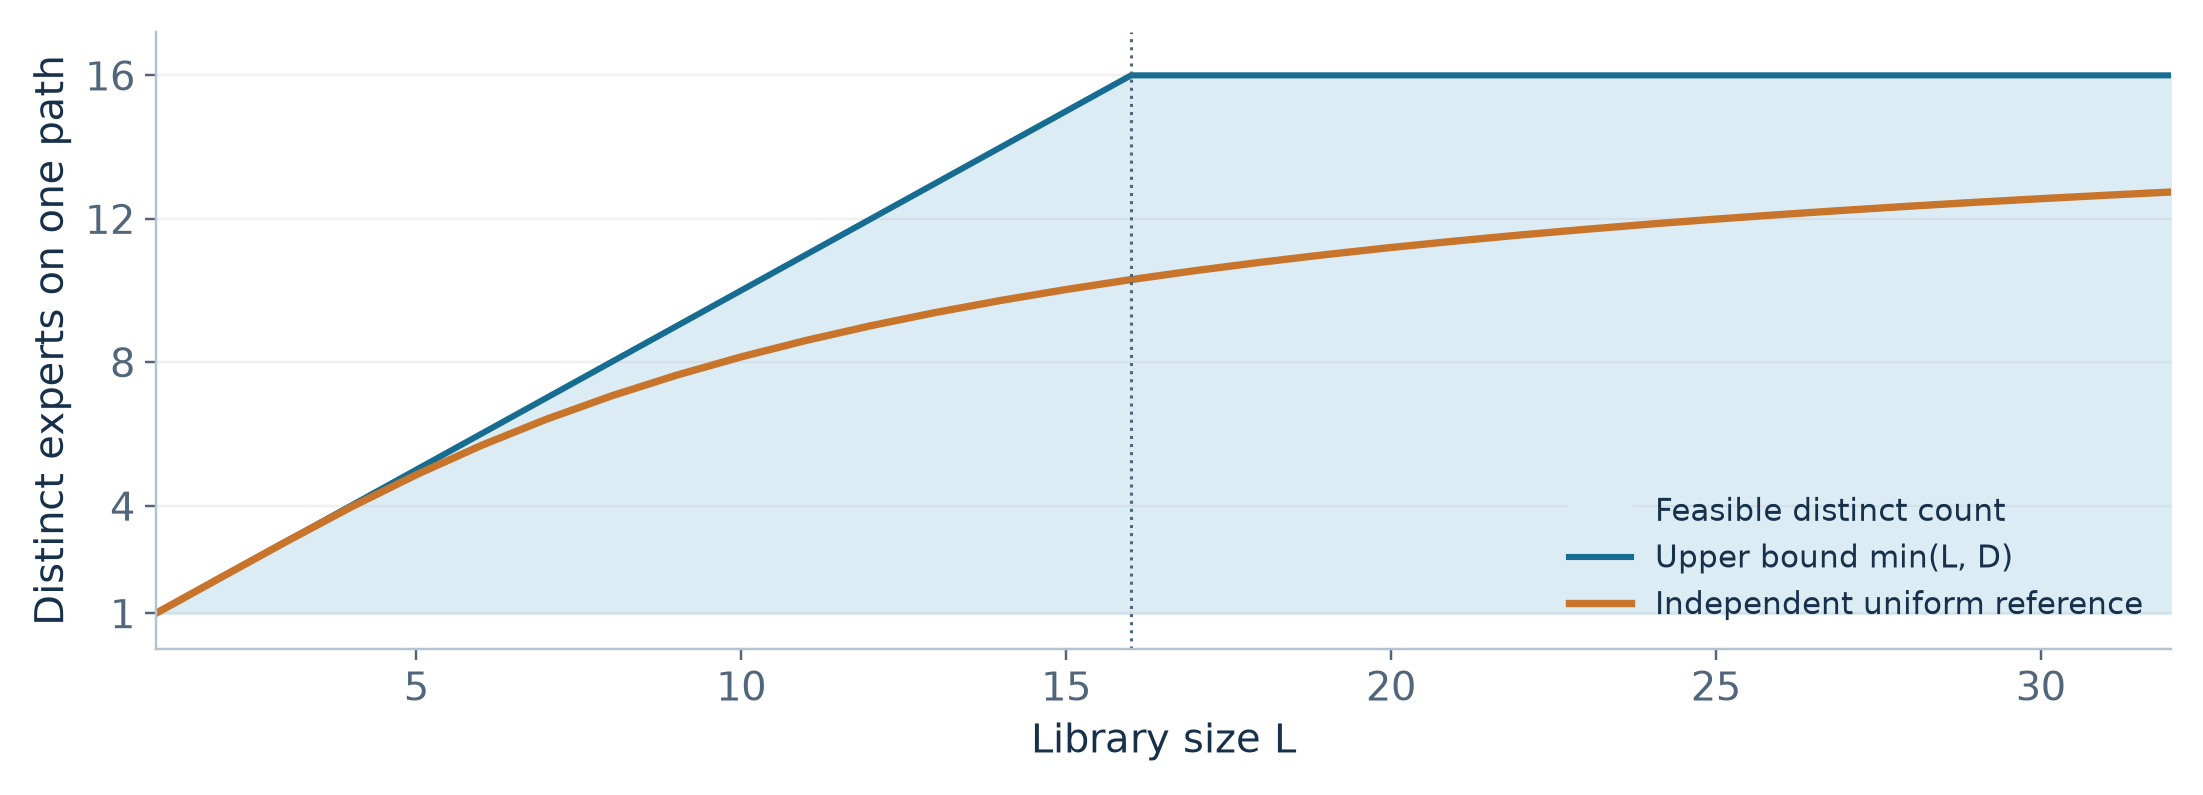
图 4. 对固定深度 16 的原创算例。阴影表示可行范围,曲线给出独立均匀抽样下的参照。
若每块有 个参数,核心的权重存储大约是 ,另加路由器与 FiLM。每 token 的线性层计算则大致随 变动,重复用同一块也要重新执行。每深度有 个窗口时,计算全库分数还要做约 量级的运算, 是隐层宽度。大库、小窗口或高度分散的选块可能让路由和分组成为明显开销。反过来,窗口路由让一批连续 token 共用一个选择,prefill 更容易攒成大矩阵乘。解码阶段每个请求通常只贡献一个新 token,分组效果需要另测。
论文用逐步加深的办法压低早期训练开销。1B 数学实验报告在训练的前 75% 使用论文所述的 增长计划。附录图 7 还比较了固定 16 层、从 1 增长到 16 层,以及除首窗外只回传最后八步的增长版本。以训练步数为横轴,浅层阶段可能吃亏。以累计 FLOPs 为横轴,同样预算可以先读更多 token。末端损失也有轻微变化,不能只看哪条曲线先下降。
若固定首尾计算为每 token ,每增加一次核心应用约多花 ,共训练 个 token,按各 token 的实际深度求和。与全程使用末端深度 相比:
举一个预算例子:首尾折合八块,末端深度 16,平均深度 10,理想节约约 。这个数来自假设,论文未报告这一比例。实际还要算注意力、优化器状态、反向截断和通信。增长本身也改变训练过程:越晚加进来的深度向量,见过的 token 越少。要把路由的作用和训练课程的作用拆开,两个对照组都应使用同一增长计划。
用固定路径控制解题策略
数独和迷宫都有同一个训练设计:每个问题搭配五种策略各自生成的轨迹,策略描述只给路由器看,损失只算解题过程和答案。数独保留 30–36 个数字,确保五种方法都能解。显性唯一候选、隐性唯一候选、交叉排除、传播和回溯各用不同的步骤格式,轨迹可能从表面文字就看出策略。迷宫把这条捷径控制得更好。五种策略都输出格子编号,区别在访问顺序。
以同一张树形迷宫为例,BFS 按搜索前沿逐层扩张,DFS 则沿分支深入并可能回到父节点。A* 用曼哈顿距离作启发式,双向搜索从两端扩张,填死路法逐步剪去叶子。它们完全可能输出同一条最终路径,搜索过程却不同。论文的迷宫生成器用 无环网格,要求答案至少 12 格,DFS 至少回溯一次,BFS 至少扩张三个答案路径外的格子。这些约束使五种搜索轨迹可区分,也限定了分布。附录给出约 720 万个迷宫、3,600 万条策略序列,以及每个任务约 100 亿训练 token。数独去重后约 2,000 万条序列。
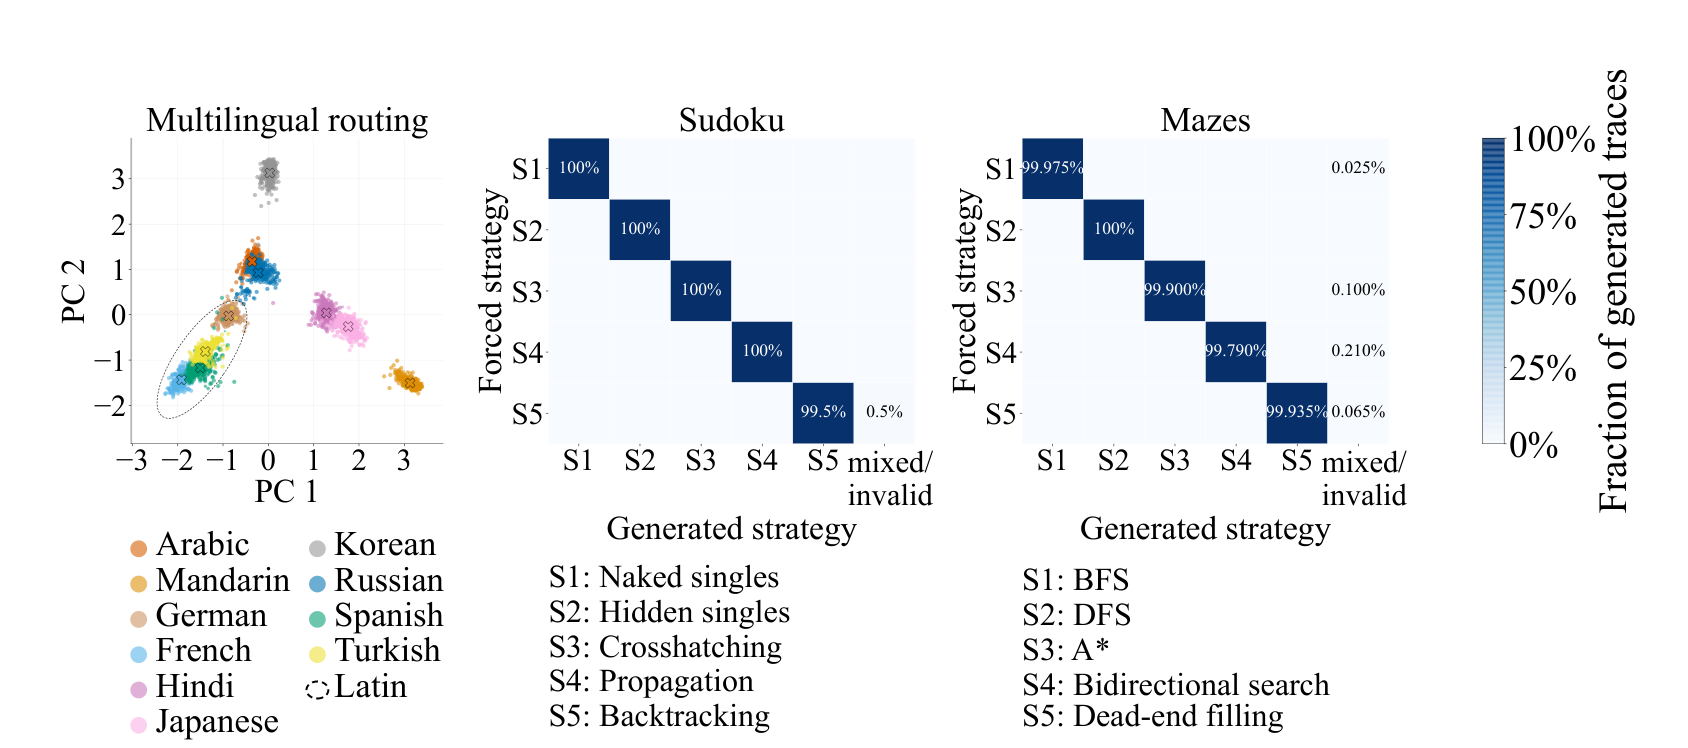
图 5. 裁自论文第 6 页图 3,保留三个面板。左侧是路由路径的 PCA,右侧两张矩阵显示强制某策略后生成的策略分类。
模板怎样提取
验证时保留策略提示,并用教师强制跑过已知轨迹。在策略 、深度 、窗口 的位置,先把所有有观测的验证例的完整专家概率取平均,再取均值最大的那一项。设这些例子组成 :
论文称它为 mode path。这里的“众数”实际按平均概率选。假设两个专家,三条验证轨迹给第一个专家的概率分别是 。它赢了两次,平均却只有 0.3433。模板会用第二个专家及其平均概率 0.6567。逐位置选出的专家还可能从未在一条真实轨迹中共同出现。这个模板是用于干预的构造,对联合路径出现频率没有直接解释。
算法 2:提取并干预策略路径
01  对每种策略,用带策略字段的验证轨迹做教师强制。
02  按核心深度和窗口序号累积原始路由概率。
03  对有观测的位置除以样本数,得到每专家平均概率。
04  保存概率最大的专家编号及该平均概率。
05  对新问题,将策略字段替换为中性填充。
06  自回归生成时,在对应位置装入模板编号和门值。
07  分别判定策略、步骤合法性和最终答案。
第 01 步读取的是验证集的完整轨迹。第 06 步使用事先固定的模板,测试时不必知道未来 token。两阶段之间的重要边界是覆盖范围。附录图 17 中,迷宫填死路策略在 W3 没有验证观测,若生成到了 W3,就复用 W2 的专家序列。这一退化规则适用于图中情形。将实验扩展到更长轨迹时,应报告每个模板单元的观测数和回退率,并分开统计全程落在有支持窗口内的样本。
三个百分比回答三个问题
主文图 3 中,数独回溯路径有 99.5% 被识别成要求的策略,迷宫双向搜索为 99.790%,其余相应结果同样接近满分。附录图 14 进一步给了轨迹和答案的指标。隐性唯一候选策略的“策略符合”是 100%,轨迹符合规则是 96.5%,答案正确是 98.5%。只拿后两项边际比例,可推出两者交集至少 %,最多 96.5%。没有逐例联合统计就得不到精确交集。图 3 的分类矩阵和附录的答案正确率适合分别读。
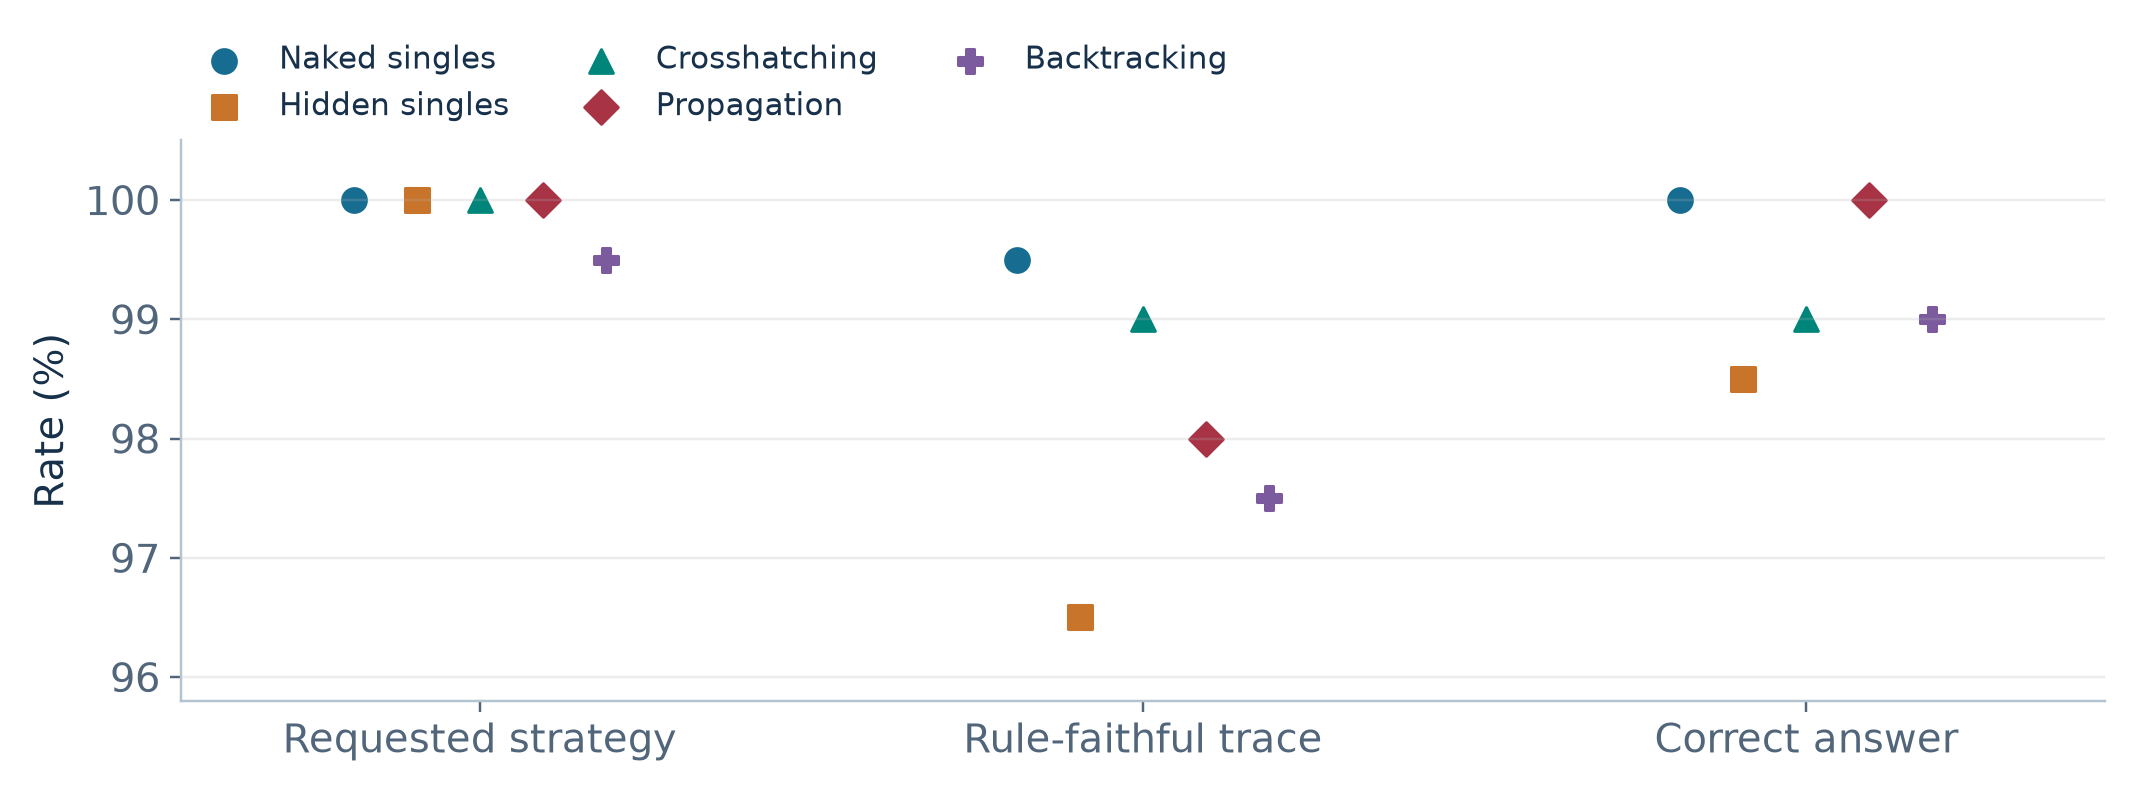
图 6. 依据论文图 14 重画,纵轴截断以展示差距。三组指标采用附录图注所标的强制路径协议。
论文里有一处口径需要留意。主文第 4.1.3–4.1.4 节引用附录图 14 和图 18 说明只提供策略描述时的表现,但两个附录图注都写的是强制路由。主文图 3 和方法说明直接支持强制路径的结论。这里保留附录图注的标法,无法从这两张图可靠地量化两种协议的差值。
还可以把模板图和真实路由的一致率并排读。附录图 13 中,数独五个策略的首窗模板 ID 相同,差异出现在后续窗口。图 12 中部分位置与模板的一致率很低,有时为零。强制模板能成功,同时日常路由可以经常走另一条路径。可能存在多条功能相近的路径,也可能是同时换掉门值提供了补偿。要找真正有控制力的位置,需要分别动 ID 和门值,还要把步骤、答案和联合正确率都记下来。
自然文本里的路径信号
多语模型在十种 FineWeb-2 语言的均匀混合上训练 100 亿 token,规模约 360M。作者对采样窗口的每个深度选块做 one-hot,沿深度拼接,再做 PCA。对比两条路径时,只要某深度选了不同专家,就有一个坐标从 1 变 0、另一个从 0 变 1,平方距离加 2:
这使图 3 左侧更好理解:它把高维路径差异压到二维,部分语言出现分群,拉丁字母语言之间有重叠。附录图 11 显示训练中的变化。分群可能来自脚本、分词长度和词频,也可能来自语言结构与训练语料。若要隔离语言因素,可以用同内容的翻译、音译和字母转写,先比较只看 token 或 prelude 的分类器,再测路由特征带来的增量。
安全实验用外部分级器给 FineWeb 序列赋分,取 0 分为安全、4 或 5 分为不安全。预训练在两组平衡混合的数据上做语言建模,不把标签当监督目标。探针在另取的 5,000 万 token 上训练与评估,其中 4,000 万用于开发、1,000 万用于测试。对所有深度的路由概率做岭回归,单窗特征的测试 AUROC 为 0.92,先跨窗做序列平均为 0.95。窗口继承整篇文档的标签,可能根本没包含触发标签的内容。序列池化有机会整合证据,在线前缀筛查则要承担等后面窗口到来的代价。
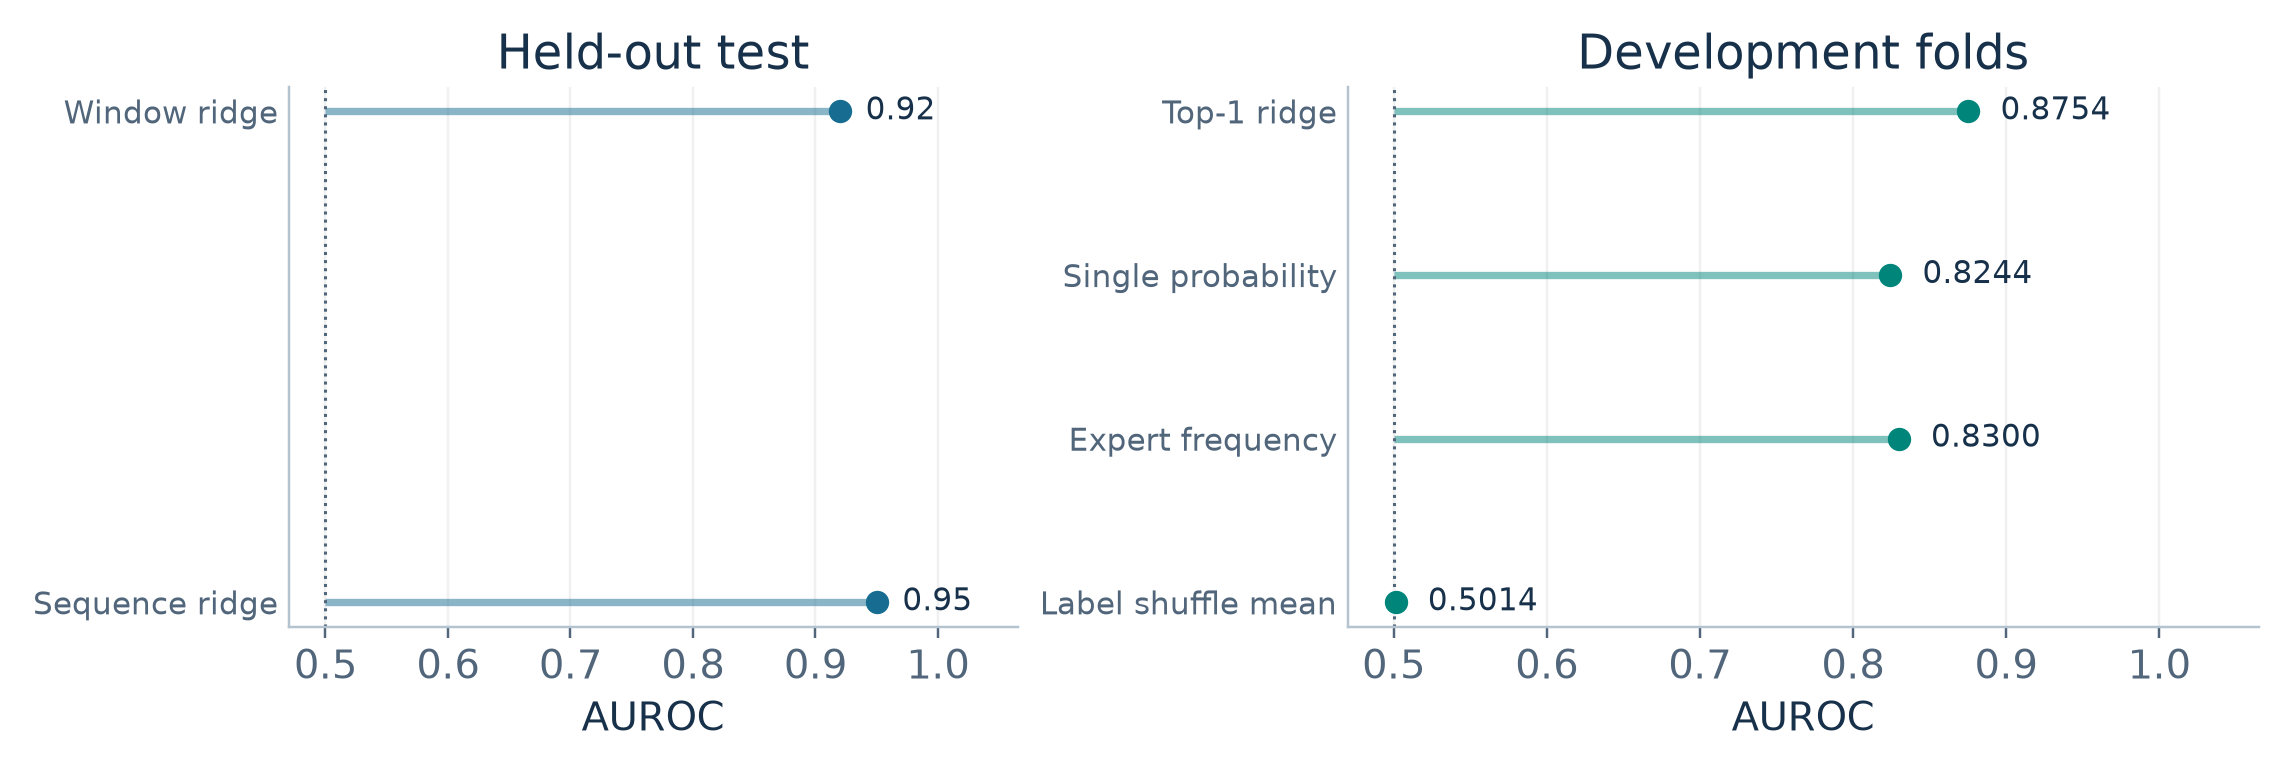
图 7. 根据论文第 4.1.2 节和表 2 重画。左侧是留出测试,右侧是开发集交叉验证及标签打乱控制,不能把左右的差当成同一协议下的提升。
附录表 2 的开发集结果显示,按每层最大概率做岭回归可达 0.8754,单层获胜概率为 0.8244,专家频率的对数似然比为 0.8300。文档级标签置乱 99 次,平均 0.5014,最高 0.5231。简单特征本身已有信号,值得与整组概率配对比较。AUROC 衡量一条正例的分数压过一条负例的机会,平分时给半分。它不能替代具体阈值上的误报率。假设线上阳性比例 1%,某阈值召回 90%、误报 5%,那么每万条有 90 个真阳性和 495 个假阳性,精确率只有约 15.4%。这组阈值数字是说明性算例,论文实际测的是外部分级器两个极端上的可分性。
效率证据要看对照组
1B 数学模型:ARC-Easy 的差值取决于基线
LoL 的 16 层由 4 层 prelude、8 层核心、4 层 coda 组成,核心库也是 8 块。训练数据混合 Nemotron 和 OpenMath,预算约 90 exaFLOPs。计算最省的配置见到约 200 亿 token。附录表 5 同时列了普通全注意力、滑窗、移位窗口和不共享路由器的 LoL。大多 benchmark 用五样本提示,GSM8K 为适应 1,024 token 的上下文使用三样本。
| 模型(论文表 5) | ARC-E | ARC-C | HellaSwag | PIQA | GSM8K |
|---|---|---|---|---|---|
| 普通全注意力 | 40.8 | 28.2 | 31.4 | 56.6 | 29.7 |
| 普通滑窗 | 49.5 | 28.5 | 31.3 | 58.8 | 27.5 |
| 普通移位窗 | 48.5 | 28.0 | 30.8 | 59.0 | 25.9 |
| LoL | 50.3 | 29.1 | 31.2 | 59.7 | 27.9 |
| LoL 不共享路由器 | 50.1 | 30.0 | 31.4 | 57.1 | 27.7 |
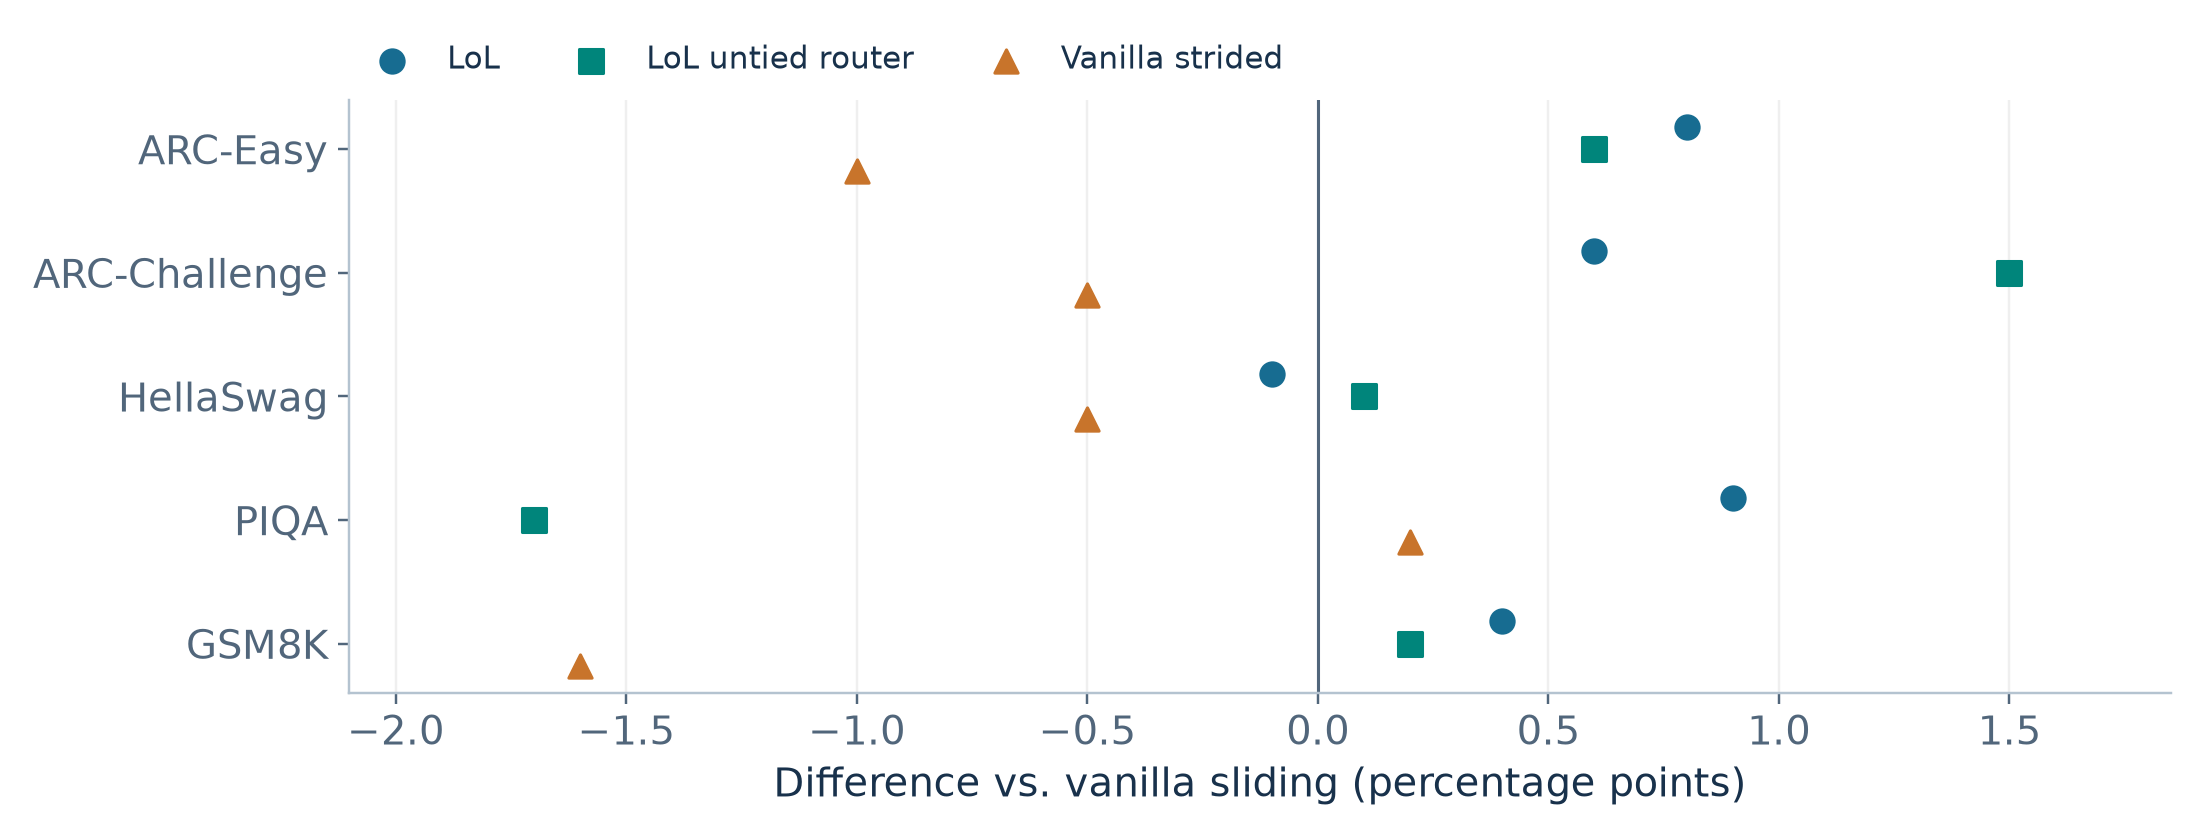
图 8. 根据论文表 5 复算并重画。单位为百分点。原表有单模型标准误,未报告配对差值的协方差,图中因此不画差值误差棒。
LoL 的 ARC-Easy 比普通全注意力高 9.5 个百分点,但比滑窗只高 0.8,比移位窗高 1.8。GSM8K 则比全注意力低 1.8,比滑窗高 0.4。就这组设置而言,它能维持有竞争力的性能。动态顺序的单独贡献仍难识别,因为注意力形态和训练增长也在变。测试题目上的标准误只能说明 benchmark 估计有多少波动,训练随机种子和配对样本的波动需要各自处理。
论文图 4 的专家热图显示,有些专家集中在相邻深度,有些横跨较广。这个结果提示专家可能形成深度专长。附录图 20 加入移位窗口的普通模型和不共享路由器的 LoL,末端训练损失仍总体接近。若想判断运行时选层本身是否有收益,可以用同一共享库训练一组固定路径模型,保持窗口、FiLM、增长计划和训练 token 数一致,再看相同输入上动态路由的增量。
FineWeb 小库:和固定循环比
Huginn 对照在约 360M 有效规模上训练,使用 100 亿 FineWeb token。核心调用固定为 16 次,LoL 的库容量 2、4、8 对应 Huginn 的 2 层循环 8 次、4 层循环 4 次、8 层循环 2 次。作者报告至少扫六个学习率,尝试多种调度,并对 Muon、AdamW 分别调参。论文图 5 左侧以非嵌入参数量为横轴,误差棒是三随机种子的最小和最大值。右侧的训练损失按三次运行平均。小库的 LoL 与固定循环有相近的损失,最终验证损失的种子间波动更大。作者怀疑初始化影响了路径探索,附录图 21 的热图与这一猜测相容。三次训练还难以说明是哪一环造成方差。
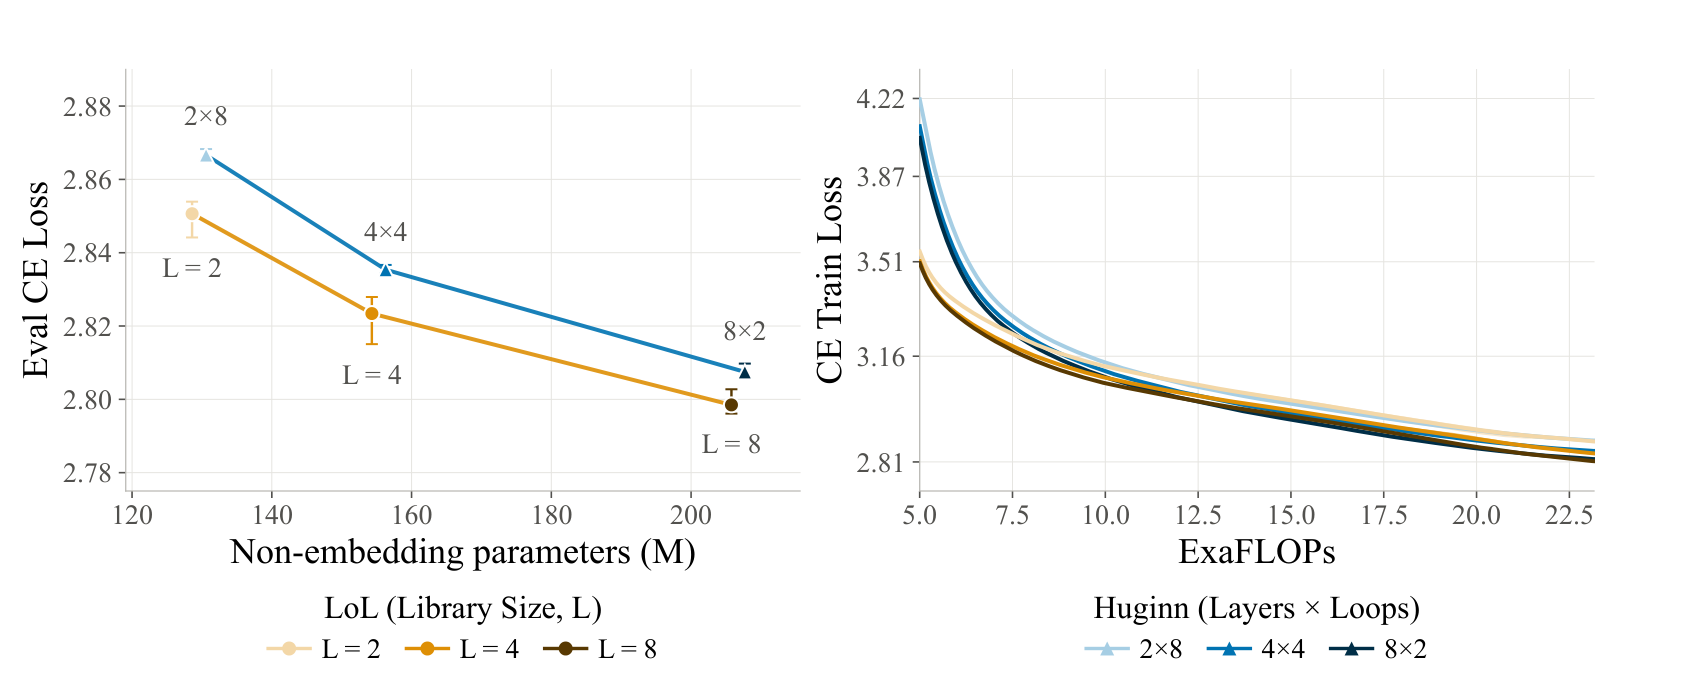
图 9. 裁自论文第 9 页图 5。左图按存储的非嵌入参数比较,右图按训练 FLOPs 比较。
这里最好同时记录存储参数、有效计算和非嵌入参数。两个配置都叫 360M 有效规模,也可能具有不同的权重驻留量。即便库很小,核心 16 次残差应用所需的激活也不会凭空消失。边际热图同样不能反推出每条路径到底用了几个专家:每个深度分布均匀的情况下,每条路径也可能始终选择同一个 ID。分析专家复用时应该直接对路径统计。
FineWeb 大库:和稀疏 MoE 比
稀疏对照是 24 块对 16 个深度,配每层三个专家用两个的 MoE,名义比值都是 3:2。作者扩大 MoE 专家的中间层以接近活跃参数量,给 LoL 的首尾加 MoE,在 MoE 对照的相应深度也用移位注意力。训练约 17 exaFLOPs,最省配置约读 100 亿 token。论文图 6 显示,LoL 借增长在早期有损失优势,末端 MoE 的训练交叉熵约 2.75,LoL 约 2.80。在相同分词和损失归约下,0.05 的差对应约 的困惑度比值。这只是同一训练口径下的换算。
MoE 的 3:2 表示每个 token 在该层实际打开两个 FFN 专家。LoL 每步只执行一个整块,3:2 比的是候选库和调用次数。路径可能反复用同一块,批次却可能触达库里的许多块。附录图 22 给出不同随机种子的专家分布,同一个名义比例可以学出不同专长。这也是为什么要把活跃参数、每步专家占用和实测时间分别记录。
用消融找到对照的缺口
附录 B 的三个消融回答的是不同问题。增长消融对比了训练轴和计算轴,也改变了梯度跨深度的范围。观察终点时要区分完整回传的增长组与只保留末端回传的版本。均衡消融比较辅助损失和选择偏置,但还需要把各专家接收的窗口数与每次更新的不平衡程度列出来,才能定位差异来自专家饥饿、优化目标冲突还是其他因素。共享路由器的图 9 显示所测设置下最终交叉熵接近。这有利于缩小路由器,但无法保证共享和不共享会学到相同的路径,更无法代替单条轨迹的干预测试。
固定深度的注意力消融也很重要。附录图 10 中全注意力训练损失最低,移位窗和滑窗的差异较小。它给出了掩码自身的效果,却没有完整覆盖“可路由与不可路由”两种配置在同一训练计划下的对照。为逐步隔离这两个因素,可以做一组分层比较:滑窗加固定路径、移位窗加固定路径、移位窗加自适应路径,以及同结构下只在段首路由的版本。固定和自适应两组共享训练预算、存储库和深度调制。滑窗若跨不同专家取键,就需要共享注意力投影或把该组限定为固定路径,记录这一差别。这样得到的结果会比单独改变库容量更接近“输入相关的路径是否值得”的问题。
局限与复现要点
论文自然文本训练多用 1,024 token 的上下文,规模以 360M 和 1B 为主。长文时局部注意力、全局首尾层和历史路由摘要会承担不同职责。参数利用在更大模型里能否转化为吞吐优势,还缺直接的服务实验。数独和迷宫则有明确策略字段、固定生成器及模板覆盖范围。图 3 的结果适合回答这套协议能否控制轨迹,不能据此推断自然语言推理也能靠改同样的几个位置来控制。
如果重做这套比较,我会先固定 tokenization、文档与样本划分、序列长度和总 token 数,再记每个训练阶段的深度与 FLOPs。附录 A 列出 RMSNorm、RoPE、SwiGLU、无偏置注意力、Muon 与 AdamW,以及按文档阻断注意力。英语 FineWeb 用 GPT-NeoX tokenizer,多语用 OLMo3。自然语言窗口为 128/64,数独后续窗口也是 128/64,迷宫为 64/32。两个合成任务首窗覆盖题面和策略描述。探针评估应按文档拆分,路径模板应按题目或生成种子拆分,并记录各单元覆盖数。这里的配对计数、残差求导和数值换算是笔记中的独立检查,模型训练曲线和 benchmark 分数来自论文。
批判性分析
先把专家编号、顺序和门值拆开
迷宫让格式捷径难以解释结果,因为五条策略轨迹都写成格子序列。但训练时策略描述已经是路由的显式输入。强制路径同时换掉专家身份和残差门值,FiLM 又让同一专家在不同深度接受不同尺度和平移。当前证据说明路径能当作控制变量。要判断专家是否组成了可重复使用的搜索过程,还需要看改变顺序本身会发生什么。
可以做四组配对干预:原 ID 与原门值、只换 ID、只换门值、两者都换。接着把模板中的专家顺序打乱,但保留每个 ID 的出现次数,并在相同窗口和深度位置固定门值。所有组保持同一输入、生成预算和评估器。分别报告策略命中、每步合法、答案正确和联合正确,按未见题目和模板是否回退分组。如果保持专家次数但只改顺序就可预测地切换合法轨迹,才更能说明顺序有独立作用。如果只改门值也有效,说明一部分策略信号可能通过幅度传递。再用有环迷宫、不同大小、策略名称重新映射做外推,能看出结果有多依赖生成器。
将权重复用换算成实际解码流量
根据前向定义,一种缓存设计可以给每个活跃窗口、每个深度保留专家编号和门值、先前窗口均值之和,以及当前窗口的输入状态累计量。新 token 到来时,用同一专家往当前窗口追加 K/V。窗口结束后,后续核心窗口通过摘要利用历史,prelude 和 coda 继续保留各自的全因果缓存。共享专家出现在两个深度时,它接收的状态和 FiLM 都可能不同,K/V 的索引仍需保留深度。这是从结构推出的服务方案,论文没有给出这种缓存的实测数据。
再考虑一个有八条并行请求的解码步。假设当层每个不同专家需从显存装入一次,八窗同选一块只读一份权重,各选不同则读八份。如果从 24 块里独立均匀选八次,套用式(12)得到平均 6.93 个不同块。实际读取量还取决于缓存命中、矩阵乘分组和与 prefill 的混跑。这一算例说明,相同的活跃 FLOPs 下,专家集中和分散可以有不同的访存与延迟。更有区分度的实验应同时测 HBM 字节数、每专家的有效批量、首 token 延迟、逐 token 延迟和 p95,分别覆盖窗口边界同步与异步的情况。
长前缀把新证据稀释了多少
论文让窗口 看所有已完成窗口的平均。加入一个新摘要 后,路由输入的变化可以直接化简:
若新证据只影响最后一窗里一个 token,它要先被窗内 平均,再被已完成窗数稀释。最近信息的直接权重因而可能随上下文增长而下降。衰减式摘要或单独保留最近完整窗口也能遵守因果性,但可能更容易受局部噪声影响。一个可操作的比较是把同一句决定性提示放在窗口首、窗中、窗尾,再改前缀长度,测专家切换何时出现、改变了几层、是否提升任务结果。另设每段只选一次共享路径的对照,可以同时量化响应速度和调度开销。这样能把“路由对内容有区分”推进到“它在需要时能多快利用信息”。
如何证明“顺序”有独立的作用
可以从一个二维算例看为什么固定专家次数仍是有意义的对照。设两块的局部残差近似是线性的,保留恒等支路,门值均为 1。第一块把第二个分量加到第一个,第二块把第一个分量加到第二个,写成
从 出发,先 后 ,中间状态为 ,结果为 。先 后 ,中间状态为 ,结果为 。两条路径用了完全相同的专家与次数。一般地,把两个残差步骤写成 和 ,两种顺序相减,单位项和一次项互相抵消,只留下
这只是局部线性算例,真实 LoL 还包含位置交互、非线性、门控与深度调制。它提示两点。第一,只有专家频率的统计无法反映顺序。第二,门值很小时,即使两块在满强度下差异明显,交换顺序的局部影响也会变弱。实验可以先在同一深度调制配置下比较两个相邻专家的交换,再逐步扩大到整段置换,记录首个出现差异的 token 与后续轨迹分叉点。结合门值扫描,能看到改变发生在两块组合本身,还是由交换后进入下一窗的前缀状态放大。要让这个比较可解释,仍须先匹配激活幅度,并把很少出现在该深度的专家单列。
路由翻转、分桶和质量需要一起看
选块由最大项决定。记最大和次大带偏置分数之间的差为 。若每个分数的扰动绝对值至多 ,最坏情况下领先项下降 ,次项上升 。因此 足以保证本次选块不变。这不是对全网误差的界,因为前一层换块可能使下一层的路由输入产生较大变化。它给了一个便宜的诊断量:记录每层、每种窗口长度的分数间隔,把低精度推理的 ID 翻转率按间隔分桶,再看实际输出是否改变。若翻转集中在小间隔且答案不受影响,一部分路径差异可能只是多个相近专家之间的替换。若大间隔位置也出现翻转,应先确认窗口编号、摘要和选择偏置在 prefill 与 decode 之间一致。
实验还可按连续多个深度的门值和专家占用来分组。高负载专家可能在 prefill 拿到足够大的矩阵乘,但在 decode 的每步只接到少数新 token。对两种流量都记录每组的窗口数、实际 token 数和最长组完成时间,有助于解释平均吞吐与尾延迟出现相反趋势。这样的量化也可检验跨请求凑批的收益能否覆盖等待时间,而不把缓存方案本身误当成 LoL 论文报告的结果。
训练之外再走几层,需要单独验证
论文讨论部分提出推理时把核心走得比训练更深。这对 LoL 有吸引力,因为额外应用共享库无需新增同等规模的权重。仍有两个设计量需要补齐。首窗路由有逐深度向量,注意力与 FFN 有逐深度 FiLM。超过训练深度时,这些向量和调制参数没有对应的训练值。可以循环使用已有深度参数、沿用最后一层参数,或者预训练时把深度条件设计成可外推的函数。这三种选择给出的计算不同,不能仅凭共享库就假定任意深度都可部署。
一种小规模验证是在相同模型上从训练末端深度逐步增加调用次数,分别记录每步损失、答案正确率和新增延迟,按训练内与训练外深度分段报告。用固定循环的额外层做对照,再比较动态选块和关闭动态路由的结果。若额外深度仅让输出信心上升却损害准确率,成本没有转化成更好的解题。还可以在训练中随机抽取终止深度,为同一块增加见过的状态范围,再看推理深度外推是否改善。论文没有这组结果,因此目前只能把它当作一个有明确失败边界的后续假设。
结论
LoL 把整块 Transformer 的执行顺序变成了输入相关的选择。关键是让当前窗口的专家由已完成前缀决定,窗内用同一个块做因果注意力,再让边界随深度移动。它在复用和稀疏两端都能训练出有竞争力的模型,并能用路径模板控制合成题的解题轨迹。下一步最值得补的是同架构的固定顺序对照、专家与门值分开干预,以及包含真实权重流量和尾延迟的服务测量。
技术参考
- Rahmani 等,Library of Layers,arXiv 2611.03526v1。本文主要核对第 3–5 节、算法 1 和附录 A–C。论文全文 · 作者项目资源
- Geiping 等,Scaling up Test-Time Compute with Latent Reasoning。固定循环 Huginn 的背景。论文
- Wang 等,Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts。负载均衡选择偏置的背景。论文
- Pérez 等,FiLM: Visual Reasoning with a General Conditioning Layer。特征缩放与平移的背景。论文