笔记日期 2026-11-08
作者 Zhongzhu Zhou
论文 FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
论文作者 Fedor Velikonivtsev、Mikhail Koltakov、Denis Kuznedelev
arXiv 2611.03344,v1,2026-11-02
1. 因果性也取决于量化前处理
我读这篇论文时,先想象一个位置已经被掩码挡住的未来 token。它参与不了注意力加权求和,却还可能参与量化器的最大值计算。只要早先位置用同一个尺度,未来 token 把尺度抬高,就会改变早先向量的舍入结果。前向掩码照常工作,输出却已经通过量化间接依赖未来。训练时若存在这条通道,模型还可能适应它。论文把同一组权重放进两种评估内核,验证损失因此呈现截然不同的结论。
另一个切入点是数据搬运。训练中,同一份矩阵在前向按特征维做乘加,到了反向可能沿 token 维归约。逐条带量化容易生成两套码和尺度,再把其中一部分留到反向。FLAMIA 给整块 token 共享一个指数,让 E4M3 码能够复用于两个方向。论文也保留一条混合路径,给打分用 NVFP4,把多数梯度乘积留在 8 位。这里的位宽选择会同时改变计算单元、尺度分组、数值误差和存储布局。
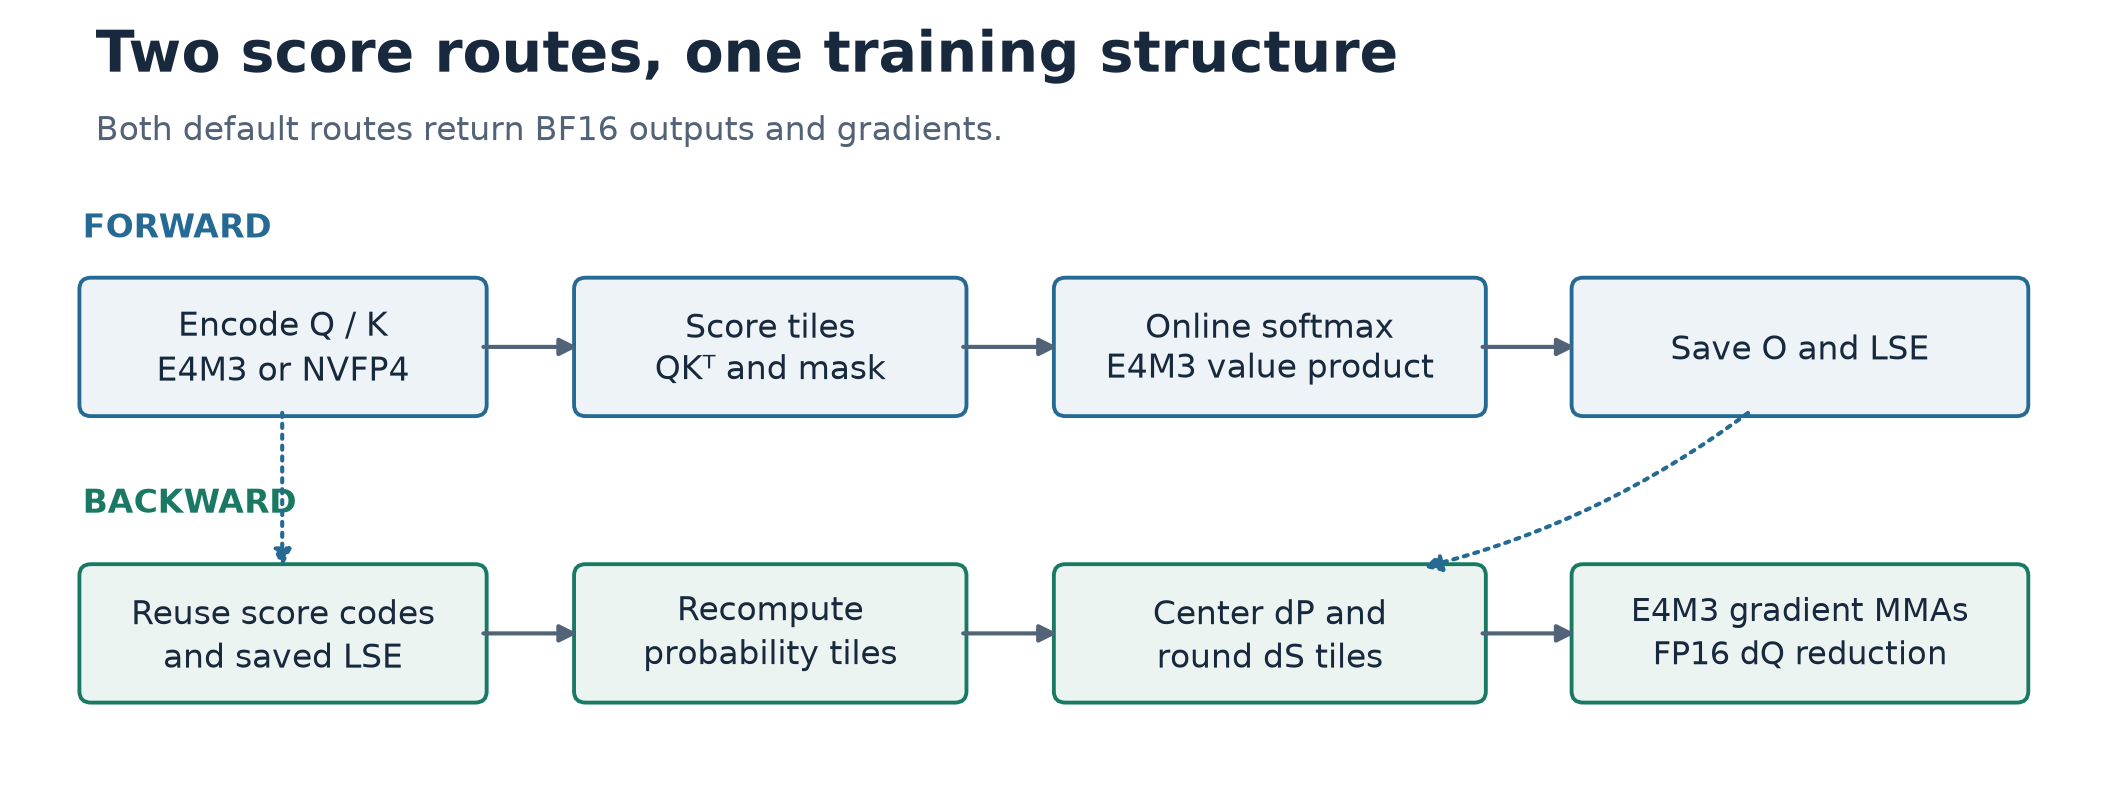
图 1. 依据论文第 3.1 至 3.5 节自绘。打分路径决定 Q/K 的码;反向重算沿用这份表示,梯度乘积另有 E4M3 视图。
整篇笔记沿三个问题展开。第一,哪个尺度能复用到两个乘法方向。第二,一个前缀究竟依赖哪些原始数据。第三,量化、前反向和数据布局一起计时后,实际节省了多少。原文的严格因果选项目前适用于支持的 batched causal 配置。标题里的「安全」需要结合选项和支持范围来读,尤其要和默认 packed 性能区分。
2. 前置知识
从一次加权求和看反向
设单头有 个位置、每个位置 个通道。 的形状都是 行乘 列。用 表示第 个 query 能看的 key,用 表示从输出传回的梯度。对 causal self-attention, 从当前文档起点延伸到 。把缩放因子写成 。
掩码外的概率为零。计算 时,累加的是同一对位置的各通道乘积。计算 时,固定输出通道,累加各 key 的贡献。反向求 时则反过来,累加所有读取该 key 的 query 的梯度。把 、 记作两个中间矩阵,就有
这里显式保留 ,也可把它并入乘法所用的分数梯度。同一份 V 在 中沿 key 归约,在 中沿通道归约。Q、K、、P、U 也有类似的双重用途。这个观察把问题从「把矩阵量成几位」变成「每个操作数需要几种分组」。GQA 还让多个 query 头共享 key/value 头,进一步改变梯度归约的工作量和访存特征。
逐步拆开 softmax 的梯度
暂时省略 query 下标。对第 个 logit 求导时,分子只有在 时有直接贡献,分母则影响所有 。链式法则给出
再把 展开,先对 key 求和,再对通道求和。
因此可以用保存下来的输出,给每个 query 算一个标量 。在精确运算中,。换个角度看,给同一行 logit 全部加同一个常数,softmax 的分布完全相同,所以这一方向的梯度为零。后面会用这条关系区分概率归一误差和中心化项的误差。
FlashAttention 留哪些中间量
注意力矩阵有 项,写进全局显存会带来很高的容量和带宽成本。分块计算时,每行保留参考最大值 、权重和 、加权向量和 。遇到新 tile 后,如果参考最大值更新到 ,此前的权重需要整体乘上 ,再合并新 tile。
这里 只含当前 tile 中有效的 key。若一直用同一套精确实数运算,最后的比值与直接 softmax 一样。反向保存的是每行 LSE 和输出,概率块按需要重算。也正因为如此,只改前向的指数近似或对角块处理,会破坏反向重算所依据的数值约定。前反向公式写得一样,只能保证它们在同一个实数目标下有联系。
两种硬件格式
可以把一个低精度值看成「码值乘尺度」。MXFP8 用 E4M3 码,每 32 个元素配一个 UE8M0 的二次幂尺度。NVFP4 用 E2M1 码,每 16 个元素配 E4M3 局部尺度,标准格式还允许配合 FP32 的张量级尺度。读论文时应关注实际尺度取决于哪些输入。即使局部尺度是 per-token,引入由未来数据计算的外层尺度也需要重新做因果分析。
在 block-scaled MMA 中,尺度组沿乘法的收缩轴布置。FLAMIA 用到的 E4M3 乘法支持两种布局方向,文中的 4 位指令则要求 K-major,K 在这里指硬件乘法的收缩轴。输入码、尺度、累加器和返回格式可以各不相同。论文把两条默认路径简称 MXFP8 和 NVFP4,后者实际混合了 NVFP4 和 FP8。两者的返回值都是 BF16, 部分和使用 FP16 归约。比较位宽时要问清楚是哪一个操作数。
3. 为什么把尺度做成 token 块
让同一份码跨两个方向使用
取一个文档内连续的 32-token 块,记 为位置 所属的块。块内所有行和全部特征使用同一个尺度 。若 是 E4M3 码,重构值为
现在沿某行连续取 32 个通道,尺度相同。转过来,沿某列取这个块内的 32 个位置,尺度也相同。因此在硬件需要的分组内重复指数即可,码无需重新量化。 采用 32 乘 32 方块,沿 query 或 key 方向取组都能用同一份数据。普通的一维细分组对单方向的表示更灵活,但换轴后原来分组的尺度通常不相同,得多写一份码。文档起点在物理地址上可能不对齐,打包加载器还要处理这个几何差异。
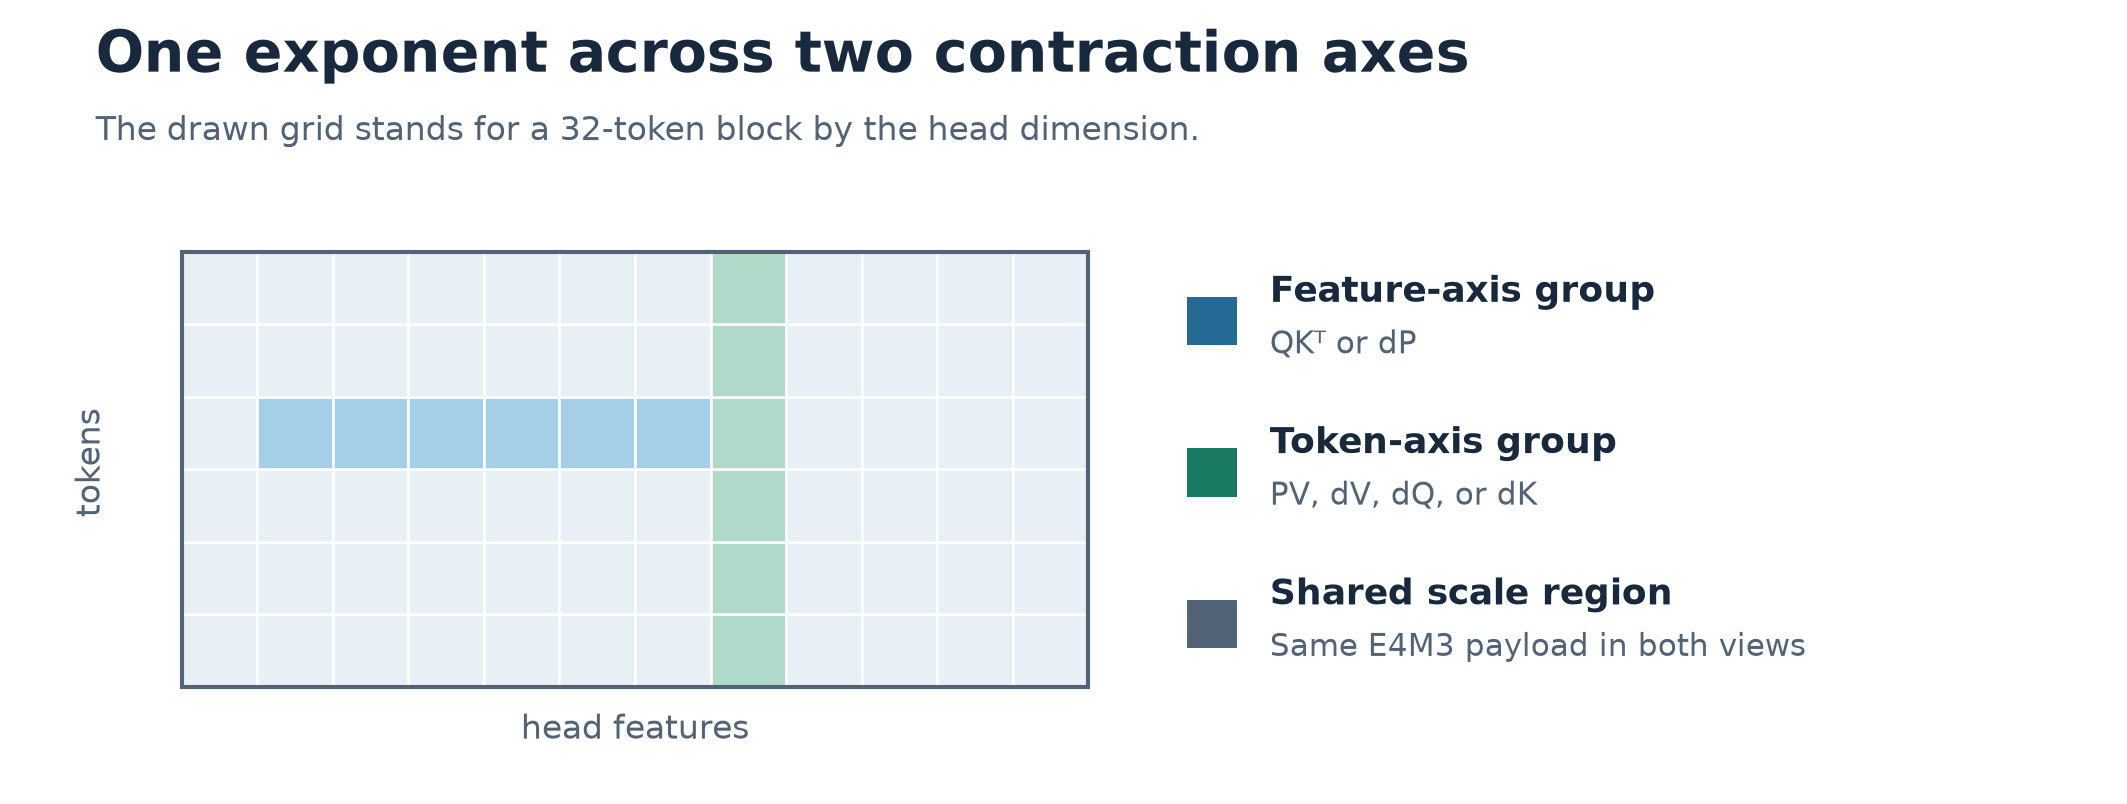
图 2. 依据论文第 3.1 节自绘。矩形表示指数覆盖的 token 块,横竖两条分别表示沿两种轴的硬件尺度组。
用一个只计码值的例子想象成本。每个 BF16 元素占两字节,两套独立的 E4M3 码也占两字节,还没算尺度。把码复用后,直接少了一套输出写回,而且反向要保留的 Q、K、V 也能少存一套表示。真实节省还取决于是否融合量化、缓存命中和内存布局。代价是一个异常大的通道可能把整个块的动态范围拉大,让附近的小值掉到低精度区。这也解释了为什么论文反复同时讨论复用与数值。
把尺度提到打分乘法之外
MXFP8 的 Q/K 指数不随通道变化,因而可在点积之外应用。令 ,有
右边先做无尺度的 E4M3 乘加,再在 softmax 前乘上行和列的系数。这个变换在代数上保持重构分数。实际浮点的舍入点和中间范围随运算次序变化。混合路线的打分采用 NVFP4,每个 token 的尺度还会随通道组变化,因此不能把一整行的尺度提成单个系数。反向重算打分仍用原来的 NVFP4 Q/K,计算 则另取 E4M3 视图。
旋转为什么有时适得其反
先沿通道做归一化 Hadamard 旋转 。因为 ,
一个独立的异常通道可被分摊到整个头。对粗尺度,分摊有机会缩小最大值;对每 16 个通道一个尺度的 NVFP4,原先只影响一组的异常也可能被传播到各组。附录 A.2 的 outlier 例子里,NVFP4 输出余弦从 0.937 降到 0.857,而对照的 MXFP4 从 0.749 升到 0.816。作者报告在所测训练中,开关旋转的差异落在运行间波动范围内。头维为 128 时,两条默认路径启用旋转。操作只在一个位置内部混合通道,因此本身没有把未来位置引进来。
4. 尺度能绕过因果掩码
两个数就够构造反例
考虑一个用于说明机制的整数舍入器,码值是 。两个 value 分别为 和 ,共享尺度 。query 1 只能看到 key 1,它的概率是 1,输出直接等于第一个重构值。
未来位置 时,,输出为 1。把未来值改为 6,,输出就变成 0。两次运行中掩码完全一样。发生改变的是早先位置的表示。这个例子没有使用真实的 FP4 码表,作用是把「共享统计量引入边」这件事单独抽出来。
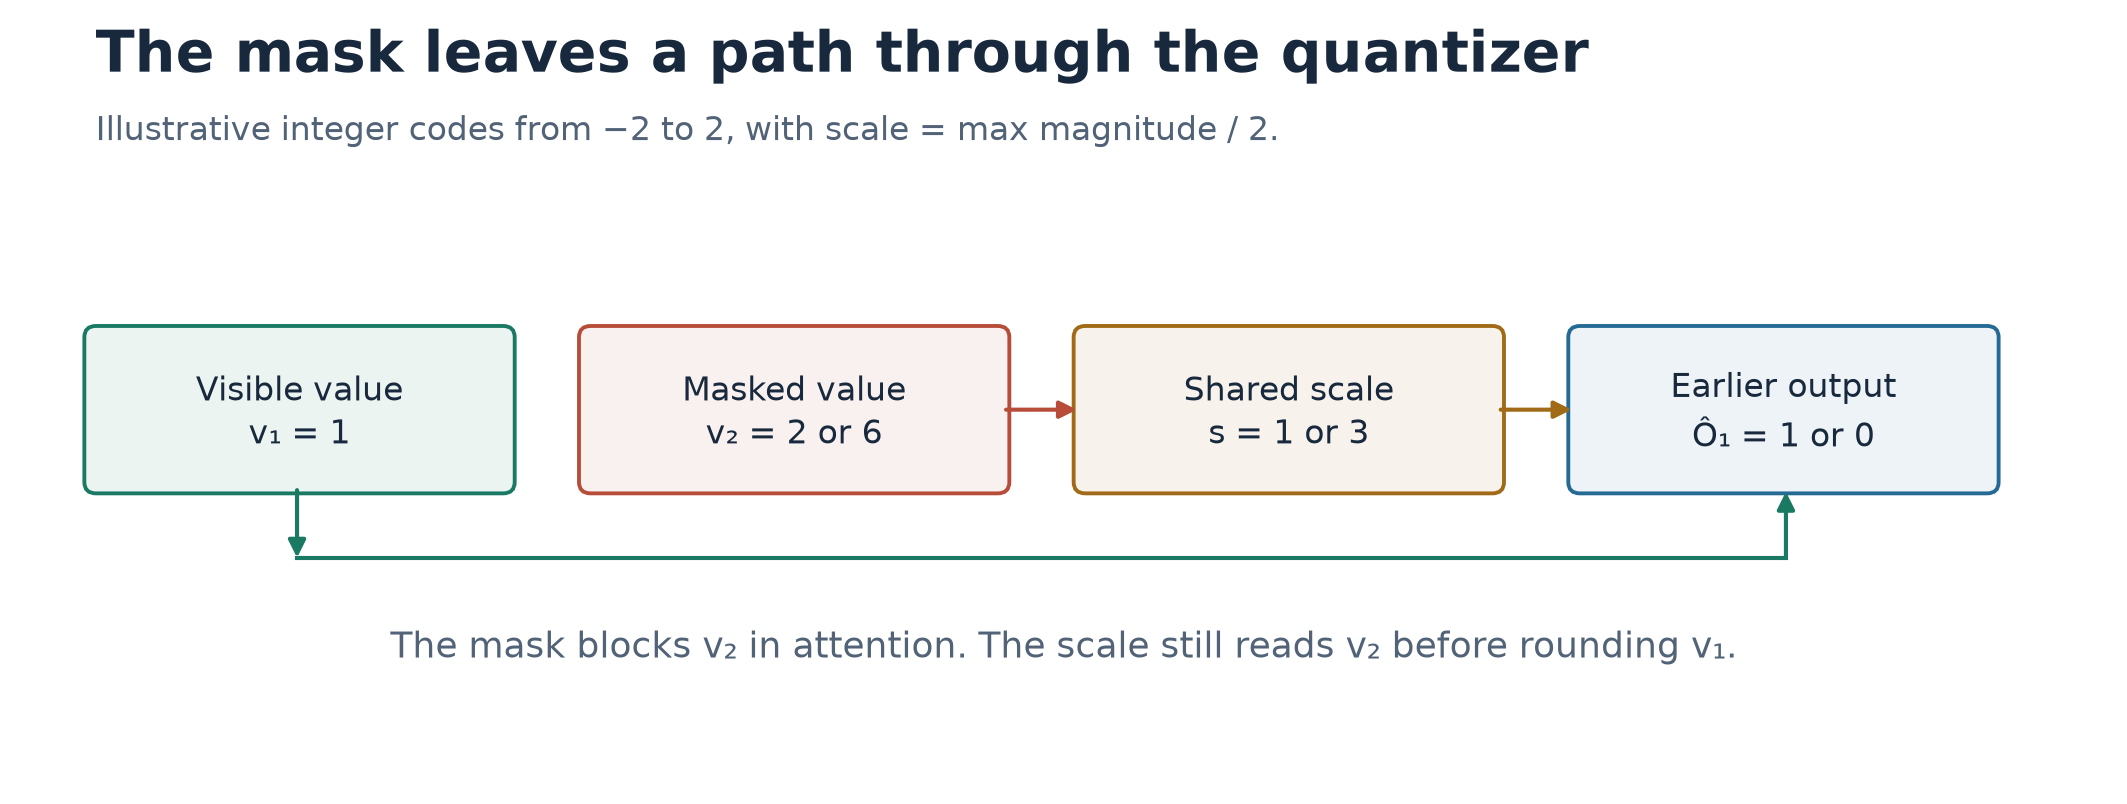
图 3. 受论文图 1 启发的自绘示意及算例。未来值抬高共享尺度,query 1 读到的过去值从 1 变为 0。
把这个例子放回分块注意力。三角掩码上方整块跳过,下方整块可见,只有对角块的边界横穿尺度组。对一条 query 行来说,若某组所有 key 都已进入前缀,共享统计量符合依赖要求;若组内横跨可见与不可见位置,组尺度就需要特殊处理。跨文档的边界也必须纳入分组。否则两个独立样本仅因为放在同一个缓冲区,就会彼此改变舍入。
E4M3 为什么常常不受尺度翻倍影响
在正常数区域,如果尺度扩大到两倍,待舍入的数就减半。E4M3 的尾数网格随指数成比例变化,码值也可以只降低一个指数。最后码值再乘回两倍尺度,重构值保持相同。这个推理要求两个位置都远离饱和区,而且对应舍入邻点仍保持同样的二次幂比例。一旦进入次正规数区,固定间距的格点不能继续等比例缩小。例如最小 E4M3 次正规码为 ,在尺度翻倍后,原值会落在零和新的最小可表示值之间,重构必然改变。
还存在饱和的边界。设块最大幅值为 ,最大有限 E4M3 码为 448。为了让最大值不超出范围,选尺度指数 时要求
如果指数格式范围允许,满足约束的最小整数是 。全零块可以使用约定的有限尺度。只按最大指数向下取整可能漏掉尾数上界:例如尺度为 1 时 480 被截成 448,尺度为 2 时 240 可精确编码,解码后回到 480。FLAMIA 用向上取整处理这一类饱和。共享尺度遇到次正规边界时仍会重舍入,残余影响可留在同一 token 块内,最多相隔 31 个位置。 的方块尺度也有类似问题。
在边界把尺度移到另一边
对 4 位 V,给对角块上的每个 key 单独设二次幂尺度 ,并把它乘进概率操作数。设 是码向量,有
这样参与计算的每项尺度只依赖对应 key。本来就全可见的 tile 保留组尺度。论文以类似方式处理 的 V 和 的 K。后者把 K 的 per-key 因子移进 对应项,称为 K fold。移尺度在实数下成立,量化与求和的次序一变,舍入和溢出仍需重新评估。第 4.5 节报告,在 32,768 token 的消融中,只在对角块应用 per-key V 尺度时前向延迟为 1.04 倍,全 tile 使用则为 2.83 倍。局部修改之所以有效,是因为只有边界块有这类跨前缀尺度组。
最后一条通道在累加器里
的多个 tile 部分和以 FP16 做归约,可以减小写回流量。FP16 的指数范围较窄,固定放大倍数可能溢出。论文先用数据决定一个二次幂放大因子,再进行 FP16 归约,最后除回去。用 表示第 行部分和的量级估计,用 表示留出裕量后的目标范围,可以用下式帮助理解这类选择。
这是说明性的范围模型。FLAMIA 按 、V、K 的幅值选因子。默认取整条序列的统计量,未来位置抬高其中一个最大值时,较早 的 FP16 舍入也可能变。严格选项为每行取自己的 ,配上只扫描可见 key 的 V 与 K 前缀最大值。它还需要 per-token 操作数尺度和 per-query 的 尺度,才能处理块内残余。附录 A.4 说明严格累加器尺度目前覆盖支持的 batched causal 调用,packed、窗口和全 4 位反向仍走默认尺度。
在这里测试 的前缀不变性,需要固定传进来的 。而 、 本来就要累加后面读到位置 的 query,它们随未来 query 变化符合数学定义。前向输出、固定来梯度下的 和 K/V 完整梯度不能共用一条前缀断言。
5. 反向重算的数值约定
把行和残差拆成两项
假设反向重算的概率是 ,其和值是 。用同一份反向表示求得的加权项为 ,由前向保存的 和反向的 得到的实际中心项为 。那么量化 之前的行和为
右边第一项反映两条路径算出来的中心项不一致,第二项来自概率重算后不再恰好归一。把 与 的 统一,并使用相应的 E4M3 V,可以消去一部分表示差异。BF16 输出舍入、概率近似和归约次序仍会留下残差。一个诊断用的替代是取 ,只要 ,重构后的实数行和就回到零。但这需要先汇总一整行的两份统计量,容易打断原来一边扫描 tile 一边累加梯度的调度。FLAMIA 选择复用 ,同时匹配重算的前后约定。
算法 1。低精度前向与一致的反向重算
下面用编号写出论文第 3.1 至 3.5 节的默认两条路线。伪代码用英文短句,使张量名和硬件术语易于对照。每步描述语义,GPU 内核可以把相邻步骤融合。
01  Select MXFP8 or mixed NVFP4/FP8 and the scale policy.
02  Rotate Q/K per token if enabled; encode the score operands.
03  Prepare E4M3 V and the Q/K views for the gradient products.
04  For each query tile, initialize online softmax statistics.
05    For each eligible key tile, reconstruct scaled scores.
06      Mask invalid positions and update the row statistics.
07      Quantize the scaled weights and accumulate their values.
08    Save normalized BF16 O and the row LSE.
09  Encode G and compute D using its matching reconstructed view.
10  Choose dQ accumulator boosts under the selected policy.
11  Rebuild backward scores from the same score operands.
12  Rebuild P with saved LSE and matching tile and exp rules.
13  Form E = G times transpose(V) from matching operands.
14  Form U = P * (E - D); scale and quantize U within the tile.
15  Accumulate dV, dK, and boosted FP16 dQ partials.
16  Undo the boosts and return BF16 gradients.
第 7 步的概率操作数服从在线 softmax 分子的范围。第 12 步用保存的 LSE 形成反向权重,具体乘法的量化比例可以不同。需要匹配的是重算打分、指数、对角分支与参考最大值的约定。如果用不同的 tile 边界识别需要 fold 的部分,明明参数相同,也可能形成不同的概率。按这种方式回传的梯度是训练所选的近似,离散舍入函数本身有不连续点。
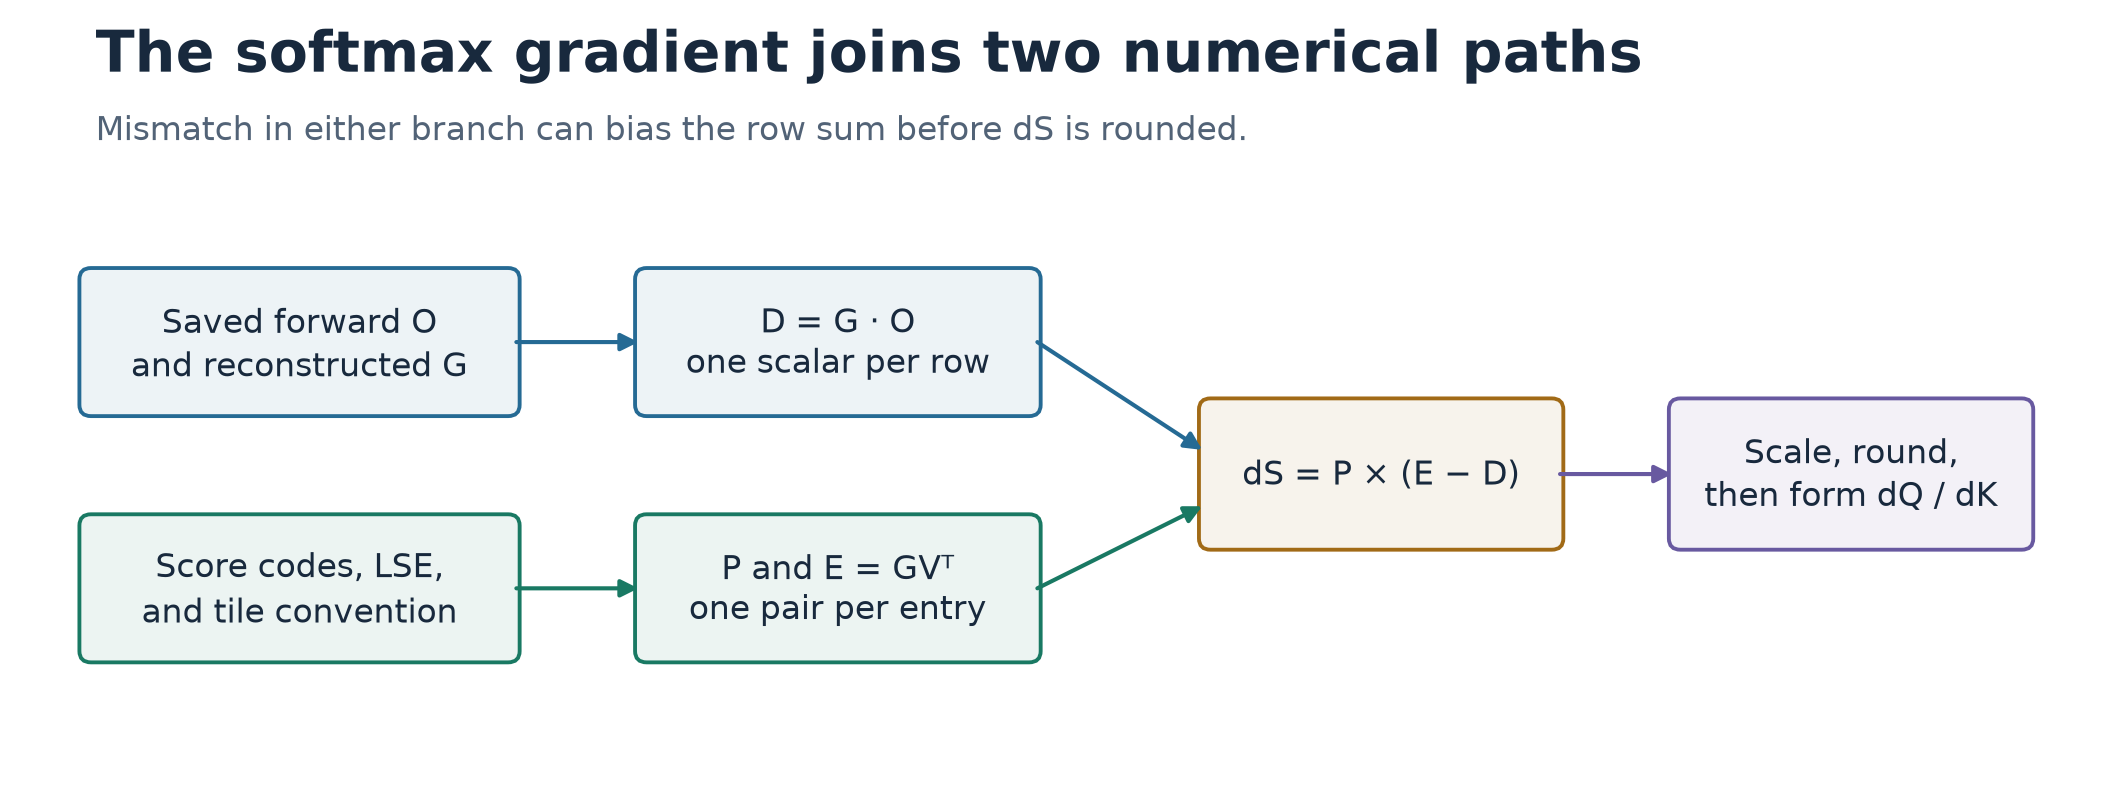
图 4. 依据论文第 3.3 节自绘。保存的输出参与 ,同一份打分表示和 LSE 参与概率重建,二者在形成 时汇合。
概率上限由两个参数共同决定
为避免不断重标定历史部分和,在线 softmax 可以暂时保留旧参考最大值。在以 2 为底的坐标中,若它最多落后真实最大值 ,则最大的指数权重最多为 。为保护小权重,先将其乘以 再量化。E4M3 的上界给出
MXFP8 默认 ,最大值不超过 256。若取 ,则可能到 1024,超过 448 后会静默饱和。最后除以 256 时,最大权重只能重构到 1.75,本来应该是 4。常规的 NaN 或异常检查抓不到这类错误。每次更新到真实最大值可以腾出更多范围给 ,代价是更频繁地缩放历史部分和。附录 B.1 还区分了反向 用到的 倍概率缩放。
小梯度为什么在余弦里消失
考虑一个人工向量,第一项是 1,其余一百项都是 0.001。把所有小项舍入成零,余弦仍约 0.99995,欧氏相对误差约 1%,但 101 个非零分量只剩一个。这个例子说明整体误差度量对小项的权重,不能用来判断任何具体训练分量的价值。论文选每个 32 乘 32 方块的最大绝对值作为 尺度,缩小大值对其他块的影响,也保留两向复用。更细的组、逐 query 取尺度或更高精度可以保护部分尾部,分别需要额外归约、专用布局或更大的数据流量。
6. 打包文档从尺度表开始
逻辑边界与物理地址分开处理
训练样本把多篇文档连续塞进一个长度为 的行缓冲。一个文档的起点可以落在任意 token 上。若量化仍按物理地址切块,文档 A 的异常激活可能改变文档 B 的码,哪怕注意力掩码从没跨过文档。若给每篇文档补齐到对齐起点,又要为 Q、K、V 和梯度重复搬运、存储填充数据。论文把块尺度统计限定在文档内,然后给每个 token 存尺度元数据,加载时再在共享内存拼出硬件使用的 128 乘 4 尺度单元。
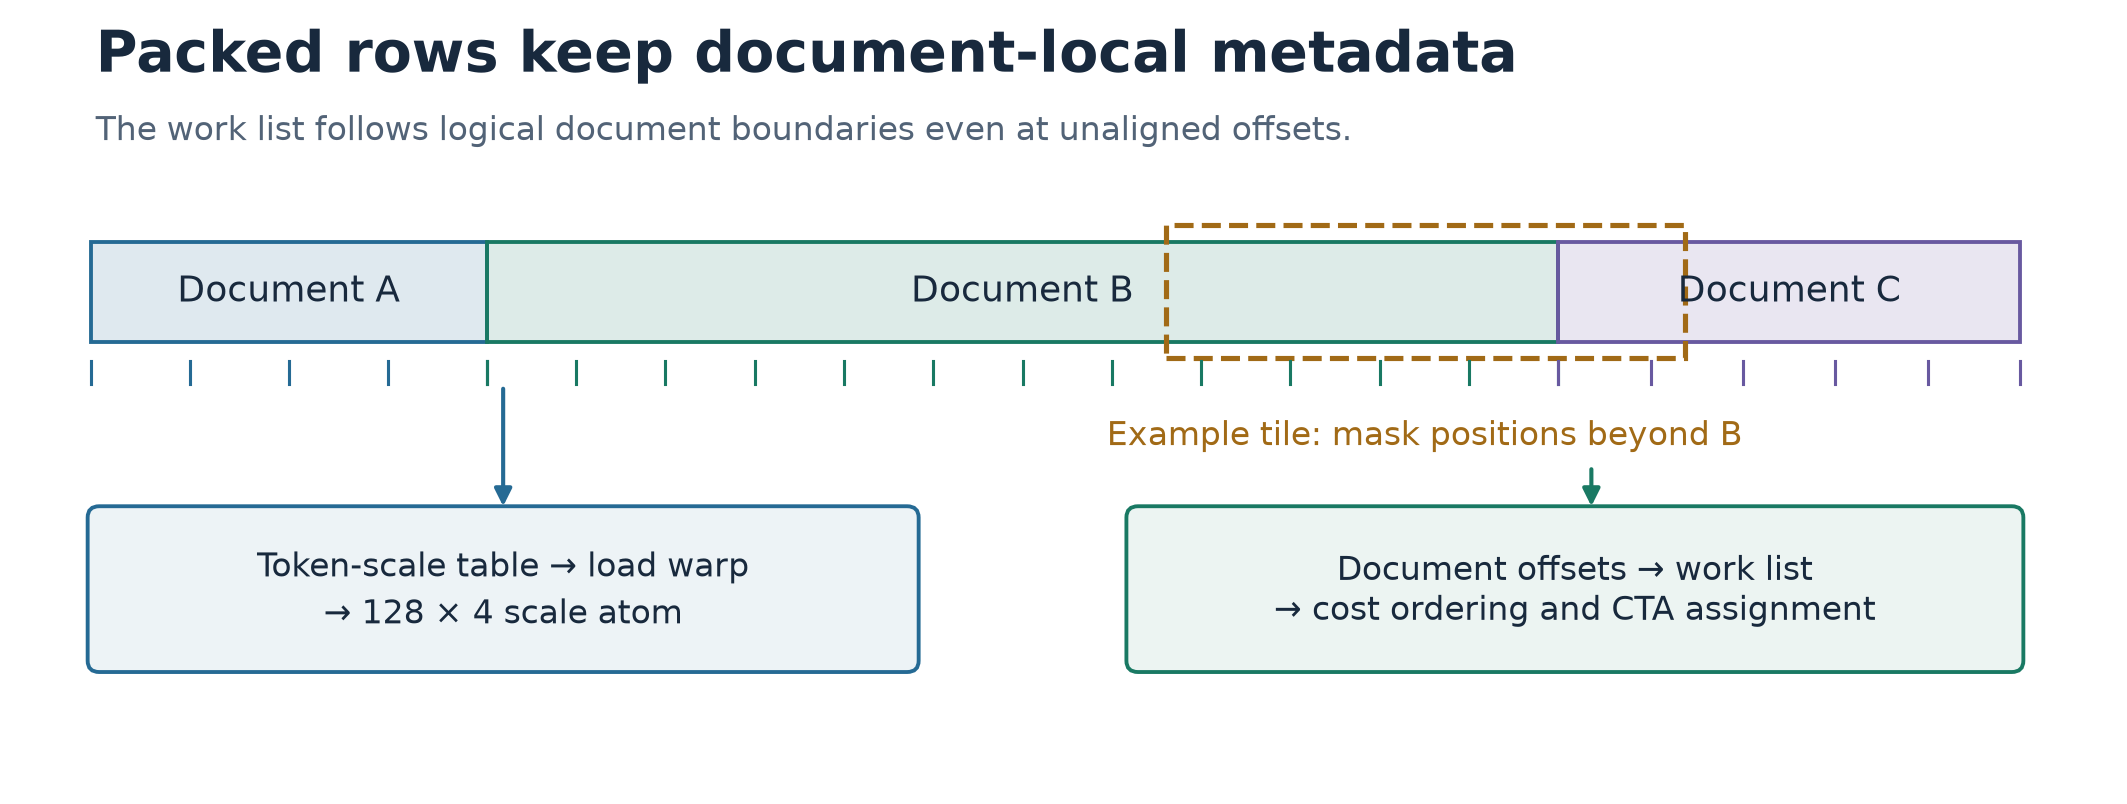
图 5. 依据论文图 2 和第 3.6 节自绘。文档偏移决定有效位置与工作项,加载器从逐 token 尺度表组装乘法所需的尺度。
tile 超过文档末尾的 key 位置被掩掉,无效 query 行保存无限大的 LSE 哨兵,重算时对应贡献为零。计算结果写回原始 packed 偏移。缓冲容量由行长度决定,文档长度分布变动时可以复用缓冲和捕获的 CUDA graph。全 4 位路线还有半字节问题: 每字节存两个 key,奇数起点不在字节边界。附录 B.2 介绍了两份错开一个 key 的副本,用一次量化输出的额外写入,换掉每次加载 tile 都拼接半字节的代价。
固定 token 总量,工作量也能相差很多
长度为 的因果文档有 个可见 query-key 对。把 篇文档的长度记为 ,总长度为 ,那么
同为 65,536 token,16 篇 4096-token 文档有 134,250,496 对可见位置,一篇 8192-token 文档加 224 篇 256-token 文档只有 40,927,232 对。后者总体运算更少,却可能把长尾集中在少数工作项上。真实 tile 还会有取整和边界掩码,不能只用这个公式预测延迟。它的用途是提醒我们,同样的 token 数和不同的文档长度分布,并不是同等的运算预算。
算法 2。用文档长度给 GPU 工作项排序
这段编号伪代码依据第 3.6 节和附录 B.6。CTA 指一个合作线程数组,也就是通常说的线程块。CLC 是支持动态领取的 Cluster Launch Control。
01  Read document offsets, lengths, and head groups.
02  Make scale groups wholly within each document.
03  Emit work items of up to 256 queries per document.
04  Estimate the visible key-block count of each item.
05  Sort items across the packed row by decreasing cost.
06  Distribute static work in alternating grid order.
07  For causal calls, permit CLC dynamic acquisition.
08  For noncausal calls, use CLC at max length >= 4 * mean.
09  Acquire the next item after the last K/V load.
10  Assemble scale atoms and mask out-of-document positions.
11  Write the results at the original packed offsets.
12  Order backward key tiles by cost and group heads for L2.
只在单条输入里把最长文档放前面,最后一条输入仍可能留下长尾。全局按开销排序再交错分派,有机会把重任务摊到多个 CTA。高度倾斜时,动态领取能减少提前分配造成的等待。领取动作放在当前任务最后一次 K/V 加载之后,避免忙的 CTA 过早把后续任务占走。非因果使用的四倍阈值来自经验。大量极短文档可能由工作列表和加载元数据主导,单个超长任务也未必能靠重排序再拆分。反向则按 key tile 排序,并把头分组以改善 L2 局部性。附录 B.6 还用有上限的首段网格加持久化溢出段,避免在一个循环内一直持有描述符而引起寄存器溢出。
7. 张量核提速后,瓶颈移到哪里
指数单元、TMEM 和通信
一个 128 乘 128 的满分数块有 16,384 次指数计算。论文列出的 B200 和 B300 指数吞吐分别是每 SM 每周期 16 和 32 次,理想发射时间分别为 1024 和 512 周期。这个商只反映一种运算的理想发射周期,不能当作整个内核的实测时间。B200 把一部分指数交给 FMA 上的多项式,缓解专用 MUFU 单元压力。B300 的 MUFU 加倍后,E4M3 路线关闭了这类模拟。论文还在 B300 的全可见 tile 上把 TMEM 读取与行最大值归约合并。
前向对下一块 按 64 个 key 分成两段,夹着当前块的 ,把 softmax 的等待和 MMA 重叠起来。混合 NVFP4 路线还有对数域的概率量化优化。若某组概率权重按二次幂 缩放,则先取指数参数的最大值即可定组尺度,再对每项直接计算缩放后的指数。
这样少一次逐项除法。第 3.5.2 节把这项优化放在 NVFP4 路线讨论,默认混合路线的概率操作数仍是 E4M3。后面推理近似用到的 4 位概率是另一配置。把名称都缩写成 FP4 会掩盖这个差别。
反向使用两个 CTA 协作可以覆盖 256 个 key,但 发出时,BF16 版的累加器布局已经用掉全部 512 列 TMEM。令 为码值,token 块指数在通道上不变,可把 重构成
尺度放到 MMA 外处理,避免再在 TMEM 中放一套尺度操作数。FP16 的 部分和减少归约流量,数据相关放大因子则处理范围。两 CTA 的选择根据格式与形状拟合,确定性调用保留单 CTA。附录 B.5 报告确定性归约使 MHA 慢 5–12%,GQA 慢 20–34%。重复两次能否逐位相同,与改动后缀是否改变前缀,是两个测试目标。
为什么指数的位级近似留在推理
把 拆成整数部分 和小数 ,则 。浮点数用指数字段承载 ,用尾数近似区间内的指数曲线。最简单的插值给出
凸函数 在两个端点之间低于割线。在 处,未平移近似的相对误差约为 。附录 C 的 Mitchell-P 先做偏移居中,再用整数运算防止位字段环绕,随后舍入到 E2M1。粗码表容得下不少小误差,靠近舍入边界的输入仍可能改码。Schraudolph 方案使用平移过的 BF16 近似,实验中每八对指数有五对走近似。平均近似误差小,不能直接推出任意 score 分布下归一后的概率无偏。
论文在真实模型激活中看到 386–1653 nats 的最大行内分数跨度,远大于高斯输入上的 39.6 nats。这解释了为何要检查截断和编码范围。比较位模式环绕阈值时还要看近似函数收到的坐标,先换算底数,确认是否已经减去组最大值。第 4.4 节报告,Schraudolph 路线的 MXFP8 推理调用约加速 1.03–1.17 倍,Mitchell-P 在非因果 packed 形状上有所加速,在因果形状上反而更慢。后者同时改动概率位宽与 V 的对角块处理,无法把全部差别归到近似函数。训练若要用它还得匹配反向重算,论文的实验里这项成本抵消了收益。
8. 先分清测速口径,再看质量
端到端指一次注意力调用
表 1 把量化、前向与反向都计入一次 causal packed 注意力调用,使用 16 个 query 头和 128 的头维。一行是 GQA 16/4,其余是 MHA。论文逐行以最快的受支持基线延迟除以 MXFP8 延迟。MXFP8 在 B200 上的加速为 1.10–1.40 倍,在 B300 上为 1.06–1.42 倍。两个上界均来自 8192 加 224 篇 256-token 文档的形状。
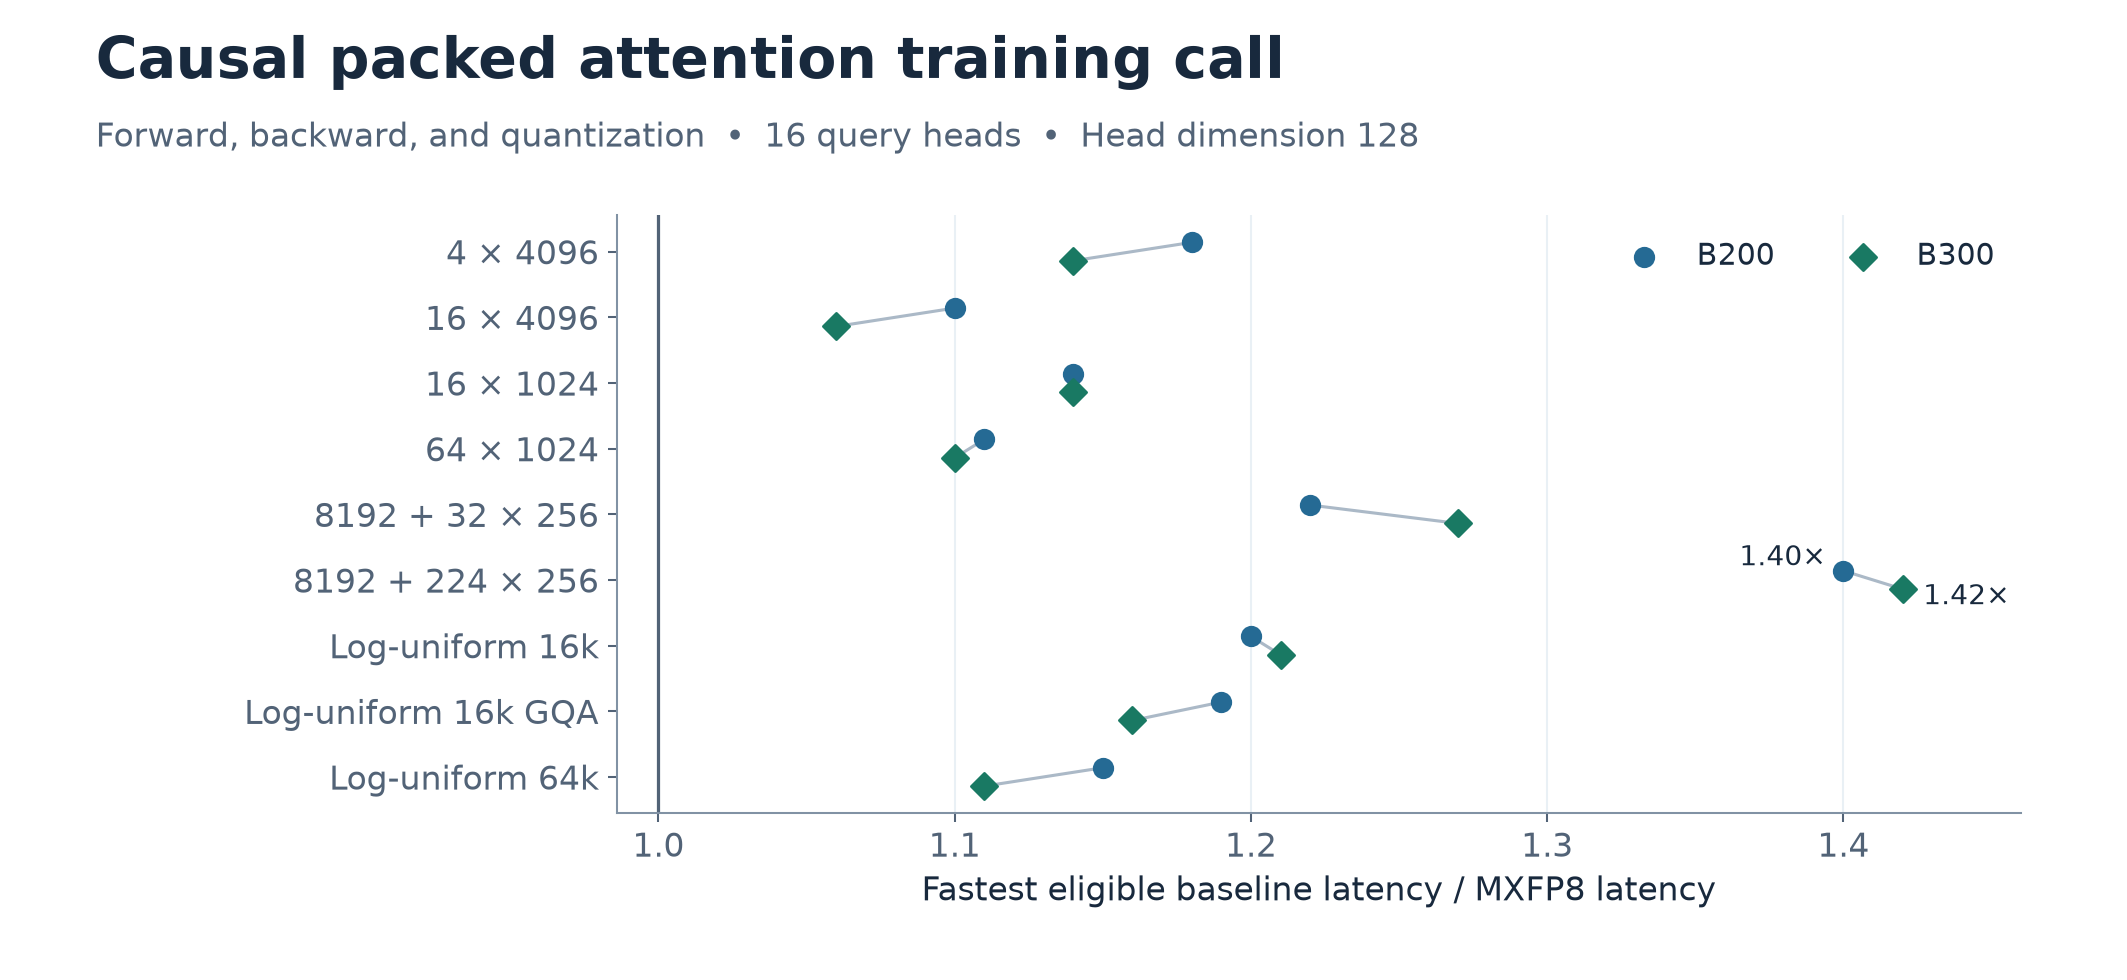
图 6. 按论文表 1 的原始倍率重绘。比较的是含量化的注意力调用,基线随形状而变。
以 B300 的这一形状为例,MXFP8 为 1.67 ms,最快基线 FA4 BF16 为 2.37 ms,复算 。cuDNN FP8 同一行是 2.81 ms,不能拿它替换最快基线。同一张表里,16 篇 4096-token 文档得到 3.17 ms 和 3.35 ms,只约 1.06 倍。B200 上最接近的几组也是均匀长度。这里可能有调度因素,也有有效 pair 数、tile 占用和访存因素。形状不同导致的变化无法只归到文档倾斜度。
测量在预热后做三轮成对计时,取中位数,调用捕获进 CUDA graph。cuDNN FP8 的输入尺度在计时内求出,输出尺度事先在相同数据上校准。有的基线只有 packed 前向,或者缺少相应 causal/GQA 模式,作者将它们放在可用的比较里。前向和反向单独测速时,FLAMIA 用的是 128 对齐文档起点。直接用表 1 减表 2 和表 3,会把不同布局和配置的时间混在一起,算不出干净的量化开销。
附录 H 的非因果 packed 结果中,MXFP8 在 B200 九项都领先,B300 则有小幅落后和按显示精度打平的情形。附录 J 的 batched B300 非因果 2 乘 8192 形状,MXFP8 为 2.17 ms,实时计算输入尺度的 cuDNN FP8 为 1.89 ms。附录 J 跨 30 个形状比较了三种校准策略,中位优势分别为 7.4%、10.3% 和 112%,最后一项包含获取全部新尺度的额外前反向。读这些数字时,先问基线每步真的需要算什么。
为什么全 4 位反向反而慢
第 4.3 节的消融在 4 乘 4096 形状中把 MXFP8 量化前处理从 789 降到 261 微秒,NVFP4 前处理从 640 降到 110 微秒。融合旋转、组统计和写出码,减少了重复读输入的机会。全 4 位的多方向布局则需要额外码副本。作者报告,量化六份副本占其反向时间的 45–52%。混合路径的反向几何平均吞吐为 1329 TFLOP/s,全 4 位为 571,BF16 为 1015。删除指数运算的诊断可以给瓶颈线索,不能计算有效注意力,也不能把该加速拆成可直接相加的百分比。
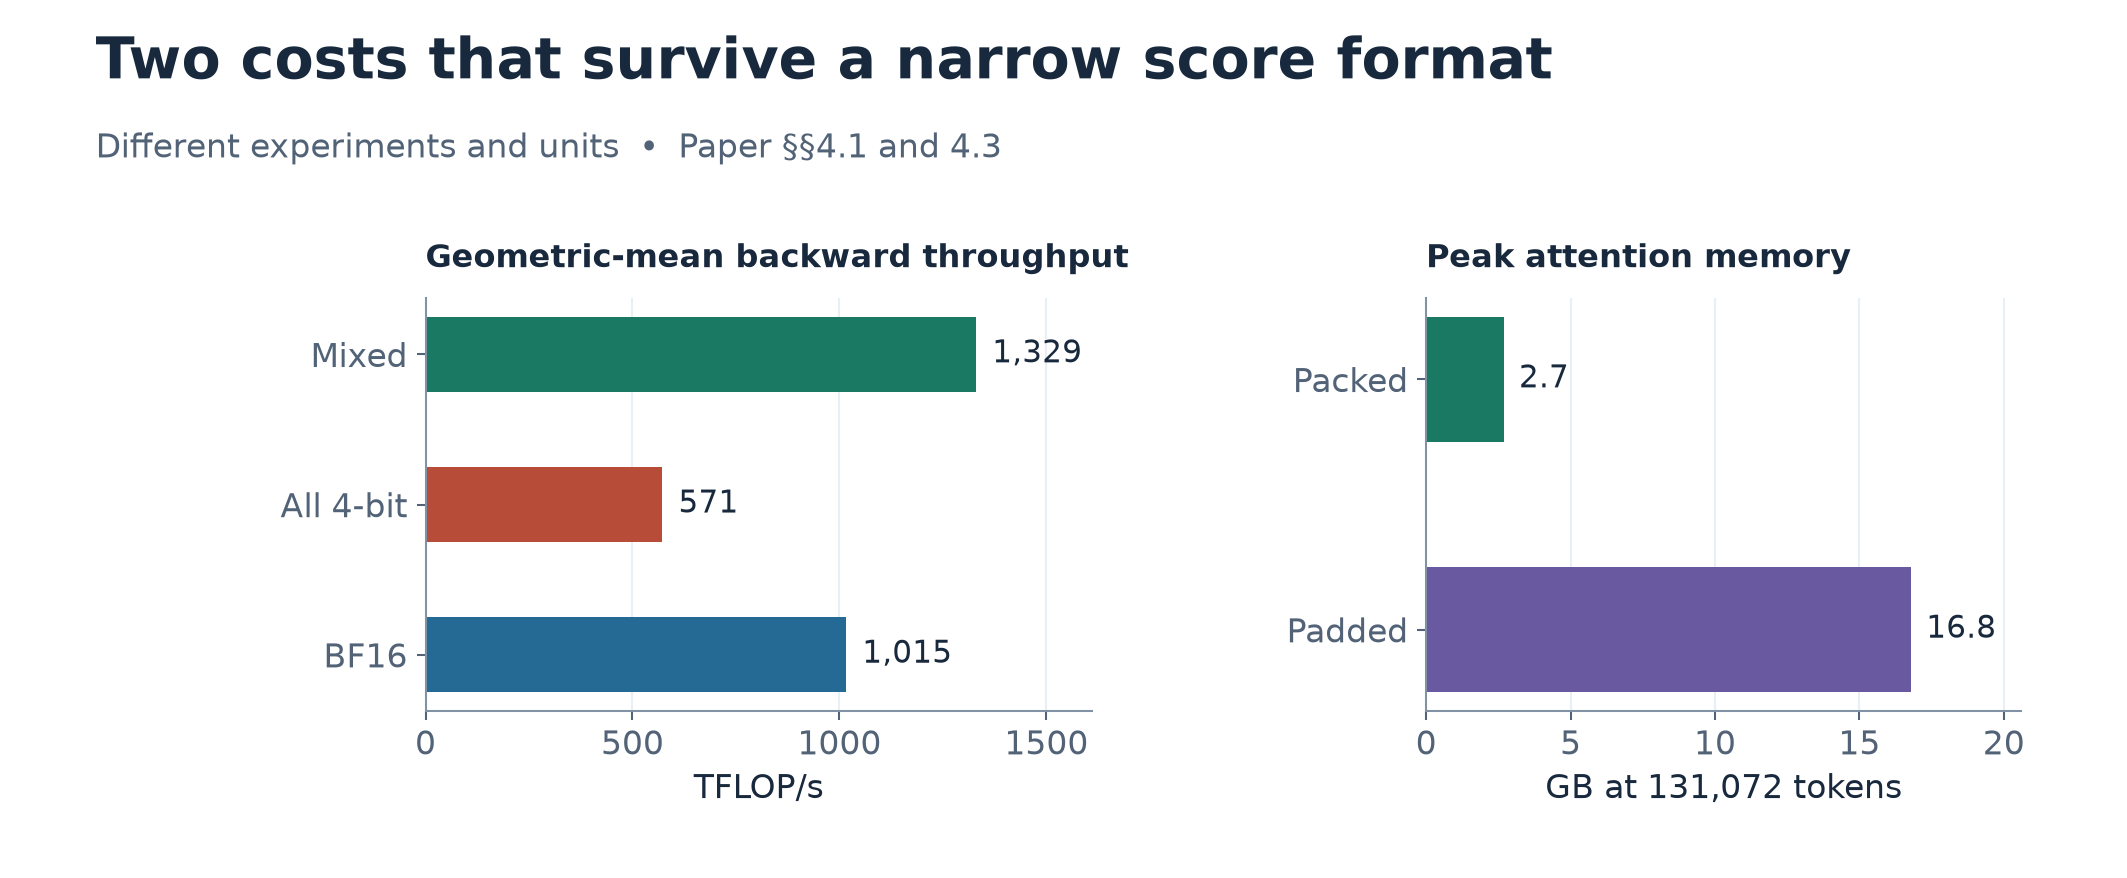
图 7. 依据论文第 4.1 和 4.3 节重绘。左图为反向几何平均吞吐,右图为 131,072 token 的单次注意力峰值显存。两图来自不同实验。
131,072 token 时,论文报告 packed 调用峰值为 2.7 GB,对齐填充缓冲为 16.8 GB,约相差 6.22 倍。这是特定填充方案下单次调用的峰值。单张 B200 训练 1B 模型时,16k 和 64k packed 行分别为 84.6k、96.8k tokens/s,填充时为 68.8k、84.3k tokens/s。这个比较也包括布局变化,不能只归到位宽。若某注意力调用占训练步时间比例 ,加速 倍,其余部分保持原耗时,则理想化整步加速为
例如 、 时约为 1.097 倍。这里的占比是说明性假设。论文表 1 给的是注意力调用的分量,无法推出每个模型的整步加速。
余弦、后缀扰动和长期训练各回答一个问题
表 4 用同一批 BF16 输入与 FP32 参考比较。因果 4 乘 4096 形状的 余弦,MXFP8 是 0.9988/0.9979,混合路径为 0.9920/0.9906,全 4 位为 0.9810/0.9456。这个实验比较一次计算的方向接近程度。表 5 则改动一个未来位置,抬高共享组最大值,读取前面位置的相对变化。严格选项在已测 和 探针里为零,cuDNN MXFP8 的 floor-exp 变体两项都到 0.11,默认 cuDNN MXFP8 则为 和 。这些是选定探针的测量值,不能当作对所有激活的误差上界。
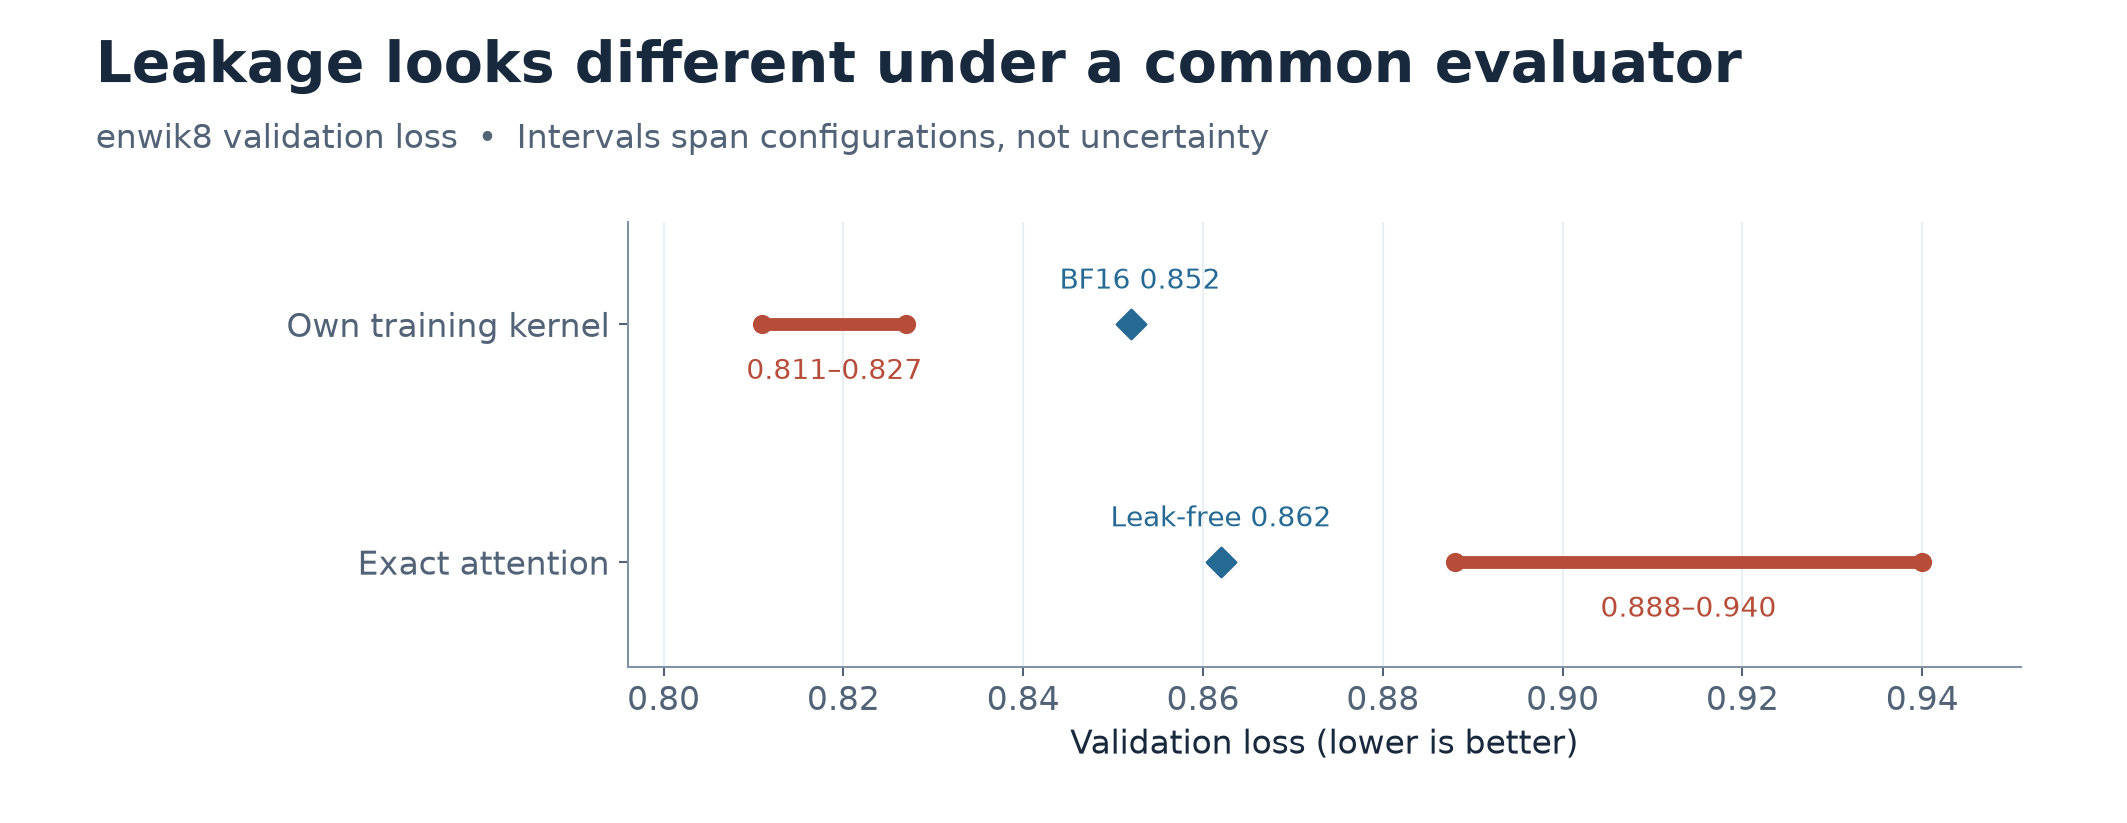
图 8. 按论文第 4.5 节重绘。横线范围来自不同泄漏配置,并非置信区间。两个点分别对应论文的 BF16 与无泄漏训练参照。
在 enwik8 的六层、宽度 1024 实验中,有泄漏的 4 位配置用自己的内核评估,损失 0.811–0.827,低于 BF16 的 0.852。同样权重改用精确注意力时,损失变为 0.888–0.940,高于无泄漏模型的 0.862。论文没有给出两个区间端点的逐模型对应,所以图中没有把它们一一连线。这组实验也解释了为什么统一评估算术很重要。
数值错配是另一类问题。给 和 不同的来梯度表示,论文报告不到 500 步出现发散;仅在前向近似指数,也在约 500 步时发散。把前反向对角处理范围分别设为 256 和 128 个 query 时,尽管单步 余弦仍为 0.945,梯度范数从 0.5 升到 。这不等于所有局部误差都会累积到同一程度。它显示了误差位置和方向的重要性。
改动 尺度的消融中,归零比例从 0.4% 升到 29%,相对 BF16 的验证损失差从 0.0008 扩到 0.049,范数误差却相近。作者报告用 32 乘 32 块内最大幅值定尺度使整次注意力调用增加 9–12% 的开销。这个代价买到更好的动态范围。由于消融同时改变了存活分量的精度,不能仅根据归零比例就判定是哪类分量导致损失变差。
1B 训练要逐项看分数
论文用八张 B300、2k 上下文训练 1B Llama-3 风格模型,数据为约 100B FineWeb-Edu token。附录 G 列出 AdamW、每步全局 token、100,000 步、峰值学习率 、300 步预热后线性衰减。把名义每步 token 数乘上步数,得到约 104.9B,和正文的约 100B 口径相容。训练损失取最后 1000 步均值,下游任务使用最终 checkpoint。
| 指标 | BF16 FA4 | MXFP8 | 混合 NVFP4/FP8 |
|---|---|---|---|
| 训练末段损失 | 2.392 | 2.397 | 2.406 |
| ARC Challenge | 0.3925 | 0.3618 | 0.3677 |
| ARC Easy | 0.6481 | 0.6460 | 0.6557 |
| HellaSwag | 0.5711 | 0.5650 | 0.5610 |
| PIQA | 0.7280 | 0.7323 | 0.7258 |
| WinoGrande | 0.5762 | 0.5635 | 0.5967 |
| 五项均值 | 0.5832 | 0.5737 | 0.5814 |
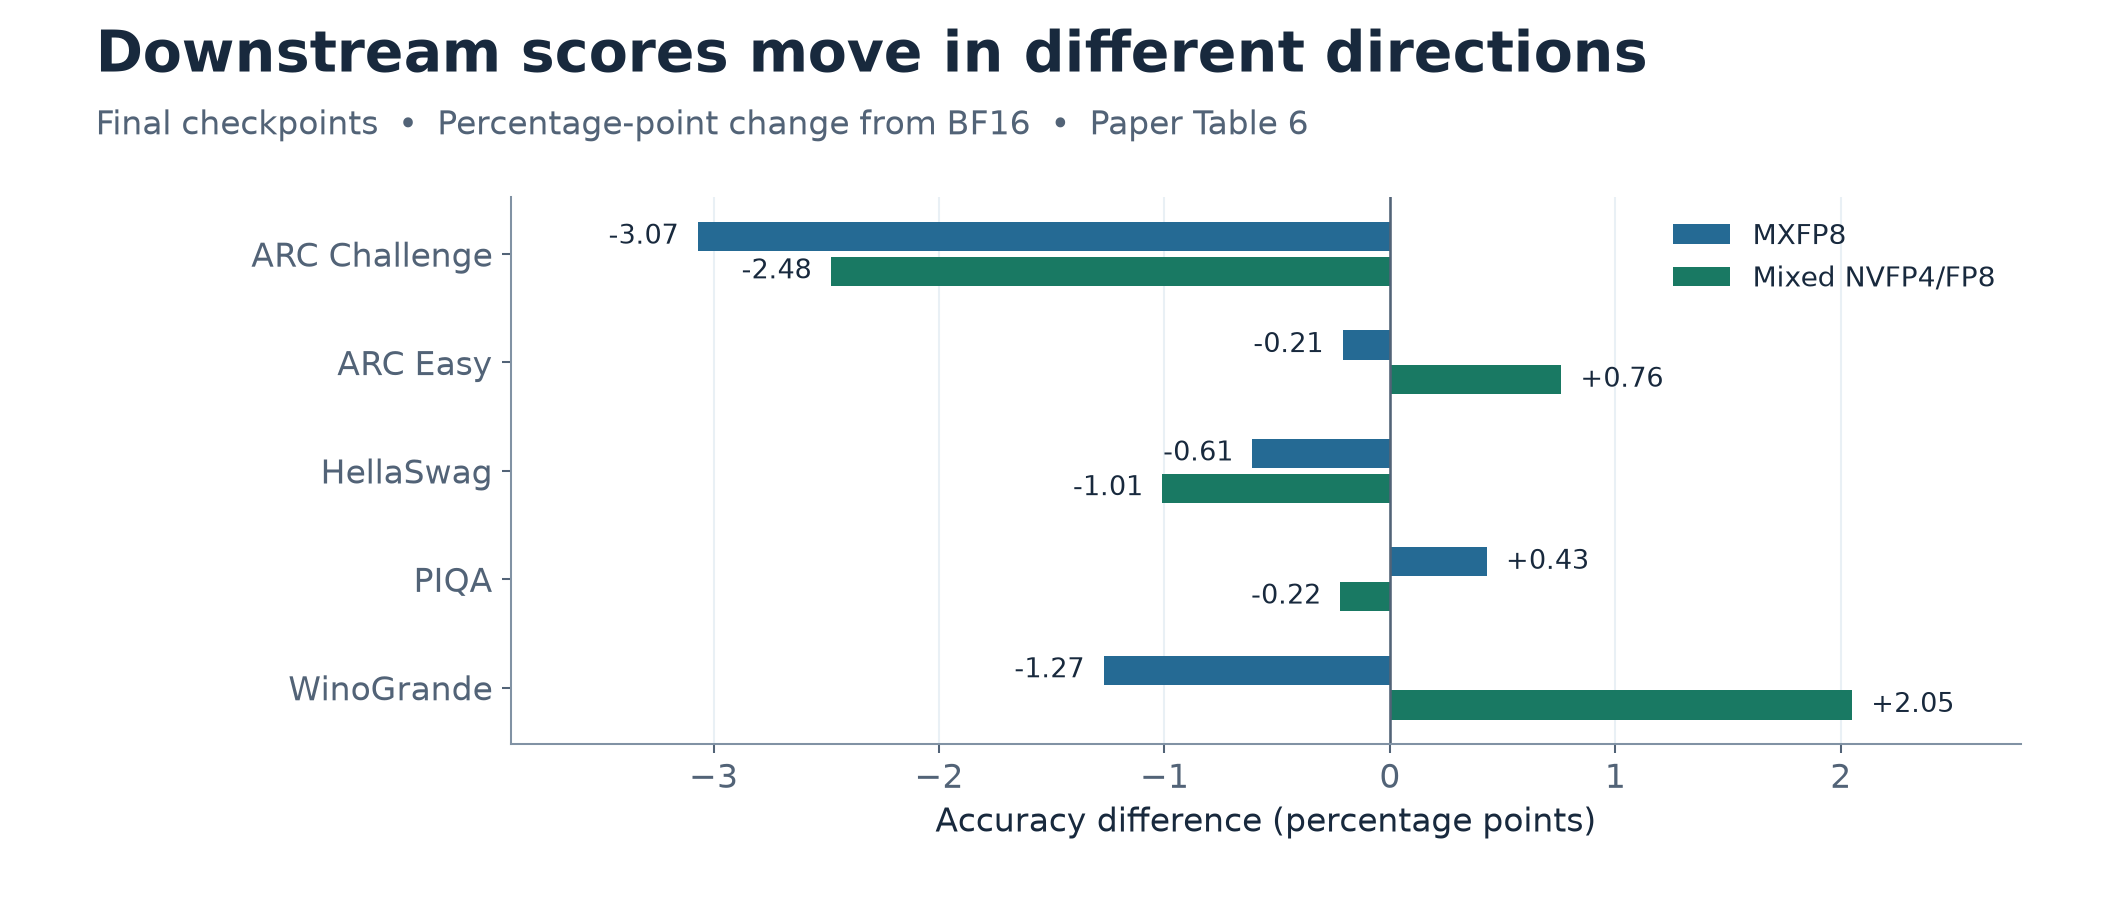
图 9. 按论文表 6 逐项复算百分点差。ARC Challenge 两条路径均下降,WinoGrande 则一降一升。
MXFP8 和混合路线的损失分别多 0.005 和 0.014。混合路线的五项均值只降了 0.18 个百分点,里面有 ARC Challenge 降 2.48 点与 WinoGrande 升 2.05 点的抵消。MXFP8 的均值降 0.95 点,ARC Challenge 降 3.07 点。均值适合做概览,却会压平不同任务的变化。若想说两套训练在质量上等价,还需要种子间波动和预先设定的可接受差值。当前结果支持在论文的训练设置下可行。
9. 复现要点与局限
准备对照时,我会在计时前列出输入布局、行长度分布、头数与头维、mask、GQA 比例、是否预量化、输出尺度的校准方式和 GPU 型号。算吞吐时用一致的可见 pair 数与乘加计数。附录 E 指出,无因果折扣的 FLOP 口径会让长序列 causal 吞吐数字接近翻倍。该附录也报告过 CuTe DSL 版本变化令输出逐位相同、速度却相差约 19–21%。把环境写到表旁,比用一个笼统的 Blackwell 标签更可比。附录 F 说明 TorchTitan 集成、选择性激活检查点和 CUDA graph 捕获。论文提供了官方资源入口。本文的例子、比值和百分点为推导或表格复算,内核与训练测量均来自论文。
因果验证适合用训练中捕获的激活做两组对照:固定输入重复运行,先了解原子归约噪声;再只改未来位置,观察前缀。测试应分别记录输出、固定 时的 、概率行和、 归零率与溢出。验证损失最好再用共同的参考内核评一次。这里同时需要看数据级依赖与数值级偏差,两种检查用的是不同判据。
论文的几个局限与部署场景直接有关。首先,默认 packed 性能测试仍有块内和累加器尺度依赖,严格选项仅覆盖所支持的 batched causal 调用。在 32,768 token 消融中,仅 causal 尺度就增加 8–11% 的反向延迟,以及 6–9% 的整次注意力调用开销。它的代价不能拿来简单修正每一行 packed 数据。其次,B300 batched 和非因果 packed 中存在基线领先的形状,换布局就要重新比较。第三,1B 预训练的 2k 上下文没有直接回答非常长的上下文下是否同样稳定。最后,推理用位级指数的效果取决于概率码和因果边界。表 7 的列名和第 4.4 节讲 Mitchell-P,但余弦说明里写了 Direct-P。笔记引用该范围时以第 4.4 节的明确比较为准。
10. 批判性分析
给 packed 严格因果做一张单独的表
我最想看到的后续结果是同一批 packed 形状同时给出严格因果与默认模式的测量。可先为每篇文档分别做分段前缀最大值,给每行建立局部累加尺度。接着在掩码边界附近处理每个操作数的尺度依赖:Q/K/V 的 per-token 选项、 的行尺度、局部 fold 和 归约都要单独覆盖。只改 V 的对角块无法处理剩余通道。保留完全落在前缀内的高效分组,有机会让额外代价集中到边界。需要重点测极短、起点错位的文档,这类输入会提高边界工作占比。
测试上可造两份只在 query 之后不同的输入,固定来梯度的相应行。分别让后缀值跨过组指数边界、逼近 E4M3 次正规区,并移动文档在物理行里的起点。用不同文档的扰动检验打包隔离,再用同文档的后缀检验因果隔离。确定性路径适合检查逐位不变,默认原子路径需要先记录相同输入的波动。这样的配对能把跨文档污染、前缀泄漏和归约噪声分开,也能说明零变化是在哪些配置和输入族里得到的。
区分梯度尾部和有方向的偏差
组尺度变大,既会让小值变成零,也会让保留值的舍入误差改变。可以在细尺度路径上人为屏蔽一批小项,使归零比例接近粗尺度,尽量保持剩余码不变。再做一个归零比例接近、尺度不同的对照。按层、头、query 位置与注意力熵分组,比较带符号的行和、梯度尾部以及优化器状态。如果只有某些头或边界位置受影响,全局余弦和单一归零率可能都看不出来。
第 5 节的行和残差还提供了一个便宜的诊断方向。先在小规模运行里测 ,再加一个按重构概率直接求 的参考。记录量化 前后残差的分位数,以及反复出现同号误差的行是否也容易出现梯度范数尖峰。这个参考可慢一些,用来拆解误差来源即可。若结果显示一致重算之后仍存在有方向的偏差,再评估额外归约是否值得进入快速路径。
把调度收益与模型训练收益分别归因
表 1 里最大的提升恰好是最倾斜的形状,但它和均匀形状在有效 pair 总数上也有差别。一种更干净的设计是尽量固定 与 ,改变文档顺序、最长项位置和短文档数量,并独立记录列表构建与末段 CTA 空闲时间。再拿相同工作列表去跑 BF16,比较调度优化是否独立于量化格式。若换成 GQA,应另外检查头部归约和 L2 命中率。这样可以解释延迟的下降究竟来自更少的空转,还是计算与访存的变化。
训练方面,可以让 BF16、默认 MXFP8 与严格因果配置共享数据顺序和初始化种子,用统一高精度注意力重评每个 checkpoint,同时保留各自原生内核的评估。对不同上下文长度报告多种子的误差区间,提前指定允许的损失差或分数差。enwik8 的例子表明,一旦训练时的信息依赖发生变化,只用各自的评估内核会把这种变化混进指标本身。统一评估更容易看出差异发生在训练轨迹还是评估算术。
11. 结论
FLAMIA 最值得记住的是尺度几何的双重作用。把二次幂指数共享到一个 token 块,可以让 E4M3 码跨乘法方向复用,也让一些尺度乘法移到 MMA 外。与此同时,指数由哪些位置共同决定,决定了一个未来扰动能沿哪条路径传播。对角块的 per-key fold 和按前缀定 放大因子,都是沿着这条依赖逐步处理得到的。
含量化的 packed 延迟、后缀扰动探针和长期训练指标各自补上了一块证据。论文报告的默认 MXFP8 优势来自具体的 packed 工作负载。严格前缀不变性需要附加选项和单独的适用范围。比较下一篇低精度注意力论文时,这两个条件都值得和倍率一起记下来。