笔记日期: 2026-11-07
作者: Zhongzhu Zhou
阅读论文: Low-Rank Key Value Attention
论文作者: James O’Neill、Robert Clancy、Mariia Matskevichus、Fergal Reid
arXiv: 2601.11471,v3,2026-04-07
1. 每个头究竟要存多少自己的东西
读这篇论文时,我先把「头之间有冗余」具体化。同一层的多个注意力头面对的是同一个 token 隐状态。它们可能都需要知道某个词是不是括号或缩进,也各有不同的匹配任务。独立的键和值投影允许所有头自由学习,但要在缓存里把这些投影的输出逐头存一份。把投影彻底共用,字节数降下来了,逐头差异只能更多地由查询、输出投影及其他层承担。LRKV 在这两种设计之间加了一个可以调的量。
做法是先给每层一套共享的键投影和一套共享的值投影,再给每个头一对低秩修正。这里的「低秩」限制了每个头能偏离公共投影的方式。给某个头的残差留出五十多个坐标,并不意味着整个头的键也只有五十多维。共享部分仍然有完整的输出宽度。缓存中每个位置也仍然对应原来的 token,没有因为压缩而被合并或淘汰。
论文在四个规模上比较了多头、分组查询、多查询、MLA 和 LRKV。给定各自选中的配置,LRKV 在最终损失表里占优,作者报告的缓存约为多头基线的一半。选择更激进的 GQA 或 MLA 时,缓存还能进一步缩小。哪一种更合适取决于损失、容量和实际解码延迟三者。本笔记把公式能推出的节省、论文中实测或统计的结果,以及仍待验证的系统收益分别记下。
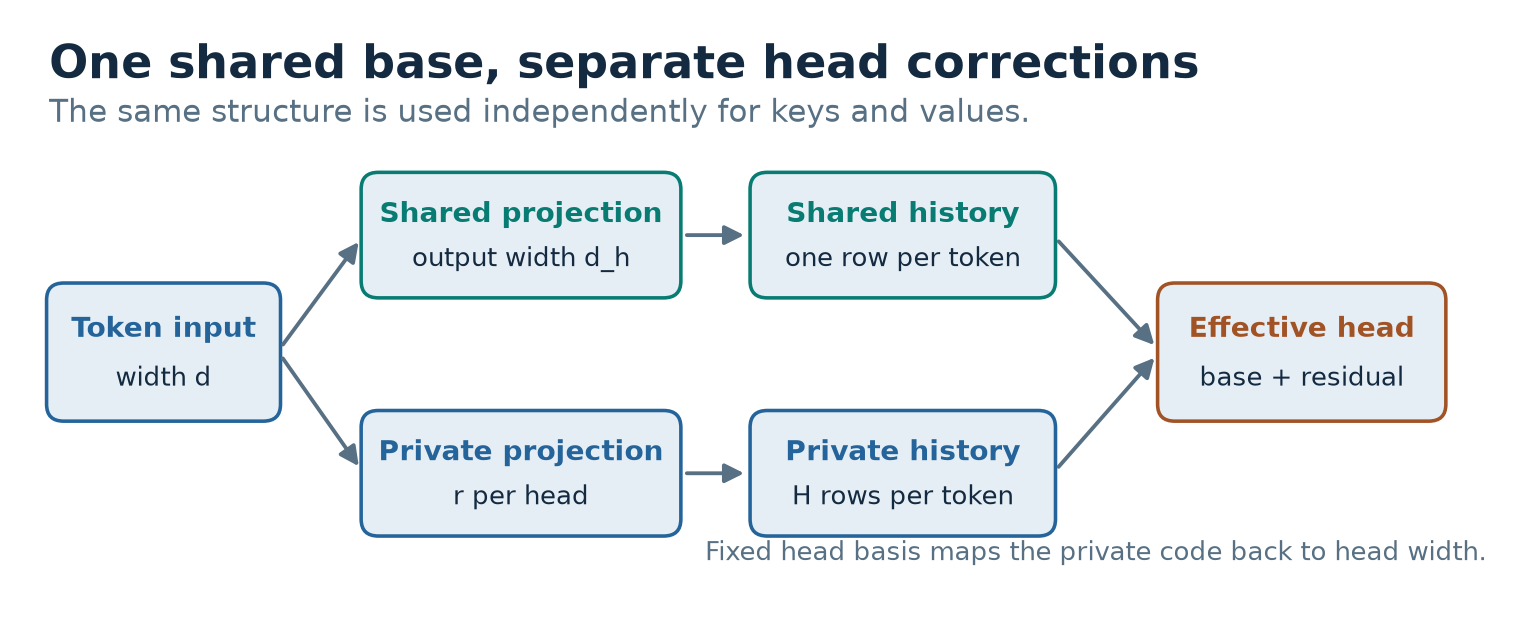
图 1. 根据论文图 1 和式 2–5 自绘。对每个 token,宽的公共特征只存一份,窄的私有坐标分别存。把私有坐标还原成头宽的矩阵属于模型参数。
2. 前置知识
一次注意力有两种乘法
设一层输入为 ,每行对应一个位置。某个头的键和值各是 ,当前查询 是一行。头用查询去比较每个键,取出一组权重,再加权求和值。因果掩码 在可见位置取零,在不可见位置取负无穷。对单个查询可以把三步分别写出。
第一步算的是「去哪里找」,第三步算的是「把什么带回来」。中间的 softmax 同时看整段历史。它会让两个看起来相似的实现得到不同的结果。设两个分支给出分数 和 。先相加再归一化,两个位置各得一半。分别归一化时,一个分支偏左,另一个偏右。若再各自读取不同的值,通常得不到同一个输出。后面写伪代码时,两个分支必须在 softmax 之前会合,读值时则必须使用同一份权重。
缩放中的 是原始键的宽度。分支计算出来的总分等同于完整的内积,所以无论私有分支的宽度是多少,除数都用原来的 。如果把私有分支换成 ,实际上改变了两部分在路由时的相对权重。
缓存到底占多少
解码时,因果性保证过去 token 的键和值不依赖新 token。每步只需产生新的一行,并访问已有的历史。预填充一次处理输入,建立第一批缓存。设层数为 、请求数为 、等长历史长度为 ,一个缓存元素占 字节。独立多头注意力的有效载荷为
前面的二来自键和值。请求长度不一时,可以先用各请求实际 token 数之和替换 ,再单列分页尾部的空槽。对显存容量来说,权重、临时工作区、缓存页和其他请求共同争抢空间。对解码耗时来说,关键是这些字节是否每步都要从设备内存读取。一个张量在显存中只存一份,并不保证多个头读它时只产生一次物理搬运。
训练还要另外考虑反向传播所需的激活、优化器状态和矩阵乘工作区。论文第 3 节的训练路径会形成完整逐头 K/V。后文推导的压缩率是解码缓存预算,不能直接拿去估算训练显存。
残差低秩,基底可以满秩
将一个矩阵写成 ,中间只经过 个坐标,因此秩至多为 。矩阵若独自承担头的全部功能,会让所有输出都落在这个小子空间。LRKV 把这个乘积加到一个稠密矩阵上,限制的是每个头相对公共基底的变化。随着 增长,私有输出能沿更多方向偏离。到 时,给定任意公共基底,也能表达任意逐头投影。此时继续保留一份公共缓存会增加存储开销。
这一点和昨天的截断 SVD 主题有关。固定一个公共矩阵,给定一个已经训练好的目标头,截断目标残差的 SVD 可以最小化 Frobenius 重建误差,平方误差等于被扔掉的奇异值平方之和。论文实际从头训练公共基底和私有因子,并让查询、其他层一起适应。两种方法的优化目标不同。矩阵范数的误差会被输入分布、注意力权重以及下游层重新加权,不能直接当成语言模型损失。
3. 训练和缓存布局
先投影出坐标,再决定何时还原
对键和值分别应用同一个结构。记 为任一公共投影, 的形状为 , 的形状为 。把论文式 2–5 连在一起写,可以看清缓存的是哪两个中间量。
把一个 token 的隐状态送进公共路径,得到 维的行向量。送进逐头路径,先得到 维的行向量。如果只为了把完整键写到缓存里,下一步会把 维扩回头宽并与公共项相加。LRKV 把这一步推迟到使用时,甚至可以只在矩阵乘的另外一侧做投影。查询的投影仍按头独立,它的状态无需为未来 token 保存。
论文用小随机值初始化残差因子。原因可以从梯度看出来。若某一头有效投影的损失梯度为 ,把变化量按三条路径展开,分别收集 、、 的系数。
公共矩阵能收到所有头的学习信号。两个残差因子如果一开始都为零,对它们的梯度也会同时为零。小随机初始化允许模型从接近多查询的结构起步,然后逐渐让私有路径承担工作。单一基底省空间,如果头自然分成几个需求相差很大的组,给每组一个基底也有道理。它的代价是存多份公共特征,收益则要看私有秩能否相应下降。
算法 1. 建立或追加因子缓存
这是从论文第 3 节整理的线性投影版伪代码。预填充和逐 token 追加走同一套投影。实际的位置编码及归一化规则留到后面单独推导。
01  Receive new rows X and their token positions.
02  Compute shared S_K = X W_S_K and S_V = X W_S_V.
03  Append both shared blocks at the token positions.
04  For each query head h, compute R_K[h] = X U_K[h].
05  Compute R_V[h] = X U_V[h] for the same head.
06  Append both private blocks at matching positions.
07  Keep B_K[h] and B_V[h] as layer weights.
08  Track sequence boundaries for the causal mask.
键和值的基底及私有因子彼此独立,省下的是同一层内多个头的重复宽坐标。缓存仍沿着时间维线性变长。若服务端用分页分配,共享页和逐头私有页应使用相同的 token 编号和回收生命周期。否则复用前缀或释放请求时,很容易让一个位置的两条路径指向不同历史。
把扩张从整段历史挪到当前查询
把完整键转置后插入打分式。先拆出公共项,再把和私有基底相乘的次序调一下。维度上,左边结果是一整行历史分数,右边两项也是相同长度的行向量。
这一变形对应论文式 6。关键是 对整个历史只算一次。得到所有分数后,再加掩码并归一化。值端的方向相反。先把整段历史归约为一个私有向量,再扩回输出宽度,对应论文式 7。
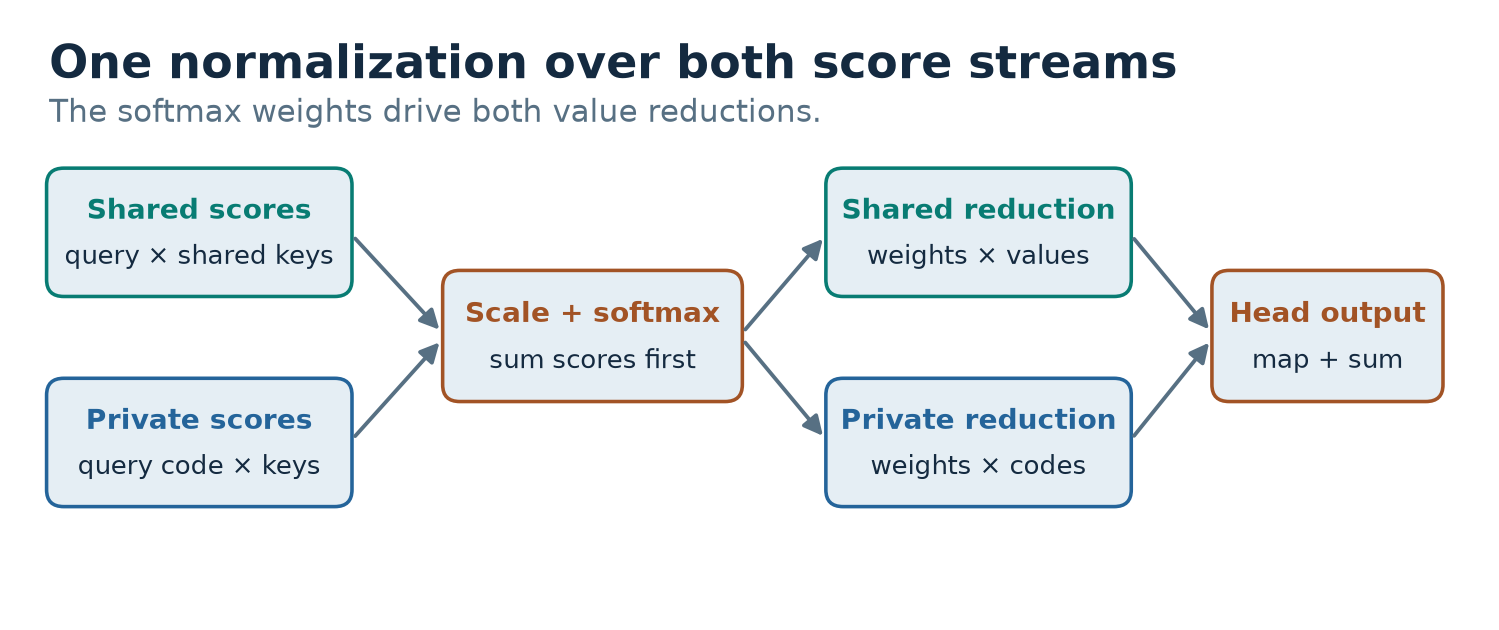
图 2. 根据论文式 6–7 自绘。两个分数贡献先合并,得到一份位置权重。值的公共和私有分支复用这份权重。
算法 2. 从因子缓存解码
以下按单查询头写出。从数学上看,它等价于先还原再计算同一个线性注意力。低精度计算会受舍入和加法顺序影响,数值核对可以使用高精度参照。
01  Project query q for the current token and head h.
02  Form private query p = q B_K[h] once.
03  For every visible row j, form the shared dot product.
04  Add dot(p, R_K[h,j]) to that shared score.
05  Scale by sqrt(head width) and apply the mask.
06  Compute one softmax over the visible positions.
07  Reduce S_V and R_V[h] with the same weights.
08  Multiply the private reduction by transpose(B_V[h]).
09  Add both results, concatenate the heads and project out.
如果把读取、打分和 softmax 融合到一个分块计算里,每处理一块都要维护到目前为止的最大分数、指数和、公共值累加器和私有值累加器。当最大值被后来的一块改写,两个值累加器和旧的指数和都按相同系数缩放。处理完历史,再统一除以指数和。这个版本能避免保存整条分数向量,但每个头的累加器多了 个坐标。为了共用缓存而把更多头安排在同一个计算块里时,寄存器压力可能成为新的约束。
拿两维例子手算。当前查询是 ,公共键是 ,私有坐标为 ,还原列是 。完整键为 ,内积为 。分开算时公共分数为 ,投影后的私有查询为 ,两项相加也得 。值端若有两个位置,权重为 和 ,对应私有坐标为 和 ,则先得到加权坐标 ,再一次性还原为 。这里演示的是结合律,没有引入近似。
4. 用预算反推私有秩
一个位置要留下几组坐标
对键和值分别计数。公共路径存 个元素,每个头再存 个元素。跨请求、层和位置把这些数乘起来,再除以 MHA 的存储量。若希望最多使用比例 的缓存,把不等式移项并向下取整即可。
这个式子给出了两个不同的缩放方向。头数越多,公共路径的占比越低。私有秩每涨一维,缓存占比始终加 。例如 18 头、头宽 128,若要把缓存控制在一半以内,秩至多为 56。论文表 7 给出 ,按式 9 得到 48.52%。如果内核对齐使物理存储宽度取到 64,占比变为 55.56%。配置文件里的逻辑秩和真正分配的宽度应分别记录。
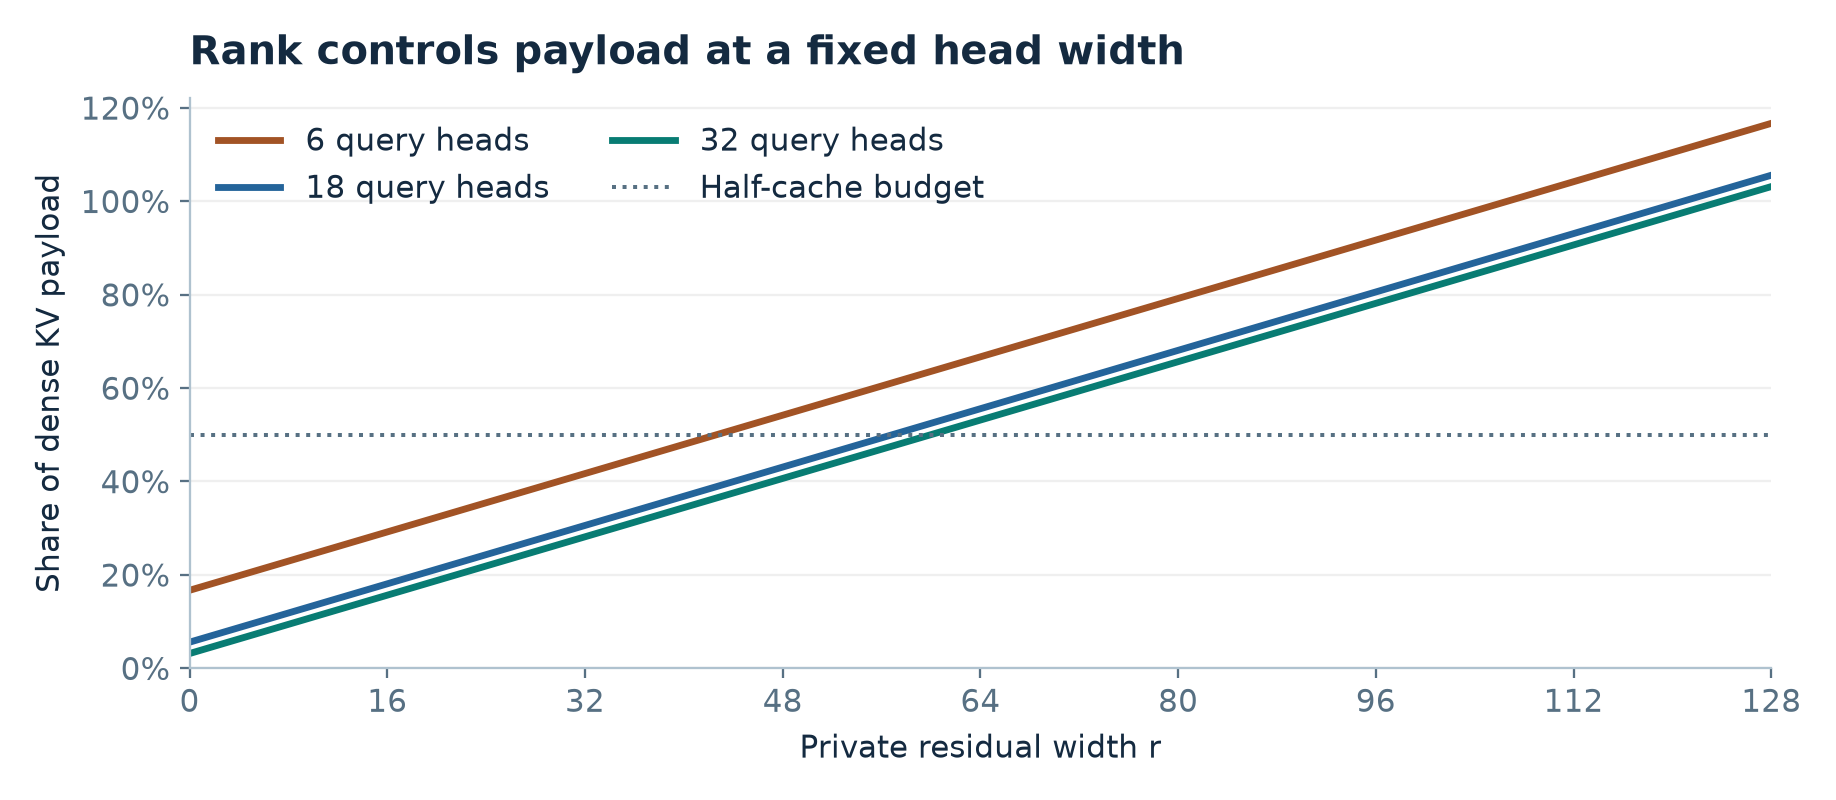
图 3. 根据论文式 9 自绘。头宽固定为 128,三条线斜率相同。头数只改变共享项的截距。点线标出与 MHA 一半有效载荷对应的预算。
用论文表 5 给出的 2.5B 参考结构做一个具体预算。18 层、18 头、头宽 128,BF16,单请求 2,048 个位置。MHA 的键值元素数为 ,每元素两字节,合 324 MiB。按 存储,计算值为 157.21875 MiB。把序列长度扩大到 8,192,分别是 1,296 和 628.875 MiB。它们是用指定层数与宽度直接算出的有效载荷,未计页对齐、位置附加量和临时缓冲。后面会与附录 G 的字节表对照。
GQA 的预算是按组数走的。以六组十八头为例,键值缓存是密集基线的三分之一。想让 LRKV 也落到这个占比,秩至多为 35。这样就进入和主配置不同的质量点。做选型时,可以先用容量目标确定可选区间,再去读该区间的实验结果。拿一个接近半缓存的点与三分之一缓存的 GQA 直接比较,只能回答那两个具体点之间的取舍。
参数成本和访问成本分开看
对单层两套 K/V 投影,稠密基线共有 个参数。LRKV 的公共部分占 ,每个头的私有因子共占 。将两部分相加并归一化,有
18 头、、 时,这个比例约为 50.9%。注意它只覆盖 K/V 投影。查询、输出投影、前馈层和词嵌入都不在分母里。论文沿用 MHA 参考结构的规模名,因此几个标为同规模的模型可以有不同的参数量。保持骨干不变而只换注意力模块,可以看设计替换的效果。若要研究参数利用率,则还要补实际参数量匹配的比较。
再看一次解码。忽略掩码和 softmax 等共同项,MHA 每头对历史做一次宽度 的打分、一次同宽的读值,约有 次乘加。LRKV 还多两次宽度 的历史扫描,以及两次大小为 的基底变换。简化后的算术比为
上下文很长时, 会变小,私有历史扫描的 仍在。假如瓶颈在显存带宽,并且同一份公共 tile 能被多个头复用,读取量可能下降。假如每个头各自把公共块从显存读一遍,光公共路径就可能花掉和原来一样的流量。如果硬件受算力或寄存器限制,额外的私有归约也会推迟收益出现。附录报告的张量字节数回答了容量问题。吞吐和尾延迟要由匹配的内核实测回答。
张量并行会在多少张卡上复制共享项
前面的公式将一个公共块只计一次。单卡正好对应这个假设。现在假设查询头平均分到 张卡,每张卡上的头都需要读完整公共特征,并在本地保留副本。私有缓存仍是每个头一份,公共缓存则会在全机计 次。与同样按头切分的 MHA 比较,键和值的公共系数一起约掉,总载荷比例变成
举一个便于整除的例子。32 个头、头宽 128、秩 54,四张卡每张处理八个头。如果全机只有一个公共块,计算值约 45.3%。四张卡各存一份,比例变为 54.7%。每卡内部仍然能让八个头共用一份,节省依然存在。这里比较的是总字节数,均匀分配时也能解释每卡本地预算。若只在一张卡保留公共块,其他卡每步需要跨卡搬运或采用不同的注意力分片方案。上下文一长,搬运按历史长度增长,机内链路和显存带宽的关系会影响取舍。
追加新 token 时,若每卡已有相同的输入激活,可以本地计算公共投影。这样用重复计算交换通信。如果输入激活本身也分片,共享投影的输入和输出都可能要通信。实现对比时,需要同时标明权重切法、缓存切法和设备间传输量。GQA 的组与设备切分不整齐时也可能复制 KV 头。MLA 共享潜变量时面临类似问题。所以单卡的缓存比例只能作为起点,多卡还需要指定数据布局。
何时节省的字节能抵过多做的乘法
可以用一个粗略的下界帮助选测试点。令 为密集解码每步实际读取的字节数, 为相应运算量, 为有效带宽, 为有效算力。忽略启动开销、访存延迟及其与计算的重叠,完成同一批工作的时间至少要覆盖两项中的较大者。如果 LRKV 的公共块完全复用,访存项理想上按缓存比 缩小,算术项按前面算出的比例 放大。
当密集基线受带宽限制,若放大后的计算项 已经超过基线的访存项 ,仅靠降低缓存载荷无法改善这个估算。以头宽 128、秩 55 的长上下文为例, 较小时算术倍率趋近 1.43。若原本已经接近算力与带宽平衡处,额外计算足以吞掉不少收益。反之,低批量或长历史下若显存流量远大于算术成本,才更可能看到公共缓存复用的优势。
这个简化模型也给出了性能计数器的用法。先看物理读流量是否随有效载荷下降,再看算力和占用率是否同时改变,最后将内核耗时与整体每 token 耗时分开。若流量没有降到预期,可以检查同一公共块是否在多个头或多个计算块间重复读取。若流量降了而耗时未降,优先检查私有累加器占用和较小矩阵的利用率。这些是可验证的分支假设,论文的元素计数本身只能决定其中的容量上限。
5. 实验结果要按各自口径读
预训练的四个主规模
论文使用 FineWeb-Edu,在一台八卡 H200 机器上做 BF16 预训练。主实验上下文是 2,048,128M 配 100B 训练 token,其他三个规模配 50B。附录 D 给出有效批量 32,768 token,优化器采用 Muon 与 AdamW 分工。各注意力变体保留其他骨干设置,因此结果首先回答在这套数据和优化条件下替换注意力模块会怎样。
交叉熵按 token 做平均,BPB 把同一总负对数似然换算成每个文本字节的比特数。一个常见误读是把两列当成单纯的底数转换。两者还差了文本字节数和 token 数之比。若负对数按自然对数计,关系为
下表摘录论文表 1 的最终交叉熵。正文重点描述 128M 和 2.5B,而这张最终表的四列最低值都来自 LRKV。比较时我以表中显示的单元格为准。
| 注意力 | 128M | 1.2B | 2.5B | 6.3B |
|---|---|---|---|---|
| MHA | 2.903 | 2.530 | 2.389 | 2.319 |
| GQA | 2.918 | 2.536 | 2.397 | 2.354 |
| MQA | 2.929 | 2.573 | 2.408 | 2.304 |
| MLA | 2.901 | 2.564 | 2.392 | 2.377 |
| LRKV | 2.893 | 2.509 | 2.376 | 2.288 |
在 2.5B,LRKV 和 MHA 的绝对差是 0.013,约为基线的 0.54%。BPB 分别为 0.719 和 0.723。到了 6.3B,最接近 LRKV 的表中基线是 MQA,交叉熵仍相差 0.016。观察到多个规模方向一致有说服力,但表里每个配置只有一个结果,差值对随机种子和训练配方的敏感度还无法估计。
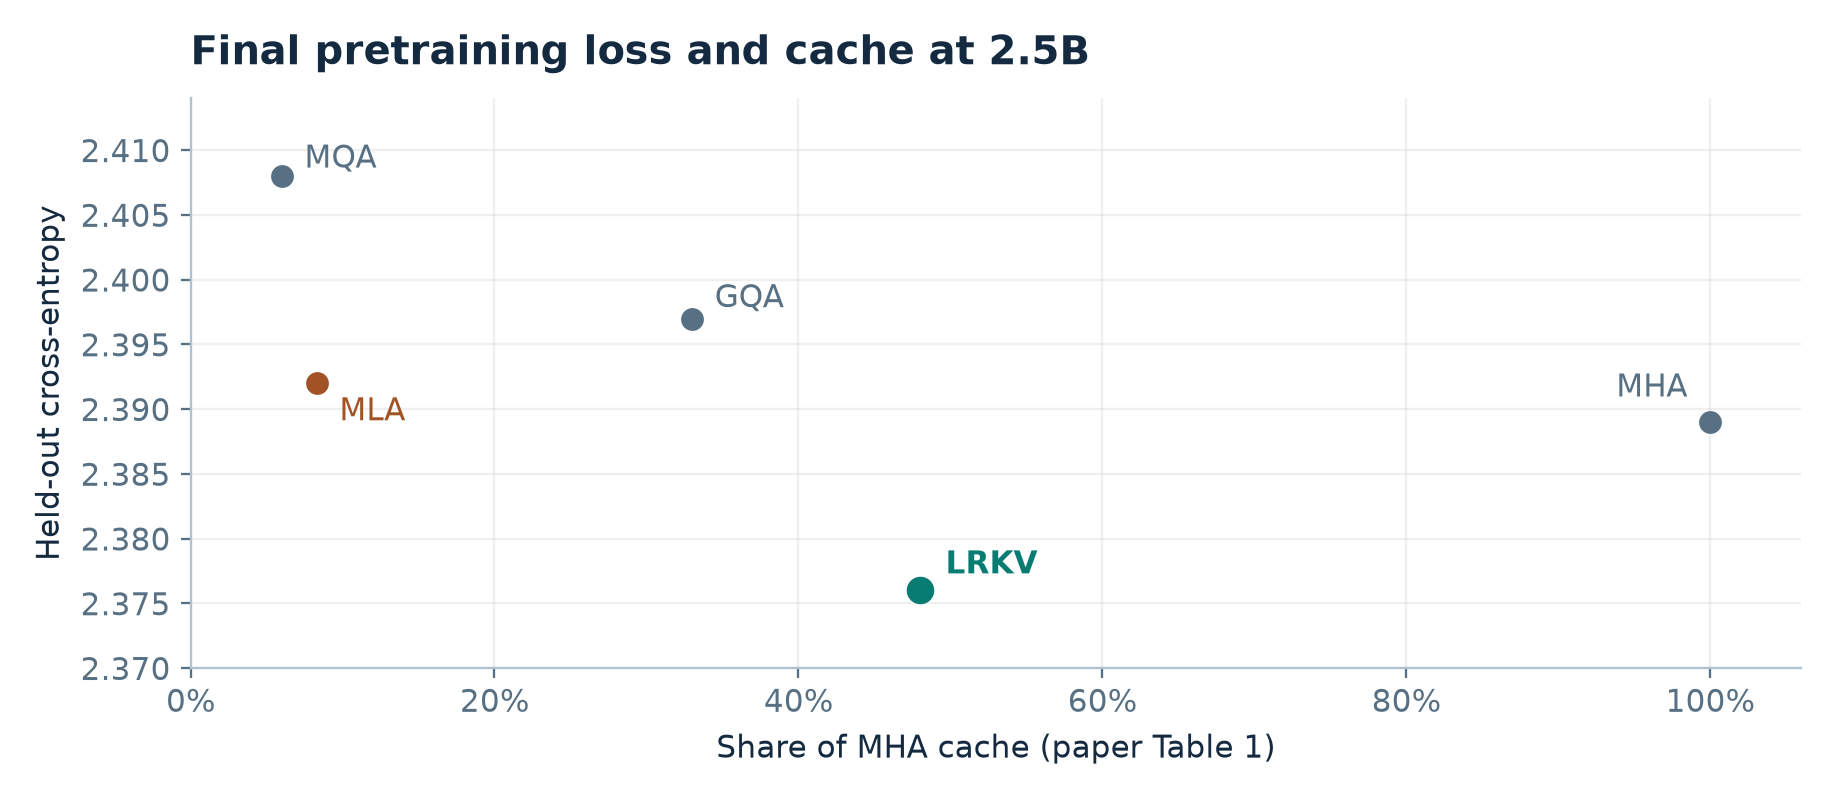
图 4. 据论文表 1 重绘。横轴是表中标注的相对有效载荷,纵轴是最终交叉熵。相较 MHA,LRKV 同时向左和向下移动。更小的缓存预算下仍有其他候选。
更早达标指多少训练步
论文图 3 的做法是把每个基线最终到达的损失当成一条水平线,再看 LRKV 曲线什么时候穿过它。针对 MQA、MLA、GQA、MHA,图里分别标为 29.7%、21.4%、24.5%、18.7%,四个展示值的平均是 23.575%。每条水平线的难度不同。这个平均可以描述同一条曲线的总体位置,不能直接当作固定工作量下的硬件加速。论文脚注也明确指出,训练会形成完整 K/V,优势是用较少训练步达到目标。
我更关注对 MHA 目标的 18.7%,因为它把问题固定在一个能识别的参考点。如果要重做这项实验,应在看曲线之前选定损失阈值,再记录插值规则、实际训练 token 和加速器时数。否则评估间隔不同也会影响对首次过线时刻的判断。改变训练内核或批量后,步数与真实耗时的关系还会再变。
秩越大,省下的空间越少
128M 的表 8 在 100B token 预算下扫描秩 8、16、32、64、128。随着秩增大,报告的交叉熵单调下降。从 的 2.908,到 的 2.896,再到 的 2.888。最高秩时损失最低,只有 2.877,但缓存达到 MHA 的 116.7%。因此「模型最强的秩」和「指定显存里能用的秩」要分开选。
表 8 中 MLA 潜宽 384 的交叉熵为 2.894,BPB 为 0.875,表列缓存为 25%。LRKV 秩 64 的交叉熵为 2.888,显示 BPB 同为 0.875,缓存为 66.7%。哪条路径在解码里更快,仍要考虑两者如何吸收投影、是否含位置相关通道,以及共享载入能否融入内核。仅看这一组点,已经能排除「所有 LRKV 配置在容量和损失上都优于所有 MLA 配置」的读法。
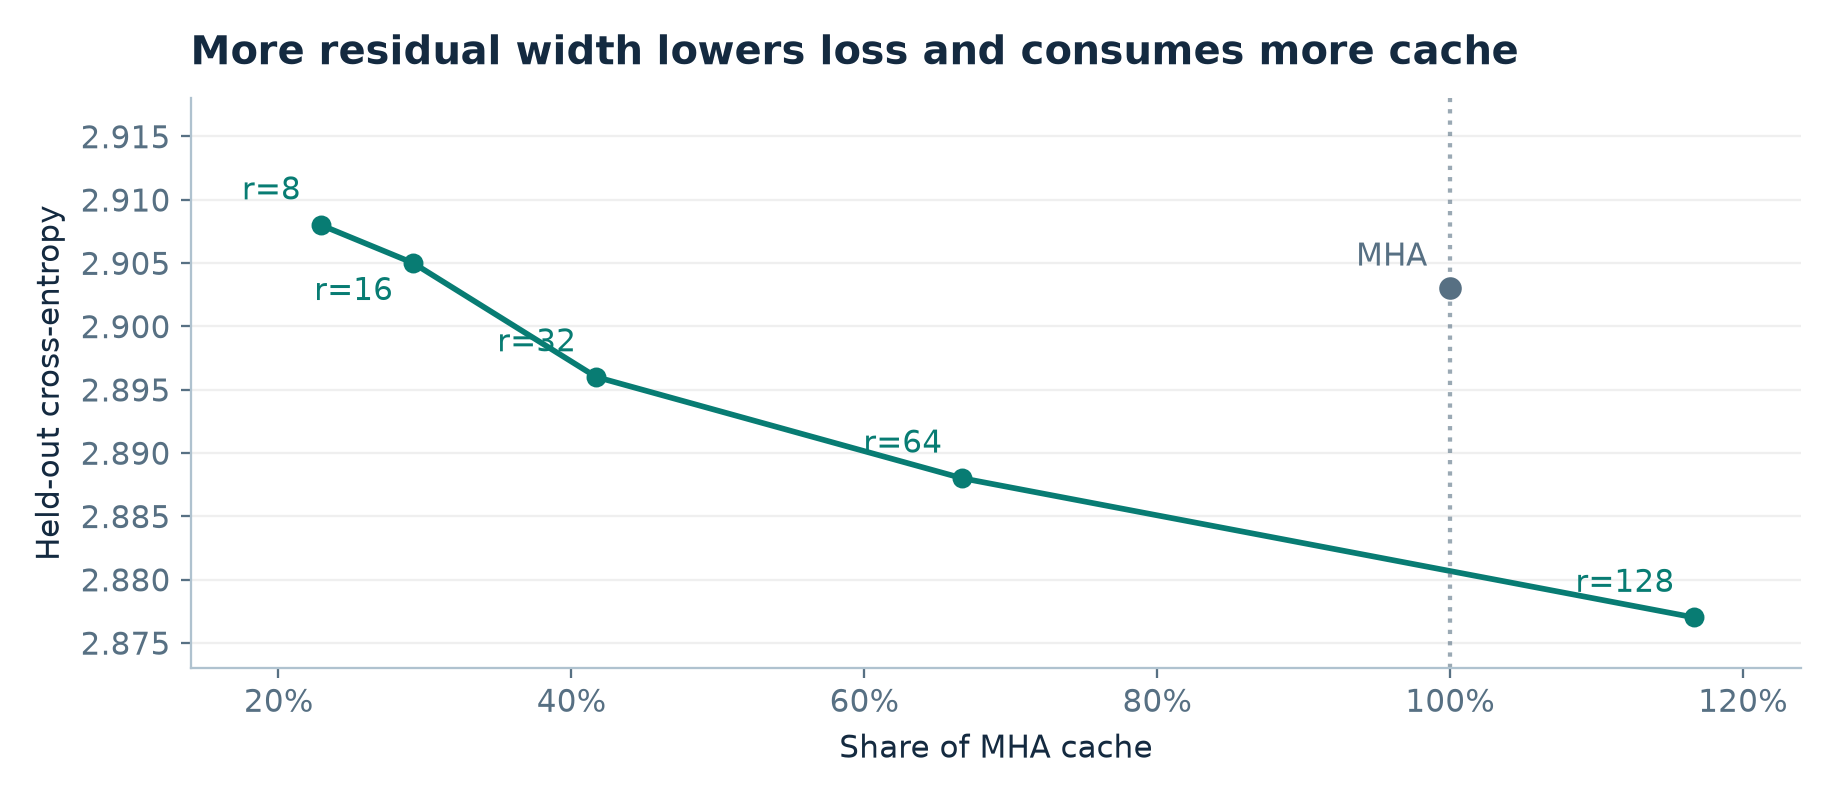
图 5. 根据论文表 8 重绘,连线仅用于阅读五个已测 LRKV 点。秩增大后,容量曲线可以穿过 MHA 的存储上限。
中期训练后的分数和 8K 结果
附录 D 的中期训练将约 46 万 SmolTalk 样本、10 万 MMLU 辅助训练样本和 8 千 GSM8K 样本混合,监督训练一个 epoch。表 2 把 ARC-Easy、ARC-Challenge、MMLU、GSM8K 和 HumanEval 等权平均。2.5B 规模的 LRKV 为 37.9%,MHA 为 35.3%,MLA 为 36.9%。展开到题目类型,ARC-Challenge 从 47.1 升到 53.8,HumanEval 却从 13.4 降到 11.7。6.3B 的 HumanEval 同样由 MHA 领先。128M 的 LRKV 在 GSM8K 只有 0.3,低于 MHA 的 1.0。汇总分数适合看大致方向,遇到代码或数学任务的具体需求,仍要回到逐项结果。
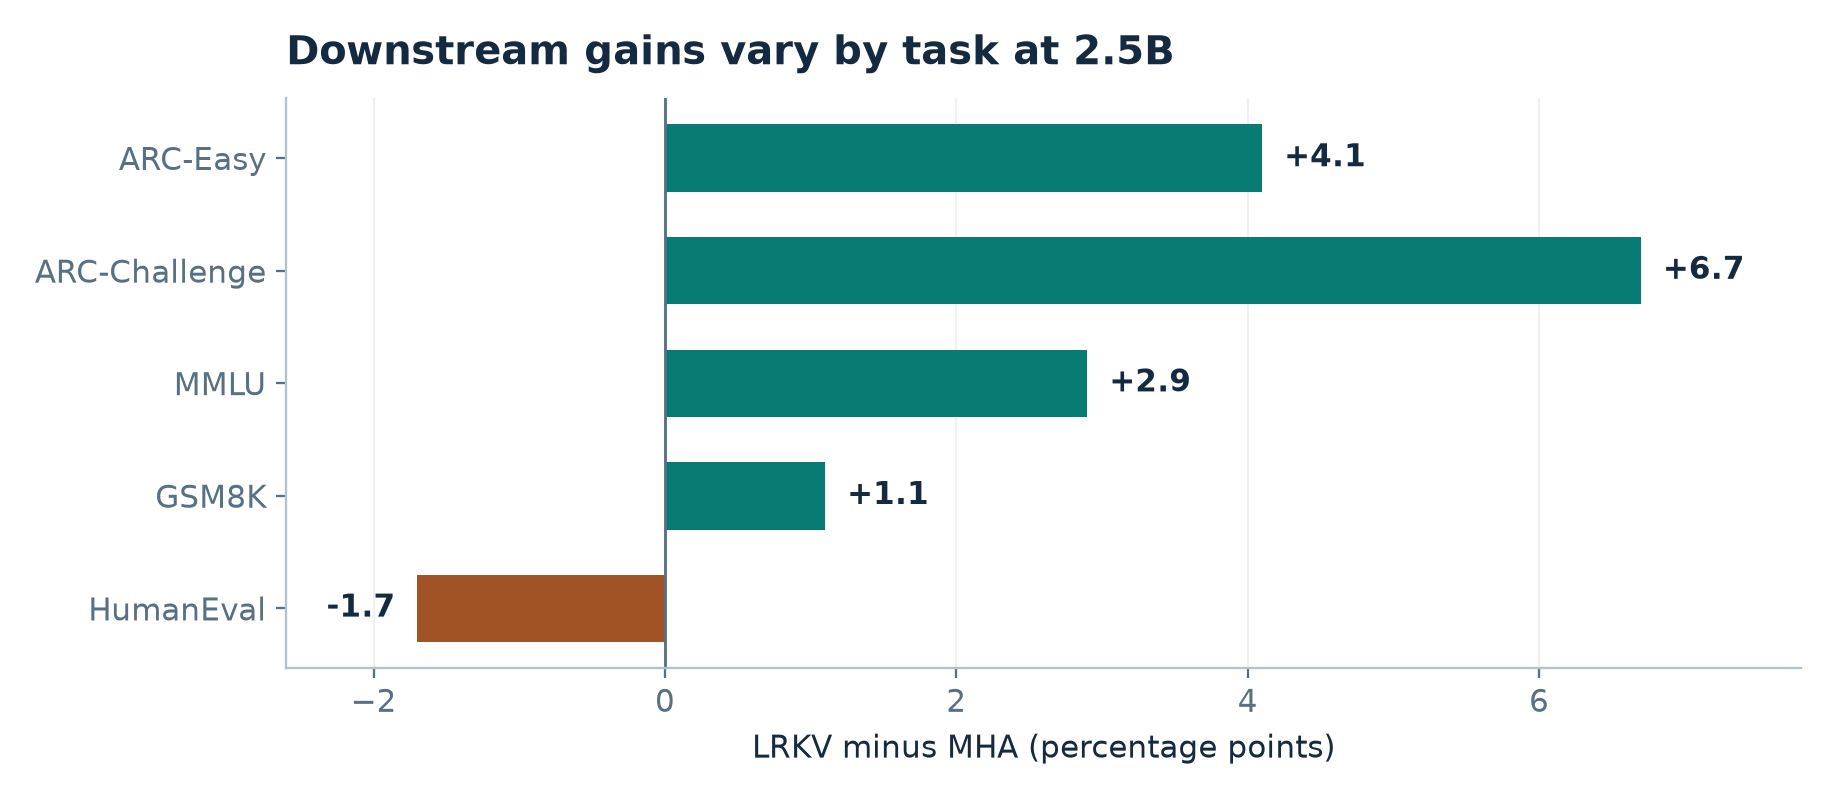
图 6. 据论文表 2 复算 2.5B 的 LRKV 减 MHA,单位为百分点。ARC-Challenge 是最大正差,HumanEval 的方向相反。
附录 E 将五种注意力架构的预训练 BPB 和下游平均分放到一张散点图上。两者同向变化值得记录。每个点对应一种架构,架构本身能同时影响两个量,且从预训练到评测之间还有一次监督训练。用这五个点不能拆出「降低一点 BPB 会带来多少下游分数」的因果作用。读者还需要知道每题的抽样设定、分数的离散程度,以及换种子后是否能保留相同的排序。
单独的 512M 实验把训练上下文增加到 8,192,并保持 50B token 预算。每个有效批次的总 token 数也保持一致。表 9 中,MHA 交叉熵为 2.740,LRKV 为 2.665。用绝对差 0.075 除以 2.740,可复算出约 2.74% 的相对下降。表 7 的配置是 12 头、秩 51,代入缓存公式得 48.18%。这个结果表明该设置能在 8K 下训练并达到较低损失。把某个稀有线索放到长文档中间再问、让相似线索互相干扰,或把长度扩到训练窗之外,都会提出更严格的问题。
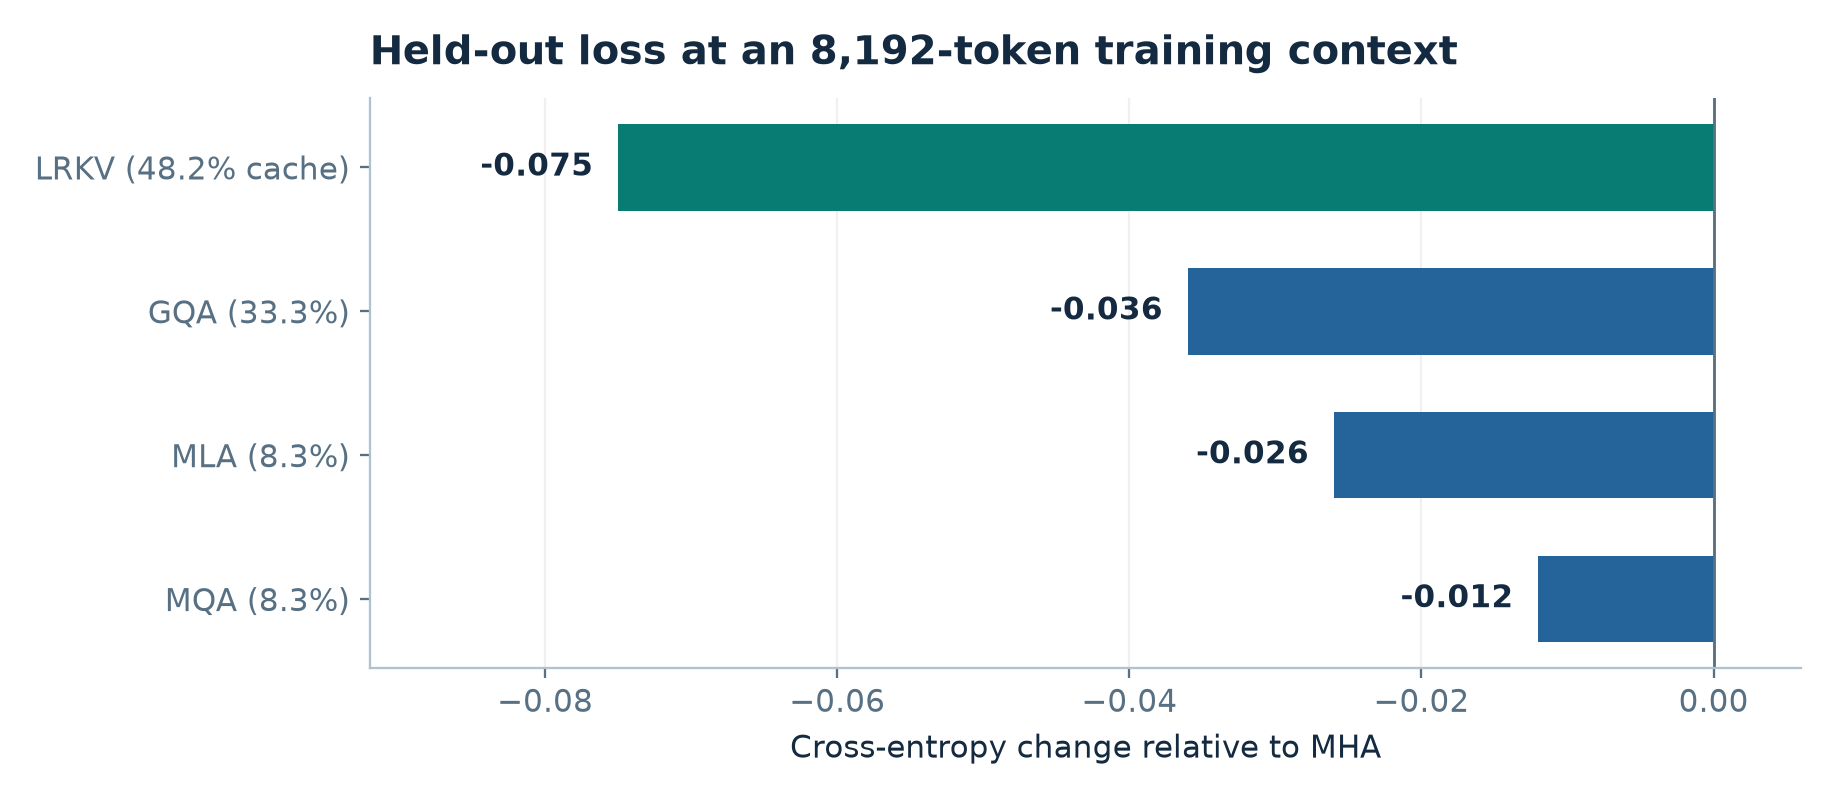
图 7. 根据论文表 9 重绘。差值小于零表示测试交叉熵低于 MHA,标签中的缓存比例来自论文表 9。
6. 头多样性怎么量
先换成决定分数的双线性形式
如果只比两个键投影的坐标,哪怕同一个头换一组正交基,也会看起来变了。在线性、无位置旋转的情况下,可以直接比较决定内容分数的矩阵 。查询和键同时右乘正交矩阵 后,中间的 恰好消掉。
把两侧输入记为 ,未缩放的分数就是 。在原始线性模型里,查询乘任意可逆矩阵、键乘它的逆转置也能抵消。分析可以绕开宽大的 矩阵。先展开 Frobenius 内积,再把迹里的因子循环移动,最后只需两个头宽乘积。
居中是在比较偏离公共方向的变化
论文用各自范数归一化,把内积变为余弦相似度。设 是把归一化后的每个双线性矩阵摊平后逐行堆起来的矩阵, 就是头与头之间的 Gram 矩阵。用 左乘 等价于每个头都减去平均头。先减再计算内积,与在现成的 两侧各乘一次 等价。
把非零特征值归一成一组权重之后,指数化的熵可以理解为「谱相当于几个同样重要的方向」。如果只有一个方向占大部分能量,有效秩会偏低。居中后的行向量相加为零,所以最多只有 个独立方向。完全相同的头经过居中全为零,此时分母也为零,程序应明确处理。如果按照表 3 的说明除以 来报告百分比,6 个头的居中上限只有 83.33%,18 个头则是 94.44%。论文报告的 93.5% 已靠近这个上限。比较不同头数时,最好同时给出原始有效秩,以及相对于各自上限的比例。
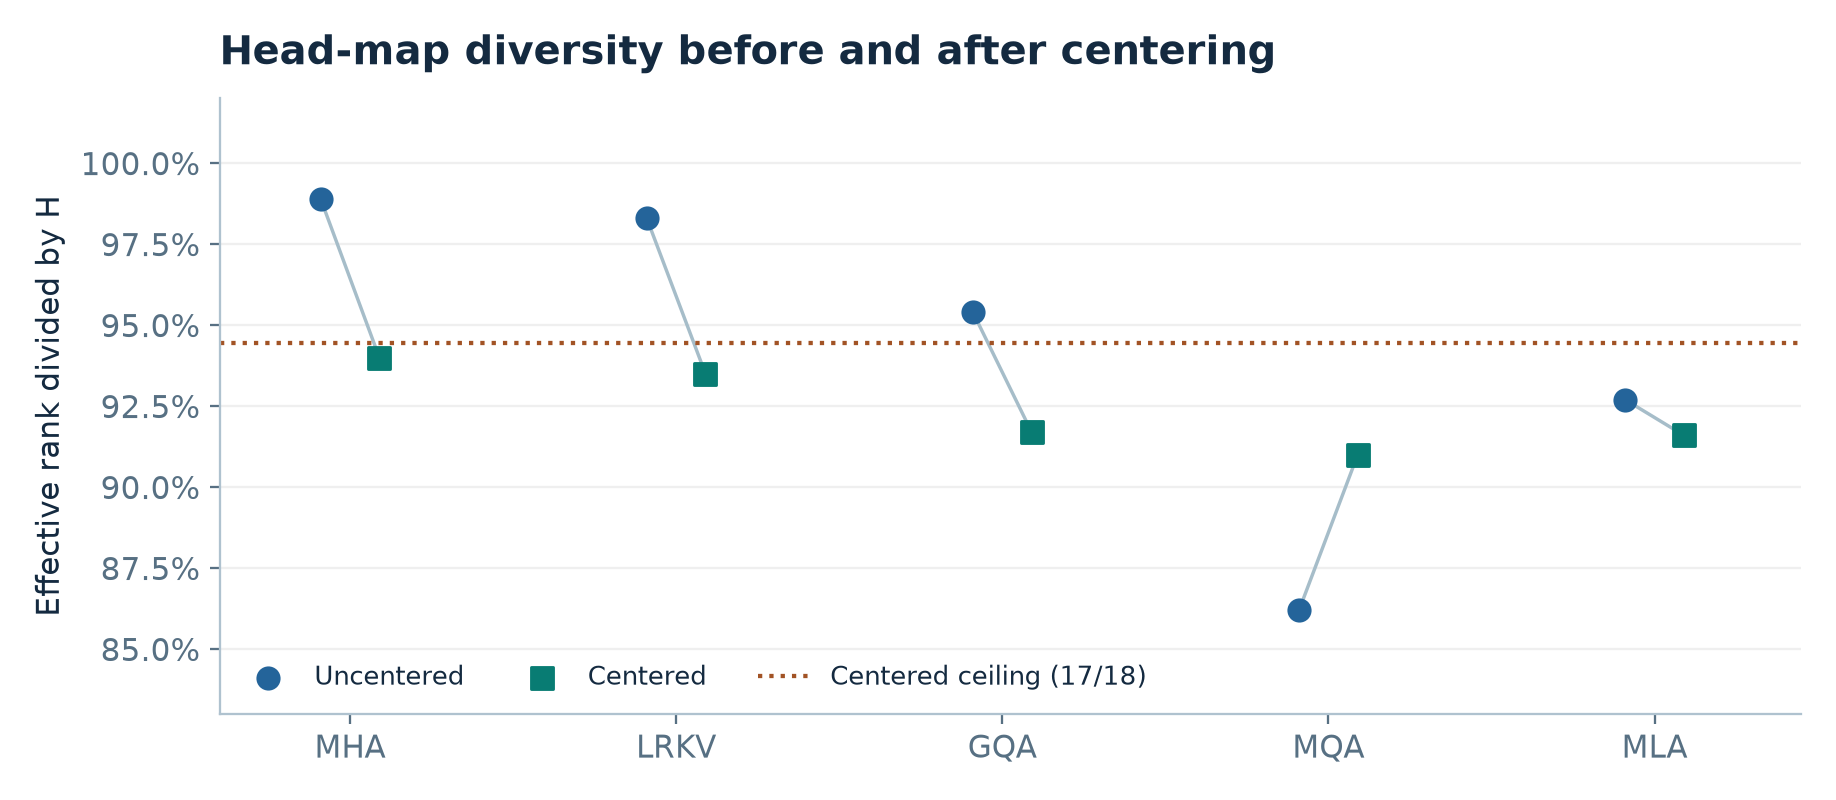
图 8. 据论文表 3 重绘。虚线是以 18 为分母时的居中上限,只约束居中列。它有助于解释为什么 LRKV 的 93.5% 与 MHA 的 94.0% 都接近满谱。
MQA 的有效秩从未居中的 86.2% 到居中的 91.0%。作者把它解释为查询补偿。共享键会引入强公共方向,查询仍可以向多个不同方向变化。居中拿掉平均项之后,剩余谱更均匀。这个现象与解释一致,但还应把实际输入送入模型,看看哪个头改变了路由和输出,再通过有针对性的干预测试这些变化是否有功能。附录的谱、累计解释方差和相似度热图,都是从不同角度看同一批参数几何。
原论文图 9 的图注称其展示六个头居中后的有效秩,曲线上却有若干层高于五。按附录 C 所写的居中操作,六个头最多留下五个独立方向,原始有效秩的上限也是五。本笔记的重绘取表 3 的汇总单元格。要进一步讨论逐层曲线,需要拿到对应的谱,以及作图时到底用了哪种归一化口径。
7. 论文给出的局限
附录 H 把结论限定在作者训练的解码器模型、数据和优化器配方、最高 6.3B 的规模以及对应硬件上。替换学习率、训练时长、长文本比例或内核实现,都会改变代价和收益。附录 C 也明确指出,多样性分析取自训练末尾的参数,衡量的是模型能表达什么。头在实际样本上做了什么,及这种分工在训练的哪个阶段形成,需要另外测量。
从部署角度看,附录 G 通过张量元素数和元素大小统计缓存有效载荷。这种方式便于逐项复算。容量之外,还要知道显存分配峰值、真实内存流量和延迟。长上下文能力也需要分层看。8K 实验覆盖了一个已训练窗口上的平均语言模型损失,关于检索距离和窗口外行为的证据仍有限。
8. 批判性分析
RoPE 的旋转能不能穿过低秩基底
论文第 3 节先将旋转分配到共享项和残差项,然后把残差的旋转移进低维坐标。前一步由线性性保证。后一步有个额外条件。用行向量记号,位置 的完整旋转为 ,私有项先还原再旋转是 。如果要在低维先做 再还原,并且对所有 都相等,就必须满足
这个等式要求残差基底张成的子空间在旋转下保持封闭。取头宽为二、秩为一、基底为 的例子。先还原得到一个横向量,再转九十度,结果在纵轴。先改一维坐标,最后还原,无论把坐标改成什么都只能落回横轴。换一个纵向查询,两条路线的内积便会不同。这是对公式适用条件的反例,独立于浮点精度或工程实现。
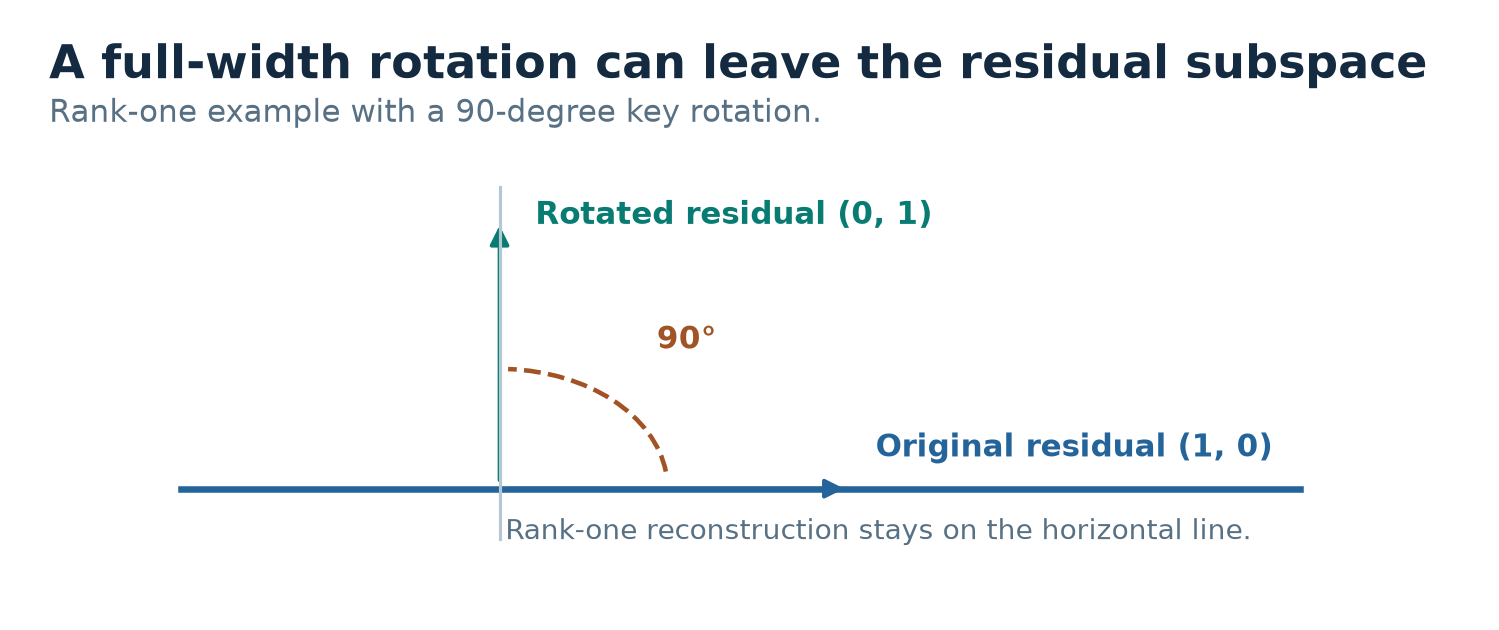
图 9. 本笔记的二维反例。实线为一维基底能够还原的位置,竖直箭头表示做过完整旋转的键。
有一种严格做法是缓存未旋转的私有坐标,再按键的位置计算私有打分。当前查询 已带位置旋转时,私有贡献为
此时括号中包含每个键的位置 ,无法在整个历史上共用一次乘法。可以分块还原并旋转后立即消费,代价转到历史扫描。也可以在训练时让私有基底对成对的旋转平面封闭,或把位置通道独立出来。这两条路线会改变模型约束,需要重新训练后与原配置比较。论文的式 6–7 对线性核心成立;结合完整 RoPE 时,我会先要求一条定义明确的等价路径。
RMSNorm 中还有一个逐头的联合量
论文用投影后的 RMSNorm 解释权重范数变大时输出还能稳定。对于 ,归一化分母 取决于完整键。把平方范数展开,会出现公共项和私有项的交叉项。
如果两条路径分别除以各自范数,键的方向通常会变。一个精确的无 RoPE 方案是追加 token 时先求联合分母的倒数,逐头存下,打分时再乘到两项相加的结果上。固定的逐通道增益可移到查询侧。如果每个头、每个位置多存一个同精度标量,相对密集 K/V 的额外占比是 ,还需要逐步读取它。这笔开销不算大,却说明把训练图和解码公式对齐时有必要列出每一种缓存张量。
同样,线性双线性形式的换基性质也有边界。有位置编码时,有效打分矩阵依赖相对位置,随意换基可能和旋转不交换。归一化及可学习增益进一步限制等价变换。参数空间 PCA 可以保留为统一的诊断量。把实际分数、值端输出和特定任务上的头干预一起报告,会让「多样性」更接近功能判断。
容量表格要把不同配置拆开
附录 G 的数字值得拿计算器核一次。2.5B 的表 7 给出秩 55,和约 48.5% 的占比相符。表 12 则说使用秩 64,列出 LRKV 为 360.0、MHA 为 648.0,却在前者后面写 48.4%。直接相除是 55.56%,也正好等于式 9 的 。同样的方法算表 12 的另外两列,128M 是 66.67%,6.3B 是 53.125%。这两个比例都符合秩 64,表里括注的 52.6% 和 45.1% 属于不同口径。附录 G.4 也把这些较小百分比和秩 64 写在一起。附录的 2.5B 绝对载荷还无法用表 5 的 18 层和表 12 所写的 2,048 token 直接推出。
这不影响给定形状后对式 9 的复算,影响的是把某个比例绑定到某个训练检查点。建议每组结果同时标明层数、头数、逻辑和物理秩、序列长度、字节单位和已计入的附加张量。图和表只引用同一份配置记录,就能避免把秩消融用的 64 和主配置的 55 混起来。表 8 的 MLA-384 也有类似问题,表列 25%,附近的解释用 50%。此外,表 2 的 6.3B LRKV 五项显示值平均为 40.36%,汇总栏写 40.2%。这几处需要原始记录来消解,因此笔记保留表中汇总,并在做逐项分析时回到显示值。
MLA 的参照路径决定了延迟结论
附录 F 的一组比较把 LRKV 的结合律路径和 MLA 的物化路径放在一起。可把同样的结合律用在 MLA 上。设某头的键为 ,其中 是按 token 缓存的共享潜变量,则键打分可以写成 。值端也能先在潜空间归约再投影。这样无需对历史中所有 token 展开完整的键和值。位置编码的做法会影响能够吸收到哪一步,实际两种方案仍要扫描各自的缓存。
我希望看到融合 LRKV、吸收投影的 MLA、以及优化过的 GQA 置于同一组质量和服务条件下比较。测量时要分清分配的显存、真正传输的字节和调度开销。尤其在长序列、多并发时,逐头残差扫描与公共 tile 复用会相互竞争。低批量的 p50 和请求拥堵时的 p99 也可能给出不同的选择。用这样的实验才能检验「空间换时间」划不划算。
9. 复现实验的组织方式
我会先把论文表 7 作为主实验的秩配置,把秩 64 的分析和消融单独记录。训练侧固定训练数据及顺序、分词、训练长度、批量、优化器与评估间隔,显式记录实际参数量。可以同时做两个对照。一个保持骨干不动,只换注意力。另一个对齐总参数预算后再比较。再分别用相同的损失阈值、相同的训练步数、相同的真实耗时问三个问题,避免把优化效率和硬件效率混在一起。
推理侧先写出完整键的参考公式,确定 RoPE 在何处做、RMSNorm 是否包含逐通道增益、哪些量在追加时计算。小输入应覆盖位置不同的两个 token、旋转会离开私有子空间的例子,以及公共键和私有修正近乎相消的情况。逐项比对 logits 和头输出可以区分公式错误与精度误差。页尾不足一块、不同批次序列长度、共享前缀回收等案例也要覆盖,因为两组缓存必须同时指向同一个历史位置。
接着用相同的缓存有效载荷选多组 GQA 和 MLA 配置,报告多种随机种子的损失、各任务的原始样本数及成对差值。长上下文需要改变线索位置和干扰项数量,观察各头在哪些距离开始失去原来的路由行为。头多样性同时报告居中前后的有效秩、相应理论上限和实际输入上的行为指标。若后续要区分公共和私有路径的作用,可以有控制地打乱某个头的私有键残差,或只替换值残差,在同一批样本上看具体能力变化。
最后从短到长扫上下文和并发,用同一精度、相同批量和匹配的位置语义测预填充、稳态解码、显存峰值和设备内存访问。等质量时比较延迟,等延迟预算时比较可承载请求数。每组结果同时列张量大小与实际流量,就能判断哪部分收益来自较小的有效载荷,哪部分来自内核复用。本笔记中的示例和对表复算均基于代数或论文数值,这套对照是后续实验设计。
10. 结论
LRKV 的价值在于把「头之间究竟共享多少」变成一个可以测量和调节的设计量。公共基底保留共享的宽特征,低秩修正给各头留下不同的投影方向。在线性核心中,先投影查询、后展开私有值的结合律给出了清楚的节省来源。在作者的实验里,中间秩带来了比 MHA 更好的损失与容量组合,任务级分数仍有分化。
离实际选型还差一条首尾一致的证据链。先说明位置与归一化如何进入压缩解码,再把同一个检查点的秩、缓存字节、损失和内核延迟摆到一起。这样才能判断这层共享结构会在哪些硬件和请求形态下带来好处。
来源
- James O’Neill、Robert Clancy、Mariia Matskevichus、Fergal Reid,《Low-Rank Key Value Attention》,arXiv:2601.11471v3。方法见第 3 节,实验见第 4 节及附录 D–G,头多样性见附录 C,局限见附录 H。论文与版本记录