笔记日期: 2026-11-05
作者: Zhongzhu Zhou
阅读论文: Polar: Agentic RL on Any Harness at Scale
论文作者: Binfeng Xu, Hao Zhang, Shaokun Zhang, Songyang Han, Mingjie Liu, Jian Hu, Shizhe Diao, Zhenghui Jin, Yunheng Zou, Michael Demoret, Jan Kautz, Yi Dong
arXiv: 2605.24220v1
版本与日期: v1,2026 年 5 月 22 日
1. 我为什么把它当作系统论文来读
训练一个会修代码的模型,通常要先给它搭一个训练环境:把问题交给模型,让模型调用工具,再用测试结果算奖励。看上去,只要模型权重相同、工具名称相同,训练环境和产品环境就差不多了。但实际使用中的 agent harness 还负责系统提示词、工具参数格式、上下文压缩、子智能体、任务结束条件,以及补丁如何提交。把这些环节改写成训练框架喜欢的形式,模型面对的任务就已经发生了变化。
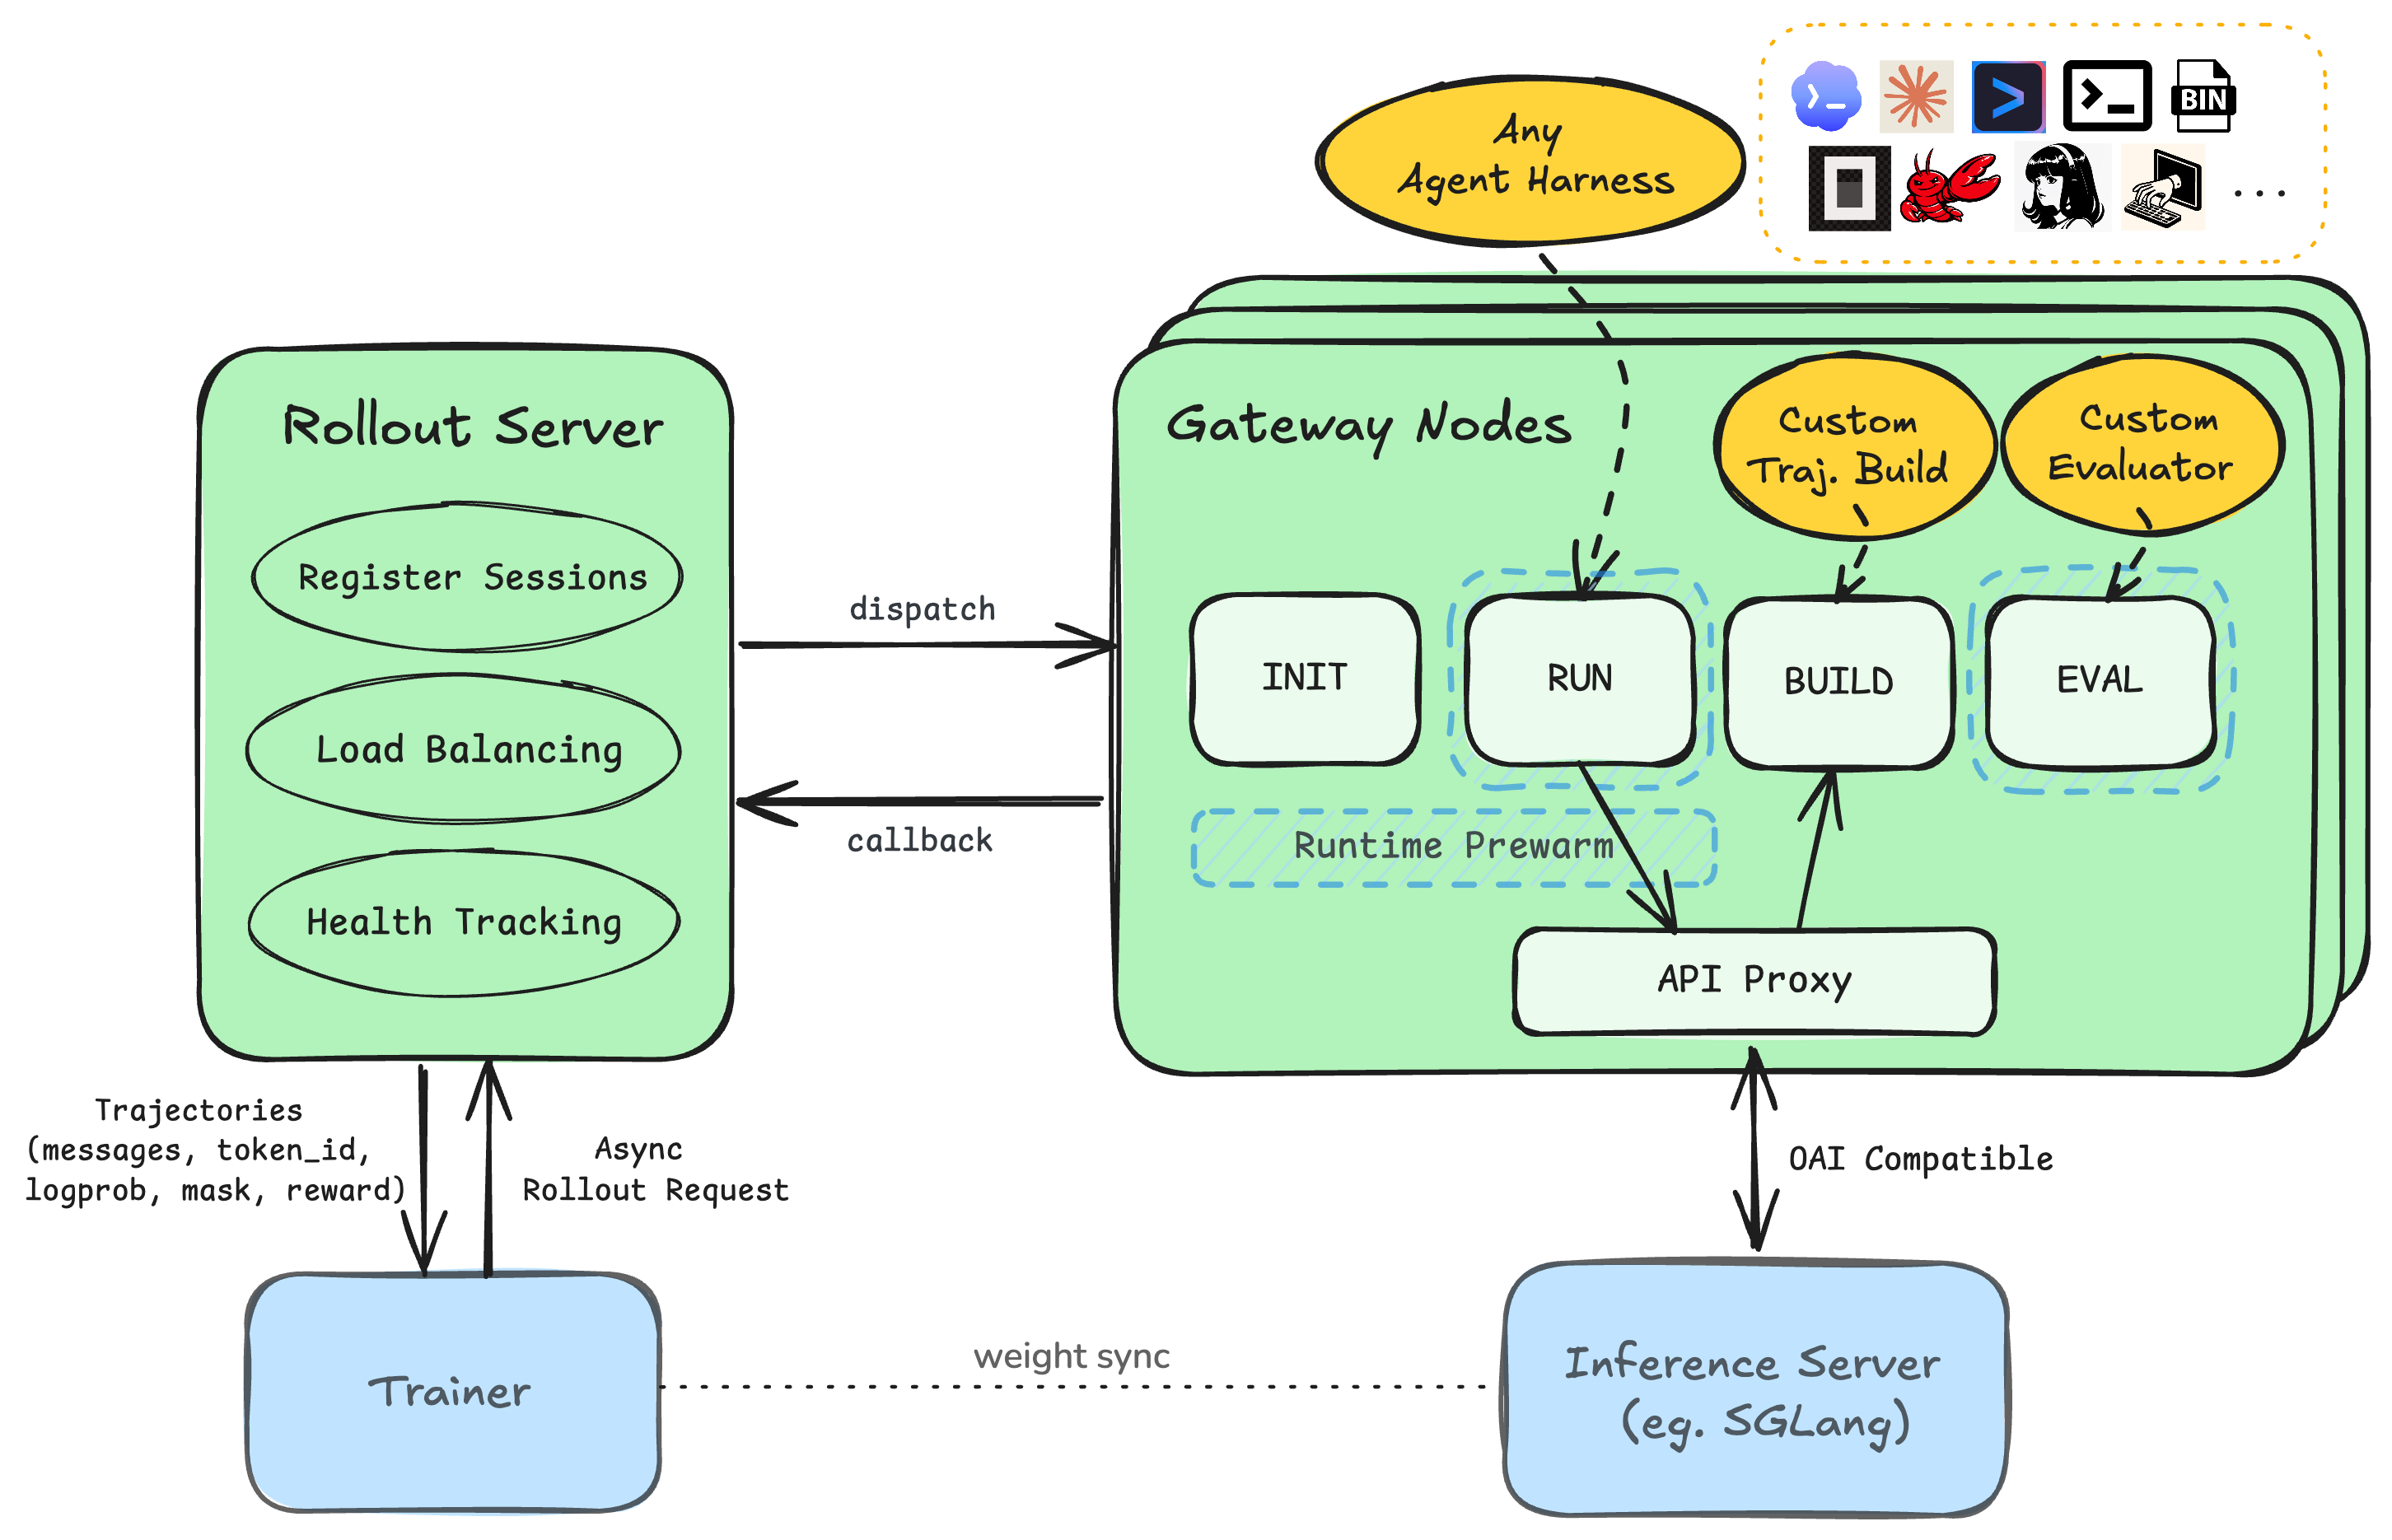
Polar 想保留这层原生执行过程。它让现成的 harness 在隔离运行环境里照常启动,把模型 API 地址指向代理。代理负责转发请求、记录推理后端真正采样的 token 和概率,再把多个请求整理成训练器能使用的轨迹。训练器则独立运行,不需要把 harness 的内部事件循环重新实现一遍。
我认为这个选择的价值是把“究竟在训练哪个系统”说得更清楚。训练对象包含模型和它所处的交互接口。尤其当模型原本不熟悉某个工具协议时,在实际接口中学习有直接意义。论文用 Qwen3.5-4B 分别搭配 Codex、Claude Code、Qwen Code 和 Pi 做在线 RL,又展示了用较大教师模型生产离线轨迹的案例。
不过,读到“token-faithful”时,我会把几个问题分开:动作 token 是否保留原样?后续动作看到的条件上下文是否相同?代理是否保留了 harness 对流式输出的行为?重建轨迹以后,训练样本的权重是否仍然符合原目标?这几件事不能互相替代。它们也是这篇笔记展开推导和批判性分析的主线。
Polar 延续了 ProRL Agent 的 rollout 服务思路,但改变了接入边界。这里的 ProRL Agent 是系统前作,不能与 ProRL 那篇“延长强化学习能否扩展推理边界”的论文混为一谈。
2. 前置知识:一次任务为何会变成很多条训练样本
2.1 先统一四个计量单位
读这类论文,我会先画清单位。task 是一道问题;session 是针对问题的一次独立尝试;completion 是一次模型调用;trace 则是交给训练器的一段序列。一个 task 可以采样很多 session,一个 session 又可以包含很多 completion,而这些 completion 未必只能合成一条 trace。
例如,一个主智能体读文件、运行测试、修改代码,又派出一个子智能体查找错误。主智能体和子智能体各有上下文;主智能体中途还可能压缩历史。因此,“这次任务的所有 API 请求”不等于“一段可以直接拼接的自回归序列”。重建器必须识别哪些调用确实延续同一段历史,哪些调用应该另起一条链。
用符号表示,一次调用记作 。其中 是提示 token, 是原始采样响应, 是相应行为策略的 log probability, 是消息结构信息。第 个动作的条件概率为
这里的 表示 rollout 时真正使用的行为策略。训练器稍后更新参数时,面对的是另一套参数。动作、上下文和行为概率必须对应同一个条件事件,重要性比率才有正确解释。
2.2 保留文字,不等于保留采样过程
设 表示解码, 表示编码。模型生成一串 token 后,把它解码成文字再重新编码,不一定得到原序列,即 未必等于 。同一段可见文本可能对应不同的 token 切分。工具调用被整理成 JSON、推理内容被分配到不同响应字段时,还会多一层规范化。
如果训练器只保存可读聊天记录,后续算出的 log probability 可能属于另一串 token。Polar 因此直接从推理后端记录原始 token ID 和对应概率。工具输出则不同:模型需要看见测试日志才能决定下一步,但这些日志不是模型生成的动作,所以它们应参与上下文计算,却不应承担策略损失。loss mask 的用途正是区分这两种来源。
2.3 从策略梯度看数据为什么必须对齐
下面是帮助理解的背景推导,不是 Polar 新提出的目标函数。假设只有模型动作的分布依赖待更新参数,环境与 harness 的转移规则固定,最终任务奖励为 。利用 ,得到
这个式子说明,最终奖励可以乘到整段任务中的动作梯度上。不能因为奖励只在最后出现,就直接断言“给之前动作同一个奖励在数学上错误”。真正要核对的是:原本属于同一个 session 的动作,到了训练器是否被误当作很多个独立 session?组内相对优势是否还按原问题分组?长度归一化是否在重建后改变了权重?
异步训练还会涉及行为策略与当前策略的差别。一个说明性的 token 重要性比率是
分子和分母必须针对同一个动作、同一个条件上下文。裁剪比率可以降低方差,但无法把“上下文错配”的分母变成正确分母。原文超参数表写了 TIS enabled,却没有把训练器的完整估计量推导出来。我不会仅凭这个缩写补写作者没有说明的算法细节。
3. 把模型 API 当边界,省掉了什么,又留下了什么
代理根据路径与请求头识别 Anthropic Messages、OpenAI Chat Completions、OpenAI Responses,以及 Google 风格请求。随后把角色、内容块、工具定义、停止条件和生成参数转换成推理后端支持的聊天格式,并请求 log probability 等训练字段。模型响应回来后,再还原成 harness 期待的协议形状。
于是,harness adapter 的职责主要是配置、安装或注册相关工具,以及返回启动原生程序的命令。运行环境接口则负责启动、停止、执行、上传、下载和取消。论文介绍的后端包括 Docker 与适合 HPC 场景的无 root Apptainer。训练器无需直接理解这两个后端如何准备文件系统。
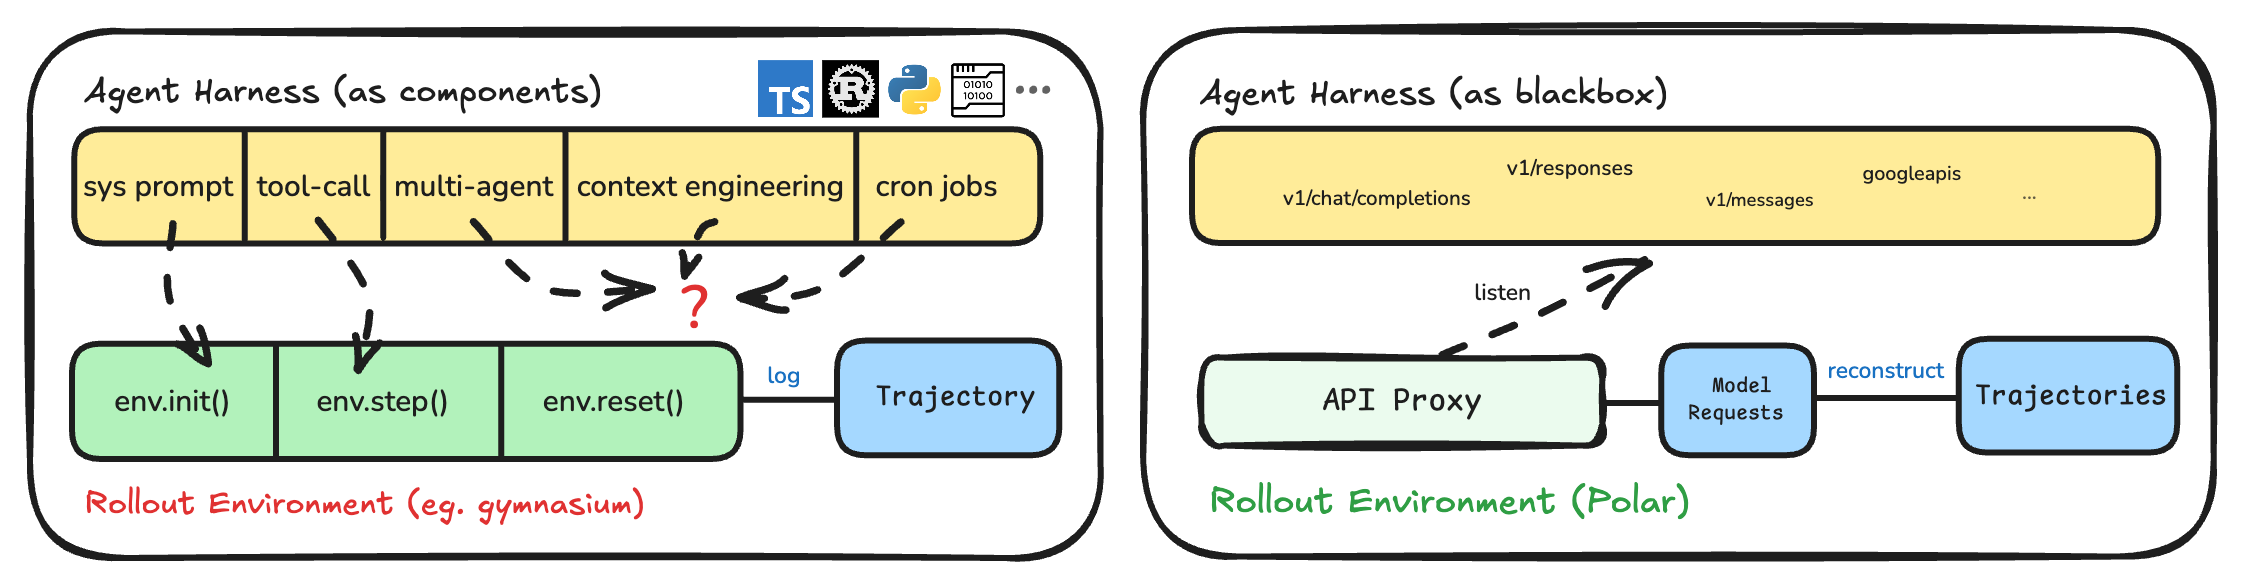
这个设计尤其适合命令行工具或无法访问内部事件循环的程序。只要它允许配置模型地址,就可能接入统一训练基础设施。相较之下,把 agent 重写成框架里的环境类,虽然能直接获得内部状态、过程奖励和精细控制,却需要每个框架、每个 harness 单独适配。
代价是观察范围变窄。代理知道经过自己端点的模型调用,却未必知道 harness 内部所有状态变化。绕过代理的模型请求、运行环境外部的工具副作用、与时序有关的交互,都不能因为“原生程序没有重写”就被认为完全保真。因此我更愿意说,Polar 保留了原生 harness 的执行入口,同时由外部代理介入模型流量。
流式响应是一个具体例子。论文先取得上游完整的非流式结果,再合成下游期待的事件流。这有利于集中记录 token,同时兼容等待 SSE 事件的客户端。但协议字段兼容,不等于时间行为相同:首 token 延迟、取消时机、工具是否与生成交错,都可能改变。对于论文验证的修代码流程,这个选择能工作;对于边生成边执行、严格受延迟约束的 agent,还需要单独验证。
还有一个容易被“agnostic”掩盖的问题:谁保证模型端点真的提供了所需字段?如果某个后端只有文本,没有采样 token ID 或可靠的行为概率,代理不能凭空恢复它们。可移植性必须和训练数据合同一起定义,而不能只用支持多少种 API 名称来衡量。
4. 异步 rollout:把不同资源的等待拆开
Polar 有 rollout server 和 gateway 两层。前者管理任务、分发 session、接收回调、保存终态并提供轮询;后者负责某次尝试从创建运行环境到拆除资源的整个生命周期,也在本地承载模型代理。这样,token 捕获与 session 身份绑定在同一个执行节点上,不必再靠一个外部日志收集服务事后猜测归属。
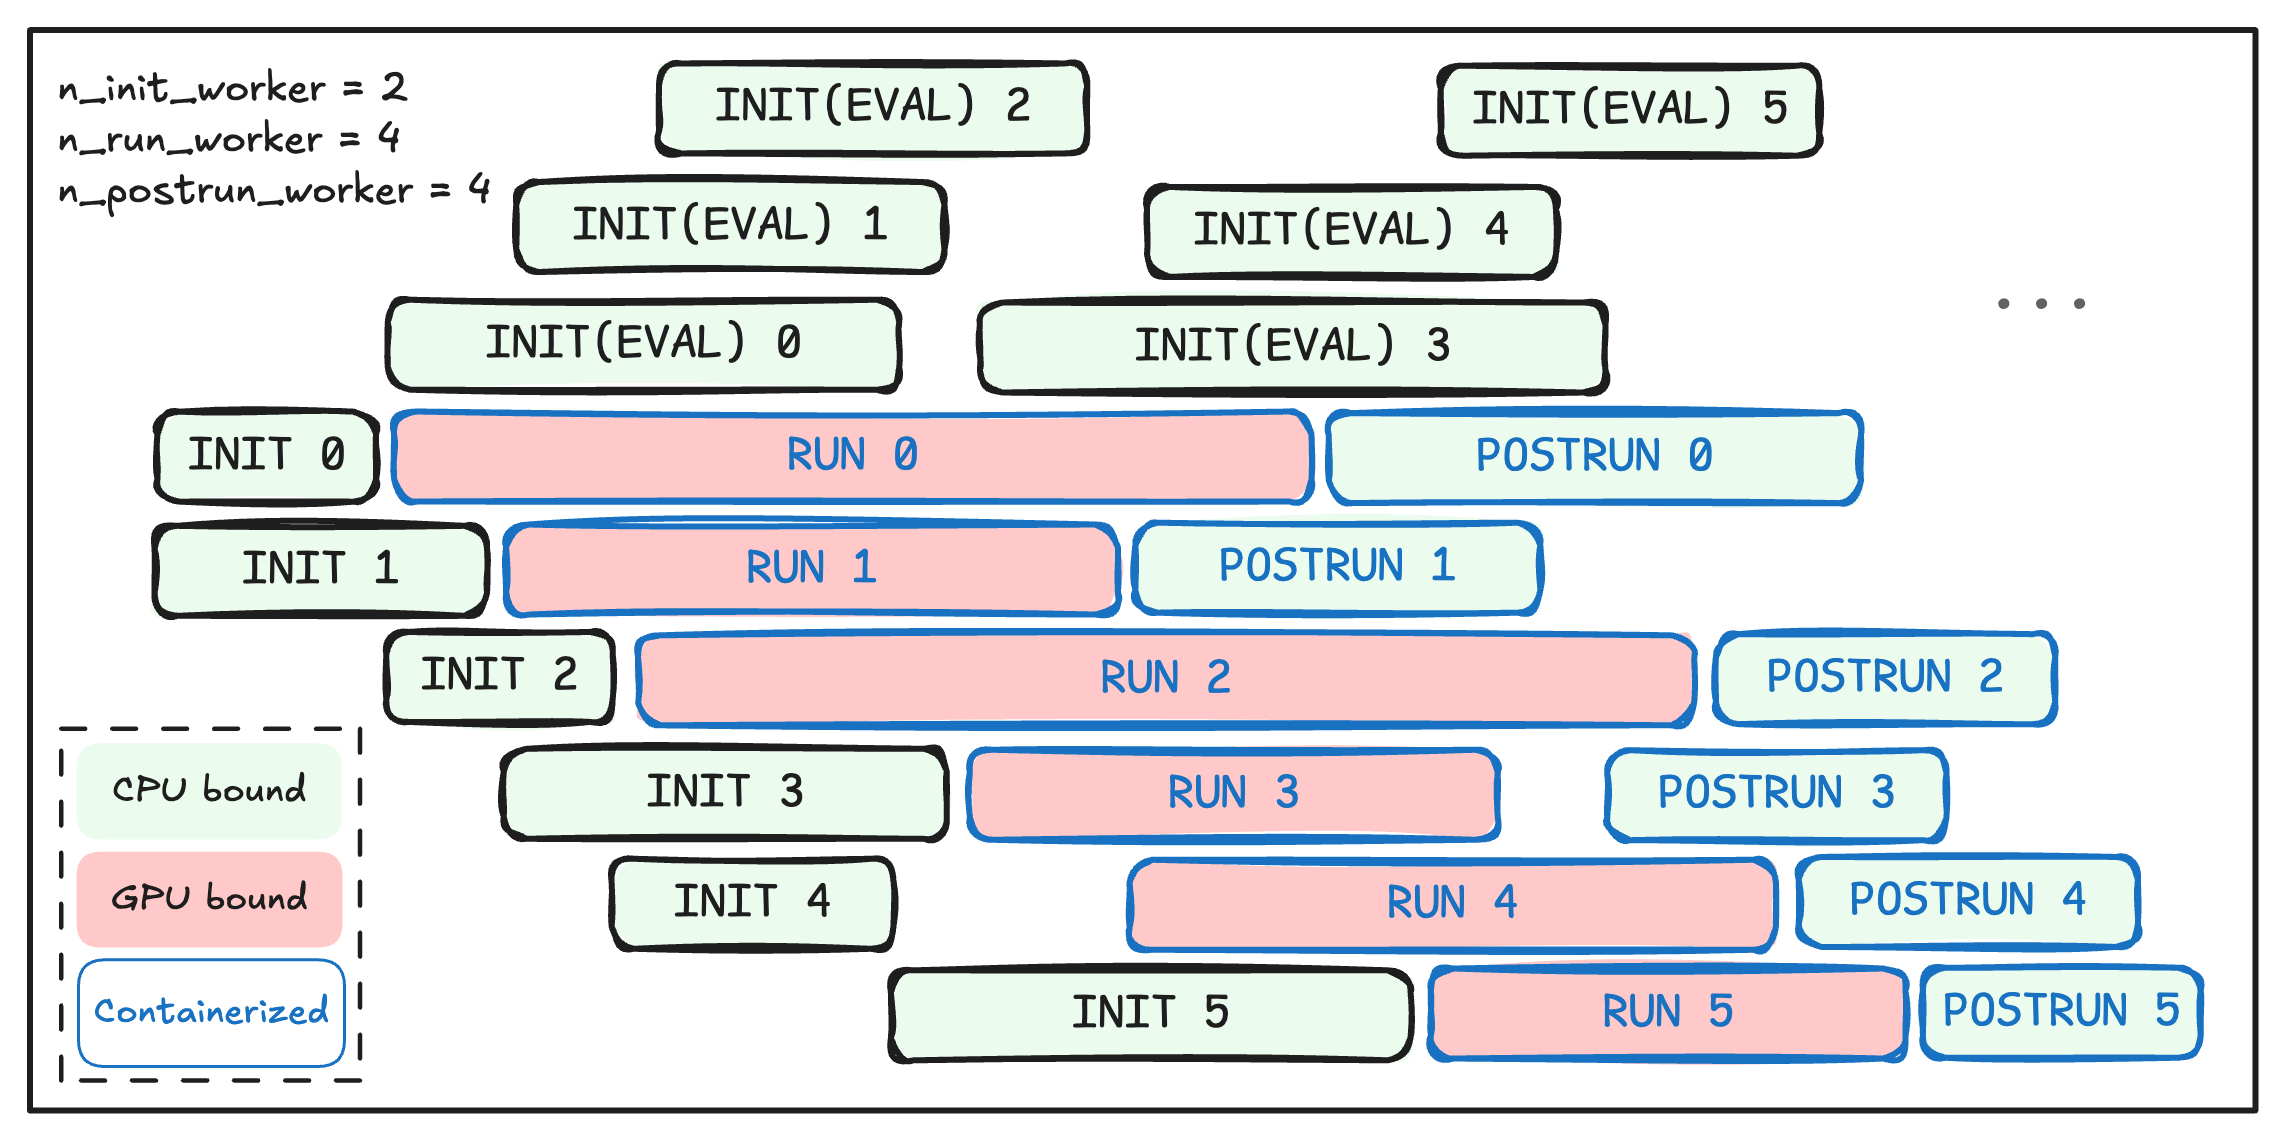
gateway 内部进一步拆成 INIT、READY、RUNNING、POSTRUN。INIT 创建环境并准备依赖,READY 是有界的预热缓冲区,RUNNING 执行 harness,POSTRUN 负责轨迹重建、测试评价、回调和清理。如果评价器需要干净运行环境,可以在 agent 仍然运行时提前准备。
4.1 为什么拆资源池能提高利用率
可以用一个简单的排队模型理解。设初始化、运行、后处理平均耗时分别为 ,各有 个工作槽。忽略共享资源竞争时,稳定处理率至少受下面的容量约束:
这是我用于解释的模型,不是论文测得的吞吐公式。串行执行时,一次尝试占用 ;流水线稳定后,吞吐更多由最慢资源池决定。不过,镜像下载可能争用磁盘和网络,测试与 agent 可能争用 CPU,推理请求则共享 GPU。只看平均时间,也无法描述长尾 session 对等待的影响。
READY 必须有界,因为预热好的运行环境即使不做事,也会占内存、文件系统和容器资源。Little 定律 可以提醒我们:增加在途任务,有时只是增加停留时间。缓冲区能隐藏初始化延迟,但不能消除 POSTRUN 的瓶颈。若测试越来越慢,背压最终仍应传到任务接纳,而不是无限准备空闲运行环境。
4.2 算法 1:一次 session 的生命周期
下面把原文第 3.1–3.3 节及附录 A.5 整理成编号伪代码,便于跟踪责任边界。它不是作者给出的原样算法,也不额外承诺分布式故障下的完整恢复语义。
Algorithm 1. Staged rollout session
01 Accept task; allocate independent session IDs.
02 Attach runtime, harness, builder, evaluator, deadline.
03 INIT: prepare runtime and harness dependencies.
04 READY: wait in the bounded prewarmed-runtime buffer.
05 RUNNING: launch harness through the gateway proxy.
06 Capture completions with session and policy metadata.
07 Prewarm a clean evaluation runtime when requested.
08 End active execution on completion or timeout.
09 POSTRUN: reconstruct the captured model calls.
10 Evaluate artifacts; retain outcome and terminal status.
11 Return results through the task/callback boundary.
12 Tear down runtimes and finish session bookkeeping.
共享 deadline 的好处是避免每个阶段各花一遍完整超时预算。即使 harness 超时,只要已经捕获模型调用,仍可进入后处理保留部分轨迹。不过,“超时”不天然等于“答案错误”:补丁可能已经修好,只是测试没跑完;也可能是容器初始化失败,模型还没机会行动。训练标签应区分验证失败、预算耗尽与基础设施异常。
原文说明了终态保存与尽力清理,却没有证明回调恰好执行一次、训练器绝不重复接收,或者节点在半次模型调用期间崩溃时如何恢复。这些问题不否定服务边界的价值,但生产系统需要更具体的持久化、幂等和资源回收合同。不能从“异步 API”四个字推断出这些保证。
5. 轨迹重建:保留原始动作,把环境插入项遮住
5.1 两种重建方式的出发点
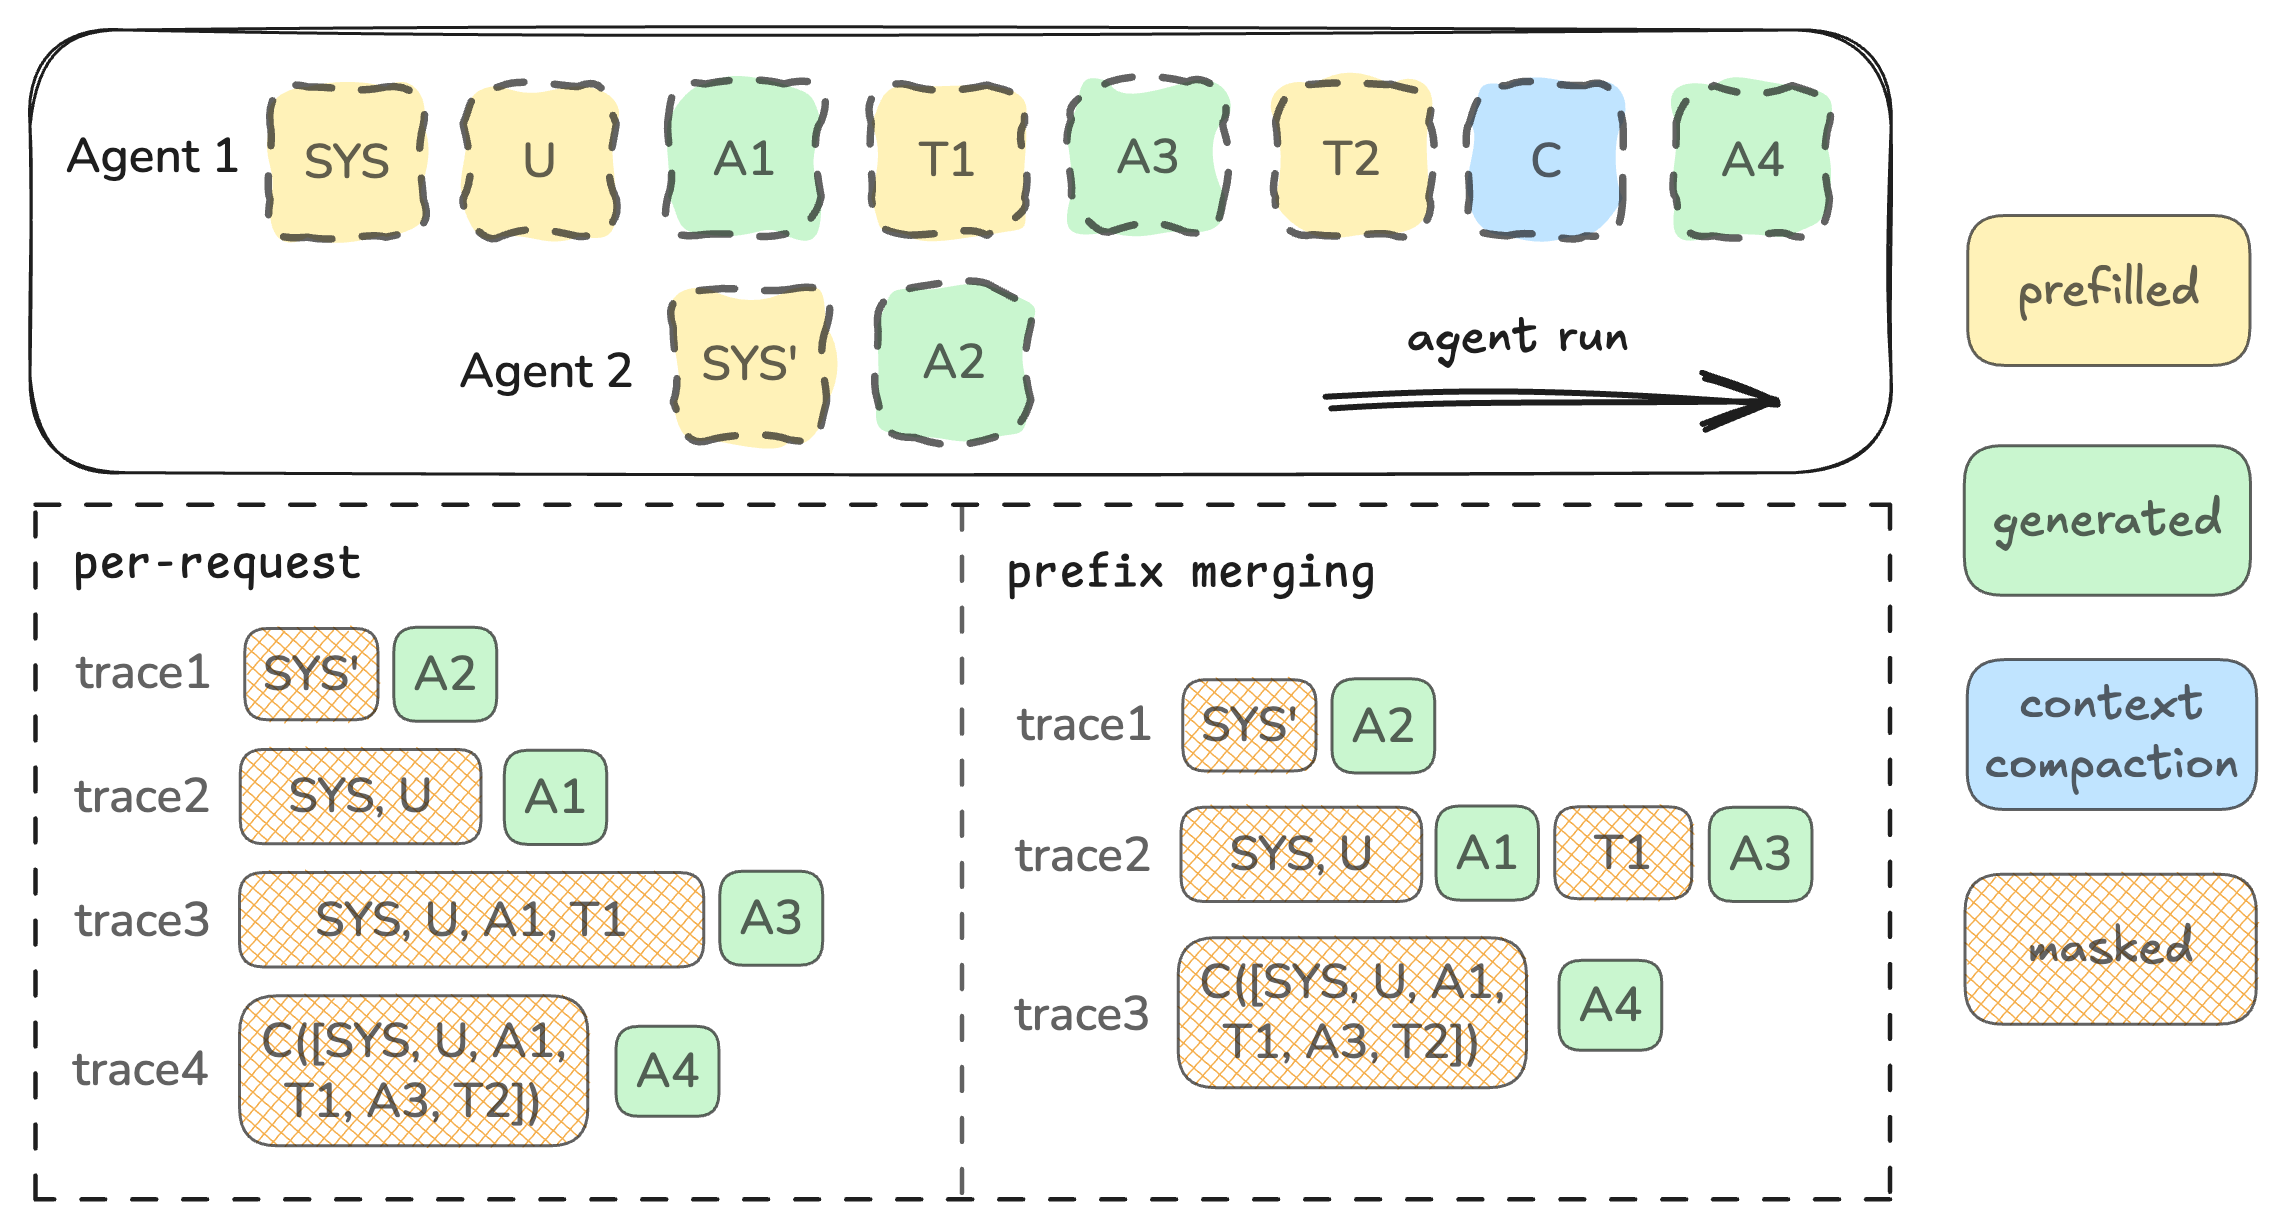
per-request 最保守:一个 completion 变成一个 trace。它保留了每次调用自己的原始提示,问题是长任务可能产生几百条短样本。训练器会重复处理大量历史,也更容易在奖励分组和采样单位上出错。
prefix merging 则尝试识别可以延续的调用链。它先通过规范化后的消息结构找候选,再检查前一次提示是否是后一次提示的严格 token 前缀:
这里检查的是旧的 prompt,而不是“旧 prompt 加上旧的采样 response”。这一区别很关键。压缩历史后通常不再满足前缀关系,应另起链;子智能体也可能拥有独立提示。因此一个 session 最后可以包含多条 trace。合并减少碎片,不等于强行把所有分支压成一条聊天记录。
5.2 规范化历史里,哪些 token 不能照抄
假设相邻两次调用满足前缀条件,先把后一次 prompt 的旧前缀去掉,得到 canonical tail:
这段 tail 既包含上一次助手回复的规范化表示,也包含工具结果、角色边界等后续上下文。若整段照抄,就可能把模型真实采样的 token 替换成重新编码后的 token。所以 Polar 保存原始 ,只从 tail 中提取需要插入的环境部分 。
设 为轮次结束 token, 为它在 中第一次出现的位置。根据原文说明,提取规则可写为
若原始响应已经采样到结束标记,就不重复添加;若没有,就把规范化 tail 中的结束标记一起带上,确保下一段提示开始前,助手轮次已经关闭。这里隐含了结束标记可正确定位的假设。若边界缺失或含义不明确,我倾向于退回独立请求,而不是猜一个边界。这是我建议的保守规则,论文没有完整描述这类异常的处理方式。
5.3 合并序列、mask 和概率数组如何对齐
一条有 次调用的链,被整理为
开头的 存入 prompt,后面的所有内容存入 response。这里的 response 只是训练数据字段名,里面确实可能含工具返回与角色分隔符。不能因为某个位置在 response 字段中,就认为它一定是可训练动作。
对应的 mask 和概率数组为
真实采样响应对应全一 mask,插入上下文对应全零 mask;插入部分的 log probability 是为长度对齐放置的占位值。它们不应参与有效损失。但这仍要求训练器在归约和相关概率运算中正确处理 mask,而不是先让无效值进入计算再假设乘零一定能解决所有问题。
原文附录 A.4 展示了这些字段,适合理解数据结构;其中使用了省略号,因此不能拿示意数组当作所有长度都可直接验证的完整样本。
5.4 算法 2:从请求记录构造调用链
编号伪代码按原文重建流程整理,其中第 12 行是对未充分说明的边界情况给出的保守建议。
Algorithm 2. Token-faithful prefix merging
01 Visit completions in their recorded order.
02 Find candidate chains using normalized messages.
03 Check the exact token-prefix relation of prompts.
04 Open a new chain if no valid continuation exists.
05 Otherwise append the completion to the chosen chain.
06 Store the first prompt of each chain as prompt_ids.
07 Copy raw sampled response IDs into response_ids.
08 Copy real logprobs; append an all-one loss mask.
09 Locate the end-of-turn marker in the canonical tail.
10 Extract interstitial context using Equation (7).
11 Append context, placeholder logprobs, and zero mask.
12 If the boundary is unsafe, keep calls separate.
13 Emit one trace per chain with session provenance.
14 Assign reward under the evaluator/trainer contract.
还应注意,前缀关系只是一种候选关联,不天然等于因果父子关系。重复调用可以拥有相同 prompt,平行分支也可能共享很长前缀。原文没有把候选链冲突的决策规则完整写出来。若记录中带有明确 parent-call 身份,调用链关系就比单靠共同前缀更强。
5.5 用一个手算例子检查边界
下面所有 ID 都是说明性构造,不是实际运行结果。设第一次提示为 ,原始响应为 。后一次提示是 ,其中 表示结束标记, 表示某段工具上下文。再假设 token 与 token 序列 解码后的可见文字相同。
此时 canonical tail 为 。由于 没有采样到结束标记,应该提取 。若第二次响应为 ,最终得到
mask 比 少一个位置,是因为最前面的 属于 prompt。被训练的是原始动作 ,而不是规范化后的 。第一个 来自插入上下文,mask 为零;最后一个 是第二次响应真实采样出来的,mask 为一。可训练性取决于来源,而不是“这个 token 看起来是不是控制符”。
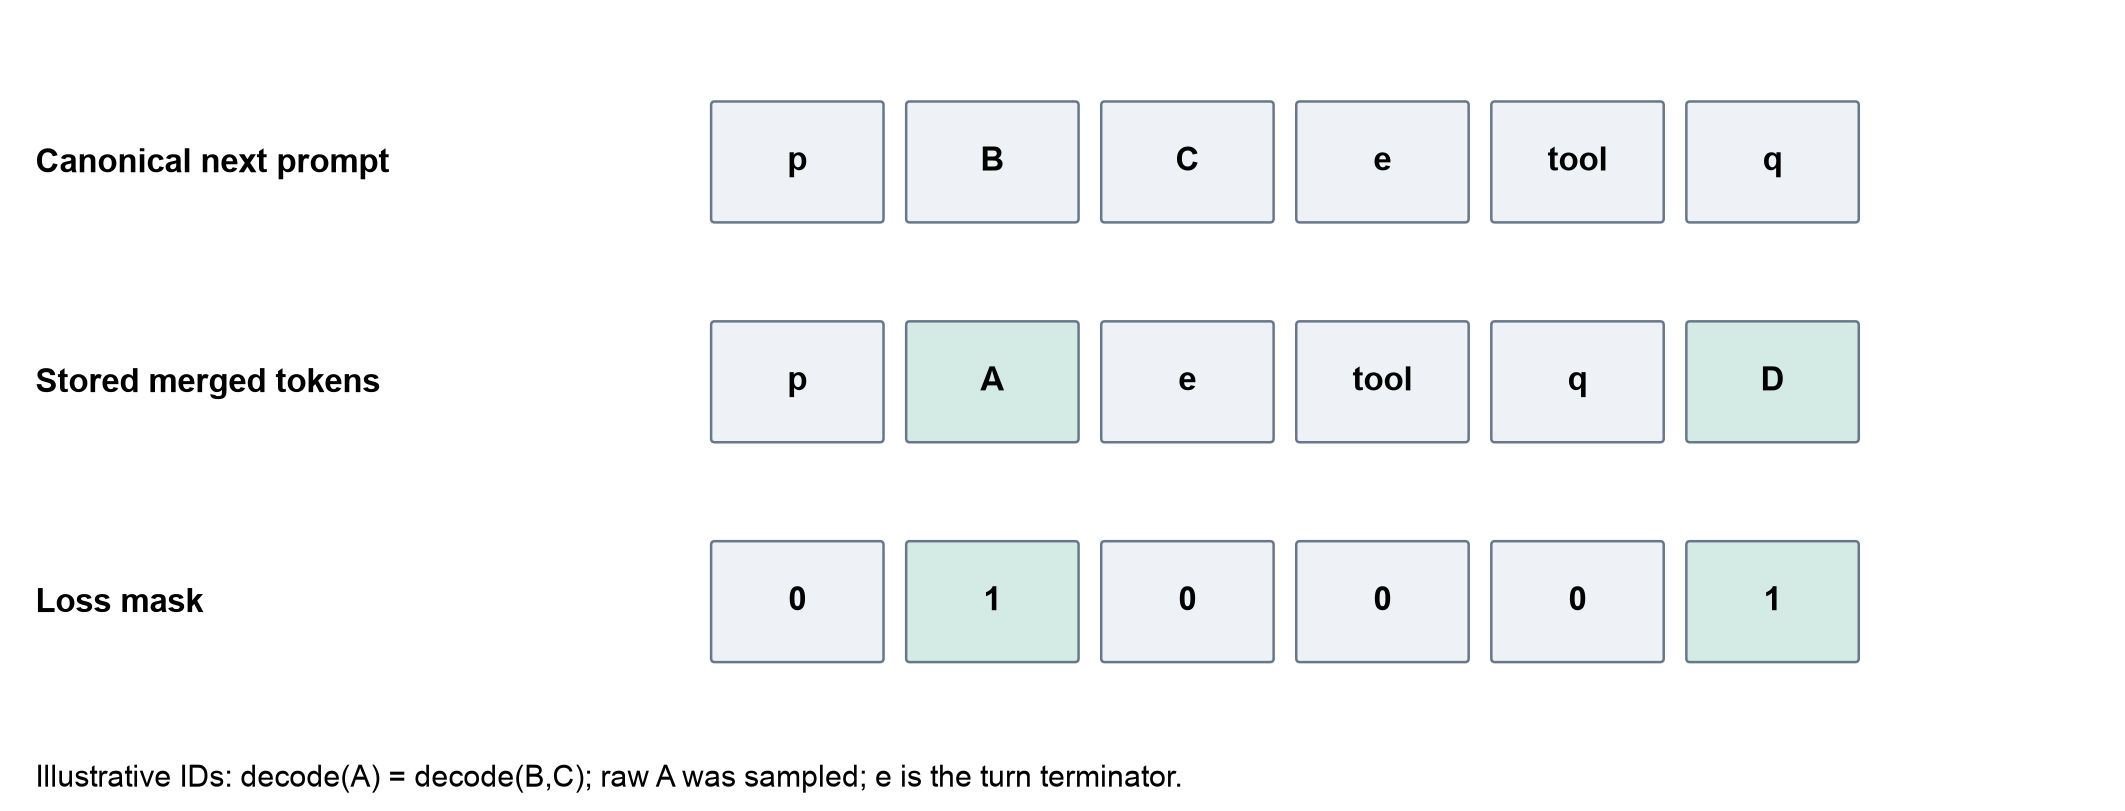
这个例子还带出更深的边界。第二次模型调用原来看到的是 ,合并序列中相应位置却看到 。文字相同,不代表模型隐藏状态相同;token 数不同还会改变后续位置。保存原始动作是必要条件,但若要宣称后续动作的条件概率也完全对应,还需要更强条件。这不是断言论文所有样本都有问题,而是要求明确保真不变量的范围。
6. 奖励传播也是系统接口的一部分
Polar 的评价器可以在干净运行环境里重新应用补丁、执行测试。这有助于减少 agent 修改依赖、测试文件或工作目录状态对得分的干扰。评价器既可以给整个 session 一个终局奖励,也可以扩展为逐 trace 或过程奖励。
但评价器返回一个数字,并不代表奖励语义已经闭环。还要看训练器如何把同一 session 的多条 trace 放回问题组里,怎样做优势标准化,以及是否按 token、trace 或 session 平均。轨迹重建不仅是数据压缩,也可能改变训练目标的隐式权重。
为了理解 GRPO 的组内比较,设同一道题采样 次,奖励为 。一种常见的标准化优势形式是
这仍是背景说明,不代表作者公开了训练器全部归约细节。若某个 session 拆成 条 trace,每条梯度贡献为 ,以下两种平均通常不同:
不能脱离目标就说哪一种永远正确。动作级目标、长度归一化和采样分布会决定权重。问题是不要让重建器在没有说明的情况下偷偷决定它。一条很啰嗦的失败轨迹有 100 次模型调用,不应该仅因拆分,就被误当成 100 次独立尝试;一次简洁成功若只产生一条 trace,也不应因此被稀释。
作者确实报告了 per-request 加终局奖励广播时出现明显 reward hacking,并把原因指向未妥善归一化的请求级信用分配。这个负面结果值得保留。它提示我们检查样本扩张与奖励分组,却不能推出“所有多轮任务都必须用过程奖励”。prefix merging 能减少碎片,但 session 仍可能有多条链,因此不会自动解决因果信用分配。
7. 在线实验:学会适应接口,与系统加速分开看
7.1 训练配置先按来源对齐
在线 RL 使用 Qwen/Qwen3.5-4B,训练数据为 NovaSky-AI/SkyRL-v0-293-data 的 293 个训练任务,通过 Slime 做异步 GRPO。附录 A.2 给出:一个 epoch、rollout batch size 为 4、每个问题采样 16 次、Adam、学习率 、weight decay 为 0.1、启用 TIS。所有四个 harness 的实验都用 prefix merging,在干净运行环境里评价最终补丁。
这张表明确省略了集群拓扑和 worker placement。因而它足以解释优化设置,但不能独立重建绝对吞吐量的硬件条件。附录 A.3 的代表性请求则写了 8 个样本和 1,200 秒超时,那是展示 API 的例子,不能直接拿来覆盖 A.2 的真实训练超参数。
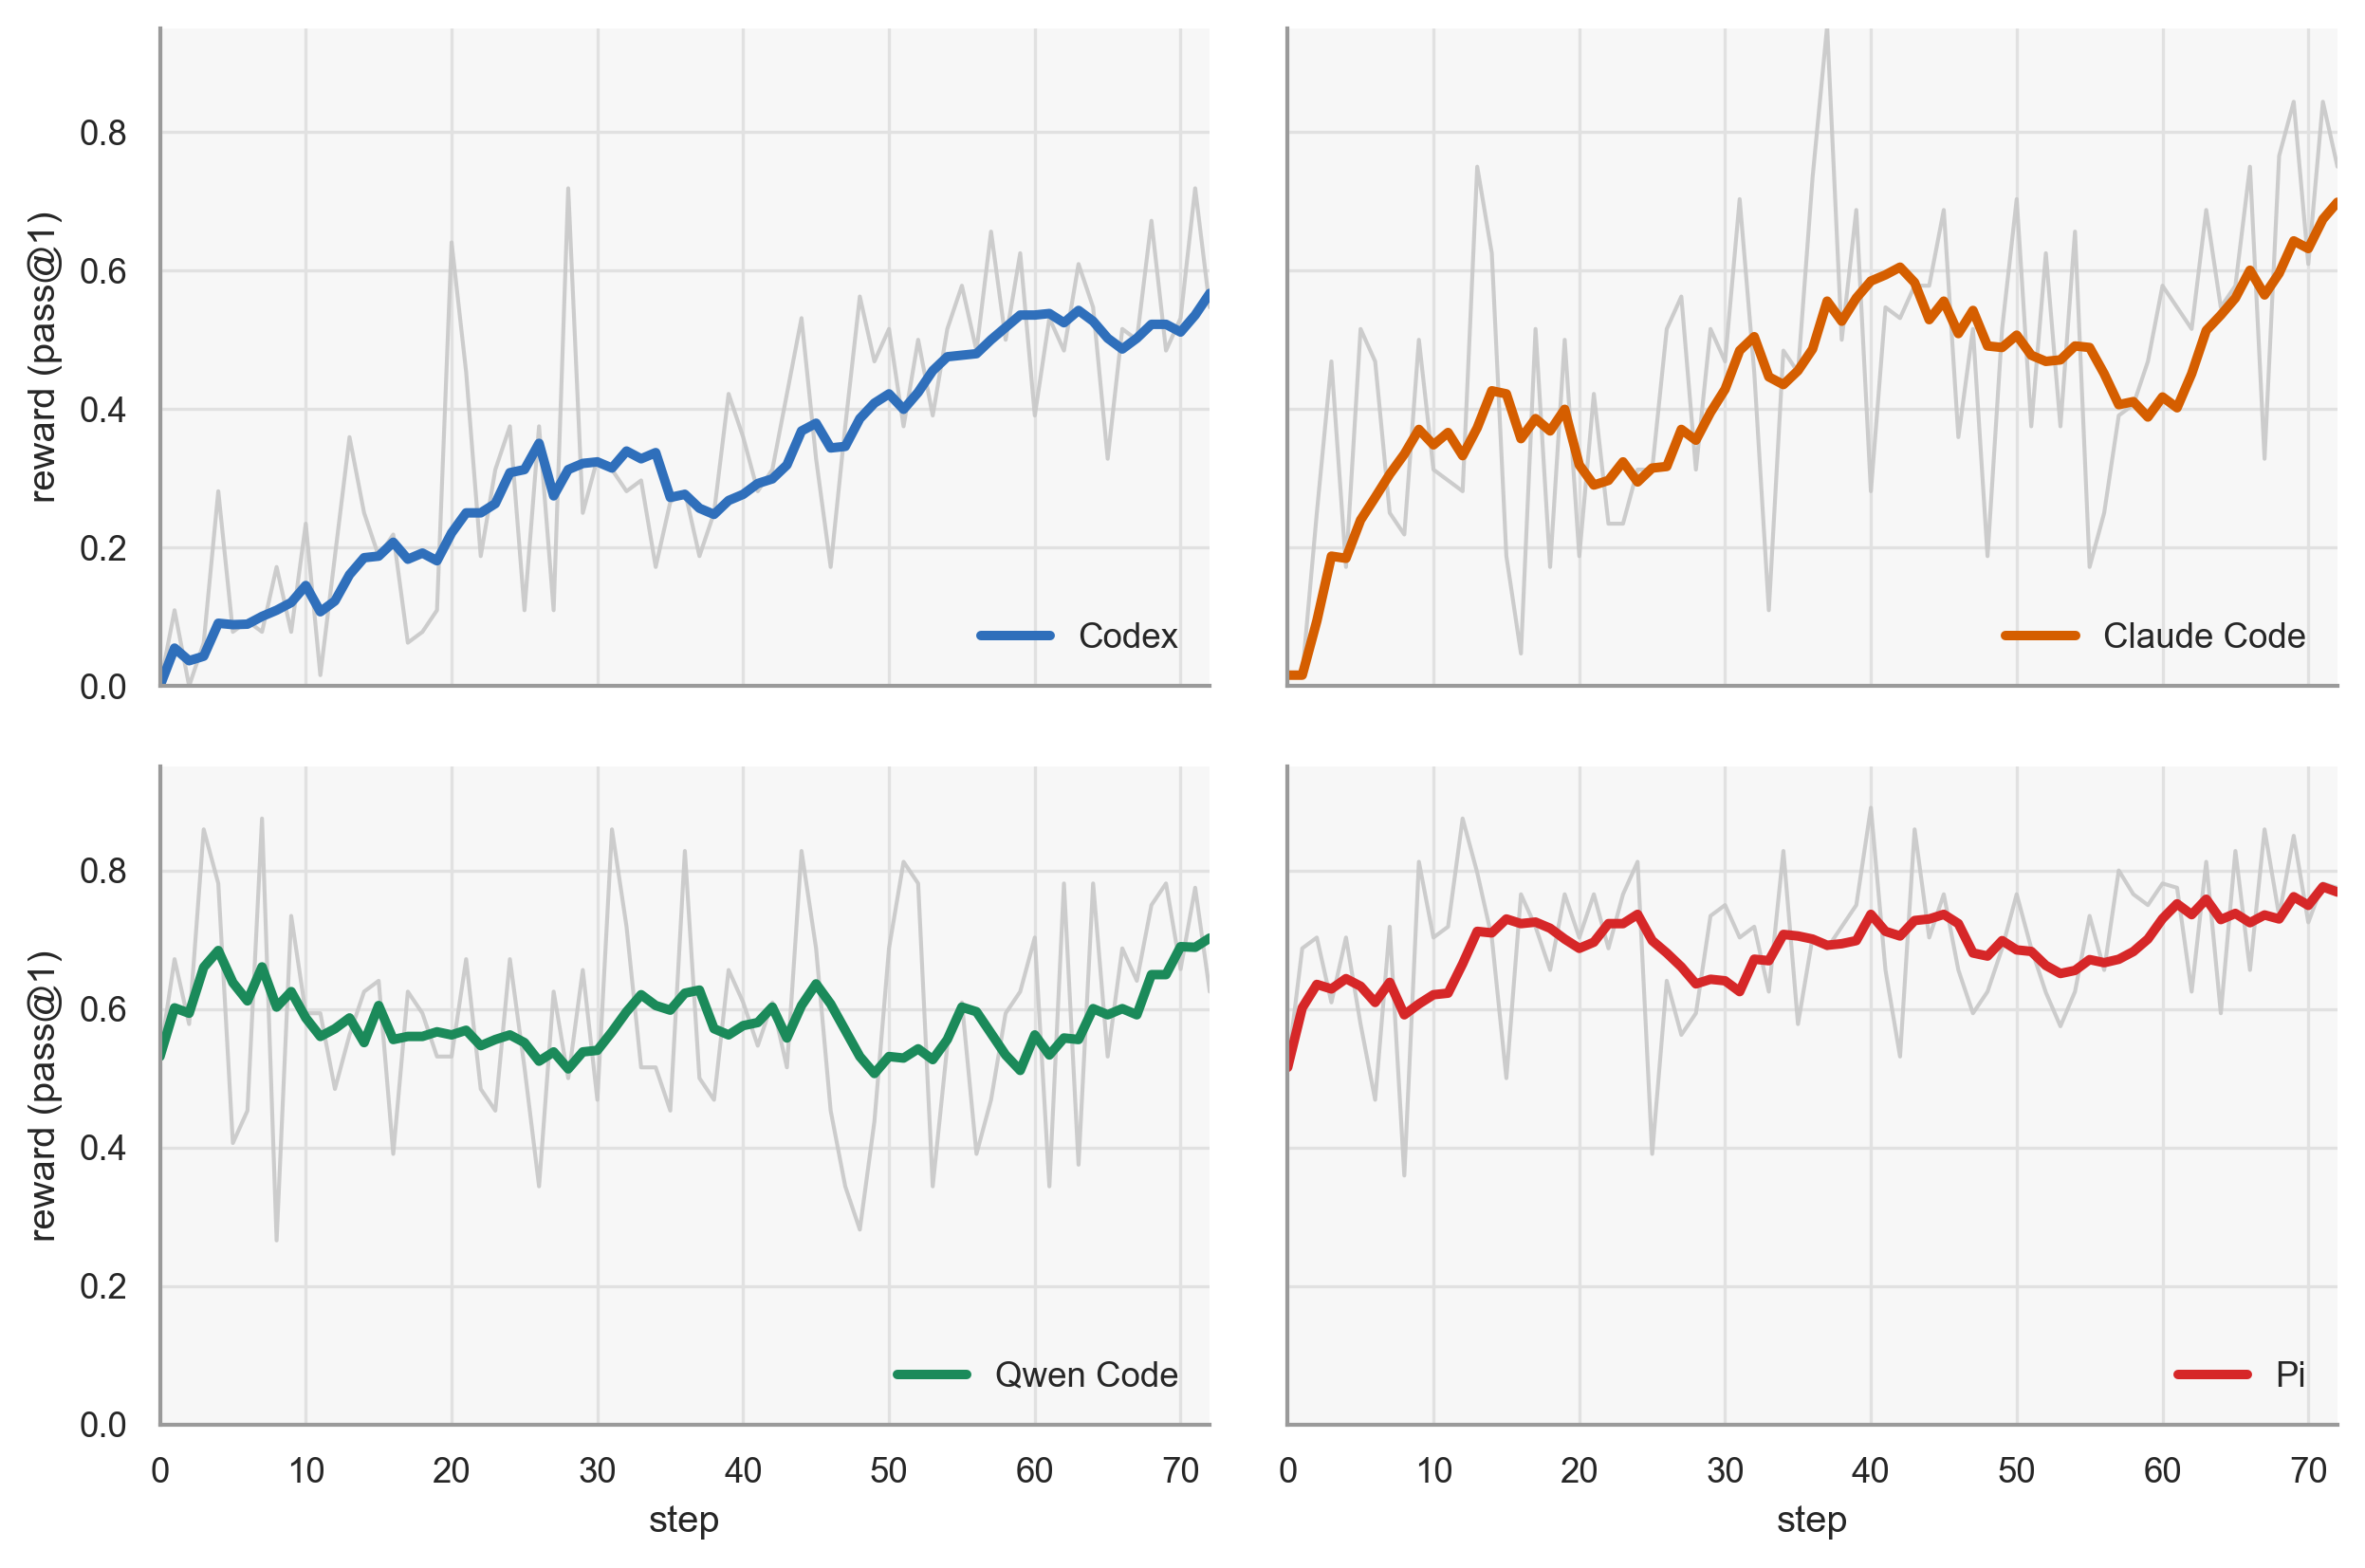
作者比较了最初十步和最后十步的平均奖励。Codex 从 9.5% 到 54.5%,Claude Code 从 28.8% 到 67.0%,Qwen Code 从 61.6% 到 66.0%,Pi 从 61.6% 到 76.2%。这些结果至少说明:保持原生接口后,代理捕获与轨迹重建所产生的数据能够驱动学习。至于泛化提升有多大,还要看另一个数据集上的评价。
7.2 测试集上,最大收益来自哪个起点
表 1 使用各自对应的 harness,在 SWE-Bench Verified 上比较 base 与训练后模型。原文报告:
| Harness | Base | Polar RL | 绝对提升 |
|---|---|---|---|
| Codex | 3.8% | 26.4% | 22.6 个百分点 |
| Claude Code | 29.8% | 34.6% | 4.8 个百分点 |
| Qwen Code | 34.6% | 35.2% | 0.6 个百分点 |
| Pi | 34.2% | 40.4% | 6.2 个百分点 |
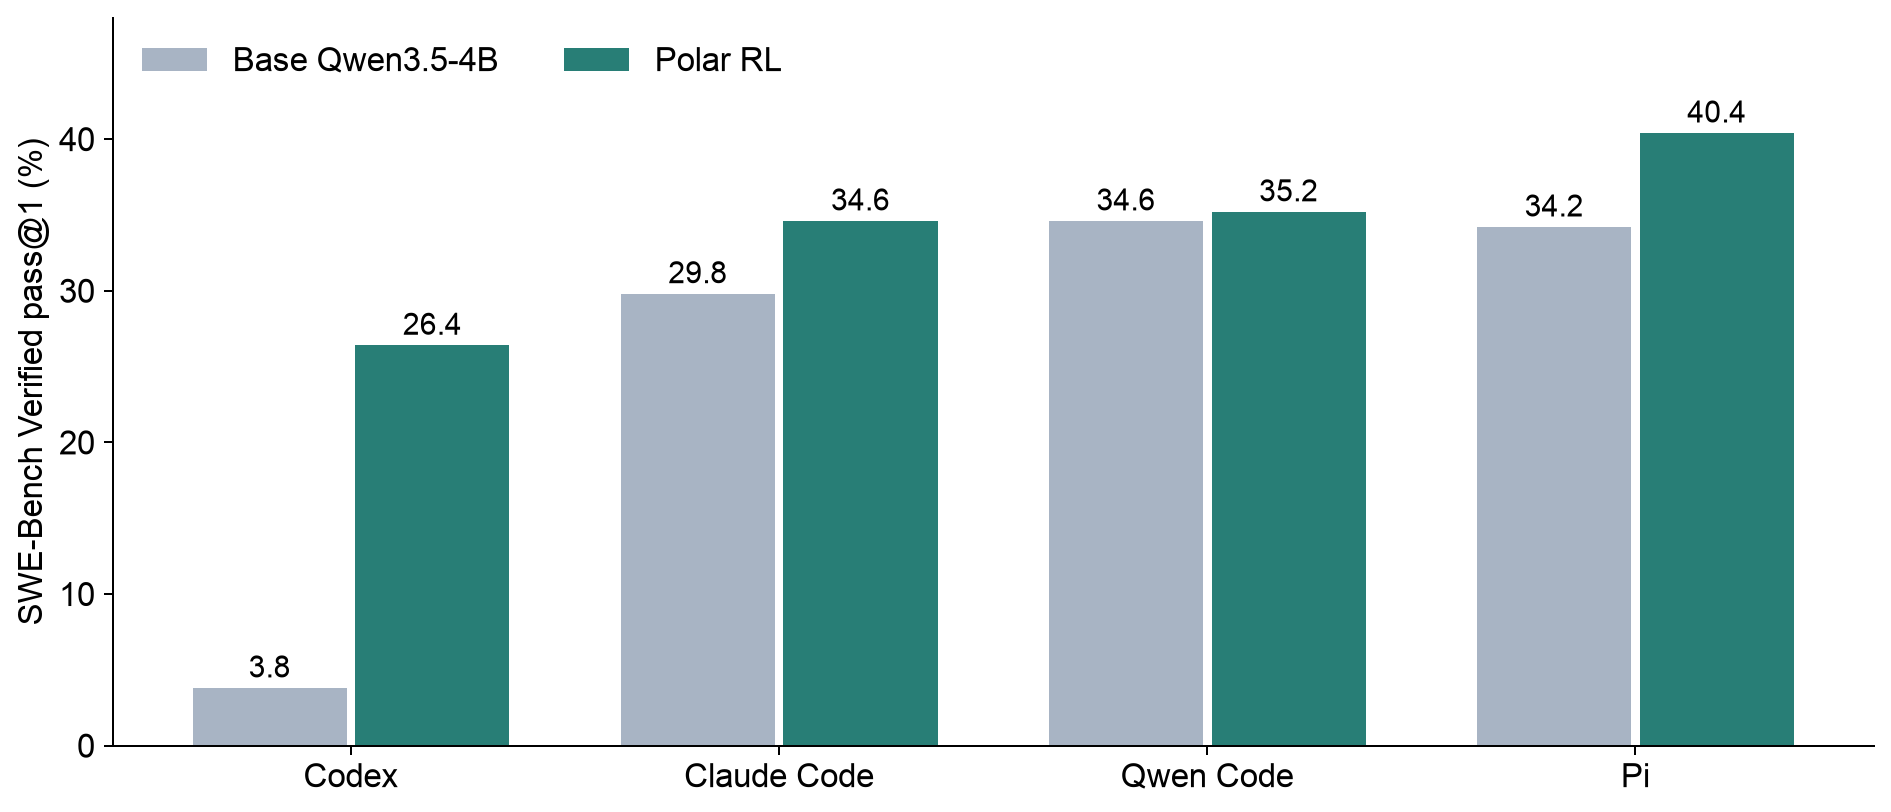
Codex 起点只有 3.8%,提升最大。作者认为,这是因为 Qwen 模型原先不熟悉 Codex 的动作协议、上下文规则和补丁提交风格。在这个接口中训练,能直接优化实际使用时需要的行为。我认为这种解释合理,却仍属于机制解释,不是已经通过控制实验隔离出来的因果结论。
如果想区分“学会这个 harness 的格式”和“问题求解能力获得普遍提升”,可以把每个训练后 checkpoint 都放到四个 harness 下评价,形成交叉矩阵。若只在训练接口提升,更多说明接口适应;若在其他接口也稳定提升,才进一步支持能力迁移。论文当前表格没有完成这一步。
Qwen Code 的 0.6 个百分点也需要谨慎解读。没有重复种子、逐任务配对比较和不确定性区间时,可以说原文记录了一次正向差异,却不能自动升级为稳定、显著的提升。对于 Codex,极低基线会放大相对倍数,因此更应先看 22.6 个百分点这个绝对差值。
7.3 5.39 倍收益的分母究竟是什么
轨迹重建消融是在相同模型、硬件与拓扑下,比较 per-request 和 prefix merging。原文取三个训练步骤的窗口,报告前者产生 1,185 个请求级更新单位、耗时 189.5 分钟;后者产生 218 个合并轨迹单位、耗时 35.2 分钟。对应的平均 rollout GPU 利用率是 20.4% 与 87.7%。
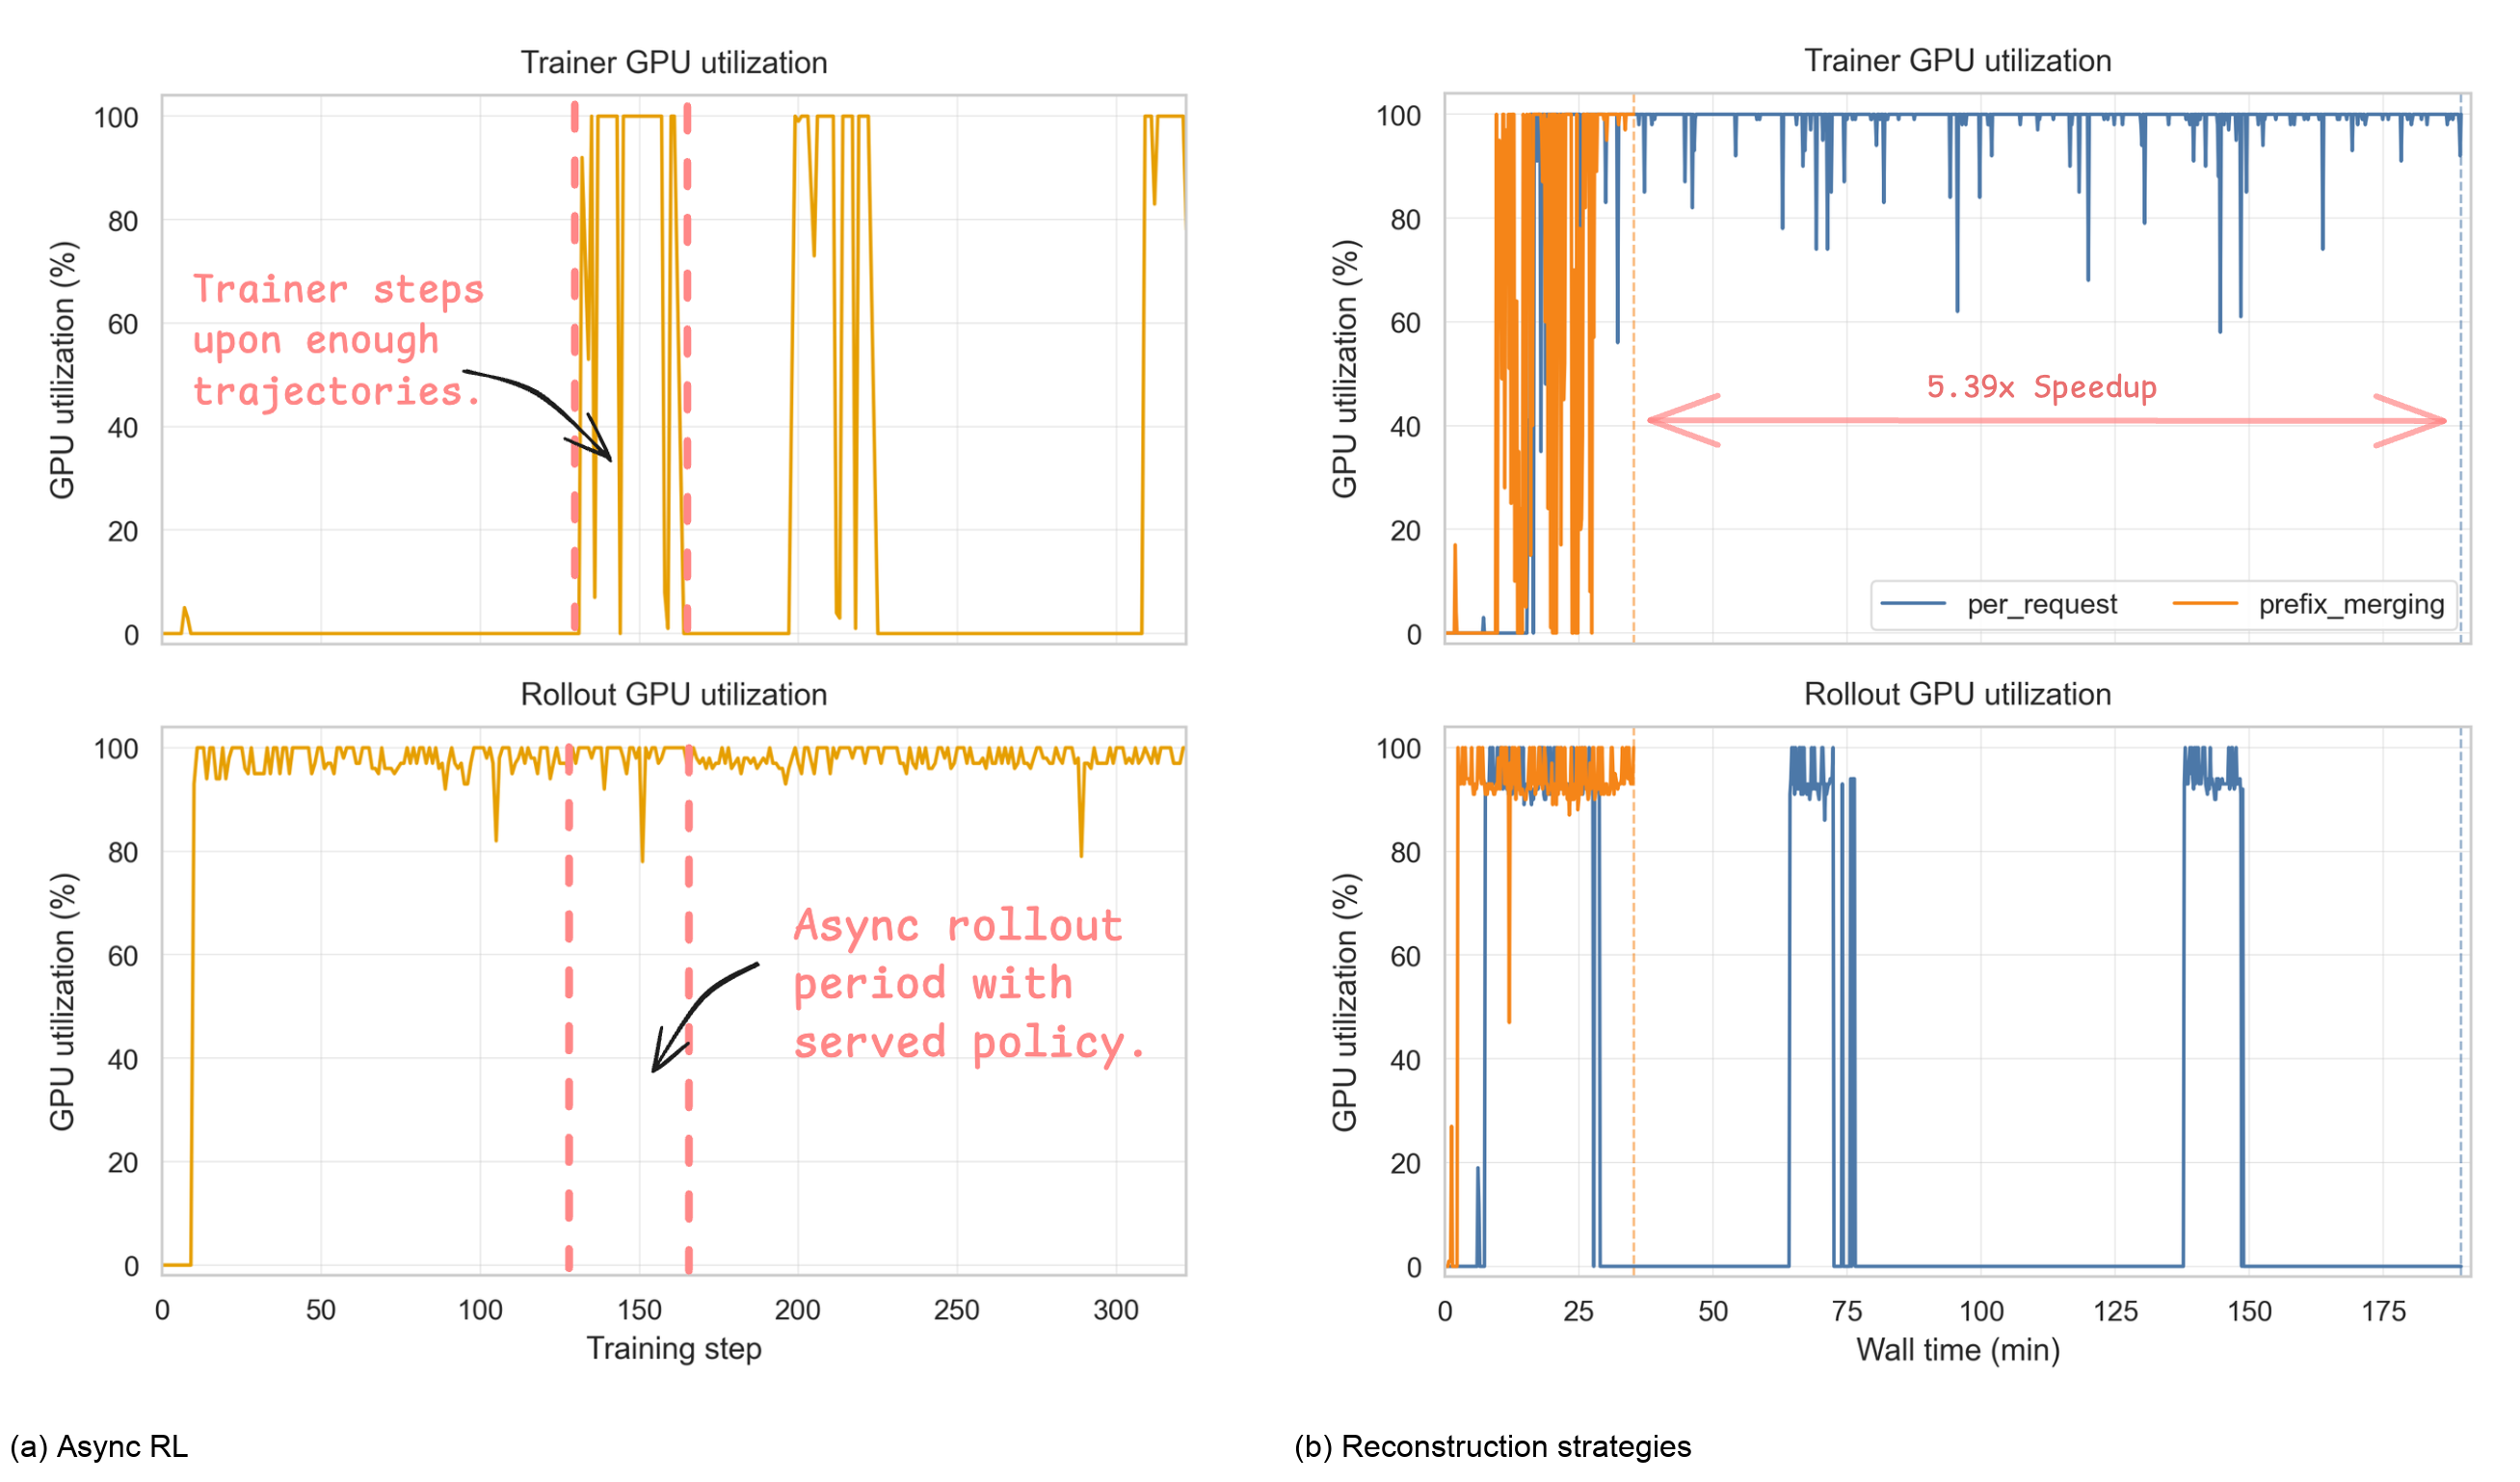
我对表述中的数量与时间做了简单复算:
作者写 5.39 倍,用已四舍五入的时间计算约为 5.384 倍,这只是小的舍入差别。更重要的是,训练单位减少比例和总时间减少比例非常接近。它提示重建策略带来的主要机制可能包含“显著减少交给训练器的单位数量”,不能据此宣称相同优化工作量下,某个计算核心快了五倍。
这里总时间除以单位数,仅是帮助理解的记账比率。由于推理和训练重叠,9.59 秒与 9.69 秒不能当作单条 trace 的独立实测延迟。合并减少重复前缀、减少调度碎片,本身可能就是合理收益;但评价效率时,应明确保持不变的是 session、采样动作 token、包含上下文的训练 token、优化器更新次数,还是最终任务质量。
我最希望看到的补充结果,是多个随机种子下达到同一测试得分所需的时间和 GPU-hours。这样,系统利用率、样本组织方式与学习效果才能落到同一条证据链上。单看更高利用率,无法判断模型是否以同样的目标学到了同样多的东西。
8. 离线轨迹生产:过滤器有效,但表格分母需要澄清
离线案例使用单个 8×H100 的 SGLang 服务,教师模型为 Qwen3.5-122B-A10B,TP 为 8,最大模型长度 32,768,harness 是 pi-coding-agent v0.67.68。每个任务放在独立 Apptainer 环境,镜像包含 Node.js 22。并发为 5–8,超时 3,600 秒,空生成允许重试一次。不要把这些设置写成前面 4B 在线 RL 的配置。
过滤标准比较直接:最终补丁必须让所有 FAIL_TO_PASS 测试通过,同时保持所有 PASS_TO_PASS 测试通过。原文称 1,638 次尝试留下 504 条轨迹,接纳率 30.8%,总资源约 64 GPU-hours。保留轨迹平均 104 条消息、51 次助手轮次,长尾超过 200 轮。公开数据按仓库分层做 90/10 划分。
但是,表 2 的行与总计之间存在可直接复算的不一致:
七行成功数之和确实是 504,但七行尝试数只得到 1,589,比总计少 49。pandas 行写 477 次尝试、98 次成功,却给出 19.7%,也不符合这两个整数。PDF 与 HTML 中都能看到这些数字。这是报告口径需要澄清,不应由读者猜测究竟是重试、漏行还是排版错误。
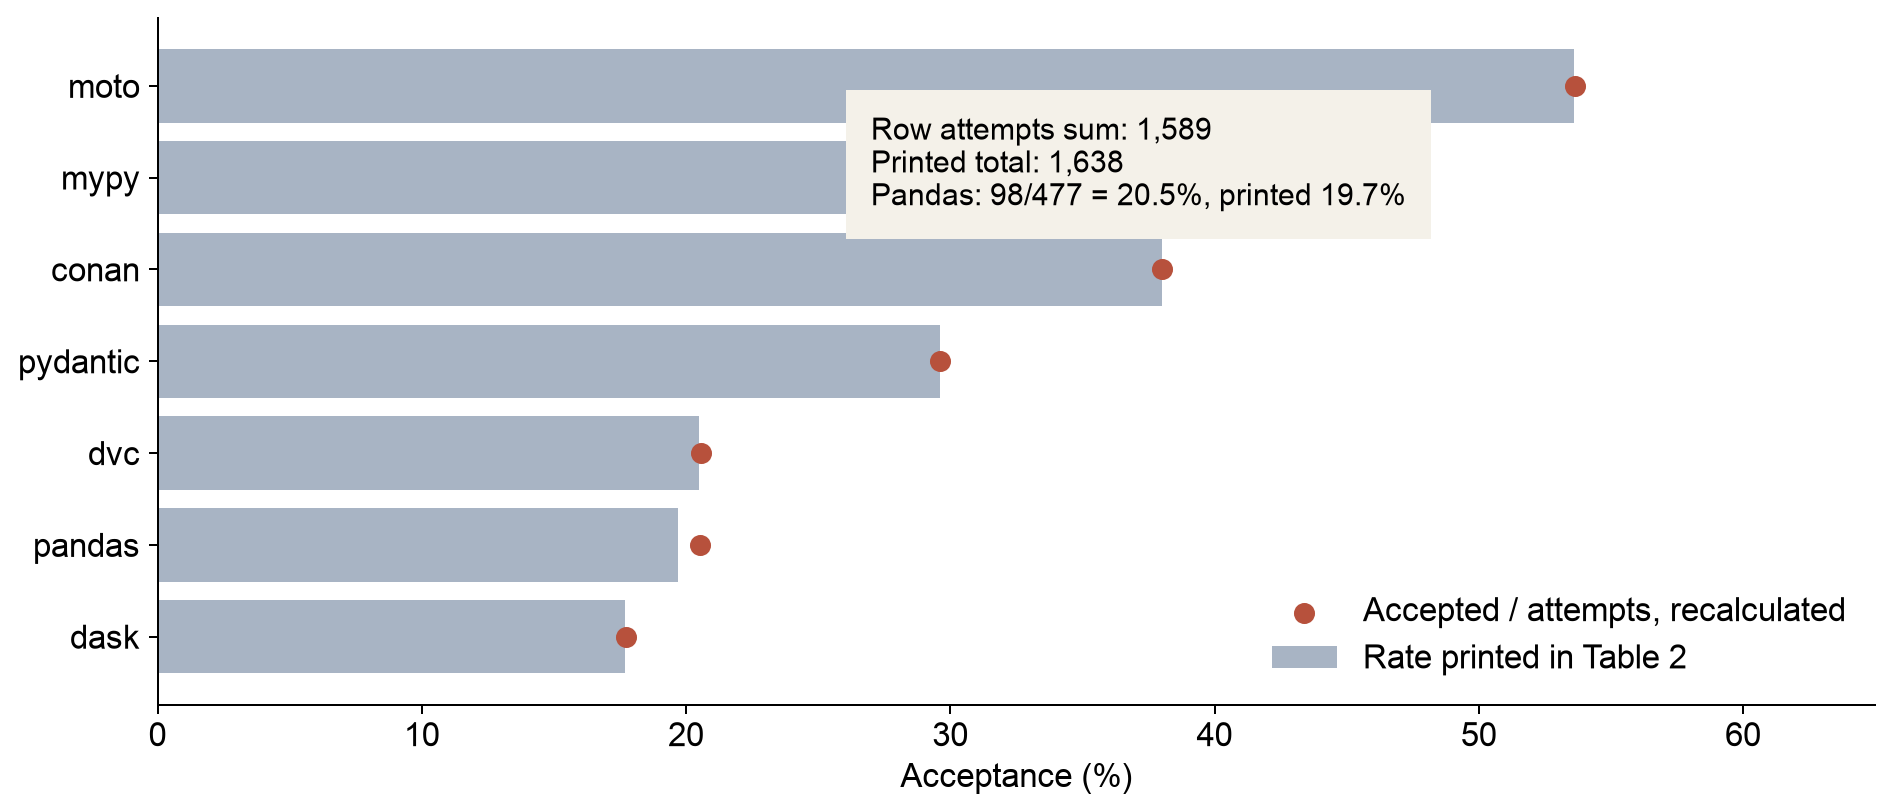
如果采用总计,504/1,638 约为 30.8%;如果采用行和,504/1,589 约为 31.7%。两个结果对应不同分母,不能不加说明地选择更好看的一个。类似地,64 GPU-hours 除以 504,约为每条接纳轨迹 7.62 GPU-minutes。这只是原文总资源的平均比率,不是单次任务的墙钟时间,也没有证明包含全部 CPU、容器和存储开销。
过滤成功补丁,是生产可用监督数据的一步,却不保证轨迹中的每次探索都必要。一个最终通过测试的 session,内部仍可能有冗余调用和无效修改。仓库分层也只能保证各仓库都有样本,不能自动排除相似 issue、重叠文件或同源补丁。要判断数据对 SFT 真正有多大帮助,还需观察下游训练结果,而不只看留下了多少条轨迹。
9. 设计取舍:选择一种边界,就要承担相应条件
我把几个核心设计放在一起比较。这里没有一种方案在所有目标上都占优;要看我们希望减少接入工作、保留上下文,还是优先控制运行资源。
| 选择 | 主要理由 | 替代方案与失败边界 |
|---|---|---|
| 模型 API 代理 | 跨原生程序边界接入 | 进程内记录可获取更多状态,但要修改接入方式 |
| per-request | 保留每次调用原提示 | 合并可减少碎片,但需兼容历史 |
| 独立后处理池 | 测试不占用执行槽 | 单池简单,却混合不同阻塞成本 |
| 干净评价环境 | 减少 agent 修改的干扰 | 复用工作环境更省资源,但可能污染评价 |
| 终局补丁奖励 | 直接对应任务结果 | 过程奖励更细,却可能引入 judge 误差 |
附录 A.1 的框架比较表是作者对不同系统设计合同的归纳,不是我独立确认的性能排名。作者自己也用部分支持标记,解释了模型 gateway、通用可观测性、完整运行环境生命周期服务之间的区别。应从这张表理解 Polar 在解决哪一层问题,而不是把每个叉号解释为其他系统绝对做不到。
异步系统还要回答策略新鲜度由谁管理。Polar 的样本带 policy-version 信息,训练器决定如何消费。但是,有一个版本字段,不等于一个很长的 session 的所有 token 都来自同一个固定 checkpoint。如果推理服务中途更新权重,多次调用可能来自不同策略。逐 token 的行为概率很有帮助,前提是它们确实与当时动作一一对应,且训练器使用适合的估计方法。
另外,异步回传会改变模型先看到什么。短任务较早完成,难题可能长期停留在执行或测试阶段;若训练器总是消费最先凑齐的组,早期更新就可能偏向快题。超时、重试和丢弃陈旧样本的策略,会进一步影响分布。这不是反对异步,而是说明吞吐指标之外,还需要看到任务、时长、奖励和策略年龄之间的联合关系。
10. 局限:论文验证的范围与这篇笔记的范围
在线验证集中在四个编码 harness 和一个 4B 模型,离线案例则换成较大的教师模型。支持某类多模态 API,不等于已经完成相应 GUI 或视觉动作训练实验。“任意 harness”是架构目标,论文提供了一组有价值的例子,尚不能视为所有应用语义都已覆盖。
系统评价主要给出一个三步窗口,没有完整报告多集群规模的扩展性、尾延迟、资源隔离和故障恢复。缺少在线硬件拓扑与 worker 配置,也限制了绝对性能比较。四个测试集差值没有重复训练种子和配对不确定性报告,尤其最小的 0.6 个百分点,不应夸大为普遍稳定收益。
离线结果的尝试数与 pandas 行接纳率存在内部算术不一致。在澄清前,可以保留生产流程与已报告结果,却不适合进一步做精确成本比较。对于 reward hacking 的观察,原文也没有给出足够细的定量过程证据来完整定位每种失效机制。
本笔记阅读了 17 页全文及附录 A.1–A.5,核对原图、表格与印刷数字。排队容量模型、策略梯度解释、权重比较和手算例子是我的分析,不是额外的作者实验。这里没有运行训练、没有生成新的 benchmark,也没有把算术复算写成实验复现。
11. 批判性分析:我最想补强的三件事
11.1 把动作保真与上下文保真写成两个不变量
这是我认为最有技术价值的疑问。设后续动作原来使用的完整前缀是 ,合并序列中的前缀是 。若想把重要性比率解释为同一条件事件上的策略变化,需要
如果分子实际在 上计算,它和分母对应的就不是同一个条件事件。保留了正确的 ,也无法让不同的前缀自动相同。把规范化助手片段换回原始采样 ID,可能改变长度、位置以及后续 token 能关注的表示。loss mask 只管哪些位置直接承担损失,不会阻止这些位置影响之后的隐藏状态。
一个具体改进是提供严格模式:只有已经重建出来的每个后续前缀都等于原调用前缀,才允许合并;不满足就退回逐请求表示。更进一步,可以研究分段训练:每段仍使用自己原始的上下文,但共享确实兼容的前缀计算。这样可能降低重复成本,却需要作为另一种训练表示单独分析,不能直接套用一条扁平序列的解释。
这仍是条件性的批评。如果实际工作负载中 raw 与 canonical 历史恰好一致,反例就不发生;如果作者还有其他上下文恢复机制,也可以通过更清楚的合同消除疑问。最有说服力的补充,是报告前缀不一致频率,以及它对重算 log probability 的影响。这样能够回答“到底在哪些样本上精确,哪些样本上只是动作 ID 保真”。
11.2 让效率比较保持清楚的学习单位
我会固定同一批采样 session,同时报告原始生成动作数、包含上下文的处理 token 数、trace 数、实际 optimizer update 数、各阶段墙钟时间,以及最终测试质量。合并减少重复前缀,是合理收益;但减少训练单位若伴随归约权重改变,就应把它视为算法与系统共同变化,而不是纯粹的计算提速。
原文 1,185 对 218 的比例几乎解释了耗时比例,因此它其实给了一个很好的分析入口。若再补充损失归一化与奖励组构造,读者就能理解更少 trace 究竟是去掉重复工作,还是换了训练预算。随后比较达到相同 pass@1 的 GPU-hours,才更接近我们实际关心的训练效率。
11.3 让异步调度的统计代价可见
我希望同时看到策略年龄、session 时长、调用数、链条数和奖励的分布。长任务可能既更陈旧又更难成功,过强的陈旧样本过滤会改变训练集。评价器也应把基础设施异常与真正补丁失败分开返回,否则模型可能把容器或测试系统的不稳定当作自身行动的后果。
离线数据方面,最直接的改进是提供可对账的尝试记录,明确重试是否进入分母,修正表 2 的口径。其次,在仓库分层之外,按 issue 和补丁相似性排除泄漏,最后评价生成数据训练出的模型。成功轨迹条数是过程产物,下游能力才是这种数据生产方式的最终价值。
12. 可复核要点与结论
理解一次运行,至少要保留任务与 session 身份、harness 配置、模型身份、调用级行为信息、原始提示、采样 ID、mask、评价结果与终态。在线训练应参考附录 A.2,API payload 参考 A.3,离线生产设置参考第 4.2 节,三者不能混用。缺失的集群拓扑和训练归约细节,仍是后续精确比较资源效率时要澄清的问题。
我对 Polar 的主要收获是:让训练发生在实际要使用的 harness 中,并把训练数据合同放在模型边界,能解决很具体的系统接入摩擦。分阶段执行和原始 token 捕获,也分别对准了资源等待和重编码漂移。下一步最值得补强的,是合并后条件上下文的严格范围,以及重建单位变化后的奖励权重语义。把这两个条件说清楚,会使架构的可迁移性和效率证据更容易被其他研究延用。
参考资料与资源入口
- Xu 等:Polar: Agentic RL on Any Harness at Scale, v1。方法、原图 1–6、表 1–4 与附录 A.1–A.5 的一手来源。
- 论文给出的官方项目入口。
- 论文使用的 SWE-Gym 训练数据。
- 论文发布的离线轨迹数据。