笔记日期: 2026-10-31 · 作者: Zhongzhu Zhou
论文题名: KV-CoRE: Benchmarking Data-Dependent Low-Rank Compressibility of KV-Caches in LLMs
论文作者: Jian Chen, Zhuoran Wang, Jiayu Qin, Ming Li, Meng Wang, Changyou Chen, Yin Chen, Qizhen Weng, Yirui Liu
arXiv: 2602.05929 · 版本: v2,2026-02-07
1. 先问清楚:这里测的是哪一种“可压缩性”?
昨天读 iS-KV 时,一个问题始终没有消失:低秩缓存到底应该留多少个方向?留得太多,节省不了多少显存;留得太少,又可能丢掉后续推理需要的信息。更麻烦的是,同一个秩放到不同层、不同模型、不同语言上,效果未必接近。KV-CoRE 正是在研究这些差异,而不是直接给出一个适用于所有请求的压缩配置。
它的出发点很朴素:不要只分析权重矩阵,应该让真实数据经过模型,再看产生的 key 和 value 激活究竟使用了多少个方向。如果一个数据集的大部分激活集中在少数方向上,那么从向量重建的角度看,低秩近似就有机会保留大部分信息。反过来,如果奇异值分布很均匀,删掉任何一批方向都会付出较明显的重建代价。
因此,这篇论文首先是一套诊断与评估框架。它计算数据相关的奇异值谱,构造低秩投影,再观察模型在截断后的变化。它并没有证明任意低秩缓存都会让推理更快,也没有给出“某个有效秩对应某个安全压缩率”的通用规则。读它时,最重要的是把“表示存在冗余”“能压缩到多少”“压完回答是否可靠”“实际运行是否加速”分开讨论。
这也解释了它与 iS-KV 的联系和差别。iS-KV 面对持续到来的 token 块,需要维护一个已经截断的历史缓存;基底改变时,旧坐标也要一起更新。KV-CoRE 则把数据集中的激活汇总成完整的特征 Gram 矩阵,最后再分解。前者需要处理过去已经丢掉的信息,后者保留的是足以恢复最终奇异值谱的完整二阶统计量。两者都用到低秩几何,但承担的任务并不相同。
论文里最有价值的观察包括:key 往往比 value 更集中;不同层的秩分布并不一致;KV 头数和宽度会明显影响结果;归一化有效秩与某种困惑度退化指标呈正相关。这些现象值得继续研究。不过,在全文与附录中,也能看到若干需要澄清的实验描述和表格汇总。下面会保留这些边界,不把推测写成结论。
本笔记中的模型实验数值全部来自原论文。用于解释概念的小矩阵、显存算术和表格均值复算,会明确标注为本文计算;它们不代表新增模型实验或复现结果。
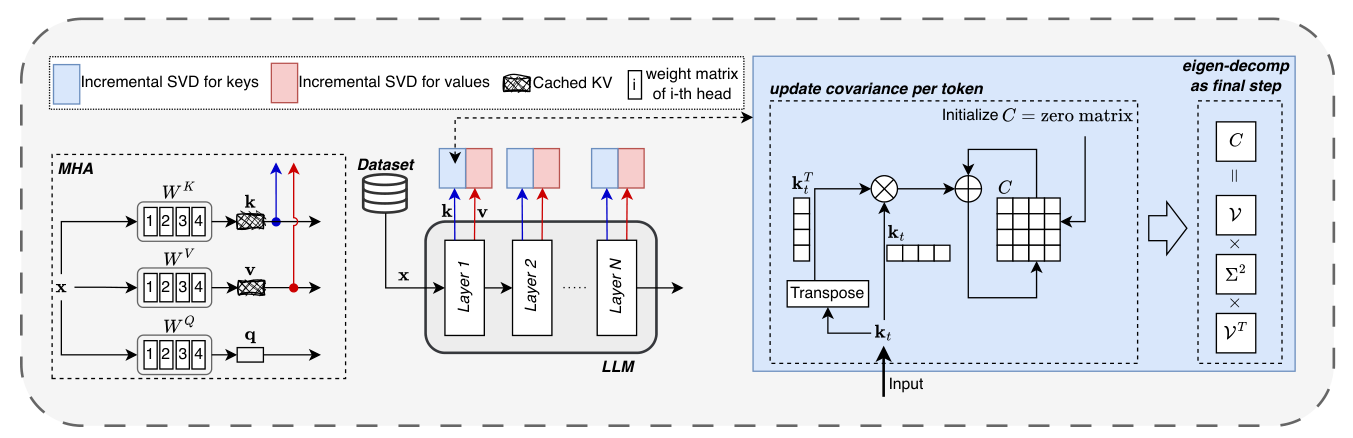
图 1. 截取自论文第 3 页 Fig. 1。右侧流程累加外积,并在最后进行特征分解;这是数据集级奇异值谱的计算基础。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
2. 前置知识:缓存、特征维度与数据相关压缩
2.1 先把矩阵的行和列说清楚
考虑某一层。序列长度为 ,实际存储的 KV 头数为 ,每个头的宽度为 。把这些头的特征拼接起来,得到总宽度 ,于是 。矩阵的一行对应一个 token,一列对应一个特征坐标。
对于一个数据集,可以把多个样本产生的激活按行收集起来,分析共同的特征空间。这里的“收集”只用于统计,不是让不同样本的 token 互相做注意力。真正评估模型时,样本仍然保持各自的因果上下文。这一点很重要,否则容易把跨样本的统计操作误解成改变模型的注意力范围。
但样本如何汇总,仍然会改变结果。如果直接纳入全部 token,长样本自然会贡献更多行,相当于获得更高权重。如果希望每个样本或每种语言具有相同权重,就需要另行定义采样或加权规则。所谓“某数据集的秩”,从来不是脱离采样方式的唯一常数。
对于单个注意力头,假设位置处理已经包含在 query 和 key 中,有
缓存让历史 key/value 不必重复计算,却不意味着它们不再需要被读取。解码时,新的 query 仍然要访问历史信息。因此,减少持久存储有可能缓解容量压力,但能否缩短时间,还取决于读取、恢复、更新和计算的总开销。
如果一个标量占 字节,模型有 个同宽层,那么单条序列的普通 KV 缓存大致为
其中的 2 来自 K 和 V 两条路径。实际系统还会有分配、对齐和元数据开销。对于 GQA,必须使用物理 KV 头数,而不是更多的 query 头数;否则会先把原始缓存估得过大,再得到一个虚高的压缩收益。
2.2 为什么不能只看投影权重的奇异值?
设 。这里 是隐藏状态, 是 key 投影。若直接近似 ,通常是在权重空间中控制误差;KV-CoRE 关注的则是经过真实输入后,激活 的误差。
令 ,那么
这个式子说明,激活误差是由 加权的。某个方向即使在权重里误差不小,如果真实输入很少激活它,最终影响也可能有限;另一个方向的权重误差不大,却可能因为被频繁使用而产生更明显的偏差。因此,权重空间里“同样大小”的两份误差,对实际数据未必等价。
数据相关方法的优势也带来了边界。某个基底在校准数据上很好,不代表它在另一个领域仍然好。医学文本、代码、不同语言或混合语言请求,可能使用原来较弱的方向。所以,在谈一个基底是否合适时,必须一起说明它是用什么数据拟合的、准备在什么数据上使用。
3. 最优性结论究竟保证了什么?
3.1 从截断 SVD 开始
设 的非零奇异值为 ,薄 SVD 写成 。这里用 表示右奇异向量,避免与 value 缓存 混淆。 和 的列向量分别正交归一。
保留最大的 个奇异值及其对应方向,就得到 。经典低秩近似结论告诉我们:
可以把这个结论理解成一次坐标变换。先转到奇异向量坐标系,Frobenius 范数不会因为正交变换而改变。此时矩阵的主要信息集中在对角线,平方能量就是各奇异值平方的总和。在只能保留 个独立方向的条件下,留下最大的那些方向,自然会使剩余能量最小。若关注谱范数,截断后的残差则为 。
“最优”之所以成立,是因为目标函数和可行集合已经写得很明确:目标是重建这个矩阵,可行集合是秩不超过 的矩阵。这里没有直接优化回答正确率,也没有考虑某个罕见 query 会不会恰好需要被删除的方向。把它读成“最优推理压缩”就超出了定理的范围。
3.2 如何把激活的最优近似写回投影形式?
论文给出的构造是
其中 是到保留子空间的正交投影。将它代入激活计算,可逐步得到
第三行到第四行使用了正交性: 只选出前 个奇异方向。同时, 的秩至多为 。所以,这个权重构造既满足秩约束,又在当前 上达到最优的激活重建误差。整个推导不需要梯度训练。
这里采用“秩至多为 ”,是为了包含原矩阵已经秩不足的情况。另外,这个最优权重也未必唯一。若某些权重变化落在 的零空间里,它们不会改变当前数据上的激活。论文给出了一个达到最优的构造,并不意味着世界上只有这一组权重可以达到同样误差。
一个容易忽略的条件是: 在这个优化问题中被视为固定。当多层投影都发生改变时,上游的误差会改变下游隐藏状态,原来用于拟合的 不一定还是新模型实际产生的 。这也是为什么局部最优性之后仍然需要端到端评测,而不能只检查每层的重建残差。
3.3 数学上能分解,工程上不一定直接省时
把投影分成 和 后,可以设想每个 token 只缓存 个坐标。但如果最终仍然把恢复后的稠密 放进缓存,持久存储并不会减少。如果只存坐标,却在每次注意力计算前恢复整段稠密历史,那么持久缓存可能变小,临时工作区和计算时间却未必变好。
头的结构还会增加限制。KV-CoRE 是把多个 KV 头的特征拼接后再做分解,因此一个奇异方向可能混合不同头的信息。标准注意力核通常按头组织 key、value 和 softmax。一个跨头的联合基底,并不会自动变成可以直接塞进现有融合算子的张量布局。
另一种选择是分别对每个头压缩,或者把投影限制为块对角形式。这样更容易保留原来的头结构,但允许选择的子空间也更少。在相同总秩预算下,联合 SVD 的最优性不能直接移植到这个受约束问题。联合谱揭示的是潜在冗余;实际能高效利用多少冗余,还要看表示和算子的限制。
位置编码同样不能跳过。若 是位置相关的旋转, 是投影,一般有 。因此,在 RoPE 之前估计的低秩子空间,不能未经说明就搬到 RoPE 之后使用。任何实际压缩方案都需要说清楚收集的是哪一个位置的激活,以及位置相关部分怎样保存。附录 A 对潜在注意力和位置分支的介绍有助于理解这个问题,但不能替代针对具体模型的等价性推导。
4. “增量”到底增量在哪里?
4.1 不保存全部激活,也能拿到右奇异向量
假设整个数据集一共产生 行激活。直接保存 ,开销会随 token 数不断增长。但我们真正需要的右奇异向量和奇异值,可以从一个 矩阵恢复:
如果把 按行分成若干块 ,那么
这里没有跨块的交叉项。原因是我们把不同块按行堆叠,左边再乘转置,得到的恰好是每一块外积之和。对于单个 token 的行向量 ,更新就是 。实际计算时,用块矩阵乘法通常比逐 token 循环合理,但两者对应的是同一个统计量。
所有数据处理完后,令 ,便有 ,从而 。整个过程中,不需要保存全部左奇异向量,也不需要保留全部 token 激活。只要完整的 Gram 矩阵被保留下来,在精确算术中就能恢复完整谱。
算法 1:收集数据集谱并构造秩 k 投影
下面的伪代码按数学过程描述,并把容易影响结果的数值选择显式列出。
输入:冻结模型、数据批次、指定层与 K/V 路径、保留秩 k
1. 用选定的累加精度初始化 d×d 零矩阵 C。
2. 对每个批次运行模型,收集有效 token 的激活矩阵 A。
3. 排除 padding,并确认收集的是约定的位置编码前/后表示。
4. 更新 C <- C + transpose(A) * A,随后释放 A。
5. 对称化 C <- (C + transpose(C)) / 2。
6. 对 C 做特征分解,按特征值从大到小排序。
7. 根据数值容差检查负特征值,不能直接忽略明显异常。
8. 仅将合理的舍入误差置零,再对特征值开平方。
9. 记录数值秩规则、完整谱和有效秩指标。
10. 保留 B_k;需要时返回 W * B_k 与 transpose(B_k)。
输出:数据集谱、诊断指标和低秩投影因子
论文称它为 incremental SVD,但展示的算法核心是累加 Gram 统计量,最后才做特征分解。它不是每来一批数据就截断一次基底,也不会持续修正一份已经低秩化的历史坐标。若把完整 换成低秩草图,确实可能进一步省内存,却会改变精确性结论,把近似误差引入诊断过程本身。
4.2 内存不随 token 数增长,不等于没有开销
累加 行的计算量约为 ,最后稠密特征分解约为 。持久统计量占 ,另加一个批次的激活缓冲。与保存整个数据集相比,它对长度友好;但对特征宽度仍然是平方级存储、立方级分解。
用 FP32 做一个算术示例: 时,单个 Gram 矩阵占 4 MiB; 时占 64 MiB。如果后者的 K、V 两条路径在 32 层同时保留,就需要 4 GiB,仅仅用于这些统计矩阵。 时,单个矩阵则为 0.25 MiB。这些是本文的存储估算,不是论文测得的峰值显存。分批处理层可以降低同时占用,但可能需要更多次模型前向。
此外,论文虽然使用 covariance 一词,展示的式子实际上是未中心化二阶矩 。擅自减去均值,会改变谱和原来的重建目标。如果采用中心化表示,均值本身也需要保存并加入恢复过程,不能把它当成一个不影响问题的预处理步骤。
最后,Gram 矩阵会把条件数平方。较小的奇异方向可能更难与数值零区分。因此,累加精度、特征值容差和数值秩阈值都应随结果一起报告。对舍入产生的极小负特征值做修正是合理的;把明显为负的值全部静默截成零,则可能掩盖真正的数值问题。
5. 归一化有效秩:有用的摘要,不是现成的秩预算
5.1 从奇异值分布得到熵
KV-CoRE 将非零奇异值的大小归一化,构造一个概率分布,再计算熵:
对熵取指数,得到有效秩;再除以矩阵的秩,得到论文使用的归一化有效秩 NER:
这里特别容易弄错的是:归一化对象是奇异值本身,不是奇异值的平方。如果手头先拿到的是 Gram 矩阵的特征值,需要先开平方,再组成 。直接把特征值归一化,会得到一种基于能量的熵指标,但它不是论文这里定义的 NER。
如果 个非零奇异值完全相等,那么 ,熵为 ,有效秩为 ,NER 为 1。如果绝大部分质量集中在一个奇异值上,而其余 个仍然为正,那么熵趋近于 0,有效秩趋近于 1,NER 趋近于 。因此,它描述的是非零方向之间的分布是否均匀。
把整个矩阵乘以一个非零标量,不会改变这些比例;做正交坐标变换,也不会改变奇异值。NER 因而对整体尺度和正交方向不敏感。这很适合比较谱的集中程度,却也意味着它主动丢掉了一些信息:一个方向的绝对幅度、以及它与未来 query 的对齐关系,都可能影响实际误差。
5.2 一个反例:NER 等于 1,也可能非常容易压缩
图 2 展示了三个纯数学例子。八个相等的奇异值,有效秩为 8,NER 为 1。对于 ,有效秩约为 3.96,NER 约为 0.494。第三个例子只有两个相等的非零奇异值,其余六个严格为零,此时有效秩为 2,实际秩也是 2,所以 NER 又回到了 1。
但第三个矩阵明明可以用两个维度无损表示。为什么“最高 NER”还可以这么容易压缩?因为分母是非零秩,而不是外部特征宽度。NER 告诉我们这两个非零方向分得很均匀,却没有告诉我们周围还有多少个完全没使用的维度。
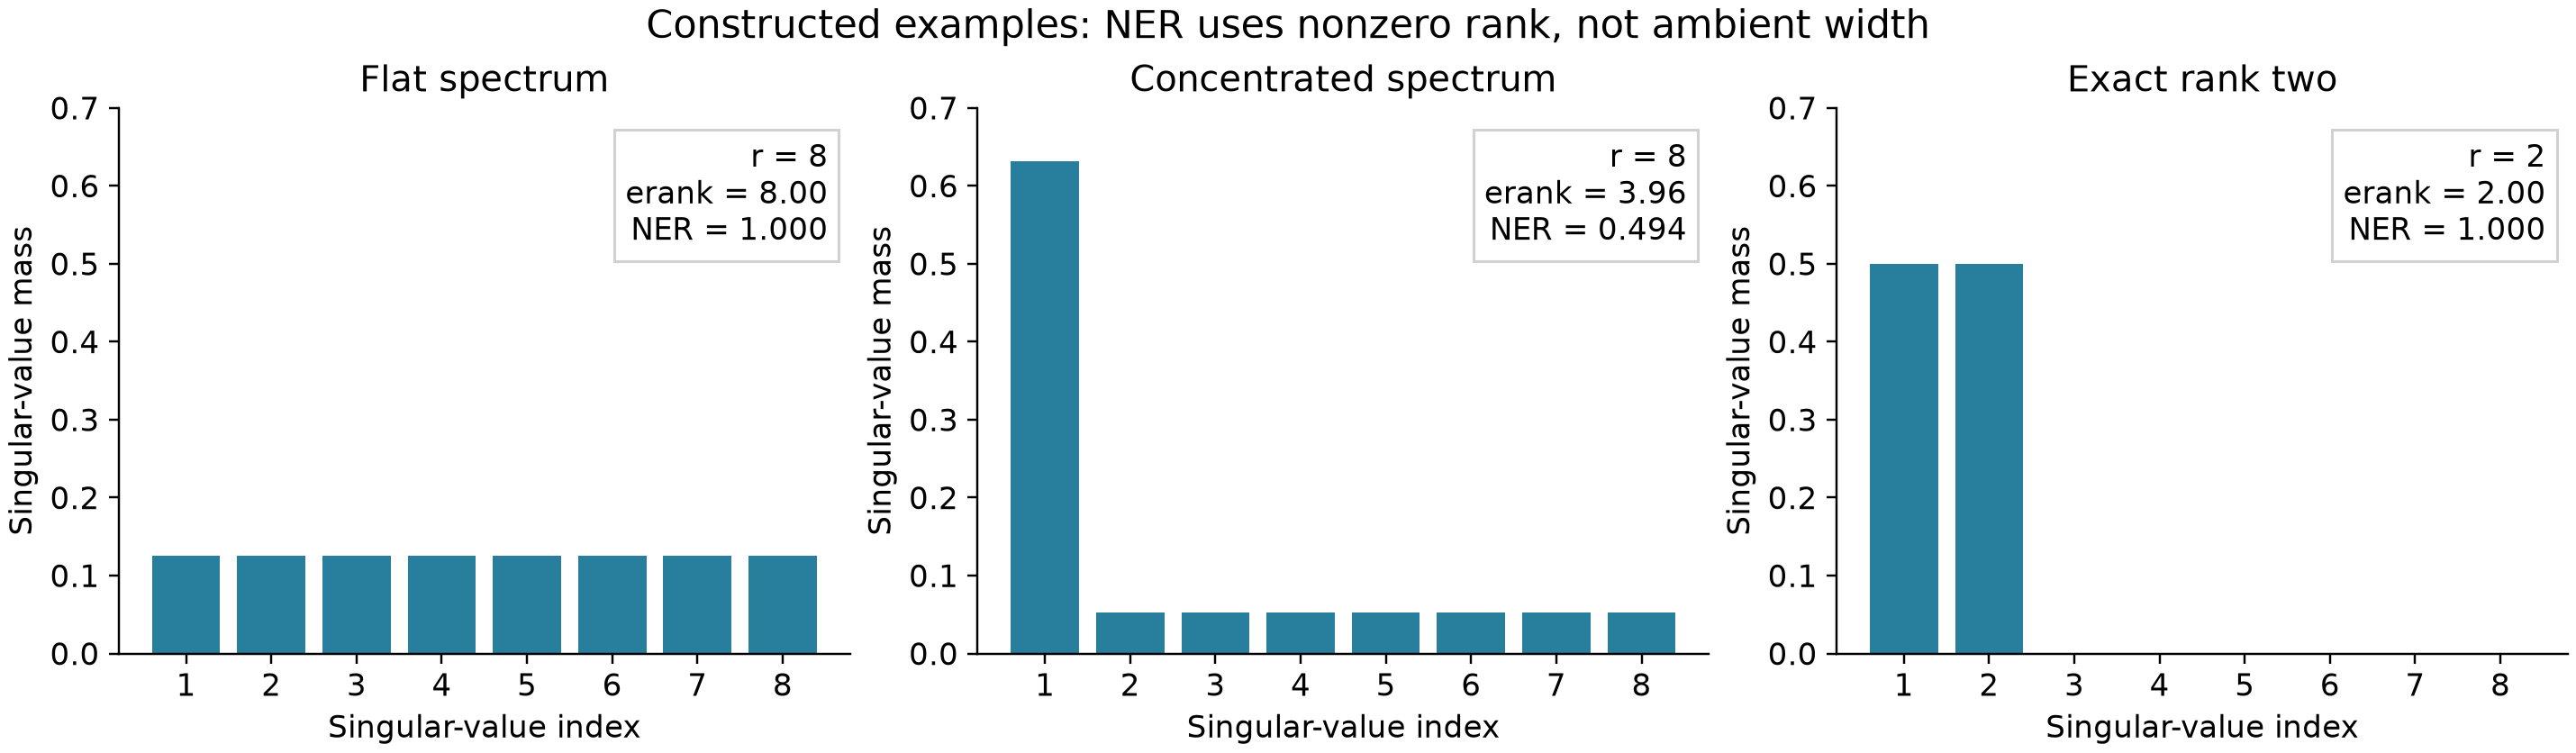
图 2. 本文原创数学示例。严格为零的奇异值不计入秩分母;因此,NER 必须与实际或数值秩、外部特征宽度一起理解。图中不是模型实测结果。
这意味着,比较一个 1024 维空间和一个二维子空间时,不能只看 NER。更不能把 NER 0.4 直接翻译成“保留 40% 的维度就安全”。只有在非零秩、特征宽度和谱形状等条件相近时,这个归一化数字才具有比较清楚的可比性。
数值秩阈值也由此变得重要。如果给一个低秩矩阵加入一个极小但非零的奇异值,熵可能几乎不变,数学秩却会增加,NER 的分母随之改变。在有限精度下,是否把这个方向视为零,需要一个明确规则。不同模型偷偷使用不同阈值,会让本来想做的公平比较失去基础。
零矩阵则是另一种边界情况:奇异值总和为零,秩也为零,式 9 和式 10 都不能直接计算。如果软件为了方便把它记作 NER 0,那属于额外定义的报告约定,不是原式自然给出的结果。
5.3 有效秩与保留能量不是一回事
Frobenius 重建误差取决于奇异值的平方。对于保留秩 ,更直接的相对残差指标是
NER 把整条谱压成一个熵数值,而上式描述“给定预算之后还剩多少误差”。不同谱可以具有接近的熵,却在某一个具体截断点后留下不同的能量。因此,一个标量很适合做概览,却不足以替代完整的预算曲线。
比较实用的报告方式,是同时列出外部宽度、数值秩、有效秩、NER,以及随保留秩变化的尾部能量。NER 用来判断是否值得继续探索,尾部曲线用来挑选候选预算,再由真实任务决定这些预算是否可接受。这样每个指标都有自己的职责,不需要硬把一个数字解释成所有问题的答案。
6. 实验到底测了什么?
6.1 模型与数据覆盖
主表实际列出了 Qwen3-4B、Qwen3-8B、Mistral-7B、Gemma-1.1-2B、Gemma-1.1-7B、Phi-3-mini-128k 和 LLaMA-2-7B。英语数据包含 Alpaca、MedAlpaca、CodeAlpaca、WizardCoder,以及 FunctionCall。多语言部分使用 VisRBench 的 query 文本,论文声称覆盖十五种非英语语言,加上英语共十六种。
不过,正文的覆盖说明与表格并非完全一致。模型介绍段没有完整列出表中出现的 LLaMA-2;语言清单包含 Danish,但 Table 1 的可见多语言部分只有十四行,没有 Danish。这些差异不意味着表中每个测量都无效,却意味着不能把正文的数量直接当作已经完整展示的数据清单。
实验不更新模型参数,也不通过反向传播学习投影。模型先产生激活,再进行 SVD 截断和推理评估。硬件部分描述了一台拥有八张 A800 80 GB 的服务器,并说明评估使用单张 GPU。这只是实验环境信息,不能据此推出多卡加速,也不是缓存压缩已经提高服务吞吐的证据。
6.2 困惑度看的是预测似然
对于固定分词后的测试序列,困惑度是平均负对数似然的指数:
它衡量模型在给定评估协议下预测这些 token 的能力。分词方式、文本分布、哪些 token 被计入损失,都会影响数值。因此,在同一个模型、同一批样本上比较压缩前后通常更有意义;跨语言、跨分词器直接比较绝对 PPL,要谨慎得多。
似然评估与自由生成也不相同。前者通常沿着参考文本计算预测概率,后者一旦生成了不同 token,后续上下文也会变化。平均概率只略有下降,并不保证推理路径、答案内容和用户感受到的质量都保持原样。
6.3 ND-PPL 不是每一项都相对完整缓存
用 表示保留 key 秩 、value 秩 时的困惑度。论文的 key 侧 ND-PPL,是在不同 value 设置下,对所有“保留更多 key 维度”与“保留更少 key 维度”的配对相对变化取平均。可紧凑地写为
是所有满足 的秩对。value 侧定义类似。关键在分母:它是当前这一对中压缩较少的配置,而不总是完整缓存。因而,这个指标不能直接等同于“相对原模型的 PPL 上涨百分比”。
它还依赖所选择的秩网格。如果额外加入很多非常激进的设置,平均值可能明显改变,即使实际准备部署的那几个点完全没变。某些相邻点也可能不单调,产生负的相对变化。尤其当 value 只保留极低比例时,PPL 会出现很大的数值,进而影响整体统计。读 ND-PPL 时,应把对应热图一起看。
算法 2:把拟合收益和分布迁移分开评估
下面是一套从本文分析引出的建议协议,用来补足诊断到部署之间的证据链;其中的额外留出与迁移实验,不是声称原论文已经完成。
输入:校准集、不重叠测试集、模型、保留秩网格
1. 仅用校准集,为每层 K/V 拟合基底。
2. 固定基底、数值秩规则和所有预处理选择。
3. 在同一测试集上评估完整模型,作为对照。
4. 对每组 K/V 秩,分别评估似然和自由生成质量。
5. 记录尾部能量、PPL、答案指标与实际内存成本。
6. 保存秩网格,并据此计算配对 ND-PPL。
7. 不重新拟合基底,测试新的领域和语言。
8. 再与目标分布重新拟合后的结果比较。
9. 报告配对不确定性,以及评审模型和评分提示。
输出:同分布权衡、迁移风险和实际系统证据
第 1 步和第 7 步的分离非常关键。在目标分布上拟合基底,再测试同类数据,回答的是“知道这类数据之后能压到什么程度”;将固定基底用于未知分布,则回答另一个更难的问题。原论文描述并没有充分消除所有校准与测试划分方面的疑问,阅读笔记应保留这种不确定性,而不是自行补上一套看起来合理的实验流程。
7. 跨模型、跨层的谱,透露了什么?
7.1 K 和 V 没有理由总用同一份预算
在 Alpaca 行,Table 1 给出的 K/V NER 分别为:Qwen3-4B 的 0.428/0.724,Qwen3-8B 的 0.452/0.753,Gemma-2B 的 0.612/0.900,Gemma-7B 的 0.359/0.469,Mistral-7B 的 0.449/0.773,Phi-3 的 0.409/0.616,以及 LLaMA-2-7B 的 0.023/0.464。在这些可见配对中,key 的谱比 value 更集中。
这给了我们一个很具体的研究动机:K 和 V 不一定应该保留相同比例的秩。两条路径不仅谱不同,作用也不同。key 改变 token 之间的匹配和权重,value 提供最终被加权组合的内容。谱的差异值得用来提出不对称预算,但最后仍然需要端到端验证,不能仅靠“key 更低秩”就假定它可以随意压缩。
比较模型时,还必须回到实际宽度。论文描述 Gemma-7B 使用十六个宽度为 256 的 KV 头,总宽度为 4096;Gemma-2B 则只有一个宽度为 256 的 KV 头。更大空间中的 NER 较低,并不意味着它需要的绝对维度更少。Qwen3-4B 与 8B 的 KV 配置更接近,均为八个宽度 128 的头。由此可见,仅用模型参数量解释可压缩性,会漏掉一个非常直接的结构因素。
英语领域之间的稳定性也不是所有模型都一样。Qwen3-4B 的五个 key 条目只从 0.421 变化到 0.432;LLaMA-2-7B 却从 0.023 到 0.265。把结果总结成“领域对秩基本没有影响”,会忽略主表中的明显例外。比较准确的说法是:某些模型的英语领域谱相近,但这种稳定性本身也依赖模型。
7.2 层间规律要测量,不能预先指定模板
图 3 是 Qwen3-4B 的逐层曲线。value 通常在 key 上方,不同数据集的曲线也经常共享类似形状。但局部峰谷相当明显,并不是随着层数增加就简单单调地上升或下降。一个统一的保留比例,显然无法反映这种差异。
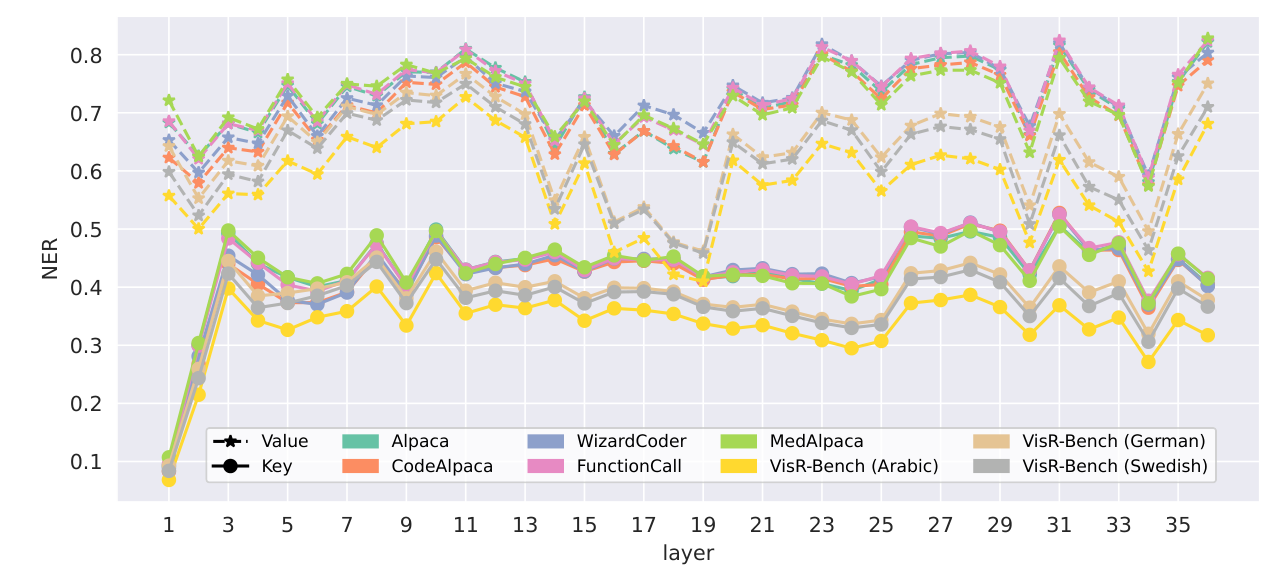
图 3. 截取自论文第 8 页 Fig. 2。key 实线和 value 虚线显示共同的模型结构特征,同时存在数据相关偏移。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
附录把同样的观察扩展到了 Qwen3-8B、Mistral、Phi-3 和 Gemma。各模型的曲线形状并不完全相同。例如,Phi-3 在较长的一段层范围内持续上升,而 Gemma 的局部波动明显。因此,“中间层一定需要更多秩”最多是对部分模型的描述,不能直接当作分配算法。
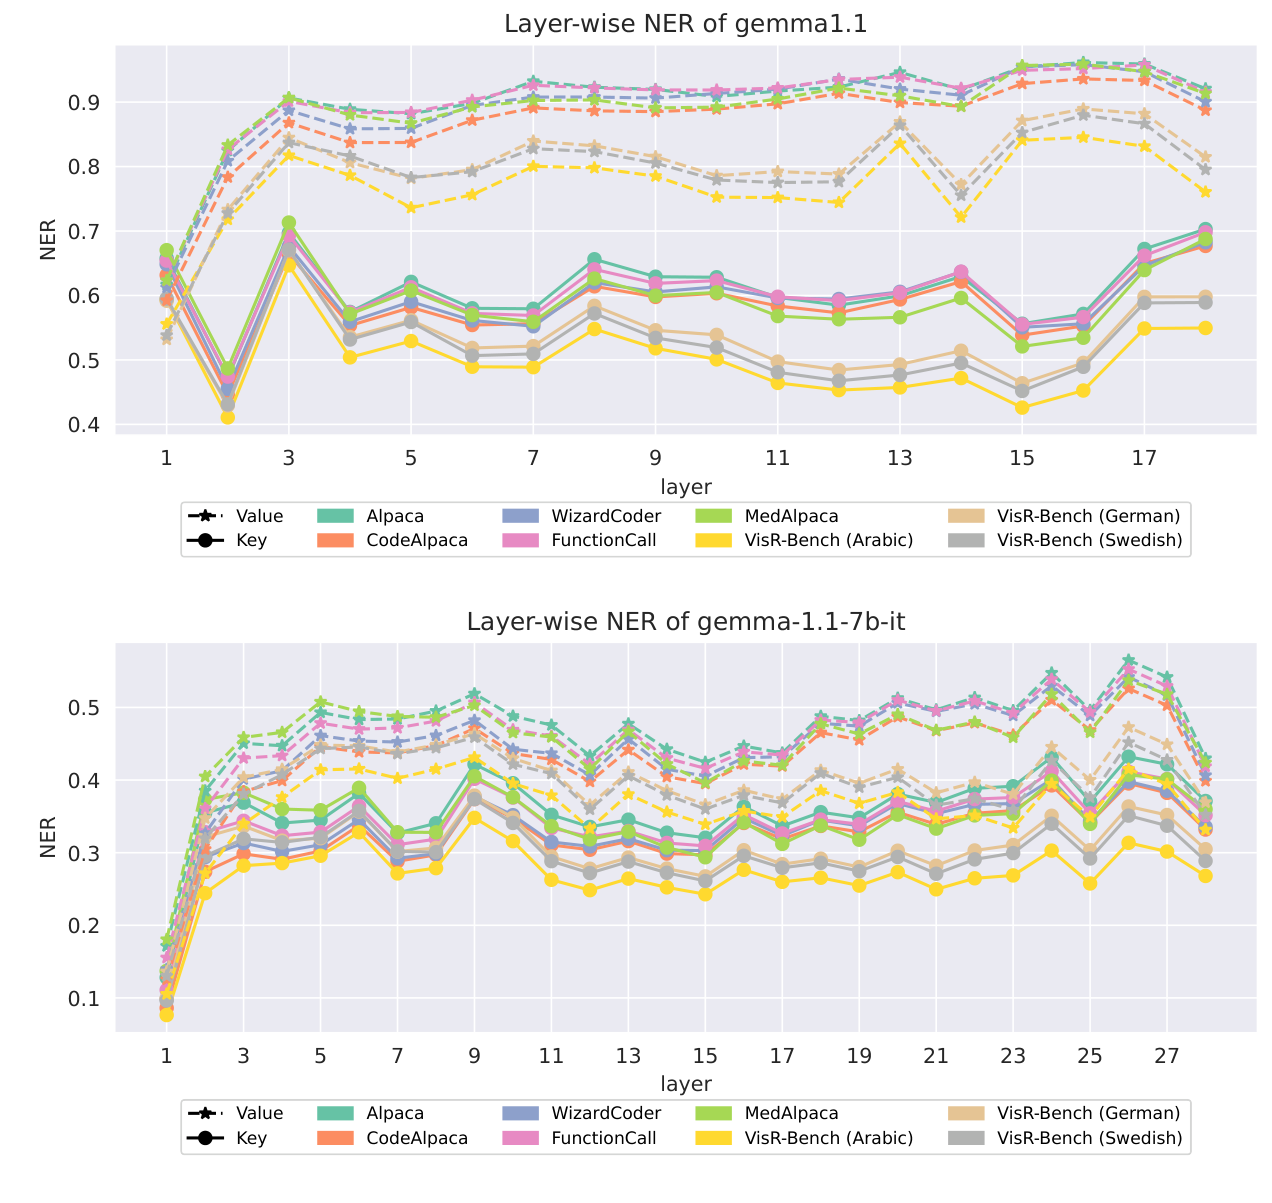
图 4. 截取自论文第 16 页 Fig. B.3。两个 Gemma 版本的 NER 数值范围和层间模式不同,物理 KV 宽度也不同;归一化数值不能单独解释为显存需求。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
如果给定一个总预算,可以考虑根据“再增加一个奇异方向能减少多少平方残差”来分配:保留第 个方向,会减少 的局部重建误差。但这仍然只是一个重建目标下的思路。不同层的存储成本、布局限制和输出敏感度可能不同,局部误差减少相同,也不保证最终答案受益相同。KV-CoRE 提供了提出此类策略所需的测量基础,并没有验证这就是最佳预算分配。
7.3 语言差异不等于已经解释了训练覆盖
对于 Qwen3-4B,可见多语言 key NER 从 Arabic 的 0.337 到 Czech、German 的 0.383;value 中则可看到 Arabic 的 0.582 和 German 的 0.640。论文提出,一些语言较低的有效秩可能反映了模型对这些语言的表示使用不足。
这个解释有研究价值,但目前还是一种假设。提示长度、分词碎片化、主题范围、模板重复以及 query 文本采样方式,都可能改变谱。较低的秩也可能只是输入多样性较窄,而不是语言能力较弱。要把结果归因于训练覆盖,需要更匹配的数据、独立的语言能力指标,以及控制混杂因素的实验。
还有一个值得警惕的反直觉现象:最容易压缩的数据分布,不一定是模型表现最好的分布。如果模型原本就没有充分使用某种语言的表示能力,压缩后变化很小,也可能只是保住了一个本来就较弱的行为。因此,必须把压缩敏感度和完整模型的绝对质量并排看,不能把“退化少”自动解释成“能力保留得好”。
8. 真正压缩之后,模型发生了什么?
8.1 先看困惑度热图的具体坐标
图 5 的纵轴是 key 保留比例,横轴是 value 保留比例。比例越大,保留的维度越多。Qwen3-4B 在 Alpaca 上的完整配置 PPL 为 8.72,K/V 都保留 0.55 时为 10.69。用这两个论文数值计算,增幅约为 22.6%。LLaMA-2-7B 对应地从 6.04 变为 6.30,增幅约为 4.3%。
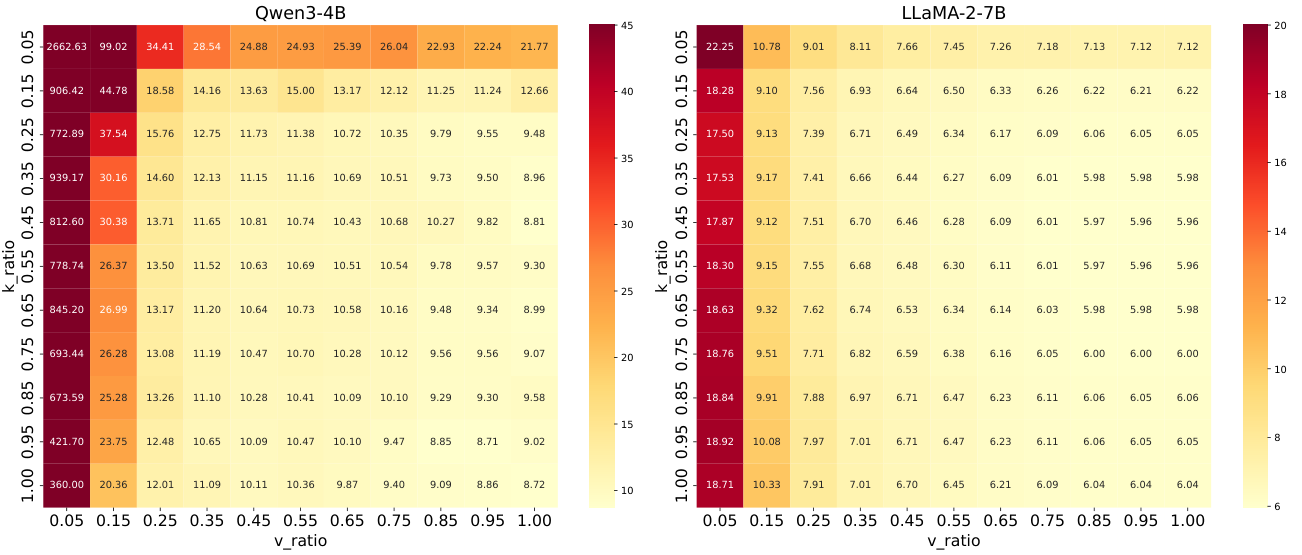
图 5. 截取自论文第 8 页 Fig. 3。要以单元格数字为准:Qwen 的极端值超过了色条范围,两个模型也使用不同的颜色上限,不能只靠颜色比较。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
在更激进的位置,两条路径的不对称十分明显。Qwen3-4B 保留完整 key、value 只留 0.05 时,PPL 为 360.00;key 只留 0.05、value 完整时,为 21.77;两者都只留 0.05 时,达到 2662.63。LLaMA-2-7B 的这三个格子分别为 18.71、7.12 和 22.25。这支持了分开处理 K/V 预算的必要性,也解释了为什么极端 value 截断可能主导总体敏感度指标。
但跨模型比较仍有两个条件。第一,同样的保留比例不代表同样的绝对秩、同样的字节数或同样的基底开销。第二,热图并不完全单调;某些点比邻近点略好,可能来自评估变化或偶然的正则化效应,不能据此认定“删得越多越好”。判断可接受的预算,需要看一段稳定区域,而不是挑一个偶然漂亮的格子。
附录 B 还提供了更多数据集的 PPL 表面。它的价值在于提醒我们:一个 Alpaca 热图不能代表全部使用场景。不同任务上的误差陡增位置可能不同,而统一预算往往会被最脆弱的那一类任务限制。如果部署需要支持多类请求,就应该对每类负载保留单独的质量曲线。
8.2 PPL 变化不大,回答也可能已经明显变化
论文另外选取 100 条 Alpaca 指令,用二元评审衡量压缩回答相对完整模型回答的质量等价性。图 6 中,K/V 都保留 0.55 时,Qwen3-4B 的平均得分为 0.57,LLaMA-2-7B 为 0.61。后者尤其值得注意:PPL 只增加约 4.3%,但按该评审协议,等价比例只有 61%。
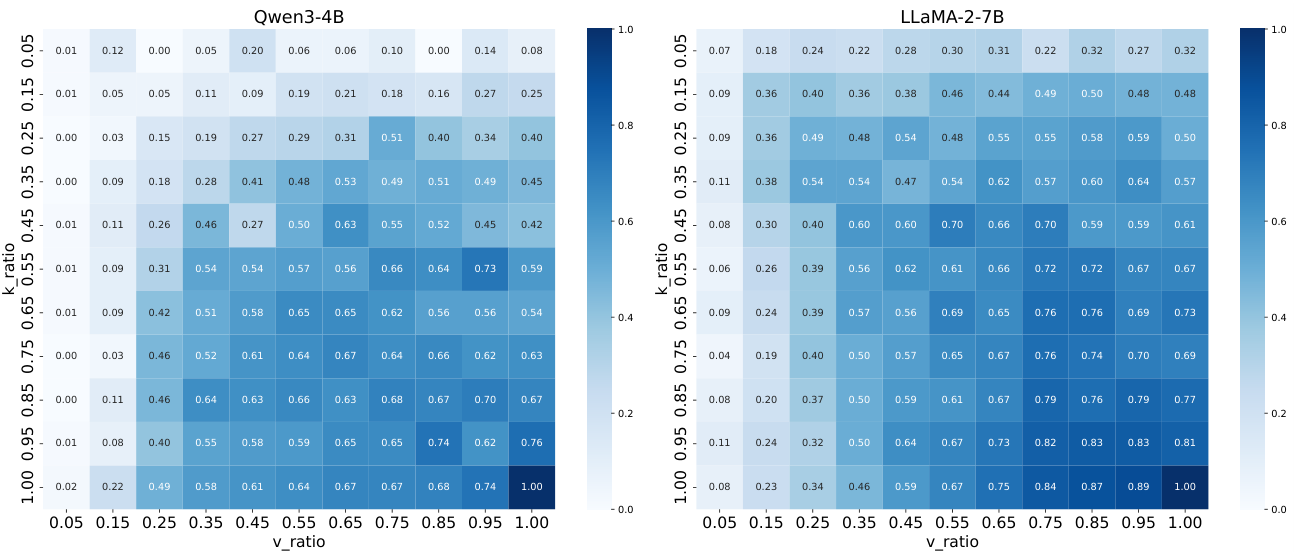
图 6. 截取自论文第 9 页 Fig. 4。每格是二元判断的均值,不是连续的正确率测量;右下角完整配置为 1.00,中等截断已可能改变回答。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
这并不意味着其余 39% 的压缩答案都客观错误。评审是按提示词比较两份回答,完整模型本身也不是标准答案。能够得出的结论是:接近基线的似然,不足以证明生成回答保持不变。困惑度与回答质量在看不同的现象,不应该互相替代。
评审细节还有两个需要澄清的地方。正文同一段先写 GPT-4o,又写 GPT-5,无法确定实际使用的评审模型。附录 C 的规则一方面允许“两边都差”判为等价,另一方面又要求压缩回答必须合理,否则给零。两条规则相遇时优先执行哪一条,并没有明确说明。精确模型名、一致评分规则和生成参数,都会影响这张图的解释。
样本量也限制了细微比较。对 100 个独立二元样本,比例估计的最大标准误为 0.05,在二分之一附近,粗略正态 95% 区间约为正负 0.10。这只是本文用于理解量级的计算,不是作者报告的置信区间。实际还可能有样本相关性、重复比较和评审波动。因此,一两个百分点的差异,不应被当作配置优劣的决定性证据。
8.3 相关性令人鼓舞,但还不能自动控制秩
图 7 在 Qwen3-4B 上,把不同数据集的 NER 与 ND-PPL 联系起来。作者报告 value 侧 Pearson 相关系数为 0.88,key 侧为 0.64。这与基本直觉相符:谱更分散时,在所采样的压缩配置上通常更容易发生性能退化。
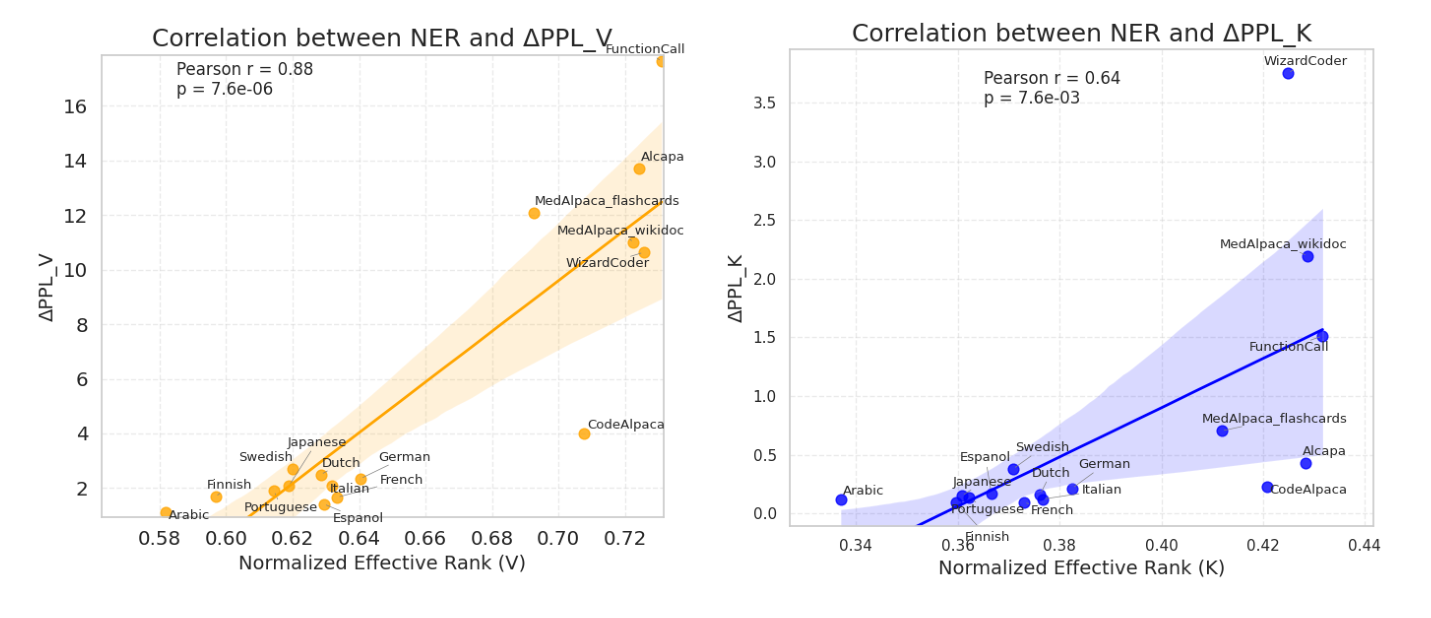
图 7. 截取自论文第 9 页 Fig. 5。这里展示的是一个模型在多个数据集上的关系,不是跨模型通用预算规则,也不是语言训练覆盖的因果证据。来源:Chen 等,arXiv:2602.05929v2,CC BY 4.0。
下一步真正有用的检验,是在没有参与拟合的数据集或模型上预测退化,并把物理宽度、实际秩和架构等因素纳入比较。这样才能知道 NER 是否提供了可迁移的决策信息,而不只是对当前一组点做出了较好的描述。
此外,ND-PPL 汇总的秩网格包含非常激进的截断。一个能预测“极端压缩会崩”的指标,未必能分辨部署阈值附近的细微质量变化。把相关性分别限制在轻度、中度和重度压缩区间,会更清楚地显示它在哪一类决策中真正有帮助。
9. 为什么重建最优仍然不能保证注意力不变?
9.1 顺着计算链,把误差写出来
对于一个头和固定 query,设近似缓存为 、。首先,注意力 logit 的变化为
这一步已经说明了问题:缓存残差是否重要,取决于 query 怎样投影到它上面。Frobenius 误差把所有行、所有特征的平方误差加起来,而当前 query 只会读取其中某些组合。平均意义上的小方向,也可能是某个特定问题需要的方向。
对于 ,Jacobian 为 ,其谱范数不超过二分之一。沿两个 logit 向量之间的线段积分,可以得到
这是针对固定 query 的一般最坏情况上界,没有利用实际注意力分布,因此可能比较松。但它至少清楚地告诉我们:query 大小与方向、key 残差以及 softmax 的敏感度,都介入了最终误差。
输出差异还可以精确拆成两项:
进而有
第一项是 key 误差改变权重后,对原 value 的重新组合;第二项是近似权重直接作用于 value 残差。两者会相互影响,而且后续层的 query 也会因为隐藏状态变化而改变。因此,单层矩阵的最优重建,不是全模型的误差保证,更不是任务正确率保证。以上推导是本文用于解释误差路径的分析,不是原论文声称的全模型定理。
9.2 真正可用的秩策略还缺什么?
首先需要一个目标:是满足显存上限,还是把答案下降控制在某个范围内,或者尽量降低解码延迟?NER 本身没有指定任何一个目标。比较合理的顺序是,先用 NER 判断谱是否集中,再用尾部能量选出几个候选秩,然后测量任务质量,最后测量实际服务成本。每一步解决一个不同的不确定性。
可以考虑用 query 加权的重建目标,使它更接近 logit 保真;也可以限制每个头单独压缩,使它更容易适配现有算子;还可以像在线缓存方法那样,让基底随数据变化。但这些选择都改变了原问题,分别带来额外校准、近似自由度下降或更新成本。不能只拿原来的 SVD 定理,就宣布新的目标同样最优。
从存储角度看,如果一个矩阵以坐标和基底两部分保存,粗略标量数为 ,而稠密表示是 。要真正省空间,需要
这是包含一份序列专属基底的示例。若使用跨请求共享的固定基底,其成本可以按不同方式摊销。但无论如何,“保留秩比例就等于显存比例”都漏掉了额外项。短上下文时,基底开销可能很重要;长上下文时,坐标存储占主导,却仍需考虑恢复工作区和计算时间。
把这些成本写清楚,才能知道某个方案适用于哪一类场景。离线分析可以接受一次较重的特征分解;在线服务则要把更新和恢复纳入每个请求的延迟。诊断方法与部署方法可以共享数学基础,却不能共用一份未经测量的速度结论。
10. 现有证据的局限
第一是覆盖范围。论文测量了若干模型和数据集上的激活低秩结构,并没有覆盖所有架构、所有长上下文推理任务或所有服务负载。数据集级谱还可能掩盖少数样本的异常,例如一次语言切换、一段罕见代码或一个关键检索 token。平均表现好,并不代表每个请求都安全。
第二是替代目标。Frobenius 重建根据平方幅度计入误差,不知道未来 query、下游层敏感度,也不知道某个 token 在语义上有多重要。困惑度与回答评审能帮助检查这个缺口,但不能把缺口完全消除。
第三是数值和统计说明。秩阈值、token 加权、校准与测试划分、评审模型和评分规则,都会影响解释。NER 又把整条谱压成一个数字,丢掉具体预算处的尾部形状。因此,它适合诊断,尚不能作为不依赖分布的质量保证。
第四是系统证据。相对保存全部激活,Gram 累加提供了一种节省数据集分析内存的办法;低秩构造也给出了理论上可用的表示形式。但论文没有展示任意拟合基底已经带来端到端服务加速。持久缓存、峰值工作区、prefill 时间、decode 时间和吞吐,应继续分别测量。
最后,语言覆盖的解释仍是观察性的。NER 低不等于已经证明训练不足,压缩后退化少也不等于原始模型能力强。需要把输入多样性、完整模型质量和压缩敏感度一起分析,才能避免把一种结构现象解释成未经验证的能力故事。
11. 批判性分析:哪些结论值得保留,哪些地方需要补强?
11.1 保留清楚的数学结论,收紧实际用途的表述
KV-CoRE 最扎实的部分,是把数据相关的激活重建目标与一个可累加的完整统计量连接起来。式 6 解释了为什么投影构造达到当前数据上的最优重建,式 8 解释了为什么不必保留全部激活。即使实验报告存在需要修正的地方,这些矩阵恒等式本身仍然成立。
但实际用途应说得更窄一些。谱集中说明存在重建意义上的冗余;它不直接说明任意指定秩是安全的,也不直接说明某种训练覆盖导致了这种集中,更不能说明分解后的缓存必然更快。这套框架的价值,在于让后续预算选择有测量依据,而不是替代后续所有质量和系统验证。
11.2 主表的汇总值需要与可见数据对齐
Table 1 有一些可以直接复算的不一致。对 Qwen3-4B,五个可见英语 key 条目的简单均值是 0.4270,表里的 Average 却是 0.424;value 的简单均值是 0.7224,表里为 0.717。这些差异超过了三位小数四舍五入通常能够解释的范围。
LLaMA-2-7B 的差异更明显:五个英语 key 条目的均值为 0.1254,表中写 0.088;value 均值为 0.3728,表中却写 0.141。更强的检查是,0.141 低于五个可见 value 条目中的每一个,因此它不可能是仅对这五行做非负加权平均的结果。
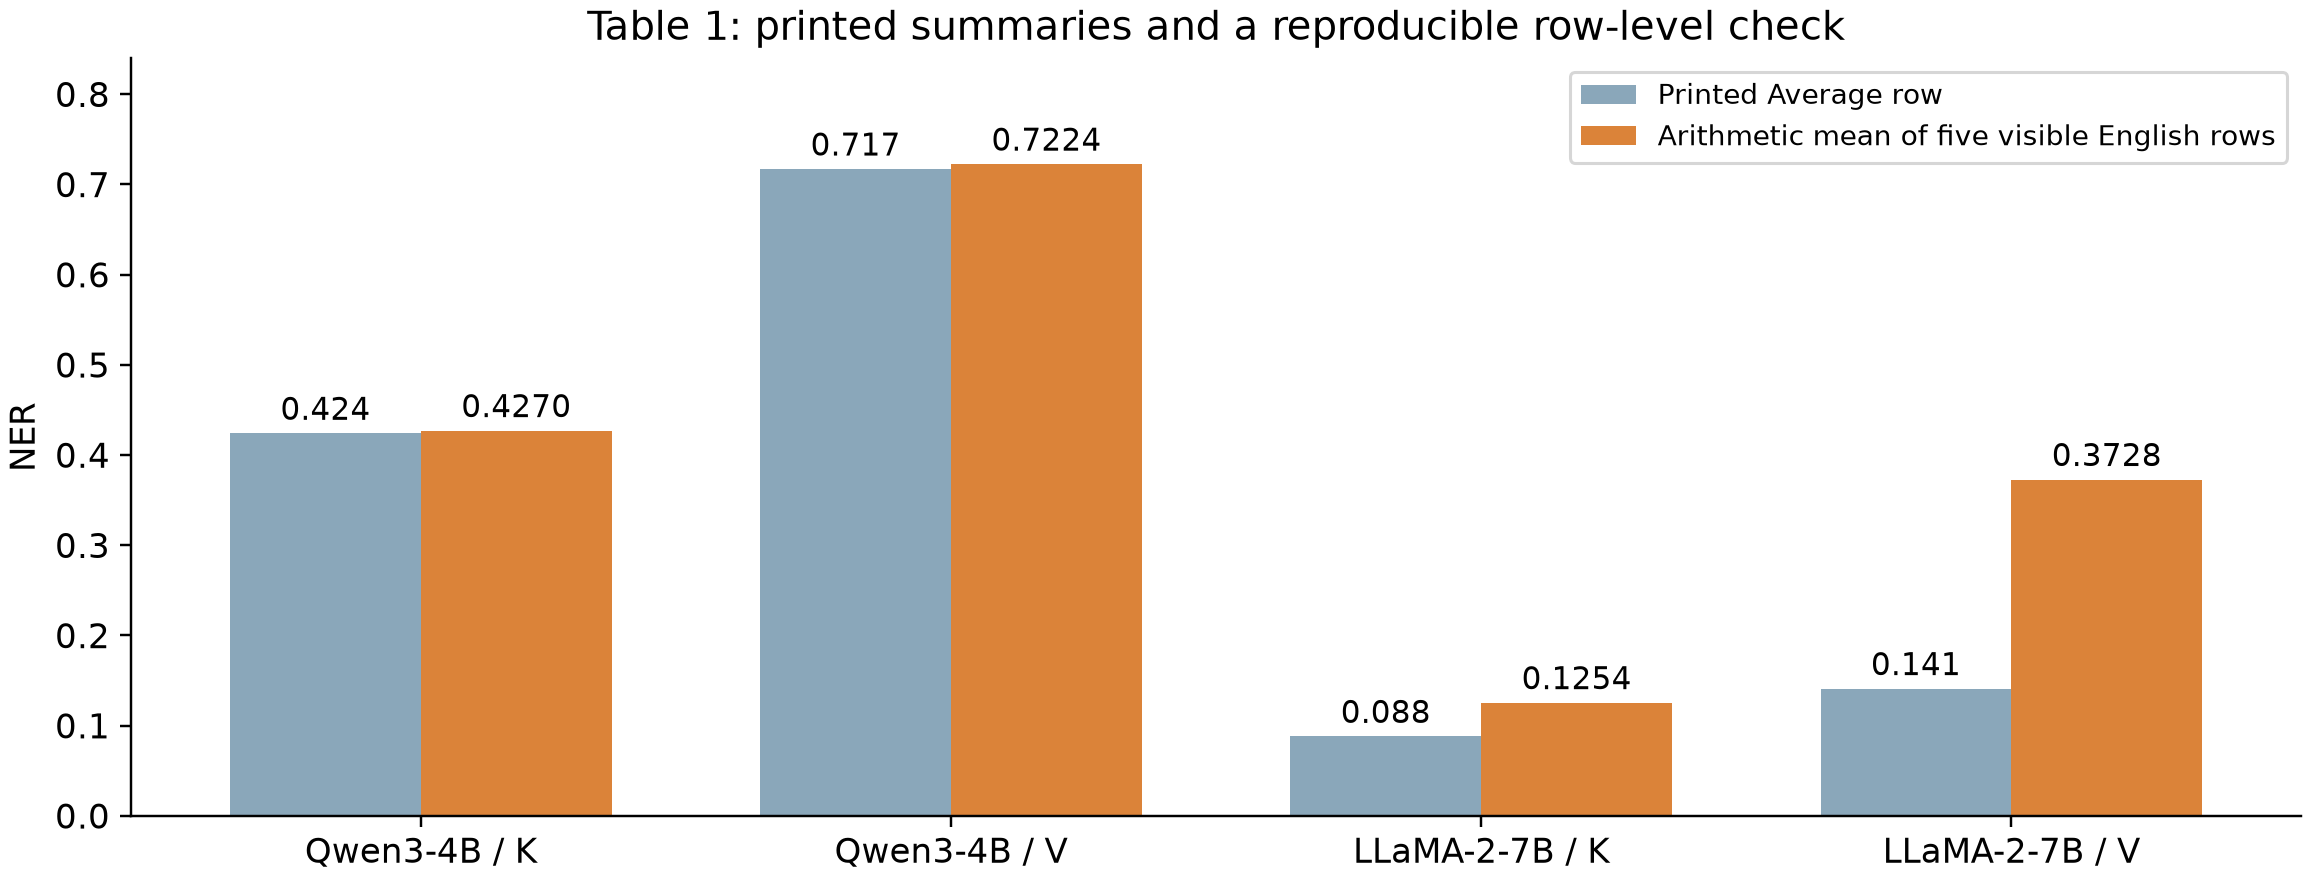
图 8. 本文依据论文第 7 页 Table 1 进行的算术复核。橙色为五个可见英语数据集行的简单均值,蓝色为原表 Average 行。这里识别的是报告不一致,不是在重估底层模型实验。
Qwen3-4B 的多语言汇总也有类似问题:表中 key 平均为 0.387,但所有可见语言行最高只有 0.383;value 平均为 0.653,而所有可见行最高只有 0.640。如果作者使用了未展示的数据、不同总体或其他聚合方法,确实可能得到不同数字,但表格需要明确说明这种方法。
面对这种情况,较合适的处理是引用标明来源的逐行数值,同时指出汇总的不一致。既不应该因此把整篇论文全部否定,也不应该悄悄替作者猜一张“正确表”。完整列出参与聚合的数据和权重规则,就能让这个问题变得可核对。
11.3 将压缩敏感度与训练覆盖解释分开验证
相关图支持继续研究 NER 是否能预测压缩敏感度,却没有证明训练覆盖是因果中介。更强的实验应匹配语言间 token 数、文本类型和模板分布,报告分词后的长度差异,再把完整模型的能力与压缩敏感度一起比较。
一个特别有价值的设计,是在分布 A 上拟合基底,在分布 B 上同时测试原模型与压缩模型;再与直接在 B 上拟合基底的结果比较。这样可以把“目标分布本来是否容易压缩”和“固定基底是否能迁移”区分开,也能检验在线适应相对静态投影究竟多提供了什么收益。
11.4 先补齐质量评审协议,再比较细小差距
评审模型名称和评分规则的不一致,应该在把热图当作配置排行榜之前解决。100 个样本足以展示某些大幅退化,但要比较接近的点,需要配对分析、重复评审或独立任务指标,以及明确的生成设置。
完整模型的回答应该作为行为参考,而不是正确性裁判。压缩有时可能偶然改善回答,也可能保留了同样差的答案。等价性、正确性和有用性分别回答不同问题。如果全部折叠成一个二元标签,就需要格外小心它的含义,不能既把“改变”都当作坏事,又把“相同”都当作好事。
11.5 更有用的下一步,是预算到质量的可验证映射
面向实际使用的后续工作,可以共同使用 NER、数值秩、尾部能量、头结构约束和 query 敏感度,预测某个字节预算下的质量。策略比较也应包含简单基线,例如统一秩和逐层能量阈值。如果复杂指标不能在留出负载上提供额外信息,就应承认它主要具有描述价值。
系统侧则需要把基底、坐标、恢复工作区和更新时间一起算入。一个方案可能显著降低持久存储,却因为恢复代价而没有延迟收益;也可能只在长上下文或高并发条件下体现价值。把适用条件写清楚,比只给一个最大的压缩倍率更能帮助读者做决定。
这样的扩展会把当前的观察框架推进为可操作的预测工具,而且目标是可证伪的:NER 到底能否在宽度和尾部能量之外增加预测能力,需要由独立数据回答。一个诊断指标是否值得保留,最终应看它是否改善了决策,而不仅是定义是否简洁。
12. 结论
KV-CoRE 让“先测量,再分配低秩预算”有了清楚的数学和实验入口。它通过完整 Gram 矩阵累加恢复数据相关的谱,并用投影构造达到观测激活上的最优 Frobenius 重建。实验也确实展示了 K/V、层、模型结构和数据分布之间的差异,以及 NER 与总体压缩敏感度的正相关。
真正值得带走的是各类证据的分工:NER 描述非零奇异值质量如何分布,尾部能量描述具体预算的重建损失,困惑度与回答指标描述不同层面的模型行为,系统测量描述实际成本。它们彼此相关,却没有任何一个可以代替其余全部。
因此,这篇论文很适合作为在线 KV 压缩方法的配套阅读。它帮助我们理解那些方法试图利用的几何结构,却没有证明无损压缩、通用安全保留比例或已经实现的推理加速。把这些边界以及报告中的不一致讲清楚之后,它最有价值的部分反而更容易看见。
参考资料与阅读范围
- Jian Chen 等:KV-CoRE: Benchmarking Data-Dependent Low-Rank Compressibility of KV-Caches in LLMs,v2,2026-02-07。已阅读全文 19 页及附录 A–C。方法对应第 2.1–2.4 节,评估对应第 3–4 节,附加层曲线和困惑度热图在附录 B,评审提示在附录 C。
- Yiren Zhao 等:iS-KV: Online Low-Rank KV Cache Compression via Block-Incremental SVD,v1。用于衔接昨日阅读,区分在线截断缓存与完整数据集统计量。
- 论文配图以注明来源的裁切形式使用,原文许可为 CC BY 4.0。本笔记图 2 和图 8 是原创解释性计算,没有声称新增模型质量或服务速度实测。