笔记日期: 2026-10-30 · 作者: Zhongzhu Zhou
阅读论文: iS-KV: Online Low-Rank KV Cache Compression via Block-Incremental SVD
论文作者: Yiren Zhao、Guanghui Song、Tianrui Qin、Kejiang Ye、Cheng-zhong Xu、Xitong Gao
arXiv: 2610.02815 · 版本: v1,2026-10-02
1. 先说清楚:保留位置,不等于保留全部信息
长推理有一个很直接的代价:模型每生成一个 token,就要为它保存各层的 key 和 value。推理链越来越长,KV cache 也越来越大。常见的做法是淘汰一些看起来暂时不重要的 token;iS-KV 选择另一条路——位置都留着,但把较老的向量写成低秩坐标。
因此,它是推理阶段的、有损的 KV 压缩方法,不需要重新训练语言模型,也不是改变 attention 数学结果的无损加速。最近的状态和被保护的提示词状态仍按原精度保存;其他状态只能重建出近似值。未来的 query 还能访问这个位置,但访问到的向量未必与原来相同。
这一区别是整篇论文的出发点。淘汰丢掉一整行,低秩压缩丢掉一部分特征方向。前者失去位置可达性,后者失去表示精度。不能仅凭“没有删 token”就认为推理信息完整,更不能因此声称答案必然不变。论文要比较的是:在相近的持久 KV 字节预算下,哪种取舍更划算。
真正有意思的问题发生在在线更新时。假设一批历史向量已经用某个基底表示,新 token 到来后,这个基底需要调整。如果只换基底,却继续使用旧坐标,相当于换了一套坐标轴、却没有改地图上的数字,历史向量就会被解释错。iS-KV 用经典的分块增量 SVD,把新基底和所有历史坐标一起更新。
它最有力的结果是质量与存储之间的折中:DeepSeek-R1-Distill-Llama-8B 在 MATH-500 上从原模型的 83.6% 变为 82.6%,持久 KV 压缩约 4.06 倍;Qwen3-8B 在另一配置下达到 89.2%,原模型为 94.4%,压缩约 5.64 倍。这两组来自不同模型与秩,不能拼成一条无条件保证。
还要把速度单独拿出来:论文测试的版本仍然重建完整 KV 做 attention,计时结果比原模型更慢。它证明了持久 KV 存储减少,没有证明峰值显存同比下降,也没有交付更高的推理吞吐。下面先把方法推导清楚,再看实验究竟支持什么结论。本文所有模型实验数值均来自论文;说明性例子和自行复算会明确标注,没有运行模型复现实验。
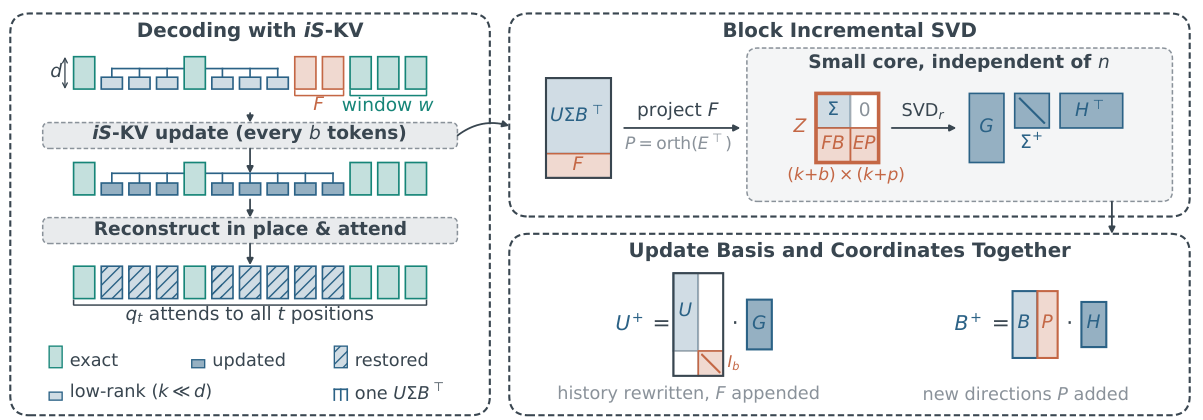
图 1(论文 Fig. 2 裁剪)。最近的行保持精确,较旧的行按块进入低秩历史;更新同时作用于基底和历史坐标。随后按原 token 位置重建缓存并执行 attention。来源:论文第 4 页。
2. 前置知识:KV、低秩和坐标究竟是什么
2.1 缓存省掉重算,但仍然需要被读取
看一层 Transformer。序列长度为 ,KV head 数为 ,每个 head 的维度为 。论文把各 KV head 沿特征维拼接,得到 ,于是 。矩阵的一行对应一个 token,低秩预算作用于这整个拼接后的特征空间,并不是每个 head 各拿一个同样大的秩。
对单个 head,attention 的核心为
其中 表示经过 RoPE。缓存使历史 K/V 不必在每个解码步重新计算,但新 query 仍然需要读取它们。缓存体积变小,可能改善容量;要让时间也变短,还得算上重建、更新和数据搬运。只看存储公式,无法直接推出速度。
几类压缩针对不同维度:淘汰减少行数,量化减少每个数的位宽,低秩则让多个 token 共享一组特征方向、减少每行独有的坐标数。这些方法可以有组合空间,但组合后的精度和性能需要另外验证。iS-KV 本文没有证明随便叠加低比特量化或服务调度器都能保留原有收益。
2.2 一行向量被写成“坐标 × 共享基底”
对 K 或 V 的 行已压缩历史,记维护中的近似为 。 为 , 为 ,理想情况下二者的列正交; 保存 个奇异值, 不超过预算 。 的每一行是一个 token 的坐标, 则是大家共用的字典。
截断 SVD 对输入矩阵解决的是 Frobenius 范数意义下的最佳秩约束重建:
右侧是丢弃奇异值的平方和。它衡量的是所有行、所有特征的总重建误差,并没有直接最小化答案错误率。某个总能量很小的方向,仍可能恰好被未来的重要 query 放大。因此,“低秩最优”必须问清楚:针对哪个矩阵、在哪个误差指标下最优。
2.3 即使子空间没变,也不能留下旧坐标
先考虑最简单的情况:基底只在原子空间里做正交旋转,,且 。令原坐标为 ,正确的新坐标应是 ,因为
如果坐标仍为 ,重建结果就变成 。还没改变子空间,更没有压缩更多信息,单是坐标解释不一致就会出错。当新数据要求扩展子空间、然后再截断到预算秩时,严格保持历史通常做不到;此时才进入有损近似问题。把这两种误差分开,才能理解论文真正修复了哪一部分。
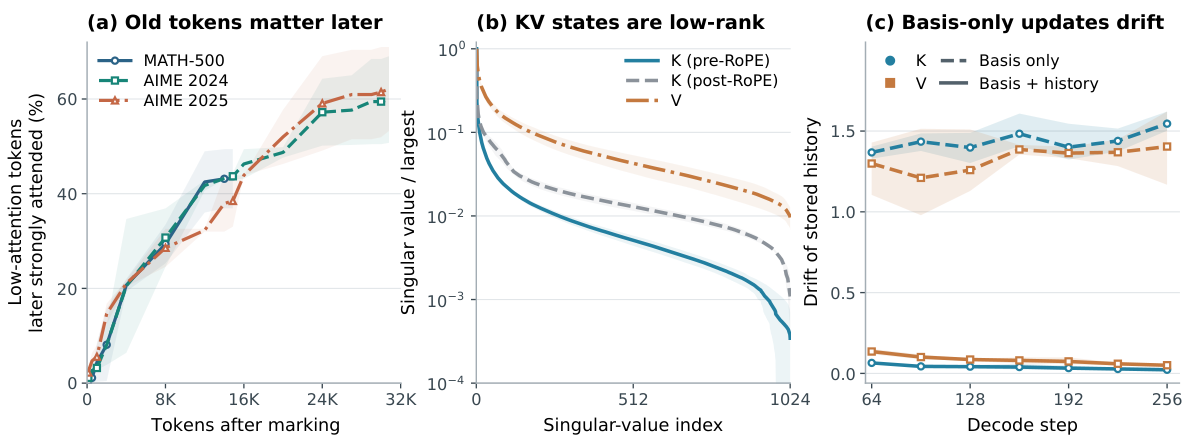
图 2(论文 Fig. 1 裁剪)。三个面板分别展示旧 token 再次被关注、KV 的奇异谱,以及只改基底导致的历史漂移。阴影是观察到的范围,不是置信区间。来源:论文第 2 页及附录 A.3。
论文的“旧 token 重新重要”探针有很具体的定义:在第 1,024 个解码步,按之前 32 步的平均 attention 标记最低的 75% token;以后某步的第 15 层 attention 超过均匀值 的 25 倍,就计作重新受到强关注。作者使用各模型、各数据集的最长轨迹,没有真的删除这些 token。AIME 上约 8K 后有 30%、30K 后有 60% 被重新强关注,说明即时低 attention 不等于永久无用;它本身不是淘汰导致答案损失的因果实验。
奇异谱探针使用每个模型四条 8K 的 AIME 2024 轨迹,以最大奇异值归一化,并在层和轨迹间取中位数。pre-RoPE key 的谱下降更快,value 相对难压缩。这个观察支持分解位置的选择,但不能自动推广到所有层、语言和任务。
第三个探针才直接针对坐标问题:第 256 步只更新基底时,K/V 漂移分别为 1.55 和 1.40;同步更新历史后变为 0.023 和 0.051。这里参照的是更新前已经表示出来的历史,不是原始未压缩 KV,也不是后文的“相对新鲜 SVD 多出的误差”。如果把这些都叫同一个 reconstruction error,结论就容易被夸大。
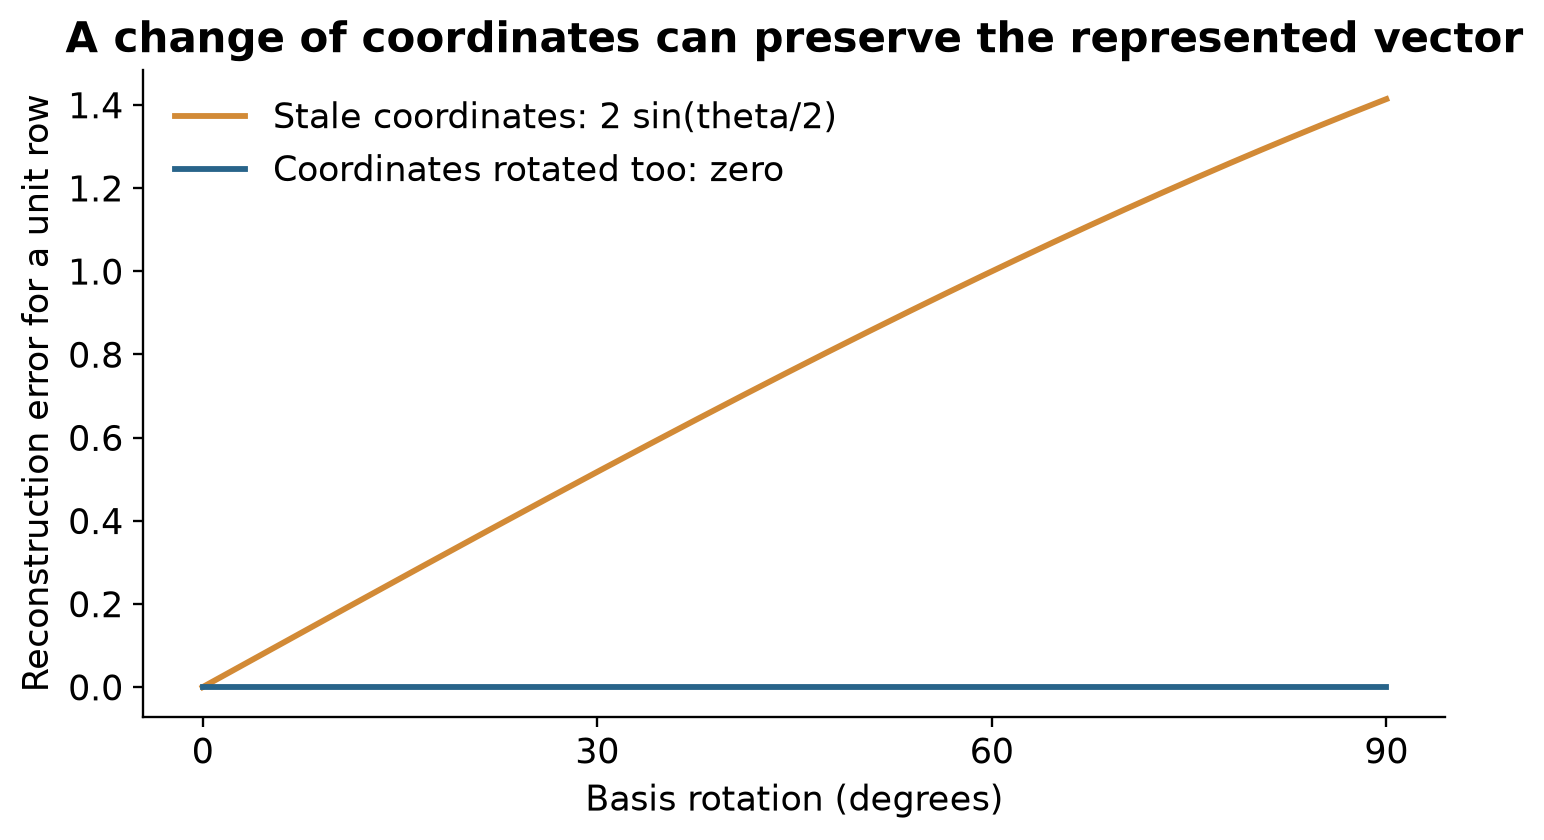
图 3。自构造的二维几何例子:完整正交基底旋转 后,单位向量沿用旧坐标的误差为 ;按式(3)一起旋转坐标则误差为零。这是解析例子,不是模型实验。
3. 哪些行精确保留,哪些行进入低秩历史
3.1 Prefill 先精确计算,再安排缓存
论文没有用压缩后的 KV 去近似 prefill 的 causal attention。提示词先按原模型完成精确 prefill,然后为后续解码准备压缩缓存。key 的分解和保存发生在 RoPE 之前;但挑选提示词异常块时,用的是 RoPE 之后的 key。前者为了利用更强的低秩结构,后者为了沿用选块信号,两者不能混为一谈。
提示词被分成每块 8 个 token,最后 4 块以及未满一块的尾部作为局部后缀。对每个 KV head,块分数是“块内 token key 与块均值的余弦相似度”的最小值。每个 head 选最低的 128 块,不够时全选;跨 head 取位置并集,再加入后缀,得到被保护的 key 位置。一个位置被选中,就保存它跨所有 KV heads 的整行 pre-RoPE key,而不是只保存触发选中的那个 head。
value 的保护范围更宽:距离受保护 key 位置不超过 32 个 token 的提示词 value 都保留。另外,最后 128 个提示词 value 初始化精确近期窗口。保护集合在解码期间固定,近期窗口则不断向前移动。这个政策对局部细节比较保守,也意味着跨 head 并集和邻域扩张可能保留很多精确行。
MATH 提示词通常很短,上述规则往往把整个提示词保护起来。因此 MATH/AIME 主要考察生成状态的压缩;64K RULER 才真正考察提示词已有一部分被压缩后的检索。不能用短提示词推理的优秀结果,代替长输入检索的证据。
算法 1:精确 prefill 后初始化缓存
1. 对提示词执行原本的 causal attention。
2. 对各 KV head 的 post-RoPE key 块计算异常分数。
3. 选块位置跨 head 取并集,加局部后缀,得到 P_K。
4. 将 P_K 向前后各扩 32 个位置,得到 P_V。
5. W_K 初始为空;W_V 为最后 min(128, L) 个 value。
6. 对 X in {K, V},令精确集合 E_X = union(P_X, W_X)。
7. 精确保留 X[E_X],其余行做预算为 r_X 的截断 SVD。
8. 保存原位置、分解因子;清空待处理队列与更新计数。
9. 将 value 的首次重新分解标记为尚未执行。
第 5 步遵循论文展示的 Algorithm 1,也与正文及附录 A.1 的 K/V 分别处理一致。算法之前的一段文字把两个近期窗口都概括为末尾位置,但展示的伪代码实际令 key 窗口为空。受保护的 key 后缀仍然是精确的。独立实现前应澄清这个小的规格差异,不能把不一致的两句话同时当作严格定义。
3.2 解码时先进入近期窗口,再按块合并
每个新 K/V 先精确保存。未受保护的行离开近期窗口后,进入 pending FIFO;只要还没凑够一块,它仍是精确的。主配置的近期窗口是 128 行,常规更新块为 64 行。更新时机由队列是否满块决定,和残差阈值不是一回事。阈值控制要补充哪些特征方向,而不是哪些 token 值得保留。
value 的第一次更新比较特殊:先等 个符合条件的 value 离开近期窗口,把它们接到已重建的提示词 value 历史后,重新做一次秩为 的截断 SVD,之后才使用 64 行分块更新。换言之,调大 value 秩也改变了首次重新分解的样本量;不能把这个 rank sweep 理解成完全只改一个因素。
K 和 V 的精确位置集合不一定相同。例如,value 保护区经过邻域扩张,而 key 没有同样扩张。因而两个低秩矩阵的第 行,未必对应同一个 token。执行 attention 之前,必须各自按原始位置散回完整序列;如果只按压缩数组下标把 K/V 配对,会把语义位置弄错。
4. 分块增量 SVD:一步一步拆开
4.1 先分出新块在旧空间内、外的部分
设维护的旧历史为 ,新到达的精确块为 。这次要近似的目标是 。注意 已经不是原始历史,之前丢掉的信息不会自动回来。
先投影到旧基底,再扣除其重建:
是 坐标, 是旧空间解释不了的残差。理想精确算术下 ;有限精度下还会残留少量沿旧基底的分量,所以作者再扣一次 。之后对 做 reduced QR,再对 QR 的小因子做 SVD,获得可靠的新方向。
如果 ,或者旧基底已经满特征维度 ,就不添加残差方向。否则,设残差奇异值为 ,保留数量为
默认 , 为计算精度的 machine epsilon。最终 是保留下来的残差基底。尺度相关的阈值下限避免把浮点噪声当成新信息,但阈值太大又会误杀真实新方向。它是数值稳定性的门槛,不是语义重要性的分数。
4.2 大历史可以通过一个小核心来更新
假设残差空间被完整保留,有 和 。于是新块可写为
把这一式和旧历史放在一起:
这里 和 的列都正交,核心 只有 大小,不随历史行数 变大。于是不用每次都分解完整的 矩阵,只需要对这个核心做预算为 的截断 SVD:。
新因子由下面的式子得到:
把 分成上面的 行 和下面的 行 ,旧位置的左因子就变成 ,新位置则使用 。再乘新的 ,就是大家在新基底 下的坐标。所谓“历史跟着基底一起变”,发生在这一步,而不只是把新行附到数组末尾。
这也暴露了一个容易被“小核心”掩盖的成本:核心分解与 无关,但旧历史的坐标要全部更新。小 SVD 并不意味着整个更新的工作量与历史长度无关。
历史为空时,直接对 做截断 SVD 即可。若 ,也不是跳过更新:核心仍含 ,新数据可以改变旧空间内的奇异值和方向,只是没有引入空间外的方向。
算法 2:合并新块并同步历史坐标
1. 若历史为空,直接返回 F 的 rank-r SVD。
2. 计算 Q = F B,E = F - Q B^T。
3. 再扣除 E 沿 B 的分量,减小数值泄漏。
4. 对 E^T 做 QR + SVD,按残差阈值构造 P。
5. 构造核心 Z = [[Sigma, 0], [F B, F P]]。
6. 保留 Z 的前 r 个奇异分量,得到 G、Sigma+、H。
7. 用 U 乘 G 的旧行块,改写旧位置的左因子。
8. 接上 G 的新行块,并令 B+ = [B, P] H。
9. 保存新因子和新加入的原始位置编号。
4.3 局部最优,究竟“局部”在哪里
由于式(7)两侧外因子列正交,核心和大矩阵具有相同的非零奇异值。截断核心的前 个奇异分量,就得到当前目标 的最佳 rank- 近似:
这个结论要求精确算术,并且残差基底完整。如果阈值还丢掉了一部分残差,令 ,利用两个误差分量的正交性,可得
因此只报告核心尾部奇异值的能量是不够的,还要知道残差构造阶段丢了多少。实际低精度保存又会额外引入舍入误差,不能把精确算术等式原封不动当作机器结果的保证。
更重要的是, 的上半部分是“已经压缩过的历史”。下面是一个自构造例子,秩预算为 1:第一批数据为 ,截断后只留 方向,旧的 分量被丢掉。接着到来一行 。增量更新看到的平方奇异值为 16 和 9,仍会留下 。
但如果一直保留全部原数据, 方向总能量应该是 ,超过 的 16,完整历史的最佳 rank-1 近似会改为保留 。增量结果相对完整原数据的误差是 ,而新鲜 SVD 的最佳误差是 4。每一步都对自己看到的矩阵最优,并不等于最终对原历史最优。
这个例子不是说 iS-KV 在真实模型中必定出现这样的程度,而是说明它的数学边界:后来遇到相似新信息,也不一定能恢复早先被截断掉的累计证据。
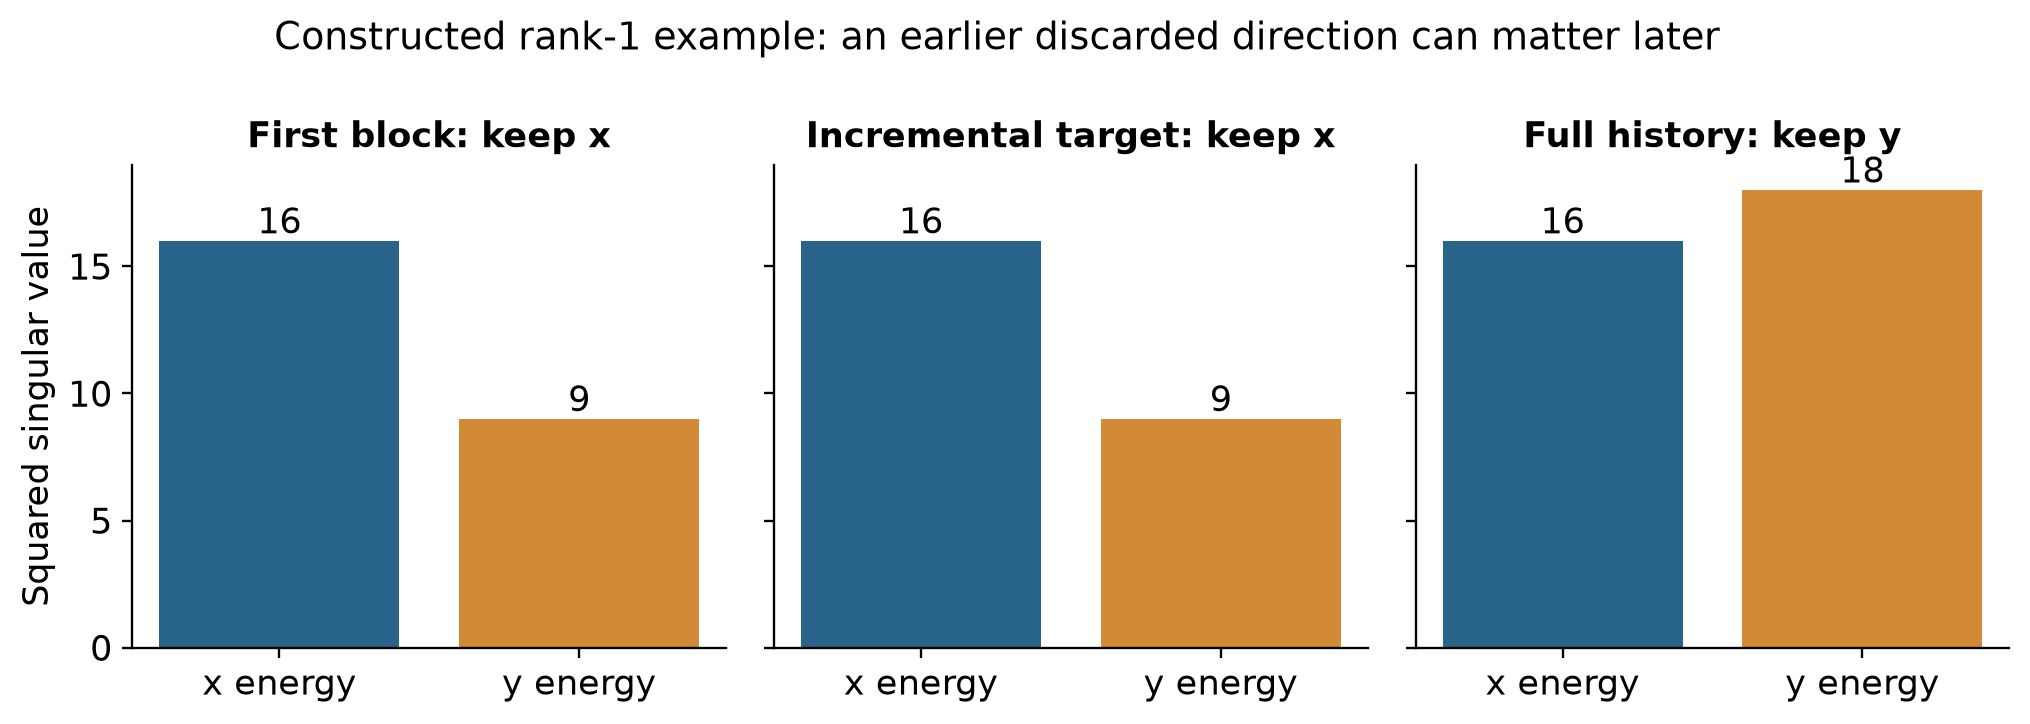
图 4。上文构造的 rank-1 例子。三幅图分别是第一批数据、增量更新实际看到的目标、完整原始历史。柱高为平方奇异值,不能解读成模型实验结果。
4.4 重新正交化修复数值条件,不找回遗失信息
重复低精度更新后, 和 的列可能偏离正交。作者定期做 thin QR:、,再分解小矩阵
把因子换成 、、,精确算术下乘积仍为原来的 。也就是说,换了一套数值条件更好的表示,但并没有重新接触被丢弃的历史分量。
主配置每处理 256 行常规 fold 就重新正交化;value 的第一次重新分解不计入这个计数。投影、残差处理、核心 SVD、重新正交化和重建均用 FP32,持久因子才使用两字节格式。分析内存时必须分开这两层,不能因为因子是 FP16/BF16,就把工作空间也都按两字节估算。
5. 小核心之外,还有哪些开销
算法 3:一次完整解码步
1. 将新 K/V 精确存入各自的近期窗口。
2. 窗口前移;未受保护且离开窗口的行进入 pending 队列。
3. 若 V 的首次 refit 未执行,等到 r_V 行后重新分解
   “重建的提示词 V 历史 + 这些新行”。
4. 其他情况在凑够 b 行后,对最旧的一块执行算法 2。
5. 常规更新累计到指定行数后,重新正交化。
6. 将合并位置转入压缩位置表,移除其精确副本。
7. 分别重建 K/V,并按原位置混合精确行与近似行。
8. 恢复 head 维度,为每个 key 使用它自己的 RoPE 位置。
9. 对重建后的缓存执行原本的 dense attention。
5.1 持久存储只是完整显存账单的一部分
对 ,设压缩行数为 、精确行数为 ,因子和精确行每个标量分别占 字节。每层持久存储量为
第一项包括 、共享基底 、 的对角元素;第二项包含 protected、recent、pending 的所有精确行。主配置没有额外缓存 的乘积。原始位置索引、未使用的预留容量、重建出来的 dense KV 和临时工作空间不在式(12)里。
为了看出共享基底的代价,先假设 K/V 使用相同秩、精度和行数。dense 存储是 ,压缩存储是 。同样的序列何时开始省字节?消掉共同的精确行项后得到
举例取 ,压缩历史至少需要 147 行才越过这一纯 payload 收支点。这是自行复算的说明性参数,不是某个模型测得的端到端阈值。精确行项在差值里抵消了,但精确行占比仍会影响整体压缩倍率。
当精确部分固定、历史足够长时,倍率趋近 。这里真正改变的是增长斜率:从 变成 ,不是把总内存变成常数。提示词保护的规模还可能随跨 head 的异常位置分布而变化。因此“固定秩”与“固定内存预算”是两件不同的事。
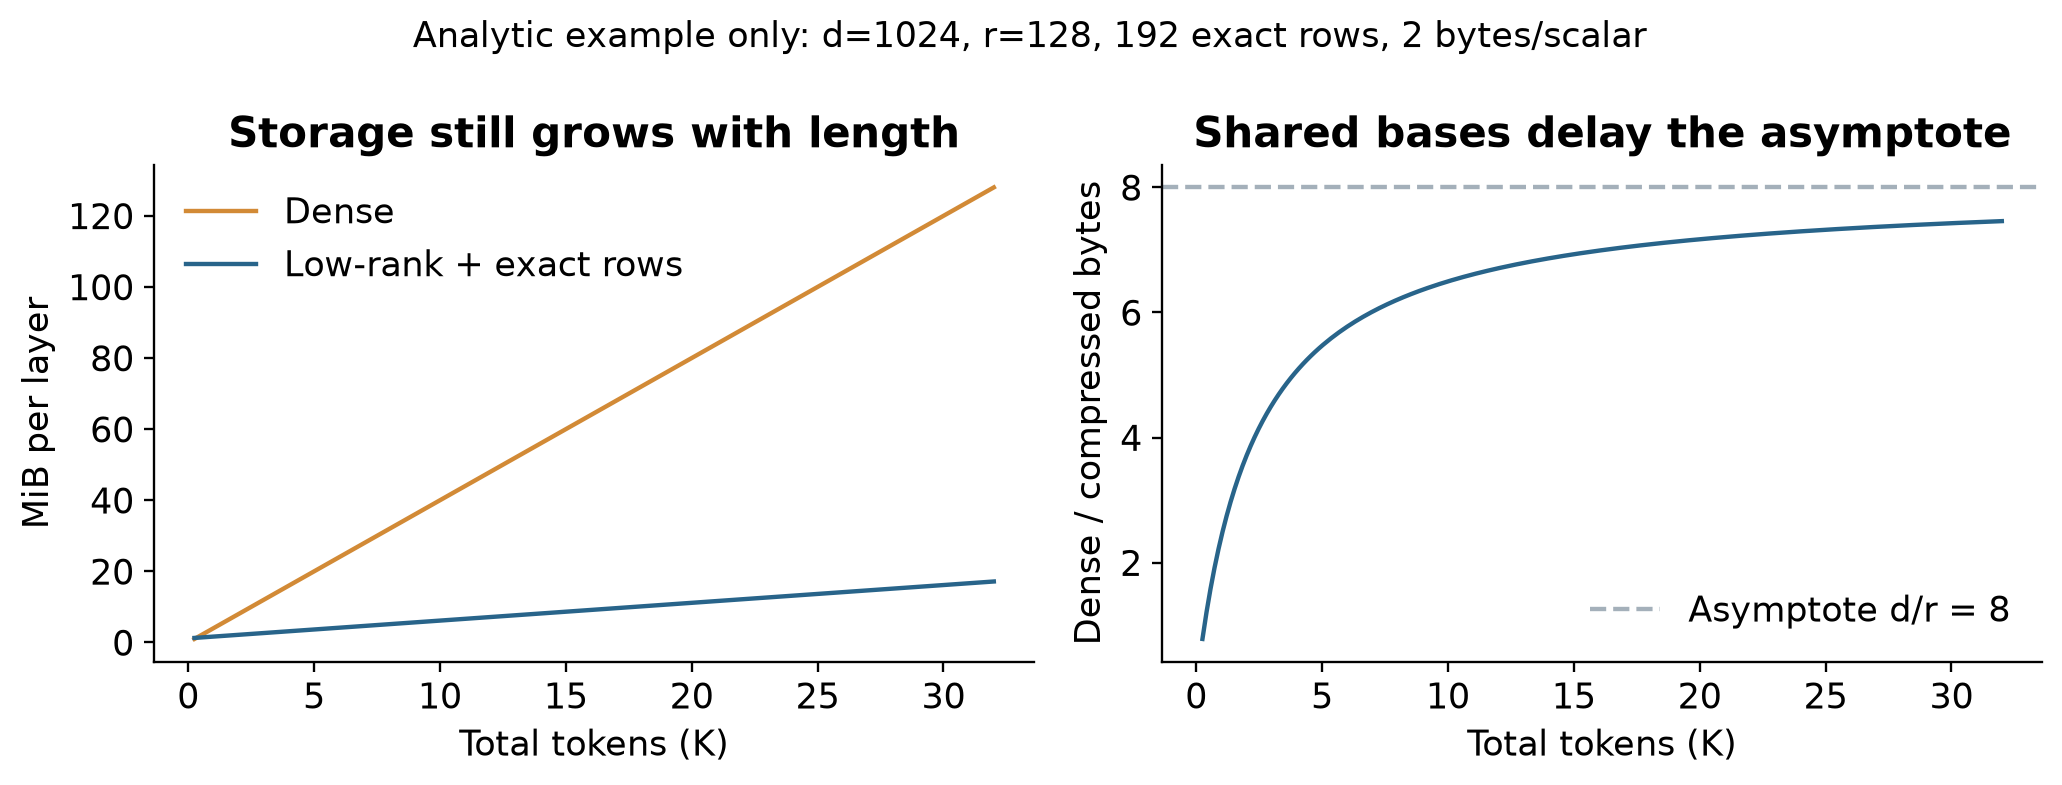
图 5。按式(12)绘制的说明性计算:、,每条路径精确保留 192 行,每个标量两字节。8 倍只是这组参数的渐近值,不是论文报告的通用实测结果;图中未计工作空间。
5.2 更新和重建为何仍然与历史长度有关
新块投影与残差计算约需 工作量;残差基底涉及一个 矩阵,核心最大约为 。但旧坐标改写需要 。按每块 个 token 平摊,只是把这一项除以 ,并没有消掉 。重新正交化和重建也都要接触历史。
一个自然想法是直接在因子上算 attention。如果没有每个位置不同的旋转,部分矩阵乘法可以重新结合;value 混合也可能在低维空间先完成。然而这里 key 在 RoPE 前压缩,每个 token 需要自己的位置旋转,不能简单给共享基底统一旋转一次就当作等价。
真正的 factor-aware kernel 还要处理精确行与近似行的混合、K/V 位置集合不同、数值精度与块更新。这是有价值的工程研究方向,但不能把它未来可能实现的收益,写成本文已经取得的加速。
6. 主要证据:相同持久内存下,推理质量怎样
6.1 MATH-500 是最扎实的一组比较
主实验使用完整 500 题,每题一次采样,temperature 0.6、top-p 0.95、top-k 50,总 prompt 加生成长度限制为 16,384。原模型、iS-KV 和 R-KV 对齐题目、提示词、每题种子与答案判定器;空输出和非有限输出算错。这控制了不少比较噪声,但并未测量多轮不同种子下的全部变化。
下面按论文 Table 1 转录主要结果。压缩倍率列属于 iS-KV;R-KV 的对应字节预算非常接近,但原表仍有微小差异。
| 模型 | 秩 | 持久 KV 压缩 | iS-KV | R-KV | 提升百分点 |
|---|---|---|---|---|---|
| DeepSeek 8B | 128 | 4.060× | 82.6% | 78.2% | 4.4 |
| DeepSeek 8B | 96 | 4.811× | 81.8% | 76.4% | 5.4 |
| DeepSeek 8B | 64 | 5.917× | 78.2% | 72.6% | 5.6 |
| Qwen3 8B | 128 | 4.681× | 92.0% | 71.4% | 20.6 |
| Qwen3 8B | 96 | 5.644× | 89.2% | 68.8% | 20.4 |
| Qwen3 8B | 64 | 7.118× | 87.8% | 60.8% | 27.0 |
两个原模型分别为 83.6% 和 94.4%。当秩从 128 降到 64,iS-KV 分别下降 4.4 和 4.2 个百分点。它在这些预算点明显优于 R-KV,同时仍然付出了相对原模型的质量损失。这两句话应当同时成立,不能只保留其中一句。
附录给出 DeepSeek 三个秩下配对题目 bootstrap 的 95% 区间,分别为 [1.6, 7.2]、[2.0, 8.8]、[2.2, 9.0] 个百分点。这支持在该配对样本上的优势,但不是换一个模型、任务或生成政策也必然有同样收益的保证。Qwen rank 96 的字节匹配相对差异仅 0.056%,因此不能把该点的大幅质量差异解释为明显多给了 iS-KV 内存。
内存账单计入 R-KV 的 128-token staging buffer,也计入 iS-KV 的共享因子和精确行。所有倍率统一在原模型的输出长度处计算。这一点很好:如果某种方法因为质量退化而更早停下,不应该把少生成 token 冒充压缩效率提升。固定参考长度把这两种影响尽量分开了。
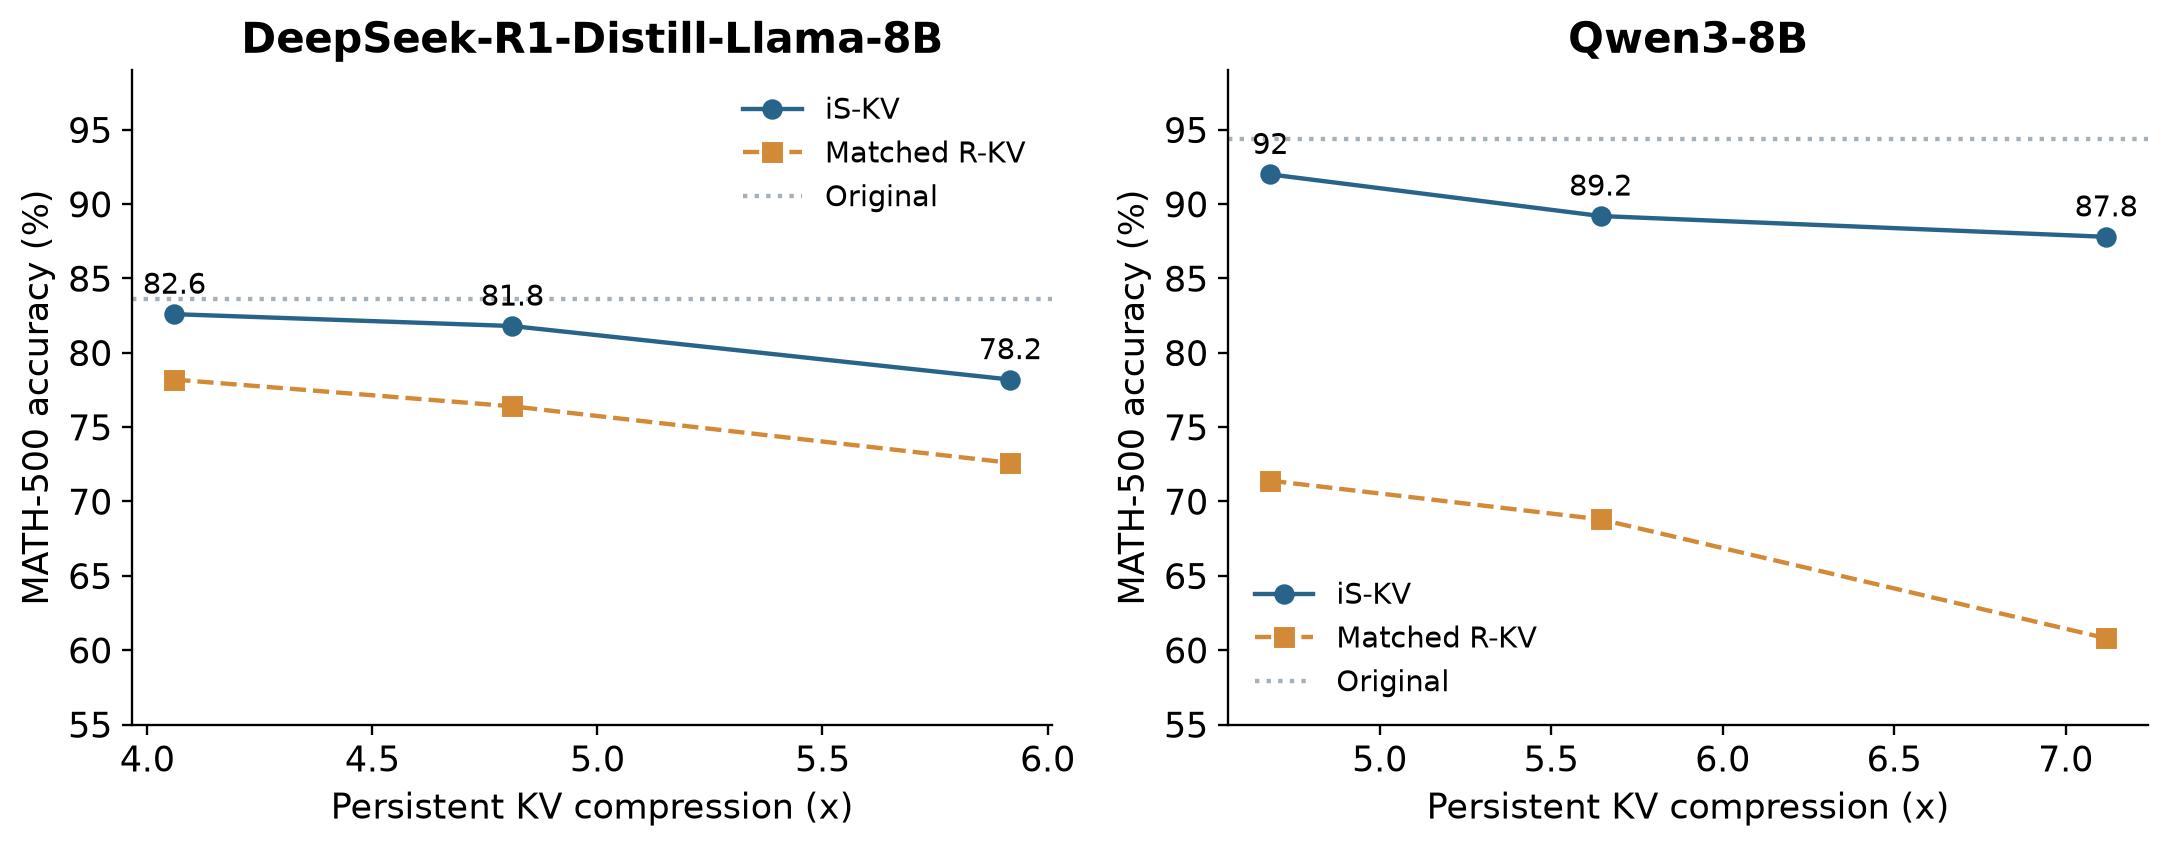
图 6。根据论文 Table 1 重绘。为方便对照,R-KV 使用对应 iS-KV 的横坐标绘图,原表保留了微小字节差异。虚线为各自原模型;此图不表示峰值显存或吞吐。
6.2 对另外两类 baseline,要降低结论强度
SnapKV 在六个点都低于 iS-KV,但来自已有 baseline 汇总,不是与另外三种方法完全相同的逐题配对流程。其一些准确率不是 0.2% 的整数倍,而 500 道二值判分题每对一题应变化 0.2%。论文因此只是按汇总百分比四舍五入推断 correct count,不能把这些推断计数当作真实逐题输出。比较最有说服力的是配对 R-KV,而不是声称所有 baseline 的控制程度完全一致。
OjaKV 的发布配置在 DeepSeek 上约 1.30 倍压缩、62.0% 准确率。作者还尝试更低秩以接近 iS-KV 的压缩范围,三组分别收集 30、28、60 条生成后提前停止,全部观察到重复直到长度上限、没有 EOS。这里总共是 118 条观察到的失败,不是完整 500 题上的“零准确率”。这些失败很有信息,但还不足以排除经过不同调参的所有在线基底更新方案。
6.3 AIME 的相同总分不等于无损
AIME 2024 和 2025 各 30 题,每题一次采样,总长度限制 32,768,Qwen3-8B 在这里改用 BF16 因子。AIME 2024 从 rank 64 到 192,iS-KV 准确率从 43.3% 升到 76.7%,匹配 R-KV 从 13.3% 升到 43.3%。rank 192 时,iS-KV 和原模型都答对 23 题。
每多对一题就约是 3.3 个百分点,样本很小。两个方法总分相同,不代表答对的是同一批题,也不证明统计等价。AIME 2025 同秩下,iS-KV 为 56.7%,高于 R-KV 的 40.0%,但仍低于原模型 63.3%。这支持较长推理场景下的方向性优势,不能包装成原模型行为完全保持。
6.4 消融更能说明在线适应的作用
在固定的 80 题 DeepSeek 子集、rank 96 下,原模型答对 67,K-only 68,V-only 65,冻结基底 51,完整 iS-KV 65。冻结与在线更新之间差了 14 题,即 17.5 个百分点,这是适应新生成状态的重要证据。K-only 只多对一题,则不宜解释成压缩提高了原模型能力。
还要同时看内存:K-only/V-only 都是 1.64 倍压缩,联合更新为 4.61 倍。它们固定的是单路径秩,不是相同总字节。V-only 与联合方法都答对 65 题,也不证明压缩 key 完全无害,可能只是错题集合不同。真正想知道预算应更偏向 K 还是 V,需要相同总内存下重新分配两者的秩。
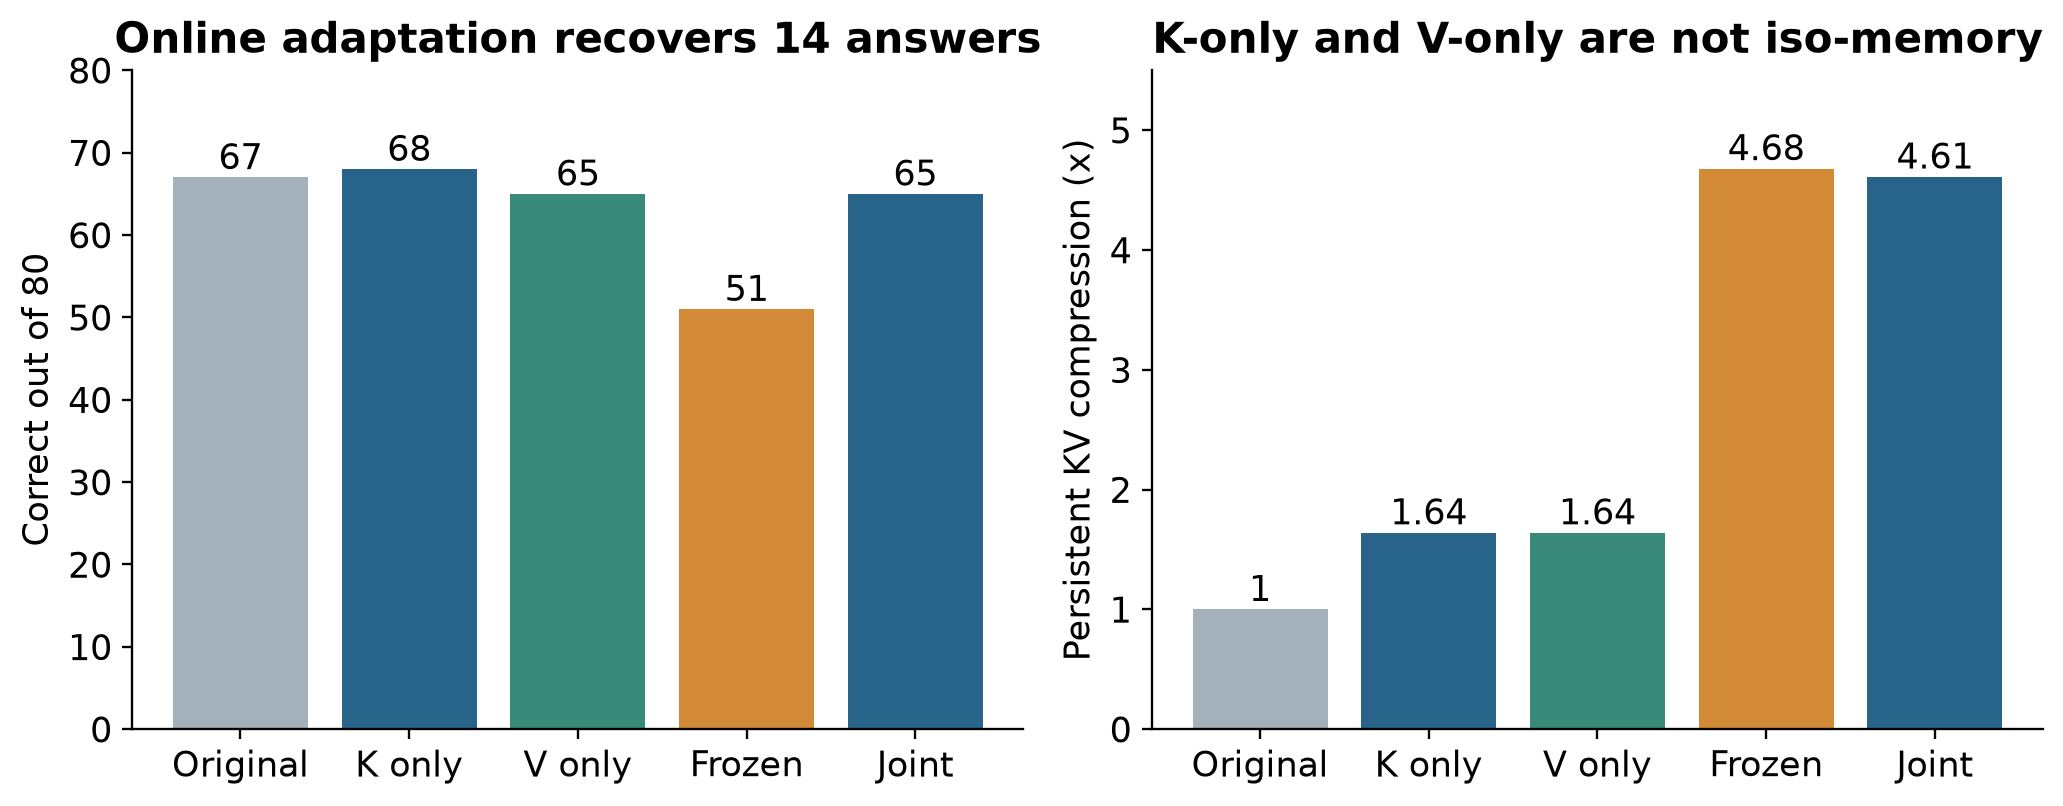
图 7。根据论文 Table 3 重绘。左图为真实的 80 题正确计数,右图为持久压缩倍率。冻结和在线更新的内存接近,而只压 K/V 的方法使用了更多总内存。
7. 长输入、速度和数值精度,决定能否实际使用
7.1 简单针检索通过,不代表所有长上下文任务都保持
64K RULER 包含 11 个任务,每个任务只有 10 个例子。rank 160 的配置在三个模型上都保住了三项 single-needle 的 100 分,但任务均值仍下降:GLM-4-9B-1M 从 89.6 到 87.8、压缩 2.67 倍;Llama-3-8B-Instruct-Gradient-1048k 从 87.3 到 86.3、压缩 2.29 倍;Llama-3.1-8B 从 85.6 到 79.0、压缩 2.23 倍。
rank 96 时,Llama-3.1-8B 的平均分降到 71.7,其中 multi-query 从 100 降到 46.6,multi-value 从 100 降到 41.6。可见“针还找得到”并不能概括需要多位置组合的检索。任务之间评分方式也不同,十个例子的规模不足以支持非常细的优劣排序。
这里还混合了配置变化:rank 96 用 128 行精确窗口、16 行 fold;rank 160 的 key 更新设置不同,value 精确近期窗口扩大为 512。更高分可能同时来自更大秩和更保守的精确保存,不能把两行结果解释成只加 rank 的收益。后续实验应固定其他条件,或明确拆分这些贡献。
7.2 实测确实省了持久 KV,但没有加速
效率实验在一张 A40 上运行 DeepSeek、batch size 1、rank 128,输入分别为合成的 8K、16K、32K,随后固定生成 1,024 步 greedy token。时间包括 prefill 和 decoding,不包括模型加载、扩展编译和缓存检查。每个方法—长度组合只有一次新进程运行,没有 inference warmup。
| 输入 | 原模型时间 | iS-KV 时间 | 时间增加 | 原 KV | iS-KV KV |
|---|---|---|---|---|---|
| 8K | 38.83 秒 | 47.45 秒 | 22.2% | 1.125 GiB | 0.746 GiB |
| 16K | 49.04 秒 | 58.32 秒 | 18.9% | 2.125 GiB | 1.185 GiB |
| 32K | 68.63 秒 | 74.70 秒 | 8.8% | 4.125 GiB | 1.808 GiB |
持久 KV 节省从 33.7% 增加到 56.2%,但时间在三个点都更长。额外开销比例变小值得继续研究,却不能外推到某个更长长度必然实现加速。单次、未预热的计时也不能给出稳定的平均延迟或尾延迟结论。
固定输出步数是一项有价值的控制:不会因为一种方法更早结束而显得更快。不过内存仍只统计持久 payload,未计重建 KV 与工作空间。尤其重建过程可能与模型其他分配同时存在,因此不能把 56.2% 说成总显存峰值减少。
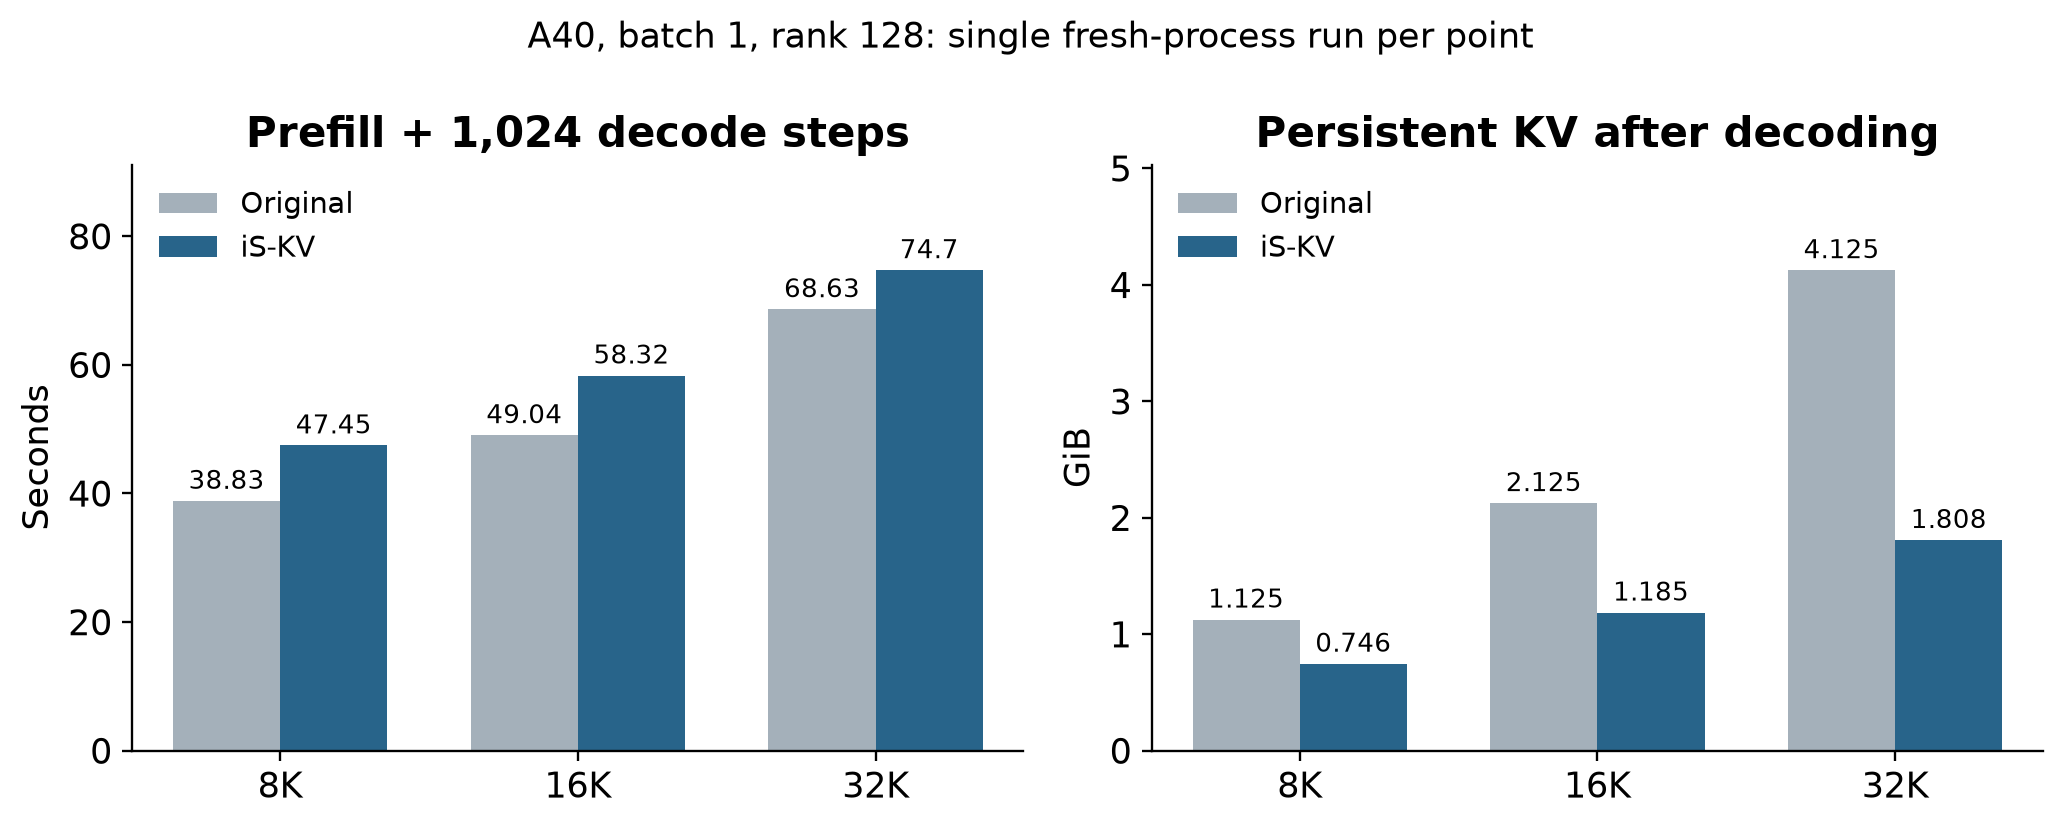
图 8。根据论文第 4.4 节及 Fig. 4 重绘。时间包含更新和重建,内存只包含持久 KV;每个点一次新进程运行。不能从右图的下降推导左图也应该下降。
7.3 两字节格式之间切换,模型行为也会变
MATH 实验持久因子用 FP16,更新计算用 FP32。在更长的 Qwen 生成中,作者观察到因子元素超过 FP16 最大有限值 65,504,转成无穷值,最后 logits 出现 NaN。派生的分解因子,尤其奇异值尺度,不必与原始 K/V 元素具有相同范围;“输入没有溢出”并不能保证因子也不会溢出。
所以全部 32K 实验改用 BF16 因子。BF16 和 FP16 都是两字节,存储倍率账面不变,但指数范围和尾数精度不同,不能因此说数值结果相同。BF16 用更大的动态范围换更少的尾数位;它解决的是一种溢出风险,不等于解决了所有长轨迹误差。
论文有一个很有启发性的对照:DeepSeek rank 128 的 AIME 2024,两种格式都得到 56.7%,但平均生成长度从 15,541 变成 18,126 token,撞长度上限的比例从 13% 变成 27%。只看答案分数,会看不到行为和资源消耗已经明显改变。因此精度格式应当写入完整配置,而不是藏在实现细节中。
附录另外定义 factor drift:相同参考矩阵 下,增量近似比同秩新鲜 SVD 多出的相对重建误差。
它衡量增量更新带来的额外代价,不是压缩的全部误差。单条 8,192 步 AIME 轨迹中,Table 5 的 key 误差约 0.0016–0.0071,value 为 0.0160–0.0207。这支持该轨迹上增量数值更新相对参考分解较接近,却不能推断相对于原模型 KV 或最终答案也只差这么一点。
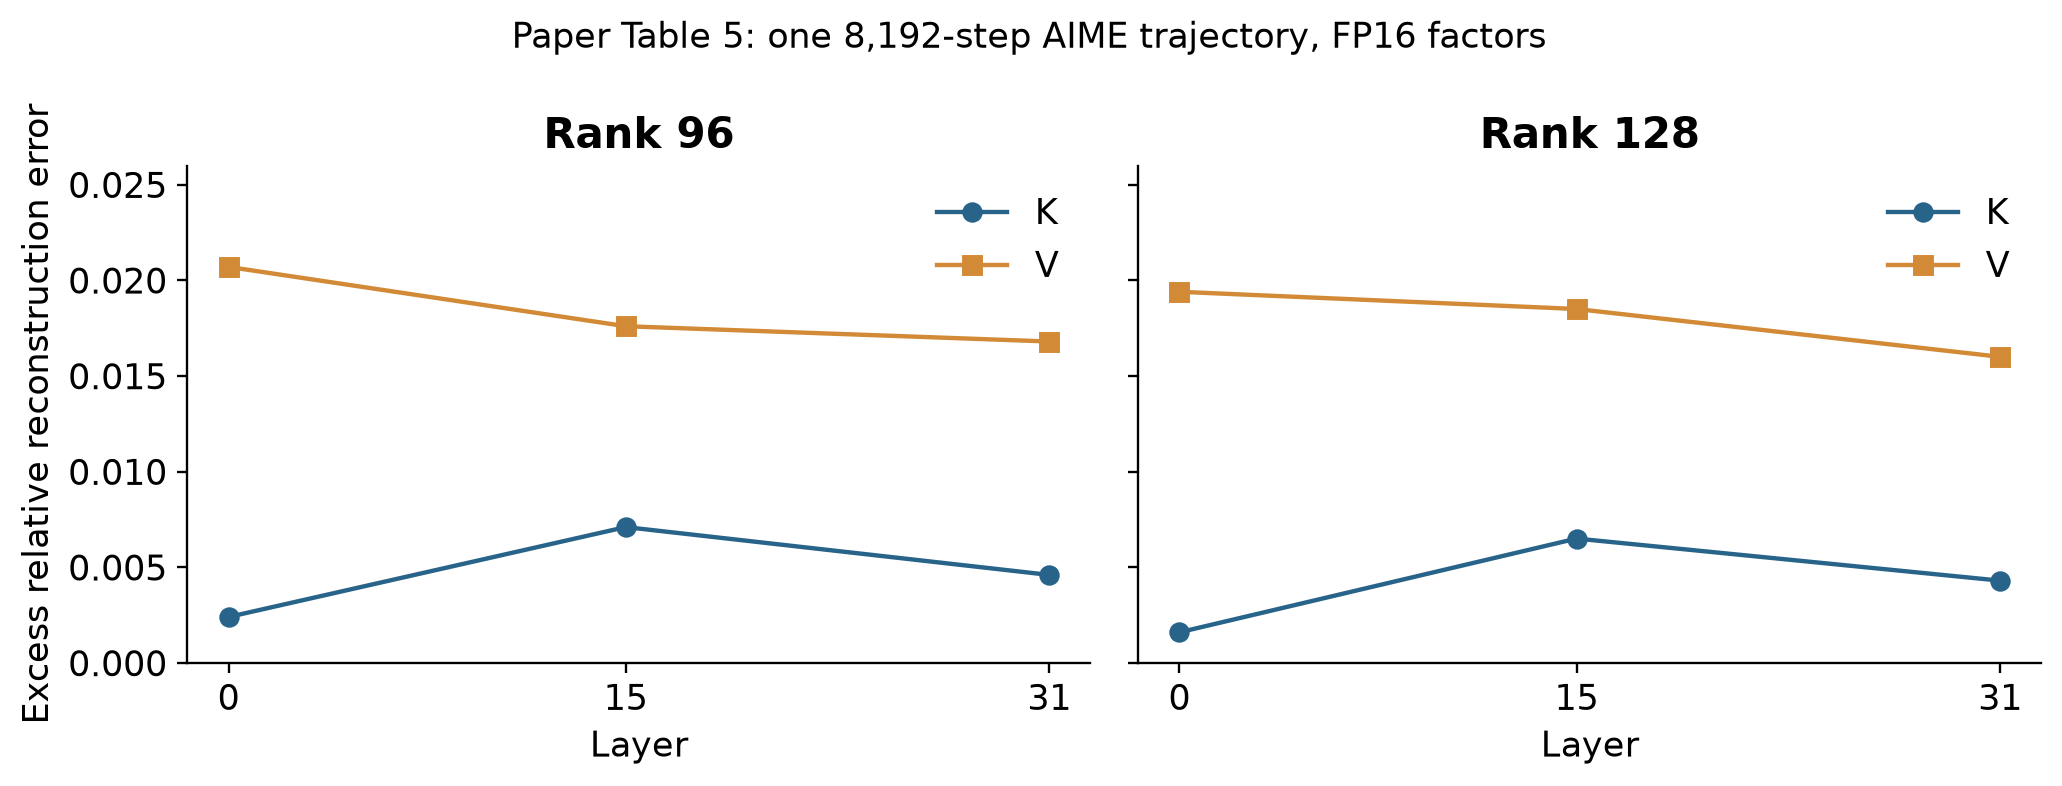
图 9。根据论文 Table 5 重绘,使用式(14)的 excess relative error。数据来自一条使用 FP16 因子的 8,192 步轨迹;它不是准确率下降,也不带统计置信区间。key 最大显示值为 0.0071。
重新正交化的一组报告结果是, 从 降到 ,表示乘积的相对变化中位数为 。作者同时说明,在 8K 步内它并没有降低重建误差。它的价值是维护后续更新所需的正交数值条件,而不是恢复低秩截断时遗失的信息。
8. 设计选择与复现实验应记录的条件
理解这类论文时,先问“固定了什么”比先看压缩倍率更有用。若独立重做主实验,应对齐提示词、每题种子、判分器、总长度限制、因子精度和原模型参考长度,并分别记录正确题数、实际终止长度、持久字节、峰值 allocated memory、峰值 reserved memory。这里列出的是评估设计建议,不是本文运行过的验证结果。
缓存政策也应完整记录:K/V 各自的秩、保护块大小和数量、value 邻域半径、近期窗口、常规 fold 大小、value 首次 refit、残差阈值和重新正交化间隔。只算每个 token 的 个坐标会漏掉共享基底与奇异值,在短历史上尤其容易高估收益。
不同替代方案解决的不是同一种问题。冻结提示词基底省掉历史坐标改写,但 80 题消融说明,它可能无法适应后续生成状态。扩大精确窗口能推迟压缩、保护近期依赖,却增加内存,也救不回很早丢掉的方向。减小秩降低增长斜率,却增大截断误差;增大 block 能摊薄更新频率,但 pending 精确行更多,核心也更大。
K/V 采用不对称秩是值得试的方向。value 的谱、单路径消融和增量漂移都暗示它可能更敏感,但这还不足以推出“预算一定应该多给 value”。key 的小误差可能经 query 放大,value 的误差则直接进入加权输出;最终分配仍需要相同总字节下的任务评估。
还可以区分几个误差层次:单次分解表达的矩阵误差、累计截断与舍入误差、固定 continuation 下的 attention/logit 变化、自由生成中的答案和终止行为。前一个层次做得好,不保证后一个层次也好。尤其自由生成会让一次小差异改变后续输入,之后不能再简单按同一轨迹逐 token 比较。论文的价值在于把部分层次分开报告,但它们之间的定量联系仍有空间。
9. 局限
第一,位置覆盖完整,特征信息仍然不可逆。低秩截断丢掉的分量不再保存,未来 query 即使访问同一位置,也无法把它们恢复。每步局部最优与完整历史的全局最佳 SVD 不是一回事,更与最佳答案行为不是一回事。
第二,内存与时间的结论有明确范围。这里降低的是持久 KV payload,未证明峰值 HBM 同比例下降;实际计时还展示了额外开销。固定秩仍让总存储随长度增长,历史坐标改写、重新正交化和重建也不是常数成本。服务系统中的并发、调度与缓存布局尚未被完整评估。
第三,实验覆盖不能视作普适推理保证。主要是两个 8B 推理模型,每题一次生成;AIME 只有 30 题,消融只有 80 题,RULER 每任务 10 例。更长长度还伴随格式或政策变化。SnapKV 的汇总来源、OjaKV 提前终止也削弱了某些比较的对称性。
第四,统一秩依赖重建代理目标。附录报告固定秩下保留能量的跨层变化较稳定,但保留 99% 能量所需秩并不恒定,Qwen 有 122–338 的跨度。统一秩是实用简化,不代表发现了所有层具有相同有效维度的规律。能量稳定也不等于各层对任务错误同样敏感。
10. 批判性分析
10.1 坐标一致性解决了必要问题,还没解决全部相关性问题
我认为这篇论文最清楚的贡献,是把“基底会变、坐标也必须变”说成一个可推导、可观测的问题。错误的坐标解释会直接破坏已经存下来的近似历史,先修复它是必要的。但真正驱动论文动机的,是未来 query 可能重新需要旧信息;Frobenius SVD 优先照顾的是当前总能量。两者之间还没有任务层面的保证。
一个更有针对性的后续实验,是记录被重新强关注的 token 上的 logit 扰动,观察这些扰动是否预测答案变化,再在相同持久字节下比较统一秩、逐层秩和 query 加权的近似。这样才能检验“谱更忠实”何时真的等于“未来更有用”,而不只是再展示一次整体谱衰减。
10.2 小核心分解的漂亮,需要完整系统账单来兑现
核心 SVD 尺寸不随历史增大,很容易给读者一种更新已经摆脱历史长度的印象。事实上,旧坐标仍要写回,dense KV 仍要重建。长序列时,这两类流量可能比小核心本身更重要。
下一步最值得做的并非继续堆一个更高压缩倍率,而是拆分时间与峰值分配:投影、核心 SVD、历史改写、重新正交化、重建、attention 各占多少;再用预热后的重复运行、多个 batch 和真实输出长度分布测试。根据结果,才知道更应该投资 factor-aware kernel、降低基底刷新频率,还是临时多保留一些秩来减少昂贵更新。这些都是内存、数值质量和调度之间的取舍,没有免费收益。
10.3 提示词保护政策应该有独立的预算消融
跨 head 取异常块并集,再扩张 value 邻域,是一种保守的保护方案,但它会随着提示词结构改变精确行数量。短题目可能全保留,长检索输入则压缩相当一部分。不同输入的总体压缩倍率,混合了分解质量与保护政策的影响。
更有帮助的实验是给 protected bytes 一个显式上限,扫描邻域半径,展示检索质量—内存曲线。在同样总预算下,把额外一份字节分别花在提示词保护、近期窗口、value 秩或 key 秩上,比较哪个位置最有效。这样才能判断优势主要来自增量分解、保守精确保存,还是它们的组合。
10.4 Baseline 和数值格式都应比较稳定工作区间
配对的 R-KV 结果是全文最有说服力的部分。OjaKV 的失败值得公开,但高压缩配置没有完整评分,不能据此终结所有替代方法的讨论。若给替代方案一个明确、对等的调参预算,再比较其稳定工作区间,对在线压缩方法的结论会更强。SnapKV 也值得在相同判分器下重新生成逐题输出,以消除汇总计数的不一致。
数值格式同样不能只比较一个最终分数。两种因子格式应在同样任务、多个种子上同时记录质量、长度和截断率。论文已经给出一个现成提醒:准确率相同,平均生成长度和撞上限比例却可以大幅变化。对服务系统而言,后两者会影响成本、内存驻留与尾延迟,不能被一个相同的答案分数遮住。
11. 结论
iS-KV 提供了一条清楚的在线 KV 压缩路径:位置保留,旧向量压缩,新数据推动基底变化时,同步更新历史坐标。经典分块增量 SVD 让这个过程有明确的局部最优性;精确近期窗口和提示词保护则控制近似发生在哪里。
现有结果支持它在测试预算下,比所比较的淘汰方法保住更多推理质量。但它仍然有损,内存仍增长,当前评测版本也没有实现推理加速。更值得期待的下一步,是把任务敏感的压缩目标与直接处理低秩表示的执行路径结合,并用完整显存和生成行为来评价效果。
参考资料
- Zhao 等,iS-KV: Online Low-Rank KV Cache Compression via Block-Incremental SVD,v1,2026-10-02。本文主要依据第 3–4 节、Table 1–5、附录 A–B。
- Brand,Fast Low-Rank Modifications of the Thin Singular Value Decomposition,2006。论文采用的经典增量分解基础。
- Bhatnagar 等,STAR-KV: Low-Rank KV Cache Compression via Soft Thresholding for Adaptive Rank Control,2026。自适应秩分配的相关方向,本文未独立评估。
- Chen 等,KV-CoRE: Benchmarking Data-Dependent Low-Rank Compressibility of KV-Caches in LLMs,v2,2026。数据依赖的 KV 可压缩性分析。