笔记日期: 2026-10-29
论文: HyScale: Scaling Long-Context Training for Learned Sparse Attention
作者: Yangshen Deng、Xinjing Huang、Yulong Wang、Yunzhuo Liu、Jun Hu、Shuyong Tan、Chun-Chih Tseng、Mingji Han、Ray Ying、Key Zhang、Luo Mai
版本与日期: arXiv:2610.32057v2,2026-10-26
资料: 论文页面 · 本次阅读 PDF · 全文
1. 注意力已经稀疏,训练为什么还是很慢?
把上下文拉到百万 token,最直观的优化是让每个 query 只关注少量位置。但「只读少量位置」前面还有一个问题:这些位置从哪里来?学习式稀疏注意力通常先用一个较轻的 indexer 给候选位置打分,再选出 top-k,最后才运行主要的注意力计算。后半段是稀疏的,前半段却可能仍然扫描全部历史。
训练又多加了一层成本。为了省显存,系统常在前向之后丢弃层内激活,等反向需要时重新运行这一层。这样一来,刚刚做过的全上下文评分和 top-k 选择,又完整执行了一遍。模型明明只使用 k 个位置,系统却在训练的两个阶段分别寻找同一组位置。
HyScale 的切入点很具体:真正需要从前向带到反向的,是「选中了哪些位置」。完整评分表只是得到这个结果的中间过程。如果 indexer 的训练损失也只依赖被选位置,那么被丢弃的那些分数既不参与主要注意力,也不参与 indexer 梯度。保存它们、或者为了重新找到相同索引而再算一遍,都可能是不必要的。[1,第 2–3 节]
论文围绕这个观察设计了两个机制。HyTopK 在第一次扫描时一边打分一边筛选,避免把完整评分表写入显存;selection replay 则保存前向选择,在重算阶段只计算选中位置的必要数值。随后再调整通信依赖和稀疏算子的访问方式,处理选择变快后仍然存在的系统成本。
最值得记住的实验数字是:在 512 张 H20 上,完整 GLM-5.1 的百万 token 训练速度提升 2.07 倍。但论文还有其他数字,它们不能混在一起。CSA 的 2.01 倍、QSA 的 1.57 倍来自单层实验;八百万上下文的 22.3 倍也来自单个注意力层的上下文并行测试。这些结果分别说明整模型收益、跨架构适用性和扩展瓶颈,测量范围并不相同。
本文的实验数据均来自作者报告。后面的内存算式、阈值小例子、复杂度比例和通信模型是帮助理解的分析,不是额外跑出的训练结果。读这篇论文时,我更关注一个可迁移的问题:哪些昂贵计算最终只留下一个很小的离散决定,而这个决定值得跨过激活检查点保留下来?
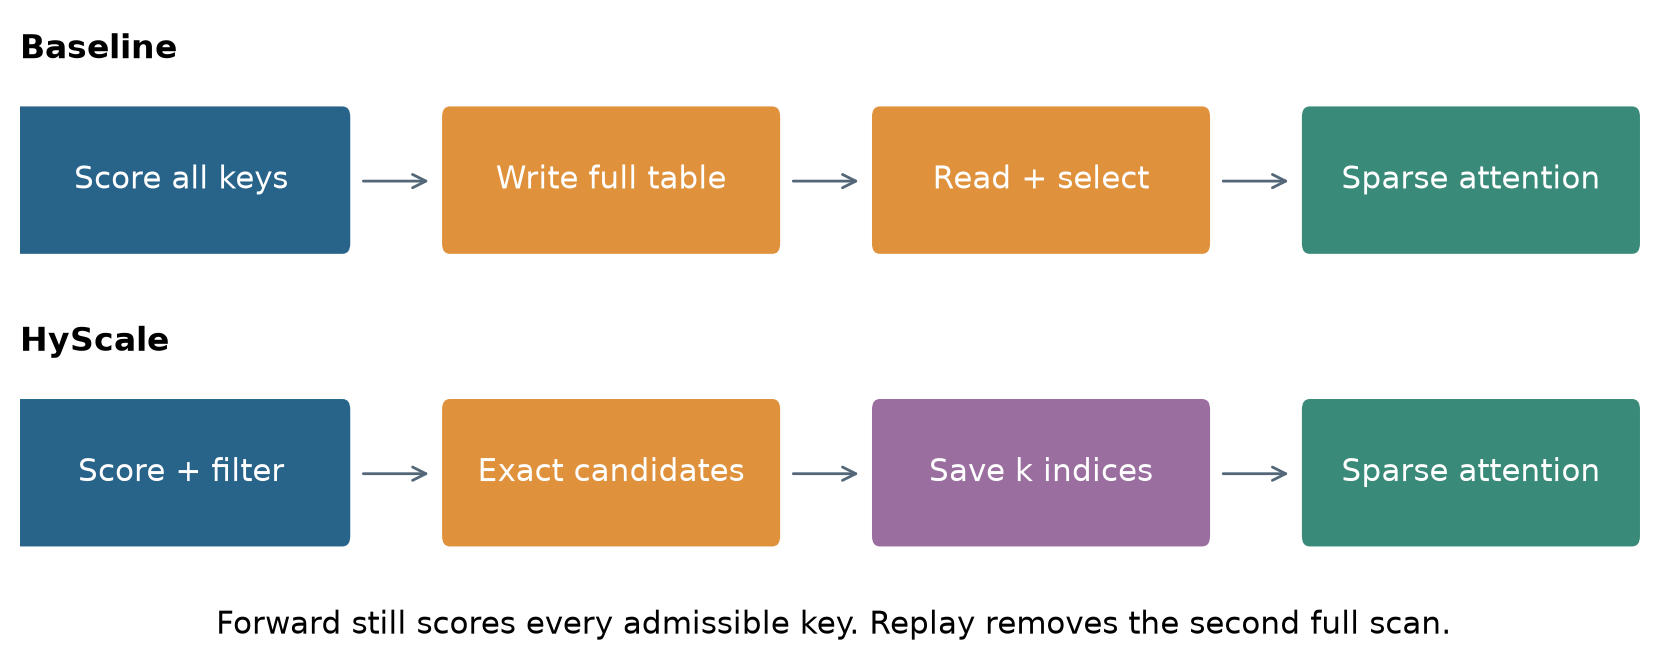
图 1. 根据论文图 2–3 绘制的解释图。HyScale 的前向仍扫描全部合法候选;减少的是评分表物化,以及重算阶段的第二次完整扫描。箭头表达依赖,不表达实测时长。
2. 先分清三种状态:评分、索引和被选位置的数值
Indexer 的 key 与注意力的 KV 不是同一份东西
以论文使用的 DSA 为例,indexer 有自己的 query 投影和 key 投影。多个 indexer head 对同一个 key 计算内积、经过 ReLU,再按权重聚合成一个分数。这个分数用来选择位置。主要注意力则使用另一组 query 和被选中的 KV 状态;在 MLA 中,后者涉及压缩 latent 及位置相关分量。
这一区分直接决定通信能否重叠。选择阶段只需要 indexer keys,不必等待主要注意力的全部 KV 到齐。注意力阶段需要 KV,但那已经是选择之后。把两类数据统一放在一个「计算开始前全部等齐」的屏障后面,会引入数据流本身并不要求的等待。
记完整上下文长度为 ,上下文并行规模为 ,每张卡名义上处理 个 query。对某个 query ,实际合法候选数记为 ,它还受因果掩码、序列边界和 block 划分影响。论文常用 的矩形规模解释成本,这是便于比较的上界式表达,不代表每个位置都应该看完整上下文。
尤其要注意序列打包。两个序列即使在内存中相邻,也不意味着前一个序列的 token 对后一个序列合法。保存索引时,必须同时保持它所处的序列布局和位置语义。否则「重放同一个整数」不等于「重放同一个 token」。
激活重算为什么容易浪费这一步
通常的 checkpoint 策略只回答两个问题:某个算子的输出保不保留?不保留时,算子要不要重跑?对于一个巨大连续张量,这样的粒度很自然;但 top-k 的输出是一小组整数,产生它的评分算子却可能生成巨大的矩阵。
因此需要区分三件事:所有候选的分数、最终索引集合、在这个集合上求得的数值。保存索引并不意味着反向所需数值都自动存在;反过来,反向需要一些数值,也不意味着必须重建所有候选的分数。HyScale 利用的正是两者之间的空间。
如果只把 top-k 输出标记为「保存」,却仍然完整重跑前面的评分算子,计算浪费没有消失。真正的改变是让评分重算知道下游只需要哪些条目。从「整个算子是否重算」转向「算子中的哪些条目需要重算」,才是 selection replay 的核心。
精确性到底指什么
本文所说的精确 top-k,是在明确的分数比较与并列规则下,返回与完整候选集精确选择一致的位置。它并不让稀疏注意力等价于稠密注意力;模型本来就采用稀疏支持集。它也不自动保证整个分布式训练逐位一致,因为其他归约、通信和浮点累加仍有自己的行为。
论文处理的是候选写入顺序和最终索引顺序造成的不确定性。这是一个范围清楚、可以解释的保证。读者应该把「选中集合相同」「结果顺序固定」「数学梯度等价」「整个训练过程逐位一致」分开,而不是把其中一项的证据转移给其他项。
3. 为什么没选中的分数可以不重算:从损失推到梯度
对 query 的合法候选集合 ,DSA indexer 可以写成:
上标 表示 indexer;没有上标的 和 属于主要注意力。 是 indexer head 数。 是位置集合,不是一组连续权重。在没有名次交叉的位置附近,它相对于分数局部不变。论文采用的训练规则是在固定支持集上对数值求导,而不是对索引如何跳到另一个位置求导。[1,公式 1–4、附录 A]
Indexer 的监督来自主要稀疏注意力在选中集合上的分布。将注意力权重跨 head 平均,得到停止梯度的目标 。Indexer 在同一支持集上的预测是:
推导关键不在于公式复杂,而在于求和范围。先把 和 固定。KL 中的 项是常量;另一项展开后,是目标加权的负分数,加上选中位置上的 log-sum-exp。前者对分数求导得到 ,后者得到 。因此:
未选位置的梯度为零,依赖的是这里的具体损失和求导约定。假如另一种方法在全上下文上归一化,或者使用需要所有候选分数的蒸馏目标,结论就要重推。仅仅看见模型里有一个 top-k,不能据此宣布所有未选分数都可以丢掉。
继续定义 ,链式法则得到:
三个式子的求和都只涉及选中位置。这证明的是依赖范围缩小,不是反向不再需要任何中间数值。例如 ReLU 的门控仍需要对应 head 的内积正负;一个聚合后的 scalar score 并不能神奇地替代所有内部依赖。默认的 index replay 会从重算得到的投影和保存的索引中,恢复这些被选位置上的必要数值。
论文还明确了 indexer 输入停止梯度:这个辅助损失更新 indexer 的投影参数,不沿主要注意力输入继续反传。目标分布也 detach,避免 indexer 的 KL 通过目标反过来改变 attention。两个停止梯度位置都属于该架构的训练定义,而不是实现时可以随便省略的细节。
4. 把显存与算量换成可核对的数字
取论文百万上下文的例子:、、,indexer 有 32 个 head,每个 head 维度 128。若分数为 FP32、索引为 32 位整数:
这里使用二进制单位,数字针对单层、单 GPU 的这部分状态。它不是完整训练的峰值显存,也没有包括候选缓冲、投影、通信副本等内容。特别是 64 MiB 的索引状态,不能拿来与整个选择算子的峰值混比。论文实际报告的 HyTopK 选择峰值为 1.5–1.9 GiB,其中包括候选缓冲。[1,表 1、图 11]
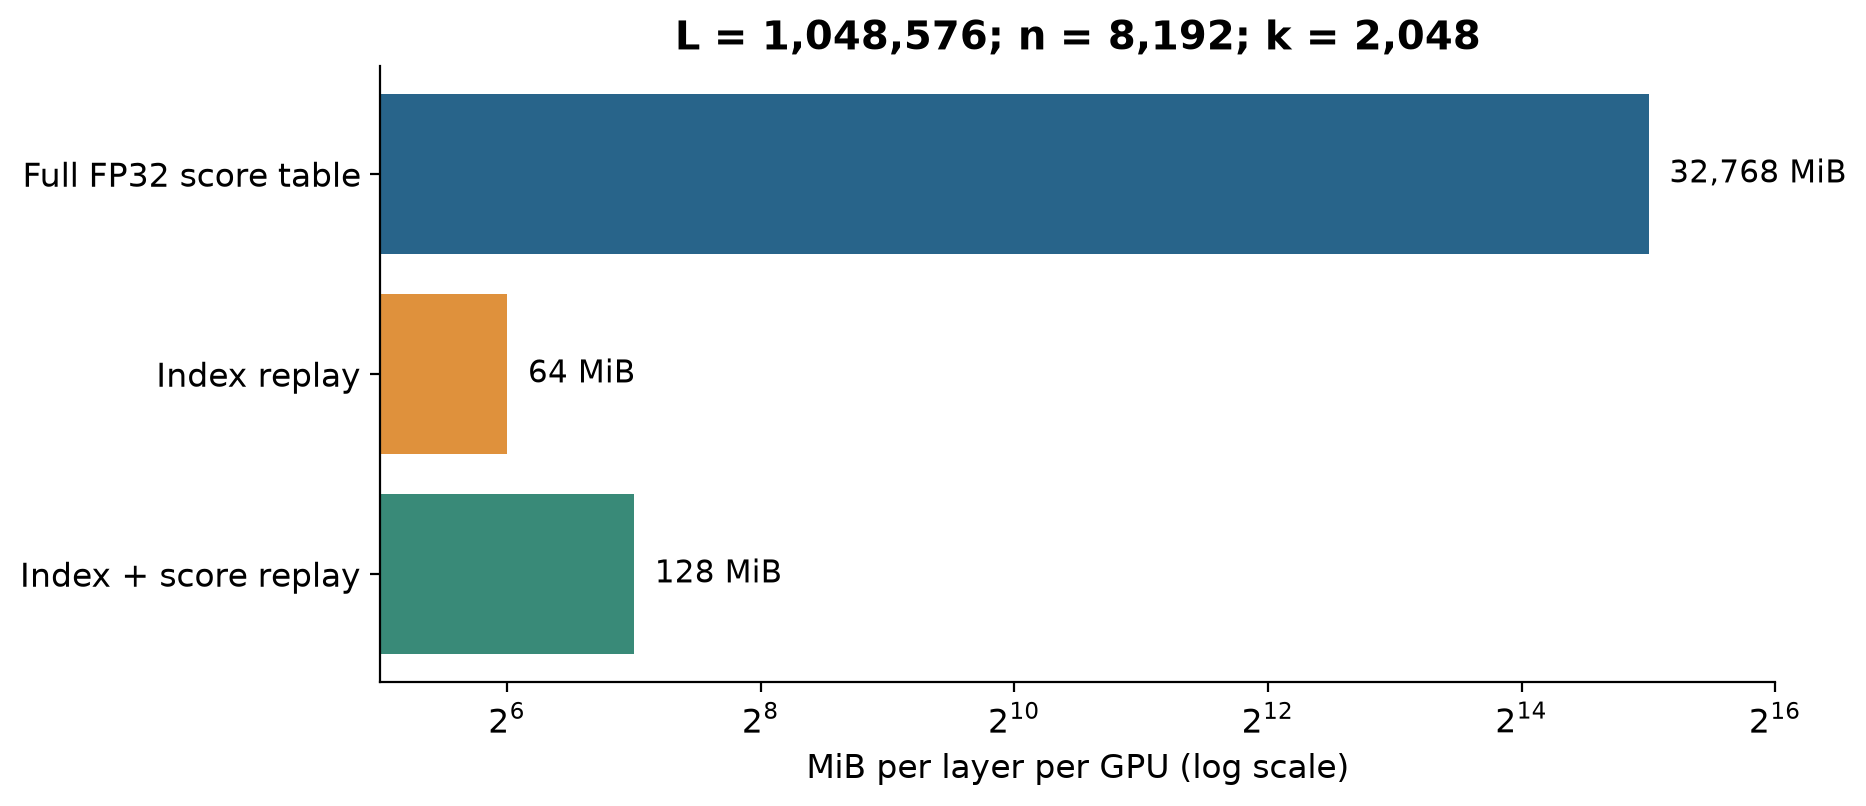
图 2. 根据论文表 1 计算的状态大小。横轴为对数尺度;比较的是选取相关的保留状态,不是整模型显存。
算量也能逐步算清。完整评分重算的主要内积工作约为 ;只重算选中位置则为 。前面的 2 把一次乘法和一次加法分别计数。代入这些维度,分别约为 70.37 万亿和 0.1374 万亿次操作,比例仍然是 512。
这不等于训练加速 512 倍。Gather、投影、稀疏 attention、通信和 kernel 启动都还在。一个系统优化说明里最容易出错的地方,就是把局部工作量比例直接写成实际速度。这里的比例只用于说明为何保存小索引、重算小支持集在量级上合理。
可以把几种策略沿着同一问题比较。全部重算,显存最低,但重新做完整选择;保存 indexer 输入,能省掉部分投影,仍然需要对所有 keys 评分;保存完整分数,可以少做内积,却留下大张量;只保存 top-k 索引但不改评分重算范围,仍然浪费计算。HyScale 的 index replay 同时保存索引和限制重算条目,才避开这个两难。
另一个变体是 score replay,再多保存选中的分数。论文默认选择 index replay,因为所需的小范围重评分最多占一个训练 step 的 1.6%,却能在其 GLM-5.1 配置下,相比 score replay 省约 5 GiB/GPU。这是基于该配置测得的权衡,并不是「凡是多算一点都更好」。
索引还可以放到 pinned host memory。前向选完后异步拷走,与 attention 重叠;重算进入对应层时再拷回,与投影重叠。这个方案成立的前提是传输赶得上消费者,并且没有与别的传输争抢过多资源。索引虽然小,却依然是一份需要管理生命周期的真实数据。
5. HyTopK:阈值允许猜错,最终结果仍要精确
采样估计的是筛选阈值
如果一个 query 面对百万个分数,最终只要 2,048 个,先把百万个分数写到显存再读回来选择,代价很大。更直接的做法是在打分 kernel 内部检查阈值,只把通过阈值的候选写入小缓冲区,随后在这个候选集合上运行精确 top-k。
一个严格低于真实第 k 名分数的阈值,当然不会漏掉正确答案,但它可能低得过头,放进大量无用候选。借用邻近 query 选中的 keys 估计阈值,也会遇到相同问题:那些 keys 对邻居重要,不一定对当前 query 重要。在上下文并行下,邻居还可能位于另一张卡上,与当前 query 同时执行,无法先等它选好再开始。
HyTopK 改用当前 query 自己的合法上下文,均匀跨步选取样本。对足够长的上下文,论文给出:
为什么有一个 3?如果样本能代表总体,采样中的这个名次大约对应全体的第 名,从而让约 个候选通过。它留出了一定余量,降低阈值过高的风险。这里是统计直觉,不是对任意分数分布都成立的确定性上界。
代入百万上下文和 k = 2048,可以得到样本数 8192,采样名次 48。第 48 大采样值大致用于估计总体第 6144 名附近的分数。默认候选缓冲为 16K 个槽位,比预期通过量进一步宽松。为了让矩阵乘法更高效,几个相邻 query 可以共享采样位置,但每个 query 仍然计算自己对这些位置的分数;这与直接借邻居的最终选择不同。
短前缀需要单独看。若合法候选本来少于样本数,或计算出的采样名次不在有效范围,不能机械套用长上下文公式。一个完整的通用算法应有精确短上下文路径或等价边界处理。后面的解释性伪代码将这一前提写出来,避免把长上下文参数误当成无条件适用的算法。
为什么候选计数能保护精确性
设阈值筛出的集合为 。如果全体合法 keys 都扫描完了、没有候选因溢出而丢失,并且 ,那么在 上做精确 top-k 就足够。原因很简单:被排除的元素都低于阈值,而集合里已经有至少 k 个达到阈值的元素,真正的 top-k 不可能出现在被排除部分。
阈值偏高时,可能只留下不到 k 个,这时检查计数即可发现失败。阈值偏低时,候选可能超过缓冲容量,溢出标记必须让本次选择失效。两种情况都进入恢复路径:重新对该 query 的全部合法上下文评分,再进行精确选择。
因此「乐观」修饰的是常见路径的资源估计,不是最终答案的正确性。它允许一个快速提议失败,但不允许失败的提议直接被 attention 消费。遇到并列分数,还需要一致的包含条件和次级排序规则,否则集合大小正确也未必返回约定的那一组位置。
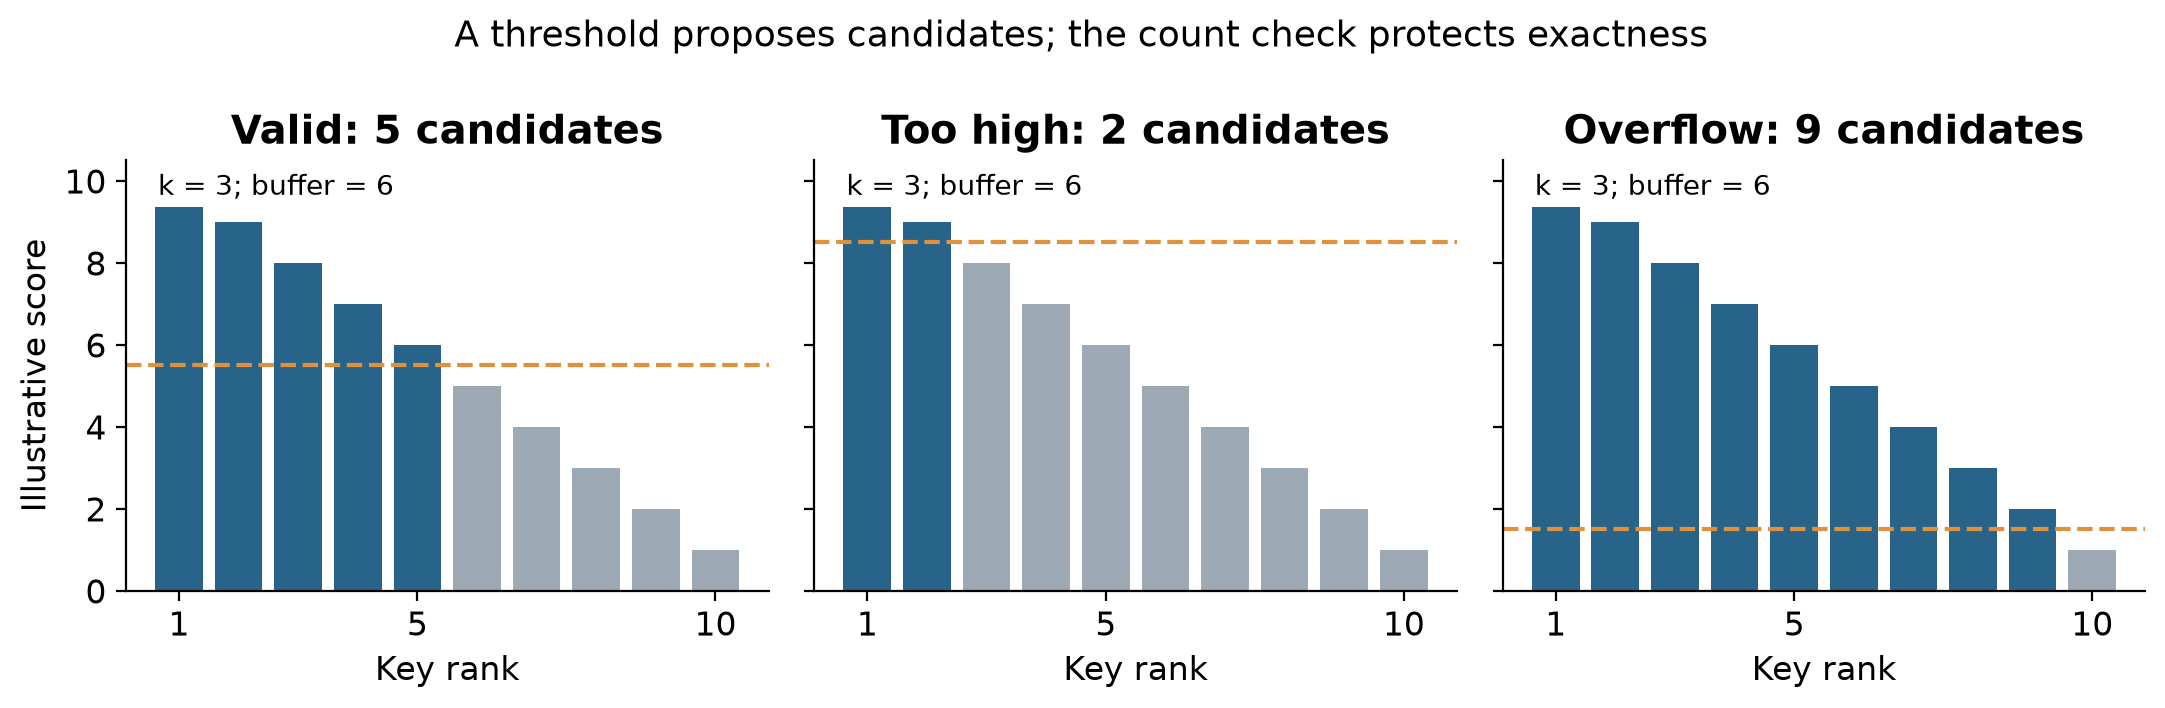
图 3. 自拟的十个分数示例,k = 3、缓冲容量为 6。左图可直接在候选中精确选择;中图候选不足,右图溢出,都必须恢复。这不是论文的实测分数。
算法 1:带恢复路径的精确选择
以下伪代码用于解释方法契约,补充了保守的短上下文回退;它不是某个实际 kernel 的逐行转写。
1. 为每个 query 确定满足因果与序列边界的候选集合 U。
2. 若 U 太短而不适用采样规则,直接进行精确选择。
3. 对跨步样本评分,估计当前 query 的阈值 tau。
4. 扫描 U 中每个 key,把分数 >= tau 的候选加入缓冲。
5. 记录真实候选计数以及是否发生过缓冲溢出。
6. 若计数不足 k 或曾发生溢出,把该 query 标记为失败。
7. 对有效候选集,按分数和位置规则选择精确的 k 项。
8. 对失败 query,完整重评分并执行精确 top-k 恢复。
9. 将最终 k 项按分数排序,同分时按位置排序。
10. 把这组有序索引交给 attention,并保存用于重放。
恢复不必先把失败数量传回 CPU 再决定如何启动。HyTopK 在 GPU 上记录失败列表和计数,随后固定启动一串小 kernel。没有失败时立即返回;少量失败时只重做失败的 query。论文说明定向恢复处理最多 64 个失败 query,超过时回退到完整重评分;实验中每次 selection 观察到的失败数没有超过 4。[1,第 3.2、4.6 节]
这样设计的价值是把失败成本限制在少数条目,而不是宣称失败不会发生。正确性由完整恢复负责,平均性能由失败分布决定。若数据形成大量并列值、特殊周期性,或跨步样本不再代表总体,算法仍可以正确,但加速收益可能下降。
6. 确定性与重放:分别固定决定和复用决定
候选缓冲通常通过原子操作追加。多个线程块的执行先后不同,即使通过阈值的元素完全相同,缓冲中的排列也可能不同。这个变化会影响两件事:第 k 名附近出现并列时保留谁,以及 attention 按什么顺序累加浮点数。
一种直接方案是把所有候选先按位置排序,但候选可能远多于 k,成本不必要地放大。HyTopK 只处理真正影响输出的部分:对临界并列分数,优先保留位置较小者;对最终 k 项,再按分数、位置形成固定顺序。论文使用 radix select 处理截断处并列,使用 radix sort 排最终集合。[1,第 3.2 节]
看一个简单例子:四个分数为 ,要选两个。若只对「原子追加碰巧先出现的两个」排序,并不能修复集合成员的不确定性。必须先按位置规则决定三个 8 中选谁。反过来,即使成员正确,输出顺序不固定,也没有给后续浮点归约定义唯一顺序。
重放处理另一个时间维度的问题。前向已决定使用哪组索引,反向前的重算就沿这组支持集恢复数值,不再重新做同一个决定。尤其在并列附近,重新运行选择可能得到另一个分数相同但成员不同的集合;保存前向决定,可以确保当前反向与实际发生的前向相匹配。
算法 2:一层训练中的 index replay
1. 前向:计算 indexer 与主要 attention 的投影。
2. 收集 indexer keys,运行精确 HyTopK。
3. 保存被选索引,可异步转存到 pinned host memory。
4. 在该支持集上计算稀疏 attention 和 indexer 损失。
5. 按 checkpoint 策略丢弃可重算的激活。
6. 重算:恢复同一层输入和必要的随机状态。
7. 恢复保存的索引,重新计算需要的投影。
8. 仅 gather 并评分这些选中位置。
9. 在相同支持集上重算主要 attention。
10. 反向:累加选中条目的梯度,执行所需 reduce-scatter。
索引必须对应正确的层、microbatch、序列布局和前向调用。它不是跨 optimizer step 的缓存,也不是假设模型更新后仍会选择相同位置。若把旧索引用到新的参数或新序列上,就成了另一种近似训练方法,不能再沿用本文的等价性解释。
重算还必须恢复必要的随机状态。保存支持集并不能替代 dropout 等算子的随机数管理。如果 layer input、mask 或投影所依赖的状态发生了变化,即使位置相同,数值也未必对应原来的前向。这个边界与一般 checkpoint 正确性是一致的。
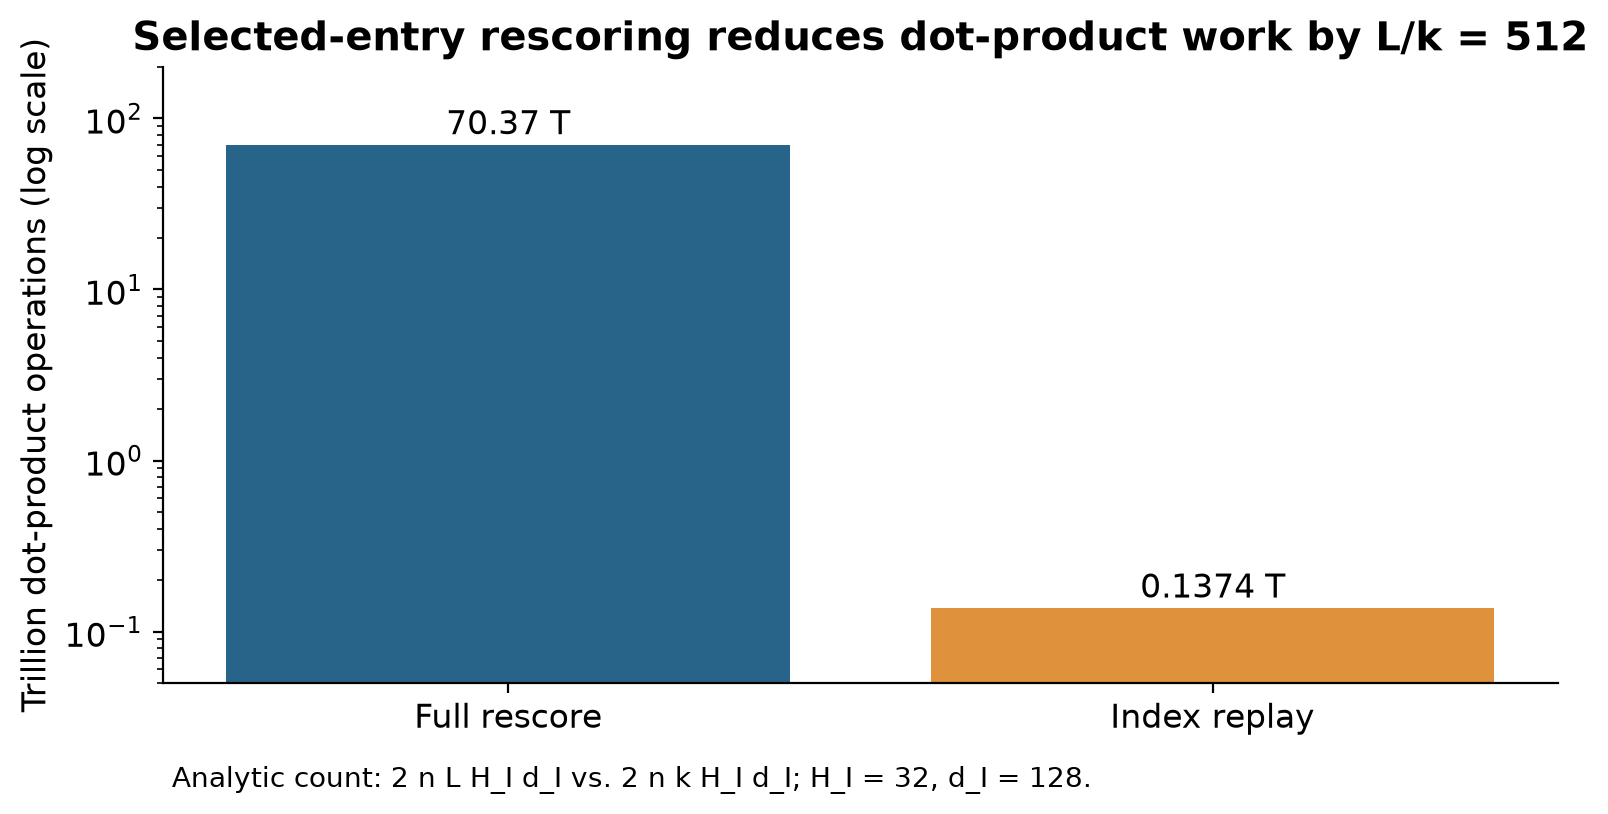
图 4. 由论文表 1 的操作计数计算。512 倍是此处内积工作量之比,不是单层或完整训练的实测加速倍数。
7. 主要注意力的反向,也只需要原来的支持集
附录 A 不只分析 indexer,还分析主要注意力。对一个 head,在保存的支持集上定义 ,,输出为 。给定上游梯度 ,先对加权求和求导,有 。
接着乘以 softmax Jacobian:当前位置的导数,要减去由注意力权重加权的平均导数。再代回输出定义,就得到:
对 latent 的梯度有两部分:作为 key 时贡献与 成比例的项;作为 value 时贡献 ,后者落在 latent 的 value 分量。所有选中该位置的 query 和 head 都要累加贡献。整个推导没有引入未选位置,因此支持集外的数值不构成该层稀疏 attention 反向的依赖。[1,附录 A]
在上下文并行下,各 rank 只处理自己的 query,却可能给其他 rank 拥有的 key 或 latent 产生梯度。因此还需要 reduce-scatter 汇总这些部分和,并把每个位置的梯度还给它的所有者。保存索引不会取消这次通信;它减少的是通信之前的重复工作,并改变可以与通信重叠的计算窗口。
这也解释了 selection replay 与「稀疏反向」的区别。稀疏反向本来就只在选中位置求和,浪费出现在它开始之前:通用重算策略为了准备一个稀疏反向,重新跑了一次稠密的选择过程。HyScale 让重算范围与反向的真实依赖重新对齐。
8. 通信重叠从消费者出发,而不是先统一等待
基线往往在选择之前,先完成 indexer keys 和 attention KV 的收集。实际上,选择只依赖前一份数据;后一份只需在 attention 开始前到齐。HyScale 因而把两次 all-gather 分开,数据准备好就发起,直到第一个真正需要它的消费者才等待。[1,第 3.4.1 节]
前向和重算中,indexer-key gather 可以与 query 投影重叠;KV gather 可以与投影以及选择重叠。反向也有对应安排:KV 梯度的 reduce-scatter 与 indexer backward 重叠,indexer-key 梯度的 reduce-scatter 与 query 投影的 backward 重叠。
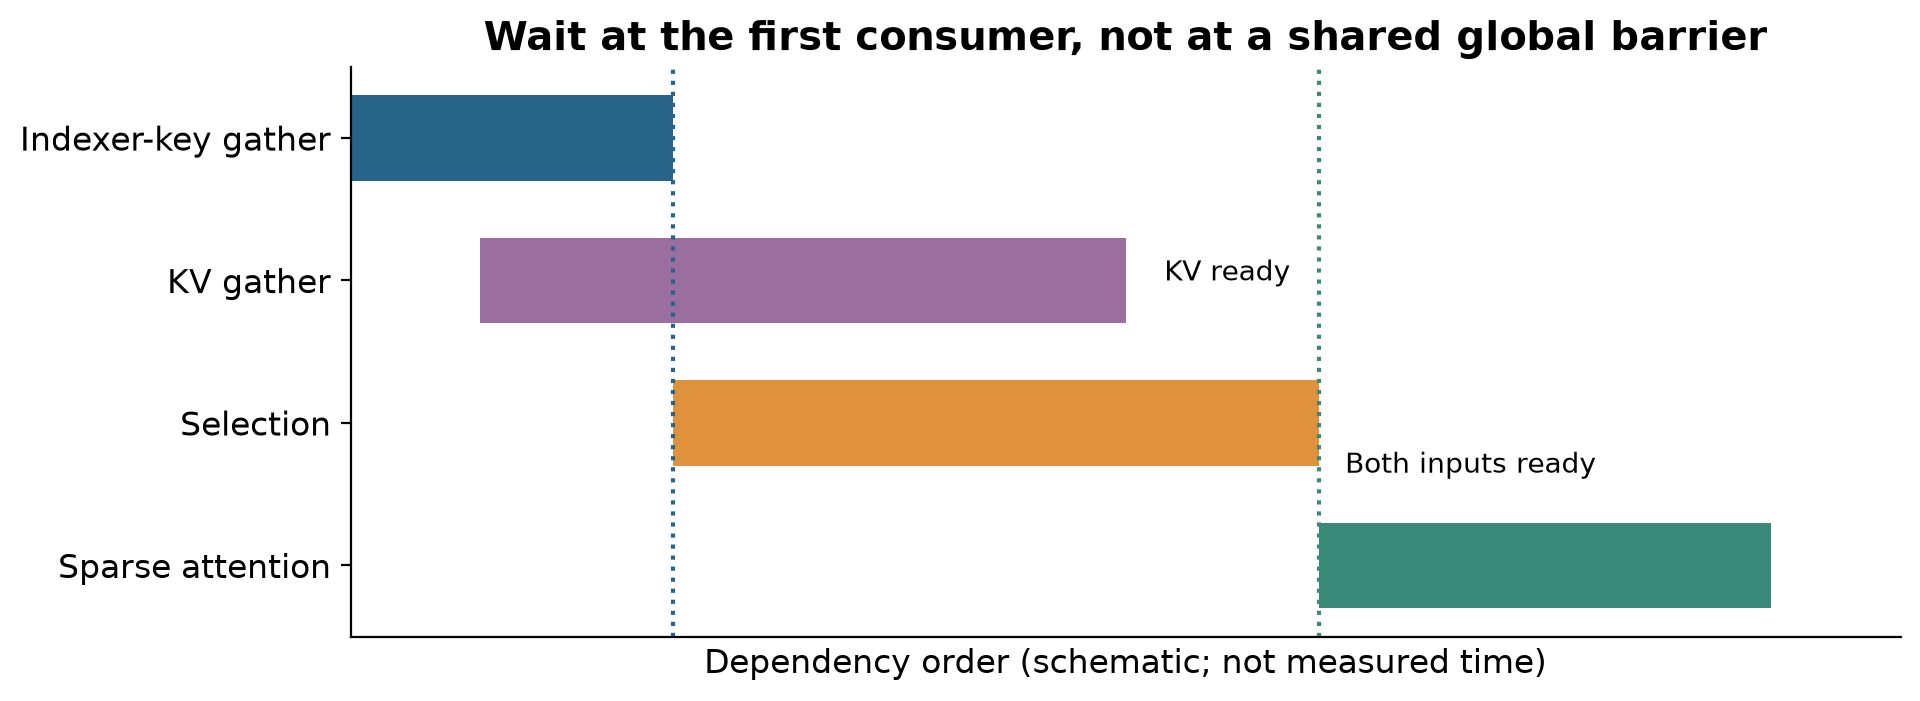
图 5. 根据论文图 3 绘制的依赖示意,条形长度不是测量值。它说明允许重叠的位置,不表示实际运行中通信一定全部被隐藏。
为了建立直觉,暂时假设投影已完成,也忽略资源争用。若选择耗时为 ,KV gather 为 ,attention 为 ,串行路径是 ;让 gather 与选择同时进行,理想路径变成:
这个式子给的是依赖层面的理想节省,不是硬件性能预测。通信和计算可能争用显存带宽或执行资源;indexer-key gather 还可能有自己的前置条件。更有意思的是,选择加速后 变短,原来藏在它后面的 KV 通信可能暴露出来。因此「某段计算变快」与「通信隐藏得更好」未必同时发生。
论文也解释了为何直接搬用稠密 attention 的常见并行方式不够。Ring 式通信重叠依赖足够多的 attention 计算,但每个 query 只读少量被选项,未必有足够工作遮住传输。按 head 划分也不一定能减少这里的数据量,因为多个 head 共享 indexer key 和 MLA latent,每个分区仍可能需要同一份完整表示。
这提醒我们,通信量应该按实际要传的张量表示计算,不能只看 head 数或逻辑分区数。系统图中多画几条 stream,并不会自动产生可用的并行;只有真实依赖允许、硬件资源也容得下的重叠,才会缩短关键路径。
9. 邻近 query 共用 keys:多算一点,少搬一些
论文的另一项优化利用选择局部性。两个相邻 query 如果选中了很多相同 keys,分别运行就会重复读取这些数据,反向也会对同一位置发起两次原子累加。HyScale 先构造两组索引的并集,让一个线程块处理这一对 query,分别用 mask 保持各自原来的支持集。[1,第 3.4.2 节]
假设两组各有 k 个位置,交集大小为 ,则:
作者在 GLM-5.1 的 78 层中选取 21 层,对 128K 和 192K token 的真实文档测量,得到相邻 query 的 top-2048 平均重叠率为 71%。代入后,并集只有 ,相对于两份独立列表的 ,理想独立 key 读取数减少 35.5%。这是从重叠率推导的读取数量比例,不等同于全部 L2 流量或耗时减少 35.5%。
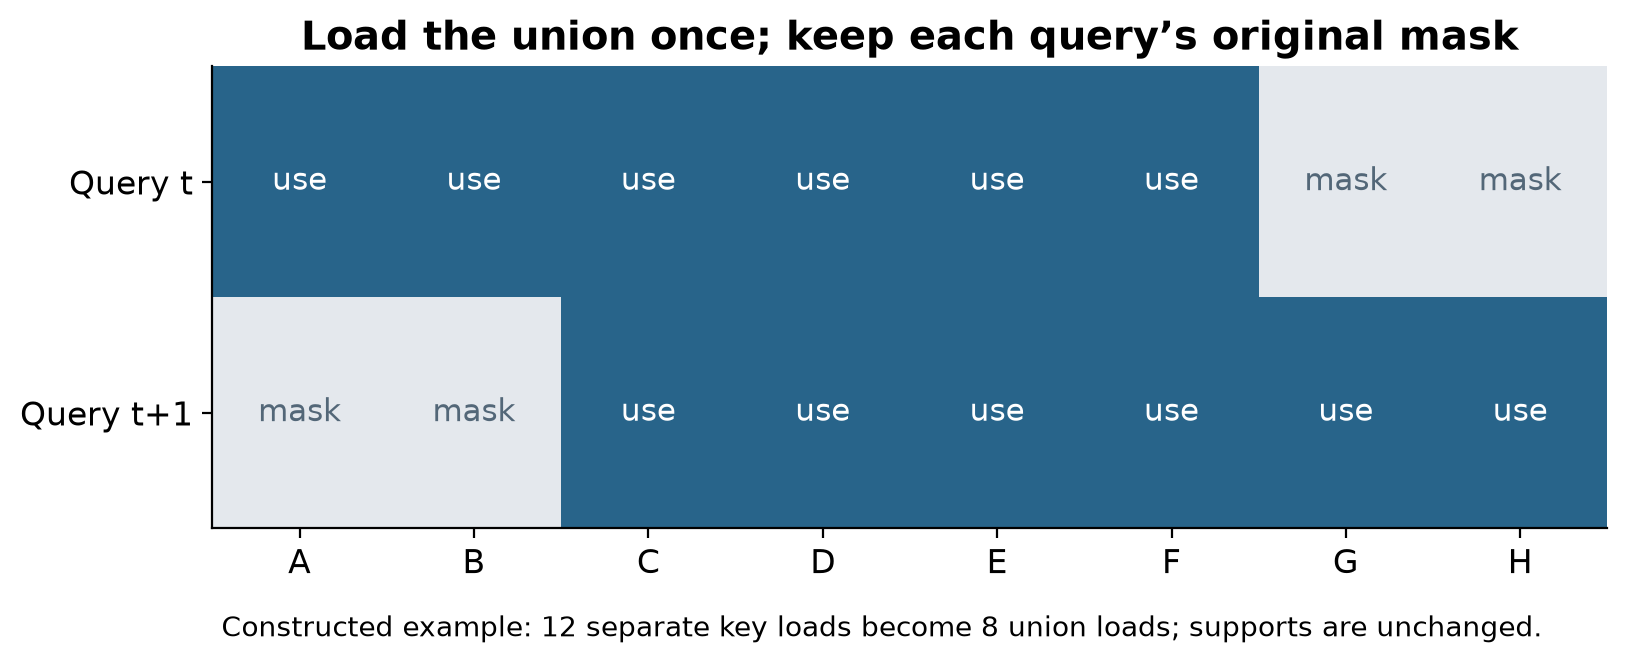
图 6. 自拟示例:每个 query 选六项,原本共读取十二项,通过并集可读取八项。第一个 query 屏蔽 G、H,第二个屏蔽 A、B;没有把额外位置加入它们的注意力。
反向时,共同位置的两份梯度可先在块内相加,再执行一次全局原子更新。所有相关稀疏 kernel 复用一次预处理得到的并集,因此预处理成本有机会被多个阶段摊薄。代价是出现一些被 mask 的计算:线程块为两个 query 覆盖整个并集,其中部分计算对某个 query 无效。
为何还值得?论文对 H800、512K 场景的分析显示,这些 backward kernel 的 L2 吞吐达到峰值的 53–65%,warp 有 40–44% 周期在等待内存,而 tensor core 忙碌比例只有 21–32%。如果算术资源闲着、搬运却堵住了关键路径,用一部分冗余算术换共享读取和更少 atomics 就有道理。
但选择局部性不是稀疏性的必然结果。若相邻 query 几乎不重叠,并集接近 ,读取节省消失,预处理和 masked work 却仍然存在。扩大到更多 query 的分组也不是无条件更好,它会增加并集、mask 和寄存器需求。两两分组是一个具体折中,收益依赖数据上的选择形状和硬件瓶颈。
10. 整模型实验:2.07 倍到底测了什么
主要实验从已经发布的 GLM-5.1 权重出发,在 512 张 H20 上运行训练。每张 H20 为 96 GB 显存,每个八卡节点有八张 400 Gb/s RoCE 网卡。每 step 固定处理 4M tokens,每 GPU 为 8K tokens,每个样本是一条完整序列。两套系统都使用 BF16、完整激活重算、平衡的 MoE 路由,以及带分布式优化器的无动量 SGD;step 时间取第 4–10 步的平均。[1,第 4.1 节、图 6]
这些条件不是无关紧要的脚注。短稳态窗口适合评估执行速度,却不能证明长期训练收敛或质量保持。无动量 SGD 的状态成本也不同于其他优化器。平衡路由则减少了一种 MoE 负载不均来源;真实路由波动可能改变各 stage 的等待关系。因此结果应理解为指定系统配置下的训练性能证据。
| 上下文 | 论文报告的并行配置 | 整模型加速 |
|---|---|---|
| 256K | PP8 × CP32 × DP2;EP64 | 1.23× |
| 512K | PP8 × CP64;EP64 | 1.44× |
| 1M | PP4 × CP128;EP128 | 2.07× |
EP 是配置描述的一部分,不能把它再与所有其他维度机械相乘,推导成超过 512 张卡的实验。百万上下文还把流水线深度从 8 改为 4,所以这组点不是「除序列长度外所有并行配置完全不变」的扫参。读图时保持这些条件,才能避免把配置变化的影响归错因。
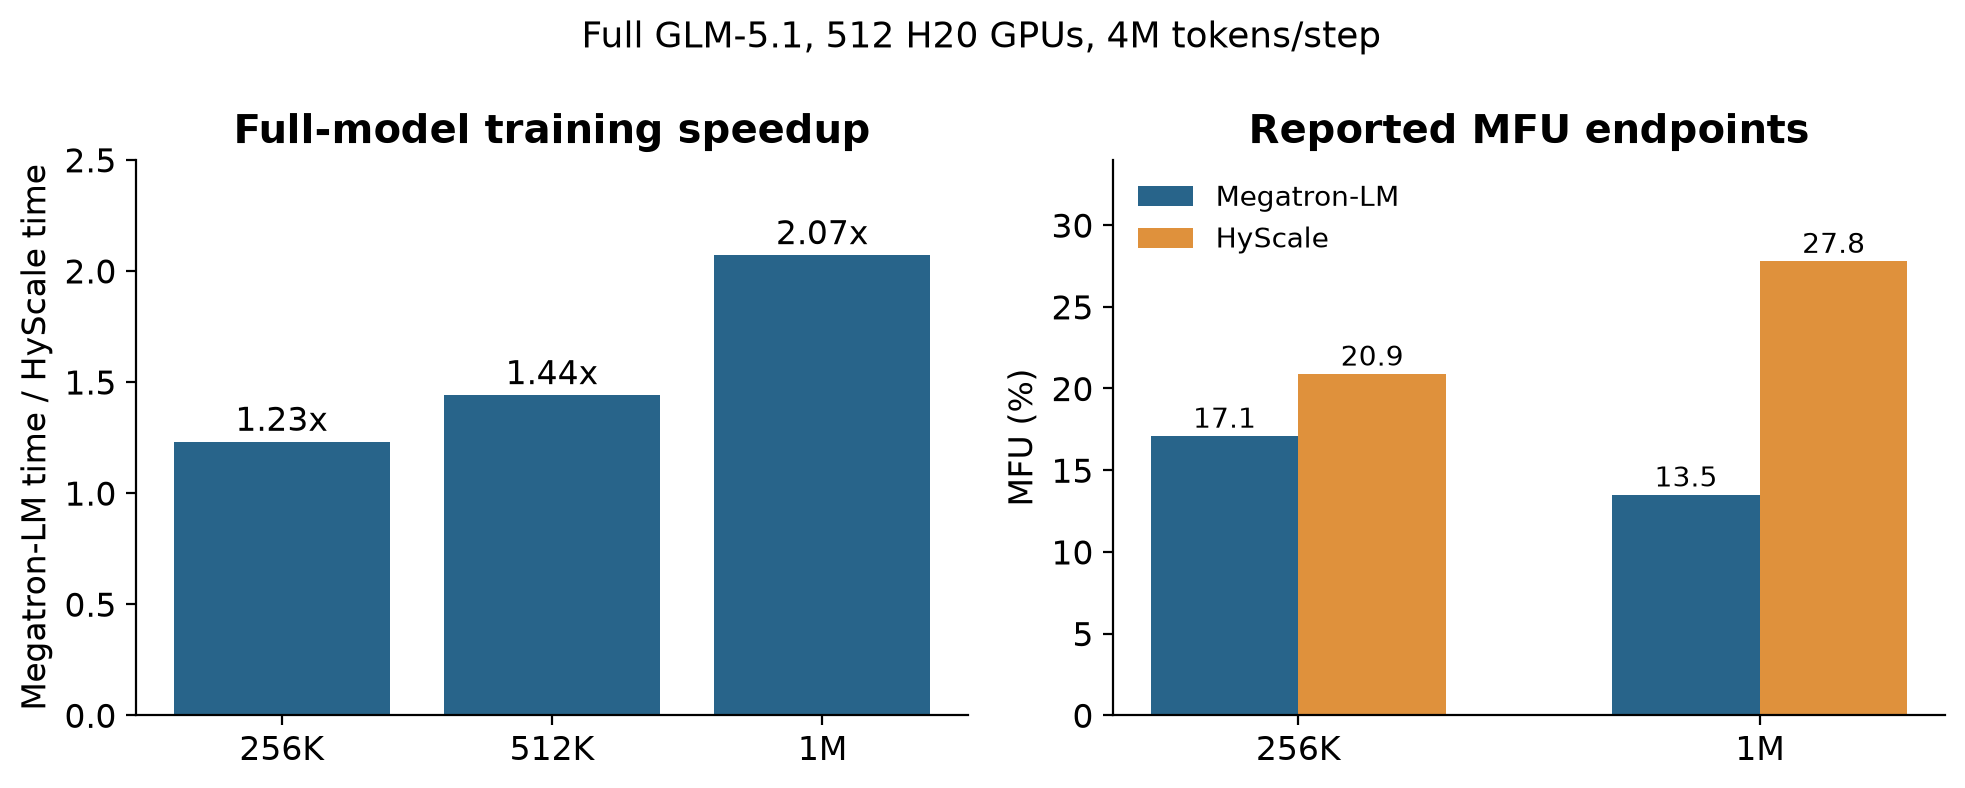
图 7. 根据论文图 6 和第 4.2 节重绘。MFU 只画正文明确给出的两端数值,没有从曲线猜测中间点。
从 256K 到 1M,HyScale 的 step 时间只增长 1.27 倍,基线增长 2.13 倍。HyScale 的 MFU 从 20.9% 上升到 27.8%,基线则从 17.1% 降到 13.5%。启用索引 offload 时,两者 GPU 峰值显存接近;作者说明如果索引保留在设备上,额外显存最多为 11%。这些是整套配置的指标,与前面单个评分表的 512 倍空间比例属于不同层次。
百万上下文的第一流水线 stage 剖析还给出更细的时间:前向选择从 35.9 秒降到 20.8 秒,重算选择从 37.0 秒降到 1.0 秒,流水线等待从 106.6 秒降到 51.7 秒。[1,图 7] 第一个变化来自更高效的前向选择,第二个直接体现重放,第三个则说明局部计算变快还会改变系统其他位置的等待。
因此不能简单把几个 kernel 加速倍数相乘。更快的 stage 会影响流水线排程,通信可能从隐藏变成暴露,固定成本的占比也会变化。图 7 中单个剖析 step 的 264 秒对 125 秒,与图 6 多步平均得到的 2.07 倍,也应按各自测量方法理解,不必强行要求两组比例逐位相同。
11. 扩展性与消融:大数字背后有不同贡献
上下文并行扩展实验针对一个 GLM-5.1 注意力层,在 8–512 张 H20 上进行。强扩展固定总上下文、增加 GPU;弱扩展固定每卡 query 数、让总上下文随卡数增长。时间包括前向、重算和反向,并取最慢 rank。因此它很适合研究 CP 瓶颈,但还不是整模型训练吞吐。[1,图 8]
HyScale 在卡数翻倍时持续变快。在 256 张卡以内,每次翻倍带来 1.65–1.96 倍的时间改善;超过 256 张之后,收益降至 1.18–1.54 倍,因为每卡 query 太少,已不足以遮住通信。基线更早停止改善,甚至在卡数增加后变慢。论文将其中重要原因归于每层重建 CP layout 时,随 rank 数增长的 host 同步;HyScale 把布局缓存为每 microbatch 构造一次。
八百万上下文的 22.3 倍结果,属于每卡 16K query 的单层弱扩展实验。它既包含 HyScale 的选择优化,也反映基线在大规模下效率明显恶化。把这写成普遍适用的「训练快 22 倍」,会同时掩盖测量范围和基线因素。更有区分度的后续比较,是先把独立的 layout cache 给基线,再看选择与通信方案还能贡献多少。
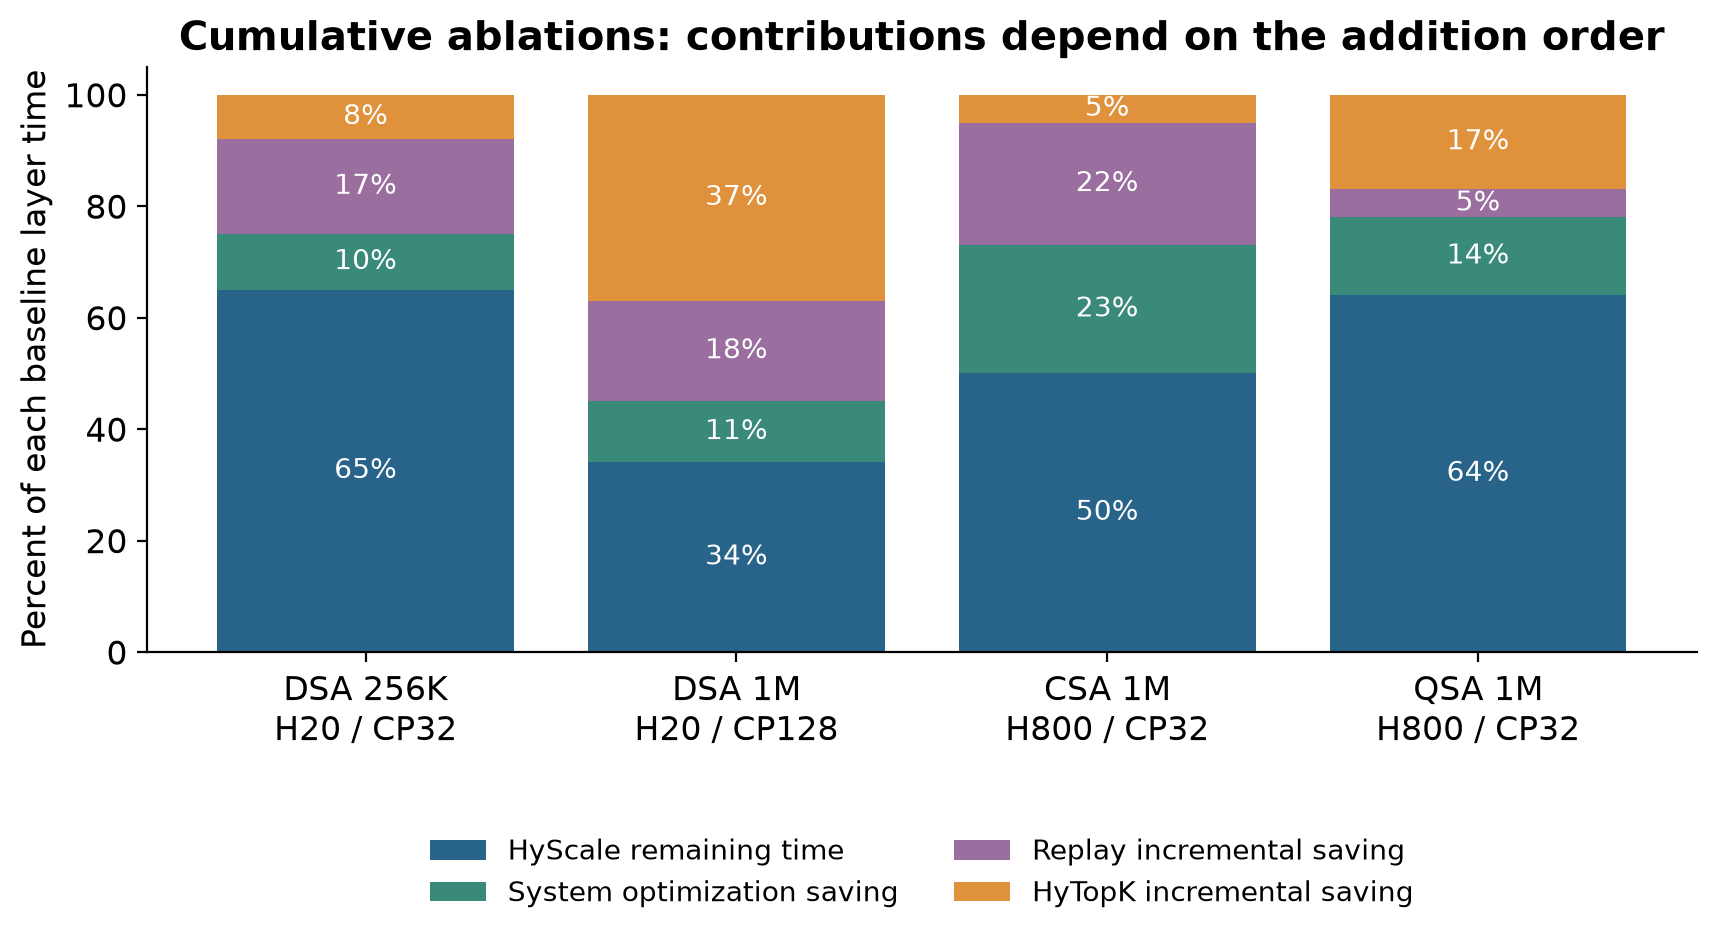
图 8. 根据论文图 9–10 的整数百分比重绘。顺序为先加入 HyTopK、再加入 replay、最后加入其他系统优化。每一列以自己的单层基线为 100%,不能当成绝对耗时比较。
百万上下文 DSA 的单层最终保留基线 34% 的时间。按论文累积顺序,HyTopK 节省 37 个百分点,replay 再节省 18 个百分点,其他系统优化节省 11 个百分点。前两项合计 55,在总共 66 个百分点的节省里约占 84%。这是很有说服力的主机制证据,但它仍然依赖加入顺序。
例如 replay 的边际收益,是在 HyTopK 已经把选择加速后测量的。不能一边用未优化的完整重评分作为参照,一边又把这个边际结果解释为 replay 单独的潜力。累积消融说明组合有效,不自动给出每个模块在所有组合中的独立贡献。
作者还根据论文构造了 CSA 与 QSA 层,在 32 张 H800、1M 上下文下重复消融,得到 2.01 倍与 1.57 倍加速。这支持方法从 token 级选择迁移到 block 级选择。由于相关 block 配置让候选 keys 数减少到约四分之一,选择本身的占比也下降,HyTopK 的边际收益自然不同。[1,第 4.5 节]
这类跨架构结果更适合解释为「同一原理在不同计算结构下仍然有用」,而不是保证任意稀疏架构都获得同样收益。若模型改用不同监督、不同块选择或更小的候选宇宙,重放契约和收益占比都需要重新分析。
12. 恢复路径的频率与代价,要分别看
选择微基准使用完整 GLM-5.1 训练中采集的选择,覆盖所有 78 层和 CP ranks。每卡 8K query、k = 2048,在 256K–1M 上下文下,HyTopK 比基线默认受限评分表方案快 1.22–1.71 倍,峰值约为 1.5–1.9 GiB。如果允许基线保留完整评分表,它会更快一些,但峰值升至 12–48 GiB,报告中仍比 HyTopK 慢 3–10%。[1,图 11]
另一个实验故意注入不同数量的失败 query,测量恢复成本。确定性排序本身增加 0.8% 的基础选择时间;一个失败 query 加上排序共增加 1.8%;64 个失败加上排序共增加 4.3%。这组数据回答「失败之后修复有多贵」,并不回答「失败多常见」。
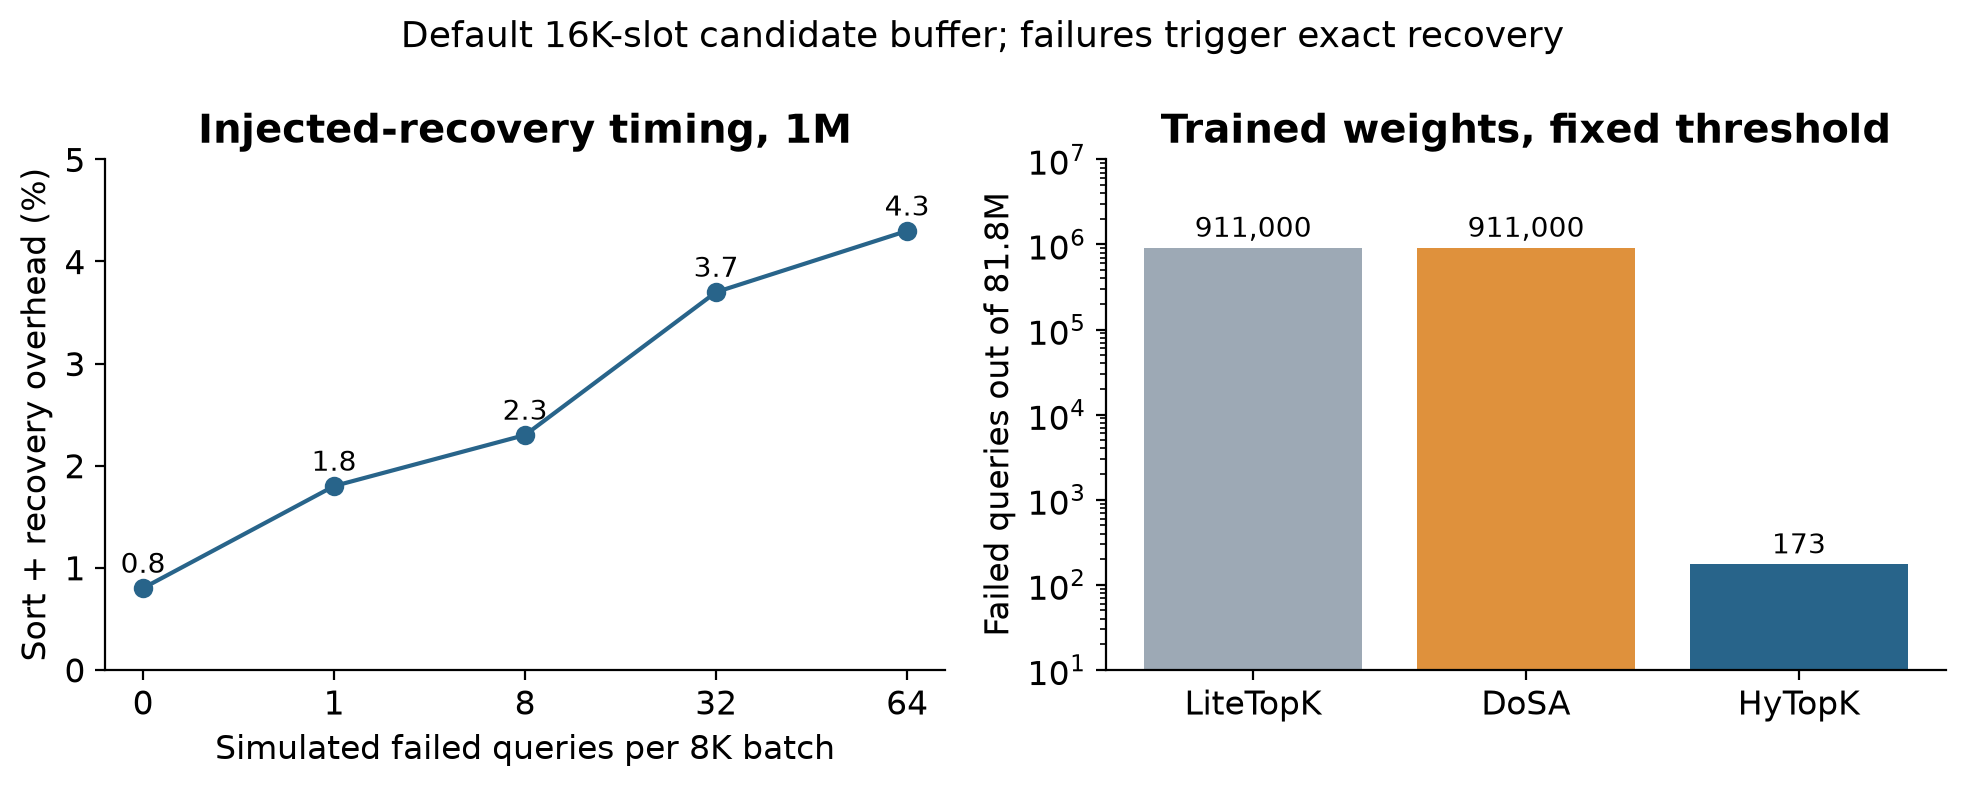
图 9. 左图重绘论文图 11b 的人工注入恢复开销;右图重绘图 12a 中已训练权重、固定阈值、16K 槽位下的失败计数。不能用左图的注入数量当成自然失败率。
论文还对一个百万上下文训练 step 的 81.8M query 比较采样策略。在已训练权重、固定阈值、默认 16K 槽位下,HyTopK 有 173 个失败 query,另外两种采样方案各为 911K。用总数计算,HyTopK 约有 的 query 失败,即约 0.00021%。这是由作者计数推导的整体比例,不代表每层、每 rank 或每 microbatch 的分布都均匀。
聚集程度尤其重要。若失败集中在少数 selection batch,固定处理 64 个失败 query 的恢复路径可能承受与平均值完全不同的压力。论文说明观察到单次选择最多 4 个失败,这是对该采集工作负载的证据;不能把它改写为算法永远不可能超过 4 个。
随机初始化权重、固定阈值时,HyTopK 在默认缓冲下报告零失败;已训练权重、扫描过程中抬升阈值时,默认缓冲下 HyTopK 为 48 个失败,另外两者各 483 个。不同面板切换了条件,因此不能把这些数字当作同一条实验曲线随意比较。[1,图 12]
它们共同支持的解释是:用当前 query 自己的上下文估计阈值,比假设邻居选中的 keys 对当前 query 也有代表性,更适合训练。随机初始化阶段邻近选择缺乏相关性,尤其说明推理阶段有效的局部性假设,不能未经检验地移到训练初期。
可以用一个简单的期望成本式把频率与代价分开:
其中 表示一次选择中失败的 query 数。这只是分析式,不是拟合结果。只要恢复完整, 大仍可以保持正确;但平均性能会下降,尾延迟和最慢 rank 完成时间可能下降得更快。同步训练关心的不只是平均 query,而是所有参与者什么时候都能继续。
13. 局限与失效边界
第一,重放的数学条件不是通用真理。当前推导依赖离散支持集的固定求导约定、只覆盖被选位置的 indexer 损失,以及论文中的 detach 关系。全上下文归一化、软路由或 straight-through 估计器可能引入新的依赖。将这个思想移到另一种模型时,应该先重画计算图、重推梯度,再决定保存什么。
第二,前向搜索仍然扫描整个候选宇宙。HyTopK 消除了完整评分表的读写,并改善选择执行,但没有把所有 indexer 内积都删掉。上下文继续变长后,剩余的扫描和全局 key 通信仍可能成为瓶颈。可以考虑与缩小候选宇宙的方法结合,但后者若改变选择结果,就要单独评估近似误差,不能沿用 HyTopK 的精确性表述。
第三,最强的整模型证据来自一个主要模型、指定硬件,以及短稳态计时窗口。论文没有给出足以覆盖各种训练阶段的长期质量轨迹。数学上保持目标计算,是重要证据;长时间数值漂移、恢复尾部行为和动态路由影响,则仍值得通过更长的训练观察补充。
第四,选择局部性只在部分层和指定文档长度上测量。不同内容、训练阶段、序列打包方式可能改变相邻 query 的重叠率,也可能改变跨步采样的代表性。例如高度不规则的 agent 轨迹或突然切换主题的上下文,是值得测试的压力场景。它们是合理的后续问题,不是论文已经证明的失败案例。
第五,系统资源并不彼此独立。Pinned-host offload 使用传输通道,候选缓冲占用显存,通信 kernel 可能争用带宽,缓存的 layout 必须与当前 microbatch 匹配。一个依赖上合法的重叠安排,只有在资源上也能执行得顺,才会转化为实际收益。
还有一个容易忽略的范围问题:选择输出可重复,不代表训练所有部分都逐位可重复。局部性 kernel 对共享梯度先合并再做 atomic,从数学上保持和式,但浮点求和顺序可能与逐 query 处理不同。对整个训练提出更强的数值保证,需要覆盖这些环节,而不是只验证 top-k 的成员顺序。
14. 独立批判性分析:最重要的贡献是重画检查点边界
我认为最可迁移的观点,是给昂贵决定保存一个足够小的离散结果。完整评分表只是搜索过程;支持集才连接了前向语义与反向依赖。保存这个决定后,大部分搜索中间量可以丢弃,需要的连续数值再沿着支持集恢复。Checkpoint 的边界因此进入算子内部,而不再只能停留在整块张量之间。
这也帮助区分几个层面的新意。稀疏 attention backward 只对被选位置求和,本身不令人意外;缓存索引也不是难以想到的技巧。更有价值的是,把这个观察与精确的融合前向选择、适合训练的恢复机制、确定性规则以及分布式调度连成一个可运行的系统方案。单独看每个部件容易觉得朴素,组合起来才暴露真正的约束。
实验归因仍值得更细。部分收益来自避免评分表和重复扫描,部分来自缓存 CP layout、序列边界,以及减少同步。这些改进都实用,但它们回答的科学问题不同。若未来比较只报一个总加速数字,读者很难知道其中多少来自新的重放语义,多少来自基线原本就能采用的常规工程优化。
我会优先补三类证据。第一,运行更长的梯度与损失对比,覆盖并列分数、不同 packed sequence 边界以及多种随机状态,观察数值差异是否累积。第二,按层、rank 和 batch 报告失败分布,并主动构造不利分数分布,测量超过 64 个失败后的回退频率与耗时。第三,把独立的 layout 和 boundary cache 给基线,再重复整模型比较,隔离核心选择机制的贡献。这些是建议追加的实验,不是本文已经执行的结果。
还应看优化之间的交互。选择加速会缩短隐藏 KV 通信的窗口;局部性优化会改变显存带宽压力;host offload 可能与其他传输竞争。累积消融证明某个加入顺序有效,却未展示所有交互。对 replay、通信重叠、局部性做一个小规模组合消融,可以看到它们是叠加、互相替代,还是在部分配置下彼此干扰。
从训练系统设计者的角度,采用门槛应该是一组清楚的语义要求:保存的支持集就是前向实际使用的集合;重算能恢复选中条目的全部数值依赖;候选不足和溢出都完整恢复;mask、token 位置与梯度归属在布局变换后仍一致;性能结论明确说明工作负载和测量范围。HyScale 提供了这类设计的一个很有价值的实例。
它还给出一个比「优化 top-k kernel」更宽的问题意识:当我们决定丢弃某个激活时,有没有顺手丢掉一个重新求解很贵、保存却很便宜的决定?这个问题不局限于注意力,但跨任务迁移时必须重新证明下游只依赖保存的那份信息。不能因为这里成立,就把所有路由、检索和动态稀疏结构都直接当成可无损重放。
15. 结论
HyScale 解释了一个常见反差:模型已经采用学习式稀疏注意力,训练系统却仍围绕完整评分表组织选择与重算。HyTopK 解决第一次扫描中的评分表物化,selection replay 解决反向前的重复扫描。阈值采样可以乐观,但候选集合必须接受检查,失败时通过完整恢复保证最终选择。
论文在百万 token、512 张 H20 上报告的 2.07 倍整模型加速,与它对显存、选择重算和通信等待的分析相互支撑。更大的单层扩展数字,以及 CSA、QSA 的单层收益,提供了不同范围的补充证据。最值得带走的原则是:保留反向真正依赖的小决定,再只恢复这个决定所需的数值。
参考资料
- Yangshen Deng 等,HyScale: Scaling Long-Context Training for Learned Sparse Attention,arXiv:2610.32057v2,2026-10-26。论文页面 · PDF。本文方法、实验数值和附录推导的主要来源。
- V. A. Korthikanti 等,Reducing Activation Recomputation in Large Transformer Models,2023。论文。HyScale 引用的激活重算背景资料。
- Z. Yin 等,LiteTopK: Exploiting the Curse of Dimensionality for a Fused Indexer-TopK Kernel in Long-Context Sparse Attention,arXiv:2607.11976。论文。相关采样方法;本文的比较数值采用 HyScale 的实验报告。