笔记日期:2026 年 10 月 26 日。论文:RRSI: Regularized Recursive Self-Improvement of Agent Harnesses。作者:Peng Xia, Rujun Han, Zifeng Wang, Yanfei Chen, Yufan Zhuang, Yoonho Lee, Chengsong Huang, Han Yu, Zhongying CuiZhu, Yifei Ming, Huaxiu Yao, Burak Gokturk, Tomas Pfister, Chen-Yu Lee。版本:arXiv:2609.24972v3,2026 年 10 月 4 日修订。论文 · 作者项目页 · 代码资源入口。
本笔记依据 27 页全文与附录 A–F。实验数字来自作者报告;自行计算、解释性例子和后续实验建议会单独说明,不把它们写成新的模型实验。版本日期采用 arXiv 记录;PDF 首页内部日期另写为 10 月 6 日。
1. Agent 越改越好,还是越来越会做这套题?
假设一个 Agent 要读材料、算出结果,再交付一份表格和一份说明。它失败的原因可能很具体:引用了没有读过的来源,计算只停留在草稿里,或者根本没有生成用户指定的文件。给它增加一次交付前检查,确实可能改善很多任务。可是,如果我们让另一个模型反复观看同一批失败记录,它也可能写出一大段专门迎合这套评分细则的提示词。后者同样能涨分,却未必能迁移。
RRSI 研究的就是这个分界。这里的 harness 指包裹在模型外面的运行机制,包括提示词、工具接口、记忆、上下文管理,以及什么时候规划、执行、检查和停止。底层模型权重保持不变,搜索过程不断修改这些外部机制。论文所谓递归自我改进,是系统用自己的执行结果改写下一轮行为,而不是模型重新训练自身参数,也不是已经证明可以无限自我增强。
问题在于,反馈不是无限的。候选机制在同一批任务上生成、打分、比较,下一轮又依据这些分数继续改。即使从未直接看到答案,优化器也会越来越熟悉这批任务的文档类型、评分偏好、常见错误和偶然规律。这是一种自适应使用数据的过程:每次新的提议,都带着过去测量留下的信息。
此外,能力提升和多花计算也很容易混在一起。Agent 多加几轮反思、多保留几千字常驻指令、多调用几次工具,可能提高成功率;但这不等于它找到了更好的通用机制。如果只按搜索集分数决定是否保留修改,搜索就没有充分理由控制成本,也没有理由主动删除已经失去作用的结构。
RRSI 的主要想法,是给“什么修改可以成为长期状态”设置更清楚的条件。它不永久禁止某一种组件被改动,而是限制每轮把多少独立编辑绑在一起,记录成功和失败的历史,把停滞的搜索引向尚未探索的组件,并在接受候选时检查特异性、分数稳定性和额外 token 成本。
我认为最值得关注的结果不是某个最高分,而是排序发生了变化。Harvey LAB 搜索集上,Meta-Harness 从 89.4 提升到 93.0,RRSI 只到 90.5;然而三个未见工作流基准的平均分,前者约为 40.6,后者为 43.6,起点约为 39.7。少吃一点眼前反馈带来的收益,换来更好的迁移,这才是这篇论文需要证据支持的核心主张。
2. 读方法之前,先把分数、成本和不确定性分开
2.1 一个 harness 的成绩不是单次输出
把 Agent 记为 : 是冻结的底层策略, 是 harness。给定任务 ,Agent 产生轨迹 ,评分器返回 ;轨迹消耗的策略 token 记为 。论文先定义任务分布上的期望表现和成本:
这两个期望对应两层随机性。第一层是抽到什么任务,第二层是同一任务上模型会走出什么轨迹。一个任务失败一次,不足以断言某项修改无效;反过来,同一任务偶然成功一次,也不足以证明修改提高了总体能力。评价时必须说清测了多少任务、每题跑了几次,以及最后怎样聚合。
若每道题跑 次,并且任务等权,经验估计为:
可以按三步理解:先得到每次执行的结果,再对同一道题的多次执行取平均,最后对任务集合聚合。编码实验有 89 道题、每题两次,因此共有 178 个执行结果。多通过一次测试,分数增加的是 ,约 0.562 个百分点,不是“多解决了百分之一的任务”。
这里还要留一个重要限定:实际基准并不全是任务等权。Harvey LAB 按评分条目累计,长 rubric 的任务权重更大;JobBench 用加权 rubric;GDPval 比较产物与人类专家产物;Frontier-Eng 用奖牌分。上面的公式是抽象框架,不能抹掉具体计分方式。不同基准上的五个百分点,不代表同样大小的实际效用。
2.2 自适应选择为什么会偏爱运气
对一个预先固定的候选,我们可以把实测分数拆成真实性能和误差:。但搜索不是随机挑一个候选,而是根据实测成绩挑最高者:
即使每个固定候选的测量误差平均为零,被选中的那个误差也不一定平均为零。因为“被选中”这件事,本身就偏爱正向误差。作为解释性模型,若所有候选真实性能相同,误差相互独立且服从标准差为 的高斯分布,那么大量候选中的最大噪声大致随 增长。
这不是论文给出的 RRSI 理论保证。真实候选高度相关,后续提议还依赖过去的反馈,高斯独立假设并不成立。这个小模型只说明一个方向:测试更多候选,可以让最优测量值越来越好看,即使真实性能没有改善。把搜索曲线不断上升直接解释为能力不断上升,跳过了最关键的一步。
2.3 评测不确定性和搜索不确定性不是一回事
固定最终 harness,再换一组任务或重复运行,测的是评测波动。重新启动整个进化过程,让提议模型走出另一条修改路径,测的是搜索波动。前者不能代替后者。一个最终方案可以被测得很稳定,却只在一次幸运的搜索中出现;反过来,不同搜索也可能得到不同代码,但产生相似的最终能力。
RRSI 的附录分别提供任务级 bootstrap 和独立搜索重复。这比只报告一次分数更有说服力,但两种实验的样本量、含义和能支持的结论都不同。后面讨论置信区间时,必须始终记住它们的条件。
3. 总体结构:约束的是修改过程
RRSI 把每轮拆成候选生成和候选选择。生成器看到当前 harness、失败反馈、历史记录、编辑数量预算、探索指令和待删组件;候选先经过筛选,再在固定搜索集上完整评测;选择器只允许同时满足各项条件的候选替换当前方案。
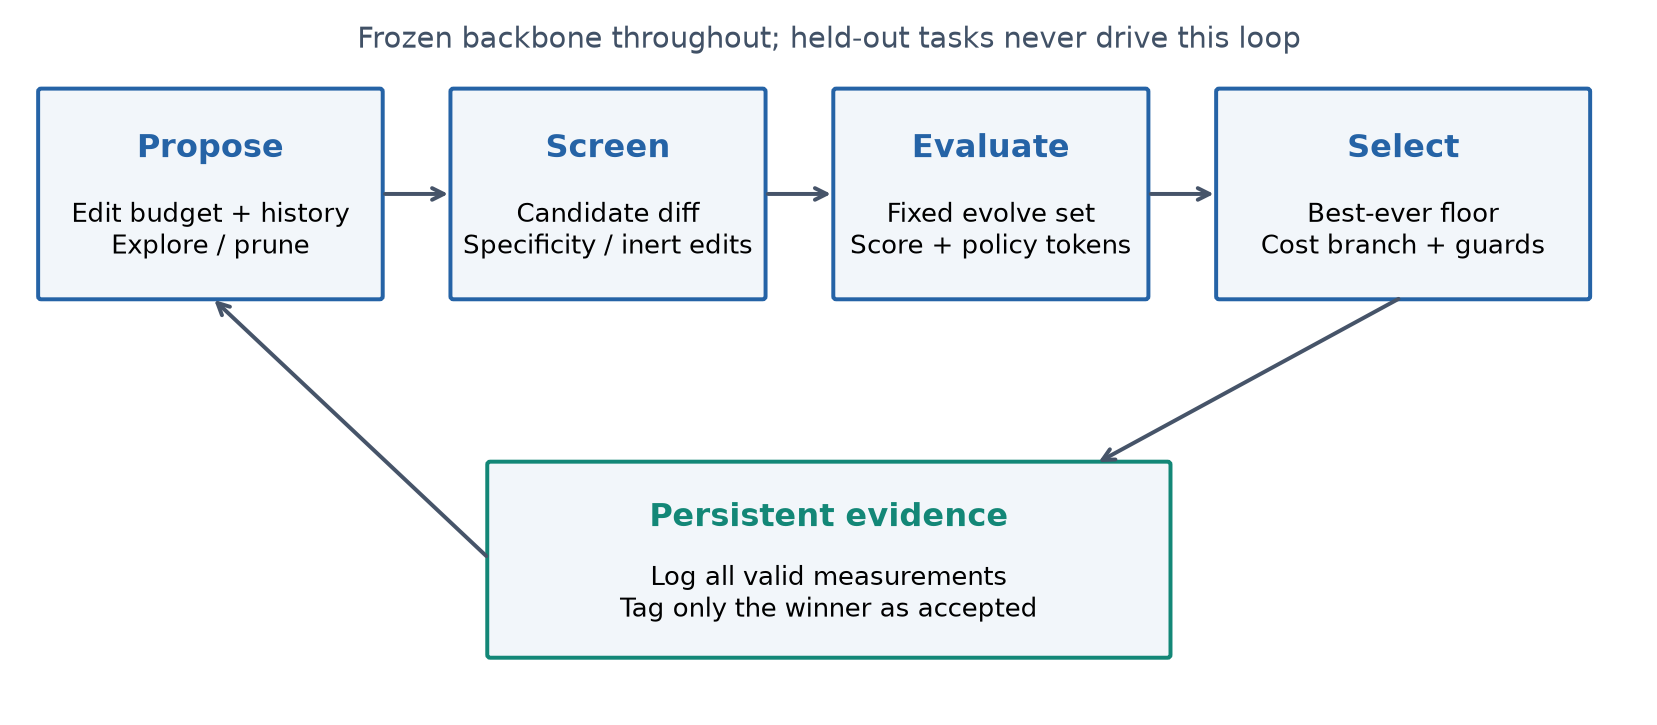
图 1. 根据正文第 3 节和附录 D 绘制的解释图。所有有效测量都进入历史,只有当轮胜出者进入接受路径;留出任务不参与这个反馈循环。
这里有个容易混淆的差别:允许修改的空间很大,不代表每轮可以任意大改。 限制一个候选最多包含两个独立编辑,并不意味着永远不能添加记忆模块;它只是不鼓励把记忆、工具路由、停止规则和系统提示词一次性全部换掉。后者即使成功,也很难知道究竟是哪项机制有用。
论文用三种经典正则化作类比:限制编辑数量类似 ,删除长期无效组件类似 ,抑制整体资源增长类似 。这些名称描述的是作用,不能按数学等价理解。系统里没有一根统一的连续参数向量,没有求解 lasso 目标,也没有真正的平方范数惩罚。把三种措施分别理解成“少量修改、删除结构、控制总开销”,比把它们当成现成理论更准确。
为什么不直接最大化“分数减去成本”?因为一个标量目标允许不同项互相补偿:只要涨分足够多,任何额外成本似乎都能接受。RRSI 的多个门槛有些不能这样交换。低于全局性能下限的候选,再便宜也不能留下;显式携带题目特异信息的修改,应在获得高分之前就被筛掉。这样做改变了搜索的激励,但也意味着每个门槛的定义和可靠性都变得重要。
4. 提议端:减少一次反馈能驱动的变化
4.1 为什么编辑预算会逐步收紧
假设当前轮先生成一个原子编辑池,用二元向量 表示选了哪些编辑。RRSI 约束 。每轮的编辑池可以不同,因而这不是固定模型参数的稀疏化,而是限制一次候选包含多少项可以独立归因的变化。
论文的预算公式是:
先忽略向上取整: 时,余弦为 1,预算等于上限;到 时,连续值落在上下限中点;到 时,余弦为 -1,预算回到下限。连续包络在这个区间单调下降。直觉是前期允许少量协调修改,寻找新机制;后期尽量缩小变化,把观察到的收益和具体编辑对应起来。
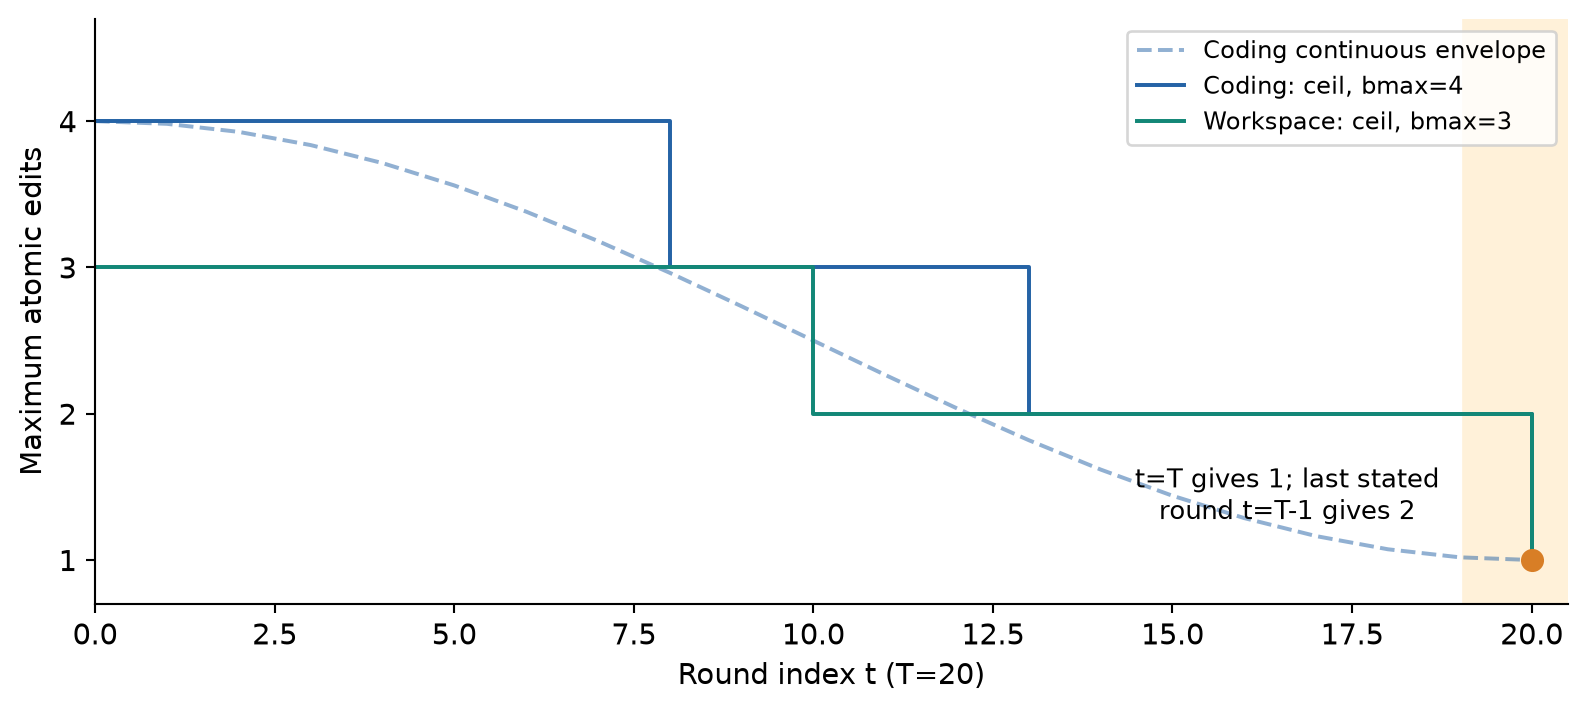
图 2. 按公式 4 和表 5 计算,不是作者的实测搜索轨迹。图中特意画出 ,因为附录写出的实际轮次范围终止于 。
这个公式有一个值得保留的细节。论文同时说最后阶段达到单编辑,但附录 D.1 的循环是 。在向上取整、下限为 1 的情况下,列出的配置在最后一轮仍会得到 2;真正到 1 要等到 。例如编码任务 、上限为 4, 的连续预算仍略高于 1,向上取整就是 2。这需要作者澄清索引或取整约定,不能为了让文字顺畅就自行改掉公式。
另外,“一个编辑”不天然等于“一个简单行为变化”。一句提示词可能影响整条执行轨迹,而跨两个文件的协调修复也可能只是同一个机制。原子编辑的划分本身就是一个判断。预算要发挥作用,需要这个判断足够一致,而不是把复杂变化重新命名成一个编辑就算合规。
4.2 历史应保存失败,但历史不等于因果解释
每项被实际评测的编辑都会记录轮次、组件、假设、变化内容、分数差、成本差和是否被接受。被评测但落选的候选也要保留。一个候选可能满足所有门槛,却因为另一个候选分数更高而落选;所以“未接受”并不自动等于“这项机制无效”。
保存这些信息能减少重复试错。如果某种重试策略已经使成本膨胀而没有改善结果,下一轮不应忘掉它,只因为换了一种措辞就重新尝试。但记录仍是观察性证据。一个候选同时添加有用的交付检查和有害的记忆扩展,整体净涨分时,两项编辑都继承同一个正收益。预算逐步收紧能减轻混杂,不能彻底消除机制交互。
附录用最近窗口内的最佳观测收益概括组件:
是曾获得有效测量的组件集合。若最近窗口没有记录,最大值定义为 ,于是只有很久以前证据的组件也可能进入待删集合。另一方面,因为这里取最大值,只要窗口内出现一次小幅正收益,它就可能暂时免于被标记。这个统计量是启发式摘要,不是对组件效用的显著性检验。
被标为待删,并不代表跳过评测直接删除。生成器据此提出简化候选,候选仍需通过选择端。这一点对相互依赖的组件很重要:一个单独看不出好处的机制,可能是另一个机制发挥作用的前提。更严谨的替代方案是做受控消融、逐项估计边际贡献,但代价会显著增加。
4.3 停滞时,优先改变搜索方向
停滞指示量检查过去 轮的分数增长有没有超过噪声带:。若没有,则为尚未探索的组件保留候选名额。论文三个设置都用三轮窗口,每轮两个候选中保留一个探索名额,因此一旦触发,探索占比可以达到一半。
这里的“尚未探索”是从未获得有效测量,而不是从未被接受。后面选择端的新颖性奖励又采用另一种定义:只看四类结构组件是否曾进入胜出编辑。两者不要混为一谈。所有组件类别都测过以后,未探索集合可以变空;把标签全部摸一遍,也不代表已经探索了足够多不同的行为机制。
算法 1. 根据附录重述的一轮候选生成
输入:当前 harness H、测量历史 L、轮次 t、总轮数 T
1. 分析当前搜索任务上的失败,整理本轮反馈。
2. 按论文余弦公式计算本轮编辑数量上限。
3. 检查过去若干轮的进步是否超过噪声容限。
4. 找出此前从未得到有效测量的组件类型。
5. 若搜索停滞,为这些组件预留探索候选名额。
6. 标出最近窗口内没有正收益的已探索组件。
7. 结合反馈、历史、预算与待删目标提出候选。
8. 给每个原子编辑标注组件和待验证假设。
9. 检查实际改动中的任务特异内容及无效结构。
10. 将通过筛选的候选交给完整搜索集评测。
这段伪代码表达论文流程,不是另做了一套实验。若要形成完全明确的操作规范,还需要规定初始轮次不足一个窗口时如何处理,以及各领域守卫条件的具体内容。方法提供的是更有纪律的证据使用方式,并不保证生成器的失败诊断总是正确。
5. 选择端:涨分之后还要过哪些关?
5.1 先筛实际改动,再让它拿到分数
完整评测之前,critic 检查候选实际引入的变化,关注任务名称、实体、特定答案、题目相关常数以及没有作用的结构。把筛选放在打分之前有意义:如果一个泄漏候选先拿到很高的搜索分数,这个结果可能影响后续提议,即使后来才发现它不该被接受。
需要检查的是最终 harness,而不是提议理由里能否出现题目名称。为了说明预计修复什么错误,提议者可以在理由里引用具体任务;真正危险的是把这些特异信息带进长期运行的机制。附录 F 也强调了这一区别。
不过,critic 不是泛化能力判官。附录记载编码搜索共筛过 38 个候选,直接拒绝的一例与声明组件和实际改动不一致有关。这只说明这次运行发生了什么,不能当成低漏检率的证据。一个不包含题目名称的通用句式,仍可能高度贴合某种评分偏好;一个名字带基准名称的工具,也可能实现可迁移的动作。通用性最终要靠行为验证,而不是靠词面判断。
主实验中,策略、提议器、分析器和 critic 来自同一个模型家族,这让比较更整齐,也可能带来共同盲点。提议器觉得合理的解释,critic 可能同样觉得合理。跨模型筛选、主动植入不同层次的特异改动,并同时测试“看起来可疑但实际通用”的对照,会帮助识别它究竟能拦住什么。这是后续研究建议,不是本笔记已经做过的检验。
5.2 用历史最好分数阻止退步逐轮累积
记接受路径上的最好分数为 ,候选必须满足:
正文称它为此前观察到的最高分,但算法 2 实际用下一轮被接受的 harness 更新。这里按算法理解:一个因为成本被拒绝的高分候选,不会自动抬高后续门槛。这个区别会改变哪些候选能进入可接受集合,简化说明时不能略过。
用一个自行构造的例子看它的作用。当前分数是 90.0,容忍带为 0.4 个百分点。若每次只和当前方案比,89.7 可以接受;接着 89.4 又只下降 0.3;再到 89.1,单步也没有超出容忍带。三次“没有明显退步”,合起来却退了 0.9。若一直锚定历史最高 90.0,下限固定为 89.6,那么第二次替换就会被挡住。
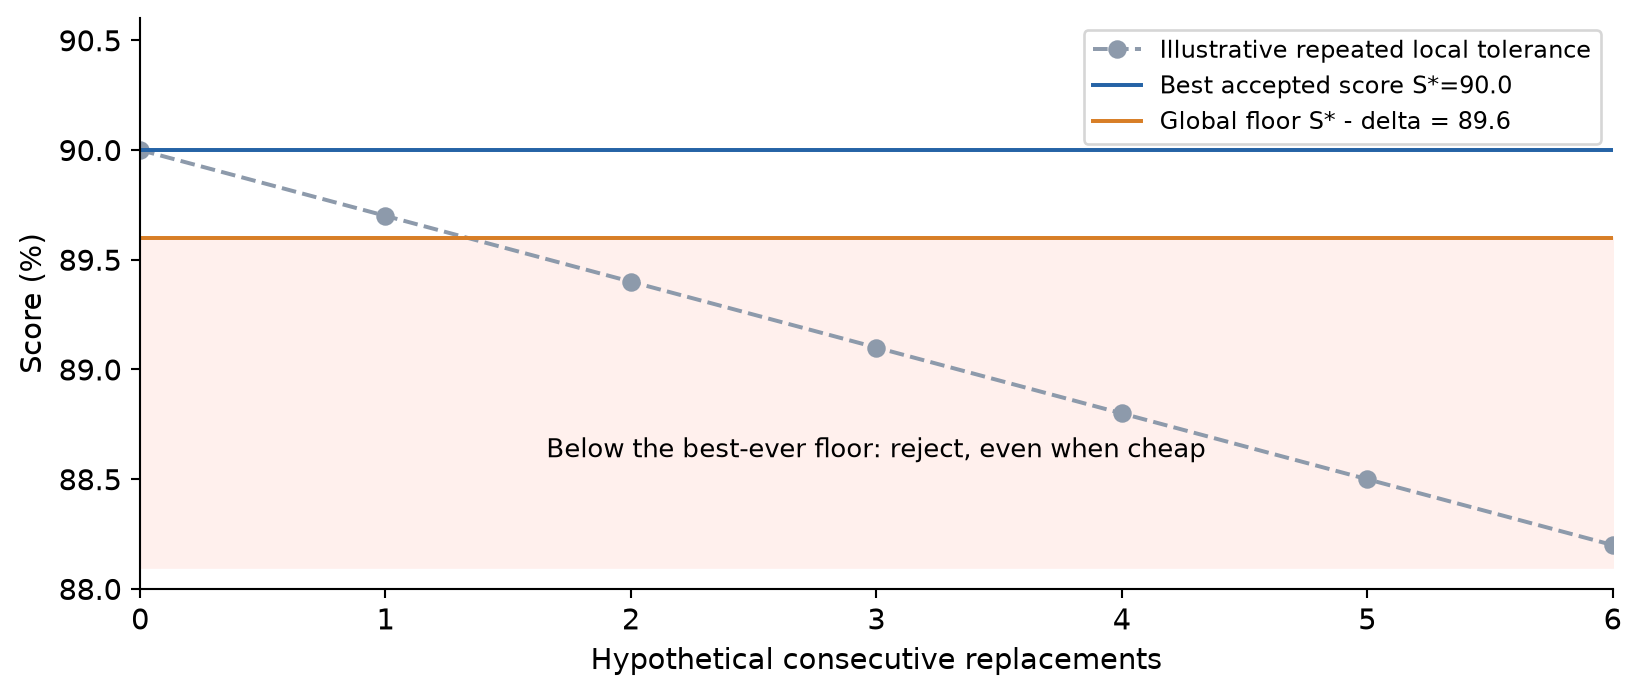
图 3. 为解释下限而构造的假设例子,非论文实测轨迹。即使候选更省 token,低于 89.6 仍不能进入接受路径。
这个门槛防止的是向下漂移,并不是统计显著性证明。 来自不变基础 harness 的重复评测波动,不是为整个自适应搜索推导出的同时置信界。不同候选可能有不同方差;一次幸运的高分也可能把下限抬得过高。保守选择有实际价值,但不应被描述成已经解决了多重比较和自适应偏差。
5.3 超过噪声带的收益,要证明额外计算值得
选择器先相对当前方案计算:
是分数的绝对变化,使用 0 到 1 的小数单位; 是 token 成本的相对变化。若 ,成本条件为 。截距允许一些基础开销,斜率规定更大的已测收益最多可以买多少额外计算。
编码设置的参数是 、。看起来斜率很大,其实和分数单位有关。按附录例子,多通过 7 次执行,先得到 ;乘以 44.5 得到 1.75;再加 0.10,允许相对成本增长 1.85,即 185%。作者描述的候选实际增加 130%,因此落在允许范围内。
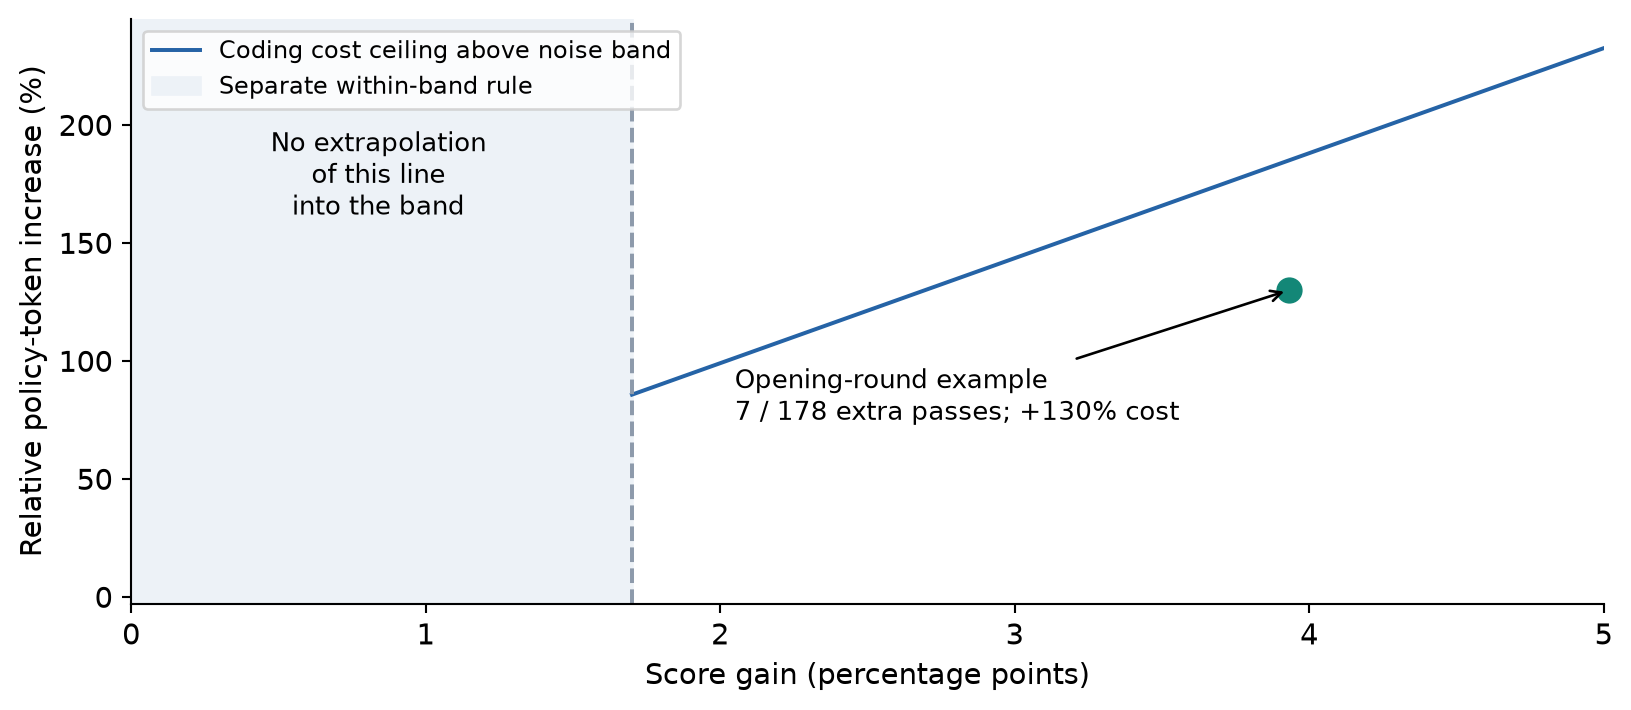
图 4. 按表 5 的参数计算,并标注附录 E.1 的开局算例。阴影区域使用另一套规则,不能把直线延长进去代替那套规则。
这个推导也说明,“正则化”不等于开销只能小幅增加。相对增长 185% 意味着最终可以达到当前方案成本的 2.85 倍。规则约束的是收益与代价之间的关系,而不是一个绝对很小的预算。它能否适合真实部署,还取决于使用者愿意为成功率付出多少成本。
单位错误会让门槛完全失效。3.93 个百分点应代入 0.0393,不能代入 3.93;130% 的相对增长应代入 1.30,不能代入 130。前者错一个单位,会把收益对应的成本许可放大一百倍。阅读这类论文时,写清单位比直接记住一组超参数更重要。
这些成本参数按基准的计分粒度和开局候选行为校准,后续迁移时固定,不用 OOD 成绩重新调。但“没有看 OOD 调参”不等于参数没有受到搜索环境影响。换一套分数尺度、任务权重或实际预算,这些系数都需要重新解释。
5.4 噪声带内:不是把上面的直线继续用下去
若候选通过全局下限,但收益没有超过容忍带,论文改用:
只包含客户端工具、技能、记忆和子 Agent 四类。 数的是这类组件此前出现在胜出编辑中的记录。因此新颖性奖励不是衡量候选语义有多新,而是统计它触及了几个从未被接受过的结构类别。普通提示词、控制流、配置、输出处理和上下文管理都不拿这一项奖励。
对编码任务,论文明确设 。带内的小幅分数上涨,不能单独让候选合格;它需要更低成本或者结构新颖性提供正贡献。因为 时,,省 token 可以成为留下它的理由。工作流和工程设置则用正的 ,因此小分数变化仍会参与判断。不能把“噪声带内不奖励涨分”当成三个领域完全统一的规则。
这里还有一个信息缺口:附录 D.3 说三个权重列在表 5,但实际展示的表 5 没有这些行。于是我们能说明规则方向,知道编码任务的特殊情况,却不能从论文里恢复其余数值。大收益分支的成本公式也不能拿来补空白,因为论文明确说此时不使用那条公式。
算法 2. 按论文门槛选择下一轮方案
输入:筛选后的候选、当前 (H, S, C)、历史最好分数 Sstar
1. 在固定搜索集上评测候选,每题运行 k 次。
2. 计算相对当前方案的分数差 deltaS 和成本差 deltaC。
3. 统计候选触及的、此前未接受过的结构类别数。
4. 若 deltaS > delta:
       cost_ok = deltaC <= beta0 + beta1 * deltaS
5. 否则:
       cost_ok = ws * deltaS - wc * deltaC + wn * novelty > 0
6. 另要求分数 >= Sstar - delta,并通过领域守卫条件。
7. 收集同时通过所有门槛的候选。
8. 从中选实测分数最高者;集合为空则保留当前方案。
9. 用最终接受方案的分数更新 Sstar。
10. 记录全部有效测量,只把新胜出者标为已接受。
这个过程并不保证每轮分数单调增加。只要没有跌破全局下限,一个略低分但更便宜或有结构新颖性的候选也可能入选。还要注意,整形公式只负责准入,合格候选之间仍按实测分数排序;新颖性奖励并没有直接成为最终排名函数。
6. 实验设置:八个基准,九个切分
主实验冻结 Claude Opus 4.8 作为策略,提议、分析和 critic 也使用它。编码从 Terminus-2 起步,工作流和工程采用 ReAct 式循环、工具网关、动态工具选择与上下文管理。基线共用初始 harness、模型、搜索任务和候选预算。这比比较完全不同的现成 Agent 更容易识别搜索方法的作用,但候选数量相同仍不意味着优化总计算相同。
三个领域分别独立进化:编码在 89 道 Terminal-Bench 2.1 上搜索,再测 SWE-bench Verified;工作流用 Harvey LAB 的 120 题搜索、40 题作同分布留出,再测 JobBench、GDPval、APEX;工程在 61 道无需商业模拟器的 EngDesign 题上搜索,再测 Frontier-Eng。合计八个基准,Harvey 多一个切分,所以结果表有九个分数位置,而不是九个相互独立的领域。
| 设置 | 搜索轮数 | 每题执行次数 | 噪声容限 | 初始编辑上限 | 剪枝窗口 |
|---|---|---|---|---|---|
| 编码 | 20 | 2 | 0.017 | 4 | 4 |
| 工作流 | 20 | 2 | 0.004 | 3 | 4 |
| 工程设计 | 40 | 4 | 0.020 | 4 | 5 |
本笔记表 1 摘录原文表 5。噪声容限使用小数单位,0.017 对应 1.7 个百分点。三组都把最小编辑预算列为 1、停滞窗口列为 3、每轮两个候选中的探索名额列为 1;前面指出的取整终点问题仍需保留。
评分协议也不能简化成“通过率”。Terminal 使用隐藏测试,各组之间重建容器;SWE-bench 同时要求修复原失败测试、保住原通过测试;Harvey 对每条 rubric 独立评分,缺交文件对应条目全部失败。APEX 则始终使用 480 题的完整分母,基础设施问题造成的缺失 rollout 也按失败处理,避免只把容易完成的任务留下来计算。
工程设计提供了一个互补检验:评分由固定模拟器或测试台决定,不依赖模型裁判。这消除了裁判采样带来的波动,但 Agent 自己仍然随机,也仍可能适应固定任务集合。Frontier-Eng 排除了与 EngDesign 重叠的领域,对无法构建的环境在两组都不给分;论文说 47 题中有 38 题贡献了奖牌信用。这个奖牌分是达到固定阈值后的平均信用,不能改称普通解题率。
GDPval 的描述存在一个尚未解释的计数问题:附录 B.5 写了 185 道题、每对产物按两种顺序展示,随后又写每位裁判每个 harness 做 204 次比较。按最直接的全量解释,这几项不能相互对应。本笔记保留作者报告的胜率,不用那个 204 擅自推导标准误或有效样本量。
从实验设计看,同一时间窗口、相同工具环境、相同裁判和执行次数都能减少无关差异;重叠领域排除和缺失记失败也加强了比较。但这些措施解决的是特定偏差来源,不能把结果扩展成对所有未来任务环境的保证。
7. 结果:迁移能力改变了方法排名
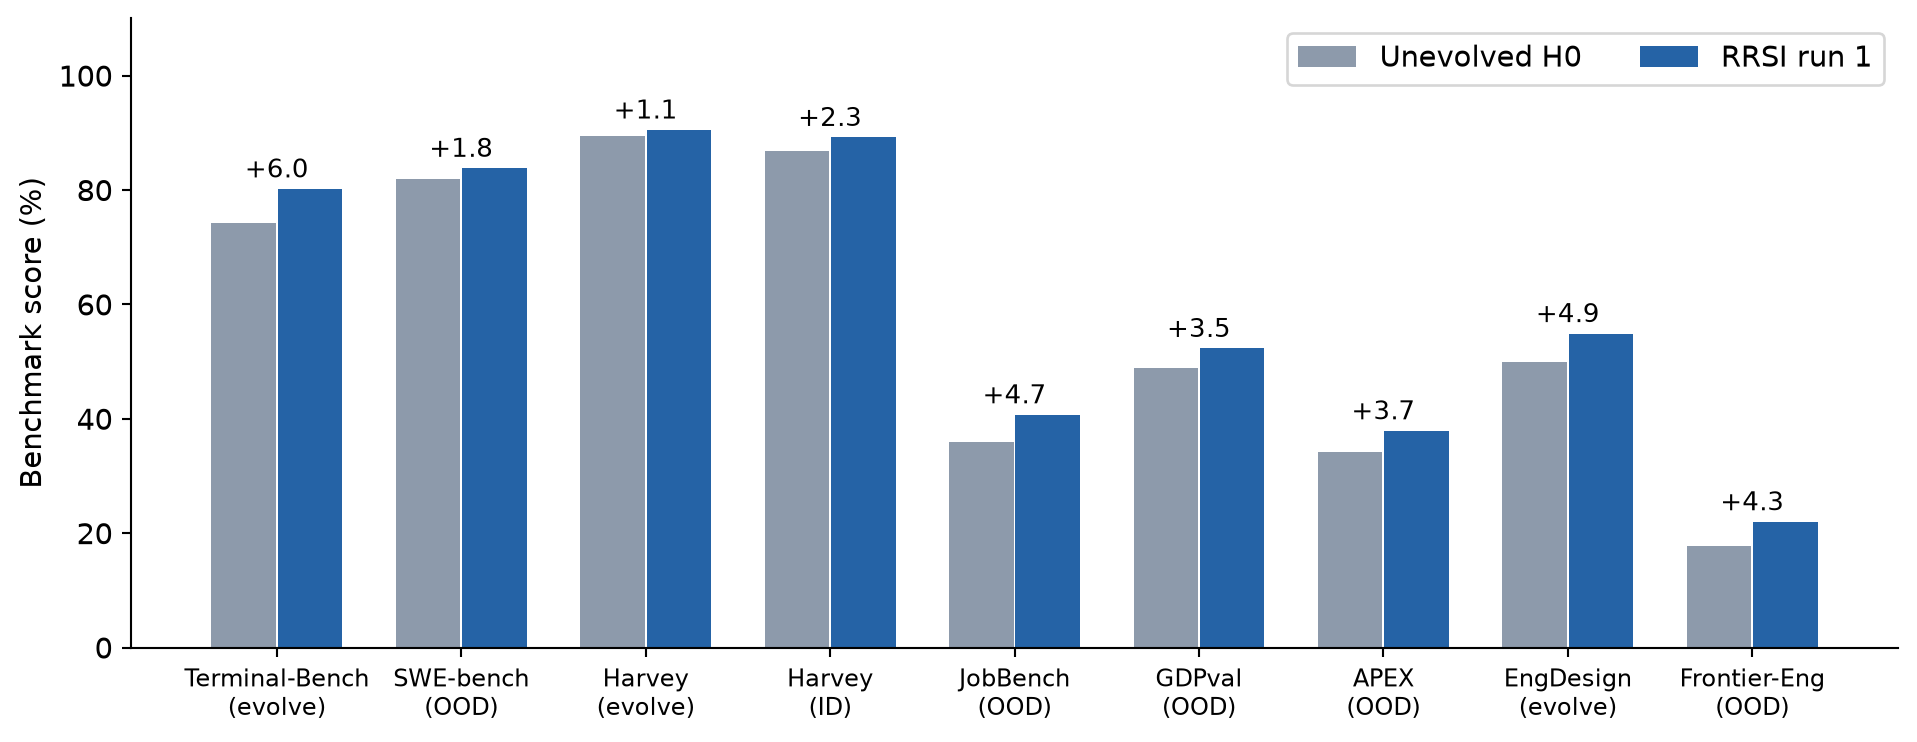
图 5. 根据原文图 3 与表 7 第一轮搜索重绘。各柱保留对应基准的原计分定义,上方是百分点变化;纵轴从零开始,不通过截断坐标放大小增益。
第一轮主实验里,RRSI 在六个没有参与进化的切分上都超过起点:SWE-bench 为 82.0→83.8,Harvey 留出集为 86.9→89.2,JobBench 为 36.0→40.7,GDPval 为 48.8→52.3,APEX 为 34.2→37.9,Frontier-Eng 为 17.7→22.0。三个搜索集的增长分别是编码 6.0、工作流 1.1、工程 4.9 个百分点。
更有信息量的是与其他进化方法的对照。四个基线在 Harvey 搜索集上都比 RRSI 涨得多,但离开搜索环境以后,情况并不一致。AHE 在 JobBench 上涨,在 GDPval 和 APEX 上退;TTHE 三个 OOD 都退。一个好看的搜索分数显然不能替代迁移评估,而一个平均 OOD 分数也最好同时列出各基准细项。
| 方法 | Harvey 搜索 | Harvey 留出 | JobBench | GDPval | APEX |
|---|---|---|---|---|---|
| 初始 harness | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
本笔记表 2 对应原文表 1。Harvey 留出集上,RRSI 与 Meta-Harness 在展示精度下同为 89.2,因此不能写成“每个留出集都严格胜过所有基线”。它真正拉开差距的是三个 OOD 基准。
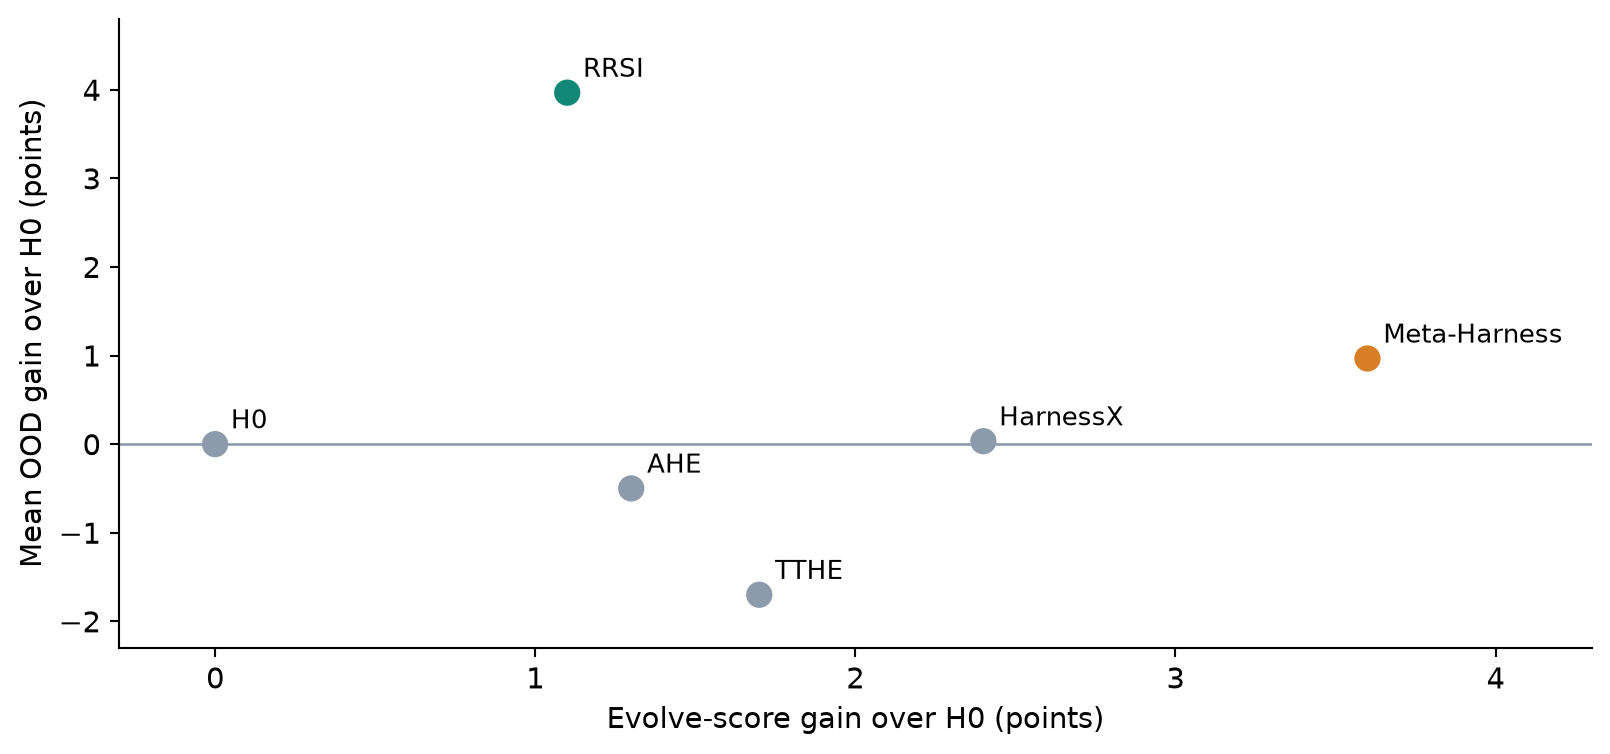
图 6. 从原文表 1 的展示数值计算。纵轴是 JobBench、GDPval、APEX 三个基准增益的等权平均,并非把所有任务放在一起算总成功率。
用表中的舍入数值手算,RRSI 的平均为 ,基础方案为 ,相差约 3.97 个百分点,相对增幅约 10.0%。Meta-Harness 平均为 40.633,约比起点高 0.97 个百分点。若只拿论文摘要式的 43.6、39.7、40.6 相减,就可能相差 0.1;这属于聚合和舍入顺序导致的差异。
另外两处不是简单舍入问题。摘要说 OOD 最大提升 4.3 点,但 JobBench 的表格和主图是 +4.7;工程那项才是 +4.3。摘要又说比无正则进化节省 30% token,但消融表的两行相除并不正好得到 30%。这些不改变主要方向,却提醒我们:精读应以明确表格、明确比较对象为单位,不能把宣传式汇总数字当成覆盖所有实验的统一结论。
8. 消融与成本:更好的机制也可能更贵
原文表 2 移除的是成组规则,而不是逐项组件。去掉提议端约束,工作流 OOD 平均从 43.6 降到 41.9;去掉接受端约束,降到 41.0;两者都去掉,搜索集升到 92.8,OOD 却只有 40.3。这与方法动机一致:放松搜索更容易适应眼前任务,但不一定留下可迁移的机制。
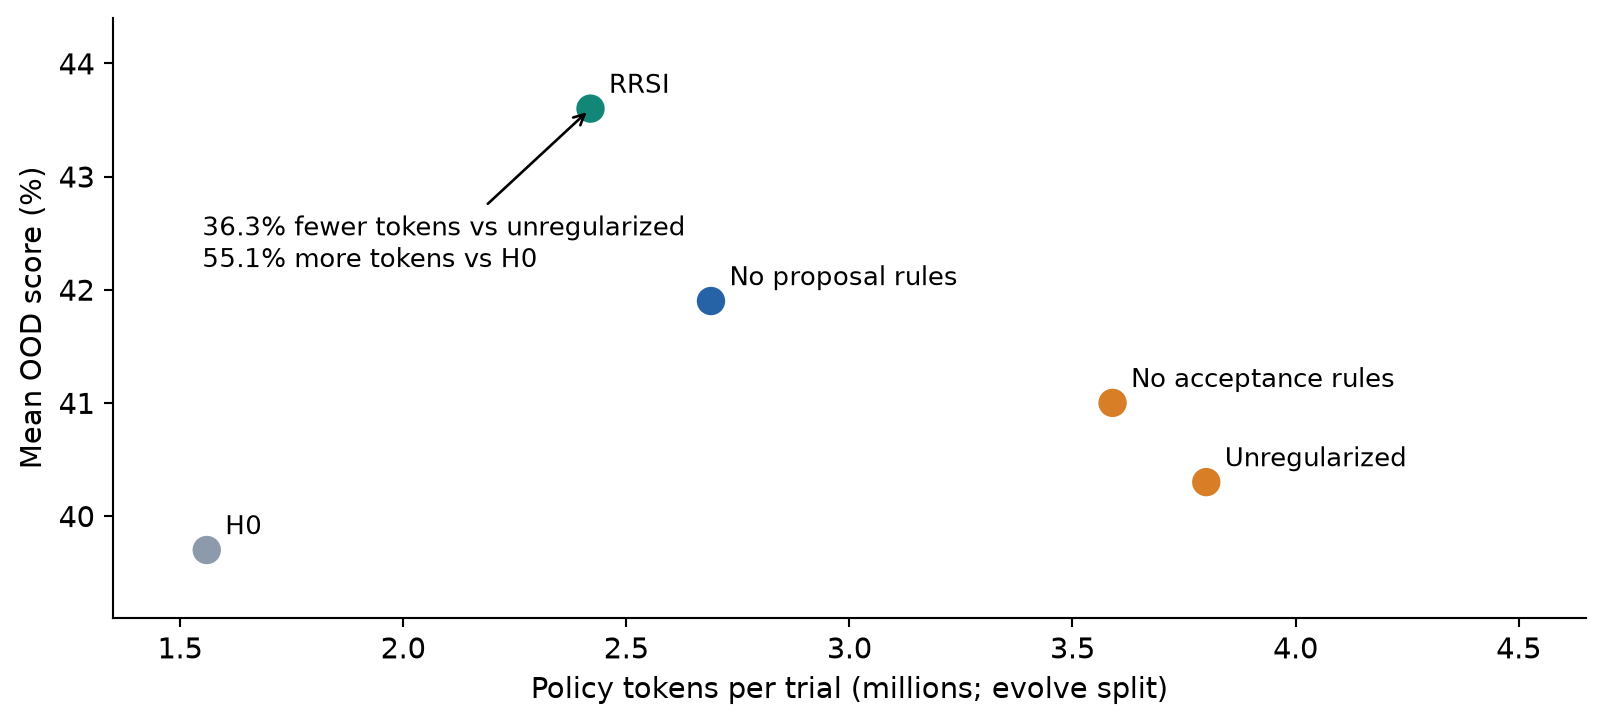
图 7. 数值来自原文表 2。横轴是最终 harness 在搜索切分上执行的策略 token,不是提议、分析、筛选和全部候选评测的总优化成本。
RRSI 每次执行使用 242 万策略 token,无正则进化使用 380 万,初始 harness 使用 156 万。两种比较应该同时呈现:
所以,这篇论文说明的是正则化能约束进化后的成本膨胀,而不是把 Agent 变得比最初更便宜。最终能力仍有一部分由额外推理计算换来。判断是否值得部署,还要看延迟、工具费用、上下文长度、失败恢复成本,以及搜索费用经过多少次实际使用才能摊薄。
消融结果也不能直接给每项机制分配一个独立贡献。接受端包含筛选、稳定性和资源约束,去掉整个组会同时改变多种激励。提议端改变了候选分布,选择端再从这个分布中挑选,两者天然交互。把联合收益简单拆成“预算贡献多少、critic 贡献多少、剪枝贡献多少”,当前表格并不支持。
附录 F 的案例有助于理解这些条件怎样改变决定。编码第 0 轮 A 候选加入有界的交付前验证,以及长任务的非阻塞轮询指引,涨 3.93 点后被接受;相似的 B 候选只涨 1.69 点、成本增 26.1%,被拒绝。第 8 轮 B 候选虽省 13.6% token,却退 2.81 点,跌破下限。工程中一个通用目录错误恢复提示,把通过次数从 122/244 提到 128/244,token 只增加 1.6%,于是留下。
这些都是论文报告的代表性案例,不是全部候选的因果分析。尤其是对被拒候选,不能只看“它也涨分了”就说规则浪费机会;还必须看它处于哪个分支、是否清楚超过噪声以及额外代价。反过来,规则接受了候选,也不等于已经证明这个机制在任何领域都有效。
工作流最终方案更能体现方法的取向:论文说 20 轮中评测了 32 个候选,只接受 4 项编辑,都接到原本已有的一次交付前回看步骤上,包括覆盖与深度检查,以及读回文件、指出缺失信息的探针。与不断堆积常驻 rubric 提示不同,这些机制针对的是“实际交付了什么”。它们为什么可能迁移,有合理解释;但合理解释仍需结果支持,也不能证明这四项就是唯一最优组合。
9. 统计证据:先问区间是在对什么随机性说话
9.1 为什么要按任务配对 bootstrap
假设任务 上,两组平均结果的差为 。配对 bootstrap 每次重采样任务编号,并在两组中使用相同的编号。对于简单任务等权平均,第 次重采样的增益估计为:
可以拆成三步。先把同一道题上两组结果对应起来;再按任务有放回抽样;最后在抽到的同一批任务上重新计算两组统计量并求差。这样保留了任务难度的配对关系,也把同一任务的多次执行绑在一起。若把每次 rollout 当成独立题目,会低估相关性,从而可能得到过窄区间。
对按 rubric 权重聚合或其他非线性指标,最后一步应重算该基准自己的统计量,而不是机械套等权平均。原文使用一万次重采样,取 2.5% 与 97.5% 分位数作为 95% 区间。
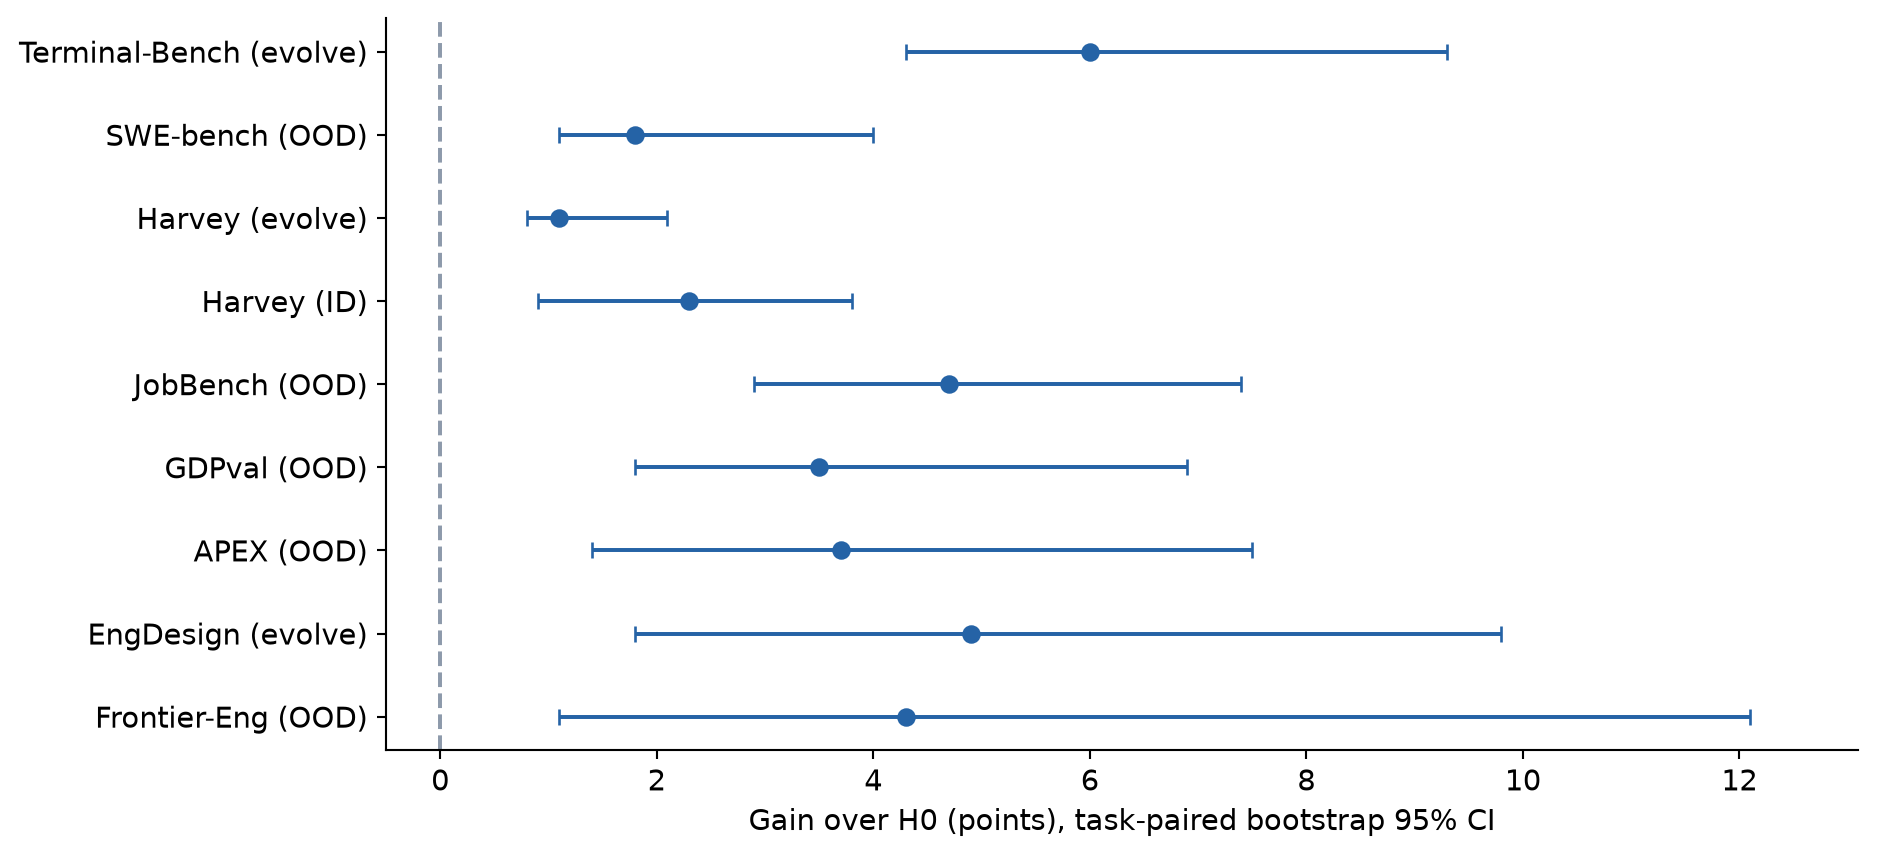
图 8. 点估计与区间端点全部来自原文表 6。这是已得到的 harness 在任务集合上的评测不确定性,不是无限多次进化搜索的区间。
列出的区间都在零以上。SWE-bench 的点估计为 +1.8,区间为 [1.1, 4.0];Frontier-Eng 的点估计为 +4.3,区间宽得多,为 [1.1, 12.1]。后者支持正向改善,但对于改善幅度仍有明显不确定性。区间为正,也不等于每个子任务都受益,更不保证换到新工具生态仍然有效。
还有一层选择条件不能忘掉。搜索集上的最终 harness 本来就是根据同一批题选出来的,常规 bootstrap 并没有把这个自适应选择过程消掉。即使是未参与搜索的留出集,区间也主要描述当前基准内部的任务变化,不是“未来任意新基准”的不确定性。它比单个分数强得多,但不能承担超出设计范围的结论。
9.2 重跑搜索,比重复测最终方案更进一步
作者用不同提议随机性重跑每个主实验。两次搜索产物在九个切分上都超过起点;工作流 OOD 平均第一次为 43.6,第二次为 43.7;最大差异出现在 Terminal-Bench,为 1.8 点,其余八个切分差异不超过 0.6。
这直接回应了“是否只靠一次幸运修改链条”的疑问,是有价值的补充。但毕竟只有两条搜索轨迹,还不能估计坏结果的尾部概率,也不足以稳定估计搜索方差。论文据此认为观察到的搜索差异小于任务评测差异,这可以描述这两次运行,却不应提升成普遍的方差大小关系。
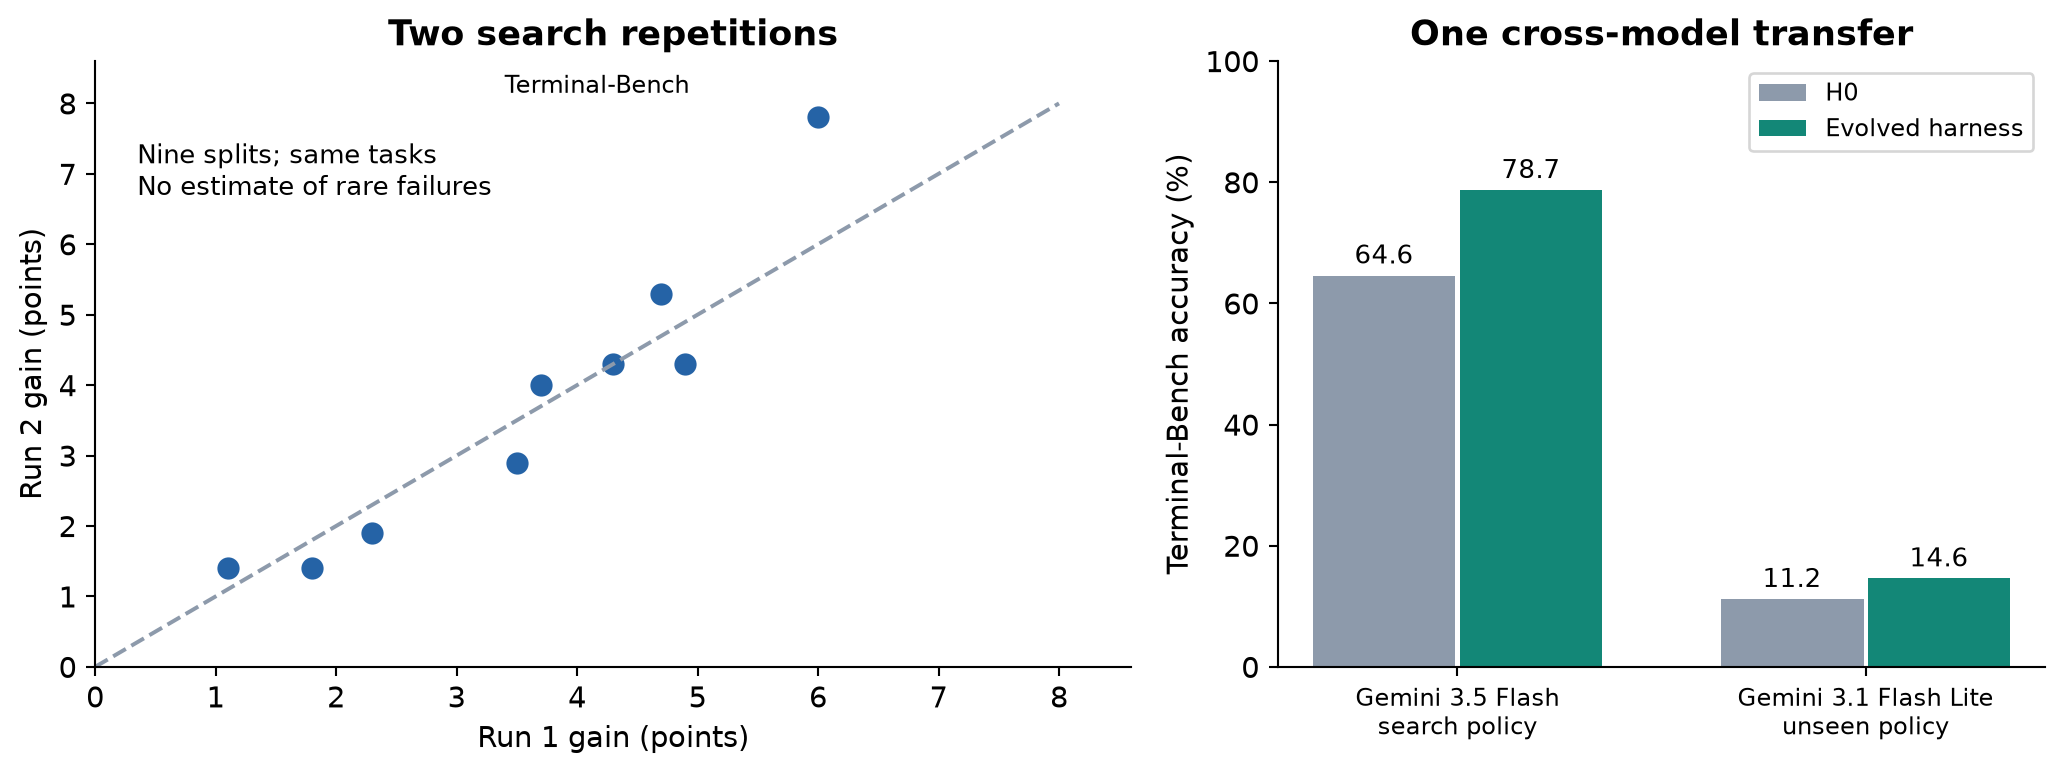
图 9. 左图来自表 7,比较两个独立搜索产物的九项增益;右图来自表 4,把同一个 Gemini 3.5 Flash 搜索出的 harness 原样交给 Gemini 3.1 Flash Lite。两部分检验的是不同类型的稳健性。
论文还在 Claude Opus 4.8 与 Gemini 3.5 Flash 上分别独立进行编码搜索,SWE-bench OOD 分别改善 1.8 和 2.2 点。这回答“方法是否只能在一个策略家族下工作”。另一项实验则把 Gemini 搜索出的最终 harness 不作修改,换到较小的 Gemini 3.1 Flash Lite,Terminal-Bench 从 11.2 到 14.6。这回答的是某一次跨模型复用,而不是新的 OOD 任务测试。
小模型的相对增幅为 ,听起来很大,但最终绝对成绩仍是 14.6。相对改善和绝对能力必须一起看。一次迁移成功说明机制不完全依赖原搜索模型,不足以证明任意模型、任意工具接口和任意上下文预算都能直接兼容。
10. 设计取舍:什么时候替代方案可能更合适?
| 设计选择 | 主要收益 | 可比较的替代方案 | 失败边界 |
|---|---|---|---|
| 编辑预算逐步收紧 | 后期更容易归因 | 全程单编辑 | 协调修复可能需要多项变化 |
| 保留全部有效历史 | 不轻易遗忘失败证据 | 近期窗口摘要 | 环境改变后旧失败可能过时 |
| 历史最好分数下限 | 阻止小退步逐轮累积 | 配对复测候选 | 幸运高分可能把门槛抬高 |
| token 增长条件 | 明确能力的额外代价 | 等计算预算优化 | token 不等于总延迟和总费用 |
| 新结构类别奖励 | 鼓励未用过的机制 | 行为多样性度量 | 类别新颖不等于功能新颖 |
| 提议删除无效组件 | 约束结构不断堆积 | 逐项受控消融 | 联合候选的信用可能混杂 |
当任务反馈有限、每次完整评测很贵时,这种启发式组合有吸引力:不为每个组件做昂贵因果实验,而是利用保守准入和最终迁移测试控制风险。如果模拟环境非常便宜,较完整的组合消融可能更值得;如果生产环境经常变化,旧负面证据则可能需要加上上下文或衰减,避免一个曾经失败的假设永远没有翻案机会。
一个尤其重要的对照是计算预算匹配。初始 harness 若也获准使用同样多的推理预算,例如添加通用的重试或验证,RRSI 还剩多少优势?现有消融表表明,它比更昂贵的无正则进化更好,这一点有实质意义;但表格没有完全分离“学到了更好的机制”和“把额外测试时计算分配得更合理”这两种来源。
长期使用还涉及另一种成本:维护可理解性。组件标签、假设记录和淘汰原因能帮助人理解进化路径,但记录越来越长也可能增加提议负担。压缩历史会节省上下文,却可能丢掉重要的失败条件。论文的有限轮数实验没有解决这个长期权衡,因此不宜直接推断数百或数千轮以后仍能保持同样效果。
11. 局限:这组证据还不能覆盖什么
作者研究的是冻结底层模型的 harness 进化。若同时训练模型权重,策略变化和外部机制变化会互相影响,现有归因会更复杂。实验也只覆盖有限初始架构、工具环境和搜索长度,不能把最多 40 轮的结果写成开放式、无限期自我增强的证据。
噪声带是经验容忍值,不是序贯检验保证;critic 是模型判断,不是泛化性质的判定器;组件收益来自候选级结果继承,结构新颖性来自手工类别。这些近似各有道理,但错误可能相互放大:一次错误归因让某个组件免于删除,又影响下一轮提议,最终形成一个很连贯却未必正确的解释。
成本方面,最终策略 token 省下多少,不等于总搜索账单省下多少。相同候选预算也没有控制提议 token、critic 调用、分析过程和无效评测开销。若只报告部署时的成本,而不报告寻找这个 harness 花了多少资源,就无法准确计算在低频任务中是否值得。
论文规范还有几处需要澄清:噪声带内权重没有按引用位置完整列出,领域守卫条件不够具体,预算取整终点与文字描述有差别,GDPval 比较次数不易对应。它们限制的是对完整决策过程的精确理解,不是可以靠猜测补上的小细节。摘要与表格的收益汇总差异也应保留,而不是选择一个更好看的数字。
12. 独立批判性分析:真正有价值的是让修改承担举证责任
我对 RRSI 最积极的理解,是把持久修改从“看起来有用就留着”改成“必须持续解释自己为什么值得存在”。一项变化要说明它针对什么失败,过性能下限,交代额外代价,并在没有参与反馈的任务上体现价值。关注点因此从产生了多少建议,转向留下的变化有多少证据。这一原则比某个具体余弦日程更值得迁移到实际 Agent 系统。
但方法的证据强项在于组合后的实验效果,不在于正则化名词。论文没有推导编辑数、剪枝窗口、成本斜率如何共同给出迁移风险上界。、、 的类比可以帮助记忆三类控制,但不能顺便借来这些经典估计方法的理论保证。真正支撑主张的是未见任务上的改善,以及与更昂贵、搜索分更高方案的对比。
第二个关键区别,是避免明显泄漏不等于避免适应基准。附录自己就指出,基线未必硬编码题目名称,却可能把评分习惯和文档类型写进常驻机制。一个语义上很通用的检查表,仍然可能只适合某类工作。因此 critic 只能作为前置过滤,不能替代留出评测。若研究者看过留出结果之后继续设计规则,下一轮主张还需要新的外层测试集。
要进一步判断这套方案究竟为什么有效,我会优先看五组实验。第一,匹配最终推理成本,比较进化机制和通用额外验证。第二,改变搜索任务切分并增加搜索随机种子,既报告平均迁移,也报告最差退步。第三,拆开接受端各个组件并分析交互,避免只知道整组有用。第四,用显式特异、隐式特异以及看似可疑但实际通用的候选校准 critic。第五,把运行拉长到未探索组件集合已经耗尽以后,观察新颖性与历史机制还能否提供方向。
这些是待做建议,不是本笔记新增的实验。它们主要想分开三种解释:机制本身更好、额外计算分配更好,以及这套超参数恰好匹配当前基准。现有结果对第一种提供了鼓舞性的证据,对第二种相对无正则搜索的改善也很明确;但要知道它们多久会同时成立,需要更广的环境和更充分的重复。
还有一个值得更谨慎措辞的地方是“因果归因”。把编辑预算降到一项,确实让分数变化更容易对应到一次修改;但单项编辑的效果仍可能依赖之前的整个 harness,也可能受任务噪声影响。因此合理表述是提高可解释性和归因清晰度,而不是实现了无歧义因果识别。承认这种差别,不会削弱方法的工程价值,反而能帮助后续实验更准确地设计。
13. 结论
RRSI 给“Agent 应该什么时候留下自己提出的修改”提供了一个具体答案:不能只看搜索集涨分,还要检查特异性、稳定性、额外成本,并把失败记录纳入后续推理。它最有说服力的结果,是少获得一些搜索集收益,却在多个未见切分上保住了更好的表现。
实践上,应把自我进化看成一个证据预算有限的自适应实验。小步修改有助于解释,保守选择有助于防止漂移,迁移测试则检验机制是否离开原题集还能工作。这三者都不能单独证明泛化;结合起来,才比一条不断上升的搜索分数曲线更接近“系统确实改进了”的证据。
参考资料与回读位置
- Peng Xia 等,RRSI: Regularized Recursive Self-Improvement of Agent Harnesses,v3。方法看正文第 3 节与附录 D,基准计分看附录 B,超参数与统计证据看附录 E,案例看附录 F。
- 作者项目页。作为补充入口;本笔记数值比较以版本化论文中的表格为准。
- 官方代码资源入口。供后续查找资源。