笔记日期: 2026-10-16
论文题名: Dobi-SVD: Differentiable SVD for LLM Compression and Some New Perspectives
论文作者: Qinsi Wang, Jinghan Ke, Masayoshi Tomizuka, Yiran Chen, Kurt Keutzer, Chenfeng Xu
论文编号与版本: arXiv:2502.02723v1,2025-02-04
资源: 论文及附录 · 作者项目页 · 官方资源入口
1. 一个压缩比例,其实包含三个决定
读低秩压缩论文时,很容易把问题想成:模型太大,给每个权重矩阵做一次 SVD,删掉靠后的奇异值,再把两块小矩阵存起来。Dobi-SVD 让我重新注意到,在真正执行这一步之前,还有三个没有被这个描述回答的问题:到底应该观察哪个矩阵的谱?不同层该各自保留多少秩?留下来的方向,值得用多少位精度保存?
这篇论文按一个很自然、但实现起来并不轻松的顺序处理它们。先观察线性层产生的激活,学习每个矩阵的截断位置;再把不同输入对应的激活子空间,汇总成一套固定权重;最后对低秩因子的部分区域降低位宽,使同一个存储预算能够容纳更多方向。它的核心不是某一次 SVD,而是把选择方向、分配秩、分配精度连在了一起。
这条路线最吸引我的地方,也是最需要仔细分辨的地方,是“最优”到底修饰什么。对一个给定激活矩阵,最优的秩约束近似有明确的代数答案。可是实际部署的语言模型不能为每个提示单独存一套权重,它必须用固定参数应对未来输入。从前一个问题走到后一个问题,需要做跨样本汇总;这一步已经改变了优化目标。再加上混合精度之后,误差也不再只有奇异值截断误差。
因此,这篇笔记会把每一段论证的适用范围写清楚。局部成立的等式,就按等式讲;依赖样本和近似的环节,就按近似讲;论文测出来的吞吐量,就连同硬件、批量和内存条件一起讲。这样才能真正理解它为什么有效,也才知道哪些设计可以带到下一篇论文或自己的系统里。
先约定一个容易混淆的词:本文说的 0.4,是名义上保留 40% 的资源预算,不是只删除 40%。在不改精度时,这个预算可以按因子元素数计算;加入 remapping 之后,它更准确地对应按原始位宽折算的存储量。参数个数、存储字节和计算量不再能互相替换。下面的实验数字均来自论文;小矩阵例子和解析曲线只是帮助理解的构造,不是新增模型实验。
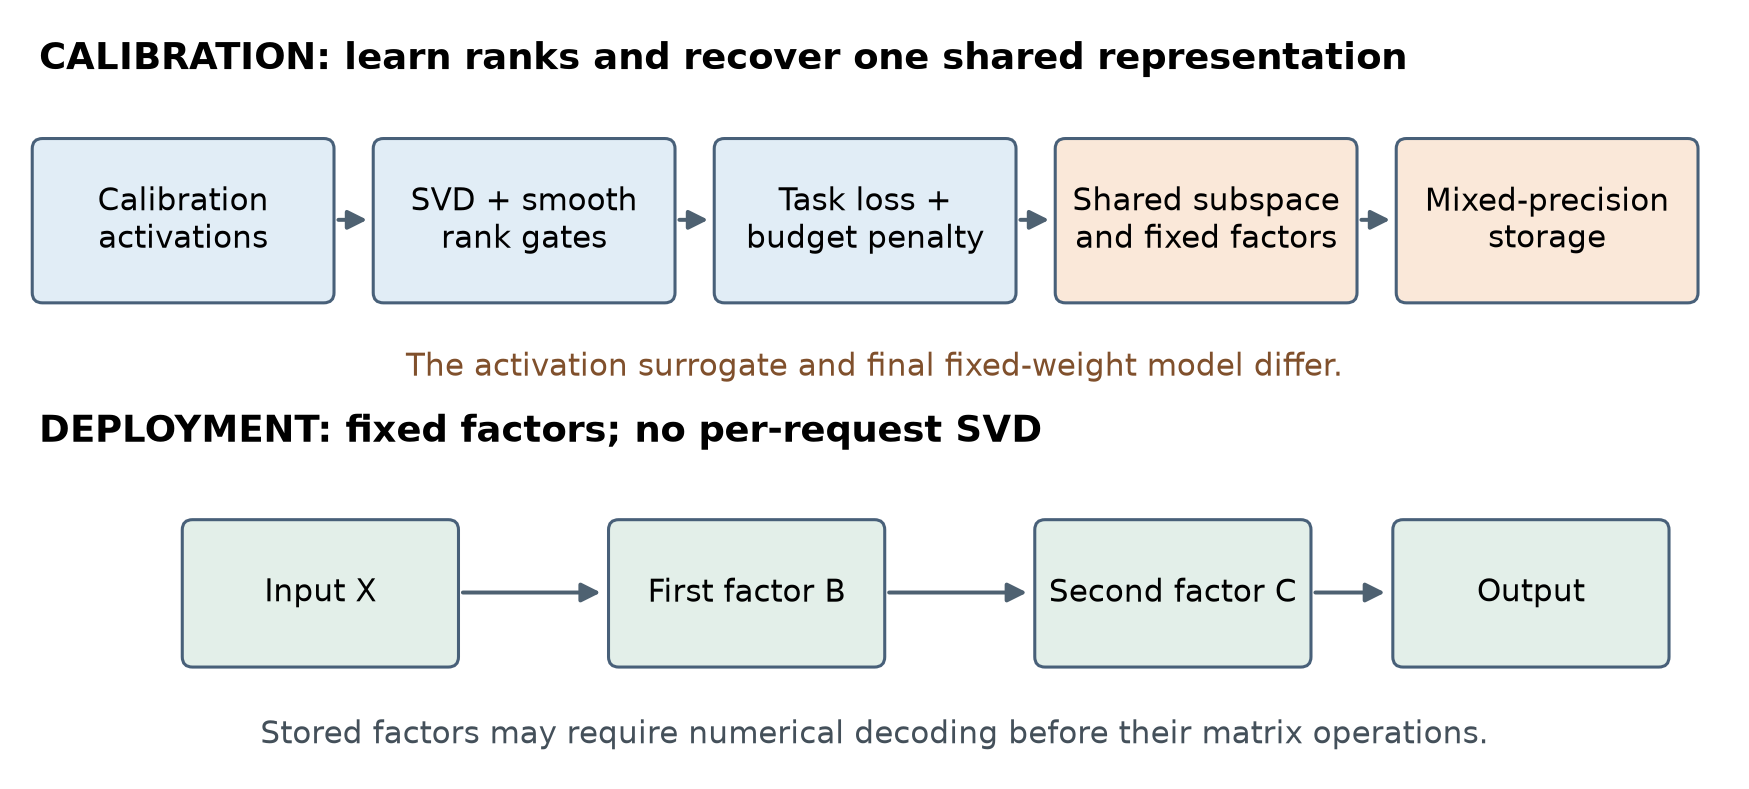
图 1:根据论文 3.1–3.3 节整理的原创流程图。校准阶段分解激活并利用任务反馈,部署阶段使用恢复后的固定因子;图中没有把离线分解当作逐请求操作,也没有指定某种运行内核。
2. 先补齐前置知识:究竟近似谁的误差?
2.1 维度写对,投影方向才不会看反
采用行向量输入的记法。设 是一批 token 的输入表示, 是线性层权重,则输出激活为 。如果把权重写成 ,其中 、,推理就变成先计算 ,再乘 。
这个记号里,激活矩阵的右奇异向量位于输出特征空间,维数是 。保留右侧的一个子空间,表示保留若干输出方向,不是从输入序列里删掉某几个 token。低秩压缩和 token 剪枝可能都减少某些资源,但它们丢掉的信息不是同一类。
薄 SVD 写成 。 和 的列正交归一, 对角线上是非负、从大到小排列的奇异值。这里需要的是正交性质,不是说这两个矩形矩阵具有“正定性”。秩描述独立方向的数量,奇异值则描述在当前矩阵和当前度量下,每个方向承载了多少能量。
Frobenius 范数把所有元素的平方误差相加。它看起来很中立,但“所有元素”属于哪个矩阵很重要:平均对待权重元素,与平均对待模型实际产生的激活元素,是两个不同目标。输入可能反复使用一个很小的权重方向,也可能几乎不触发一个很大的方向。
2.2 为什么权重 SVD 好,输出却可能很差?
设误差矩阵 。激活重建的平方误差可以逐步展开为:
第一步只是把 代入范数定义,第二步把输入的 Gram 矩阵写成半正定平方根。这个式子把输入的作用露出来了:权重误差前面多了一个由数据决定的几何变换。如果 恰好与单位矩阵成比例,权重误差和激活误差只差一个缩放;如果输入强烈偏向某些方向,两者就可能完全不同。
看一个不涉及任何模型训练的小例子。令 ,。在权重里,第一维的 3 大于第二维的 1,因此秩一的权重 SVD 留下第一维。但激活变成了 ,真正大的输出方向是第二维。按权重选方向,激活平方误差是 100;按激活选方向,平方误差只有 9。
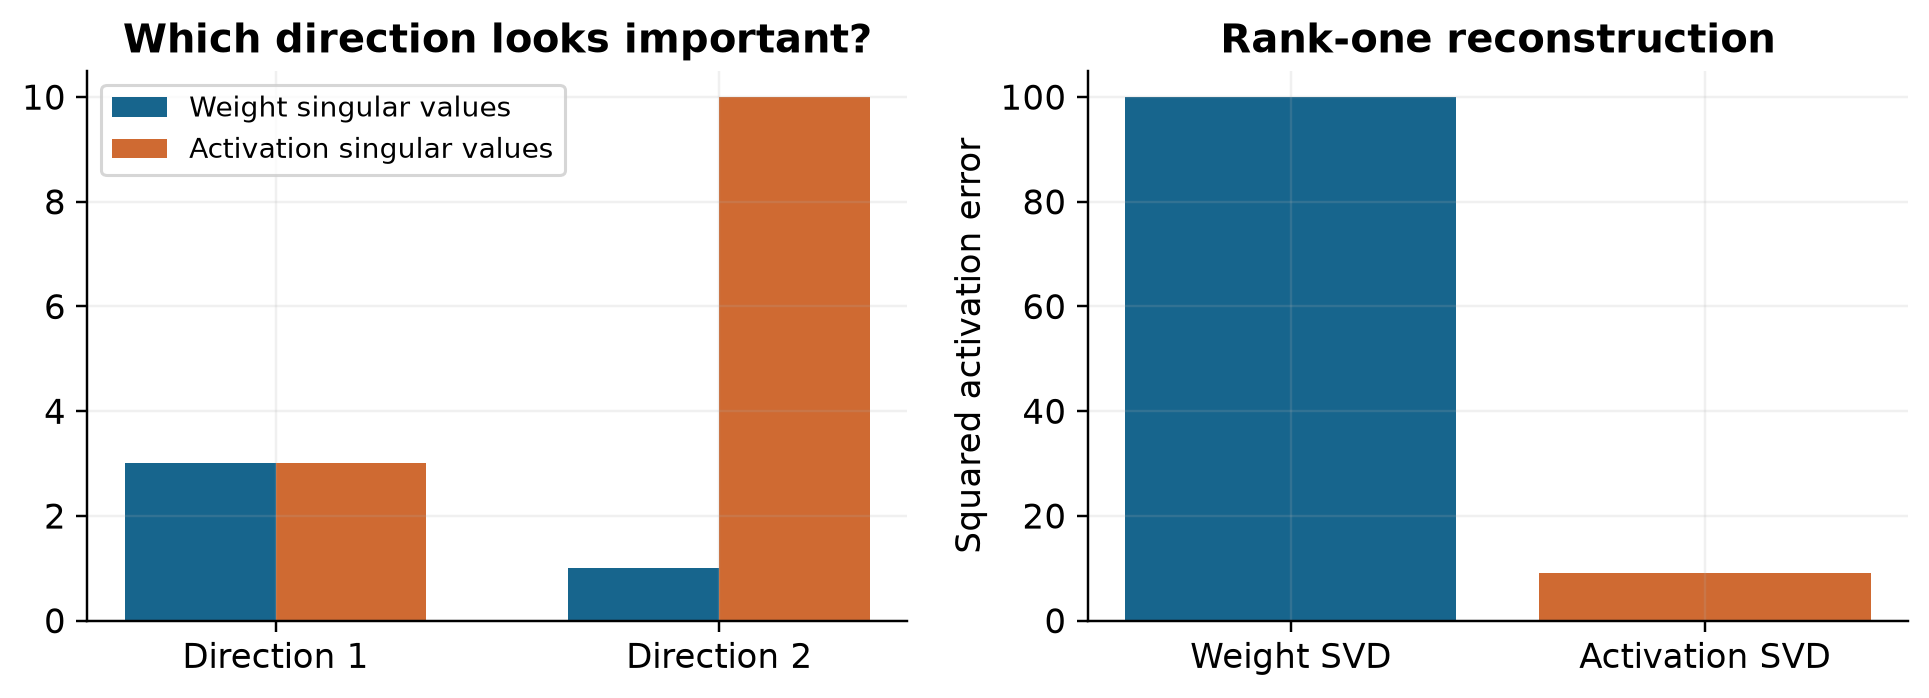
图 2:原创解析例子。左图比较两个矩阵中的方向幅度,右图比较秩一重建的激活误差。它说明两个 SVD 优化的是不同对象,不代表实际语言模型测量。
由式(1)也能直接想到另一条路线:如果能够稳定处理 ,可以先把权重变换到输入加权的空间,在那里截断,再映射回来。因此,直接截断激活不是唯一能感知输入的办法。比较不同方法时,应当进一步看协方差的数值条件、校准数据、近似的形式和各层预算,而不能只凭“它对权重做分解”就认定它一定优化错了目标。
2.3 重建最优,不等于任务最优
Eckart–Young–Mirsky 定理回答的是:给定矩阵、给定秩,在 Frobenius 范数或谱范数下,哪个近似误差最小。它不直接回答下一词预测损失、代码生成错误率或机器人任务失败率。一个能量很小的方向,仍可能被下游任务非常敏感地使用。
重建误差仍然有实际价值。它容易用有限校准数据估计,也给局部压缩提供了清楚的优化目标。需要避免的是把代理目标的保证,直接升级成整个模型行为的保证。Dobi-SVD 的可微秩分配把任务损失引进来,是为了缩短这段距离;但后续固定权重恢复和量化仍然会再次改变近似。
3. 从一份激活到一份权重:这里确实有一个精确答案
设 是激活矩阵前 个右奇异向量组成的基,令 。它是在输出特征空间里的正交投影。将激活右乘这个投影,恰好保留前 个方向:
最关键的一步其实是矩阵乘法结合律。这里没有求 的逆。即使校准 token 数少于输入维度,或者 本来就秩不足,这个构造依然可以在当前输入上精确产生 。而且低秩因子已经现成:取 、,就能把部署层写成 。
为什么可以说它在这个局部问题上最优?任意秩不超过 的权重,乘上 后,输出秩也不会超过 。EYM 定理告诉我们, 已经是所有秩不超过 的输出里最好的那个;式(2)又给出了一份确实能产生它的权重。因此,在固定 、固定线性层、固定重建范数下,这个下界可以达到。
注意准确的秩表述是“不超过 ”。如果选中的奇异值都非零,通常可以得到恰好 的情形;如果激活本身没有这么多非零方向,就不应坚持等号。权重也未必唯一:输入零空间里的某些改变,在这批数据上完全看不出来。局部输出相同,并不意味着未来所有输入上的行为相同。
3.1 激活 SVD 发生在校准阶段
这里很容易产生一个误解:是不是每生成一个 token,都要再对激活做一次 SVD?那样会变成另一种动态方法,也会带来很不一样的开销。Dobi-SVD 用激活分解寻找子空间和学习秩,最终要部署的仍是固定因子。校准时的昂贵分解,与推理时的两次矩阵乘法,应分别记账。
这也解释了为什么“只训练 224 个参数”不意味着压缩过程便宜到可以忽略。确实,优化器不需要为几十亿个权重维护更新状态;但要决定这些秩参数,仍需要计算激活、做分解,并把任务梯度传回去。可训练变量个数和求出这些变量所需的计算量,不是同一个指标。
3.2 把所有激活堆起来,会得到另一个清楚的目标
假设内存足够,可以把所有校准激活纵向堆成 。对它做一次 SVD,会得到所有样本联合重建的输出子空间;等价地,可以看 的主要特征空间。这个观察不要求真的在内存里造出一个巨大矩阵,它只是帮我们明确优化目标。
它与“先给每批数据取一个子空间,再汇总这些子空间”不同。前者保留各批数据的能量大小,后者如果只保留正交基,就可能让一批很弱的激活和一批很强的激活拥有同样的方向投票权。这未必是坏设计,例如它可能减弱异常大幅值样本的影响;但这种选择需要理由,不能自动当成等价变形。
4. 怎样让截断位置变成可以学习的量?
4.1 用平滑门近似离散秩
秩是整数,直接对“保留第几个奇异值”求梯度没有意义。论文给每个矩阵设置一个连续截断位置 ,用双曲正切构造平滑门:
当第 个分量明显在截断位置之前,门值接近 1;明显在后面,门值接近 0;就在边界上时,门值是二分之一。 越大,过渡越陡,越接近真正的硬截断。论文使用 。
这个门的导数是:
它说明梯度主要来自边界附近的奇异分量,并且还受到奇异值幅度的缩放。可以把秩的更新理解成:如果多留一点边界方向能明显减小任务损失,就推动边界向外;如果这些方向不值它们占用的预算,就往里收。
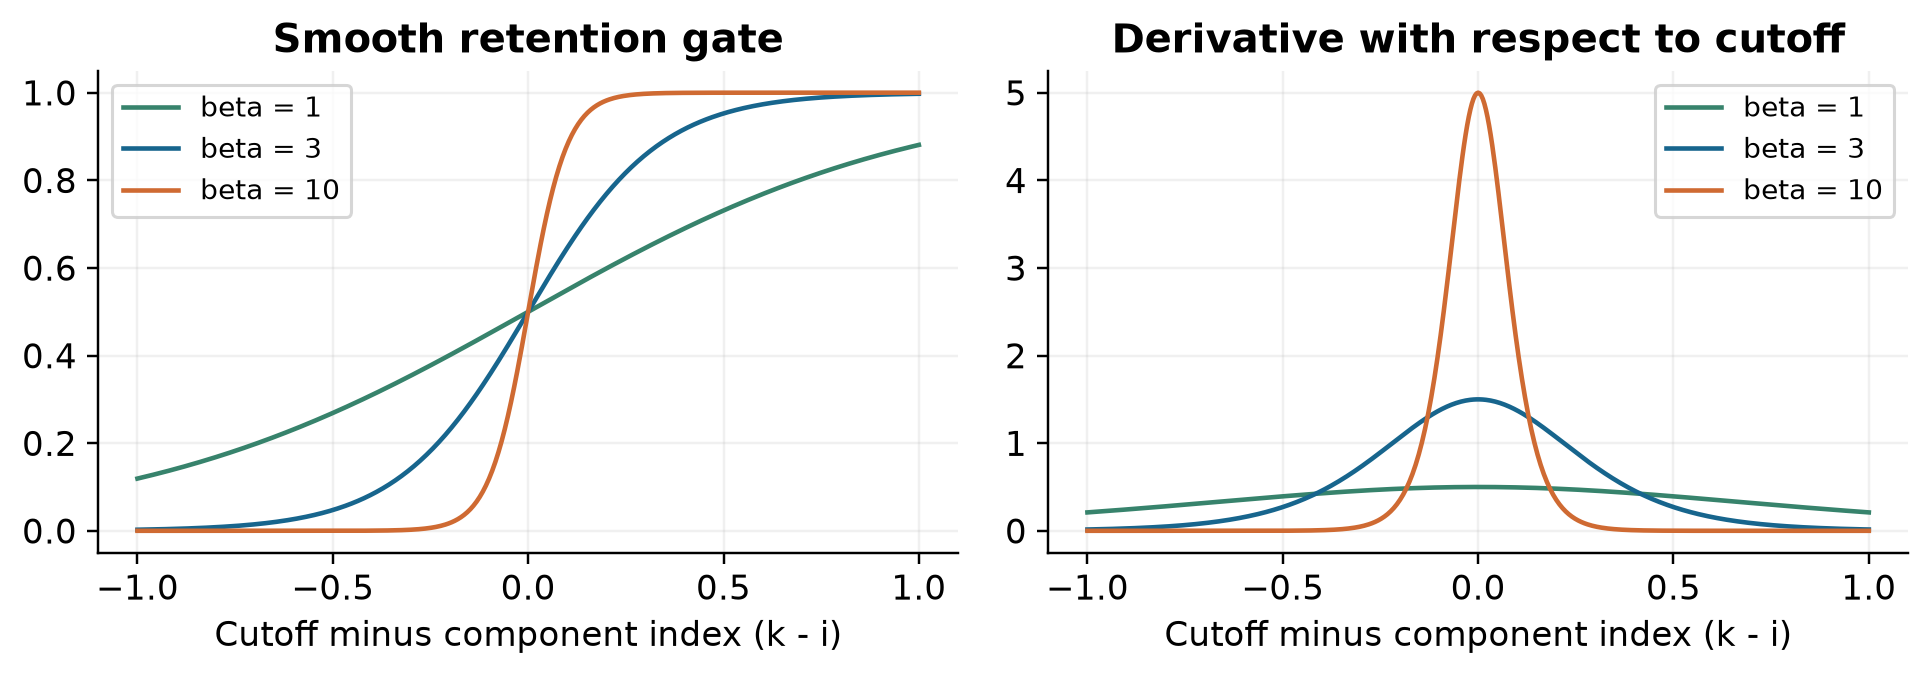
图 3:式(3)和式(4)的解析曲线。更陡的门更像离散截断,但有效梯度也集中到更窄的范围。不同颜色对应不同平滑强度。
这里的可学习性仍有结构限制。它学习的是排序后奇异谱的一条边界,不是让每个奇异方向独立决定保留与否。前面的分量仍然比后面的更容易保留。如果某个任务真正需要“留下一个较小但敏感的方向,删除一个较大但不重要的方向”,单一单调门并不能任意表达这种组合。
4.2 层与层之间怎样争取预算?
论文用任务损失加预算偏差的惩罚来训练:
这里我把预算惩罚系数写成 ,避免与论文稳定梯度时也使用的 混淆。一个是控制存储预算的强度,另一个出现在小奇异值的数值处理里,不能因为符号相同就把它们当成一个超参数。
如果还没有降低精度,第 个矩阵每多留一单位秩,因子元素数增加 。全局预算可以按这些实际增量加权,而不是简单平均各层秩。加入 remapping 后,还应改成对应的字节成本。不同形状的矩阵,同样增加一个秩,对存储的影响并不相同。
从资源分配角度看,一个层是否应该多拿一点秩,要看它带来的边际任务收益是否值得这份边际存储成本。统一秩或统一保留百分比,通常无法同时照顾到所有层的形状和敏感度。可微方法的吸引力在于,允许每个层根据端到端损失争取自己的预算。
但惩罚项不是硬约束。有限步优化、绝对值在目标附近的不光滑、连续 到整数秩的转换,都可能使最终结果偏离目标。真正输出压缩模型时,仍需要算清楚实际采用的整数秩和存储量。尤其是不同形状矩阵之间交换秩时,总秩不变不代表总字节数不变。
算法 1:可微秩分配的概念流程
输入:固定权重、校准数据、目标资源预算
1. 为每个待压缩矩阵设置连续截断位置 k。
2. 在每个校准批次上计算线性层激活。
3. 对选定激活做分解,用平滑门调整奇异值。
4. 将截断后的激活送入后续网络,得到任务损失。
5. 加上当前表示成本相对目标预算的惩罚。
6. 沿激活路径反向传播,只更新各矩阵的秩控制量。
7. 训练结束后,得到满足部署预算的整数秩。
输出:每个矩阵的目标秩,供固定权重恢复使用
这是对论文思路的概括。最后一步把整数秩的预算检查明确写出来,是实际构造固定因子必须面对的问题,不表示原文已经给出了完整的预算修正算法。连续门所在的模型只是中间表示,它与最后部署的模型还有一段距离。
4.3 少量可训练参数,也可以对应不少计算
论文对 LLaMA-7B 提到 224 个可训练秩参数,以及八个 GPU 小时的训练表述。附录 A.3 给出 256 个 WikiText-2 样本,每个 2,048 token,batch size 32,320 个 epoch,Adam 优化器、余弦调度和 0.1 的学习率。仅从这些设置就能看出,这是一项利用数据进行优化的压缩过程。
更准确的描述应当是:权重本身被冻结,秩被学习;之后的权重恢复不再需要额外权重微调。不能把后一句缩写成整条流程“无需训练”。与只收集一次统计量的压缩方法相比,应同时看压缩耗时、峰值内存、校准数据量和最终质量,而不只看有多少参数会进入优化器。
校准数据少也不等于泛化问题不存在。秩控制量虽然少,但它们决定的是一个大模型每层能通过多少信息。用一类文本优化出的瓶颈,可能刚好保住这类文本最需要的方向,却压缩了另一类任务需要的方向。后面 C4 的消融结果正好提醒我们注意这一点。
5. SVD 反向传播:稳定不等于处处精确
当两个奇异值很接近时,对应的奇异向量会变得难以单独确定。可以在几乎相同的二维子空间里旋转一小下,使各个向量变化很大,而整体子空间变化很小。把梯度写在这些单独向量上时,就容易出现奇异值间隔的倒数。
这不是简单地把优化器学习率调小就能消除的结构问题。对于两个正奇异值 ,先只讨论间隔倒数的正幅值:
当 时,可以用几何级数展开。只取有限项后,即使 趋近 1,也不会继续发散,而是趋近 。对不相等的奇异值,截断掉的尾项为:
这个式子把代价说得很清楚:有限项让接近碰撞时的响应受到限制,但此时它也不再等于精确的间隔倒数。这是一种有意识的近似。若两个奇异值本身都接近零, 仍然可能很大,因此还需要单独处理小值。论文讨论了阈值及特殊分支,附录列出的相关小值参数是 ,Taylor 项数为 10。
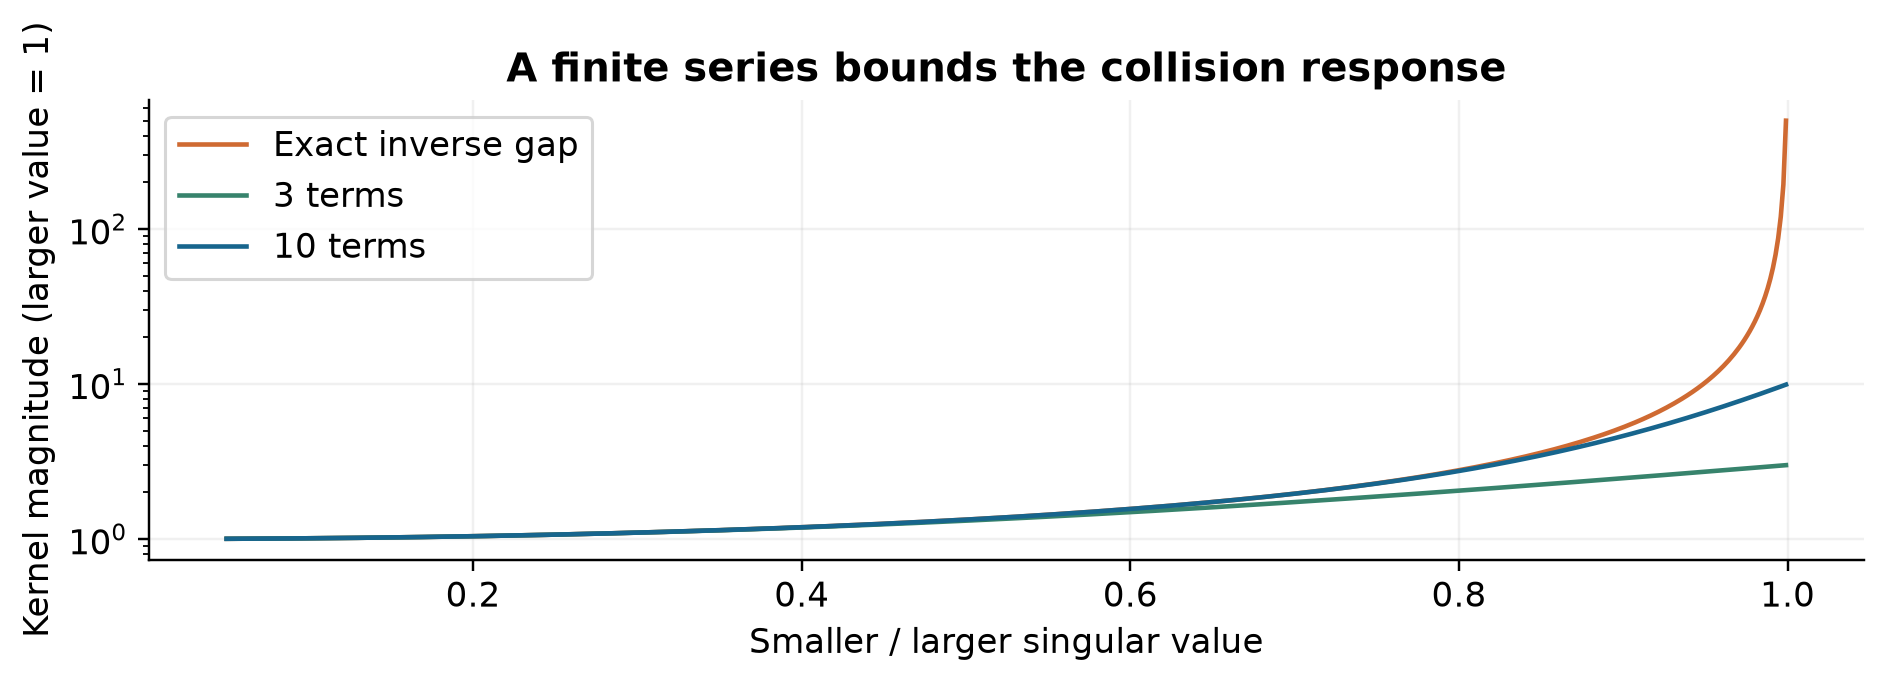
图 4:将较大奇异值归一化为 1 后的解析曲线。有限级数限制了谱碰撞附近的幅值,但不意味着重复奇异值处存在唯一、精确的奇异向量导数。
正文与附录算法使用了不同的展开形式,正文前后还出现了谱间隔符号方向的差异。上面的推导刻意只用正幅值,把收敛范围和截断误差说清楚。完整矩阵梯度还需要处理下标交换的反对称关系、矩形分解的正交补项,以及接近零时的特殊分支;不能把这段标量推导直接当成完整反向规则。
另一种思考方式是,尽量让目标依赖投影矩阵或整个谱函数,而不是依赖某一组可任意旋转的基。这样有时可以让重复子空间内部的旋转影响互相抵消,但截断边界上的秩变化仍需要处理。也可以改用离散搜索,避免对 SVD 求导,代价是评估多个候选模型。Dobi-SVD 选择可微路线,本质上是在用反向传播和分解成本,换取任务驱动的精细预算调整。
最值得记住的失败边界,是截断线恰好穿过一簇几乎相等的奇异值。此时轻微扰动就可能改变“最后一个被保留的向量”是谁。数值稳定可以帮助训练继续进行,却不能证明那个具体向量具有唯一的语义意义。解释结果时,更应关注子空间、预算和最终任务表现。
6. 多个输入,怎样汇成一组固定权重?
6.1 先区分三个相似但不同的目标
对第 批校准输入,保留的右奇异基记作 ,投影记作 。每批输入都能给出一个候选权重 。部署时需要共同使用 ,更直接的目标是:
它比较的是每批数据理想的截断激活,与共同权重在这批数据上实际产生的输出。把 去掉,度量就从输入相关的激活误差变成了权重误差;继续把 去掉,又变成了子空间之间的距离。这三步看上去都在比较“投影是否接近”,但坐标权重已经变了。
正文式(5)把矩阵写到范数外面,不能按通常的标量范数等式理解。一般来说, 不能写成 。附录 A.4.1 的论证转而从权重空间误差出发,用一个没有权重的投影误差上界来说明子空间汇总的合理性。后者可以明确写成:
6.2 子空间汇总与 PCA 的关系,可以推得很清楚
每个秩为 的正交投影都满足 ,而且迹为 。把平方范数展开后得到:
前面一项是常数,因此最小化误差,等价于在 列正交的条件下最大化最后那个迹。答案是 的前 个特征方向。若把各批基横向拼成 ,就有 ,因此也可以通过这个拼接矩阵的主要左奇异空间得到同样答案。这就是主要子空间估计与该代理目标之间的具体联系。
这个结论本身是干净的。它说的是:如果每批数据贡献一个秩为 的投影,我们可以找一个最能代表这些投影的共同子空间。它没有自动证明这个子空间能最小化原始激活误差,更没有直接证明它能最小化整网任务损失。
6.3 上界的最优解,不一定是原问题的最优解
由矩阵范数的次乘性,可以得到一个有效上界:
论文使用 Frobenius 范数形式的上界,也可以成立,只是可能更松。问题在于,无论采用哪一种,最小化右边都不必最小化左边。上界可以指导设计,但除非进一步证明界是紧的、或两个目标有相同的最优结构,否则不能直接把最优性传递过去。
可以用一个三维秩一例子精确说明。令 。七个候选子空间中,两个沿第一坐标轴,三个沿第二坐标轴,两个沿第三坐标轴。不带权重的投影距离会选第二轴,因为它出现最多;保留第一、第二、第三轴时,总代价分别是 10、8、10。
但乘上这个 后,权重空间误差分别变成 55、62、82,第一轴反而更好。这不是只挑三个候选碰巧比较出来的:对任何单位方向 ,两个目标可以分别写成 和 。三个平方系数的和权重为 1,因此各自最小系数对应的轴就是全局最优,确实选出了不同方向。
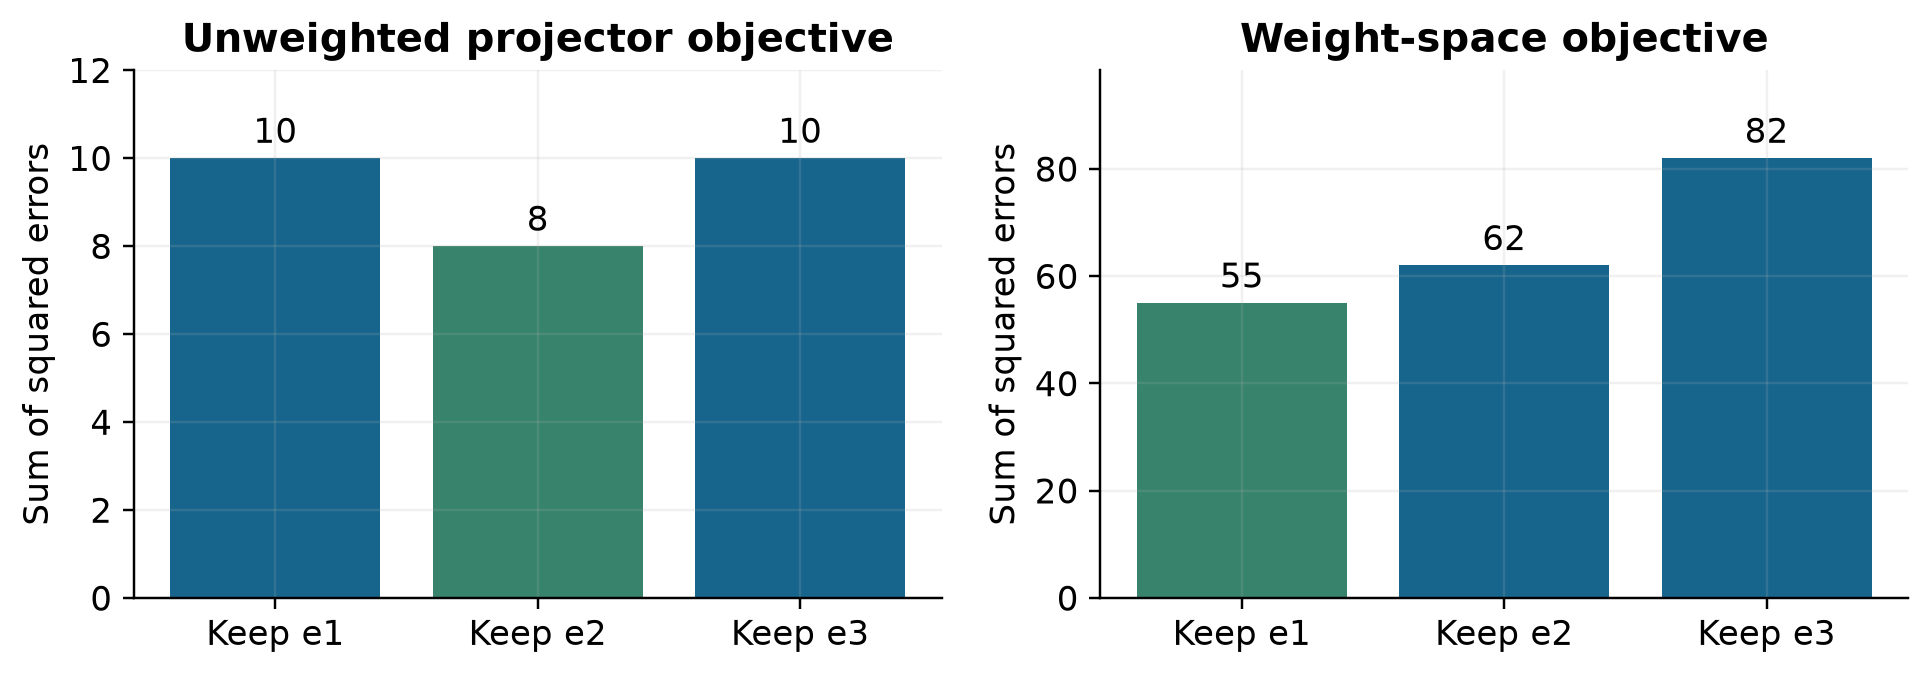
图 5:原创三维反例,七个秩一投影的出现次数为 2、3、2。左图是不带权重的投影误差,右图是权重空间误差。两者最优方向不同;这不是对某个语言模型的实测结论。
这个例子不是在证明论文的方法一定失败,而是在限定它能够声称的理论保证。代理目标可能很好用,甚至在模型上表现很好;但“很好的代理”与“原问题的精确解”是两种不同结论。把这一点分开,后面的实验才有正确的位置。
6.4 增量 PCA 解决内存问题,也增加了近似边界
保存所有校准子空间会占内存,因此论文采用增量 PCA 的思路:用一个有限大小的摘要代表目前见过的主要方向,再与新批次的信息合并、分解、截断。这样无需一直存着所有历史样本。摘要大小主要与特征维度和保留秩有关,而不再直接与样本总数成比例。
这不意味着内存与矩阵维度无关。存一个稠密协方差通常随特征维度平方增长;存一个薄基通常随特征维度乘保留秩增长。两者都是实在的成本。论文图里 PCA 内存增长很快、IPCA 比较平,并不足以推出一般性的“指数复杂度对常数复杂度”结论。
正文、算法 2 与附录对流式汇总的描述还留下了需要区分的数学细节:流入的是投影后的权重还是奇异基?中心化作用于哪个对象?中间摘要是否保留奇异值幅度?拼接的方向是什么?这些选择都会改变代理目标或近似程度。尤其是基可以翻转符号、也可以在同一子空间里旋转;投影 对此不变,直接对基的坐标中心化却未必不变。
算法 2:固定权重恢复的概念流程
输入:原权重 W、目标秩 k、多批校准激活
1. 为每批激活提取保留的右侧子空间。
2. 用有限大小的摘要汇总这些主要方向。
3. 从摘要中取得共同的 k 维正交基 V。
4. 构造 B = W V,以及 C = V 的转置。
5. 将部署层写成 X -> (X B) C。
6. 用未参与拟合的数据评估这组固定因子。
输出:不需要逐请求做 SVD 的固定低秩层
这段伪代码刻意不替原文补写未充分明确的增量细节。精确求解 的主要特征空间,可以解式(9);流式过程中反复截断,可能偏离这个精确解;即使式(9)解得完全准确,它与式(8)之间仍有代理目标的差别。两层近似需要分别理解。
7. Remapping 到底突破了什么限制?
7.1 两个因子本来就有存储开销
对一个 的矩阵,保持相同数值精度,用两个低秩因子需要存 个元素。相对原矩阵,存储保留比例为:
如果矩阵是 的方阵,这个比例就是 。保留一半秩时,两个因子的元素数刚好与原矩阵一样多;要真正省元素,就必须低于一半秩。这个限制来自当前表示方式的成本,不是信息论意义上任何编码都无法越过的墙。改变精度、共享结构或改变表示形式,都可能改变这笔账。
Dobi-SVD 选择降低部分因子的精度。设 ,把恢复后的秩 权重分成 和右因子转置 。原来都是 16-bit;现在把 的前 行和整个 改为 8-bit, 剩下的 行仍保留 16-bit。暂不计 scale 等元数据时:
另一种长宽方向对称处理,因此统一写成 。直观上,两块 8-bit 数据在字节预算上合起来相当于一块 16-bit 数据,但它们仍是两组需要分别解释和反量化的数值。这里没有把两个任意的 16-bit 数无损塞进一个 16-bit 数。
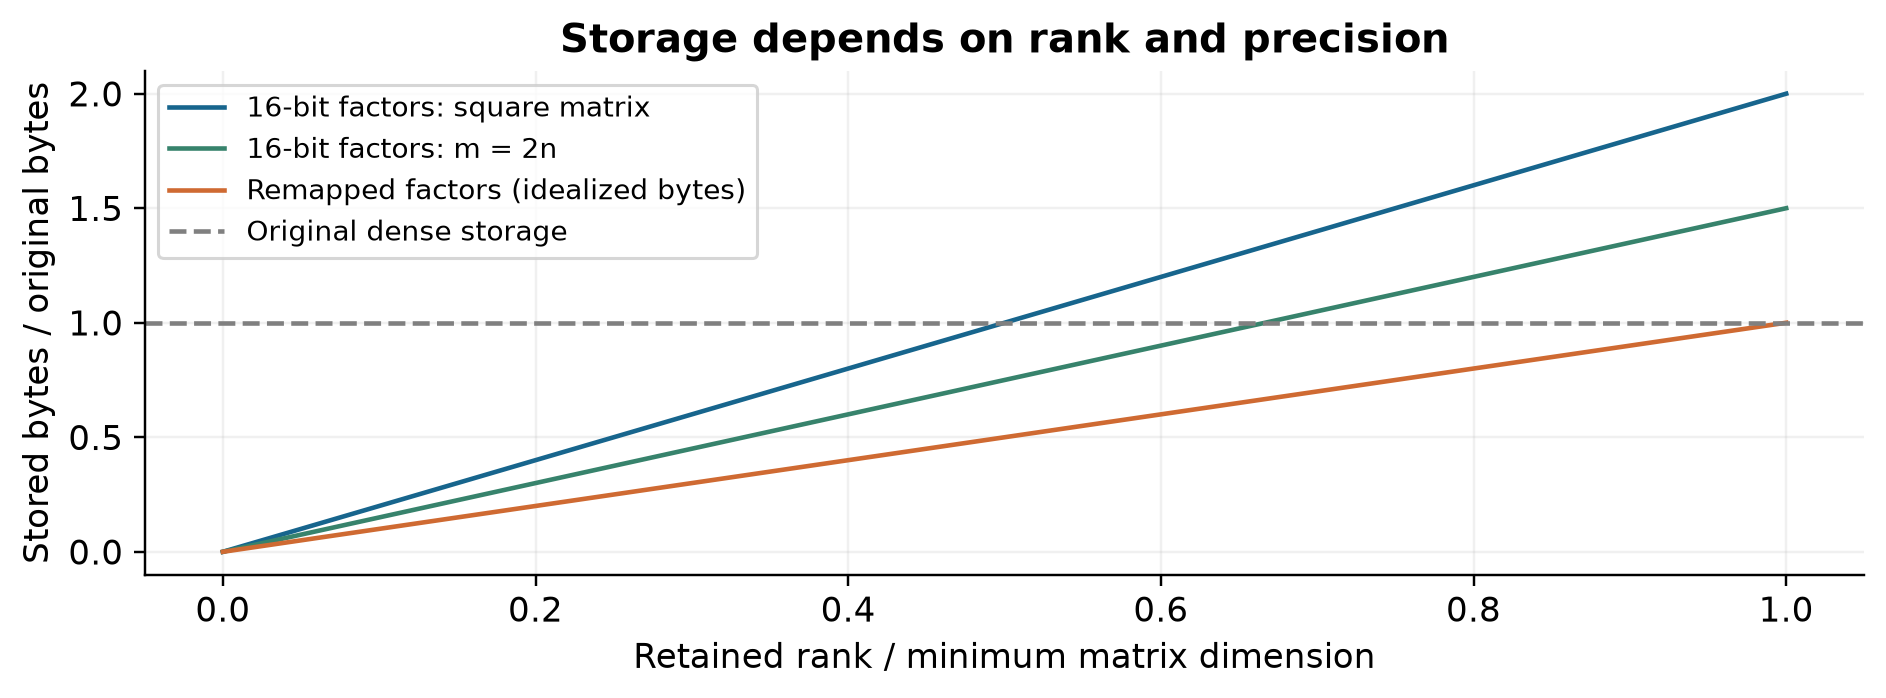
图 6:根据式(12)和式(13)绘制的解析存储曲线,未计量化元数据。同一字节预算允许 remapping 保留更多秩,原因是部分因子的数值精度降低了。
以 方阵为例,名义 0.4 的字节保留比例下,两个 16-bit 因子只能保留大约 819 个方向;理想化的 remapping 账本允许保留约 1,638 个方向。实际整数取整会使比例略有偏差。这是一笔很明确的交换:方向数约翻倍,代价是量化误差和相应的表示处理。
当删除方向的损失明显大于保留方向后的小幅数值扰动时,这种交换可能很划算。但不能仅看到“秩更多”就得出更好的结论。如果量化误差经过另一因子放大,或者被量化区域恰好包含敏感方向,更多秩也未必能补偿。需要在固定秩和固定字节两个坐标下分别做比较。
7.2 存储更小,计算量却不一定更少
因子怎样打包,并不会自动减少它们包含的数学乘法。对每个 token,两次稠密因子乘法的主要工作量仍与 成比例。把 remapping 的秩规则代入,可得到:
分子和分母分别表示因子乘法与稠密乘法的主要工作量。对方阵,这就是 。如果字节保留比例为 0.8,因子形式的线性映射反而可能需要约 1.6 倍的主要算术操作。这个式子没有计入注意力、归一化、矩阵乘法利用率和精度转换,因此不能直接拿来预测整网速度。它只说明,存储节省与算术节省并不是一回事。
论文表 23 恰好提供了一个提醒:Dobi 0.8 的 GFLOPs 是 33.94,而表中量化稠密模型的数值是 29.30。即便如此,某个实际系统仍可能更快,因为内存搬运、驻留条件和采用的计算内核不同。那需要由真实系统测量支持,不能从压缩比例公式直接推出。
算法 3:m 不小于 n 时的混合精度存储
输入:秩 k 的近似权重,以及 8-bit 量化器
1. 将近似权重分为 B V^T,形状分别为 m×k 和 n×k。
2. 把 B 的前 n 行量化为 8-bit,保留所需 scale 元数据。
3. 把 V 的全部元素量化为 8-bit,并保留相应元数据。
4. B 剩余的 m-n 行继续用 16-bit 保存。
5. 按组合字节预算存放两块 n×k 的量化数据。
6. 在实际线性运算所需的位置恢复因子的数值含义。
输出:混合精度因子表示,而不是一个稠密 16-bit 权重
附录给出的 remapping 使用 bitsandbytes 8-bit 量化。这里把数值本身、存储编码和矩阵运算分开描述,是为了避免从一个打包布局,直接推断某种特定推理路径一定很快。实际运行时可能需要转换、缓冲区,甚至暂时展开部分表示,这些都会影响峰值内存和时间。
7.3 正交不意味着元素必然服从正态分布
论文用集中、近似正态的因子直方图解释量化为什么容易。那些图是关于所观察因子的经验证据。但正交本身推不出元素服从正态分布:单位矩阵就是一个非常简单的反例。再者,把 乘上 后,各列幅值也会变化,不能只凭原始正交性判断每块因子的量化难度。
量化误差还会在因子乘法里互相作用。若两个因子分别有扰动 、:
一个因子里的元素均方误差很小,当然是好迹象,但它的作用还会被另一因子放大或削弱,之后又要乘上实际输入。因子误差、权重重建误差、激活误差、任务损失,是一条不同量组成的链。不能在链条第一环测到小误差,就直接宣布最后的任务损失也可忽略。
从设计选择看,固定取前若干行来降低精度,优点是结构简单、账本清楚;局限是行号本身未必代表任务敏感度。如果未来想改进,可以研究在相同打包成本下,选择哪些区域更适合低精度。但这种方案会引入选择开销和不规则存储,未必能保留原方案的简单性。
8. 实验结果该怎样读,才不会混用配置?
8.1 先固定以表 2 为数字依据
表 2 的对象是 LLaMA-7B,包含不做 remapping 的 Dobi-SVD* 和完整方法。下面只摘录这个表里的数字,不把摘要或正文中不同的数值替换进来。
| 保留比例 | 方法 | WikiText-2 PPL | C4 PPL | 平均任务准确率 |
|---|---|---|---|---|
| 1.0 | 原模型 | 5.68 | 7.34 | 0.52 |
| 0.8 | Dobi,无 remapping | 8.54 | 10.01 | 0.46 |
| 0.8 | Dobi,完整方法 | 6.08 | 7.83 | 0.50 |
| 0.6 | Dobi,无 remapping | 13.54 | 23.54 | 0.38 |
| 0.6 | Dobi,完整方法 | 8.12 | 12.63 | 0.47 |
| 0.4 | Dobi,无 remapping | 46.18 | 190.62 | 0.32 |
| 0.4 | Dobi,完整方法 | 9.95 | 17.94 | 0.40 |
完整方法在同一名义存储比例下,比无 remapping 的版本明显更好,尤其是 0.4 的位置。但它的平均准确率仍从原模型的 0.52 降到了 0.40,绝对下降 12 个百分点,相对下降约 23.1%。WikiText-2 PPL 相对 5.68 也增加了约 75.2%。所以“比其他低秩压缩方法强”与“几乎不损失原模型能力”,在这里必须分开说。
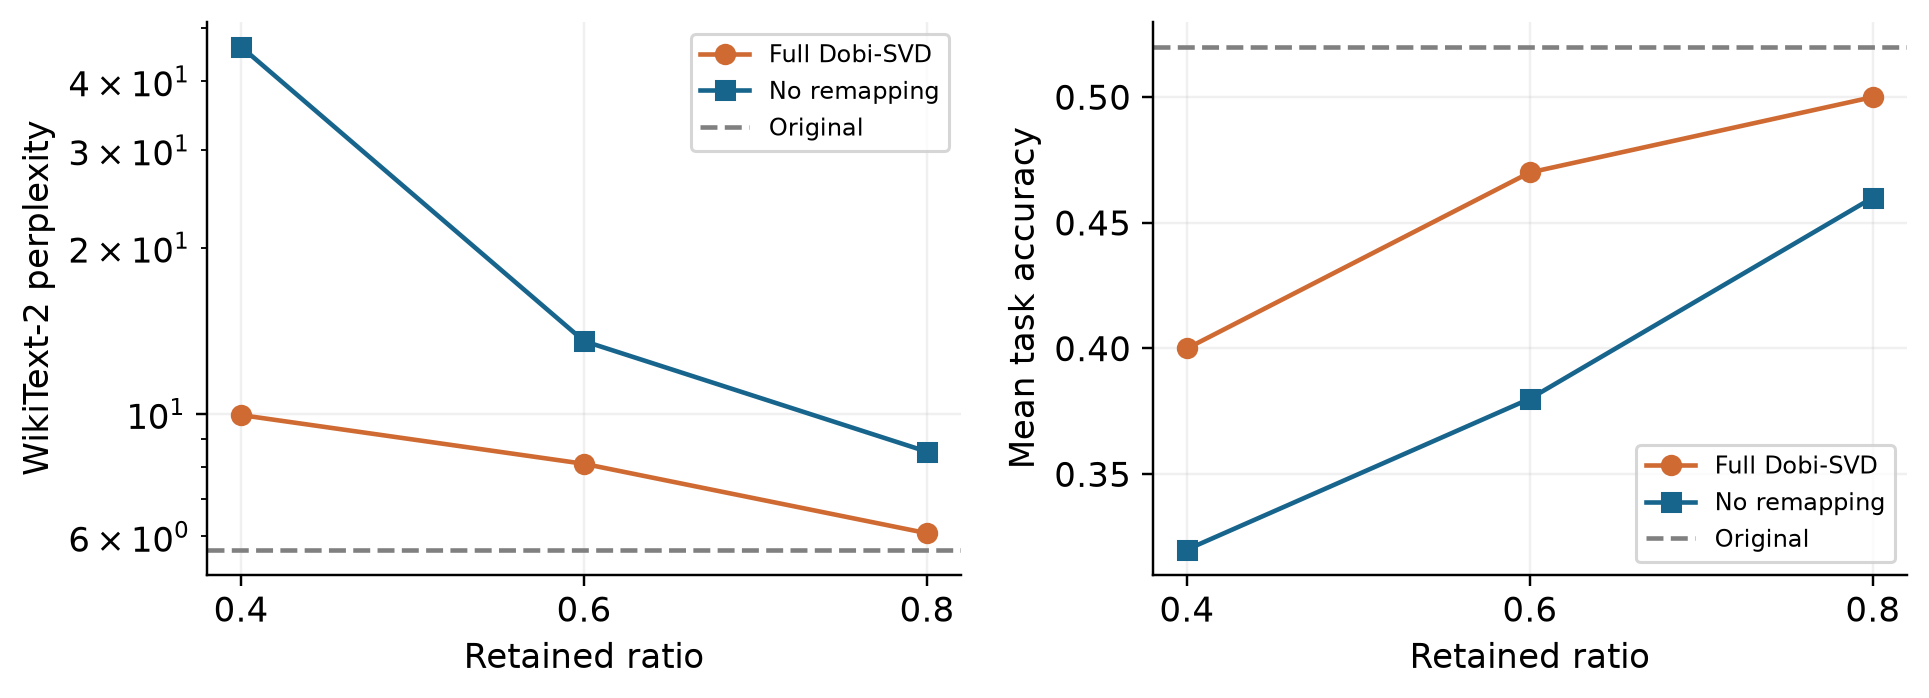
图 7:重绘自 arXiv:2502.02723v1 表 2。加入 remapping 的组合效果很明显,但激进预算下与原模型的质量差距仍然存在。PPL 越低越好,准确率越高越好。
这篇论文有一个不能略过的数字冲突:摘要和引言给出的 0.4 下 WikiText-2 PPL 是 9.07,4.1 节写成 9.70,表 2 与结论则是 9.95。附近基线数字也有正文和表格不一致的情形。单凭文档不能确定哪一个对应作者最终想表达的实验。因此本文的表格和曲线统一采用表 2,并保留这个冲突,不自行平均,也不挑最漂亮的那个。
对我而言,这不是为了列举排版错误,而是为了保持结论可追溯。如果一个读者拿这篇博客去和后续论文比较,至少应当知道 9.95 来自哪个表,而不是得到一个混合多个版本、看似精确的“统一结果”。
8.2 学习秩有帮助,但不是每个语料都变好
表 16 在不做 remapping 时,比较统一截断位置与可微训练得到的截断位置。0.4 下,WikiText-2 从 58.02 改善到 46.18,PTB 从 270.16 改善到 238.91;但 C4 从 145.41 变成 190.62,反而更差。这与附近“各数据集持续改善”的概括并不完全一致。
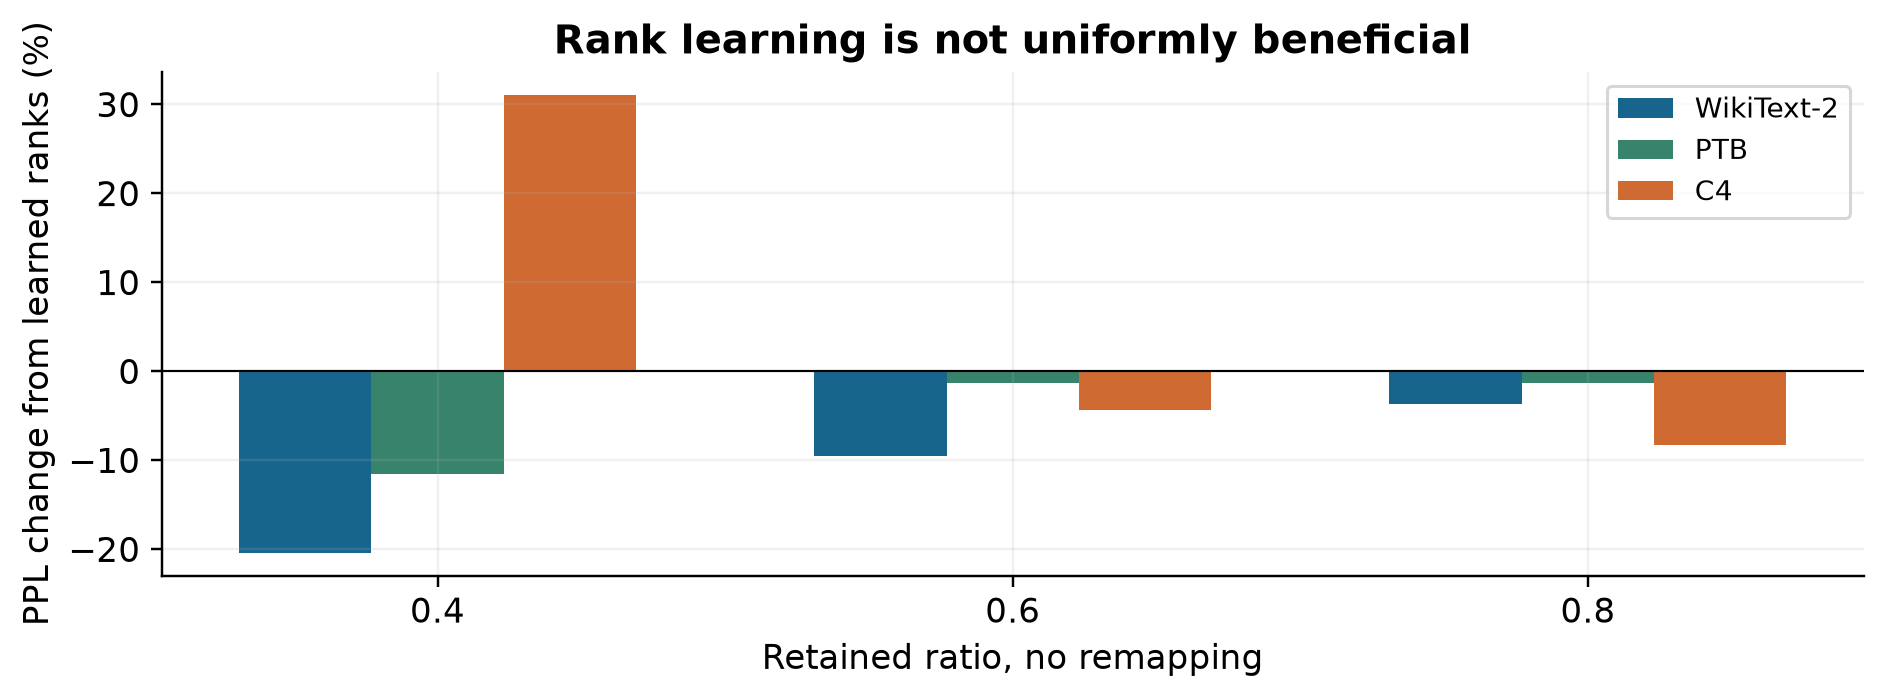
图 8:根据表 16 计算学习秩后的相对 PPL 变化,负值表示改善。0.4 保留比例下,C4 的方向与另外两个语料相反。原始数值和计算来源已单独保存。
这与校准目标偏向其数据分布的情况相容,但仅凭这个表不能证明具体原因就是过拟合。还可能存在其他实验设置差别。可以确定的结论是:由任务损失驱动的预算分配,需要在提供梯度的数据之外继续评估。只学习几百个标量,也可能让大模型的信息瓶颈偏向一个有限任务。
表 8 则有另一种有价值的对照。在相同的 remapped 秩下,比较全精度因子和混合精度因子,0.4 下 WikiText-2 PPL 分别是 9.78 和 9.95。这个对照主要说明该设置下量化损失不大。它与“完整方法对低秩、同字节预算方法”的比较不是一回事:后者同时改变了秩和精度,不能把全部收益归给秩分配算法。
因此,理想的实验至少需要两条横轴。一条固定秩,观察精度变化带来的损失;另一条固定真实字节数,观察多保留方向是否值得降低精度。两条轴各自回答一个问题,不能靠一张压缩率表全部替代。
8.3 更难的能力评测,会给出不同的可用边界
表 6 给出 LLaMA-2-7B 和 LLaMA-3.1-8B 的 MMLU。原始分数是 41.0、63.3;保留 0.8 时是 38.6、60.1;保留 0.6 时是 27.5、50.1;保留 0.4 时是 24.1、28.2。特别是后一个模型,最激进设置下下降了 35.1 分。
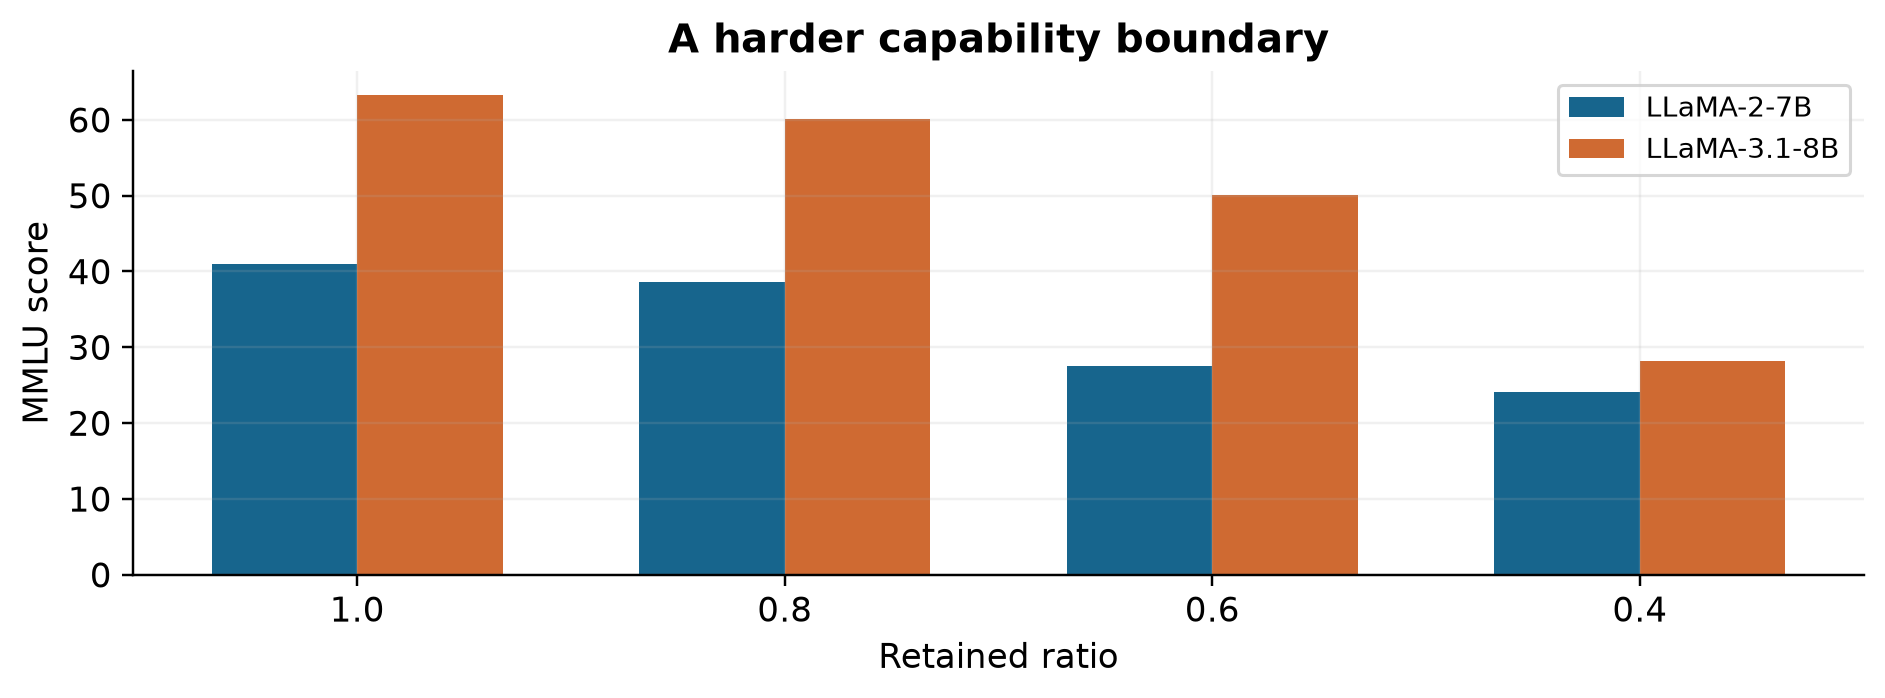
图 9:重绘自论文表 6。模型能接受多大压缩,取决于目标能力的质量门槛;单一困惑度指标不足以代表所有部署用途。
这些分数提醒我们,压缩算法之间的相对领先,不会自动抵消相对原模型的绝对能力损失。对一个只需要局部语言预测的应用,可以接受的比例,未必适合依赖更广知识和推理能力的应用。所谓“可用压缩率”应该由任务门槛决定,而不是由一条看起来平滑的 PPL 曲线决定。
附录还扩展到 13B 模型,并展示了一些生成样例。这些样例有助于确认模型还能生成语言,但少量挑选的回答不是成功率估计。它们不能替代对长文本连贯性、工具调用可靠性、代码正确率或事实性的系统评估。若要说明生成能力被保留,仍需明确采样方法、题目集合和评价规则。
9. 为什么有时加速十几倍,有时只有几十个百分点?
9.1 Titan Xp 的关键是跨过了显存驻留边界
表 10 在 12GB Titan Xp 上报告:原模型 2.09 token/s,保留比例 0.4 时达到 25.97 token/s,约 12.4 倍。正文明确解释,原模型需要在 CPU 与 GPU 之间搬运数据,而压缩后模型可以全部放进 GPU。这个收益对实际使用很有价值,但它比较的是两个不同的内存驻留状态。
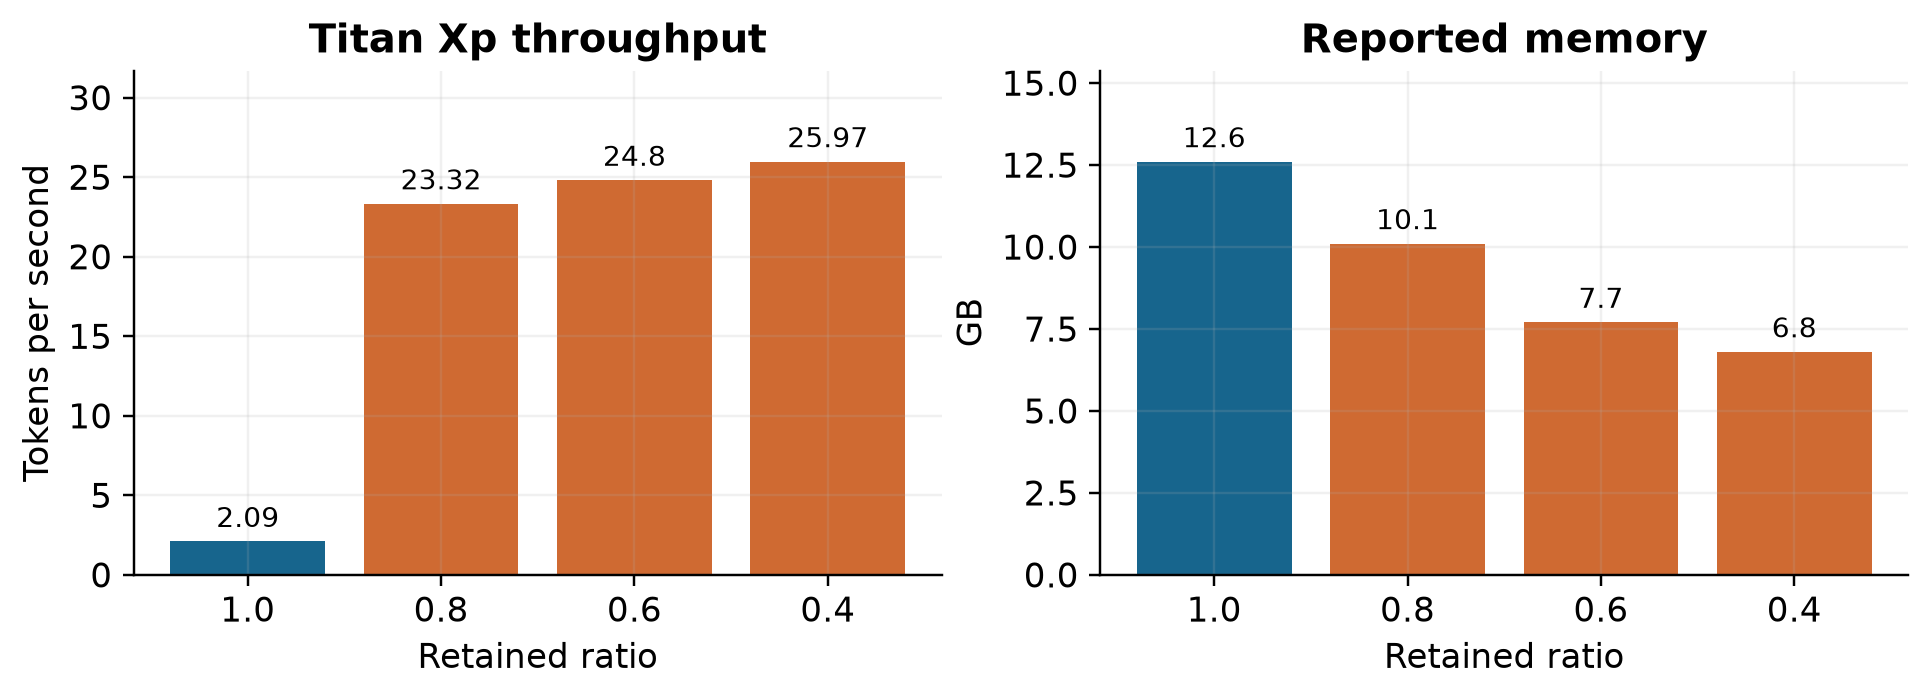
图 10:重绘自论文表 10。大幅加速包含避免 CPU–GPU 数据搬运的收益,不能理解成全驻留稠密模型上的算术计算直接加速了十二倍。
可以用一个简单的时间分解理解它:
当权重终于能全部放进设备时,第二项可能突然下降,而不是平滑下降。计算项随秩变化,精度转换还可能带来额外成本。这个式子只是解释性的记账方式,没有用论文数据拟合,也不是一个能直接预测吞吐量的模型。它说明同一压缩方案换到另一张卡上,收益为何可能完全不同。
内存数据本身也有口径问题。正文提到原模型大约需要 14.8GB,表 10 的原模型行却列 12.6GB。在不知道两者分别包含哪些缓冲区、权重或缓存时,不应把任一个直接写成精确峰值显存。可以引用作者明确给出的 offloading 解释,但不应自行补全一个文档没有提供的一致内存账本。
9.2 A100 的结果应当单独理解
原论文图 4 在 A100 上改变 batch size 和序列长度。对应的 4.3 节描述,保留比例 0.4 时最高约 1.75 倍,0.6 时最高约 1.4 倍。这比 Titan Xp 的数字温和得多,也符合预期:如果稠密模型原本就能完全驻留,压缩就没有同样巨大的主机传输瓶颈可以消除。
吞吐量还不等于单请求时延。增加批量可能提高矩阵运算利用率,也可能增加排队;短上下文更容易突出权重读取成本,长上下文则会让注意力与 KV cache 成本变得显著。因此,引用速度时最好同时写明 batch、提示长度、生成长度、精度和驻留方式。离开这些条件,一个倍数很难迁移到另一套服务系统。
低秩因子还会改变矩阵形状。理论上少做一些乘加,不代表每次运算都能同样充分利用 GPU。过瘦的中间维度、额外的 kernel 启动、临时激活写回,都可能吞掉收益。反过来,某些批量下的规则矩阵形状可能很好地利用现有矩阵乘法。这些都是需要实测的系统因素,不能单靠 rank 推断。
9.3 与量化组合时,引用完整的一行结果
论文表 9 中,0.6 的 Dobi 加 GPTQ 对应 2.4GB、PPL 9.97;其他位置有不同的大小描述。最稳妥的引用方式是把模型、比例、方法、内存和质量从同一行取出,并注明表号,而不是把正文的大小与另一张表的质量拼起来。
表 23 的比较也有明确范围:它采用特定的 Hugging Face/bitsandbytes 设置,正文讨论了避开经过特殊 kernel 优化的量化基线。这个实验可以说明那套运行条件下的差别,却不能证明所有低比特部署都比 Dobi 慢。不同优化成熟度的后端之间,速度差有时更多反映运行库,而不是表示本身的上限。
从部署决策看,真正的问题应当是:在当前硬件和任务质量门槛下,哪种表示的内存、吞吐量和延迟组合更合适。低秩和量化不是只能二选一的阵营,Dobi-SVD 恰恰说明两者可以合作,只是合作以后更需要统一账本。
10. 多模态扩展说明了什么?
论文把方法应用到 LLaVA-v1.5 和 OpenVLA 的语言模块。这个扩展合理,因为大规模线性映射在这些系统里仍占重要资源。但它压缩的是其中一部分,不能直接推论所有视觉编码器、动作头或跨模态接口也同样适合这套秩规则。
LLaVA 在保留比例 0.4 时,表 11 的 POPE-random 从 88.1 变成 89.8,看起来还有改善;但 Science QA 从 70.22 降到 52.38,TextQA 从 58.22 降到 46.72。表中的平均值也与显示出来的各列简单算术平均不完全一致,所以这里以具体任务列为准,不据此构造新的总平均结论。
一个与幻觉相关的任务分数较好,不代表整个多模态能力都几乎无损。表 12 的相同压缩设置,在 batch 16 下报告约 20.1% 的吞吐量改善;这个速度收益需要连同具体任务的质量变化一起看。部署时如果最关心的是 Science QA,就不能只用 POPE 的变化来解释这项交易。
OpenVLA 的表 13 报告坐标和角度均方误差,以及开合动作的准确率。保留比例 0.4 时,准确率从 0.9570 降为 0.9297,角度 MSE 从 0.2929 变成 0.3132。这些是离线动作预测指标,不能写成机器人闭环任务成功率为 92.97%。平均误差小,也不代表没有少量大的失误;连续执行时误差还可能逐步累积。
其速度从 3.97 变为 4.67 tasks/s,约提升 17.6%。这个量应当保持论文评测中的任务单位含义,不能自行扩展成真实机器人完成整项任务的速度。要证明闭环部署效果,需要额外的环境、任务、交互和成功判定定义。
10.1 把替代方案放在同一张决策表里
| 设计选择 | 为什么有吸引力 | 主要边界 |
|---|---|---|
| 直接权重 SVD | 简单,不依赖校准数据 | 忽略输入几何 |
| 输入白化后的低秩重建 | 直接关联激活误差 | 协方差条件数与分布变化 |
| 可微秩分配 | 用端到端损失调整预算 | 反向传播与重复分解成本 |
| 离散秩搜索 | 避免 SVD 导数 | 候选评估成本与搜索粒度 |
| 混合精度低秩因子 | 用位宽换更多保留方向 | 量化误差和表示转换 |
| 稠密权重量化 | 保留完整矩阵秩 | 极低位宽误差与硬件支持 |
这些方案不是完全互斥的。白化可以与非均匀秩结合,低秩可以与量化结合,某些层也可以保持原样。真正有意义的比较是:一组具体的秩、精度和执行方式,能否在相同真实资源预算下满足质量门槛。Dobi-SVD 的贡献之一,就是让这个联合设计问题变得更明显。
在选择替代方案时,还应考虑压缩结果的使用期限。如果压缩只做一次、模型要服务很久,可以接受较重的离线优化;如果模型频繁更新,或者需要针对许多不同设备快速生成版本,压缩时间本身就可能成为关键资源。论文只训练少数秩参数这一点很有价值,但不能独立回答这种生命周期层面的成本问题。
11. 局限与失败边界
第一,校准既是计算成本,也是统计假设。 学到的截断位置和共享子空间,都由采样数据决定。代码、多语言、长上下文代理使用的方向,可能在 WikiText-2 里很少出现。表 16 的 C4 例外让这个风险有了具体迹象,但没有证明唯一原因。更丰富的校准数据和独立任务上的质量门槛,都比“可训练参数很少”更能说明泛化是否可靠。
第二,共享子空间恢复又引入了一层近似。 每批数据的局部最优基携带了输入特定的信息。换成一个共同基,目标就变了;增量汇总时再次截断,还可能继续偏离精确聚合结果。因此,固定秩定理应当始终带着它对应的数据、度量和约束,不能只剩下一个没有范围的最优标签。
第三,字节预算是理想化的。 量化 scale、对齐、padding、未压缩的 embedding、临时缓冲区和 KV cache,都可能使整网内存不等于因子存储公式。文件大小、模型加载后的驻留内存、完整服务进程的峰值内存,是三个不同概念。压缩是否能让模型跨过某张卡的容量门槛,最后仍要以完整运行状态为准。
第四,稳定的梯度是一种数值策略。 有限级数在重复谱附近改变了反向信号,小值阈值又带来尺度依赖。这可能是有效且必要的工程选择,但不表示奇异向量原本的非唯一性消失。评价这种策略,应看优化是否稳定、是否收敛到有用的最终表示,而不是把它当成处处精确可微的证明。
第五,原文中的数值和叙述冲突限制了比较精度。 除了核心 PPL 的三个数值,消融表与“全部改善”的文字、部分内存描述、训练曲线横轴与列出的 epoch 数,也需要分别处理。这些问题并不使所有结果失效,但会限制哪些结论能精确复述。本文保留表号和单独的比较条件,没有把冲突自行拼成一个新实验。
第六,当前证据没有覆盖所有部署场景。 主要模型集中在特定的 7B–13B 家族,硬件、后端和上下文条件也有限。多模态动作指标不是闭环成功率,少量生成样例不是生成能力排行榜。合理结论是这些结果支持进一步研究和特定条件下的使用,而不是证明方法对所有模型、任务和硬件都稳定领先。
12. 独立批判性分析
12.1 最值得带走的是把决策拆开的能力
我最愿意从这篇论文带走的,不是某个单独的加速倍数,而是它把通常藏在“压缩率”里的决定拆开了:先明确重要信息在哪个激活空间里,再决定各层分多少秩,最后决定留下来的因子用多少位保存。这三个决定各自有目标、成本和失败方式。即使以后替换平滑门、增量方法或量化器,这个问题划分仍然有用。
Remapping 也解释了低秩论文之间为什么很容易出现难以解释的排名。同样写着 0.4,一个方法可能用低位宽保存较多方向,另一个方法用全精度保存较少方向。质量差距就可能主要来自表示预算,而不是某个子空间估计器更聪明。公平的消融需要固定秩的比较,也需要固定真实字节的比较,两者回答的问题不同。
如果进一步把推理运行时纳入,比较还会多一个轴:同样的表示,在不同后端可能需要不同的转换和缓冲。最终部署质量不是一个数学对象单独决定的,而是统计目标、数值表示与执行方式共同决定的。论文让我们看到了这三者可以协作,也暴露了它们被混在一起时会产生的解释困难。
12.2 理论链条里,最优性应该说得更窄
式(2)的局部等式很有用,也很准确。式(10)精确地刻画了一个不带权重的投影代理目标。但从这两个结果走到整网任务最优,不能只靠同一段代数继续顺推。尤其是,上界最小与原目标最小通常不是一回事。图 5 的构造例子说明,这不是措辞上的挑剔,而是数学上确实可能选出不同解。
附录 A.10 的模型级论证同样需要分清理论和实验。对激活扰动,局部损失变化可以用梯度内积近似:
误差范数更小,意味着这个上界更小,但不意味着实际内积一定更小。一个长度为 1、恰好沿损失梯度方向的误差,可能比一个更长、却与梯度垂直的误差造成更大的一级损失变化。这个简单例子已经足以说明,不能仅由 EYM 最小化重建范数,就推导出所有激活上的任务损失排序。
原文通过采样若干层和截断位置的实验支持激活截断,这些实验是有价值的经验依据。更恰当的表述应当是:在这些模型和采样配置里,激活截断通常表现更好。它与“对所有模型和输入都存在一个一般定理”之间,仍有一段不能省掉的距离。
12.3 最强的实用收益,未必来自最漂亮的算术公式
对真实用户而言,让一个模型终于能全部放进显卡,可能比理论 FLOPs 少一点更重要。Titan Xp 的结果在这个意义上很有价值。问题不是要贬低这种收益,而是要给它选对比较对象:另一种能够放进同一张卡的量化模型、一个原生更小的模型、其他混合表示,都可能是实际替代方案。
论文探索了其中一些方向,但并没有在所有维度上证明共同胜出。表 24 就给出一个值得认真读的例子:压缩后的 LLaMA-13B 平均准确率是 0.54,高于原生 7B 的 0.51;但 batch 1 吞吐量是 38.6 对 42.3,batch 8 是 283.2 对 319.5,速度反而较低。因此它体现的是质量与速度之间的交换,不是两方面同时占优。
表 25 换了另一组模型家族后,结果不同,也不能因此反推一个普遍结论。原生小模型和压缩大模型之间,还混有架构、预训练数据和训练预算差异。评估时应把“这个具体模型对这项任务更好”与“所有压缩大模型都优于原生小模型”分开。
12.4 哪些补充证据最能减少不确定性?
第一组有价值的研究,是把校准和评价任务明确分开,专门看学习到的秩能否保住生成能力,而不只优化同类文本的困惑度。它能回答我们到底学到了通用的瓶颈分配,还是某个语料的特定偏好。尤其是代码和长回答任务,错误不能总被一个平均 PPL 数字代表。
第二组,是在固定秩下比较精确聚合子空间、增量近似和输入加权恢复。这样能把“局部激活很好”与“共享权重不好”之间的损失单独测出来,而不是把全部差异归给最终压缩比例。还可以改变数据进入流式算法的顺序,判断中间截断是否使结果依赖顺序。
第三组,是让有无 remapping 的方案在完整字节账本和相同运行后端下比较,明确 scale、临时内存和转换时间。这能回答多保留的秩究竟带来多少质量,以及为这些秩降低精度后,实际系统付出了多少代价。只比较 checkpoint 大小或只比较理论因子个数,都不够。
这些是我根据论文提出的后续研究问题,并不是这次笔记已经完成的实验。它们的共同特点是每次只针对论证链里一个不确定的连接。相比不断增加更多混合条件下的榜单行,这样的研究更容易说明为什么一个方法好、为什么它在某些地方失效。
13. 结论
Dobi-SVD 最有启发性的地方,是把低秩压缩重新写成一个联合问题:信息应该在哪个空间里衡量、各层该分到多少方向、这些方向值得用多少位保存。单批激活到权重的投影恒等式给出了精确起点;可微截断让预算响应任务损失;混合精度让更多秩能够进入同一个存储预算。
这些设计组合起来,在论文所测的模型上取得了有竞争力的结果;当压缩使模型摆脱 CPU–GPU 搬运时,实际收益尤其显著。但共享恢复是代理问题,谱退化附近的梯度处理是近似,更小的存储也不保证每种配置都减少算术。某个 PPL 或任务上的优势,同样不能替代其他能力的评估。
把这些边界写清楚,并不会削弱论文的价值。恰恰相反,它让我们能更准确地复用其中的思路:保留真正成立的等式,理解每个近似为什么存在,再用匹配的实验判断这种近似是否值得。
参考资料与阅读范围
- Qinsi Wang, Jinghan Ke, Masayoshi Tomizuka, Yiran Chen, Kurt Keutzer, Chenfeng Xu:Dobi-SVD: Differentiable SVD for LLM Compression and Some New Perspectives,v1,2025-02-04。本笔记依据 30 页 PDF,含附录 A.1–A.10,作者名单也按这一 arXiv 版本记录。
- Dobi-SVD 作者项目页,用于定位论文及相关资源。
- Dobi-SVD 官方资源入口,供读者进一步查阅。
式(1)至式(17)统一了维度与符号,并在文中区分精确恒等式、解释性推导和论文使用的近似。图 1–6 是原创解析图,图 7–10 根据明确标注的论文表格重绘。本笔记未声称产生新的语言模型训练、性能测量或复现实验结果。