笔记日期: 2026-10-10
论文题名: DFlash: Block Diffusion for Flash Speculative Decoding
论文作者: Jian Chen、Yesheng Liang、Zhijian Liu
版本与日期: arXiv:2602.06036v2,2026-05-28;首次提交于 2026-02-05
资源: 论文、作者项目页、官方代码入口
阅读范围: 正文与附录共 13 页。实验数字统一采用 v2;文中的教学算例、补充推导和建议明确区别于作者实验。
1. 我最关心的问题:起草本身为什么也会成为瓶颈
推测解码通常被解释为“小模型先猜,大模型一次检查多个 token”。这个解释没有错,但容易把小模型的时间忽略掉。如果小模型也逐个生成 token,那么每轮推测仍然要先完成一串串行计算。为了提高接受率而把小模型做深,又会在每一个草稿位置重复支付新增的计算成本。
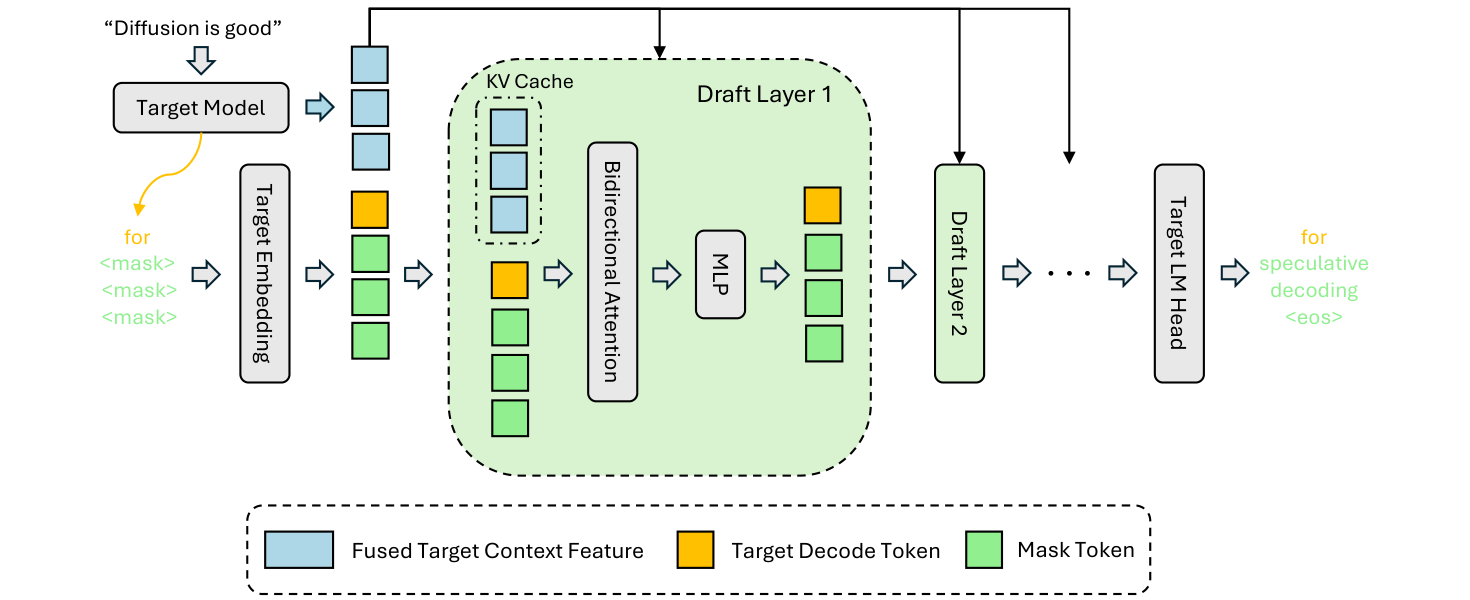
DFlash 处理的正是这个问题。它让一个较小的块扩散模型一次预测多个被遮住的位置,并把目标大模型的隐藏状态作为条件输入。草稿模型可以大胆地并行猜测;最终哪些 token 能交付,仍然由目标模型通过推测验证决定。草稿不需要独立达到目标模型的生成能力,关键是能否用足够低的成本给出一段容易被接受的前缀。
我把论文的方法拆成三个互相配合的设计。第一,草稿从逐 token 生成改成单次前向预测整个块,减少串行步骤。第二,目标模型的特征进入每一层草稿网络的 KV,而不是只在入口融合一次。第三,训练样本的形状与推测周期对齐:一个已经确定的干净 token,后面跟随一块 mask,并对靠前的位置赋予更大损失权重。
这种分工让扩散模型的角色很清楚。这里追求的不是“扩散语言模型全面替代自回归模型”,而是让它成为一种专门生成候选的模块。候选即使出错,只要验证与纠正机制成立,就主要损失时间,不必把错误直接交给用户。
不过,“最高约 6 倍加速”必须放回具体条件。论文表 1 中,Qwen3-8B 在 MATH-500、温度为零、Transformers 后端下达到 6.08 倍,七个任务的平均值是 4.86 倍,而 MT-Bench 为 2.75 倍。换到表 3 的 B200/SGLang 服务实验,同一 Qwen3-8B 在 Math500 上从并发 1 的 5.1 倍降到并发 32 的 2.8 倍。我认为这些差异比单个最大数字更值得读。
2. 前置知识:并行验证与并行生成是两回事
2.1 自回归模型为何可以一次检查多个候选
给定提示词 和输出序列 ,自回归目标模型把联合概率分解为
这个式子要求第 个 token 的分布依赖此前的 token,却不意味着在“所有候选都已经给出”的情况下,还要逐个运行模型。训练时的 teacher forcing 就是熟悉的例子:把完整序列送入带因果掩码的 Transformer,可以一次得到多个位置的条件分布。
正常生成的困难在于,我们事先不知道那些候选是什么。推测解码用一个便宜模型把它们先填上,于是大模型可以并行评估这些猜测。但如果某个早期猜测被拒绝,后面位置是在错误前缀下算出的,不能因为“后面的 token 看起来也合理”就继续保留。
这也是我理解推测解码时最先记住的一点:大模型一次计算了多个分布,并不代表这些分布都一定能转化成最终输出。真正有用的是从左到右连续存活的那一段。
2.2 为什么小批量推理适合这种办法
在小 batch 解码中,每次只生成很少几个 token,却需要搬运大量模型权重,GPU 的计算能力可能没有充分利用。把多个验证位置放在一次前向中,有机会更充分地利用硬件,从而摊薄每个最终输出 token 的开销。
但这里存在一个工作区间。验证更多位置仍然要付出矩阵乘法、注意力、词表投影和缓存操作的成本。如果服务已经靠大量并发请求把算力用满,新增推测位置就可能占用本来能服务其他请求的资源。因此,并行验证既可能带来显著收益,也可能在高负载下变得昂贵,不能把它当作免费操作。
2.3 DFlash 的扩散只做一步
看到“扩散”时,容易联想到反复去噪很多轮。DFlash 的草稿生成采用单次前向:输入块的首位是目标模型提供的干净 token,其余位置是 mask;模型对块内输入使用双向注意力,同时预测后续位置。
需要区分的是,双向注意力并不等于已经看到其他位置最终采样出的 token。例如第七个位置在计算隐藏表示时,第六个位置仍然是 mask。网络可以通过位置表示和上下文协调预测,却没有像自回归模型那样,明确条件化于刚刚抽出的第六个 token。这解释了它为什么快,也提示了长草稿的连贯性边界。
为避免符号混淆,本文用 表示包含干净首 token 的块大小,用 表示新提出的候选数量,用 表示训练损失的衰减尺度。原文的 在不同位置承担不同作用,我在笔记中把它们分开。块大小为 16,不等于每轮就能新接受 16 个草稿 token。
3. 接受长度:为什么前面一个错误比后面一个错误更贵
3.1 先把计数对象说清楚
设 为第一次拒绝之前连续通过的草稿 token 数量。暂时不考虑提前遇到结束符的边界,每轮还会得到一个目标模型的纠正 token,或者在全部候选通过时得到额外的 bonus token。因此,一轮的期望有效进展为
这个等式可以直接推出来。若 ,那么“至少接受一个”“至少接受两个”“至少接受三个”这三个指示量为一,其余为零,求和恰好得到 3。对一般的 也有 ,两边取期望即可。这里不需要假设各个位置独立。
这个表达式很有用,因为它把平均接受长度拆成了各段前缀存活的概率。第一个位置出错会让所有较长前缀失效;最后一个位置出错只影响最末端的一项。两个错误虽然都算一次 token 错误,对系统进度的影响却不相同。
3.2 一个简化算例
为了获得直觉,假设在前缀已经存活的条件下,下一个候选继续通过的概率总是 。这是教学假设,不是论文对真实接受率的建模。于是
当 、 时,结果约为 4.86;当 时,约为 8.15。也就是说,即使每一步看起来有相当高的通过概率,长前缀仍然会因为连乘而迅速变少。把块开得很长,并不能保证有相应长度的有效输出。
这个算例还说明,单看草稿的平均 token 准确率可能误判它的价值。假设两个草稿模型总共猜对的 token 数相同,但一个更容易在开头出错,另一个把错误集中在末尾,后者通常会产生更长的有效前缀。DFlash 对早期位置加权的训练动机,正是来自这种不对称性。
实际接受事件还受采样温度、任务类型和前缀内容影响。我们不能把某个平均值 代入几何级数,就当作真实工作负载的精确预测。更可靠的测量应包含接受前缀长度的分布,而不只是一个整体平均数。
4. 从接受长度走到真正的加速
4.1 一轮到底花了多少时间
把一轮草稿时间记为 ,验证时间记为 ,调度、缓存更新等额外开销记为 。若匹配条件下,目标模型普通自回归解码的单 token 时间为 ,则典型周期的平均单 token 延迟与加速比可写为
原文公式主要显式列出前两项。我在这里单独写出 ,是为了提醒自己不要把系统操作隐藏掉,这是笔记中的解释性扩展。若每轮长度和时间变化较大,实际统计应使用总时间除以总输出 token,而不是不加权地平均每一轮的比值。
再把三个时间分别除以 ,记为 ,就得到一个很直接的盈亏条件:
也就是说,一轮多带来的有效 token,必须足以覆盖这一轮相对于普通单步解码的总成本。接受长度变大只是分子增长;如果分母增长得更快,整体仍然变慢。
举一个没有测量含义的算例:若 ,三个归一化成本分别为 0.25、1.25、0.10,加速比就是 。如果扩大验证块后,验证成本从 1.25 上升到 2.0,而接受长度不变,加速比就降为约 2.55。这个算例比“猜得越多越好”更接近实际调参目标。
4.2 并行草稿改变了什么
自回归草稿生成一条长度为 的候选链,时间近似为 。DFlash 则用一次块前向,其时间更适合写为 ,分别依赖块长度、草稿深度、上下文长度和 batch。
在中等块大小、GPU 尚有并行余量的范围内,增加位置的边际延迟可以远小于增加一轮串行前向。这给了 DFlash 使用更深网络的空间。但我不会把它写成“计算复杂度与块大小无关”:更多位置仍然有实际运算,注意力和词表输出也不会凭空消失。
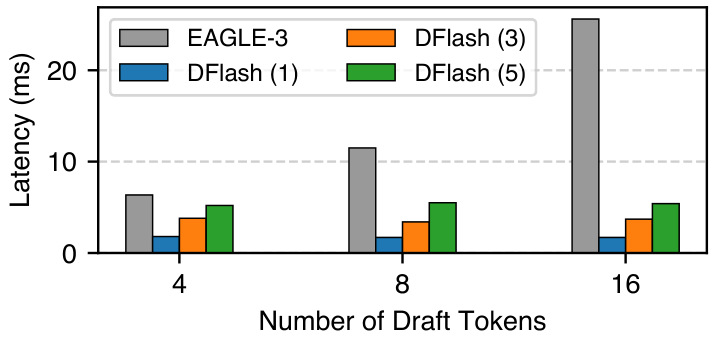
图 2 的重要之处在于,同样的时间预算可以重新分配。一个五层的并行草稿模型,可能比一个一层但需要反复串行运行的草稿模型更快。腾出的时间可以用于更强的表达能力,提高候选质量。不过这种交换不是没有上限,后面的深度消融已经显示,八层虽然接受得更多,却不一定比五层更快。
因此,我更愿意把不同草稿设计放到“总周期成本与接受长度”的二维图里比较,而不是先按准确率选最强模型,再补看运行时间。树形候选和线性块的预算含义也不同,相同的数字不自动意味着相同的验证工作量。
5. 草稿并不精确,为什么最终采样还能精确
5.1 贪心模式比较容易理解
温度为零时,目标模型对候选序列做一次因果前向,依次比较候选 token 与目标模型的 argmax。一直相同就保留;遇到第一次不同,就输出目标模型的选择,丢弃后续草稿。如果全部通过,则再由目标模型给出一个额外 token。
这里的关键是“连续相同”。后面的目标分布是在候选前缀下计算的,一旦前面某个 token 被替换,后面的那些分布就不能继续直接使用。只挑出所有看起来正确的位置拼起来,不是标准的推测验证。
在 tokenizer、logits 处理方式和并列最大值的处理一致时,这套前缀比较可以恢复目标模型的贪心序列。但温度大于零时,要求保持整个概率分布,就需要更仔细的接受与纠正机制。
5.2 非贪心模式要补回缺失的概率质量
下面推导的是 DFlash 所引用的标准推测采样原理,不是把一个新算法归给 DFlash。设当前已经确认的前缀下,目标分布为 ,草稿实际使用的提议分布为 。先从 抽取候选 ,再以如下概率接受:
因此,某个 token 通过草稿接受分支贡献的概率质量为 。如果 比目标分布多给了概率,就通过拒绝削掉多余部分;如果少给了概率,还需要在纠正分支补回来。
把缺失的总质量记为 ,拒绝后应从正残差归一化后的分布采样:
拒绝事件本身的概率就是 。于是两个分支加起来,最后输出 的概率为
当 时,不会发生拒绝,也就不需要计算残差分布。将这个论证沿着已经接受的前缀逐步应用,便得到自回归联合分布的保持。这里需要的不是草稿与目标一样强,而是验证器使用了与实际候选采样相符的提议概率。
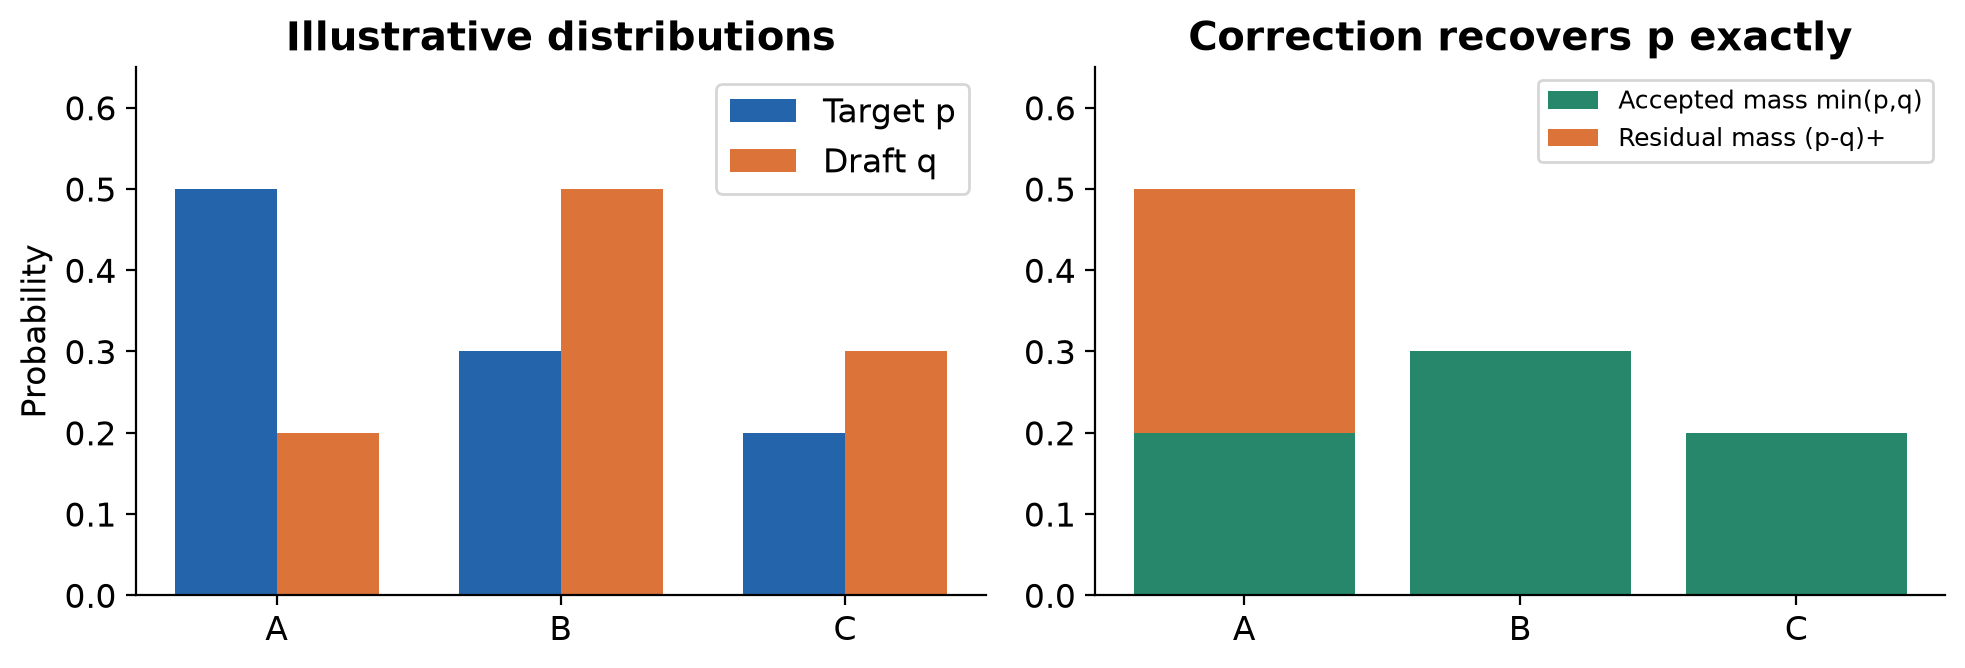
在图 3 中,接受分支总质量为 0.7,剩余的 0.3 全部应该补给 token A,所以发生拒绝时应当总是纠正为 A。如果拒绝后简单地再从原始目标分布抽一次,通常会形成错误的混合分布。这个小例子让我能明确区分“精确推测采样”和一般意义上的“先写草稿再修改”。
精确还不等于同一个随机种子下逐字相同。两种算法消耗随机数的顺序可能不同,但分布可以相同。它也不意味着目标模型会更少犯事实错误:保持的是目标模型原本的行为分布,而不是把它变成一个能力更强的模型。
算法 1:一个概念性的精确推测周期
输入:已确认前缀、合法目标特征、一个干净锚点 a
1. 构造 [a, MASK, ..., MASK],总块大小为 B。
2. 草稿模型前向一次,保存各位置实际提议分布 q_i。
3. 按照这些分布抽取 m = B - 1 个候选。
4. 目标模型对锚点与候选序列做因果前向验证。
5. 从左到右,仅在此前候选均通过时检查下一位置。
6. 贪心模式比较目标 argmax;采样模式使用接受概率。
7. 首次拒绝时,输出目标纠正 token;采样时用残差。
8. 丢弃被拒绝后缀,并只保留仍然有效的缓存。
9. 若候选全部通过,则从目标模型取得 bonus token。
10. 保存有效目标特征,以新锚点进入下一轮。
这段伪代码说明的是数学流程和数据依赖。需要特别区分“已经输出的 token”和“已经计算出隐藏状态的 token”。新抽出的纠正或 bonus token 虽然已经是干净锚点,但它自己的目标隐藏状态可能要等下一次目标前向才得到。不能把被拒绝后缀里的状态误当作新的合法上下文。
6. KV 注入:目标特征到底进入了哪里
6.1 先融合不同深度的目标表示
目标模型完成 prefill 后,除了给出首个输出 token,还可以提供上下文各位置的隐藏表示。DFlash 从若干目标层抽取特征,拼接后投影到草稿宽度。附录 A.3 的融合形式为
五组特征来自同一上下文的不同网络深度,不是五条未来答案。主设置在目标模型第二层到倒数第三层之间均匀选取五层。较浅与较深的表示可能提供不同信息,融合层把它们压到草稿网络能够使用的表示空间。
从直觉上讲,草稿模型不再独自从原始 token 重建整个任务。它得到的是目标模型已经加工过的上下文信息,可以把有限容量更多地用于预测接下来的短块。但“目标特征包含未来信息”应理解为包含预测未来的线索,不能理解成看到了真实未来 token。
6.2 每层都能查询目标上下文
设草稿输入表示为 ,按照论文的列向量记法,第 层的核心投影关系为
查询 Q 只来自草稿位置;K、V 则同时包含目标特征和草稿位置。因此,目标特征更像一组可读取的上下文条目。它们不会作为普通草稿 token,继续通过这一层的 Q 投影、注意力更新、输出投影和 FFN。
这与“在草稿输入端拼上目标特征”不是同一件事。后者把目标信息融合进最初的表示,后续层需要自己维持这些信息;KV 注入让每一层都能再次访问目标上下文。论文用信息被逐层稀释来解释两者差异,我把这看作有消融支撑的设计直觉,而不是已经测量出的普遍定律。
目标特征的融合只做一次,但不同草稿层仍有各自的 K、V 投影。可以缓存的是这些与有效历史上下文对应的条目。这里也不应说成“直接共用大模型的 KV 缓存”:草稿网络有自己的层、投影和缓存内容,只是它们的上下文来源于目标隐藏状态。
6.3 内存数字的正确读法
附录用宽度 2048、五组目标特征和 BF16 来估计融合矩阵大小:
在 batch 为 1、序列长为 2048 的例子中,拼接输入约占 40 MB,投影后的输出约占 8 MB;块大小为 16 的解码阶段,临时投影激活小于 400 KB。这些近似使用十进制 MB,且针对附录中的具体配置。
我觉得最容易误读的是把 42 MB 当成整个 DFlash 的额外显存。它只是共享融合投影的参数量,不能替代草稿层权重和各层 KV 缓存的完整账目。若草稿有 层、batch 为 、上下文长为 、缓存 K/V 宽度为 、每元素占 字节,那么粗略缓存量是 。这是笔记中的估算模型,真实分组方式和布局还会影响常数。
这个估算至少提醒我,单请求下很小的附加成本,乘上长上下文和大量并发后也可能变得重要。评价“轻量”时,要明确是训练参数少、前向延迟低,还是部署总显存少,不能把这些含义混为一谈。
7. 训练:要学的是验证器能用的草稿
7.1 先对齐目标模型的回答分布
作者收集了大约 80 万条来自 Nemotron Post-Training Dataset V2 和 CodeAlpaca 的样本,但不是直接使用原始回答,而是由目标模型重新生成回答后用于训练。这个选择符合推测解码的目标:一个回答即使语义正确,只要 token 序列与目标模型常选的路径差异很大,也可能使接受率下降。
因此,这里的训练数据“好不好”包含一层特殊标准:它是否能让草稿预测目标模型实际会产生的局部续写。不能只按照普通指令微调的数据质量标准来判断。
7.2 随机锚点比固定切块更贴近推理
常规块扩散训练会按固定边界切分响应。DFlash 随机抽取响应中的锚点,把每个锚点作为块内第一个干净 token,后续 个位置全部遮住。这样训练出来的任务与推理时的输入形状更接近:上一轮验证产生了一个确定 token,现在需要预测它后面的短块。
真实推理的起点可能由拒绝位置决定,不会总是落在训练时人为规定的整齐边界上。随机锚点让同一条响应暴露出更多局部起点,提高数据利用率,也减少固定分块造成的边界偏差。
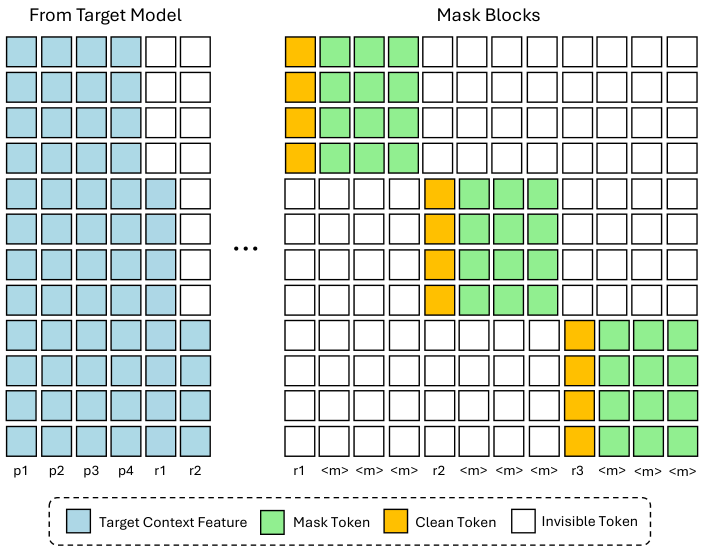
训练时可以先对完整的干净序列计算目标隐藏状态,因为目标网络本身是因果的。但是,对某个较早的锚点而言,后面那些隐藏状态已经包含了未来响应 token,不能全部暴露给这个草稿块。因果目标网络不等于所有目标特征对所有训练块都合法。
同样,不同草稿块之间需要隔离。随机抽出的跨度可能重叠,如果一个块能看到另一个块的干净位置,就可能从侧面得到答案。图中的稀疏掩码同时完成块内双向访问、合法上下文访问和跨块隔离;这不是仅为了提升训练速度的技巧,也是训练问题成立的必要条件。
7.3 位置权重为什么向前倾斜
把锚点位置记为 ,其后第 个真实 token 为 。将论文所述交叉熵训练与位置权重放到一起,可写成
这里 表示该锚点可访问的合法目标特征。这个式子是为了讲清训练目标而做的整合表达,不表示某个特定实现采用了何种平均或归一化细节。
第一个预测位置的权重是一,后面按指数衰减。回到公式 2 就容易理解原因:改进较早位置的条件通过概率,会影响许多“前缀至少存活到这里”的事件;仅改进最后一个位置,只增加最末尾的一项。
不过,位置加权不是直接优化最终速度。真实接受概率涉及 与 的匹配,最终延迟还包括草稿与验证成本,这些没有全部进入交叉熵。所以我把指数权重看作一个便宜、有动机的代理目标,而不是已经精确求解的系统优化目标。
附录规定,块大小 16 时 ,块大小 10 时为 5,块大小 8 时为 4。以 为例,最后一个预测位置的权重为 。它明显偏向前面的 token,但没有完全忽略末尾。尾部仍需学习,否则扩大块长就很难带来额外进展。
算法 2:论文层面的训练流程
输入:目标模型生成的提示词与回答;块大小 B
1. 冻结目标模型,以及共享的 embedding 和 LM head。
2. 在线计算或离线读取目标模型的因果隐藏状态。
3. 融合选定目标层的特征,得到草稿上下文。
4. 从回答中随机抽取合法锚点位置。
5. 每个块构造成 [干净锚点, B - 1 个 MASK]。
6. 允许块内注意力和对应的合法上下文 KV 访问。
7. 屏蔽未来目标特征,禁止不同块之间的信息泄漏。
8. 一次草稿前向预测全部被遮住的位置。
9. 对预测 token 计算位置加权交叉熵。
10. 更新可训练草稿组件,后续轮次重新采样锚点。
附录 A.1 给出的训练配方是 AdamW、六个 epoch、学习率 、梯度裁剪阈值 1.0、余弦调度和 0.04 的 warmup 比例。最大序列长为 3072,Qwen3-Coder 为 4096,每条序列随机抽取 512 个锚点。论文另一个长上下文实验提到 4K 基础草稿模型,不能把它与所有主实验配方自动合并。
固定每条序列的块数,约束的是待预测草稿位置的数量,不是整个训练成本与上下文长度彻底无关。更长上下文仍影响目标特征的生成、读取以及草稿注意力。在线训练实时计算特征;离线训练预先保存特征,用存储和 I/O 换目标模型重复计算。增加抽取层数,也会线性增加融合前的离线特征存储。
8. 实验:我如何拆开几个容易混淆的比较
8.1 先看 instruct 模式,而不是把所有结果求一个最大值
表 1 采用 H200、Transformers、关闭 thinking、最多生成 2048 个 token。EAGLE-3 的树预算分别为 16 和 60,均使用七步草稿与 top-k 10;DFlash 对 Qwen3 使用块大小 16。主设置中,小型 Qwen3 对应五层草稿,Qwen3-Coder 使用八层草稿。
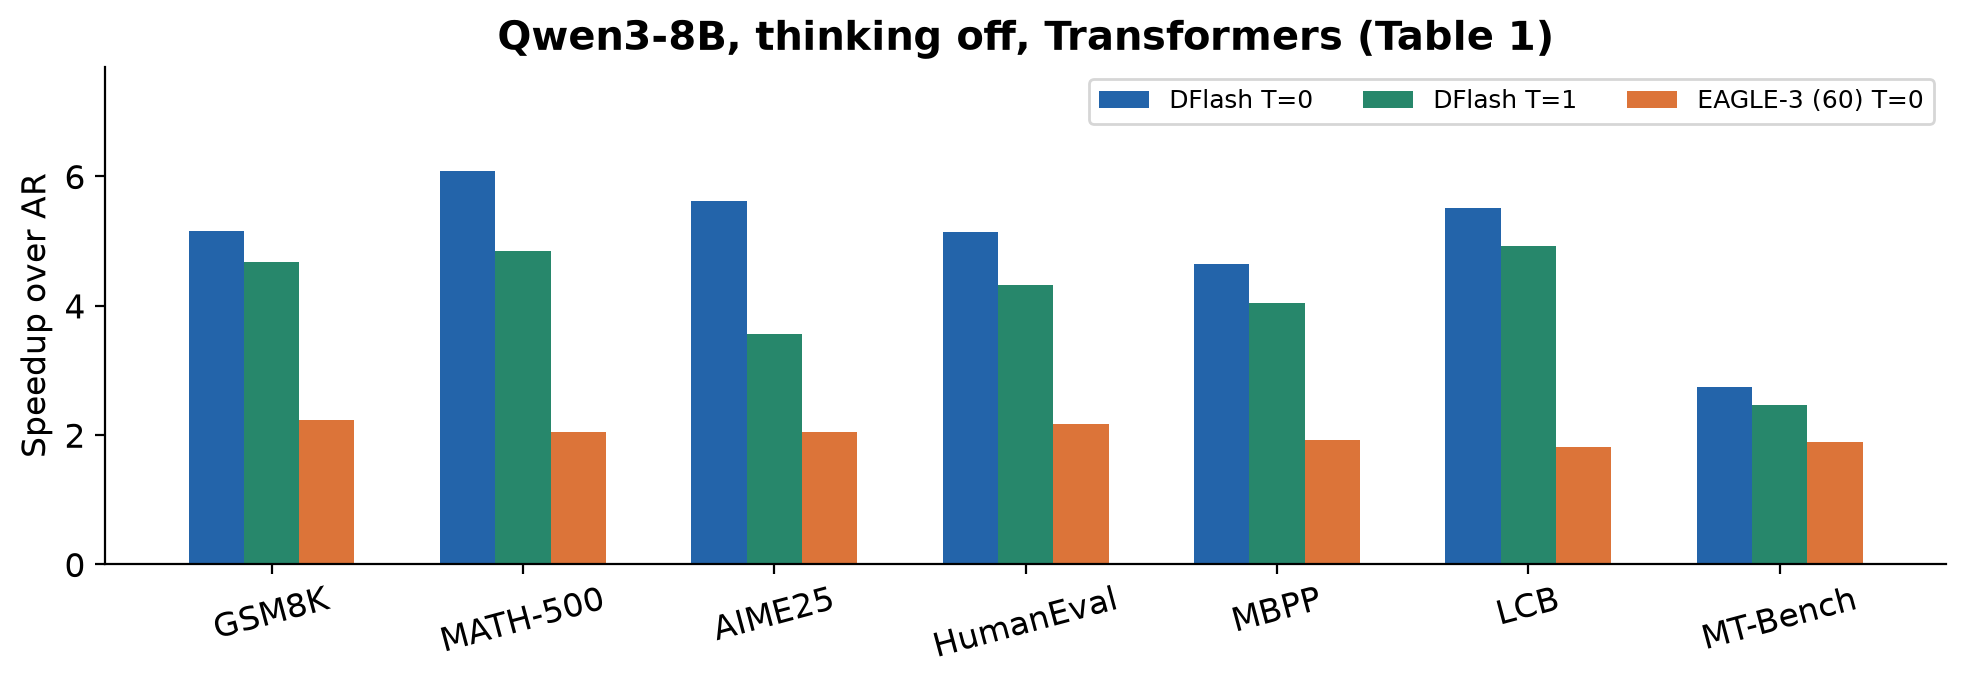
Qwen3-8B 在温度为零时,DFlash 的平均加速为 4.86 倍,平均 ;EAGLE-3 的 60 节点配置为 2.02 倍、。温度为一时,DFlash 变为 4.03 倍、;对应 EAGLE-3 为 1.88 倍、。采样增加了续写路径的不确定性,但在这些条件下,DFlash 仍保留较明显的优势。
这里有一个值得明确指出的小问题。原文附近的文字说约 2.4 倍提升,并提到 EAGLE-3 (16),但按照 Qwen3-8B 表格计算, 对应的是 60 节点基线;如果除以 16 节点基线的 1.76,则约为 2.76。我认为这是正文比较标签与表格之间的不一致。因此笔记采用具体行值,不沿用可能混淆的那句概括。
这不等于否定表中实验,而是防止转述时把分母换掉。同一个“提升几倍”既可能指相对普通自回归,也可能指相对另一个推测方法;如果不写清楚,读者很容易把两个倍率再重复相乘。
MT-Bench 也值得单独看。它在温度零时为 2.75 倍,明显低于数学任务的峰值。多样化续写可能影响接受率,但表格本身没有隔离这一因果解释,所以我只把它作为合理分析,不把“对话更自由”写成已被实验单独证明的原因。
8.2 reasoning 模式使用了相应训练数据
表 2 打开 thinking,并使用包含目标模型推理轨迹的数据来训练草稿。Qwen3-8B 在温度零时,对 GPQA、MATH-500、AIME25 分别达到 4.17、4.64、4.51 倍;温度一时分别为 3.75、4.03、3.70 倍。
这支持 DFlash 能加速所测试的长推理输出,但并不证明一个仅在普通 instruct 回答上训练的 checkpoint,无需调整就能达到同样效果。这里的训练分布匹配仍然重要。
同样,加速长推理不等于提高推理正确率。精确验证的目标是让最终生成分布维持目标模型的样子,只把完成这次生成所花的时间降下来。如果目标模型原本会走一条错误推理链,推测解码本身并不提供额外的事实纠错机制。
8.3 服务框架结果需要连同并发一起读
表 3 换成单张 B200、SGLang、论文注明的 FA4 注意力后端,以及 Spec-v2 调度重叠。这里提到后端仅为说明 DFlash 实验条件,不把它扩展成另一篇论文的独立选题。
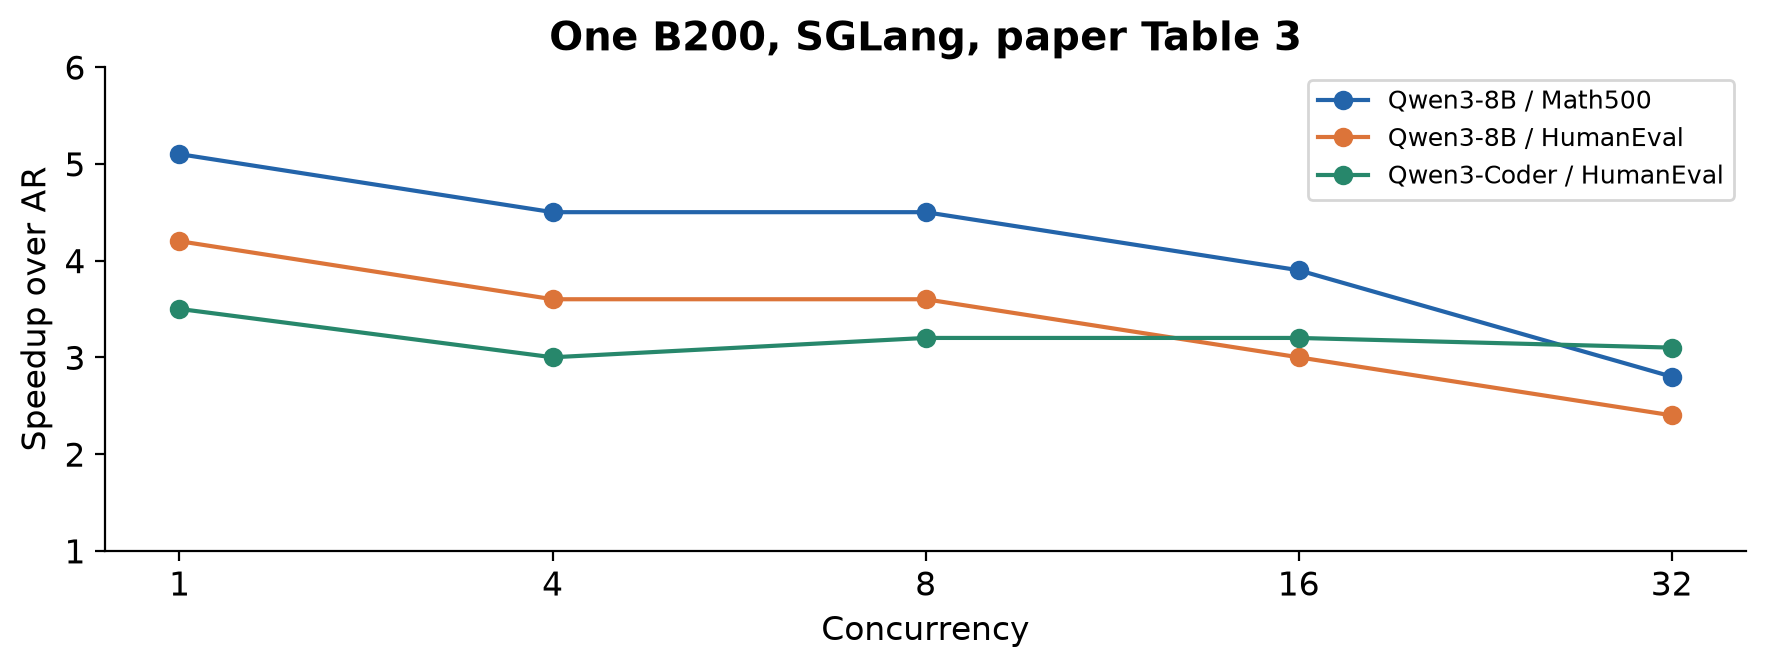
Qwen3-8B 在 Math500 上,并发一时吞吐从 230 提高到 1175 token/s;并发 32 时从 5694 提高到 16076 token/s。后者仍是可观增长,但对应约 2.8 倍,已经不是低并发下的 5.1 倍。
总体 token/s 也不是每个请求的体验。首 token 延迟、输出 token 间隔、长短请求混排后的尾部完成时间,都不能从一个总吞吐数字直接读出来。如果网站或 agent 应用关心用户等待多久,还需要匹配相应服务指标。
表 5 的 LLaMA-3.1-8B 对照更能说明“接受更多不一定更快”。这里用与 EAGLE-3 相同的 UltraChat/ShareGPT 数据训练 DFlash,并且为了可比性采用不含调度重叠的 Spec-v1。论文说明原因是 Spec-v2 不支持 EAGLE-3 的树形草稿。
在 GSM8K、并发 32 时,EAGLE-3 (60) 的相对速度降到 0.6 倍,而 DFlash (10) 仍有 1.6 倍。前者平均接受长度为 4.55,还略高于后者的 4.32,却没有更快。这是公式 4 中分母的重要性在真实表格里的直接体现。
附录 A.4 还扩展到更多模型和 vLLM。SGLang、并发八下,Qwen3.5-9B 在 Math500 上 DFlash 为 3.5 倍,原生 MTP 为 1.7 倍;但 GPT-OSS-120B 的 Math500 只有 1.6 倍,MT-Bench 为 1.3 倍。方法有跨模型价值,并不意味着不同目标模型可以套用同一个收益估计。
9. 消融:哪些设计有证据支持
9.1 长上下文微调修复的是接受长度下降
作者用 1600 条 LongAlign 样本,对 Qwen3.5-27B 的基础草稿模型微调三个 epoch,然后在 LongBench 的不同上下文长度上测量接受长度。
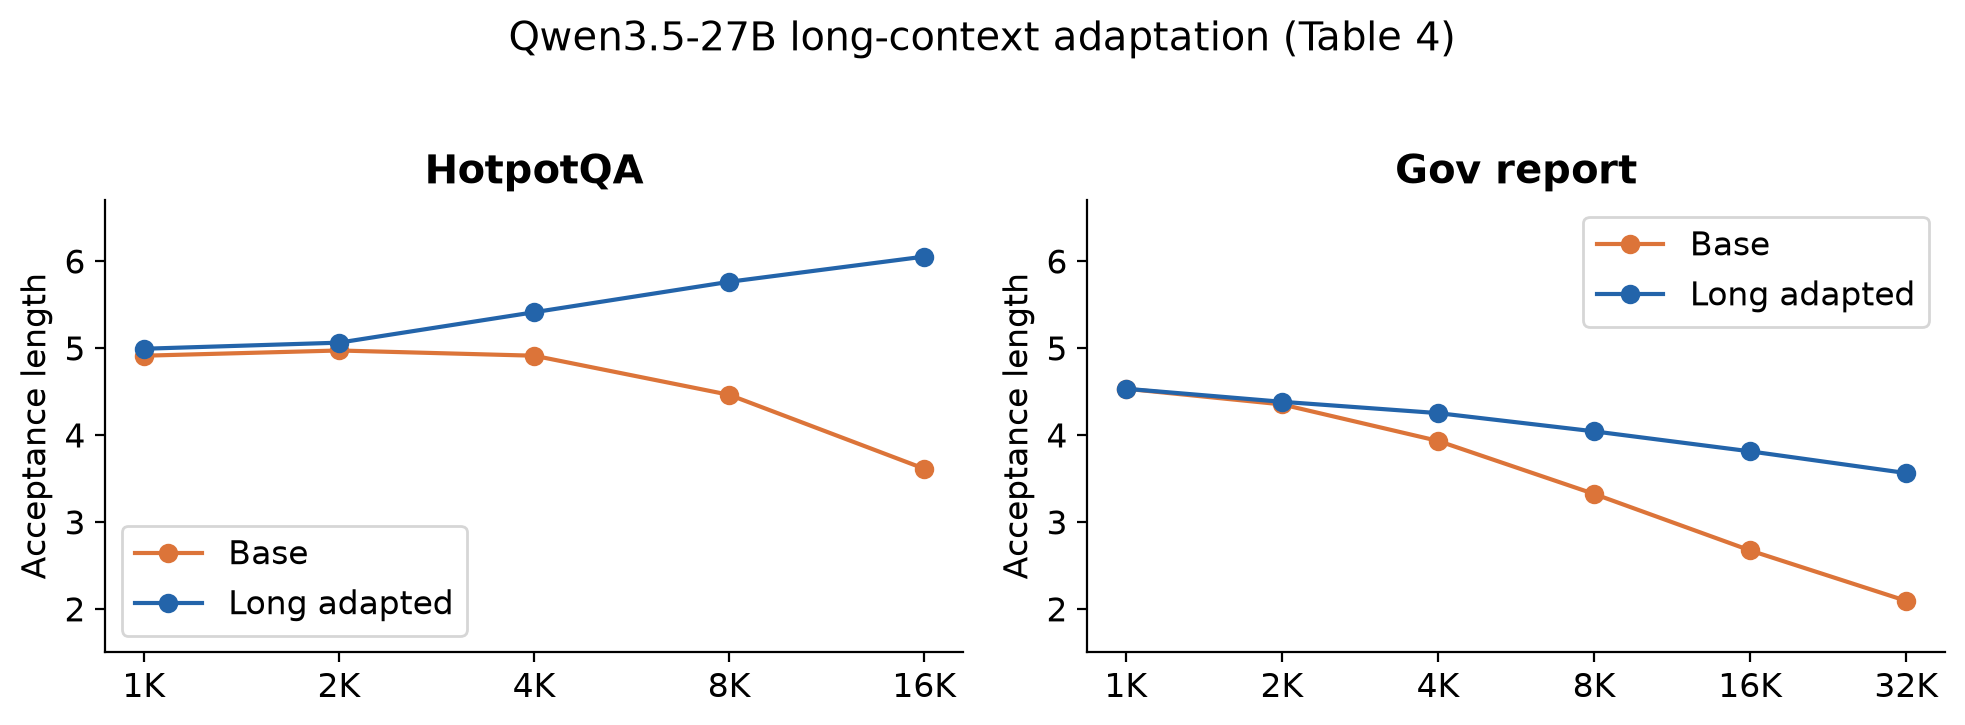
在 HotpotQA、16K 上,基础模型的接受长度为 3.61,长上下文微调后为 6.05;Gov report、32K 从 2.09 提升到 3.56。这说明短上下文训练造成的接受率退化,并不必然是目标特征条件化的固定上限,少量适配能够改善它。
但表 4 测的是接受长度,没有直接给出这些长上下文配置的端到端加速。更长缓存的读取成本、草稿注意力成本和显存占用,都还会进入延迟分母。把“接受长度提高”写成“延迟相同比例降低”,就超出了这组实验能支持的结论。
9.2 草稿更深,接受更多,速度却会出现峰值
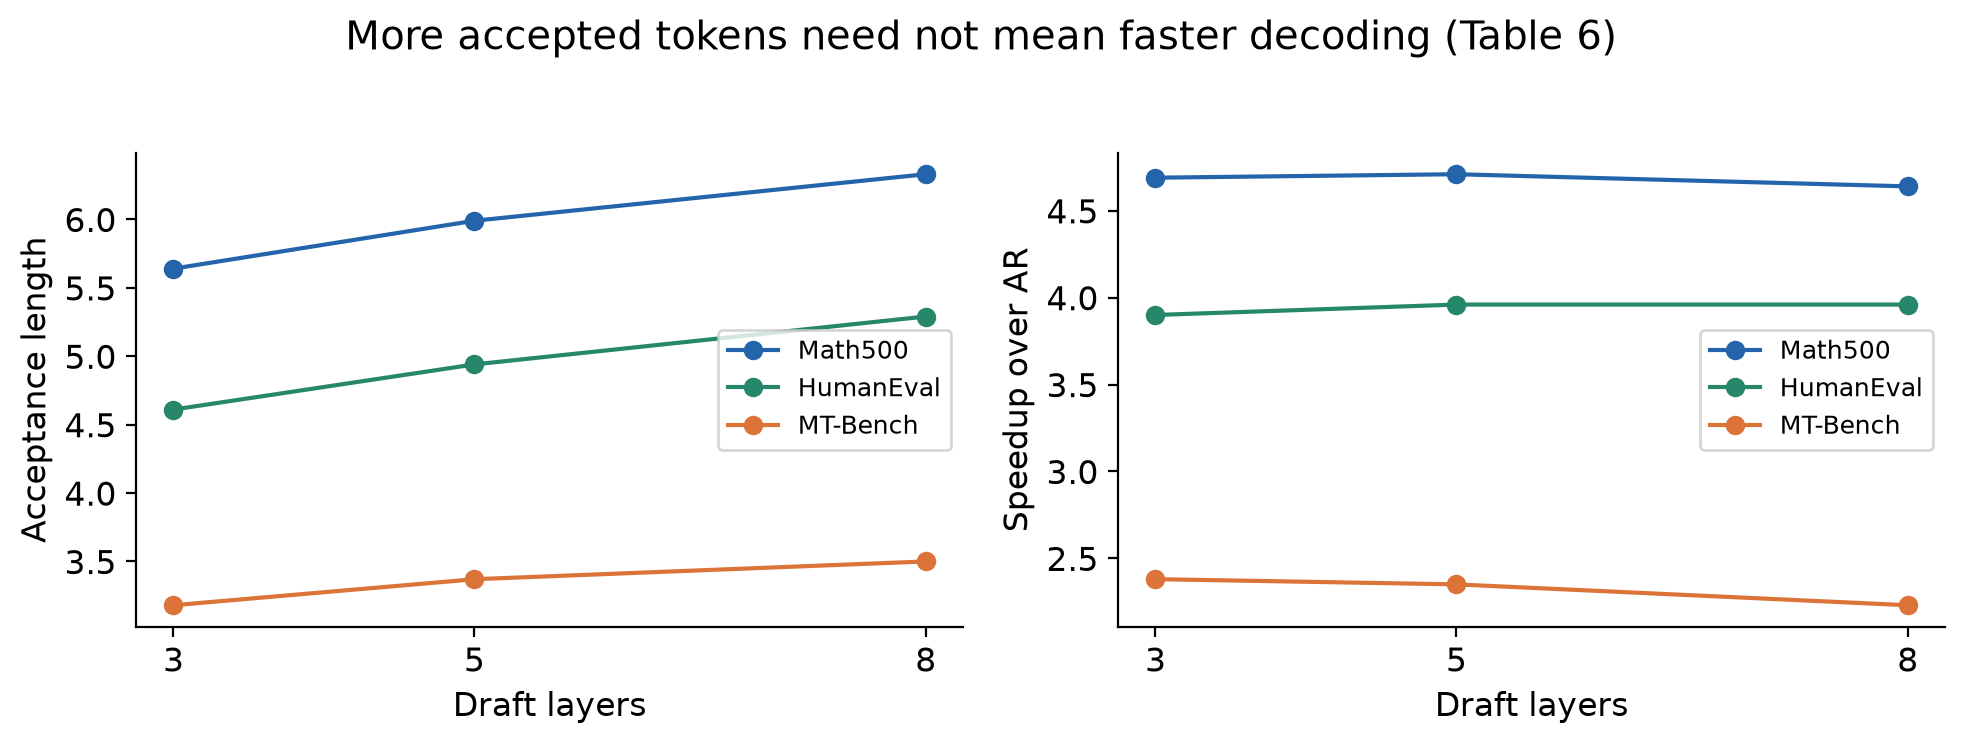
Math500 从三层加到八层时, 从 5.64 上升到 6.33;对应加速却从 4.69 变为 4.64 倍,五层的 4.71 倍略高。这里我不会过度解读三层与五层那一点点差距,因为表中没有给出不确定性区间。更稳固的定性结论是:表达能力带来更好草稿,而新增计算会消耗收益,两者必须一起优化。
表 7 固定三层草稿,将目标特征从三层增加到五层,Math500 加速从 4.49 提高到 4.69 倍,其他两个任务也改善。这个结果支持跨深度特征有用,但没有证明提取越多层越好。离线存储、特征传递和投影成本都会随配置变化。
9.3 KV 注入和并行预测贡献不同
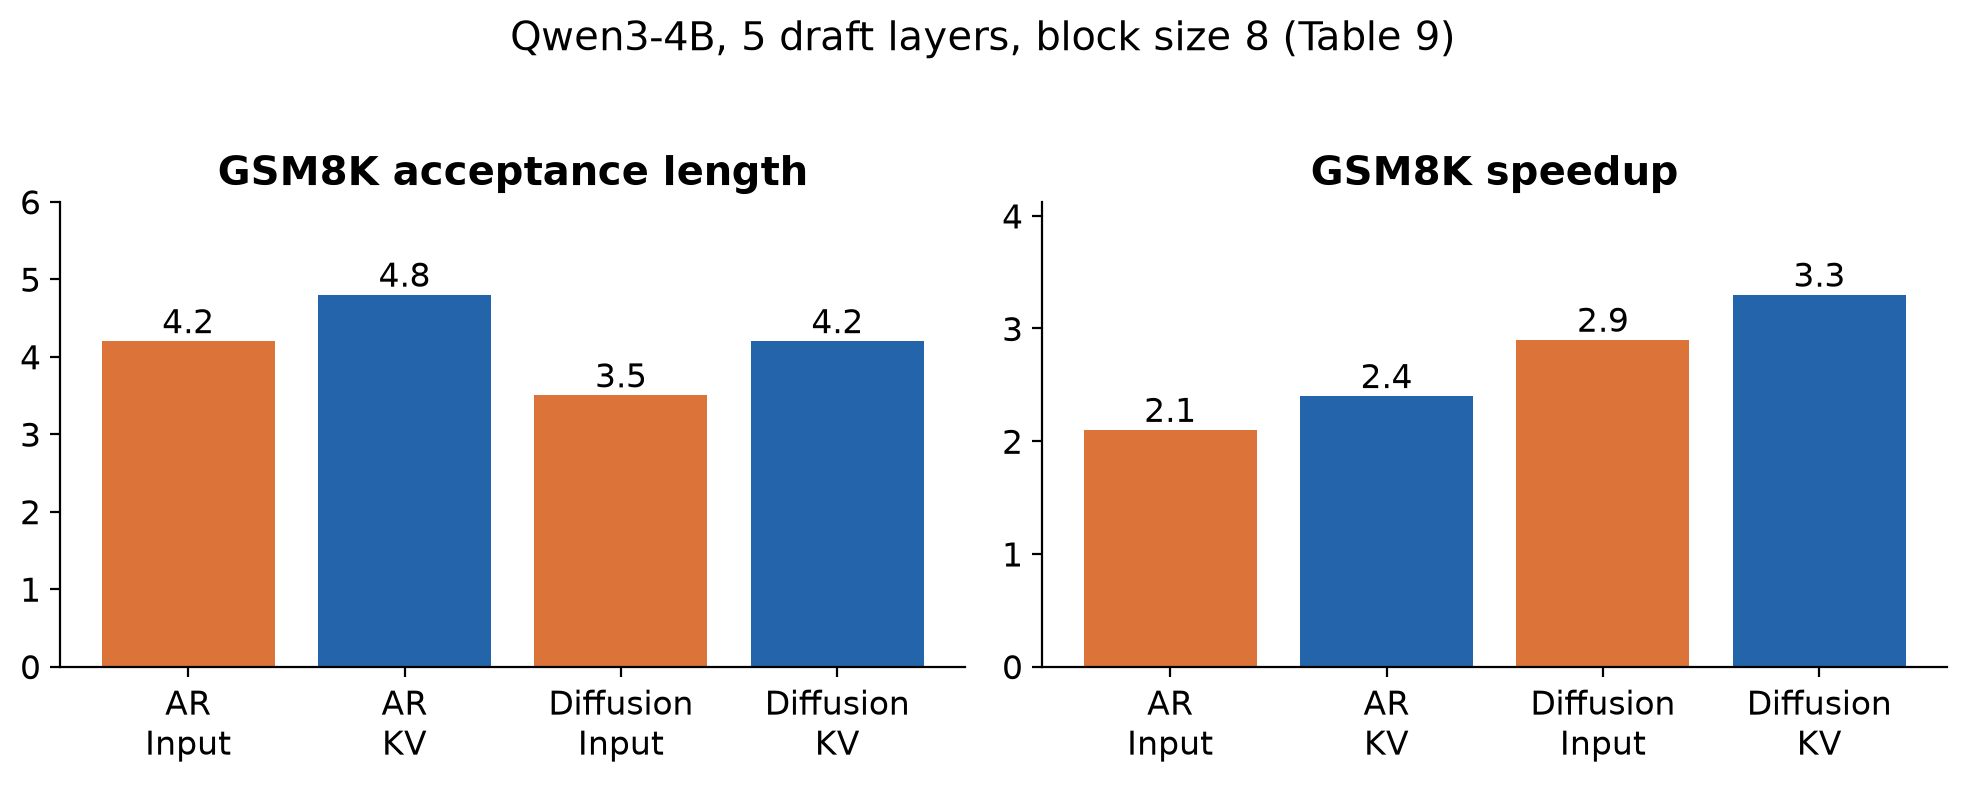
我认为这组二乘二消融是全文最有解释力的证据。自回归草稿中,KV 注入相对输入融合让接受长度从 4.2 增到 4.8,加速从 2.1 增到 2.4 倍;块扩散中,接受长度从 3.5 增到 4.2,加速从 2.9 增到 3.3 倍。也就是说,不论生成方式如何,持续访问目标特征都带来了收益。
横向比较更有意思。块扩散加 KV 的接受长度只有 4.2,低于自回归加 KV 的 4.8,但速度为 3.3 倍,高于后者的 2.4 倍。DFlash 不必证明“并行预测总比自回归预测准”,只需要用更低的串行成本取得足够好的候选,就能赢得时间。
因此,我不会把两个贡献混成一句“扩散模型更会预测未来”。更准确的说法是,KV 条件化提高候选质量,块并行降低起草成本,两者共同改善最终周期效率。
9.4 训练块长与推理块长存在不对称迁移
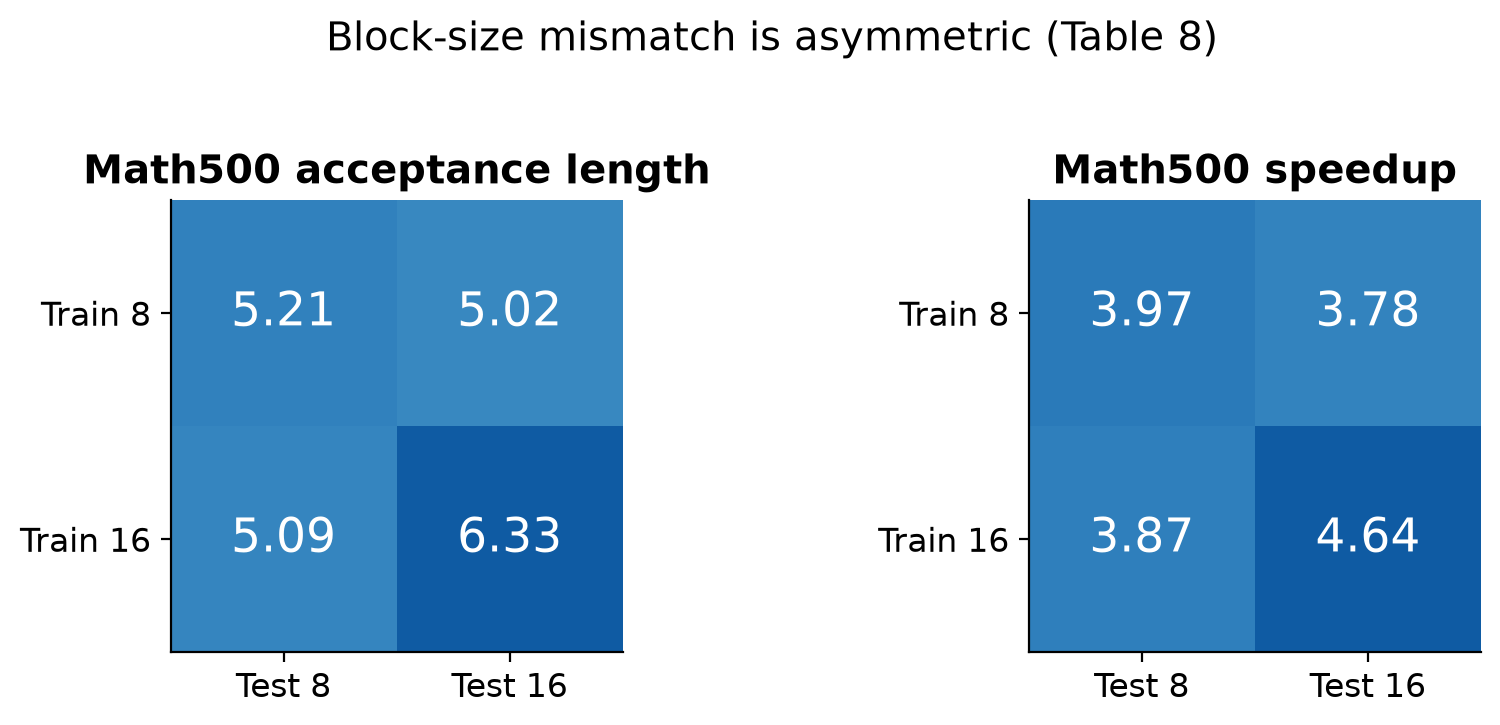
在 16 上训练、改用 8 推理时,接受长度为 5.09,接近在 8 上训练并推理的 5.21;但在 8 上训练、改成 16 推理时,仅有 5.02,远低于 16 到 16 的 6.33。扩大推理时分配的位置,并不会自动教会模型利用更长预测范围。
这个不对称性为动态块长提供了可能:可以先用大块训练,再根据负载缩短推理块。不过论文明确把自适应块长调度留给后续工作。现有证据是不同块长的静态对照,还不能写成已经完成了一个自动调度系统。
表 13 对随机锚点也给出了单独支持。在相同的十万条训练子集、三层草稿下,Math500 从固定切块的 4.13 倍提高到随机采样的 4.69 倍,接受长度从 4.94 增到 5.64;HumanEval 的速度从 3.29 增到 3.90 倍。这个结果说明训练边界分布本身也值得优化,不只是网络结构重要。
10. 如果换一种设计,会付出什么代价
10.1 自回归草稿仍有它的优势
浅层自回归草稿每个位置都能看到已经采样的前驱 token,因此容易表达具体续写路径之间的依赖。单次并行 mask 预测没有这个条件。它的代价是多步串行延迟,所以两者的比较不是“旧结构完全没有价值”,而是同一时间预算下谁能产生更多有效输出。
大型预训练扩散模型则能提供更强的独立生成能力,但需要更多常驻参数和更贵的草稿前向。如果再加多步去噪,候选连贯性可能改善,不过每一步都必须通过增加接受长度来赚回成本。仅仅证明草稿更像完整答案,并不足以证明服务更快。
10.2 更多候选不一定更省资源
树形草稿可以覆盖分叉的不确定性,避免只押注一条线性候选。但树的构建、裁剪和验证都要成本,结构预算与线性块长度并不一一对应。高并发时,对最终不会使用的节点进行大量验证,甚至可能拖慢整体服务。
同理,把目标特征只融合到输入端,结构更简单,但后续层只能依赖已经混合的表示;每层 KV 注入增加了稳定访问上下文的渠道,同时也引入投影与缓存账目。选择哪种方式,应该看目标模型、硬件和上下文分布,而不能单靠“更深”“更多特征”来决定。
算法 3:我建议的配置评估顺序
输入:目标模型、请求分布、硬件、延迟要求
1. 固定 tokenizer、采样参数和输出长度限制。
2. 按请求类型测量对应的普通自回归基线。
3. 选择少量草稿层数与推理块长进行对照。
4. 分别记录草稿、验证、调度时间和有效输出数。
5. 把 prompt 处理与稳定解码阶段分开统计。
6. 分层考察并发、上下文长度和回答长度。
7. 同时记录显存占用与延迟分位数,而非仅看 TPS。
8. 在相同服务要求下比较完整配置。
9. 为已经测量过的工作区间选择最快的可行配置。
10. 模型或流量分布改变后重新评估。
这是一份建议的实验设计,不是本次已经执行的基准。它的目的,是把论文里的机制连接到实际服务目标。某个配置即使整体吞吐最高,如果交互请求的尾部延迟明显变差,也未必适合面向用户的场景;反过来,一个只在小并发下成立的延迟收益,也可能对交互式 agent 非常有价值。
11. 局限与失败边界
目标模型依赖。 DFlash 需要目标内部隐藏状态,也依赖与目标生成分布匹配的数据。只有 token 或 logits 的远程 API,不能直接提供同样的条件输入。即使词表没有变化,目标模型更新后隐藏表示的语义也可能改变,旧草稿模型是否仍然合适需要重新评估。
并行候选的路径依赖不足。 一次 mask 前向不会看到各位置最终抽出的前驱 token。在自由度较高或局部分叉较多的续写中,长块可能产生彼此不协调的候选。验证器能够保护最终分布,却无法收回已经浪费在这些候选上的计算时间。
硬件与负载变化。 草稿、验证和缓存开销都会随着 batch、上下文、模型结构和硬件改变。本文的并发曲线能帮助理解趋势,但不能代表所有线上服务;尤其不能把小并发下近似平坦的草稿成本外推到无限长块。
比较覆盖不完整。 原文说明,一些扩散推测方法因为缺少可用实现,没有进入主要对照。这限制了“普遍优于全部替代方案”的结论。相同训练数据的 LLaMA 实验增强了说服力,但仍不能消除不同模型和框架设置之间的所有差异。
统计不确定性不足。 许多结果是平均值或点估计,没有完整置信区间和延迟分布。三层与五层那样很接近的速度差,不能仅凭表格就宣布一个配置绝对更优。数据集平均倍率也不等于按真实流量和输出 token 数加权后的服务倍率。
精确性的含义有边界。 数学上的分布保持依赖正确的提议概率、残差纠正、前缀条件与停止规则。它不是同随机种子逐字相同的承诺,也不是目标回答质量升级的证明。数值精度和采样变换属于需要匹配的条件,不能在转述“无损”时省略其含义。
12. 批判性分析
12.1 最有说服力的不是最高倍率,而是拆得开的机制
我最认可表 9 的原因,是它把“条件化更强”和“起草更并行”拆开了。块扩散方案即使接受前缀比自回归方案短,仍然可以更快,这与总周期延迟模型直接对应。这样的证据比只展示一个最终速度数字更能说明为什么方法有效。
随机锚点也是一个容易被大结构掩盖的小设计。验证器决定推理过程在哪里重新起草,而训练通常人为决定块边界。随机起点用较低成本扩大边界覆盖,确实处理了一个具体的分布不匹配。当然,它仍不等于按照真实验证轨迹进行完整的 on-policy 训练;“更接近”与“完全一致”需要分开。
12.2 有些直觉应该保留为解释,而不是升级成定理
目标隐藏状态能改善草稿预测,不意味着它含有已经发生的未来。它包含的是在因果上下文中形成的预测性信息。把这点说清楚,既有助于理解训练掩码为什么不能泄漏答案,也能避免把方法描述成某种超出因果生成的能力。
“并行草稿的成本不随 token 数增加”也只能作为某个硬件工作区间的近似。真正的优势是,一批额外位置可以利用尚未用满的并行算力,其延迟增量通常比多次串行前向小。到了计算、注意力或显存瓶颈处,这种优势会缩小。
另外,我在本文坚持以带版本号的 v2 PDF 为数值依据。作者项目页上的部分结果与 v2 表格不同,H200/Transformers 和 B200/SGLang 的设置也不同。如果把最好的速度、最强的调度重叠和最小的显存数字拼在一起,就会得到一个论文并没有实际测试过的“理想配置”。
12.3 我最希望补充的证据
第一类是系统账目:不同并发下的接受前缀分布、草稿与验证时间拆分、混合长短请求时的延迟分位数。这些测量能够回答,收益究竟来自减少目标调用,还是主要把瓶颈从一个地方转移到另一个地方。
第二类是适配账目:当目标模型版本、上下文长度和业务请求改变时,重新生成训练数据、保存特征、训练草稿分别要多少成本,能换来多长时间范围内的服务节省。论文的小规模长上下文微调很有启发,但单凭接受长度还不能完成这个运营层面的判断。
所以,我对本文的判断是积极但具体的:DFlash 给出了一套可信的设计,能够把目标表示转成低串行开销的并行候选。最值得迁移的是条件化、草稿并行和面向验证的训练一起优化的思路,而不是某个对所有模型与流量都成立的固定倍率。
13. 结论
读完 DFlash,我留下的核心图景是分工:草稿模型负责尽快提出一段有用的候选,目标模型负责确认最终输出。每层 KV 注入持续提供目标上下文,单次块预测减少串行起草,随机锚点与位置加权则让训练更贴近验证器实际消费候选的方式。
真正串起全文的是三个计算:接受长度由各段前缀的存活概率累加而来;加速比由有效进展除以完整周期成本决定;精确采样靠接受质量与残差质量相加恢复目标分布。理解了这三点,就既能解释 DFlash 为什么可能很快,也能理解为什么更长块、更深草稿、更高接受率有时仍然会让系统变慢。
论文在多种目标模型和后端上提供了相当有说服力的加速证据。下一步值得关注的,是这种结构如何随着上下文、并发和业务流量变化选择配置,以及完整服务成本是否仍然支持同样的收益判断。
参考资料与配图来源
- Jian Chen、Yesheng Liang、Zhijian Liu:DFlash: Block Diffusion for Flash Speculative Decoding,v2,2026-05-28。方法与实验的主要依据,已阅读全部 13 页及附录。
- Yaniv Leviathan、Matan Kalman、Yossi Matias:Fast Inference from Transformers via Speculative Decoding。标准推测验证框架;本文公式 6 至 8 是我为解释概率质量守恒而写的推导。
- DFlash 作者项目页。作为资源入口,本文实验值统一使用版本固定的论文,而不混用项目页不同阶段的数字。
图 1、2、4 分别裁自原文图 2、3、4,依据原文 CC BY 4.0 许可,裁去周围正文并保留图内信息。图 3 为独立教学示意。图 5 至 10 分别重绘原文表 1、3、4、6、9、8;全部明确标注来源,没有将重绘数值当作新测量。