笔记日期: 2026-10-03
笔记作者: Zhongzhu Zhou
论文题名: SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models
论文作者: Muyang Li, Yujun Lin, Zhekai Zhang, Tianle Cai, Xiuyu Li, Junxian Guo, Enze Xie, Chenlin Meng, Jun-Yan Zhu, Song Han
论文编号与版本: arXiv:2411.05007v4,版本日期 2025-11-08;首版日期 2024-11-07
阅读范围: 正文及附录 A-F。模型实验数值来自作者,未独立复现;复算、说明性例子和图片来源均单独标明。
1. 先把问题想清楚:低秩分支到底保护什么
读完 SVDQuant,我最想记住的不是“又一种四比特量化”,而是一个更具体的分工:把少数难以量化的方向交给高精度分支,把剩下的大部分工作交给低精度分支,再让两条分支尽量共用输入读取和输出写回。
这个分工同时回答两个问题。第一个是数值问题:激活和权重都降到四比特以后,怎样避免图像质量崩溃?第二个是执行问题:增加高精度补偿分支以后,为什么不会把低比特计算省下来的时间重新花掉?论文分别用 SVDQuant 和 Nunchaku 回答它们。只理解前半部分,很容易得到质量还行、速度却不理想的方案;只追求后半部分,则可能得到速度很好、但生成内容已经失真的模型。
方法的顺序很重要。先做通道缩放,把激活中的异常值压力迁到权重一侧;再对变换后的权重做 SVD,让少数主导方向留在 16-bit 分支;最后对稠密残差权重和已经平滑的激活做 4-bit 量化。运行时,Nunchaku 把低秩降维和激活量化放在一起,把低秩升维和主分支矩阵乘放在一起,减少重复搬运。
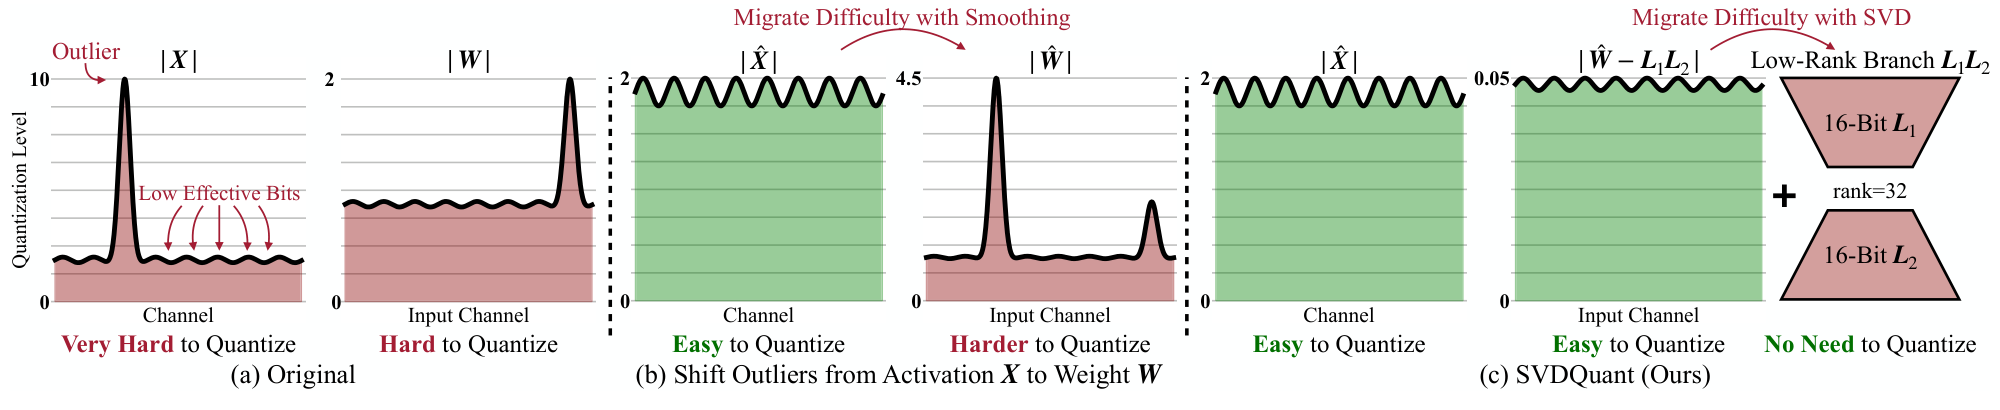
图 1(论文图 3):先转移异常值,再用低秩分支承担主导权重方向。这里裁取原论文示意图;图中的高精度分支是整个方法的组成部分,不能在统计成本时省略。
我最初容易混淆的一点,是把这篇论文当成“用低秩矩阵替换原来的大矩阵”。实际上,它没有直接丢弃奇异值尾部。尾部仍然作为一个稠密矩阵存在,只是以四比特保存和参与计算。低秩分支负责的是保护数值困难的成分,而不是独自表达整层权重。这解释了为什么很小的秩也可能有明显作用。
因此,“低秩压缩”和这里的“低秩保护”具有不同的误差来源。前者直接损失被截掉的方向;后者在分解时仍可精确表示原矩阵,误差主要来自后续量化、有限精度因子和实际计算。两者都使用 SVD,但不能把同一条截断误差结论不加区分地套到最后的模型质量上。
这份笔记会先补齐量化和矩阵分解的前置知识,再推导误差为什么转移到了残差,随后解释融合执行、LoRA 接入和实验结果。最后单独讨论局限与批判性分析。我的总体判断是:论文给出了很有说服力的数值方法与系统设计配合,但“接近原模型”应当按具体指标理解,不能扩展成所有场景无损。
2. 前置知识:四比特、省显存和加速不是同一件事
2.1 从一个线性层看计算量
设输入是 ,权重是 ,输出为 。这里的 表示参加这次矩阵乘的激活行数,可以包含大量图像空间 token。因此,图像 batch size 等于 1,并不意味着矩阵乘只有一行输入。
这次乘法大约需要 次乘加,按一次乘加算两个浮点运算,就是 FLOPs。扩散模型会在多次去噪步骤中重复调用网络,每一步又处理很多图像 token。这使得它的瓶颈和小 batch 自回归解码并不完全相同:仅仅减少权重读取,不一定能显著减少主要计算时间。
W4A16 表示权重四比特、激活十六比特。它可以缩小权重存储,也可能让原本装不进显存的模型避免 CPU 卸载。但计算时若仍把权重展开为高精度,就没有自动获得原生四比特矩阵乘的吞吐。W4A4 则让两侧操作数都进入低比特计算路径,才有机会利用相应 Tensor Core 的吞吐能力。
所以我会稍微收窄论文中“仅权重量化不能加速扩散模型”的表述。对一个原本需要 CPU 卸载的系统,W4A16 也可能明显减少总时间。更准确的说法是:仅权重量化并不会天然解决四比特算术吞吐的问题。是否省显存、是否减少通信、是否加速矩阵乘,需要分别衡量。
2.2 为什么异常值会吃掉量化分辨率
以最简单的对称 INT4 最近舍入为例,对一组非全零数值 ,令
这里 表示反量化后的近似值,不是四比特整数编码本身。对称编码使用 到 ,暂时不讨论额外负数编码的其他安排。如果一组里最大值的绝对值为 7,步长就是 1,那么许多绝对值小于 0.5 的元素都会舍入为零。问题不是这些小元素完全没用,而是异常大值决定了整组的刻度。
如果能把大成分单独表达,剩下的数值范围缩到 1,步长就能缩到 。同样的小元素可以获得更多区分。关键条件是“大成分单独表达”,不能直接裁掉大值后声称误差变小,否则只是把损失藏到了另一处。
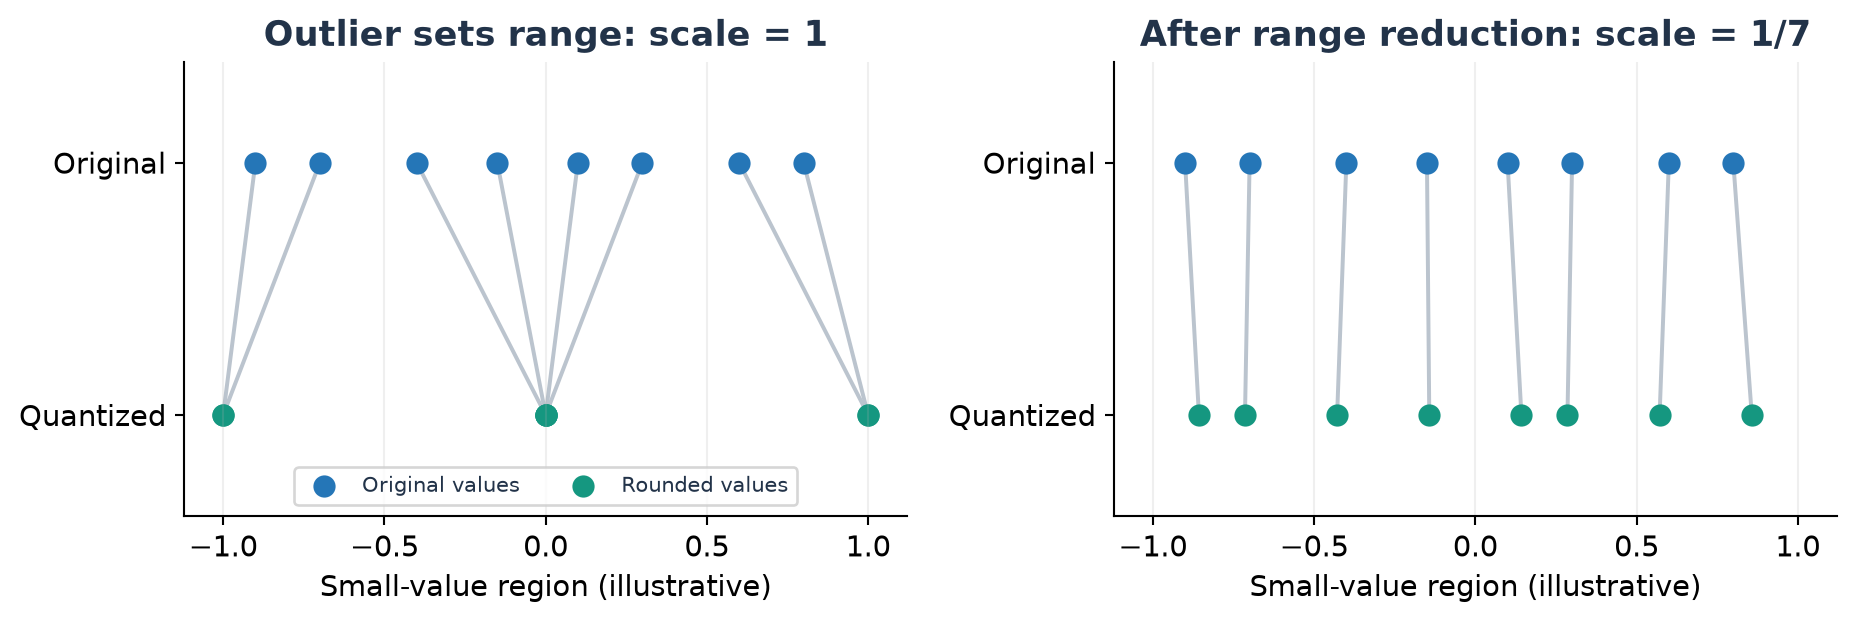
图 2(自行绘制的解释性例子):左侧使用步长 1,右侧使用步长 1/7,比较同一批小值的舍入。左侧决定范围的大值没有放进小值显示窗口。图中没有任何模型实测结果。
FP4 也不能简单看作最大值换了的 INT4。浮点可表示数值的间隔不均匀,NVFP4 还配合更细粒度的缩放。本文 INT4 使用 64 个元素一组、16-bit scale;NVFP4 使用 16 个元素一组、FP8 scale。因此两者的质量比较,同时包含数值格式和分组粒度的变化,不能把所有收益都归因于浮点格式本身。
2.3 局部误差怎样进入生成轨迹
可以用一个简化的去噪更新帮助理解:,其中 是条件输入。量化不仅改变这一步网络的输出,还会改变下一步拿到的状态。对误差做局部线性化,有
这只是我的解释性模型,不是论文证明的全局定理。它告诉我,某一层输出 MSE 很小,并不等于最终图像一定几乎不变。已有误差会被后续动力学放大或抑制,新的误差又不断加入。提示词、guidance 和去噪步数改变后,这种传播关系也可能改变。
因此我会同时关注两种证据:一是局部近似是否合理,二是完整生成轨迹上的实际质量。论文同时测较多步的模型和少步蒸馏版本,这一点比只报告某层重建误差更有价值。但少步模型的成功也不自动证明所有采样器、所有分辨率都成立。
3. 第一步:把动态激活的困难移到静态权重
3.1 一个不改变原始输出的坐标变换
令 是作用在输入通道上的可逆对角矩阵。对输入和权重分别做相反方向的缩放:
这条等式的含义很朴素:第 个输入通道除以 ,对应权重行乘以 ,精确计算时结果保持不变。缩放只是重新分配数值大小,没有凭空消除信息,也没有在这个阶段引入低秩损失。
这里需要特别检查乘法方向。沿用论文给出的 为 、 为 的约定, 应该左乘 。正文 4.2 的一处文字写成了 ,和它声明的维度不一致。我在笔记中统一使用式(3),这样维度和前后乘积都能直接验证。这个记号问题不改变作者的平滑思想,但如果照抄,就可能把推导写错。
附录 D 的通道缩放来自 SmoothQuant 式的参数族:
激活统计量从校准数据取得。作者逐层搜索迁移强度 ,用做完 SVD 后的层输出 MSE 选择。式中假定统计量非零;真实的数值规范还需要处理零通道和极小分母,不能从这个简写公式反推出某一种具体的保护常数。
如果某些输入通道常常有很大的幅度,就用较大的缩放把它压下来。代价是对应权重行变大。普通平滑往往试图在两边取得折中,而 SVDQuant 更进一步:先把困难集中到权重,再用额外的高精度分支承担它。权重是静态的,适合离线分解;激活会随提示词和步骤改变,不适合每次重新做昂贵分析。这是这种不对称选择的直观理由。
3.2 什么时候迁移会失效
式(3)只保证量化之前的等价性,并不保证任意缩放都会降低量化误差。过强的迁移可能让权重残差更难量化;校准集没有覆盖到的激活异常值,也可能在后续输入中重新出现。因此“迁移”必须和“保护”一起评价,不能只展示激活范围变小就结束。
还有一个更隐蔽的条件:被放大的权重成分最好集中在少数奇异方向里。如果异常值分别占据很多彼此独立的方向,小秩分支就装不下。论文示例中的尖锐奇异值谱说明该策略在一些层上很合适,却不是所有层都具有同样结构的证明。
我会把“吸收异常值”理解为一种有效的几何描述。它不意味着残差的每个 group 都完全没有大值,更不意味着一切非高斯结构都被消除了。更有信息量的诊断,是同时看激活范围、残差各组最大值、奇异值尾部和层输出误差,而不是只看某一张范围图。
4. 核心推导:为什么量化误差只剩残差那一支
4.1 两侧量化误差是耦合的
记 、。在输出误差里加上再减去 ,便得到
第一项是原输入乘上权重量化误差,第二项是输入量化误差乘上量化后的权重。两边不能独立看:激活误差有多大固然重要,它随后乘上的矩阵有多大也同样重要。
先用三角不等式分开两项,再对矩阵乘积使用 Frobenius 范数的次乘性,最后利用 ,就能得到论文命题 4.1 的形式:
这条上界告诉我,应当同时关心矩阵本身的尺度和各自的量化误差。它也解释了为什么单纯缩小激活范围仍可能不够:如果权重被放大,另一部分误差可能变得更糟。
不过上界不是精确误差。推导丢掉了不同项之间的方向关系、符号和抵消,因此通常比较松。上界变小只能提供动机,不能证明每一个输入的真实误差一定更小。之后仍需要实验检验,这一点在读“理论支持”时尤其容易被忽略。
4.2 让主导方向绕过四比特激活
把平滑后的权重分解成 ,其中 为 、 为 。计算时用
第一项保留高精度的平滑激活,第二项才使用四比特激活。假如暂时把高精度分支理想化为精确计算,原输出与近似输出相减后,高精度项会直接抵消:
现在式(6)中的完整权重可以换成残差 。这就是最关键的一步。激活的低比特误差不再经过整个 ,而只经过 ;最强的几个权重方向已经用没有四比特量化的输入单独计算了。
所以保护低秩成分不只是“让几个大权重存得准”。它同时让这些方向避开激活量化误差。若把两条分支都喂给同一个四比特激活,这层保护就不完整了。式(7)里两次出现的输入形式不同,正是理解方法时必须留意的细节。
当然,16-bit 不是数学上的无限精度。因子存储、矩阵乘累加以及最终相加仍会引入误差。严格一些应再加一个高精度分支误差项 。论文把它忽略,是为了突出主导量化项的变化,而不是宣称整层没有其他数值误差。
4.3 残差范数如何关联量化误差
对于没有裁剪的均匀最近舍入,每个元素的误差不超过半个步长。如果一个 group 有 个元素,把这些误差平方相加再开根号,就有
若进一步假设 ,取期望后就得到一个与残差 Frobenius 范数成正比的上界。论文使用了不含 的较松系数,思路相同。对分组量化,应该先对每一组应用相应界,再合并各组平方误差。
但这里有一个不能跨过去的逻辑台阶:SVD 最小化的是整体 Frobenius 残差,未必最小化每组最大值,也不保证不同候选残差的常数 保持不变。更不用说最终层输出还受到输入分布加权。因此,这个论证能解释为什么降低残差能量值得尝试,却没有证明 SVD 得到了最优的最终量化模型。
附录的高斯例子还有一个细节值得修正。对 个中心高斯变量的绝对值最大值,用一般的最大值估计时可把正负两侧视为 个变量,从而采用 这一安全界。论文直接用了 ,在 时右边为零,显然不能作为一般结论。结合 ,可以得到充分常数 。这个修正不推翻方法,但提醒我:分布假设和常数应写清楚,而且学习到的残差并没有自动满足独立同分布高斯条件。
5. SVD 的最优性到底到哪里为止
设 ,奇异值按从大到小排列。截取前 个方向,可写成
为什么尾部能量等于误差?不同奇异方向对应的秩一矩阵在 Frobenius 内积下正交。减去前 项以后,剩余项的平方范数正好相加。截断 SVD 在秩不超过 的矩阵中,给出了最小的未加权 Frobenius 残差。这是明确的数学最优性,但目标是矩阵近似,不是生成图像的偏好分数。
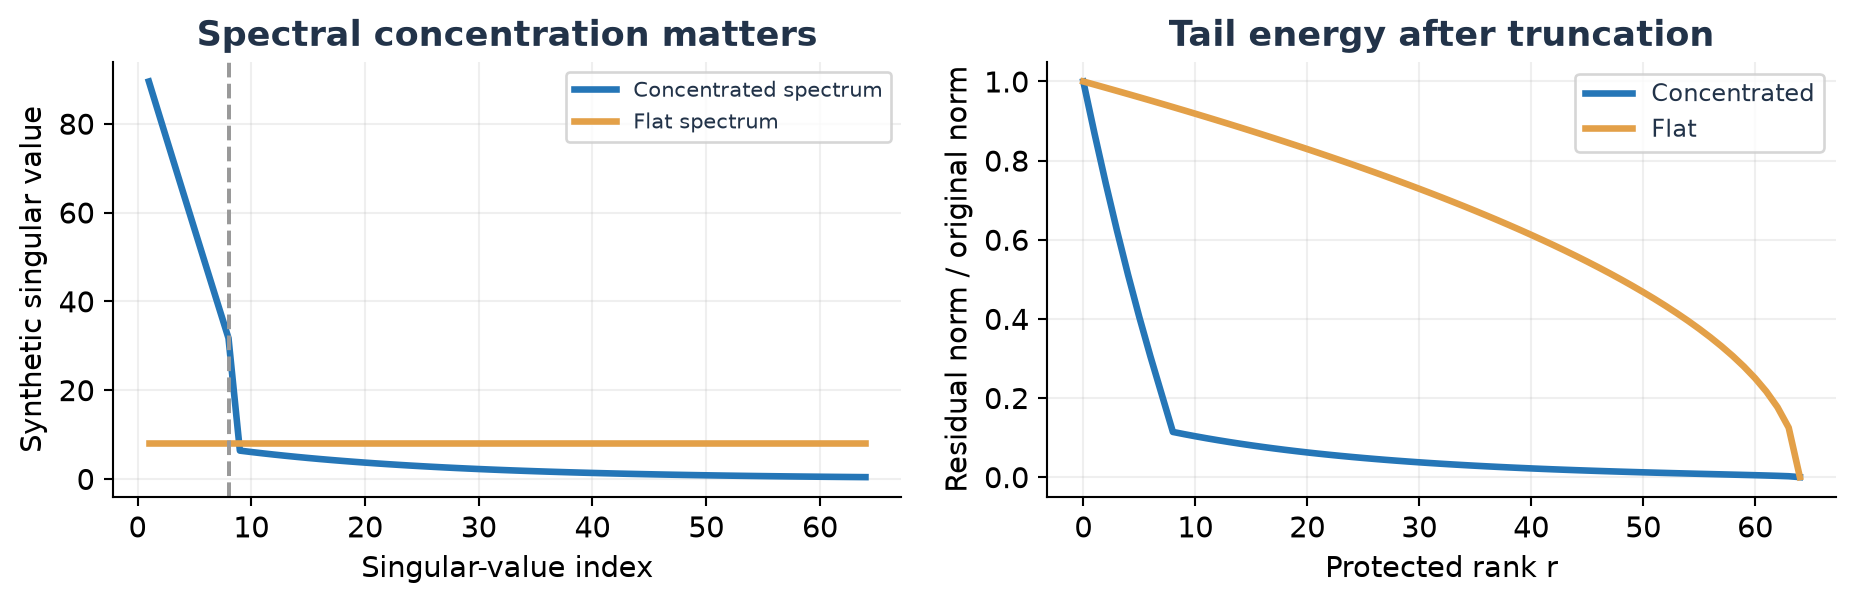
图 3(自行绘制的解析示意):左边构造集中型和近乎平坦的奇异值谱,右边计算保留不同秩后剩余的归一化尾部范数。数据是用于解释的合成谱,不是从任何模型提取的实测值。
集中型谱的大部分能量由很少几个方向承担,保护这些方向很划算;平坦谱则不同,增加几个保护方向只能拿走很小一部分能量。SVDQuant 的直觉是,经过异常值迁移以后,权重中需要高精度的部分往往更加集中。这个观察可以解释它的成功,也同时提示它可能失效的矩阵结构。
这和“先量化,再低秩修补误差”不是相同次序。如果舍入误差已经铺散在很多方向里,低秩补偿就不一定抓得住。SVDQuant 优先提取原权重中有结构的高能成分,然后才量化残差。论文关于 LoRC 和其他变体的消融,就是在说明先后顺序对四比特质量的影响。
实际方法还不止一次 SVD。正文描述了进一步交替更新:对目标权重减去已量化残差的矩阵做分解,重新调整残差,多轮中保留误差最小的结果。统一到平滑坐标后,应当理解为针对 更新保护分量。附录还说明,残差权重量化使用 GPTQ。因此,把论文实验简单归结成“SVD 加普通最近舍入”,会遗漏实际使用的重要组成。
算法 1:构造一个有低秩保护的量化层
下面按论文描述整理概念流程,不把未明确给出的候选网格或迭代次数写成作者的默认设置。
1. 从校准去噪轨迹收集有代表性的层输入。
2. 遍历候选迁移强度 alpha,构造 D、X/D 和 D*W。
3. 对变换后的权重计算秩 r 的截断 SVD。
4. 用变换后的权重减去低秩乘积,得到残差。
5. 按选定格式、分组和校准方法量化残差。
6. 可用变换后权重减去 Q(残差),更新保护因子。
7. 重新计算残差,保留已经评估过的最佳候选。
8. 根据校准层输出误差选择 alpha 与低秩因子。
9. 保存因子、残差编码、scale 及坐标变换信息。
交替更新不意味着全局最优。量化有不连续的舍入边界,某次因子调整可能降低矩阵重建误差,却让一批残差元素越过编码边界,最终层输出误差反而变大。保留实测最佳候选是合理做法,但更完整的报告还应区分:选择平滑参数的目标、选择迭代结果的目标和最后评价图像的目标,三者是否一致。
这里也需要区分校准与完整训练。方法不要求重新进行全模型量化感知训练,但它不是无数据方法。校准输入决定了缩放参数和残差量化的适配范围。提示词多样性、时间步覆盖和 guidance 设置都影响结果,不应当被当成无关紧要的准备工作。
6. Nunchaku:计算只多一点,为什么延迟能多很多
6.1 小的是中间维度,不是所有张量
保护分支依次计算 和 。它相对于原始稠密乘法的乘加量为
如果权重是 ,保护秩为 32,额外乘加量只有 1.5625%。这是我用公式得到的示例,不是论文某层的实测数字。直觉上似乎应当几乎免费,但这个直觉把算术量误当成了总时间。
降维乘法依然要读一个 的高精度输入,升维乘法依然要产生一个 的输出。秩变小,并没有让这两个大维度跟着缩小。如果独立执行两条分支,就可能重复读取输入、分别写出结果,再额外执行相加。小矩阵乘还可能达不到高吞吐,kernel 启动开销的相对占比也会更高。
论文特别讨论了 QKV projection:升维输出较大,超出缓存可容纳范围时,额外的 DRAM 读写会更明显。因此,“只增加很少 FLOPs”和“只增加很少时间”之间,并没有天然的等号。这是我认为本文最适合迁移到其他工作中的系统经验。
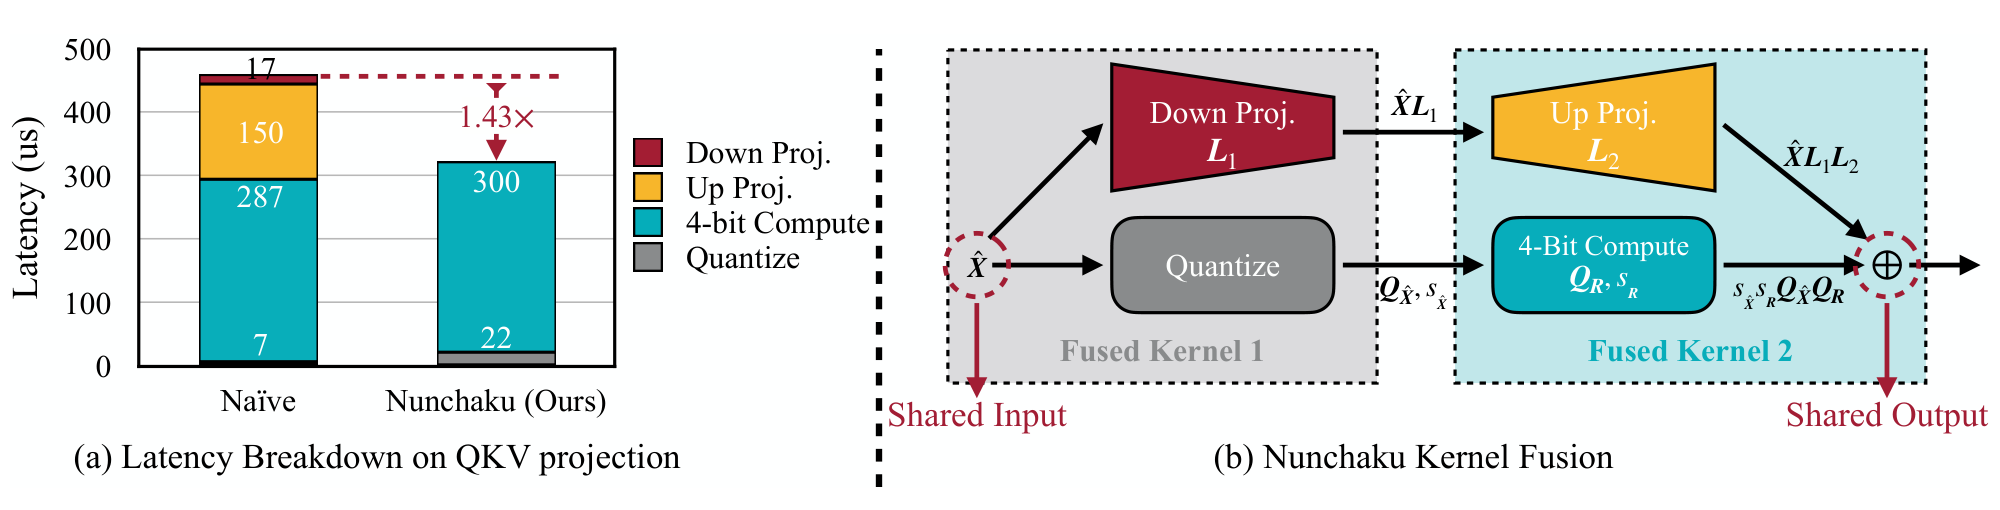
图 4(论文图 6):降维分支与激活量化共享输入,升维分支与四比特矩阵乘共享输出。图中的 57% 是所展示投影实验的额外开销,不能直接当成完整模型的统一比例。
Nunchaku 的思路是按共享的大张量配对。第一组融合读取一次高精度输入,同时做低秩降维和激活量化;第二组融合把四比特主分支结果与低秩升维结果在写回前合并。小的中间张量 仍然需要传递,融合并不意味着所有中间存储都消失了。
算法 2:按共享张量组织融合执行
以下伪代码说明论文 4.3 的数据流,不假定某个具体线程布局、寄存器安排或指令调度。
1. 读取平滑后高精度激活的一个 tile。
2. 复用该 tile,计算低秩降维结果 Z。
3. 对同一 tile 做量化,输出低比特激活和 scale。
4. 读取主分支所需的残差权重与低比特激活。
5. 累加低比特矩阵乘结果并应用对应 scale。
6. 从 Z 和第二个因子计算高精度升维结果。
7. 在写回之前合并两条分支的贡献。
8. 执行该层周围模型所要求的普通输出处理。
这种配对方式十分自然,但能否高效实现仍取决于硬件和形状。更大的保护秩、更多 LoRA、不同 batch 或输出维度,都可能改变寄存器压力、共享内存占用和执行效率。正文报告的约 5%-10% 分支开销,应当放在对应实验安排里理解,而不是为任何输入形状作保证。
6.2 再算一次存储账
只计四比特稠密残差和十六比特低秩因子,忽略 scale、对齐、bias 和其他模型张量,权重字节数相对于 BF16 的比例是
同样采用宽度 4096、秩 32 的例子,比例为 26.5625%,理想压缩倍数约为 3.76。这已经不是简单的四倍,因为还要付保护因子的成本。若继续加入 scale 和保留高精度的部分,实际压缩率还会变化。
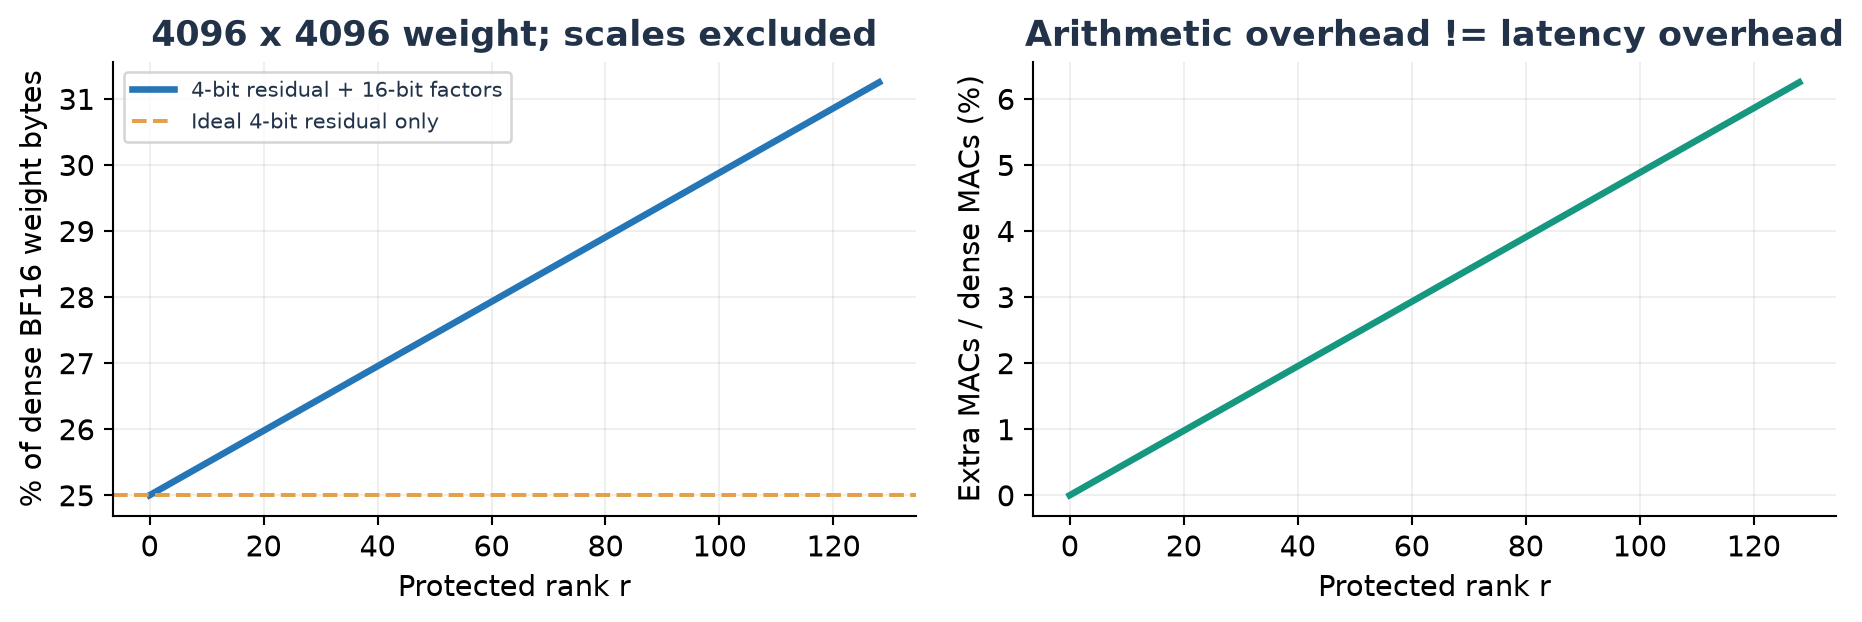
图 5(自行计算):方形 4096 维权重在不同保护秩下的存储与乘加比例。这里只是字节和运算计数,不包含 scale 与其他模块,也不预测真实 GPU 时间。
论文报告 FLUX transformer 从 22.2 GiB 降到 6.1 GiB,后者包含约 0.3 GiB 的低秩分支。直接相除约为 3.64 倍,与正文的约 3.6 倍模型大小下降相符。推理峰值显存约下降 3.5 倍是另一种统计口径,还包含激活、工作区等运行时因素。
我会避免把“6.1 GiB 模型”写成“任何推理只需 6.1 GiB”。文本编码器、VAE、分辨率、batch、临时空间和内存分配行为都可能影响最终显存。模型权重能放进去,只是部署成功的一个条件,不代表整个生成管线在同样预算内一定能执行。
7. LoRA 为什么可以不重新量化就接进来
假设一个 LoRA 更新为 ,其中 为 、 为 。在平滑后的坐标里,它对应 ,而不是直接把 原样塞进去。把它与原来的保护分支拼接,可得到
LoRA 的强度系数可以吸收到一个因子里。这样一来,原先已经量化的残差 不必因为增加适配器而重算,适配器贡献进入高精度路径。这个等式也说明,坐标变换不能漏掉:平滑输入乘未经变换的 LoRA 因子,通常不再等价于原始适配器。
新的拼接秩最多为 。如果两个子空间有重叠,真实数学秩可能更低,但若自动再截断回 ,就又引入了一次近似,不能同时宣称完全保持适配器的作用。多个 LoRA 一起使用时,成本也会继续增加。因此“不重新量化”首先是模块化能力,不是无限免费地叠加适配器。
论文展示了 Realism、Ghibsky Illustration、Anime、Children Sketch 和 Yarn Art 五类社区 LoRA,并在附录补充更多图像。这些例子支持了接入现有 LoRA 的可行性,但没有覆盖所有适配器、任意强度或各种组合。适配器可能改变后续激活分布,保护了当前加法分支,并不意味着整张网络里其余的低比特误差都消失。
从部署角度看,我更看重这种设计将模型残差和用户适配器解耦:不同用户可以共享主模型,而不必为每个适配器重新量化全部权重。它是否同时满足预期吞吐,还要根据适配器数量、秩和并发形状单独评估。论文给出了很好的起点,而不是所有多租户场景的完整答案。
8. 先读实验条件,再读加速倍数
论文评估了几种差异明显的模型:50 步 FLUX.1-dev、4 步 FLUX.1-schnell、20 步 PixArt-Sigma、20 步 SANA-1.6B、30 步 SDXL 和 4 步 SDXL-Turbo。这组覆盖包含 DiT 和 UNet,也包含普通多步生成与少步蒸馏,因而比单一模型的成功更有参考价值。不过,它仍然是这些图像生成设置上的证据,不自动覆盖其他扩散任务。
校准使用 COCO captions,评价使用从 MJHQ-30K 和 summarized DCI 分别抽取的 5,000 个提示词。sDCI 是把很长的人工图像描述压缩到 77 个 token 的版本,所以不能把这组结果理解成“保留原来上千词复杂描述的理解能力”。校准集与评价集分开是优点,而评价文本如何处理,也决定了结论覆盖的范围。
附录 D 给出的八比特设置使用秩 16,激活按 token 动态量化,权重按 channel 量化。四比特设置采用秩 32,激活与权重都分组量化。INT4 的 group size 为 64,scale 是 16-bit;NVFP4 的 group size 为 16,scale 是 FP8。残差权重使用 GPTQ。这些条件应当和结果一起记录,不能只写一个 W4A4 标签。
还有明确的高精度例外。FLUX 自适应归一化相关线性层的输入保留十六比特,因此这些层采用 W4A16;其他模型的 cross-attention key/value projection 保留十六比特,作者给出的理由是它们只占不到 5% 的运行时间。这样的选择很合理,但说明“四比特模型”描述的是主要计算路径,不是网络里所有张量和乘法都只有四比特。
评价指标也应分成不同问题来读。FID 衡量生成分布与参考图像分布的距离,越低越好;ImageReward 是学习得到的偏好代理,越高越好,但它不是人工盲评;LPIPS 比较量化图像与对应高精度图像的感知距离,越低越好;PSNR 则衡量数值接近程度,越高越好。
一张量化图像可能和原图不完全一样,却得到不错的分布指标。反过来,高 PSNR 也不能保证对象数量、文字拼写或空间关系正确。我认为使用多种指标是必要的,而当它们不一致时,应该承认不一致,不要挑一个最有利的数值概括全部质量。
9. 对着表格看:有效,但不是每一项都更好
9.1 FLUX.1-dev:相对 NF4 的进步很清楚
下面摘录论文表 1 中 FLUX.1-dev 在 MJHQ 上的数值。它们是作者报告的结果,并非本次运行模型得到的数据。
| 方法 | FID 越低越好 | ImageReward 越高越好 | LPIPS 越低越好 | PSNR 越高越好 |
|---|---|---|---|---|
| BF16 | 20.3 | 0.953 | - | - |
| NF4 W4A16 | 20.6 | 0.910 | 0.272 | 19.5 |
| SVDQuant INT4 | 19.9 | 0.935 | 0.223 | 21.0 |
| SVDQuant NVFP4 | 20.4 | 0.937 | 0.208 | 21.4 |
比较 NF4 和 INT4 SVDQuant,可以看到即使后者同时量化了激活,ImageReward 和相似性仍更好。LPIPS 从 0.272 降到 0.223,按 复算,相对下降约 18.0%。NVFP4 的 LPIPS 又更低,但 FID 比 INT4 略高,已经展示了“指标不一致”这一事实。
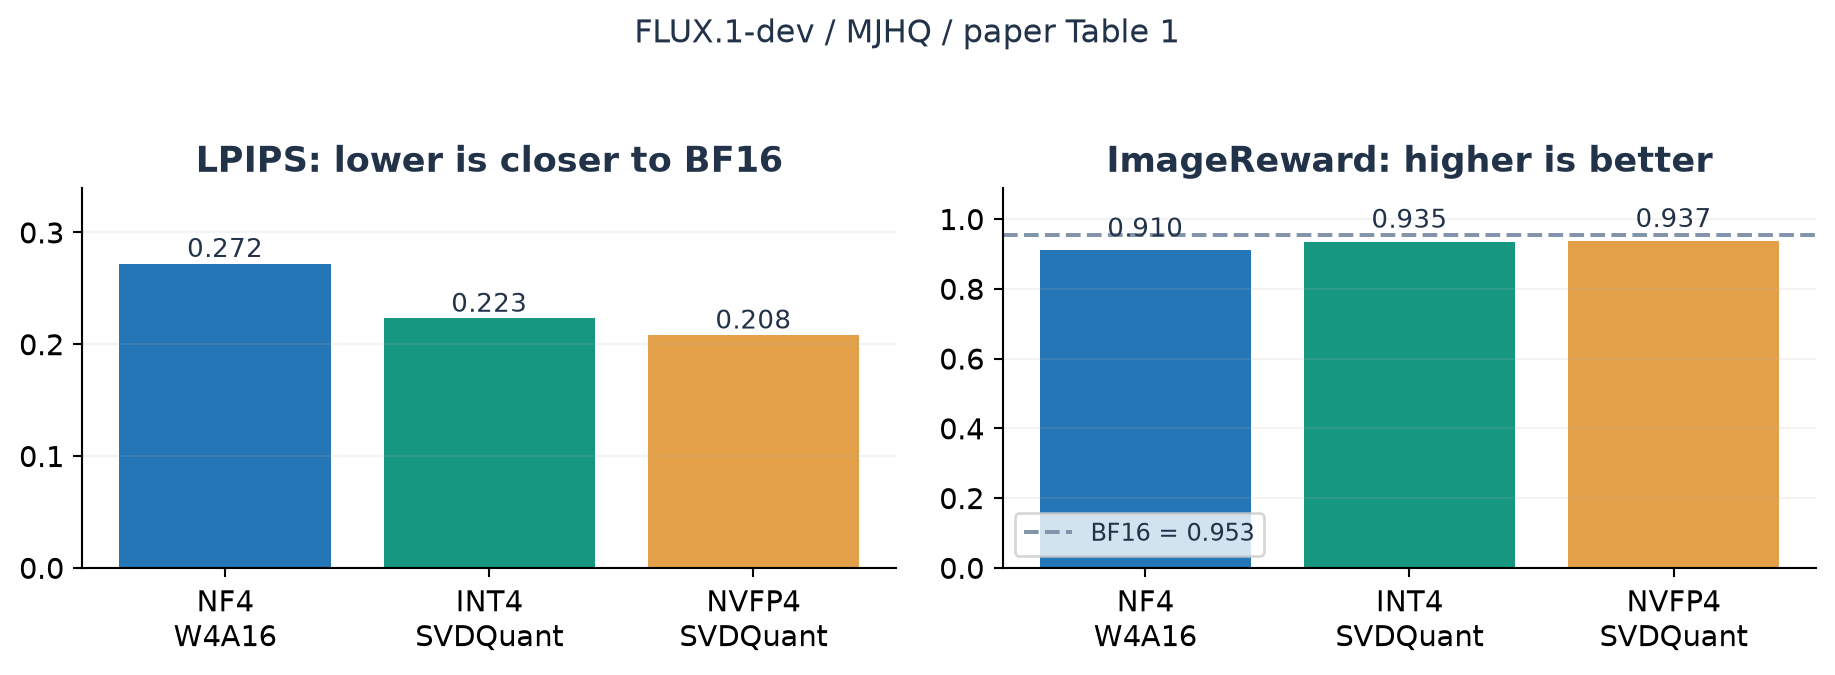
图 6(依据论文表 1 重绘):FLUX.1-dev / MJHQ。右侧虚线是 BF16 的 ImageReward 0.953,可以直观看出 SVDQuant 超过所列 NF4 基线,同时仍未达到 BF16 的这一指标。
这里有一个正文与表格不一致的问题。5.2 节文字说 dev 版本在 ImageReward 上超过原 BF16,但表 1 中 MJHQ 的 0.935、0.937 都低于 0.953,sDCI 的 1.01 也低于 1.02。我以表格为准,不重复更强的文字结论。另一处例外是 schnell 的 MJHQ LPIPS:INT4 为 0.258,NF4 为 0.257,不能说所有指标都优于 NF4。
这些细节不意味着整个方法无效。更合理的结论是,在显著减少计算精度的前提下,SVDQuant 对所测模型保持了有竞争力的质量,并在多项重要比较中优于相应低比特基线。但“小差距”“部分指标略优”和“全面提升”不是同一个说法。
9.2 PixArt-Sigma:低秩分支承担了主要稳定作用
PixArt-Sigma 的结果更能体现保护分支的价值。表 1 中,MJHQ 上 FP16 的 ImageReward 是 0.944,INT4 SVDQuant 为 0.878,NVFP4 为 0.940;两种四比特设置的 LPIPS 分别为 0.323 和 0.271。相对于其他低比特方案,它们很强,但 INT4 与 FP16 之间仍有明确的质量差距。
表 3 把低秩分支和 GPTQ 拆开比较。对 PixArt-Sigma INT4,二者都不使用时 ImageReward 为 -1.226,LPIPS 为 0.762;只加 GPTQ 时是 -0.902 和 0.763;只加低秩分支时跃升到 0.858 和 0.356;二者都用则是 0.878 和 0.323。
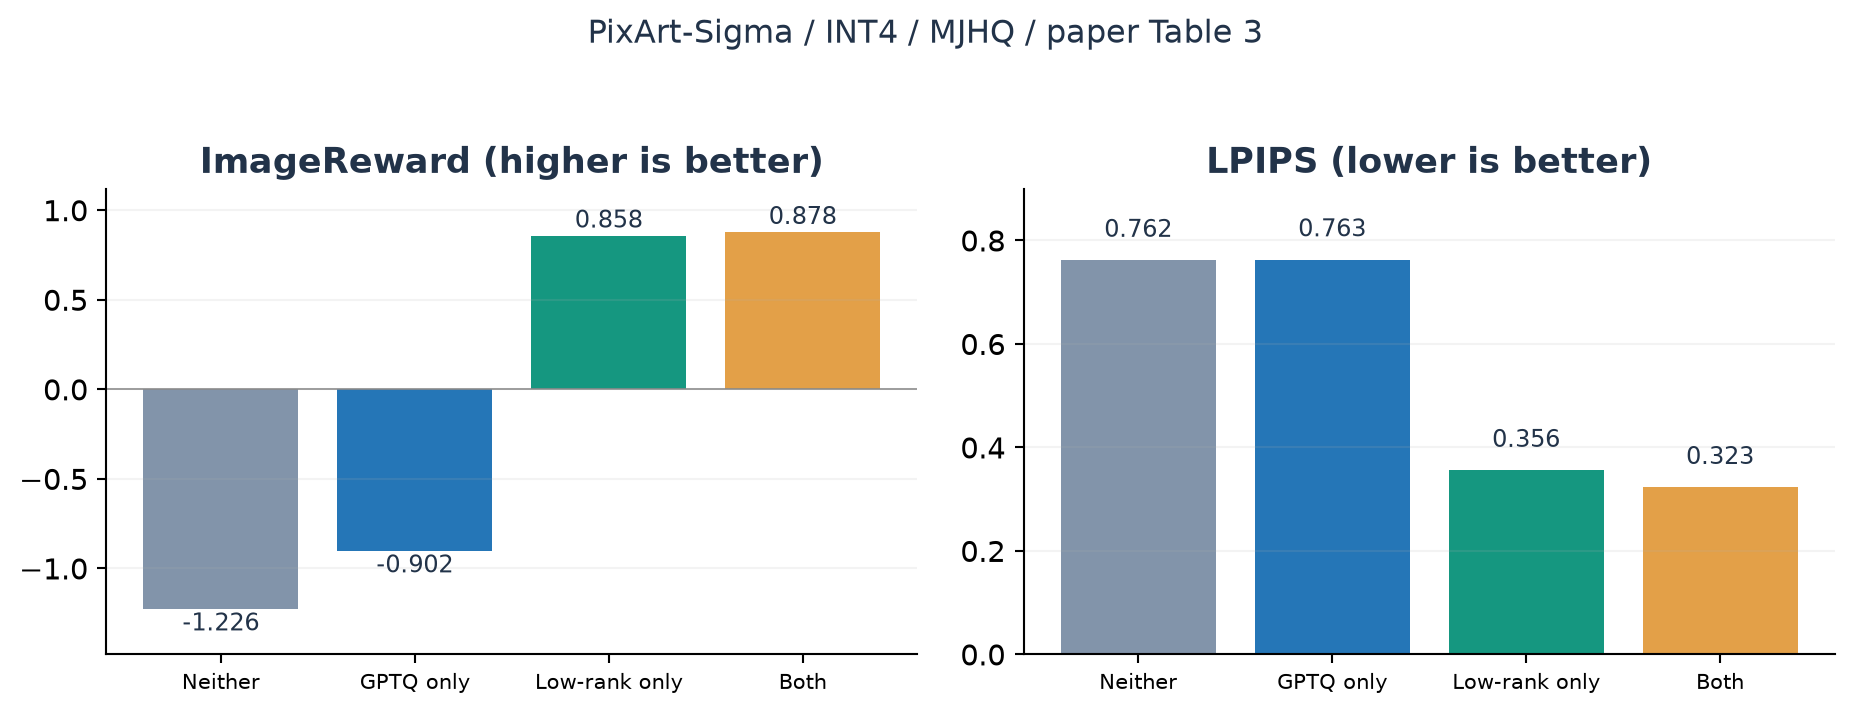
图 7(依据论文表 3 重绘):PixArt-Sigma / INT4 / MJHQ。图中保留负的 ImageReward,没有用截断纵轴隐藏失败配置。低秩保护是这组实验避免崩溃的主要因素,GPTQ 则进一步改善已经可用的近似。
但是,“每多加一个组件,所有指标都会改善”仍然不成立。FLUX.1-dev 的 NVFP4 设置里,只使用 GPTQ、没有低秩分支时,LPIPS 为 0.204、PSNR 为 21.5;两者都使用时则是 0.208 和 21.4,略差一点。与此同时,ImageReward 从 0.936 到 0.937 又略好一点。组件之间的影响需要按模型、格式和指标分别解释。
表 3 还把 schnell 的 BF16 ImageReward 写成 0.968,而表 1 是 0.938,附近文字没有解释这个基线差异。因此我不会把两张表拼在一起算百分比,避免用不一致的基线制造“提升”。需要作者补充采样条件或修正表格后,才能进行更严格的跨表比较。
9.3 延迟:必须写清楚分母是什么
附录表 4 列出 FLUX 单步延迟:BF16 为 657 ms,INT8 为 282 ms,朴素 INT4 为 212 ms,未融合的 SVDQuant 为 250 ms,加上 Nunchaku 后为 218 ms。自行复算可得,未融合相对朴素 INT4 多约 17.9%,融合后只多约 2.8%。
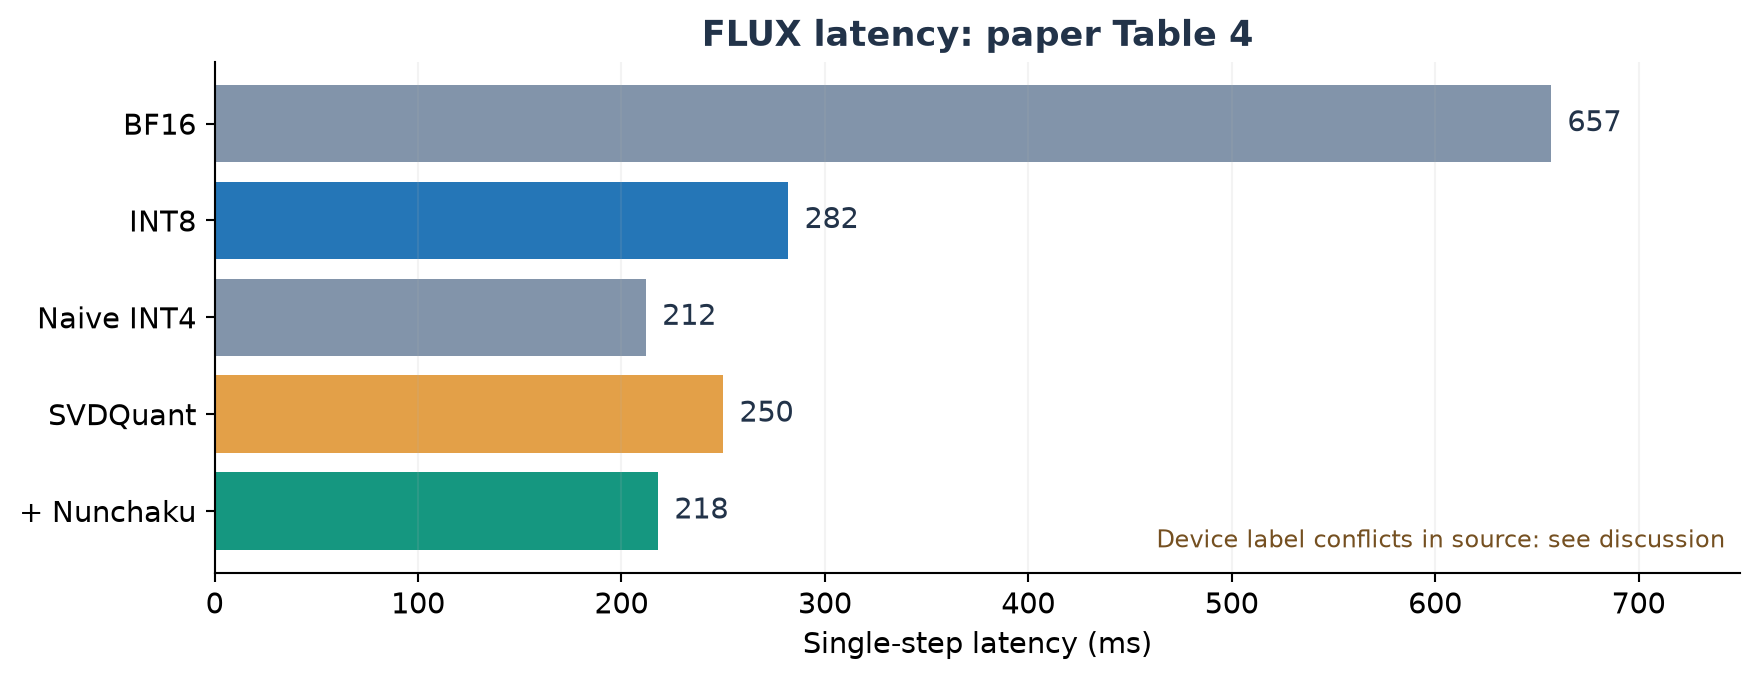
图 8(依据论文表 4 重绘):保留作者给出的单步时间。该段正文称设备为 laptop RTX 4090,表题却称 desktop RTX 4090;笔记不猜测究竟是哪一个,因此这里不作唯一设备归属。
218 ms 相对 BF16 的 657 ms 约快 3.01 倍,相对 INT8 的 282 ms 约快 1.29 倍。它并不是相对朴素 INT4 快三倍,事实上朴素 INT4 的 212 ms 还略快。Nunchaku 的贡献,是让加入保护机制后的速度重新接近低开销的四比特路径,而不是让额外分支神奇地消耗负时间。
论文另有更大的笔记本加速倍数,原因包含避免 BF16 模型逐层 CPU 卸载。把模型从“装不进 GPU”变成“常驻 GPU”,确实具有很大的实际价值,但这属于驻留方式改变带来的收益。它不能和所有权重原本已常驻显存的 kernel 加速混成同一种结论。
原图 1 的约 8.7 倍端到端加速与原图 8 的约 10.1 倍也不应互换。端到端管线还包含文本编码器和 VAE;少步模型中,这些未优化部分的占比可能更显著。用一个简单的 Amdahl 模型表示,如果可加速部分占原时间比例 ,该部分快了 倍,那么
例如 、 时,总加速约为 2.14 倍。这只是用来说明统计口径的算例,不是我对论文数据拟合出的结果。它提示我,每一个倍数旁边都应该有模型、设备、运行范围和基线驻留状态,而不仅仅是一个醒目的数字。
10. 秩、位宽和校准是需要共同选择的参数
论文默认使用秩 32,但附录 E.5 比较了 PixArt-Sigma 的秩 16、32 和 64:提高秩通常能改善质量,同时增加参数和延迟。正文图 10 的定性消融使用了秩 64,不能把它的图像直接当成默认秩 32 的展示。
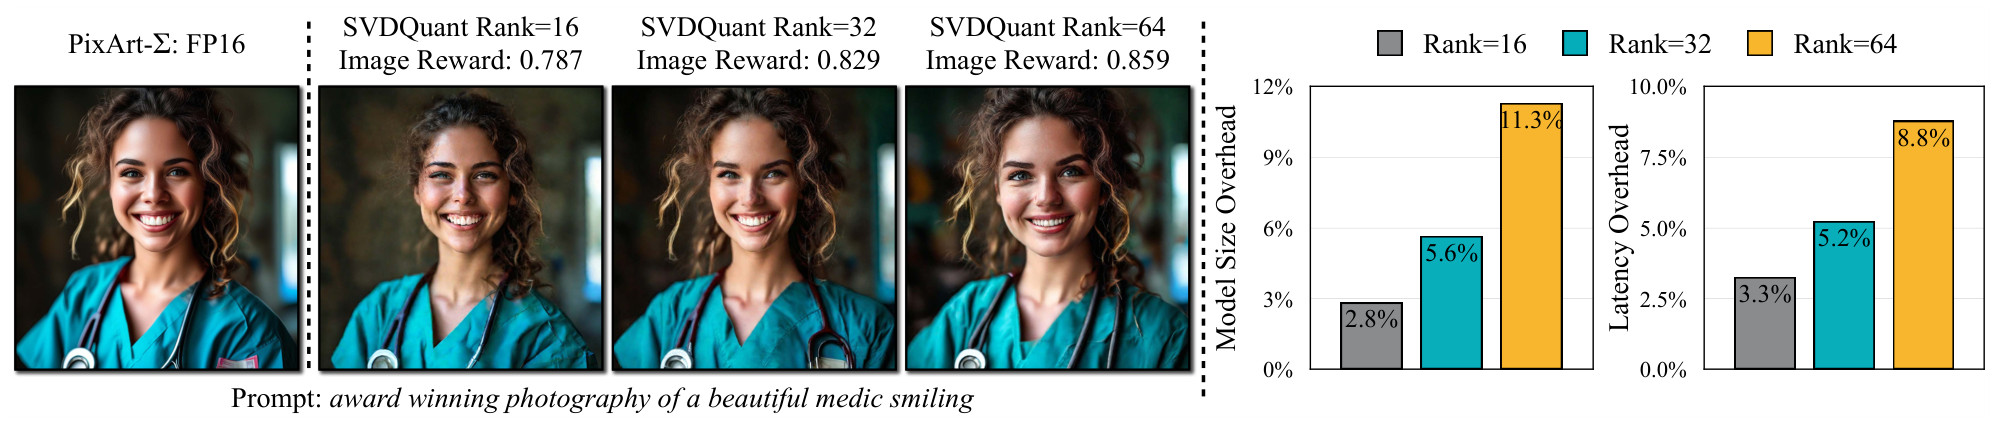
图 9(论文图 18):PixArt-Sigma 在不同保护秩下的图像、参数与延迟代价。它展示的是质量与成本的取舍,没有证明每一层、每个模型都应使用相同秩。
在未量化的矩阵近似里,提高秩一定减少 SVD 尾部范数;在完整量化生成里,最终指标却不必严格单调。残差的分组刻度、迭代校准选择、有限精度因子和去噪误差传播都可能改变结果。所以我会把秩视为一项资源分配,而不是“越大越保险”的简单开关。
统一秩的优点是部署简单,形状规整,也便于设计融合 kernel。逐层分配不同秩可能获得更好的质量成本曲线,但如果只按参数数量分配,仍可能忽略真实延迟:有些形状增加一点秩就跨过资源占用阈值,实际成本并不是线性的。
附录 E.6 还探索了三比特和更低位宽。作者报告,在所测条件下三比特仍能生成图像,W2A4 或 W4A2 则不能。这是数值可行性探索,不代表三比特已经具有与 INT4 / NVFP4 相同的硬件加速路径。能用模拟量化生成图像和有快速实际算子,是两种不同证据。
另外,位宽扫描在高于四比特时使用 per-channel,四比特及以下使用 group size 64。它适合比较一组实用配置,却不是只改变位宽的单变量实验。读者如果想区分位宽本身的影响,应保持分组、scale 精度和保护秩一致,或明确报告这些因素同时变化。
算法 3:我会怎样组织后续受控实验
这是建议的实验设计,未在本次笔记中执行。它关注方法和测量条件,不涉及仓库内部实现对照。
1. 固定模型、采样器、步数、分辨率、提示词、种子和 guidance。
2. 将校准提示词与评价提示词分开。
3. 记录全部高精度例外、保护秩、分组与 scale 格式。
4. 同时测成对图像相似性、分布质量和提示词正确性。
5. 分别报告 denoiser 单独延迟与完整管线延迟。
6. 将 GPU 常驻基线与 CPU 卸载基线分开。
7. 在相同评价集上扫描保护秩与低比特格式。
8. 重复计时,记录预热、波动和峰值显存。
9. 给出质量、显存和延迟的联合曲线,并注明例外。
11. 局限与失败边界
第一条边界是谱是否足够集中。如果被迁移到权重的困难分散在很多方向里,秩 32 的分支就未必能保护足够多的信息。这个问题不只取决于权重大小,还取决于通道结构与输入分布。一个在校准集上很合适的缩放,也可能在新的提示词、时间步或更强 guidance 下暴露出未覆盖的异常值。
第二条边界是局部目标和全局生成目标不同。Frobenius 范数不包含下游任务对不同方向的敏感性,层输出 MSE 虽然更接近实际计算,也不等于人类偏好或提示词正确性。论文通过完整图像评估提供经验支持,但不能因此把局部误差上界升级成整个生成过程的质量保证。
第三条边界是硬件路径。INT4 和 NVFP4 的收益取决于相应低比特算术支持,Nunchaku 的两组融合还取决于形状、布局和资源占用。论文测得的 NVIDIA 设备结果不能直接套到另一种 GPU 或其他加速器。随着 rank、batch、LoRA 数量上升,原本很便宜的保护分支也可能不再容易融合。
第四条边界是评价覆盖和统计不确定性。防止 PixArt INT4 崩溃这样的巨大改善很明确;但 0.257 与 0.258 这样的小差异,没有波动估计就不适合做强排序。示例图能说明“会发生什么”,却不能说明“多大概率发生”。不同类别失败是否被平均指标掩盖,也值得进一步检查。
最后,W4A4 的标签容易让读者低估混合精度的作用。保留高精度的层、scale 和低秩分支本来就是方案的一部分。它们不是需要隐去的例外,而是理解质量和速度来源所必须保留的条件。实际部署时,最好给出完整精度分配,而不仅是一个模型名称后缀。
12. 批判性分析:我认为最值得继续做的四件事
12.1 用输出敏感性与实测代价分配保护秩
统一秩让算子形状简单,但各层的谱和下游敏感性不相同。一个自然改进,是在少数离散秩候选中进行逐层选择,同时看输出误差和融合后的实际延迟,而不是只用参数预算。比较时应控制相同峰值显存、相同 denoiser 时间,并保持校准集不变,否则无法分辨收益来自更好分配还是更多资源。
我不会仅凭“各层 MSE 之和更低”就宣布成功。应当沿完整去噪轨迹测试,并加入成对随机种子和困难提示词类别。某一层权重范数不大,误差却可能被后面的步骤放大;另一层即使局部误差更大,也可能对最终图像影响有限。这种敏感性差异,才是逐层分配真正想利用的信息。
系统成本也需要真实测量。秩从 32 增到 48,在数学上只是多算一点;在某个 kernel 中却可能触发寄存器占用或并行度变化。一个只对 FLOPs 线性建模的分配器,可能把预算分到数值上合理、执行上很差的位置。本文已经说明算术与搬运不能混淆,后续优化也应遵循同样原则。
12.2 把数值格式、分组粒度和保护机制拆开
本文 NVFP4 使用的组比 INT4 更小,因此观察到更好质量并不能单独确定 FP4 网格的贡献。我会先做离线数值层面的组合实验,分别控制格式、group size、GPTQ 和保护秩,再在真正有硬件支持的组合中选择部署方案。
这种研究顺序有一个好处:可以先确认质量机制,再确认系统机制,不必要求每种数值配置一开始就有同样成熟的快速 kernel。最终部署当然仍需真实吞吐,但数值比较和硬件比较承担不同问题,分开设计反而更容易解释结果。
表 3 已经提醒我们,组件之间并不是对所有指标简单相加。某些配置提高 ImageReward,却略微降低与 BF16 的相似性。若同时报告逐层误差、分组范围和完整图像指标,就更容易判断差异发生在局部近似、参数选择还是后续轨迹中,而不是一律解释为“量化噪声的随机性”。
12.3 让理论真正对应分组量化和 FP4
式(8)的代数关系很清晰,但后续范数界是一个替代目标。更完整的理论可以从每个 group 的舍入和裁剪出发,显式加入 scale 的有限精度、高精度因子的舍入,以及 FP4 非均匀网格。这样才更接近实验中使用的量化器。
还应明确常数随残差分布如何变化。对同一个 ,不同分组的最大值分布可能非常不同,因而实际量化质量也不同。与其只引用高斯近似,不如测量每层、每组的最大值与范数比例,看看哪些层满足直觉、哪些层偏离,是否与失败配置相吻合。
附录绝对值最大值的常数修正相对容易处理,但更重要的是避免把“在某种分布假设下有上界”写成“真实模型残差已经满足该假设”。低秩最优性本身没有问题,需要谨慎的是从这一最优性走到实际量化误差,再走到最终生成质量的两次推断。
12.4 先把证据对应关系理顺,再强化结论
本文里有几处可以具体修复的地方:平滑权重的乘法顺序、dev ImageReward 的正文表述、schnell 的跨表 BF16 基线,以及附录表 4 的 laptop / desktop 标签。单个问题不大,但加在一起,会让读者难以判断哪一句结论对应哪一个实验条件。
我希望看到一份与版本绑定的结果表,让每张图、每组数值都能对应模型、采样器、提示词集合、随机种子、rank、格式、设备和计时范围。特别是 GPU 常驻和 CPU 卸载应分开报告。这样既能保留“模型装进显存”的实际价值,也能让读者判断“计算本身快了多少”。
此外,可以加入一个简短的生成错误分类:漏掉对象、文字损坏、结构畸变和空间关系错误。平均 FID 或 learned reward 可能对这些类别不够敏感。真实应用关心的不只是平均质量是否接近,还包括低比特方案是否新增了一类难以接受的错误,以及这类错误的发生频率。
这些批评不会改变我对核心方法的正面判断。SVDQuant 最有说服力的地方,是没有停留在“理论额外计算很少”,而是继续把额外分支在硬件上最贵的读写找出来,并给出相匹配的融合方案。上述改进主要会让适用边界、机制归因和实验结论更清楚。
13. 结论:把高精度用在少数真正困难的方向上
SVDQuant 可以理解为一个精度分配方法:平滑负责迁移困难,SVD 负责挑出紧凑的主导成分,四比特残差负责承担大部分计算,Nunchaku 负责让保护机制不被重复搬运拖慢。每一步都针对一个不同的障碍,少了哪一步,最终质量或速度都可能明显变差。
它最强的证据,是在困难的四比特生成设置里保持可用质量,同时通过融合获得实测速度收益。需要一起保留的条件也很明确:部分计算仍是高精度,校准和 GPTQ 属于实际方法,指标之间并非完全一致,避免 CPU 卸载与更快的矩阵乘是不同来源的加速。
对我自己的研究,最值得迁移的思路是同时在三个层面评价近似:究竟保护了哪个数值子空间,究竟减少了哪些大张量搬运,以及用户最终观察到的生成行为是否保留。只在参数、FLOPs 或某一个质量分数上成功,都还不足以构成完整的高效推理方案。
参考资料
- Li 等,SVDQuant,arXiv v4,重点对应正文第 3-5 节、附录 A-F;全文。
- 作者项目页,用于核实资源入口;本文技术比较以指定论文版本为准。
- 论文提供的官方资源入口:DeepCompressor、Nunchaku。