阅读日期: 2026-09-29
笔记作者: Zhongzhu Zhou
论文: ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models
论文作者: Mingjie Liu, Shizhe Diao, Ximing Lu, Jian Hu, Xin Dong, Yejin Choi, Jan Kautz, Yi Dong
版本: arXiv:2505.24864v1,2025-05-30
1. 我最关心的问题:更常做对,和开始会做,是一回事吗
把一个模型训练得更强,至少有两种直观含义。第一种是原来偶尔能做对的题,现在一次就能做对。第二种是原来尝试很多次也看不到正确答案的题,现在终于能解出来。前者主要改变使用效率,后者看起来更接近“能力边界扩大”。ProRL 研究的正是这两种变化之间的关系。
但这里有一个容易被标题掩盖的细节:“没看到正确答案”取决于看了多少次、允许生成多长、怎样判分,以及输出格式是否被识别。它不是数学意义上的“不可能答对”。如果不先讲清测量条件,关于 RL 是否产生新推理能力的讨论很容易变成不同定义之间的争论。
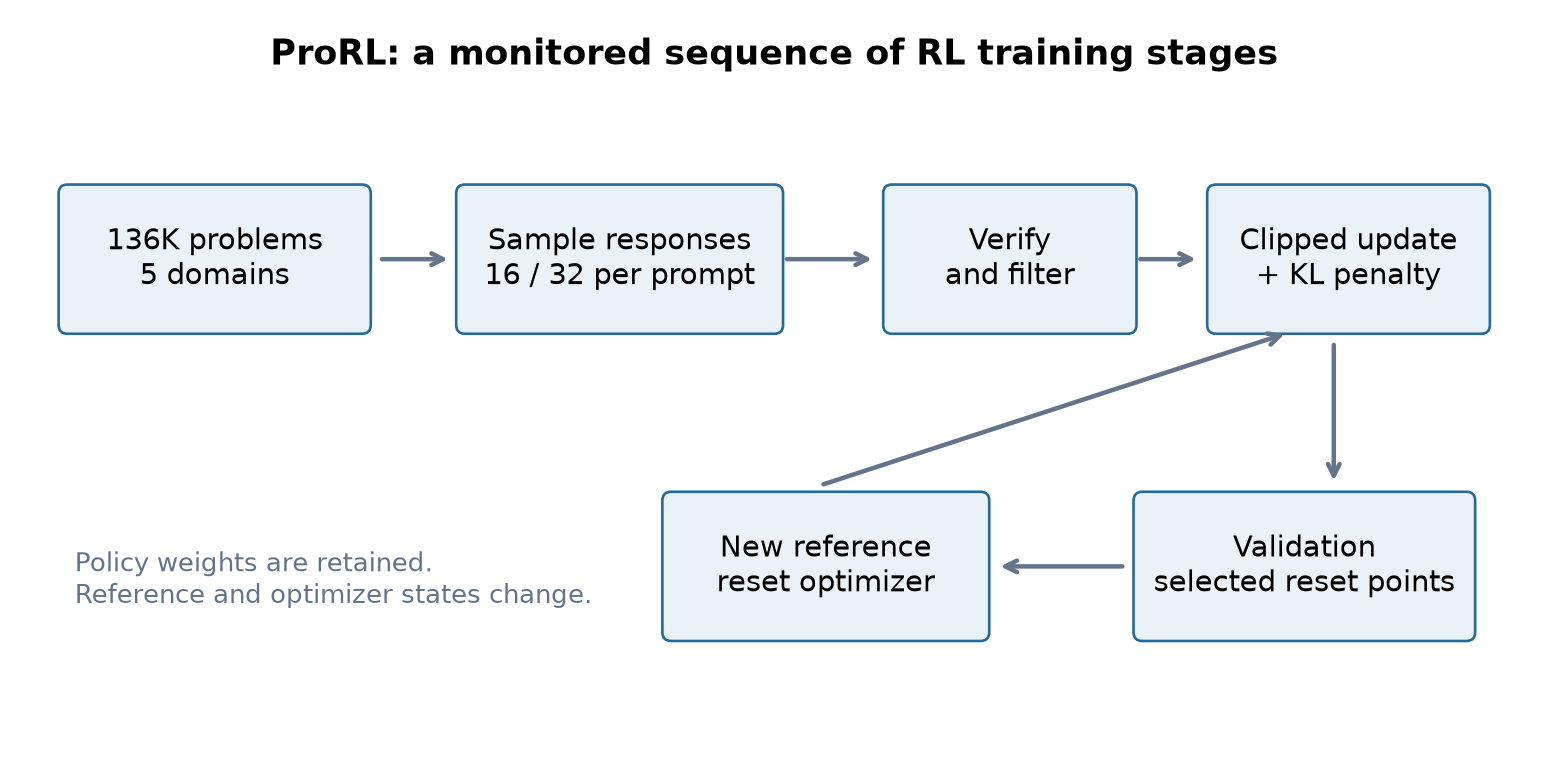
ProRL 从 DeepSeek-R1-Distill-Qwen-1.5B 出发,在五类可验证任务上做超过 2,000 步的训练,经历八个阶段,最后得到 Nemotron-Research-Reasoning-Qwen-1.5B。起点已经经过推理蒸馏,不是未经后训练的原始预训练模型。训练过程中,作者组合了组内相对策略优化、非对称裁剪、动态筛题、KL 正则,以及参考策略和优化器状态重置。
读完正文与附录后,我认为最可靠的结论是:一套经过持续干预的长期 RL 配方,确实能显著提高这个小模型的实测表现,而且某些代码和逻辑任务的高采样预算覆盖率也提高了。 这足以反驳“RL 的任何收益必然以覆盖率下降为代价”这种过强说法。它还不足以单独证明“只要训练更久,就会创造基础分布中完全不存在的推理”。
原因并不抽象。论文自己的曲线就显示,部分数学任务的 pass@256 降低;GPQA 的中间检查点在大采样预算下优于最终检查点;一些逻辑题的低分包含输出格式问题。另一方面,训练中同时改变了数据、采样组大小、终止奖励和上下文长度。把这些事实放在一起,才能知道长期训练真正做了什么。
2. 前置知识:策略、奖励和探索分别指什么
2.1 模型不是一个固定答案,而是答案的概率分布
给定题目 ,把模型生成的回答记作 ,策略参数记作 。自回归生成意味着整段回答的概率,可以分解为每一步条件概率的乘积:
这解释了为什么训练能够改变某条推理路径出现的频率:参数更新同时影响路径上各个 token 的概率。它也提示我们,文本看起来不同不一定代表算法不同;相同算法也可能被写成很多不同的回答。
验证器给出奖励 。如果把奖励视为更新时固定的信号,利用 ,可以得到策略梯度的基本形式:
式(2)只是理解方法的背景推导,不是 ProRL 新提出的定理。高奖励回答会推动相应概率上升,但到底能否发现新解,仍取决于采样有没有提供有效差异、任务之间能否迁移,以及验证器实际奖励了什么。
2.2 可验证,不等于只有一种正确性定义
论文训练数据共约 136K 道任务:数学 40K、代码 24K、STEM 25K、逻辑 37K、指令遵循 10K。数学和 STEM 采用二值奖励;代码按测试通过比例给连续奖励;逻辑和指令遵循也有规则化的连续评分。代码出现语法错误、编译失败或总执行超过五秒时,该设置给零分。
这里描述的是论文的奖励协议,并不是笔记运行模型后得到的验证结果。测试通过率只对应现有测试集;它不保证程序对所有输入都正确。逻辑题的部分得分也不等于完全解题成功。后面讨论 pass@k 时,必须重新明确“成功事件”,不能直接把平均连续奖励塞进二值成功概率公式。
STEM 数据还经过基于 R1 回答和 GPT-4o 一致性判断的筛选。因此,这不是一个没有任何外部知识或强模型参与的数据流程。所谓 RL 阶段的自动验证,与整个训练过程是否依赖蒸馏、数据筛选,是不同的问题。
2.3 探索不能只看温度或文本多样性
温度升高可以让模型采到更多低概率 token,但也可能增加乱码、重复和无效回答。我们真正关心的是:多出来的样本是否包含有用、可学习的成功路径,以及训练后是否仍保留不同题目的可解性。单纯让回答风格变多,不必然增加推理覆盖率。
ProRL 的思路是让训练在高温采样、KL 约束、动态筛题与适时重置之间保持平衡。理解它时,可以把“发现信号”和“利用信号”分开:rollout 决定见到哪些回答,优势估计决定哪些差异值得放大,正则与裁剪则限制更新方式。三者都会影响最后看到的推理能力。
3. 从组内奖励到实际更新
3.1 为什么需要同一道题的多个回答
对于同一题目采样 个回答,得到奖励 。用组内均值和标准差归一化,可以得到相对优势:
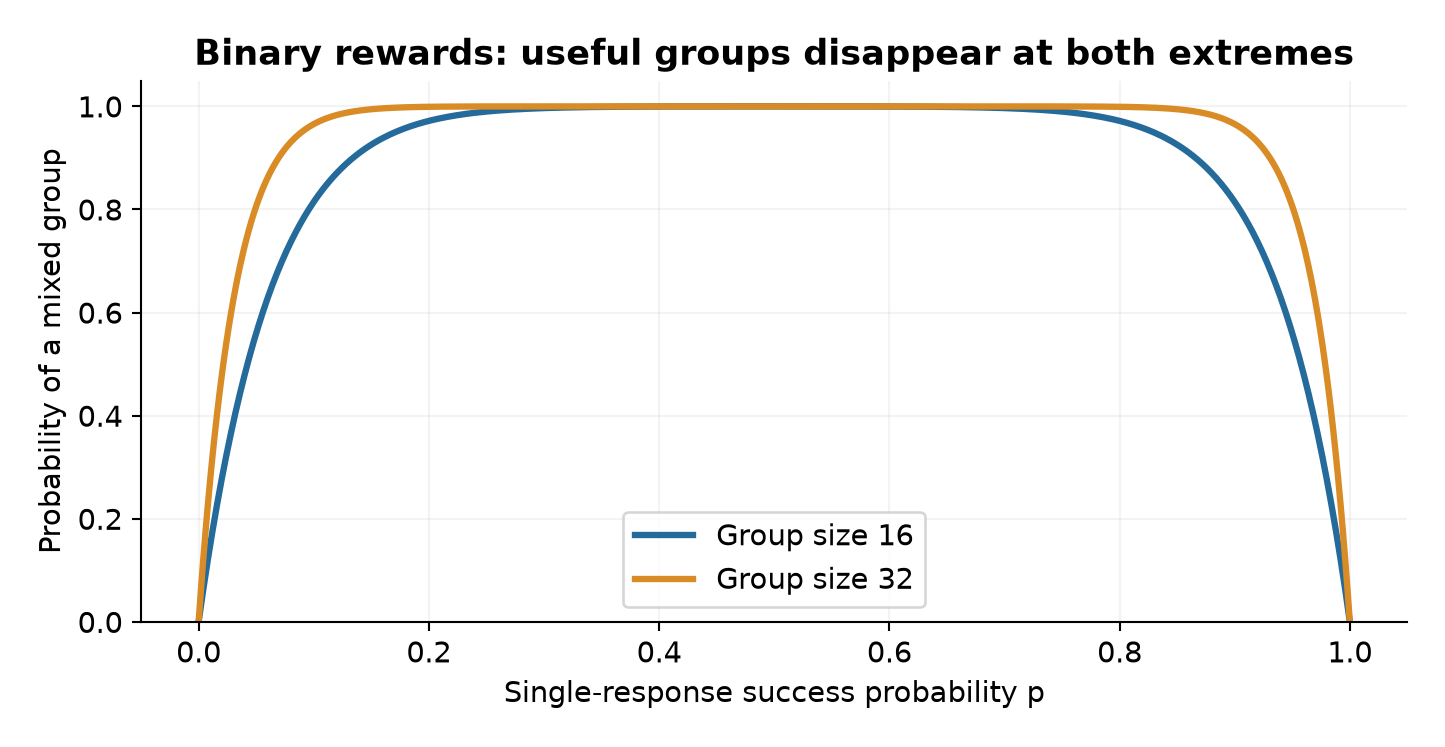
这里的直觉是“比这道题的其他样本更好”,而不是跨所有题目直接比较分数。简单题和困难题的平均奖励可能差很多;组内相对化能降低这种尺度差异。但若所有回答都拿同一个分数,就没有组内对比信号。二值奖励下,全错和全对都属于这种情况。
论文采用动态采样,移除奖励全为零或全为一的组。对于连续奖励,不能把这一描述扩大成作者必然删除了所有同分组;这需要具体协议说明。式(3)中的 用于说明数值稳定性,不能借此推断论文没有报告的常数。
3.2 筛题改变的不只是数据量
先做一个明确的二值、独立同分布采样示例。若某道题每次成功概率为 ,一组 个回答中既有成功又有失败的概率为:
推导很直接:所有可能组的概率为一,减去全失败,再减去全成功。对 的难题, 时约有 14.85% 的组能产生二值对比; 时约为 27.50%。组变大能增加见到稀有成功的机会,但不会让完全采不到有效信号的问题自动消失。
更重要的是,动态筛选会改变优化器实际看到的题目分布。过易题常被过滤,极难题也可能反复采样仍无信号。留下来的通常是当前策略下能产生奖励差异的任务。因此,原始题库的五类数量比例,并不等于最终梯度贡献比例。要比较两个训练方案,最好同时知道过滤率、实际接受的组数与生成 token 数。
3.3 非对称裁剪为什么可能有帮助
令 表示当前策略与采样策略在某个 token 上的概率比,忽略聚合细节后,裁剪目标的核心形式为:
上界更宽,给正优势样本的概率增长留出更大空间。对原本低概率、但拿到好奖励的回答,这有助于避免过早压住更新。不过,这不是一个“所有概率变化都被硬限制住”的约束:最小值分支与优势正负共同决定梯度,参数共享也会影响未直接采到的回答。
论文的配方把这种 DAPO 风格裁剪与 KL 约束一起使用。前者控制相对于采样策略的局部更新,后者控制相对于参考策略的偏离。两个参照对象不应混为一谈。公式也不能替代 token、序列与 batch 的归约规范;不同归约方式可能改变不同长度回答的权重。
算法 1:组内相对更新的概念步骤
1. 从当前任务混合中取题目 x。
2. 用采样策略生成 G 个回答,并保存采样概率。
3. 用对应领域验证器计算每个回答的奖励。
4. 按动态采样规则移除全零或全一组,必要时补采。
5. 计算组内均值、标准差和相对优势。
6. 计算当前策略相对采样策略的 token 概率比。
7. 聚合非对称裁剪目标,并加入 KL 正则项。
8. 完成本轮参数更新,记录采样量和有效组数。
这是依据论文机制整理的教学伪代码,不指定正文未给出的常数,也没有把它写成可复现作者全部训练细节的程序。
4. KL 正则和移动参照:保留学到的东西,改变偏离的代价
4.1 为什么参照模型可能逐渐变成阻力
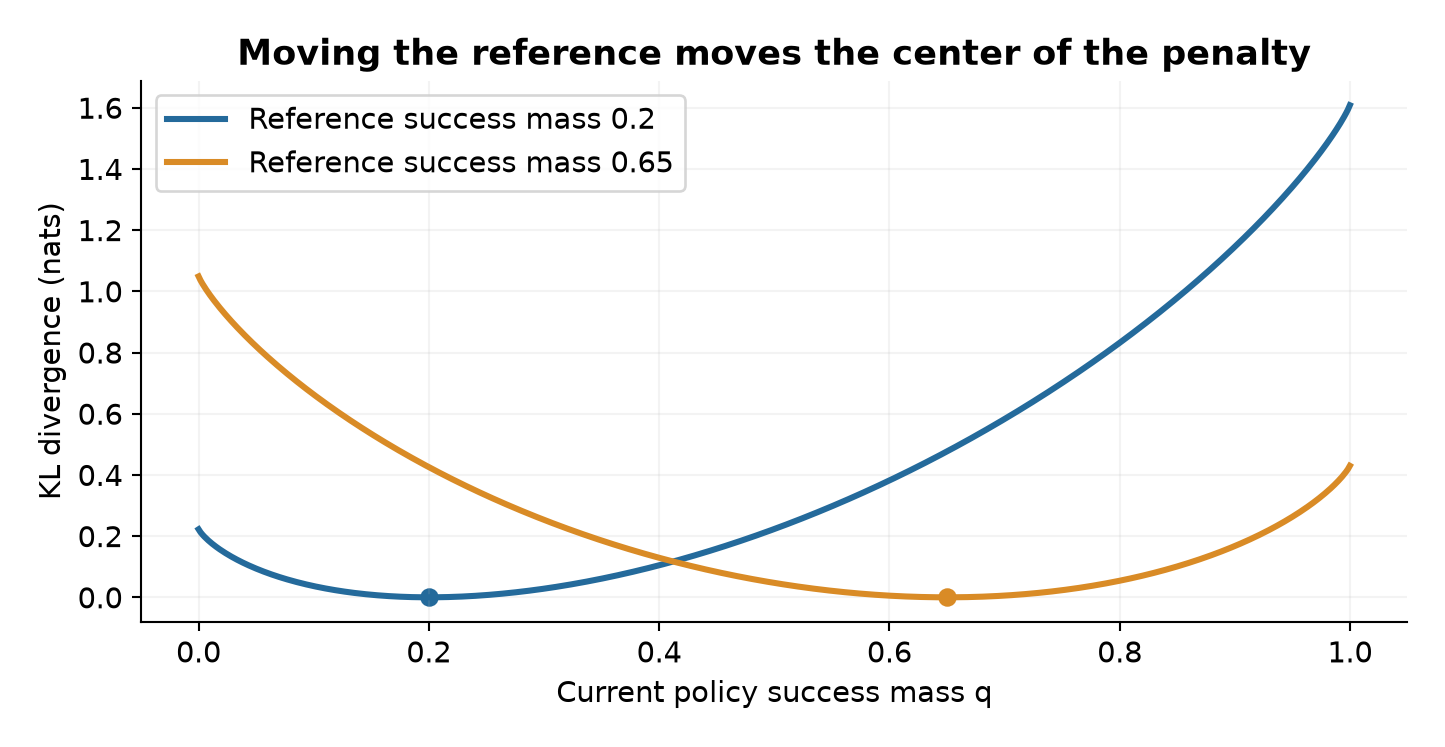
先考虑一个简化的回答级目标。令 为参考分布, 为正则系数:
偏离参照越多,代价越高。这能限制训练早期的剧烈漂移,但如果当前策略已经明显优于老参照,继续提高奖励仍可能需要付出越来越大的正则代价。ProRL 用参考策略重置来处理这种情况。
这里有一个常见误读:加 KL 就等于给模型设定了一个熵下限。展开公式可以看出并不是这样:
右边确实有熵,但同时还有对参考分布的偏好。若参照非常集中,KL 约束也可能鼓励集中。它没有直接规定“熵必须大于某个阈值”。所以,论文用 KL 帮助维持探索是一项经验性的训练设计,不能被改写成无条件的熵保证。
4.2 一个能说明方向的解析例子
在有限回答空间、奖励固定且参考概率非零的理想化条件下,对式(6)加入概率归一化约束并求导,可以得到:
是把所有概率加起来归一化的常数。这个结果说明,奖励会指数式提高某些回答的权重,但提高多少仍受参照 和系数 影响。它不是神经网络实际 GRPO 更新的闭式解,也不表示模型真的枚举所有回答。
如果较好的回答在旧参照中概率很小,惩罚可能很强;把参照更新为已经学好的当前策略,就重新定义了下一阶段“偏离”的起点。图 3 用只有两种结果的分布展示这一点。概率值是解释机制的例子,不是论文实测轨迹。
4.3 重置清除了什么,没有清除什么
ProRL 的 reset 同时更新参考策略并重置优化器状态,保留当前模型权重。概念上可写成:
最后两项表示 Adam 一类优化器的一阶、二阶历史统计重新开始。它们会改变之后的更新行为。因此,即使观察到 reset 后训练改善,也不能只归因于参考模型变化,需要把参考重置和优化器重置分开消融。
另一个边界是:每一阶段相对新参照的 KL 较小,并不说明最终模型相对最初模型的 KL 也小。KL 不是满足三角不等式的距离,不能简单把多个阶段的局部界相加当作全程保证。移动锚点允许持续位移,正是它可能有用、也需要独立监控退化的原因。
算法 2:分阶段训练与参考重置
1. 以已蒸馏的基础模型初始化策略和参考模型。
2. 在当前数据、组大小、长度上限下运行多轮更新。
3. 观察验证表现、奖励、生成长度与异常输出。
4. 若训练计划决定进入重置阶段,保存当前权重。
5. 把参考模型设为当前策略,清空优化器历史状态。
6. 保留策略权重,按该阶段设置继续训练。
7. 保存中间检查点,避免只保留最后一个模型。
论文没有给出一个足够明确、可直接照搬的自动 reset 检测器,也没有在本次阅读文本中清楚给出 KL 系数。因此步骤 4 故意写成训练计划决定,不能把观察者的建议伪装成作者报告的自动规则。
5. 八个训练阶段,比“训练更久”包含更多信息
论文名义训练温度为 1.2,通常每题 16 个 rollout,第 6-7 阶段改为 32。batch size 为 256,mini-batch size 为 64,每轮 rollout 对应四次梯度更新,AdamW 学习率为 。这些数值是报告的配置,不代表所有阶段的 token 成本相同。
正文第 3.2 节把最初长度具体写为 8096,而其他描述使用 8K。这里保留两种原始写法,不擅自把 8096 改成常见的 8192。最后阶段把长度预算提高到 16K。精确比较预算时,应确认这些记号究竟指相同限制还是不同约定。
| 阶段 | 主要变化 | 阅读时应该追问什么 |
|---|---|---|
| 1 | 四个领域,约 8K 长度、16 个回答 | 先建立可用的多任务策略 |
| 2 | 参考与优化器重置,保留长度设置 | 收益来自哪一类重置 |
| 3 | 加入指令遵循,后期出现重复与不结束 | 数据变化和终止行为如何相互影响 |
| 4-5 | 加入针对终止行为的奖励调整 | 分数恢复有多少来自有效输出增加 |
| 6-7 | 组大小变为 32,并继续重置 | 采样成本与有效奖励差异是否同步增加 |
| 8 | 长度改为 16K,组大小回到 16,约 200 步 | 更长推理与更久训练如何区分 |
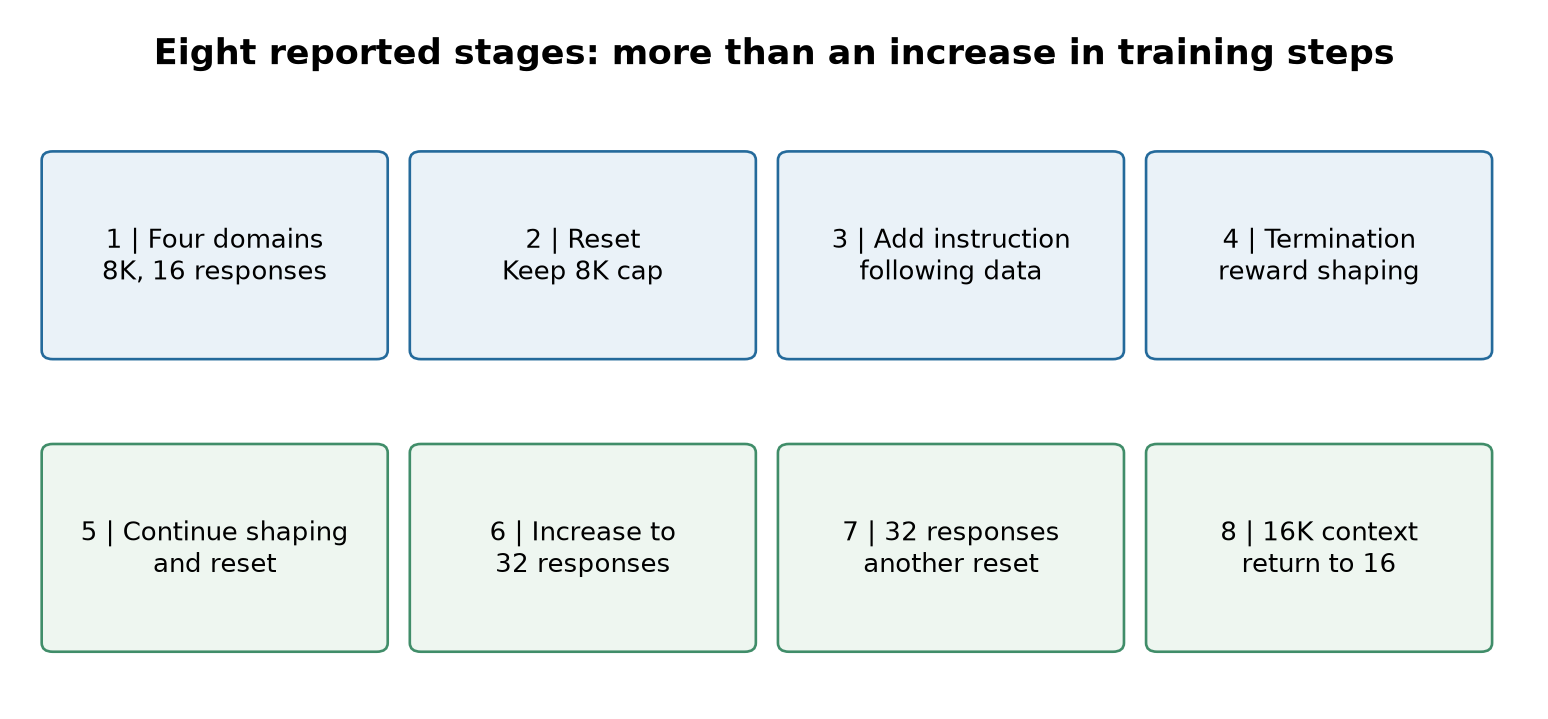
论文给出的总训练步数超过 2,000,相关轨迹约到 2,500 步。不能将这条轨迹当成一个其他条件不变、只增加步数的实验。它更像一份训练维护记录:遇到平台期或重复问题后,调整机制使训练继续产生收益。这种经验很有价值,但它支持的是“整套配方可行”,不是各个部件的独立因果结论。
从工程选择上看,动态采样解决无差异奖励,KL 约束控制漂移,重置更新参照,终止奖励针对重复,较大组增加采到好回答的机会,长上下文允许更长推理。每个设计都有具体目标,也各有失败边界。把它们全部折叠为一个“longer”变量,会丢失最值得学习的部分。
6. 主要实验:收益很大,但不要换着口径读数字
6.1 五个领域的提升分别是什么
主评测使用温度 0.6、top-p 0.95 和 32K 最大回答长度。数学、代码与 STEM 每题采样 16 次,使用二值评测奖励估计 pass@1;逻辑与指令遵循报告平均连续奖励。下面统一沿用论文 0-100 的展示尺度,最后一列是相减得到的绝对分数差。
| 领域或汇总指标 | 1.5B 蒸馏起点 | ProRL 1.5B | 绝对变化 |
|---|---|---|---|
| 数学平均,表 1 | 44.45 | 60.14 | +15.69 |
| 代码平均,表 2 | 23.08 | 37.49 | +14.41 |
| GPQA,表 3 | 15.86 | 41.78 | +25.92 |
| IFEval 平均奖励,表 3 | 44.05 | 66.02 | +21.97 |
| Reasoning Gym 平均奖励,表 3 | 4.24 | 59.06 | +54.82 |
数学从 44.45 到 60.14 是增加 15.69 个百分点,按起点计算的相对增幅约为 35.3%。两种表达都可以,但必须说清楚。对连续奖励指标,直接称为“分数提高”更稳妥,不能把 59.06 理解成 59.06% 的题目完全解对。
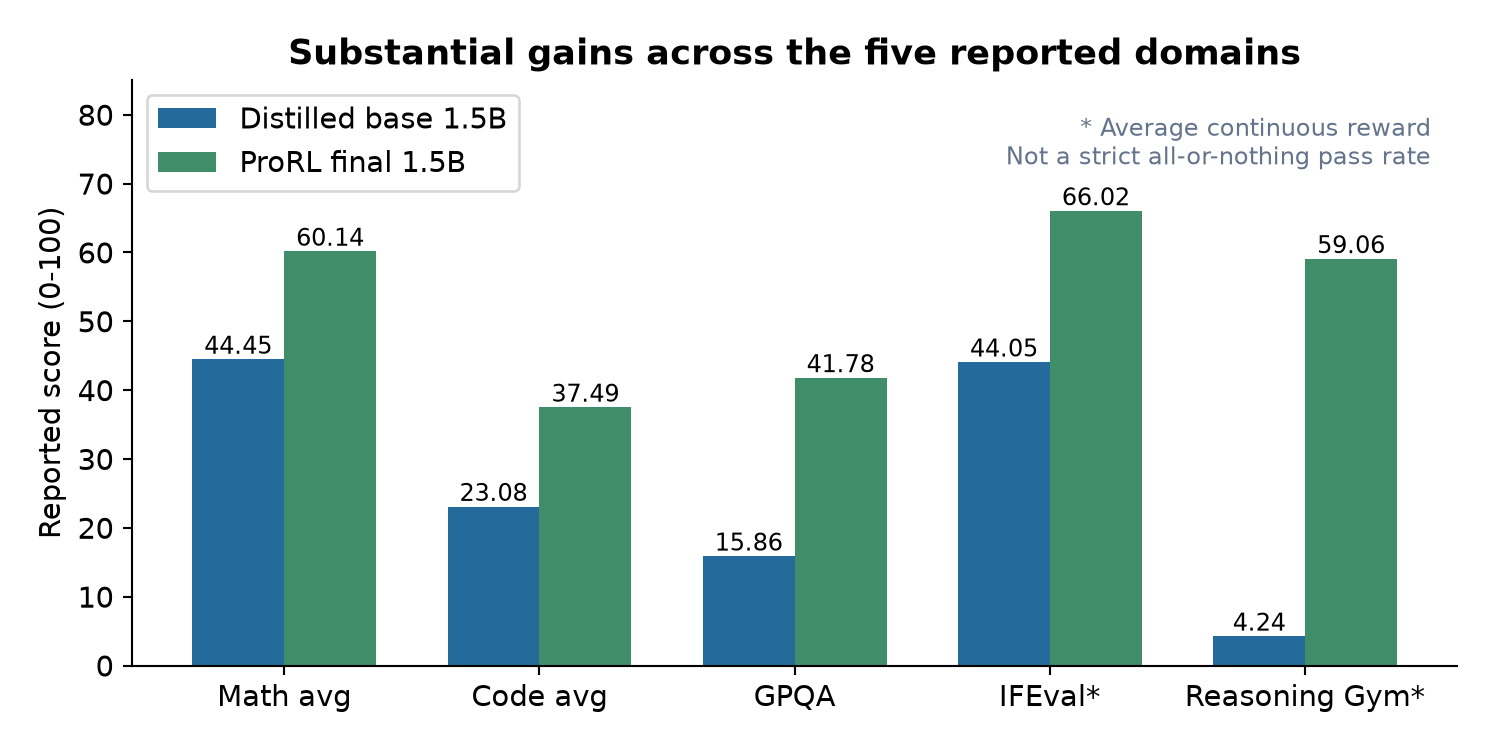
有几处内部不一致值得保留。引言给出的数学、代码、STEM、指令遵循增益分别是 14.7、13.9、25.1、18.1;主表相减则得到 15.69、14.41、25.92、21.97。这里采用表格数值,不把差异默默抹掉。这也不能简单用“百分比和百分点不同”解释,因为数字并不对应那种换算。
6.2 通才平均更强,不等于每项都赢
数学平均 60.14 高于 DeepScaleR-1.5B 的 54.54,差值为 5.60。正文写成提升 4.6,与表格不符。代码平均 37.49 高于 DeepCoder-1.5B 的 30.96,差值 6.53,与正文约 6.5 的描述一致。这些基线体现了模型竞争力,但训练预算和数据分布并未被控制成完全相同。
逐项看,HumanEvalPlus 上 ProRL 为 72.05,低于 DeepCoder 的 73.40。与 7B 蒸馏模型比较,ProRL 的数学平均 60.14 低于 63.19,代码平均 37.49 低于 41.39,而 GPQA、IFEval 和 Reasoning Gym 更高。合理的结论是小模型在多个领域具备很强竞争力,不是所有任务上都能替代更大模型。
表 5 还有一个例子:ProRL 在 ARC 类别得分 2.52,低于 7B 的 3.42,但图表说明宣称各类推理任务都更优。与此同时,代数达到 97.21。保留这些反例并不会抹杀训练收益;它让读者看清剩余难点并不均匀分布。平均涨分可能来自某些任务接近掌握,另一些任务依然很弱。
7. pass@k:成功样本存在,和系统能选出来,是两层问题
7.1 先固定题目,再谈成功概率
对于题目 ,在固定模型、解码方式和二值验证器下,设单次成功概率为 。独立采样 次,全失败概率是 。取补集,再对题目求平均,就得到:
这个指标问的是“样本集合里是否至少有一个正确答案”。它隐含了一个知道正确性的理想选择器。实际产品如果没有可靠验证器,就算 256 个答案里有一个正确,也未必能把它选出来。多数投票、模型裁判、执行测试分别定义不同的选择机制,应当单独评测。
另一个常见错误是先算平均单次正确率,再代入 。这一般不等于逐题计算后平均。题目之间越不均匀,差异可能越大:相同平均准确率,可以由“每道题都有一点希望”组成,也可以由“一半题很会,一半题完全不会”组成。
7.2 从有限样本推导估计量
实际不知道 ,但可以采样 个回答,其中 个通过验证。所有大小为 的子集有 个,全部失败的子集有 个。因此常见的估计量为:
当 时,不可能挑出 个全失败回答,分子定义为零。当 时,只要样本里有一次成功,估计量就是一,否则是零。这说明大 端点对有限样本很敏感,尤其是稀有成功附近。
这里给出的是二值覆盖率的标准推导和我建议采用的透明评测方法。ProRL 的逻辑任务包含连续奖励,原文对各图的成功阈值和估计细节不够充分,不能替作者保证所有曲线都严格使用式(11)。如果指标其实是样本中的最高部分得分,其意义就不同于至少一次完全成功。
算法 3:透明的二值覆盖率评测
1. 固定题目、检查点、解码参数和验证器。
2. 每道题独立采样 n 个回答,保存完整评分结果。
3. 分别记录格式可解析、部分得分和完全成功。
4. 对指定的二值成功事件,统计成功次数 c。
5. 对每个 k <= n,用组合数公式计算该题 pass@k。
6. 按预先声明的题目权重求平均。
7. 按题目成组重采样,估计模型差值的不确定性。
8. 同时报出响应长度、token 成本与失败类型。
这是一份建议协议,没有在本文中实际运行作者模型。同一道题的多次回答应作为一组处理,不能把 256 次尝试当成 256 道独立题。如果多个题目由同一模板或生成器产生,还可能需要按任务族分组,避免置信区间过于乐观。
7.3 论文曲线为什么比单个平均分更有信息
图 4 的多次采样实验给出了三个很不同的例子。MATH 的 pass@1 从 0.844 升到 0.918,但 pass@256 从 0.990 降到 0.982。GPQA 最终模型的 pass@1 为 0.405,高于中间模型的 0.356;然而 pass@256 为 0.904,低于中间模型的 0.964。CodeContests 则在大预算下继续改善:起点、中间和最终分别为 0.881、0.966、0.979。
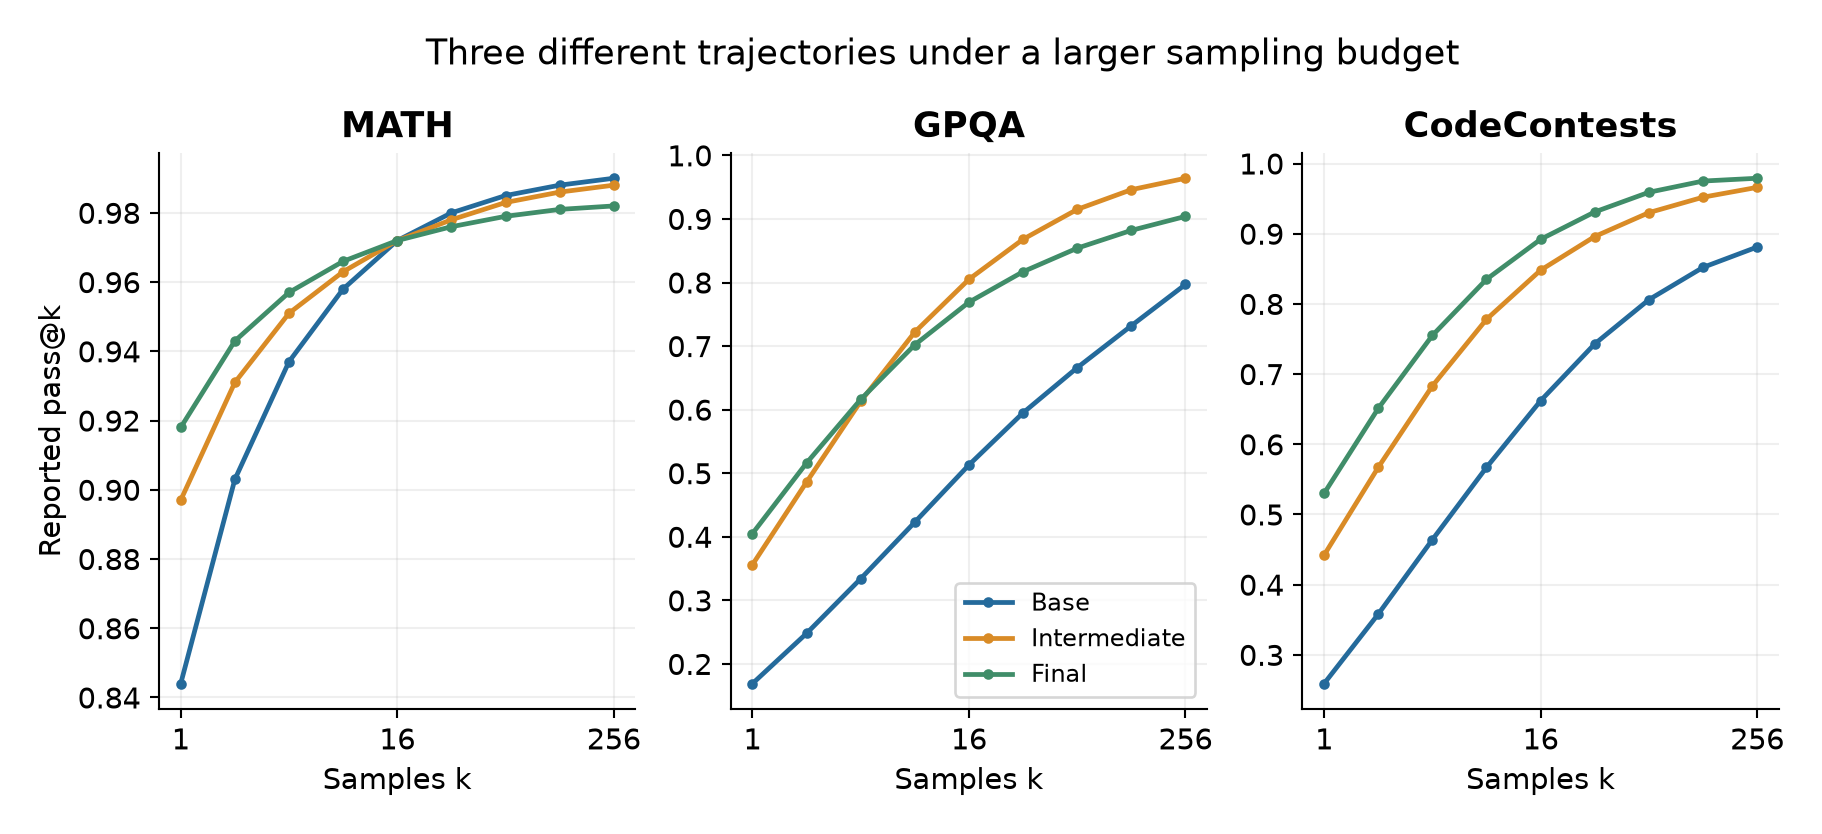
它们说明,检查点选择需要与目标预算匹配。只保留最终模型,会错过某些用途更合适的中间模型;只看 pass@1,又会看不到少数题目上成功路径消失的现象。反过来,只看很大的 pass@k,也会低估单次回答可靠性提升带来的实用价值。
这组曲线来自每题 256 个回答的独立分析,不能直接和前面的 16 次评测表格拼接。特别是 APPS,表 2 的起点和最终为 20.95、41.99,而图 11 的 是 0.292、0.583,差异相当明显。正文没有把题目集合、采样次数和口径差异解释完整,本文不擅自断言全部只是随机波动。
8. 泛化实验:新的任务类别,与更大的同类题目
8.1 留出的任务类型确实提供额外证据
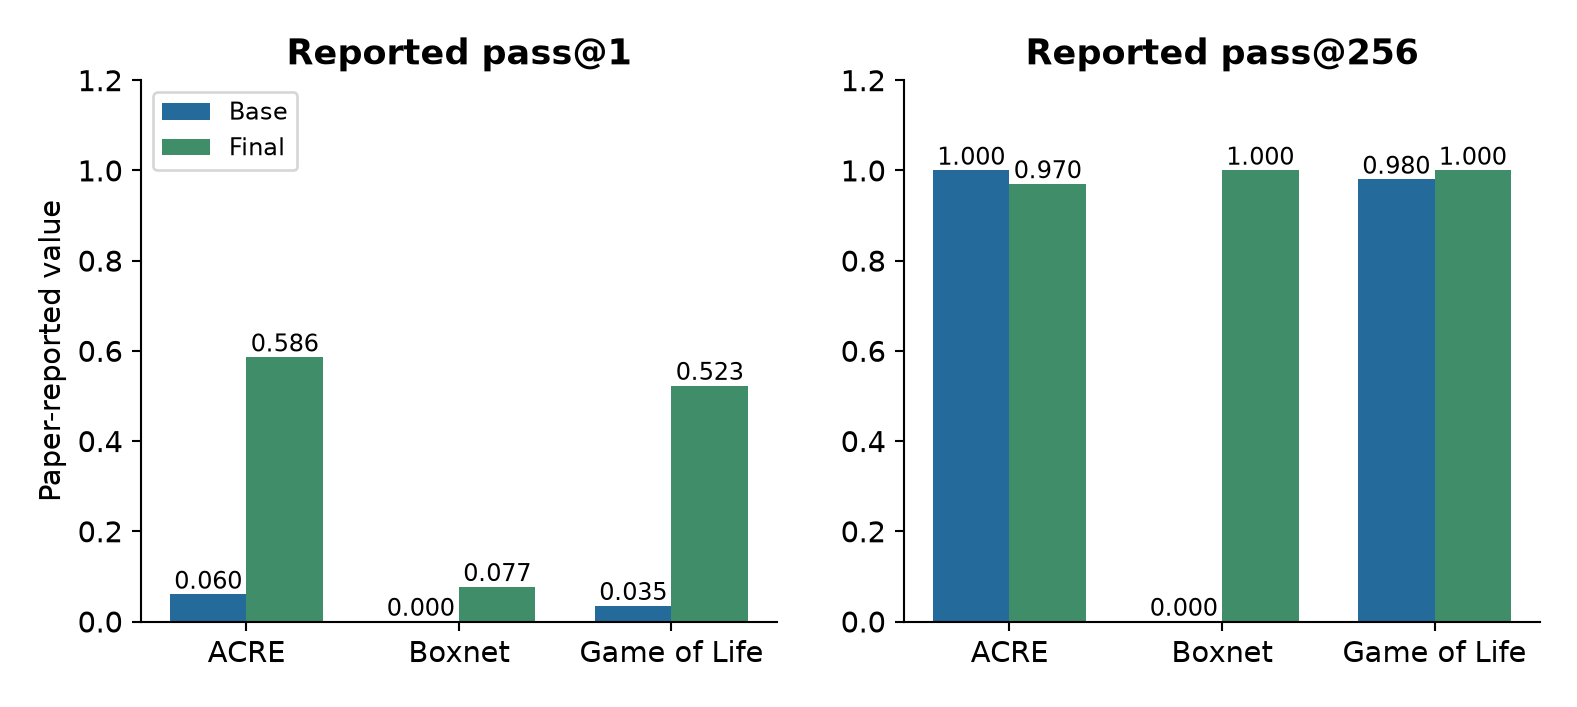
论文在训练任务类型之外评估了 ACRE、Boxnet 与 Game of Life halting。主表中,三者的起点到最终得分分别为 5.99 到 58.57、0.00 到 7.91、3.49 到 52.29。这支持训练产生了跨任务类型的迁移,而不是仅记住训练题目的答案。
但“RL 训练未包含这种任务类型”不等于“预训练和蒸馏从没见过相关概念”。起点模型的完整知识来源并未被逐一排除。合理的 OOD 结论必须带着相对于哪一部分训练分布的限定。
独立多次采样分析也补充了边界。图 10 中 ACRE 的 pass@256 从 1.000 降到 0.970,尽管单次分数大幅提高;Boxnet 从 0.000 升到 1.000;Game of Life halting 从 0.980 升到 1.000。Boxnet 最终的 仍只有 0.077。它显示了搜索分布的变化,但不宜描述为一次回答就能可靠完成规划。
8.2 图染色研究的是难度扩展
训练用 10 个顶点的图,测试改为更大图,是同一任务族内的问题规模外推。图 12 中,最终模型在 13、15、18、20 个顶点上的 pass@1 分别约为 0.425、0.102、0.012、0.008。图中大采样预算恢复了很高的覆盖,所列 pass@256 达到一,但单次成功率随着规模增大显著降低。
这个结果有意义:模型在更大实例上仍能找到可用解。不过它与学习到具有明确复杂度保证的通用图染色算法不同。有限规模测试不能直接推断任意图的算法泛化,也不能忽略验证器是完全成功还是部分得分。一个预算足够大的搜索过程,可以在某些实例上成功,同时在部署时仍然很昂贵。
8.3 256 次没有成功,统计上究竟排除了什么
对一道固定题目,如果独立采样 次没有成功,零成功事件的概率为 。求解让该事件概率等于 的 ,得到单侧置信上界:
取 、,上界约为 1.16%。也就是说,零成功与一个很小但非零的真实概率完全相容。若真实概率只有 0.001,256 次全失败的概率仍约为 77.4%。这不是说观察毫无价值,而是说明“没测到”与“概率严格为零”之间有多大距离。
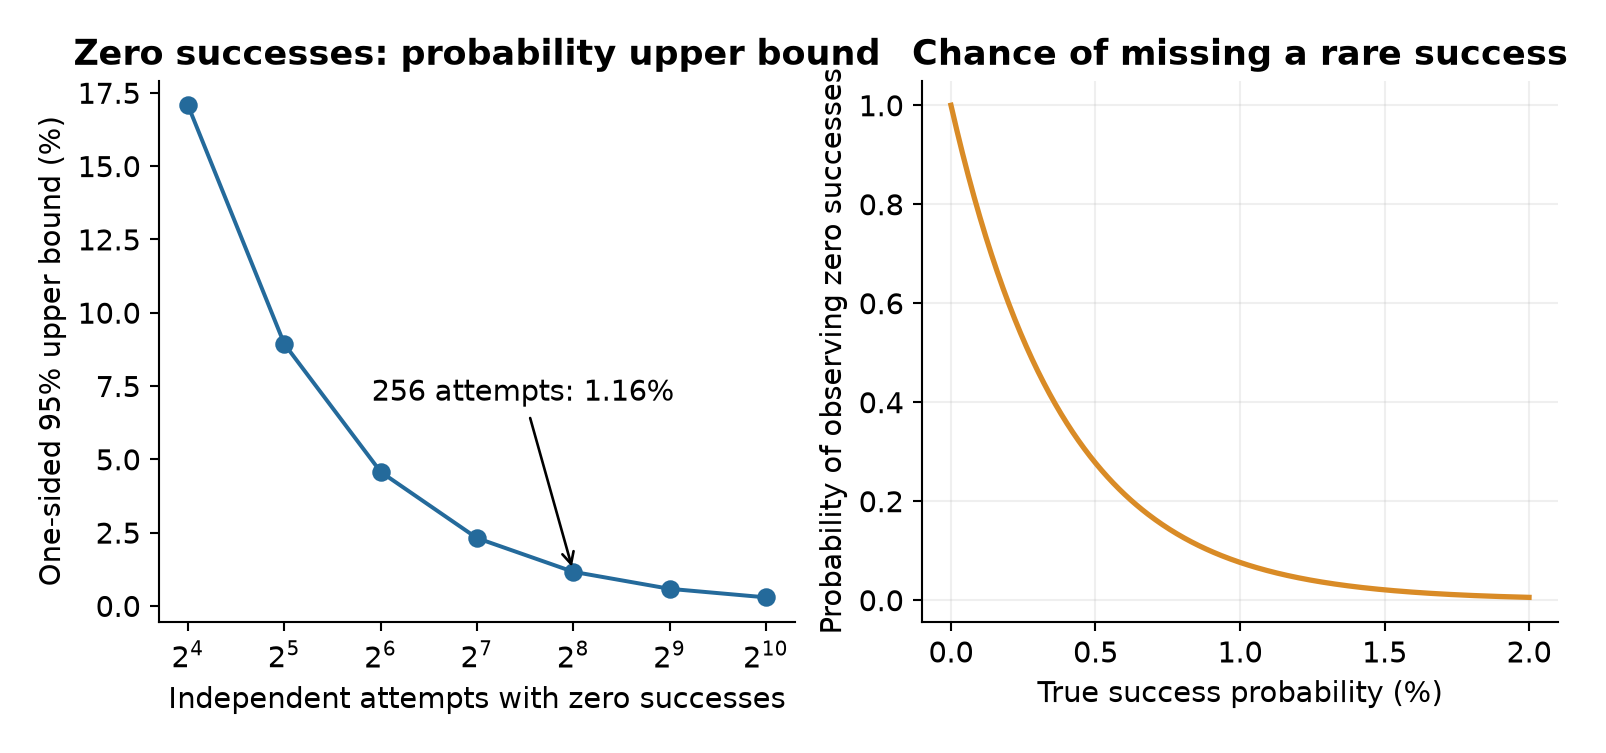
上述区间针对一个预先指定题目,不是同时对数千道题成立的保证。如果先从很多题里挑出所有基础模型零成功的题,再研究这个子集,还会出现选择效应。更有说服力的报告应提供逐题样本数、配对结果与整体任务分布,而不是只挑最符合叙事的零成功案例。
9. 均值与方差的界:为什么平均准确率不够
9.1 先从一个小例子建立直觉
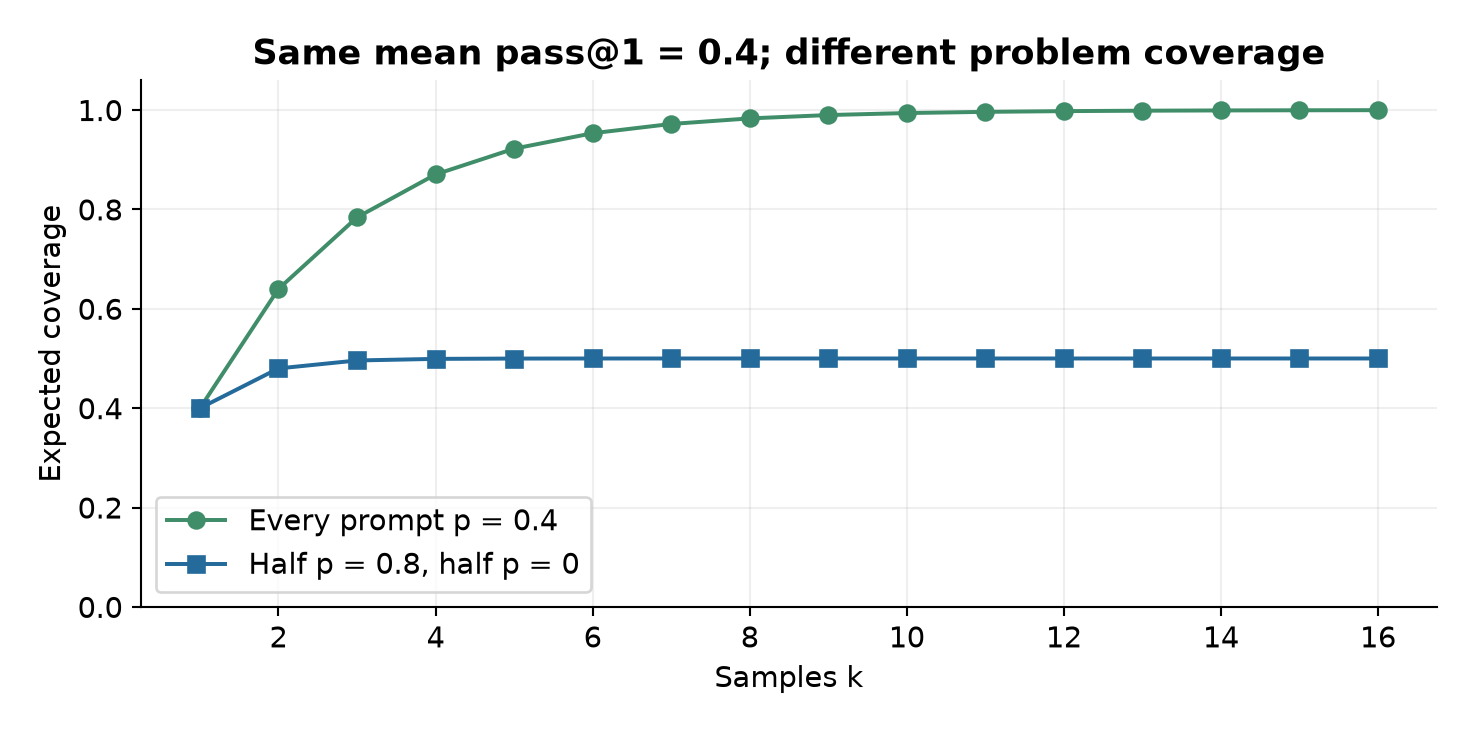
假设系统 A 对每道题的单次成功概率都是 0.4;系统 B 对一半题为 0.8,另一半为零。两者平均 pass@1 都是 0.4。但 A 的 pass@2 为 ,B 的平均 pass@2 只有 。
增加采样次数时,A 对每道题都有机会继续获得收益;B 中成功概率为零的那一半题始终没有机会。这解释了为什么策略把概率质量集中到一部分题目后,单次平均表现可能提高,覆盖面却不一定改善。
9.2 按步骤推导论文讨论的上界
令随机变量 表示随机抽取题目的单次成功概率,均值为 ,方差为 。令 ,则平均 pass@k 为 。对于整数 ,函数 在 上是凸函数,对 应用 Jensen 不等式:
接着展开二阶矩。由于 ,有:
在 时,这个表达式恰好等于真实覆盖率。固定均值时,方差越大,pass@2 越低。它为前面“能力分布越不均匀,多次采样越可能留下死角”的直觉提供了精确版本。
但是,不能把这个界使用过度。 不满足上述凸性步骤;大 时界可能很松;不同模型的均值和方差通常同时变化。即使一个模型的上界更低,也不意味着它的实际覆盖一定低于另一个模型的实际覆盖。上界给出的是限制,不是两个未知真实值的完整排序。
还要注意,这里的方差是不同题目成功概率之间的方差,不是同一道题生成奖励的方差,也不是训练梯度噪声。组内奖励差异有助于更新,而跨题能力分布过于不均匀可能损害覆盖,这两句话可以同时成立。把两个方差混在一起,会错误地得出“训练时应当消灭奖励方差”之类结论。
9.3 这个界最适合用来提出什么实验
我会同时报告逐题成功率分布和 pass@k 曲线,而不只报告一个平均数。尤其值得看两类题:基础模型能偶尔答对、训练后再也没观察到成功的题,以及基础模型罕见成功、训练后变得稳定的题。前者提示遗忘或过度集中,后者提示很实用的概率迁移。
这依然是有限样本分析。若每题只有少量采样,估计出来的方差包含测量噪声,不能直接当作真实能力方差。增加采样、给出逐题区间并做配对比较,有助于解释覆盖率变化。
10. 要复现科学结论,哪些实验信息最重要
我把复现的目标理解为:同一个数字到底回答了哪个问题。除了模型资源本身,下面这些信息会直接改变结论的含义。
| 信息 | 为什么重要 |
|---|---|
| 起点及中间检查点 | 判断回退何时发生,而不是只比较首尾 |
| 题目切分与任务生成设置 | 区分新实例、更大实例和新任务类型 |
| 验证器的解析规则与满分标准 | 区分格式学习、部分正确和完全解题 |
| 每个阶段的设置与重置时点 | 明确训练过程中到底改变了什么 |
| KL 系数与目标归约约定 | 理解正则强度和不同长度样本的权重 |
| 接受、丢弃的 rollout 及 token 数 | 支持公平的成本比较 |
| 逐题、逐模型评分矩阵 | 进行配对覆盖率和不确定性分析 |
论文给出了起点模型、数据规模、名义超参数、阶段说明和很多逐任务图,但 reset 触发器与 KL 系数等细节仍不完整。验证混合还包含来自 AIME2024、Codeforces、GPQA、IFEval 和图染色等评测基准的子集。这个事实不能直接证明最终测试题被拿去训练,却意味着监控集与最终未触碰测试集的边界需要讲清。
如果未来做一组受控实验,我会让各分支从相同检查点出发,使用相同数据混合和生成 token 预算,分别打开或关闭参考重置与优化器重置。不重置的分支也应获得合理超参数调优,不能故意保留一个很差的固定参照配置。另一组实验再固定这些条件,只改变训练时长。这里是在提出实验,不是汇报已经完成的复现。
11. 训练成本与部署成本,需要分别计算
11.1 一步训练不是一个稳定的计算单位
论文报告使用四台节点,每台八张 H100 80GB,总计约 16K GPU-hours。如果 32 张卡一直被占用,简单相除约为 500 小时。这是资源量的换算,不是测得的真实墙钟时间,也没有包含关于利用率、失败重跑、工程工作量或数据制作成本的判断。
更直观的 rollout 成本近似是:若接受 道题,每题采样 个平均长度为 的回答,采样组接受率为 ,则生成 token 数约为:
这只是规划公式,不是 ProRL 的实测缩放定律。不同题目长度与接受率相关,批处理和重采样方式也会影响实际成本。但它把一个经常被忽略的量放进来了:动态筛题丢掉的样本,依然消耗了生成成本。
以 的二值示例计算,组大小 16 时接受率约为 0.149,32 时约为 0.275。每个有效组对应的期望回答数 分别约为 108 与 116。扩大组能减少补采题目组的次数,但并不意味着每个有效组需要的回答总量减少。它还可能改善估计质量或发现稀有成功,这些收益应当单独测量。
因此,第 6-7 阶段组大小翻倍,以及最后阶段允许更长回答,都让“相同步数”的含义发生变化。若只按更新步数比较,没有 token、验证器和优化器开销的账本,容易把更多计算误认为更高效率。
11.2 部署时有没有可信选择器,决定覆盖率值多少钱
代码题可以用执行测试过滤候选答案,因而 pass@256 比较容易转化为一个搜索系统。没有可靠验证器的科学问答则不同:正确答案即使出现在候选集中,系统也未必知道是哪一个。一个错误但自信的裁判,可能把新增覆盖率的收益全部吃掉。
如果应用只允许一次回答和严格时延,单次正确率可能比曲线最右端更重要。如果应用允许离线搜索,并且成功结果能被可信验证,高预算覆盖就很有价值。ProRL 没有消除这两种目标的差异。它让多个任务上的权衡变好,同时也通过 GPQA 和数学曲线告诉我们,最终检查点未必是每种预算下的最佳选择。
12. 局限:哪些结论现在还不能下
第一,因果归因不充分。 这是一套有阶段干预的长期训练配方。时长、数据混合、终止奖励、采样组大小、上下文预算和两类重置共同变化。实验说明这套组合有用,尚未隔离每一项的必要性,更没有证明只延长训练就能得到同样收益。
第二,起点有特定训练历史。 DeepSeek-R1-Distill-Qwen-1.5B 已经通过蒸馏获得推理相关行为。结果不能自动推广到原始预训练模型、其他参数规模或不同蒸馏来源。与专业模型和 7B 模型的比较很有参考价值,但不是完全等数据、等计算的训练实验。
第三,成功定义与有限采样限制了能力判断。 二值完全成功、连续奖励和格式可解析率回答不同问题。256 次零成功无法证明概率为零。主表与附录部分数字存在未解释差异,因此不能把各处结果直接拼成一条严格一致的缩放曲线。
第四,稳健性仍需更多证据。 逐任务曲线揭示了异质性,但不能替代多随机种子、计算匹配和明确置信区间的研究。选择性展示若干曲线,也不能让读者知道完整任务分布中回退的比例、幅度和稳定程度。
第五,本笔记没有报告新的模型实验。 模型表现全部来自论文;二值组采样、置信上界和均值方差示例是明确假设下的教学计算。图形重绘只帮助核对解释,不构成独立复现。官方权重是后续研究资源,不是本文推断未公开设置的依据。
13. 独立批判性分析:什么证据会让我更相信能力扩展
13.1 把“新推理路径”变成可操作的问题
“新路径”可能指从未见过的文字、第一次观察到的正确解、不同算法策略,或者原分布概率严格为零的序列。这四件事不能混用。ProRL 比较容易测量前两种,后两种需要额外证据。对通常的 softmax 语言模型,很多字符串本来就可能有极小的非零概率,有限采样无法直接判定其数学支持集。
我更愿意把能力边界定义为:在指定解码器、验证器、响应数和 token 预算下,能够可靠解决的任务集合。这个定义没有回避实用能力。把一个实际几乎采不到的成功概率提高到可用水平,就是很有价值的能力提升;没必要因为概率可能原本非零,就把收益轻描淡写为“只是采样”。
同时,也没必要为了强调收益,宣称起点从未包含任何相关行为。只要双方固定同一个可操作定义,就能比较训练到底改变了哪些题目的可解性,而不是围绕无限采样或严格零概率打转。ProRL 最有力的部分,是给这种比较提供了长训练轨迹与多预算数据。
13.2 格式学习也有用,但应与解题能力分开
附录 F.1 展示了一个很关键的现象:基础模型用 boxed 形式输出,而任务期望 answer 标签。即使推理里包含相关内容,严格验证器也可能给低分。这意味着观察到的成功至少有两个门槛。
设 表示输出格式能被解析, 表示解析后语义正确。如果验证器直接拒绝无法解析的回答,那么:
提高任一因子都会涨分。对需要调用工具的 agent 来说,遵守输出契约本来就是重要能力;不能把这类训练视为没有价值。但它与学会新解题算法不同。若要讨论推理边界,就应该同时报告解析成功率、已解析回答中的正确率,以及原始严格分数。
一个有用的控制是单独做语义保持的格式修复,例如去掉明显多余的包裹,而不改变答案内容。修复规则应在观察模型输赢之前确定,也不能把错误答案重新解释成正确答案。这样可以估计多少收益来自格式,多少收益在中和表面差异后仍然保留。
这个控制还有一个实际好处:它能指导下一步训练。如果主要问题是契约不匹配,简单的格式训练或评测提示调整可能更便宜;如果解析率已很高但语义正确率仍低,就需要更深入的解题学习。将两者合并成一个总分,会让资源投入缺少方向。
13.3 文本新颖性不是算法新颖性的直接证据
论文还用 Creativity Index 分析与 Dolma 的重合程度。这个指标可以提供文本分布变化的线索,但 Dolma 并不等于起点模型完整、已知的预训练和蒸馏语料。较低重合可能来自新措辞、新格式或新的推理结构,不能单独证明新算法,也不能证明相关内容在训练历史中不存在。
若要更接近机制解释,我希望看到同题解法策略标注,以及要求关键步骤改变的反事实题目。例如某种不变量推理是否在条件变化后仍然成立,模型是否会相应更换策略。仅仅把答案写得更长、用不同词复述,无法回答这个问题。
这里并不是要求每一篇训练论文都解决“模型究竟理解了什么”的全部哲学问题,而是给不同证据安排适当角色:分数说明行为结果,覆盖曲线说明采样预算下的解题分布,文本指标说明表面或结构变化,受控反事实才更接近策略机制。
13.4 移动 KL 参照是合理机制,但需要拆开验证
移动参照提供了一个很具体的优化解释:当策略变强,旧参照越来越不合适,更新参照可以减轻累积的偏离代价。优化器重置则改变历史梯度统计。两者同时发生后表现改善,并不能告诉我们各自作用有多大。
最小的一组分解实验可以把参考重置开关与优化器重置开关交叉,形成四个分支,固定数据和生成 token 预算。再单独比较上下文长度变化,并对没有 reset 的分支合理调参。这样既不会把弱基线当陪衬,也能找出对其他模型最可迁移的原则。
我并不认为缺少这组实验就让论文失效。当前结果已经证明配方有实用价值。分解实验的意义在于,将“这一轮训练做成了”推进到“下一轮在不同起点上为什么也值得这样做”。这才是工程经验转化为普遍训练方法的关键一步。
13.5 监控与最终评测之间,需要一条明确边界
重复观察公开基准并据此修改训练阶段,即使没有直接训练最终题目,也可能形成对基准的适应性选择。解决办法不是空泛地怀疑泄漏,而是事先规定检查点选择规则,并留出从未用于干预决策的最终测试集。
同样,若重点讨论基础模型从未成功的题目,应该声明子集如何选择,以及选择和最终评估是否使用独立样本。否则,一个幸运或不幸运的采样集合就可能被放大成能力结论。真正有说服力的是配对、可重复、带预算和不确定性说明的变化。
算法 4:我建议的更强证据协议
1. 预先冻结留出任务族,并定义完全成功事件。
2. 声明 token 预算、采样次数、解码器与答案选择器。
3. 只用独立验证集选检查点和调整阶段设置。
4. 对所有选定模型评估同一批未触碰的测试题。
5. 分开记录格式成功、部分得分和完全解题成功。
6. 配对估计 pass@1 与覆盖率差值,并给出不确定性。
7. 在相同生成 token 预算下比较训练分支。
8. 显式报告退化任务和中间检查点胜出的情况。
这是一份建议协议,不是作者已完成的实验,也不是本文运行得到的结果。如果在多个起点模型上,中和表面格式差异后仍稳定提高单次表现和高预算覆盖,我会更有信心把结论推广为推理能力扩展。如果收益主要被格式控制或预算匹配解释,配方仍可能有用,只是机制应换一种描述。
14. 结论
ProRL 最值得学的,不是一个“RL 训久一点就行”的口号,而是维持训练有效性的具体方法:筛掉缺乏对比信号的样本组,约束但不永久固定策略参照,监控终止异常,保存中间模型,并按任务与采样预算分析收益。
论文清楚表明,这套长期、多阶段配方能把小型蒸馏模型的实测能力推高,在若干代码与逻辑任务上同时改善准确率和覆盖率。它也保留了反例:部分数学覆盖下降,高预算下中间模型可能更强,逻辑收益里包含格式学习。把这些事实一起读,结论反而更可靠。
下一步最有价值的是固定预算的控制实验、明确的成功定义和未触碰的留出任务。它们能帮助我们区分哪些是可迁移的训练原则,哪些依赖特定模型、数据混合和评测协议。对实际系统,最后仍要回到一个朴素问题:在我能承担的成本内,能不能更可靠地找到并选出正确答案。
参考资料与资源入口
- Mingjie Liu、Shizhe Diao、Ximing Lu、Jian Hu、Xin Dong、Yejin Choi、Jan Kautz、Yi Dong:ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models,2025。全部训练与性能数字来自此版本;正文及附录 A-F 已完整阅读。
- NVIDIA:Nemotron-Research-Reasoning-Qwen-1.5B,官方模型权重资源。
- Yang Yue 等:Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?,作为下一步对照阅读候选;不使用后续版本替换 ProRL v1 的原始测量。
- Andrew Zhao 等:Absolute Zero: Reinforced Self-play Reasoning with Zero Data,作为课程和求解策略共同演化的后续阅读候选,不作为本文实验基线。
图 1-9 为原创解释图或标明来源的数值重绘。统计示例、公式推导和建议协议均与论文报告的模型实验区分。