笔记日期: 2026 年 9 月 27 日
笔记作者: Zhongzhu Zhou
阅读论文: FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving
论文作者: Zihao Ye, Lequn Chen, Ruihang Lai, Wuwei Lin, Yineng Zhang, Stephanie Wang, Tianqi Chen, Baris Kasikci, Vinod Grover, Arvind Krishnamurthy, Luis Ceze
版本: arXiv:2501.01005v2,2025 年 4 月 21 日
资料入口: 论文全文、项目主页、官方代码资源
1. 我想从这篇论文里弄明白什么
把一个注意力 kernel 跑快,与把在线推理服务做好,中间还隔着不少问题。真实请求的输入长度不同,生成结束时间不同,有些共享系统提示,有些完全独立。KV 缓存也不一定放在连续的物理地址上。今天这一批请求适合的工作分配,到下一个 token 时可能就变了。
因此,我阅读 FlashInfer 时最关心的并不是某个峰值算力,而是它如何划分三个职责:数学上怎么算,数据在内存里怎么放,以及每一步让哪些 GPU 线程块做哪些工作。这三个问题互相影响,却不应该被绑死在一个只能处理固定形状的 kernel 中。
论文的答案可以概括为三点。第一,用块稀疏视图表达 query 对 KV 页面的访问。第二,让局部注意力计算产生可合并的状态,而不是只输出一个已经归一化的向量。第三,把随请求变化的工作队列写入元数据,由结构固定的 GPU 程序读取。变化较慢的算子定义与硬件配置,则交给即时编译来专门化。
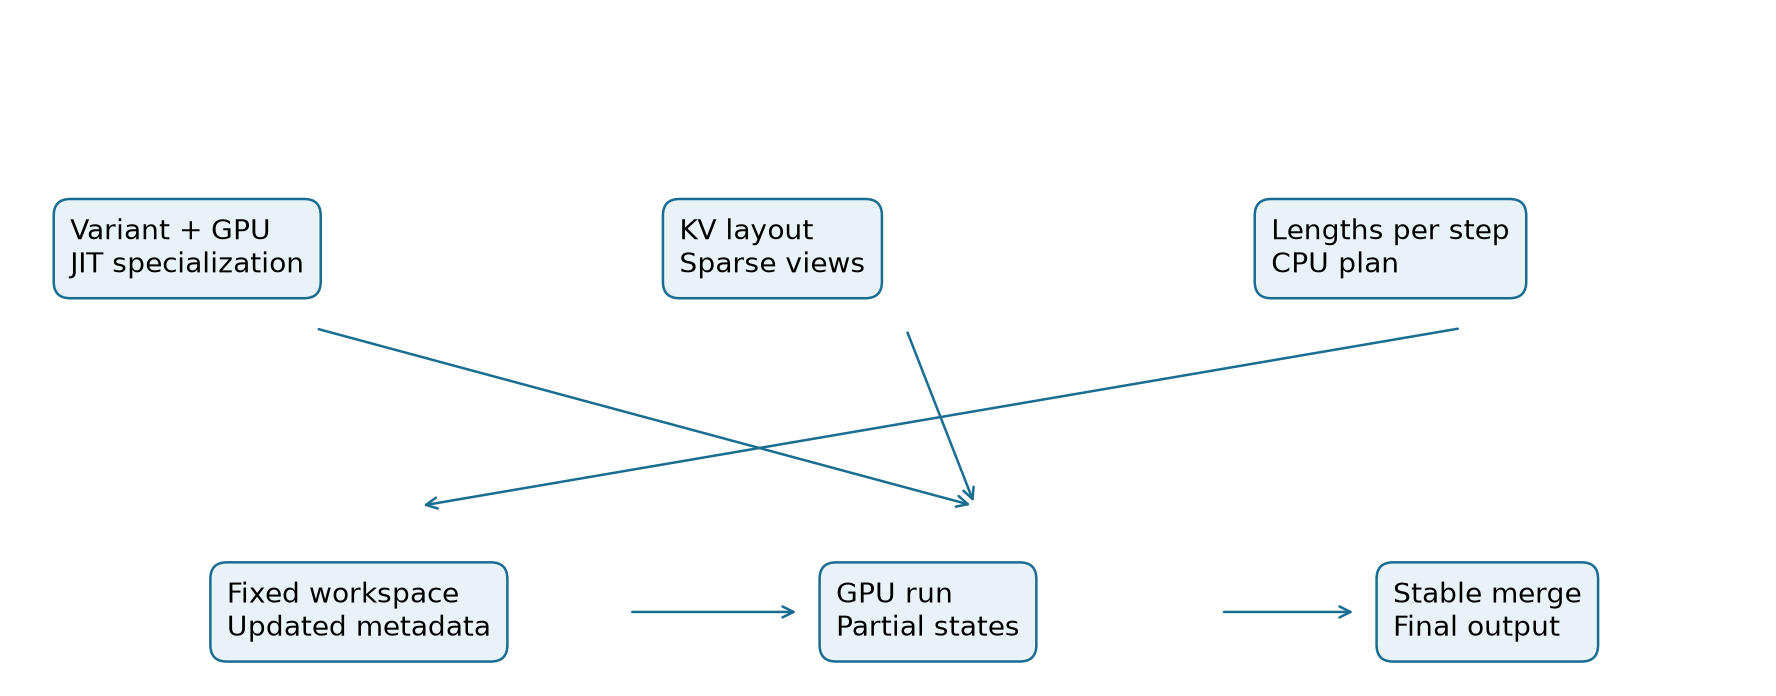
这里有一个容易忽视的前提:服务框架其实已经掌握了很多有价值的信息。页表知道 token 在哪里,共享前缀结构知道谁可以复用数据,序列长度知道每个请求大约有多少工作。FlashInfer 的重要作用,是让这些信息真正影响注意力计算方式。
本文的实测数字均来自论文。我补充的公式推导、玩具例子和成本模型用于解释机制,不是我重新运行得到的性能结果。全文连同附录 A–G 共 21 页已阅读;尤其保留附录里“不一定更快”的结果,因为这些结果更接近实际选型时需要回答的问题。
2. 前置知识:同一个注意力公式,为什么需要不同执行方式
2.1 Prefill 与 decode 的形状差别
考虑一个注意力头。查询矩阵为 ,键和值为 。包含可见性掩码 的标准注意力为
允许访问的位置,掩码贡献零;禁止访问的位置,贡献负无穷。Prefill 一次处理多个输入 token, 可以很大。普通自回归 decode 中,一个请求通常只新增一个 query,却仍要读取长历史中的 KV。适合上百个 query 行的矩阵乘法分块,放在只有一行的场景里可能浪费很多资源。
这也解释了为什么“同样是 attention”不足以指导 kernel 选择。算子的数学形式相同,不代表计算与访存比例、并行度和数据复用机会相同。长 prefill 可以让一批 query 共同消费一块 KV;短 decode 更容易受读取历史 KV 的带宽限制。
2.2 先用一个简化模型理解计算强度
先忽略 softmax、掩码和重复加载。两次矩阵乘法约需要 次浮点运算。若每个数占 字节,输入只读一次、输出只写一次,粗略流量为 。于是理想化运算强度是
当 ,它趋近于 。论文所说的 可以这样理解:query 越多,同一批 KV 越有机会被复用。这个式子不是实际 GPU 的精确 roofline,因为索引、补齐、局部结果以及重复 tile 加载都会增加开销。
把互不相关的 decode 请求凑成一个大 batch,会同时增加运算与各自的 KV 读取,不会自动让一个请求复用另一个请求的历史。批处理能提高设备利用率,但与提高单份 KV 的复用程度是两件事。
2.3 GQA 为什么能提供额外复用
设每个 KV 头对应 个 query 头。如果这些 query 头分别交给不同线程块,KV 可能要重复经过较慢的存储层级。如果把同一组的 query 头与 query 长度维度合并,就能让一个 tile 中的更多行复用一次 KV 加载。
附录 A 给出的索引关系可以写成
这里 是融合后的行号, 是原 query 位置。例如 时,融合后有 15 行,仍然代表三个位置、五个 query 头各自的计算,并没有把这些注意力输出混成一个。变化的是执行布局,而不是模型定义。
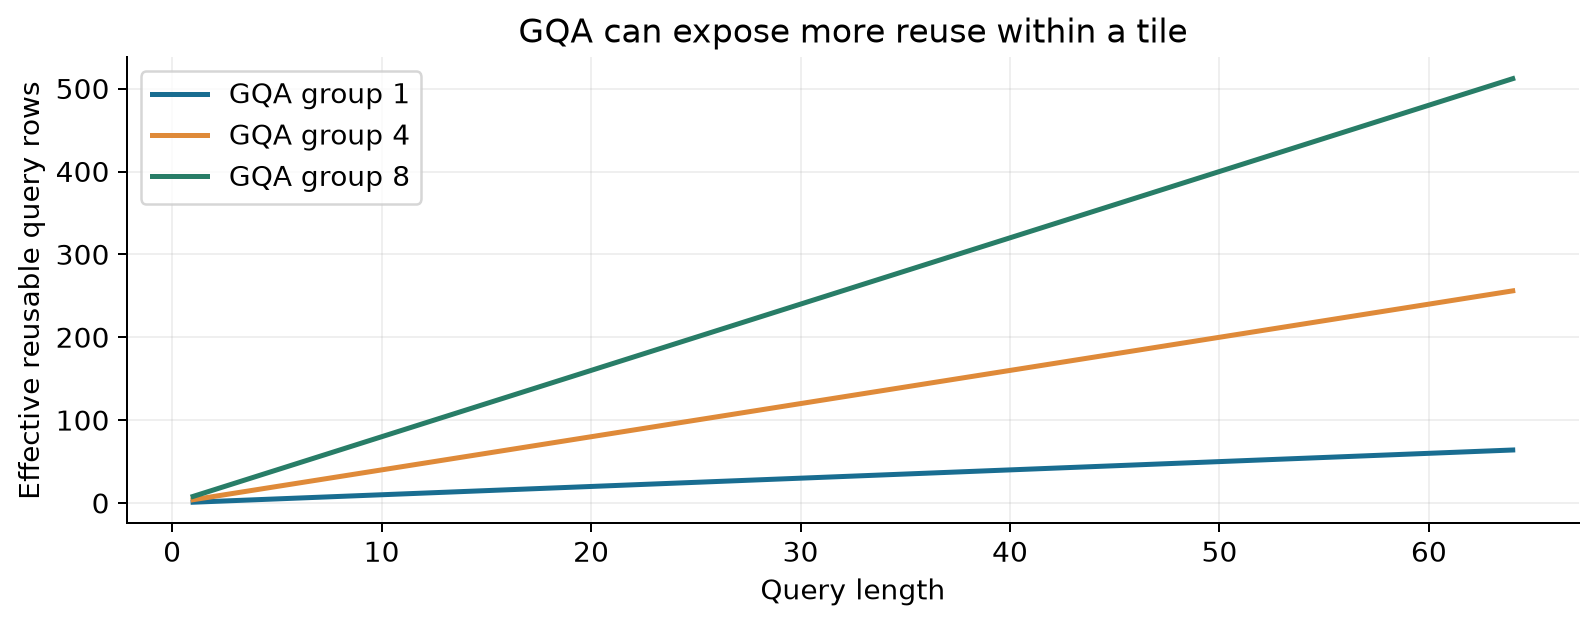
长 query 本来就有足够多的行可复用 KV,因此 head-group fusion 在短 query 场景更有意义。也不能把 倍有效行数直接翻译为 倍性能:更大的 tile 会消耗更多寄存器和共享内存,硬件驻留能力可能随之下降。
2.4 CTA 与 persistent kernel 是什么
CTA 可以理解为一个 GPU 线程块。多个流式多处理器执行这些线程块,能同时驻留多少块,受线程数、寄存器和共享内存约束。如果一个线程块负责很长的请求,其余线程块很早完成,设备就会出现“有活没做完,但许多执行单元已经空闲”的情况。
Persistent kernel 使用数量固定的一组线程块,每个块按照工作列表处理多个逻辑任务。逻辑 tile 的数量因此不必等于启动的线程块数量。它提供了重新分配工作的机会,却不会自动保证均衡;列表如何安排、成本如何估计、局部结果如何汇总,仍要设计。
3. 注意力状态:拆分之后为什么还能算回原来的结果
3.1 只保存局部输出,会丢失什么
先固定一个 query,把缩放和掩码都吸收到分数 中。对允许访问的位置集合 ,定义分母与加权分子
局部输出是 。一旦只保留 ,就不知道这部分键在整个序列中拥有多大的概率质量。两个分区可能输出同一个向量,分母却相差很多倍。直接平均两个局部输出,一般得不到全局注意力。
令 。对互不重叠的 ,分子与分母都可以相加。把 代入,得到
所以 FlashInfer 把 作为注意力状态。输出向量记录方向,对数归一化因子记录质量,两者一起才足以支持后续合并。
一个简单反例:设 ,两个标量输出分别是 。正确结果是 。直接平均只能得到 3。错误并非浮点精度造成,而是归一化之后丢掉了权重。
3.2 从数学正确走到数值稳定
直接计算 可能溢出。令 ,再计算 、。分子分母同时除去 ,结果不变:
此时两个指数都不超过一。减去共同最大值不改变归一化后的比例,却避免了大指数带来的风险。这一步也是 online softmax 一类算法反复利用的思路。
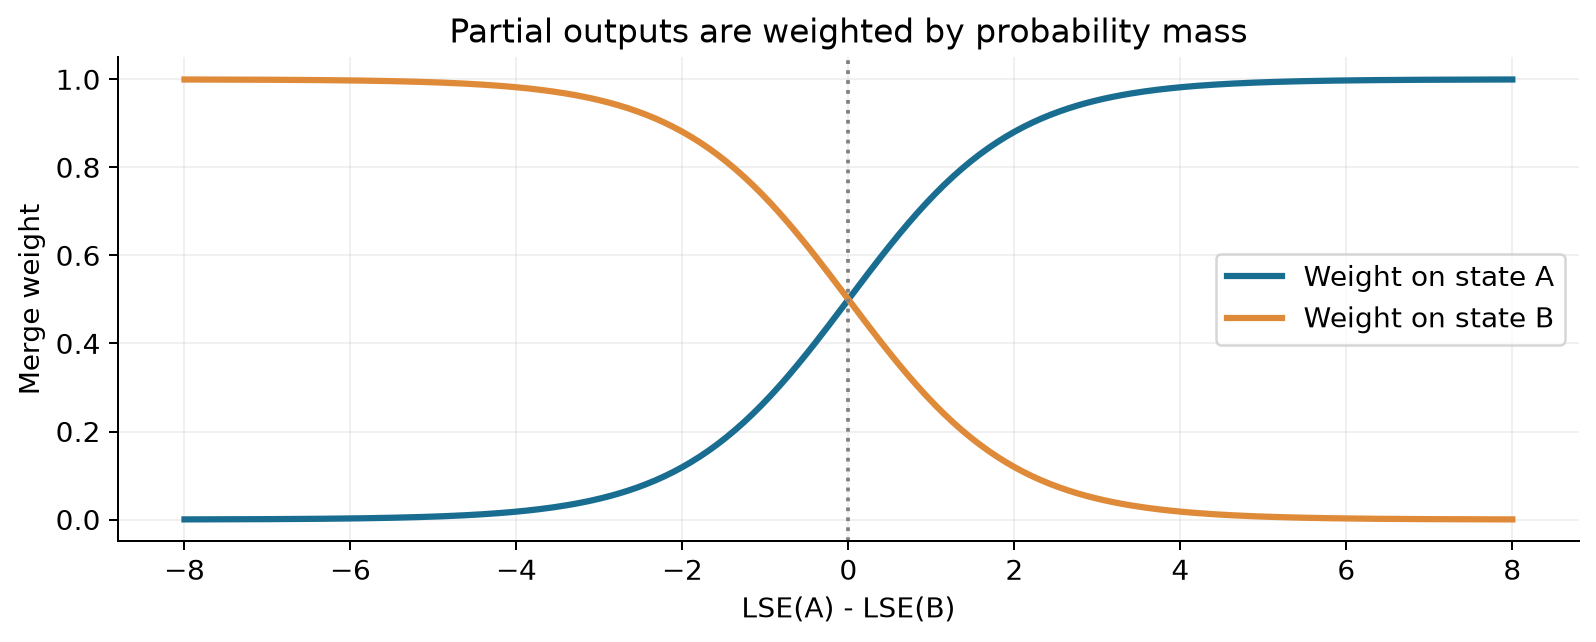
若一个分区为空,它的质量应为零,直接返回另一个有效状态。若两个都为空,不能机械地计算“负无穷减负无穷”;必须明确空状态规则。这是公式解释中的必要边界,不是对论文未写明行为的猜测。
3.3 算法 1:稳定合并两个注意力状态
下面是基于论文第 2.2 节整理的解释性伪代码。有效标志用于避免让空分区的任意输出参与计算。
1. 输入 A=(OA, lA, validA),B=(OB, lB, validB)。
2. 两者均无效时,返回空状态。
3. 仅 A 有效则返回 A;仅 B 有效则返回 B。
4. 令 m = max(lA, lB)。
5. 计算 a = exp(lA-m),b = exp(lB-m)。
6. 计算 O = (a*OA + b*OB)/(a+b)。
7. 计算 l = m + log(a+b)。
8. 返回 (O, l, true)。
为什么它有结合律与交换律?因为在归一化之前,实际合并的是 ,而加法具有这两个性质。不过前提是各分区互不重叠,每个合法键只出现一次。不同请求复用同一物理页没有问题;同一个 query 的两个分区都包含同一个键,就会重复计算其概率质量。
另一个边界来自有限精度。数学上任意合并顺序等价,浮点数中却可能因舍入不同产生微小差异。论文选择在相同序列长度信息下生成确定的汇总顺序,避免非确定性的原子聚合。这支持固定计划下的重复性,却不等于任意分块方式、任意硬件都逐比特相同。
3.4 同一合并操作,服务两种优化
第一种是 Split-K:把一个长 KV 序列分给多个线程块,让更多执行单元一起帮助一个 query。第二种是共享前缀拆分:把 query 可见的键分成共享部分与私有部分,让多个 query 尽量复用共同前缀的加载。
前者主要改善并行度,后者主要改善数据复用,但最后都需要恢复全局归一化。注意力状态正好提供共同接口。这是我认为论文最有迁移价值的设计:让执行方式可以改变,同时把数学结果约束在同一个明确的合并规则下。
代价也必须记住。局部状态需要存储,分区需要索引,最终需要汇总。拆分只有在省下的等待或访存大于这些新增开销时才有价值。不能因为代数允许拆,就默认拆得越细越好。
4. 块稀疏视图:描述访问关系,而不是默认近似注意力
4.1 把页表看成矩阵
可以把 query tile 与物理 KV 页面之间的关系画成一张矩阵:行是 query,列是物理页,有效块表示这些 query 会读取哪些页。块行大小 配合 query tile;块列大小 对应缓存管理的粒度。论文用 Block Sparse Row,也就是块压缩行格式,统一描述这类关系。
这里的“稀疏”首先指访问关系。某个请求仍然可以读取自己全部历史 token,只是不会读取服务器里其他请求的页面,因此相对于全局页池仍是稀疏的。它与通过剪掉部分历史 token 来近似注意力,是不同层面的问题。
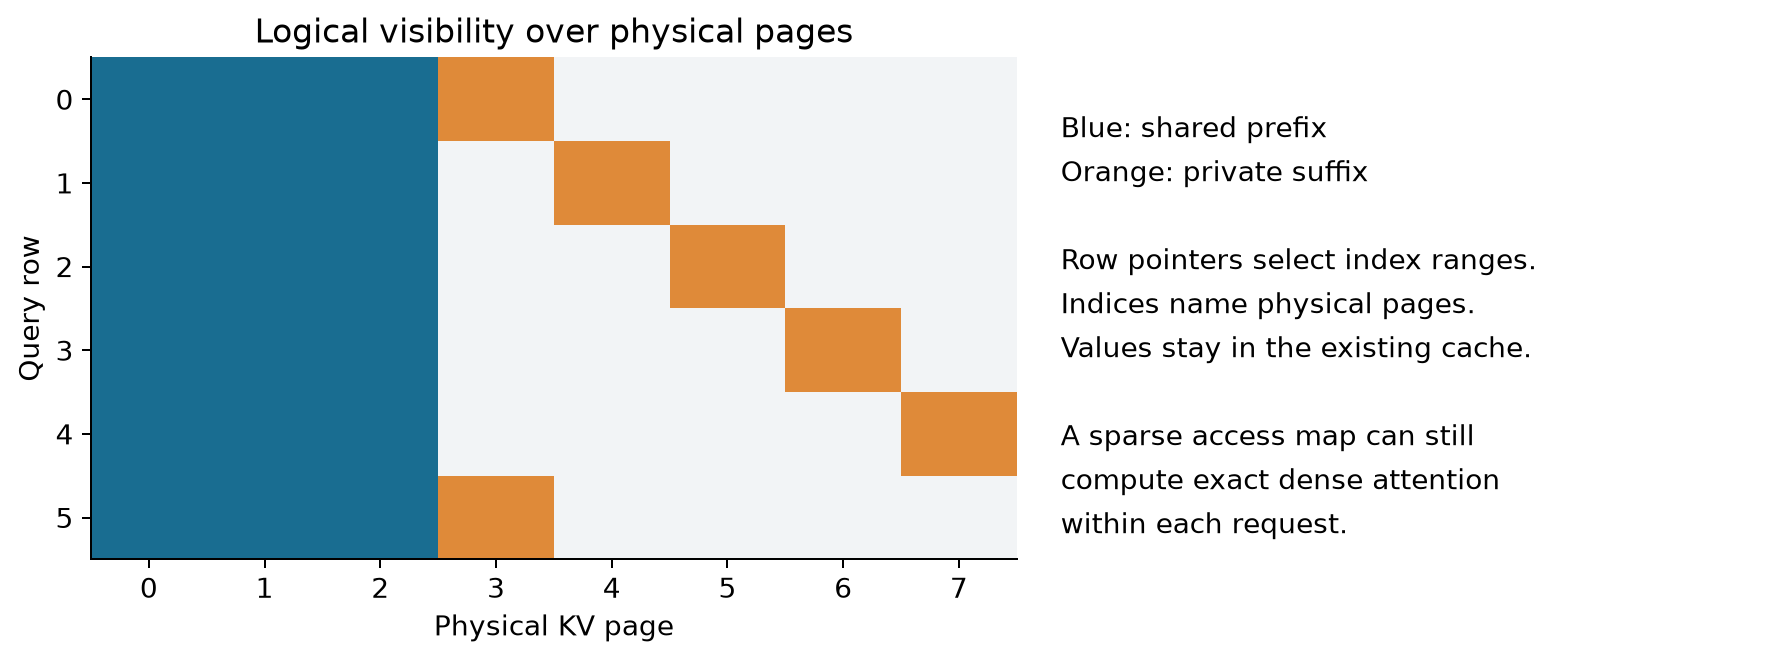
对一个简单分页序列,设逻辑 token 位置为 ,页大小为 。先找它所在的逻辑页,再查物理页号:
例如页号数组为 ,每页四个 token。逻辑位置五属于第二页,页内偏移为一,因此物理 token 位置为 。这只是 token 维度的映射,具体头与特征维度还要叠加各自的步长。
逻辑顺序与物理地址必须分开理解。因果掩码根据逻辑位置决定谁能看谁,不能用物理页号代替时间顺序。最后一页可能没有填满,也需要真实长度来屏蔽无效槽位。行指针则负责说明每个请求使用索引数组中的哪一段。
Query 与输出采用 ragged tensor,可以把不同长度请求紧凑打包,不必全都填充到最长请求。这样节约的是无效存储和计算;页表表达的则是紧凑张量与物理缓存之间的对应关系。两个层次配合,才把不规则请求转换成 kernel 可以处理的输入。
4.2 先 gather,再交给规则的矩阵计算
Tensor Core 喜欢规整的矩阵块,物理页索引却可能非常分散。FlashInfer 的办法是先把离散的 KV 行收集到连续共享内存里,再使用规则的矩阵运算。即使逻辑上相邻的 token 位于不同页,每个 token 的特征维度仍保持连续,有利于合并访存。
论文描述了 128 字节异步拷贝路径。Hopper 上,连续 KV 可以利用 TMA,但任意索引 gather 不满足同样的仿射寻址要求,因此不能简单把它替换成 TMA。附录还提到:当块足够大时,可以在块内部使用固定步长的 TMA 加载,但在这一版本中属于后续优化方向。
这个例子很能体现系统设计的现实约束。一个新硬件特性很强,不代表所有内存布局都能利用它。为了减少内存碎片而采用细粒度分页,可能会放弃某些连续加载优化。服务整体是否划算,要同时考虑缓存容量、可并发请求数和 kernel 时间。
4.3 为什么需要组合多种格式
如果所有数据只使用一种块大小,大块可以让多个 query 复用加载,却可能为私有区域带来大量无效位置;小块适合不共享的后缀,却可能错失前缀复用。一个格式很难同时把两种结构表达得高效。
Composable formats 给共享前缀与私有后缀各自建立视图,选择不同的块行大小。底层 KV 不必搬动,主要新增的是索引与指针数组。各视图分别产生注意力状态,最后再合并。
替代方案之一,是一个通用大 tile 加大量掩码。接口简单,但掩码掉的位置仍可能占用资源。另一个方案,是服务框架专门维护两套前缀与后缀缓存。它可能适合固定场景,却把内存管理与注意力实现耦合得更紧。FlashInfer 把视图作为边界,灵活性更强,也必须承担视图规划与结果汇总的成本。
5. 哪些事情交给编译,哪些留到运行时
论文的模板基于 FlashAttention-2 与 FlashAttention-3 思路,描述的硬件范围从 Turing 到 Hopper。这些是论文时期的设计背景,不是今天软件版本的支持列表。
FA2 模板列出的 query tile 候选为 ,KV tile 候选为 。一行 query 的路径使用 CUDA Core,较大 query tile 使用 Tensor Core;Hopper 的 FA3 路径还要满足 WGMMA 的行数要求。应用层允许灵活的稀疏块大小,不代表硬件矩阵指令的形状也可以任意变化。
选型启发式先考虑平均有效 query 长度,包括适用时的头组融合,再结合寄存器和共享内存约束选择 KV tile。大 tile 能提高复用,却可能减少同时驻留的线程块。寄存器使用过高还可能溢出到更慢的存储。因此,“一次做更多”与“整个 GPU 做得更快”并不总是一回事。
5.1 可定制接口改变什么
接口允许在 query、key、value、logit、mask 和 output 等位置加入变换。即时编译把这些变换与数据类型、头维度、硬件特性组合到专门化模板中。使用者不必因为分数计算稍有变化,就重写所有加载与调度逻辑。
例如 logits soft cap 可以写成
它的导数为 ,因此绝对值很大的分数会变得不那么敏感。这段推导说明变换的作用,不说明它在 GPU 上的代价;后者仍要看实验。掩码又是另一种语义:它决定哪些位置根本不参与归一化。变换与掩码的先后关系必须保留这种含义。
RoPE 融合也很直观。若先单独旋转键,再写回中间结果,attention 随后还要重新读取;把旋转放到加载和计算路径中,可以减少中间流量与一次启动。但融合也会增加 attention 内部的指令和寄存器使用。如果预处理后的键本来可以多次复用,收益还会改变。
5.2 softmax 可选,不代表所有变体都用同一个合并公式
论文举了不使用 softmax 的 sigmoid attention。对未归一化的形式
互不重叠分区的局部输出直接相加即可,不应该再套用前面的 log-sum-exp 加权合并。模板可以复用计算骨架,但具体 reduction 必须匹配算子的数学结构。
因此,我把“可扩展”理解为大量局部注意力变体可以共享加载、分块与调度设施,而不是任意序列模型都能直接塞入同一模板。若跨 token 的依赖或状态递推发生根本变化,就可能需要新的 scan 或执行结构。论文中的前向支持,也不等于已经完成可定制反向传播。
6. 动态调度:把不均匀的请求拆成可分配的工作
6.1 用长度估算负载
设请求 的 query、KV 长度分别为 ,query tile 大小为 。所有 query tile 需要扫描的 KV 工作量,可以粗略写成
论文算法 1 用 来确定 KV 分块上限,其中 是 CTA 数量。长任务被拆开,工作块按 KV 长度降序排列,再依次放到当前估计负载最小的 CTA 上。成本模型为
这不是精确的 GPU 时间公式。缓存命中、掩码密度、融合操作以及访存路径都会影响真实成本。它的用途是在规划开销较小的前提下,抓住长度差异造成的主要不均衡。
6.2 算法 2:构建均衡的执行计划
下面重述论文的调度思路。正整数取整与稳定的平局规则是为了让解释完整;论文印出的算法没有展开这些细节。
1. 输入请求长度、query tile 大小 Tq、CTA 数量 C。
2. 划分 query tile,计算 W = sum(tile数 * KV长度)。
3. 若 W 为零,返回空工作计划。
4. 令 KV 分块上限 L = max(1, ceil(W/C))。
5. 把每个 query tile 的 KV 范围切成长度不超过 L 的块。
6. 按块长度降序排序,相同长度按稳定 ID 排序。
7. 建立最小堆,保存各 CTA 的预测成本和编号。
8. 依次取工作块,分配给堆顶的最轻 CTA。
9. 将该 CTA 成本增加 alpha*Tq + beta*块长度。
10. 放回最小堆,并记录局部状态写入位置。
11. 为每个最终输出记录有序的局部状态列表。
12. 返回工作队列及结果合并映射。
若工作块总数为 ,直接排序需要 ,最小堆分配约需 。这是对算法结构的复杂度分析,不是论文测出的 CPU 耗时。把同一计划复用到多个兼容层,正是摊薄规划成本的重要手段。
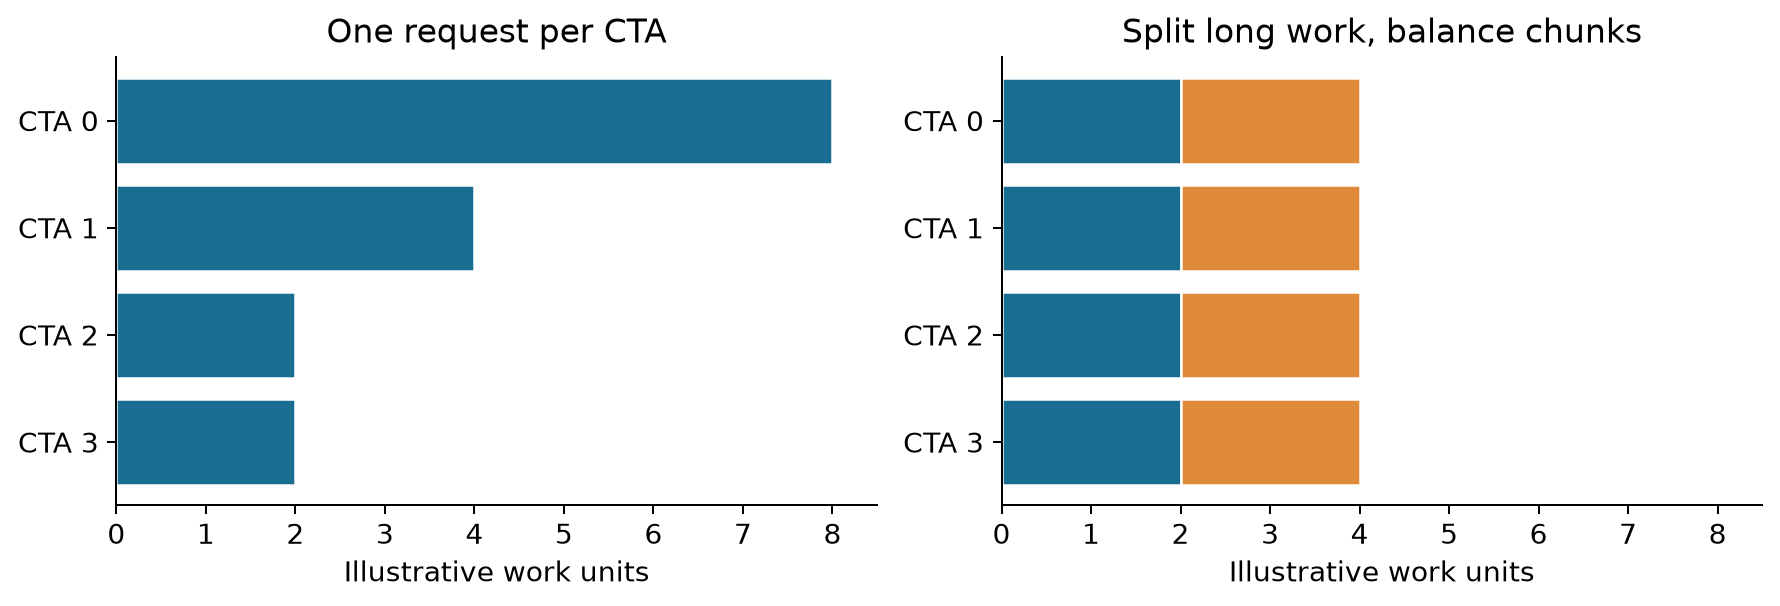
这个例子的总工作量是 16,四个工作者平均至少需要四个时间单位。每个请求独占一个工作者时,最长请求要做八个单位,其他工作者会等待。切成两单位的块后,可以接近平均下界。
一般情况下,理想最短完成时间至少受两个量限制:
一个是平均负载,另一个是不可再分的最大工作块。更细的块可以降低后者,却会产生更多局部状态和汇总工作。所以调度需要找到合适的颗粒度,不能只追求均匀。
6.3 固定的图,变化的元数据
CUDA Graph 的优势来自稳定的启动结构与指针。FlashInfer 不需要把每一步的所有长度都固化进图里,而是让图读取固定地址处的工作队列与合并映射。地址不变,里面的内容可以更新。
论文把 CPU 上的 plan 与 GPU 上的 run 分开:plan 每个生成步运行一次,兼容层共享同一份结果;run 执行注意力与局部结果汇总。固定工作区包含 GPU 元数据和局部输出,主机侧用锁页内存准备元数据,再异步拷贝到设备。
第 3.3 节一方面描述 attention 与 contraction 两个阶段,另一方面又提到将其合并到 persistent kernel。仅靠这段文字,不能确定每种执行配置的同步方式。我在笔记中保留明确的逻辑阶段和稳定接口,不把不够清楚的句子扩展成具体实现断言。
6.4 算法 3:一个生成步的概念生命周期
这段伪代码解释论文 Listing 1 的职责分工,并非可直接运行的 API 示例。
1. 声明容量上限,分配生命周期足够长的工作区。
2. 准备专门化 kernel 与若干图配置。
3. 使用稳定地址捕获 GPU run 路径。
4. 每个生成步更新请求长度和页表信息。
5. 选择与当前任务兼容的已准备图配置。
6. 生成计划,把元数据写入固定工作区。
7. 保证元数据传输先于图执行完成。
8. 重放图;在兼容层之间复用有效计划。
9. 消费输出、更新请求状态,进入下一步。
固定指针不等于无限容量。若当前请求数或累计长度超过捕获时声明的上界,就需要显式处理容量切换。图重放消除了部分启动成本,不会自动解决缓冲区越界、过期页表或错误的跨层计划复用。
6.5 拆分的内存账也要算
附录 D.3 给出局部输出容量表达式
这里算的是元素个数,不是字节,也不包含调度元数据。额外的一维用于保存 log-sum-exp。若所有元素都按 字节存储,对应容量才是 ;若输出与归一化因子的数据类型不同,就需要分别计算。
举一个纯算术例子:令 ,可得 13,209,600 个元素。若每个元素四字节,大约是 50.4 MiB。这不是论文的默认分配实测值,只是提醒我们,单个 query 的小状态乘上 tile、头数和 CTA 后,可能成为可观的内存成本。
论文的两倍系数依赖它对分割点和短请求直写的论证,不能直接套到任意自定义分块器。若把所有工作切成极小的块,中间结果数量当然可能增加。理解容量契约比记住一个孤立公式更重要。
7. 实验结果:先分清比较对象,再读加速百分比
7.1 实验环境决定结论范围
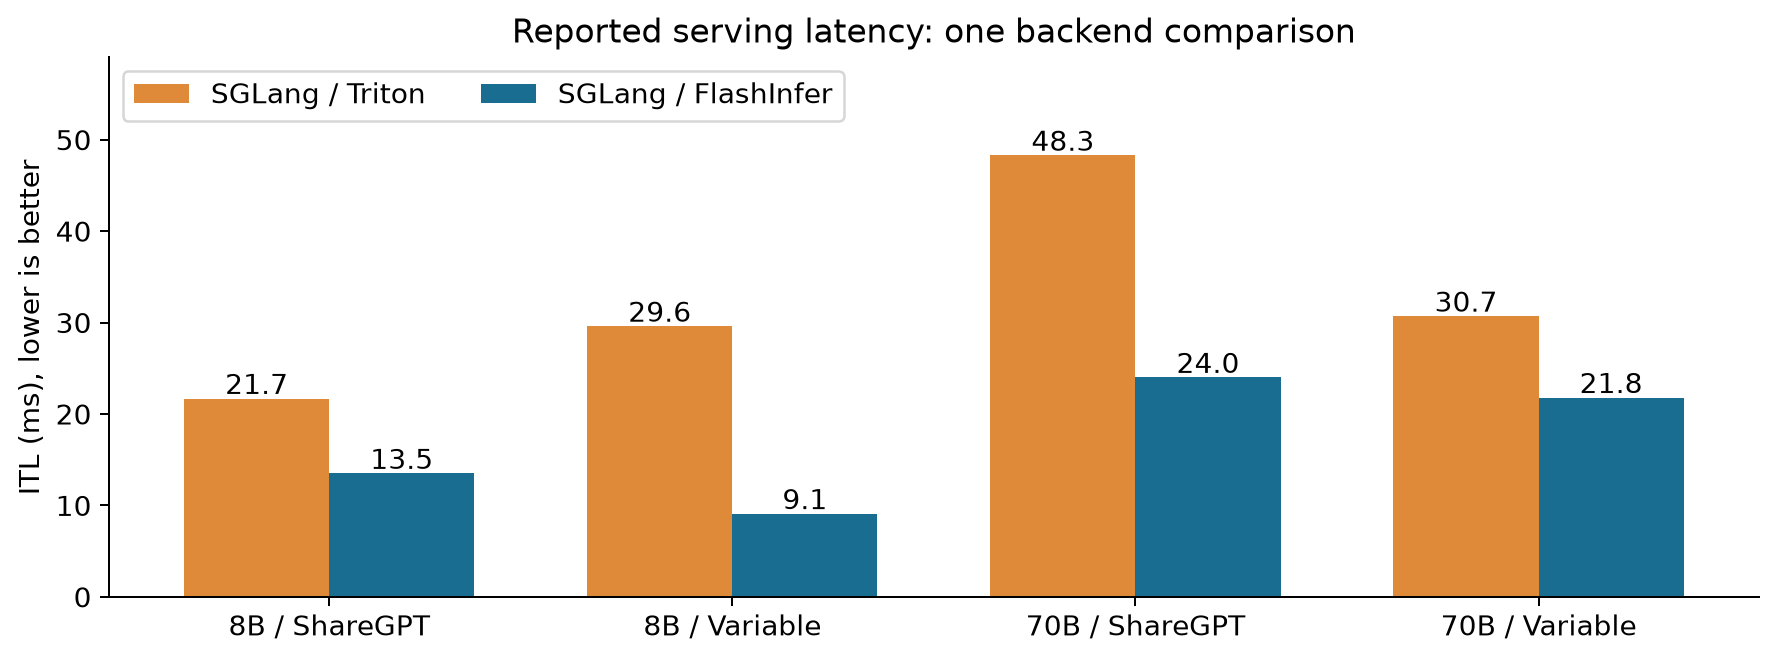
论文评估 FlashInfer v0.2,使用 CUDA 12.4、PyTorch 2.4.0,在 A100 40GB SXM 与 H100 80GB SXM 上进行,主体采用 f16。主实验比较 SGLang v0.3.4 的 FlashInfer 与 Triton v3.0 注意力后端。Llama 3.1 8B 使用一张 H100,70B 使用四张。
两个负载分别是 ShareGPT 和合成的 Variable。主实验调整请求率,使 P99 TTFT 保持在 200 ms 以下。这里既有设备计算,也有在线服务的排队与调度背景,所以不能把结果当成任意离线 batch 的吞吐测试。
原图 7 的图注把中心统计量写作“Medium”,看起来意指 median,但措辞并不严谨。我保留图中明确标注的数值,不凭这个词补出论文没有讲清的聚合方式。附录表 8 则明确写了 Median ITL 与 Median TTFT。
降低延迟与提升速度的百分比应分开计算。设原时间为 ,新时间为 :
8B 的 Variable 从 29.6 ms 降至 9.1 ms,对应延迟降低约 69.3%,倒数时间比约为 。这不等于吞吐增加 69.3%。70B 的 Variable 从 30.7 降至 21.8 ms,则是约 29.0% 的延迟降低。论文标题式的 29–69% 区间,来自不同负载下差别很大的结果。
TTFT 也有改善,但比例不同。8B 的两组分别从 49.2 降至 38.8 ms、61.8 降至 53.2 ms;70B 分别从 141.2 降至 115.6 ms、165.2 降至 157.8 ms。首 token 时间与后续 token 间隔对应不同路径,不能混成一个“整体延迟”概念。
7.2 调度器到底贡献多少
完整后端对比同时改变了多个因素。要看负载均衡本身,附录 G.3 更有解释力:它比较同一个 FlashInfer 后端开启与关闭调度器的差别。模型是 Llama 3.1 8B,设备是 H100;两种合成输入分布的输出长度固定为 256。
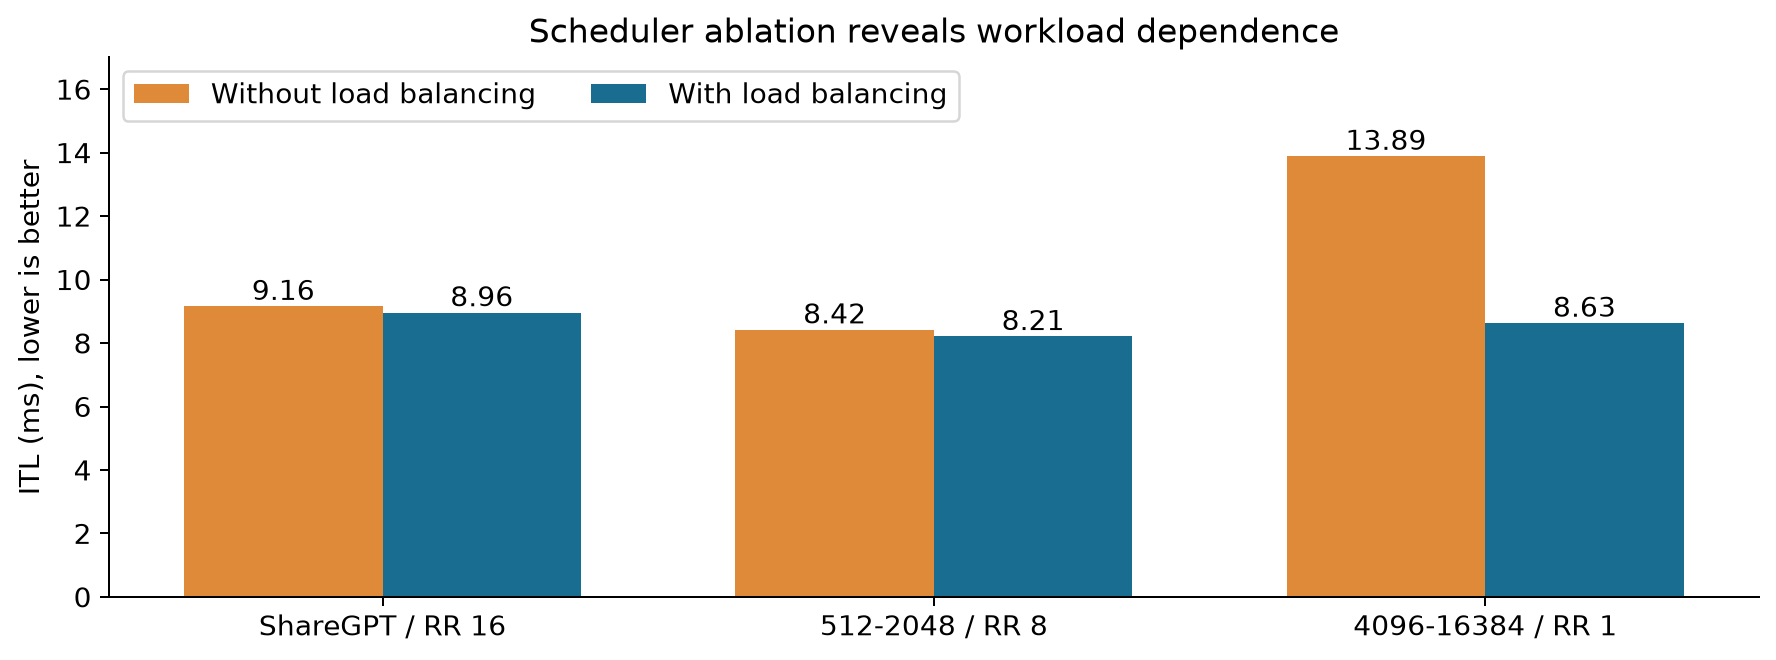
三组 ITL 的降低幅度约为 2.18%、2.49% 和 37.87%。最后一组从 13.89 ms 降至 8.63 ms,说明长请求不均衡确实可能产生很大代价。但同一组 TTFT 只从 421.60 降至 411.02 ms,改善约 2.51%。解决 decode 阶段的负载不均,不会自动等比例加快处理提示词的全部路径。
还要注意三行使用了不同请求率,因此它们是不同工作负载的实验,而不是仅改变长度、其他因素全部固定的曲线。短负载上只有几个百分点的差异,也提醒我们不能把主图的全部提升都归到调度器名下。
7.3 共享前缀:kernel 的大收益需要具体条件
附录表 5 固定后缀长度为 128,同时改变共享前缀长度与 batch size。当 batch 为 64、前缀长 32,768 时,kernel 时间从 4090 降至 254.54 微秒,约为 倍。而 batch 为 16、前缀只有 1024 时,从 46.52 降至 45.17 微秒,只有约 倍。
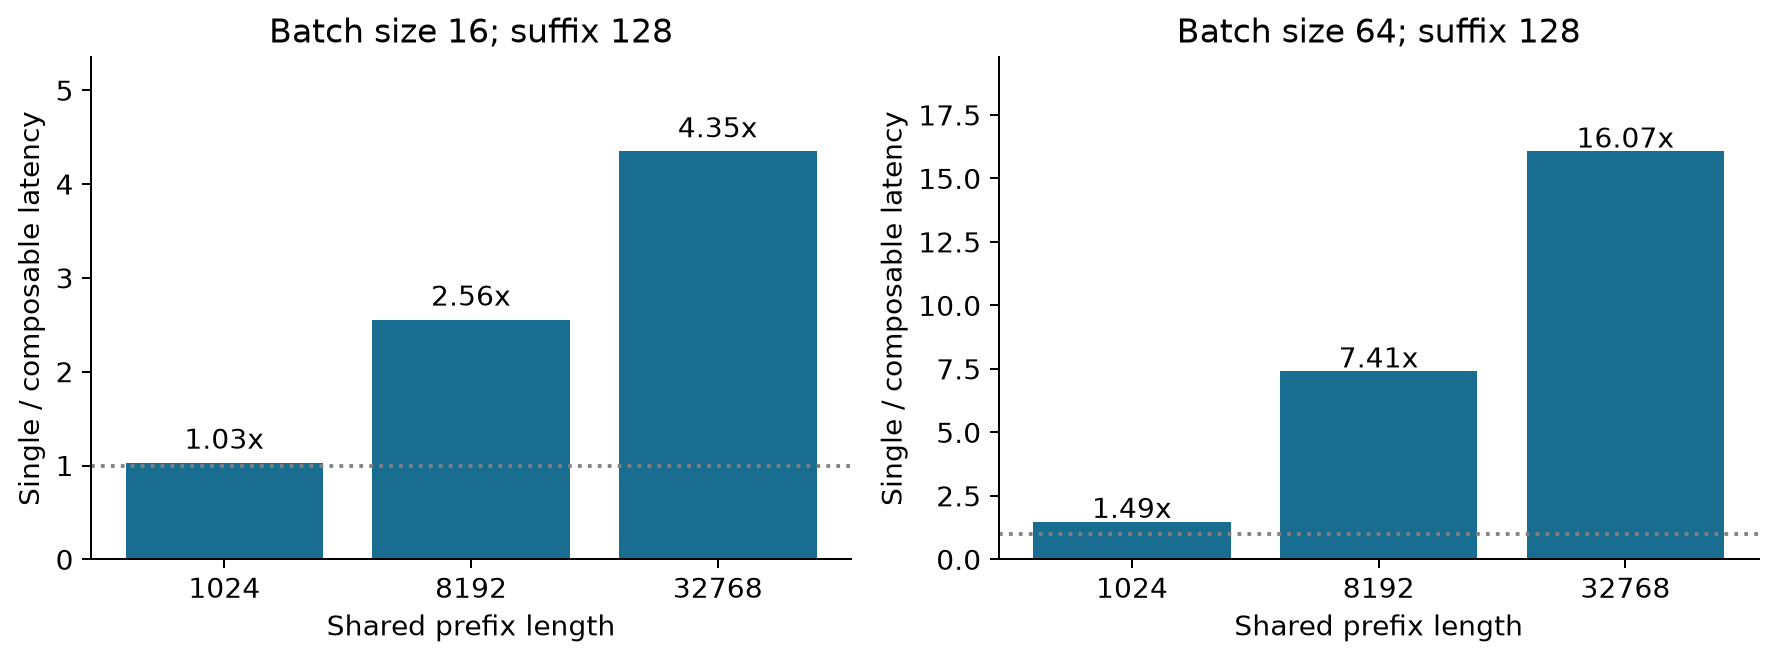
可以用一个流量模型理解趋势。设 个 query 共享 个前缀 token,每个 query 另有 个私有 token。若跨 query 没有片上复用,读取量粗略为 ;若前缀理想地只读一次,则为 。比值为
共享前缀主导时,它接近 ;私有后缀主导时,它接近一。这个模型故意忽略 L2 命中、重复 tile 加载、索引和合并。如果基线本来就能从缓存复用部分数据,其实际流量会低于模型估计。因此它只用于解释机制,不能当作实测时间必然达到的上界或保证。
端到端并行生成的结果要温和得多。原图 10 在 时标注 8B 的 ITL 改善为 13.73%,70B 为 17.42%。但 时标注分别是 -10.34% 与 -18.56%,说明增加拆分与合并可能反而变慢。
图文之间还有一个值得保留的小差异:正文称峰值出现在 ,但 8B 的 ITL 图在 处标注 +15.95%,大于 的 +13.73%。所以我把 当作论文报告的一个有效工作点,而不把它写成通用最优值。
这里 对应并行生成分支或候选完成,不应理解成一条自回归序列可以任意同时生成未来多个 token。不同分支共享前缀,才是这一实验利用的结构。
7.4 稀疏 gather 也有代价
附录 B 使用页大小一,把离散 KV 与连续 KV 对比。所展示的 decode 带宽接近,但 prefill 有明显吞吐损失,FA3 模板尤其如此。
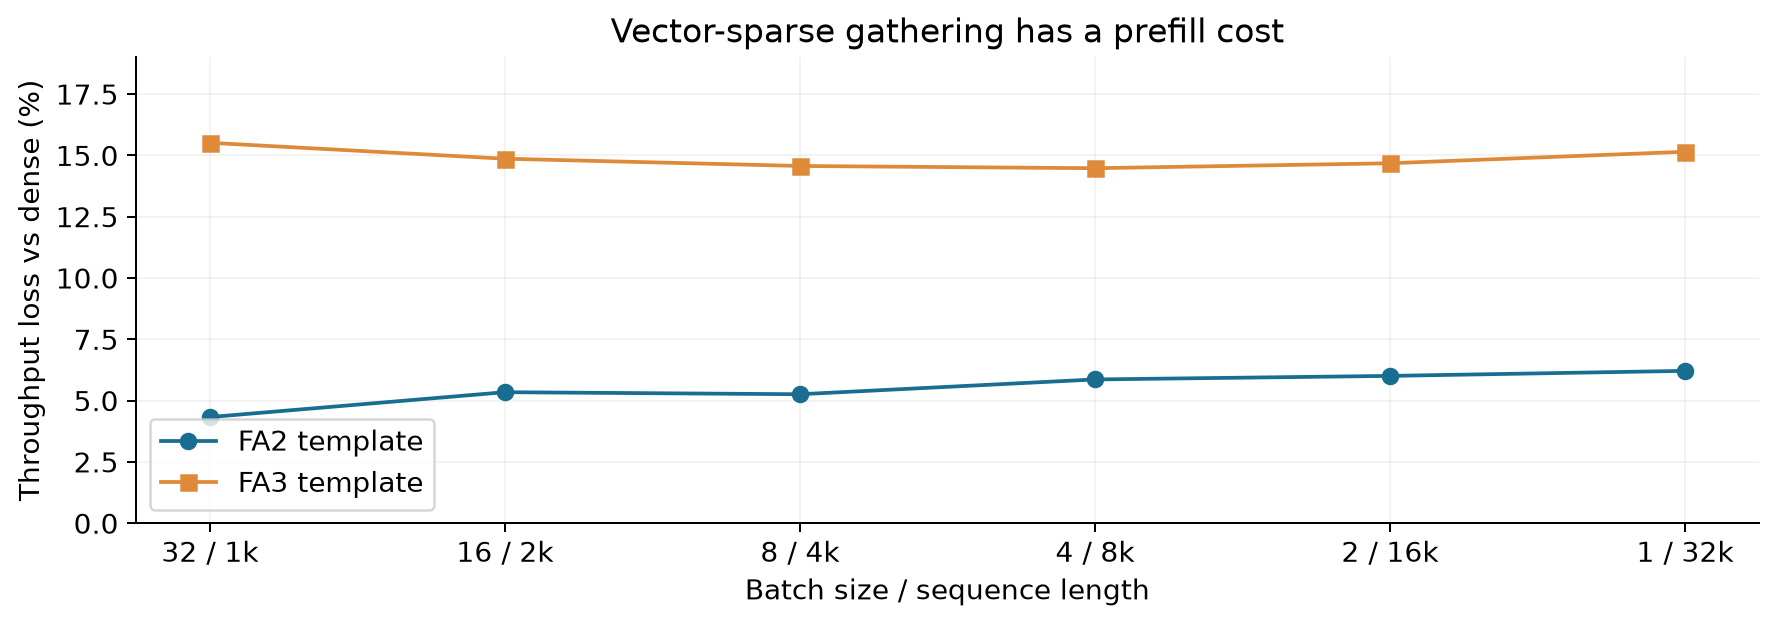
以 batch 一、长度 32,768 为例,FA2 的连续与稀疏数值为 370 和 347 TFLOP/s,损失约 6.22%;FA3 为 627 和 532,损失约 15.15%。附录笼统写“约 10%”,但不同模板的差别不应被这个平均印象抹掉。
吞吐减少与延迟增加也不是同一个百分比。在固定计算量下,627/532 对应约 17.9% 的时间增加。更高吞吐的连续路径,可能利用了稀疏路径无法使用的加载方式;稀疏表示的价值是灵活管理数据,并不意味着在相同工作量下自动快于连续表示。
7.5 融合与接入结果分别说明什么
Streaming-LLM 实验使用 Vicuna-13B 与 MT-Bench。原图 9 在 H100 上、最近窗口为 1000、2000、4000 时,融合 RoPE 的 ITL 分别为 13.2、13.3、13.4 ms;未融合对比为 18.2、19.1、20.0 ms。逐点计算的降低幅度约为 27.5%、30.4%、33.0%。正文的 28–30% 并未严格覆盖所有点,我优先保留明确数值对。
附录表 1–4 还比较了 causal、soft-cap、ALiBi、滑动窗口等变体,支持该实验环境下专门化模板的价值。但它们不构成 CUDA 相对 Triton 的永久排名。编译器对硬件特性的支持会演进,系统接入开销也可能独立变化。
vLLM 的结果尤其有提醒作用:
| 配置 | 吞吐 token/s | 中位 ITL ms | 中位 TTFT ms |
|---|---|---|---|
| 默认 bf16 | 6062.89 | 10.42 | 35.85 |
| FlashInfer bf16 | 6065.41 | 10.63 | 36.60 |
| 默认 e4m3 | 6015.86 | 12.56 | 39.74 |
| FlashInfer e4m3 | 6020.32 | 10.92 | 37.93 |
数据来自附录 G.4 表 8,请求率为 16。bf16 吞吐几乎不变,两项延迟却都恶化约 2%。使用 e4m3 KV 时,ITL 改善约 13.1%。作者将 bf16 回退归因于主机侧 Python 接入开销;表格证明了回退确实存在,但没有给出完整时间分解来单独验证全部因果归属。
8. 局限:哪些场景不能直接外推
版本与硬件范围有限。 论文中的 FlashInfer v0.2、SGLang v0.3.4 与编译器版本都影响结果。历史实验不能回答今天某个新模型、新 GPU 应该选哪个后端。论文展示的是前向推理,可定制反向 kernel 被列为未来工作。
统一表示要付出额外成本。 Gather、索引数组、局部状态与合并都会占用资源。对于完全连续且均匀的 prefill,简单 dense 路径可能更合适。很少的 query 或很短的共享前缀,也未必足以抵消准备与合并成本。
线性成本模型不完整。 无法直接覆盖所有 mask 密度、缓存命中、GQA 布局、量化转换和变体指令数。按预测值分得均匀,不保证真实 GPU 时间也均匀。这限制的是调度启发式,不是否定注意力状态合并的代数。
容量与生命周期属于正确性条件。 图执行期间,缓冲区必须保持有效;元数据传输必须先于消费;真实请求不能超出捕获配置覆盖的上界。论文解释了这些设计约束,但没有证明任意规模变化都能零成本处理。
中心统计量不能代替尾延迟。 主实验用 P99 TTFT 约束工作点,不意味着它完整展示了 P99 ITL、短请求公平性或突发到达时的行为。所示表格缺少置信区间,也使几个百分点的差异难以判断稳定性。
稀疏 kernel 的速度不能证明剪枝质量。 附录 G.5 的 Quest 场景说明它能高效计算选中的页面。被丢弃的键是否影响答案质量,属于上游选择算法的模型级问题,需要不同证据。
这些边界并不削弱论文的设计价值。相反,它们帮助区分“可以使用这套抽象”与“这个具体场景一定变快”。后者需要把完整服务链路纳入测量。
9. 批判性分析:真正需要优化的是执行边界
9.1 最值得保留的是不同变化速度的分离
我的主要收获,是不同信息应在不同时间固定下来。算子定义和硬件 tile 能力变化较慢,适合专门化;请求长度和页面归属每步改变,适合元数据;QKV 数值逐层改变,属于执行路径。
这解释了为什么“把 attention 编译一下”还不够。为每种请求形状重新编译,可能产生大量变体;把所有属性都留到运行时,又可能损失优化机会。FlashInfer 的视图、状态与计划构成了一组接口,让不同生命周期的信息各归其位。
其中一个实际好处,是 KV 所有权继续留在服务框架。注意力引擎消费这些缓存的视图,而不必变成第二套内存管理器。但边界越清晰,契约越要精确:逻辑位置、共享页、图容量与跨层计划复用都不能含糊。
9.2 推导规划成本的盈亏条件
假设每个生成步有 个可复用同一计划的注意力层。未优化时每层时间为 ,规划后的计算加合并时间为 。CPU 规划与元数据传输中落在关键路径上的成本为 ,新暴露的接入开销为 。那么
要获得正收益,需要
这是我为解释设计补充的简化模型,不是论文测得的耗时分解。它说明为什么跨层复用计划很重要,也解释了为什么一个 kernel 的小提升可能被主机侧开销吃掉。若不同层的可见长度或布局不兼容, 要支付多次,结论就会改变。
举例说,,每层节省两微秒,新增固定开销 30 微秒,则每步净省 34 微秒。如果每层只省半微秒,同样接入就会慢 14 微秒。这里没有 GPU 实验,只是在说明测量必须分辨的时间尺度。
9.3 为什么十几倍 kernel 提升可以只剩两成系统提升
设原来一步中,待优化注意力占比为 ,它获得 倍加速。暂时忽略新增开销,Amdahl 定律给出
当 ,整个生成步只有约 倍。于是,共享前缀 kernel 的 倍与端到端十几个百分点的改善完全可以同时成立。真正有解释力的实验,应同时报告被优化部分的占比与新增成本,而不是让读者把 kernel 加速直接套到整个服务。
9.4 我希望增加哪些实验
更强的因果证据,需要固定到达轨迹、模型、精度、缓存策略和图配置,再逐项改变优化。先在相同可见 token 数下比较连续加载与索引加载;再固定 microkernel,只改变调度;最后保持物理缓存分配,开关前缀组合。这样才分别回答表示成本、均衡收益和复用收益。
测量内容应包括设备注意力时间、CPU 规划、元数据传输、合并、工作区峰值,以及用户能感知的 TTFT、ITL 和请求吞吐。中位数之外还应报告尾延迟与短请求公平性。对于仅有约 2% 的变化,重复试验和不确定性尤其重要。
9.5 算法 4:建议的对照实验流程
这是后续研究建议,不是本文已经完成的实验,也不是作者程序的核验流程。
1. 固定一条请求到达轨迹、模型、精度与缓存策略。
2. 定义均匀、变长、偏斜、共享前缀四类负载。
3. 每组对照只改变一项优化。
4. 使用相同策略预热已准备的执行配置。
5. 重复同一轨迹,记录主机、设备与用户层指标。
6. 将规划、传输、合并及工作区成本纳入统计。
7. 报告分布、不确定性以及性能回退。
8. 分开呈现 kernel 比值与端到端延迟降低比例。
我还会把共享前缀长度与生成分支数联合扫描。只看一个分支数无法总结复用机会: 比值、attention 在整步中的占比、基线真实缓存命中率,都可能移动组合格式的盈亏点。
对 CUDA Graph 兼容性,值得增加跨容量边界的受控实验。稳定状态下重复 replay 的测试,会遗漏图准备、缓冲区增长和配置切换。这些开销未必很大,但只有量出来,动态负载的结论才更完整。
9.6 我的判断
论文有说服力地说明:注意力引擎应该消费服务系统已经知道的结构信息,而不只接收几个 dense shape。状态合并的代数清楚,缓存复用的来源具体,附录还提供了接入回退等反例。最值得迁移的是把布局、微内核与调度独立决策,再用可合并状态把它们连接起来。
相对不确定的是每项设计对最终提升的独立贡献,以及旧软件栈结果能外推多远。完整后端比较同时改变多项因素,vLLM 结果又说明主机开销可以抵消设备优势。我愿意采用这套设计原则,但会把每个具体加速比例视为与工作负载绑定的结论。
10. 结论
FlashInfer 把三个常被 dense shape 隐藏的问题显式化:KV 实际存在哪里,哪些 query 可以共享加载,以及不同请求各自有多少工作。注意力状态保留归一化信息,使拆分结果能够正确合并;稀疏视图分离缓存所有权与计算布局;运行时计划则让固定程序适应每步变化的负载。
我的实际判断顺序是:先找瓶颈,再估计能消除多少重复访存或等待,最后把规划、传输和合并的新增成本算进去。长且偏斜的请求、大共享前缀通常提供更明确的机会;均匀短请求或主机侧负担较重的服务,需要更谨慎地评估。
读完之后,比“FlashInfer 快多少”更有价值的问题是:服务系统掌握的哪些结构信息还没有被执行引擎利用?这些信息应该在编译时固定,还是在每步更新?这两个问题,也能指导其他不规则 GPU 工作负载的接口设计。
资料与配图来源
- Ye 等,FlashInfer,arXiv:2501.01005v2,MLSys 2025。主文与附录 A–G 共 21 页;第 2–3 节支撑方法解释,第 4 节与附录 G 提供实验数据。
- 项目主页与官方仓库仅作为资料入口。
- 图 1–5 是根据论文概念绘制的解释图、解析曲线或玩具例子,不含新模型实验。
- 图 6 重绘论文图 7;图 7 重绘附录表 6;图 8 从附录表 5 计算延迟比;图 9 从论文图 12 计算吞吐损失。正文保留原始比较条件与数据出处。
- 本文新增的公式、成本例子和对照实验建议均为阅读分析,不代表已经复现论文中的模型或服务实验。