笔记日期: 2026-09-17。作者: Zhongzhu Zhou。
Paper reviewed: QeRL: Beyond Efficiency — Quantization-enhanced Reinforcement Learning for LLMs。
Paper authors: Wei Huang, Yi Ge, Shuai Yang, Yicheng Xiao, Huizi Mao, Yujun Lin, Hanrong Ye, Sifei Liu, Ka Chun Cheung, Hongxu Yin, Yao Lu, Xiaojuan Qi, Song Han, Yukang Chen。
arXiv: 2510.11696v1,2025-10-13 提交,全文 21 页。本文的表格、公式与页码均以 arXiv v1 为准,不假定会议版本与之完全相同。
1. 我从这篇论文里读到了什么
强化学习训练语言模型时,显存和探索常被当作两个独立问题。前者问模型、优化器、激活和 KV cache 能否同时放下;后者问模型能否生成足够多有价值的回答,从奖励里获得有效梯度。QeRL 的出发点是把二者联系起来:用 NVFP4 压缩冻结的主干,用 LoRA 承担参数更新,再通过归一化层上的噪声改变生成策略。压缩引入的误差不再只被视为需要修补的质量损失,也可能成为探索的来源。
这个想法有吸引力,但我会把它拆成三个需要分别验证的命题。第一,低精度表示是否真的减少了当前瓶颈上的数据移动?第二,扰动是否增加了能带来学习信号的有效回答?第三,完整训练是否更快达到一个预先设定的质量目标?一个更快的 decode kernel,只回答了第一个问题的一部分;一条更高的熵曲线,也没有自动回答第二个问题。
论文在 7B GSM8K 实验中报告:BF16 LoRA 为 88.1%,NVFP4 加 AQN 为 90.8%,全参数更新为 91.2%。这个结果值得认真读。但另一张表里,7B 的四项基准平均分在加入 AQN 后从 37.0 降到 36.4。32B 模型能够在特定单 H100 80GB 配置下训练,则说明它有很实际的可运行性价值。把这些结果并列看,比只记住“量化帮助 RL”更有用。
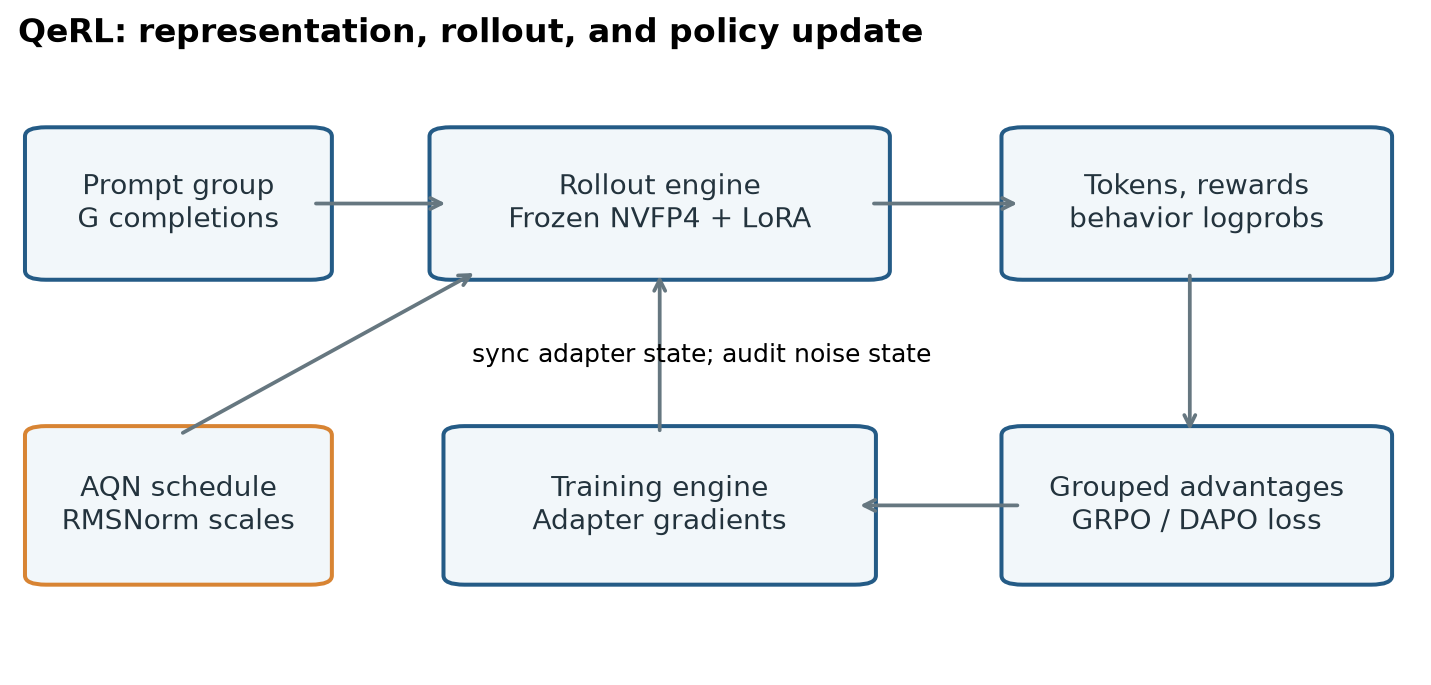
图中我特意把行为策略的 log-probability 放在生成结果旁边。引入噪声后,生成这条回答的到底是哪一个策略,是训练正确性的一部分。只同步 LoRA 矩阵而忽略归一化状态、采样配置或噪声作用范围,就可能把系统实现问题带进梯度估计,却误以为只是随机种子带来的波动。
本文先把前置知识讲清,再推导 AQN 的实际扰动形式,最后讨论实验和复现。我关心的不是用一句话赞同或否定论文,而是区分哪些结论已经由现有结果支持,哪些结论还需要更直接的干预实验。
2. 前置知识:省下的参数状态,与仍需执行的计算
2.1 LoRA 到底省了什么
先采用列向量约定。投影矩阵 ,输入 。LoRA 用两个较小矩阵表示更新:,。若适配器缩放系数为 ,量化主干上的前向计算为
冻结的主干不保存可训练参数的梯度和优化器状态,适配器则需要这些状态。但 仍然要算,生成每一个 token 时仍然要访问主干权重。反向传播也没有全部消失:为了把梯度传到更早的适配器,仍可能需要经过冻结层的输入梯度计算。因此“可训练参数很少”与“训练计算量按同样比例下降”是两回事。
以一个 的方阵为例,主干有 16,777,216 个参数;rank 为 32 的两个适配器共有
个参数,占这个矩阵的 1.5625%。这是解释性的单层计算,不是整模型的测量。非方形 FFN、未量化 embedding、适配器放置位置、是否训练归一化尺度,都会改变整模型的比例。
冻结还有一个与 kernel 有关的好处:量化格式和打包布局可以保持稳定。如果每一步都修改稠密主干,就必须考虑何时重新计算尺度、重新舍入、重新打包,以及训练使用哪一份权重。QeRL 借助冻结主干绕开了这类全参数低精度训练问题,把主要更新留在较小的高精度分支里。
2.2 组内奖励为什么能产生学习信号
对同一个问题生成 个回答,得到奖励 。组相对优势的一个常见定义是
减去均值,是比较这条回答是否比同组其他回答更好;除以标准差,则改变了不同问题组对更新的相对权重。后者并不只是避免数值过大的小技巧。尤其在二元奖励中,成功率不同的问题组,会产生不同的标准化梯度尺度。
例如奖励为 时,均值是 ,采用总体方差定义得到标准差 ,忽略很小的数值 epsilon 后,优势为
如果四条回答都是错的,均值和所有中心化奖励都为零,奖励驱动的更新也为零。给分母加 epsilon 可以防止除零,却不能凭空产生信息。如果四条回答全对,问题类似:这个组同样无法区分哪条更值得强化。
这提供了一个理解探索的具体角度:好的探索,能让更多原本奖励全同的组出现有区别的结果,而不是单纯生成更多不同字符串。对数学任务而言,格式错误、不可解析答案和无效推导也可以增加字符串多样性,却未必增加可利用的学习信号。
GRPO 的标志性简化是省去学习式价值 critic,并不是禁止学习式 reward model。QeRL 采用数学奖励任务,是它的实验设置,不能被写成 GRPO 的一般定义。另一个需要分开的地方是 KL:论文介绍方法时给出带 KL 的目标,但附录 E 说明实际训练没有熵损失和 KL 损失。解释概念目标时可以保留 KL,描述实际实验时必须服从实验配置。
2.3 策略比率的分母来自谁
令 token 状态为 ,生成数据的行为策略为 。常见的 token 概率比率是
裁剪目标取 与裁剪后的版本两者较小值。正优势的回答不应因概率已经提升很多而继续得到无限激励;负优势则对应另一侧的限制。裁剪约束的是代理目标的更新激励,不能修复一个来自错误行为策略的分母。
对 QeRL 来说,量化主干可以是静态的,但 AQN 会改变归一化参数,进而改变生成分布。训练和生成都使用四比特权重,只能说明表示精度的一项条件相同。LoRA 版本、噪声状态、温度、top-p 支持集、实际数值 kernel,以及缓存是否失效,仍然可能不同。看见训练比率接近 1,也不能在未核对这些因素前宣称数据严格 on-policy。
3. NVFP4:格式、尺度和执行路径要一起理解
3.1 四个 bit 不等于均匀整数网格
E2M1 使用一个符号位、两个指数位、一个尾数位。其非负可表示值包括 ,间隔并不均匀。NVFP4 在这个小网格外叠加两层尺度:每 16 个权重共享一个 FP8 E4M3 块尺度,再用一个 FP32 张量尺度处理更大的整体范围。
对于块 中的第 个权重,可以把重建写成
如果尺度已经固定,一个便于理解的量化操作是选择重建误差最小的网格点:
这只是解释量化值如何表示,不是完整 AWQ 校准算法。实际校准可以关心激活加权误差、裁剪范围或通道敏感性,不一定等同于逐个权重最小化绝对误差。论文对 NVFP4、MXFP4 使用了 AWQ,并以 OpenThoughts-114k 的 256 条、每条 2048 token 的序列进行校准;NF4 则采用默认设置。因此实验比较不只更换了数字格式,也更换了校准方式与可用 kernel。
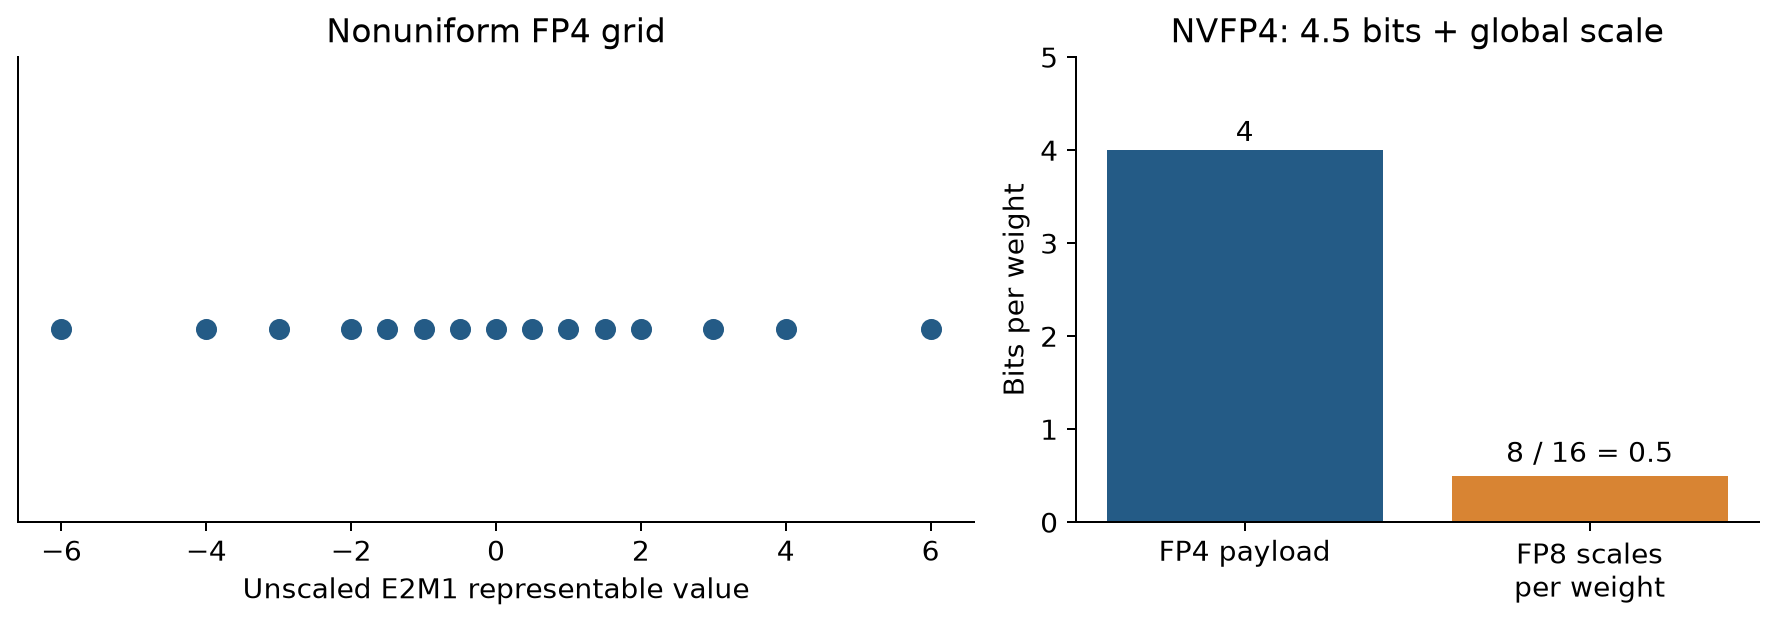
按理想布局计算, 个权重的四位载荷需要 字节, 个块尺度还需要 字节,故
BF16 为每个参数两个字节,因此仅看这部分的理想压缩倍数为
把它写成必然四倍,会漏掉块尺度;把 3.56 倍直接写成训练显存收益,又会漏掉适配器、优化器、KV cache、激活与 workspace。NVIDIA 的 NVFP4 格式说明也明确给出了约 4.5 bits/weight 的含尺度记账。
3.2 为什么更省空间的表示有时反而更慢
自回归 decode 往往需要为少量新 token 读取很大的权重。压缩权重可以减少内存带宽压力。但读取后还要拆包、恢复尺度、转换到算术单元支持的操作数布局。如果这些步骤不能与访存和乘法有效重叠,节省的字节可能被额外指令吃掉。QLoRA 能省显存,并不意味着其默认 NF4 路径一定能加速 RL rollout。
QeRL 采用 Marlin 的 NVFP4 权重乘 BF16 激活路径。这里必须区分“某 GPU 上的软件能运行 NVFP4 权重”与“该 GPU 原生执行 FP4 Tensor Core 指令”。论文的 H100 结果不代表 H100 获得了 Blackwell 的原生 FP4 算术。存储格式、解包后的计算精度、累加精度、硬件架构应分别记录,否则容易把软件兼容性写成硬件能力。
我会用一个简单的投影核验先排除布局问题:保存同一小批输入,把打包 kernel 的输出与按照同样尺度显式反量化后的参考矩阵乘法比较。此时还不引入奖励或采样。如果直接开始 RL,适配器可能部分补偿一个错误的布局,使问题看起来只是初始效果略差,反而更难定位。
算法 1:准备可核查的 QeRL 主干。以下是依据论文整理的解释性步骤。
- 固定预训练 checkpoint、tokenizer 和 chat template,保存版本标识。
- 选择校准序列,记录数据来源、条数、长度以及预处理方式。
- 对目标矩阵确定激活感知的变换、裁剪参数和块尺度。
- 生成 E2M1 编码,保留 E4M3 块尺度与全局尺度。
- 按实际推理 kernel 的要求打包,核对矩阵尺寸、分组轴和 padding。
- 加入 LoRA,明确 rank、缩放系数和哪些投影启用适配器。
- 用固定输入比较参考反量化乘法和实际 kernel 输出。
- 分别测模型驻留内存和完整训练配置的峰值,再进入 RL。
若要改成全参数低精度训练,还需要解决梯度、舍入与尺度更新的问题,那已超出这篇论文的冻结主干加 LoRA 设置。复现时保持这个边界,可以避免把另一套训练技术的假设混进来。
4. 量化噪声为什么不能保证提高熵
4.1 先把“误差让分布变平”写成导数
静态量化残差是 。它通过网络传播,在某个问题上造成 logit 变化 。即使权重误差在某种校准分布下均值为零,也不能直接推出每个问题的 logit 扰动均值为零;多层非线性变换不会自动保留这个性质。
设
先求 softmax 对 logit 的导数:
再对熵用链式法则。 的微分为 ,而概率之和恒为 1,因此其导数之和为零。代入并整理得到
所以,小扰动带来的熵变化一阶近似为
式子里没有一个自动非负的量。扰动若进一步抬高已占优势的 token,分布通常更尖;若降低这个 token 的 logit,则可能变平。论文展示的是特定模型、量化方式和训练条件下的经验曲线,不是任意量化器都提高探索的定理。
用一个很小的例子即可看清方向。初始 logits 为 ,熵约 0.524 nats。只给最大 logit 加 0.5,熵约变为 0.386;只给它减 0.5,熵约变为 0.680。这三组数由本次笔记直接计算,不涉及 Qwen、训练数据或 GPU。
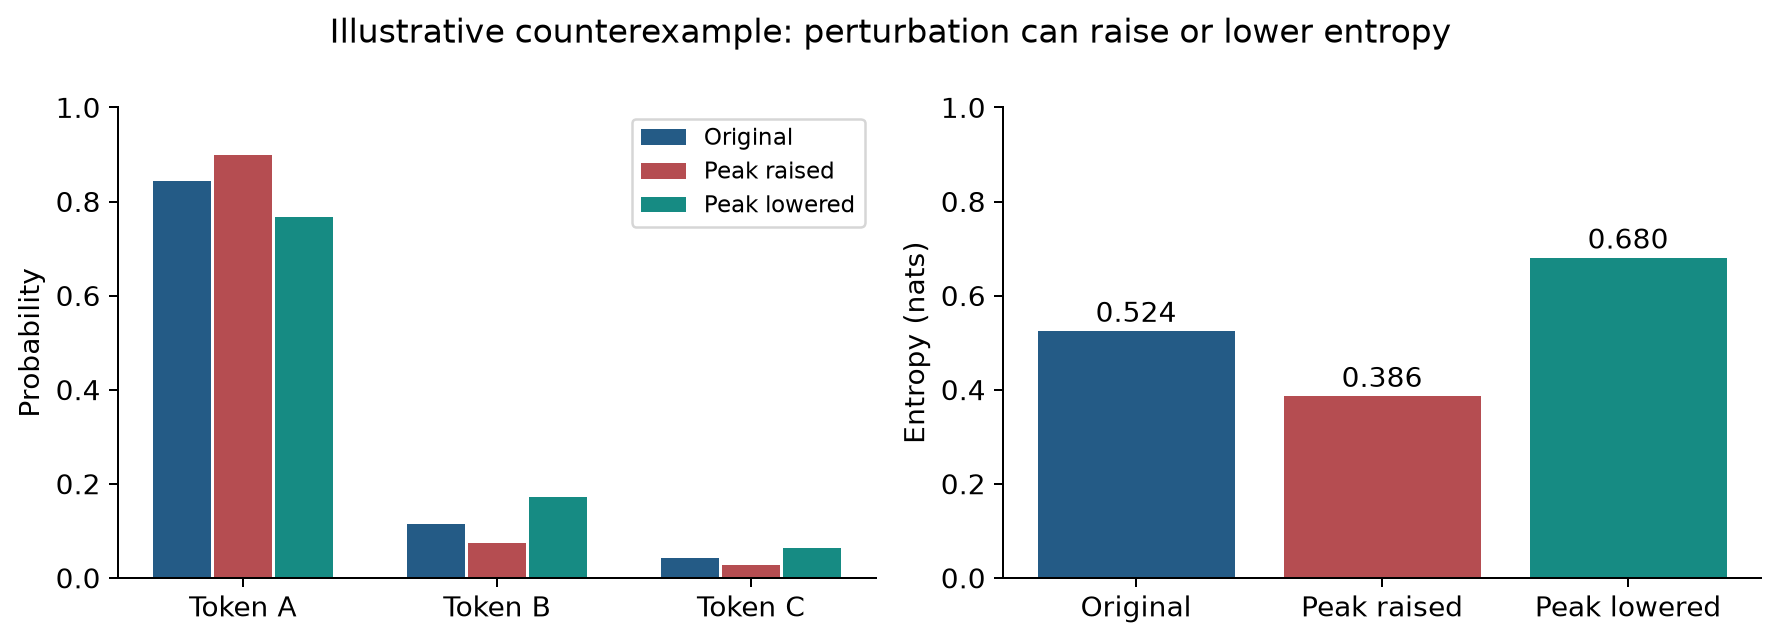
这个反例并不否定 QeRL 的观测。它限定了可以从观测推出的结论:量化可能在这个任务分布上产生有利扰动,但需要说明为什么这些扰动往往朝着有利方向,而不是把所有数值误差都称为探索奖励。
4.2 零均值噪声也不足以保证正收益
如果假设 logit 噪声零均值、协方差为 ,一阶项在期望下抵消。二阶展开给出
现在方向由熵对 logits 的曲率及噪声协方差共同决定。以均匀分布为边界例子:它的熵已经最大,任何让单次分布变得非均匀的非平凡扰动,都不可能让这些单次分布的平均熵更高。因而“均值为零”与“平均熵提高”之间仍然缺少条件。
进一步说,熵提高也不等于质量提高。数学任务需要的是能形成有效奖励差异的探索,不是让所有词的概率接近。若噪声显著增加格式错误或中途偏离题意,即使熵升高,也可能减少可解析、可学习的回答。一个合理的噪声强度需要同时看有效回答率、正确率、组内奖励差异和长度变化。
4.3 策略之间的多样性,不等于单个策略内部的熵
设每次抽到噪声状态 ,输出为 ,固定问题为 。信息论恒等式给出
左边是把所有噪声状态混在一起后的输出熵;右边第一项是固定噪声后的平均熵,第二项表示输出多大程度上随着噪声状态改变。两者不是同一个测量。
例如,每种噪声都让模型很自信地选择一种不同的解题策略,条件熵可以不高,混合后的多样性却很大。这可能是有用的、整条回答保持一致的探索。相反,如果每生成一个 token 就换一次噪声,可能增加局部随机性,却破坏推理路径的一致性。论文对“每次 forward”和训练阶段噪声的描述,需要结合实际作用范围理解。
因此我希望看到的不只是一个标为 entropy 的标量,而是明确的测量定义:固定哪些 prompts,是否包含低概率 token,是否经过 temperature/top-p,按 token 还是按回答平均,是否先对噪声取期望。再加上奖励混合组比例、有效解题路径数量和无效答案率,才能把抽象的探索解释落实到学习数据上。
5. AQN 的实际形式:把噪声放进 RMSNorm
5.1 从归一化尺度推到权重行缩放
这一节切换到行向量记号,使输入通道的变换更直观。令
其中 是 RMSNorm 的逐通道尺度。给尺度加上向量 后,有
若所有 ,定义 ,则 。对后面的投影矩阵 ,
这说明:归一化尺度上的加性噪声,等价于后续矩阵的乘性行调制。它不等价于给整个权重矩阵的每个元素独立加一个高斯噪声。后者自由度多得多,相关结构也不同。论文用一般加性噪声解释动机时比较直观,但理解实际实现应以这个有结构的变换为准。
只是为了把变化写成相对缩放比率。原始表达式 在某个尺度为零时仍然有定义。不过近零尺度仍然是值得监控的边界:绝对值很小的噪声,相对于这个尺度可能非常大。实际前向不需要真的计算 ,但分析扰动敏感性时不能忽略这个问题。
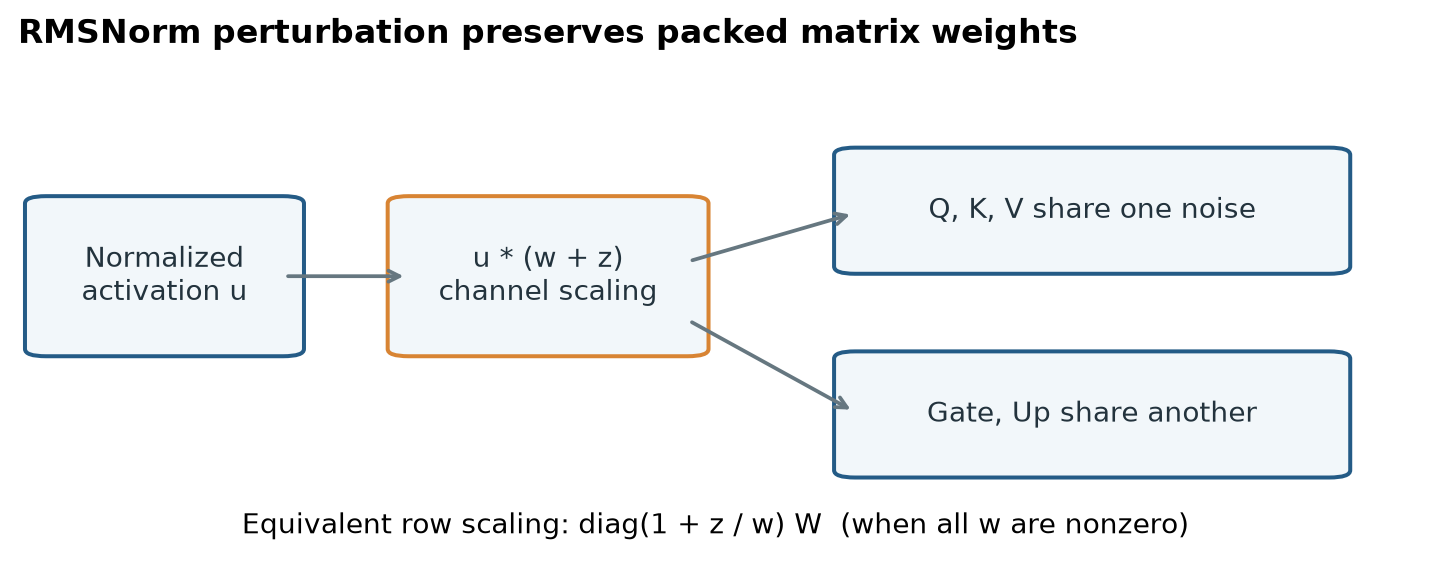
这种设计的系统优势很明确:修改的是输入进入投影前已有的通道尺度,打包的四比特矩阵本身可以保持不变,推理 kernel 的布局约定不被破坏。若直接给量化权重加任意高精度矩阵,要么重新打包,要么额外执行一个分支,都会改变效率条件。
但“没有额外可训练参数”不等于实际执行完全免费。随机数生成、状态恢复、训练与 rollout 引擎同步、prefix cache 失效,都有真实执行位置。即使这些成本很小,也应在时间记录中体现,而不是从“零参数”推出“零开销”。
还有一个图文不一致值得说明:主文和图 6 说 FFN 中共享噪声的是 Gate、Up,附录 G 的一句话写成 Down、Up。根据计算图,应理解为直接相邻的 Gate、Up 共享归一化输入;Down 的输入还经过了门控乘法和非线性。我采用前者,不把附录里的措辞照抄成一般等价关系。
5.2 共享噪声带来的限制,也可能是作用来源
Q、K、V 使用同一组通道噪声,因此它们不是三个相互独立的扰动矩阵。这会改变 attention logits 和 value 表示之间的相关性。Gate、Up 之间的共享也会影响门控通道的联合变化。这样的耦合可能比完全独立噪声更温和,也可能在某些层同时放大误差。
如果想进一步解释机制,一个比“继续增大噪声试试”更有区分力的实验,是在相同输出扰动幅度下比较共享噪声与独立噪声。这样才有机会判断收益是否来自参数空间的结构,而不只是总体随机程度不同。另一条思路是按层或按通道敏感性分配噪声预算;但它会引入新的超参数,必须与全局固定尺度做等预算比较。
5.3 指数日程要明确起点和终点
论文先保留一段零额外噪声的 warm-up,再加入逐渐减小的随机扰动。一个明确的十阶段约定是:第 0 阶段不加 AQN,第 1 至第 9 阶段使用正噪声,并让首尾恰好等于设定值。
若 start 为 0.01、end 为 0.0005,第 1 阶段就是 0.01,第 9 阶段就是 0.0005。取对数后,各阶段之间的间隔相等;回到原尺度,前期绝对减幅较大,后期较小。这里的“自适应”主要体现为训练过程中变化的人工日程,并非根据当前奖励或熵自动闭环调节。
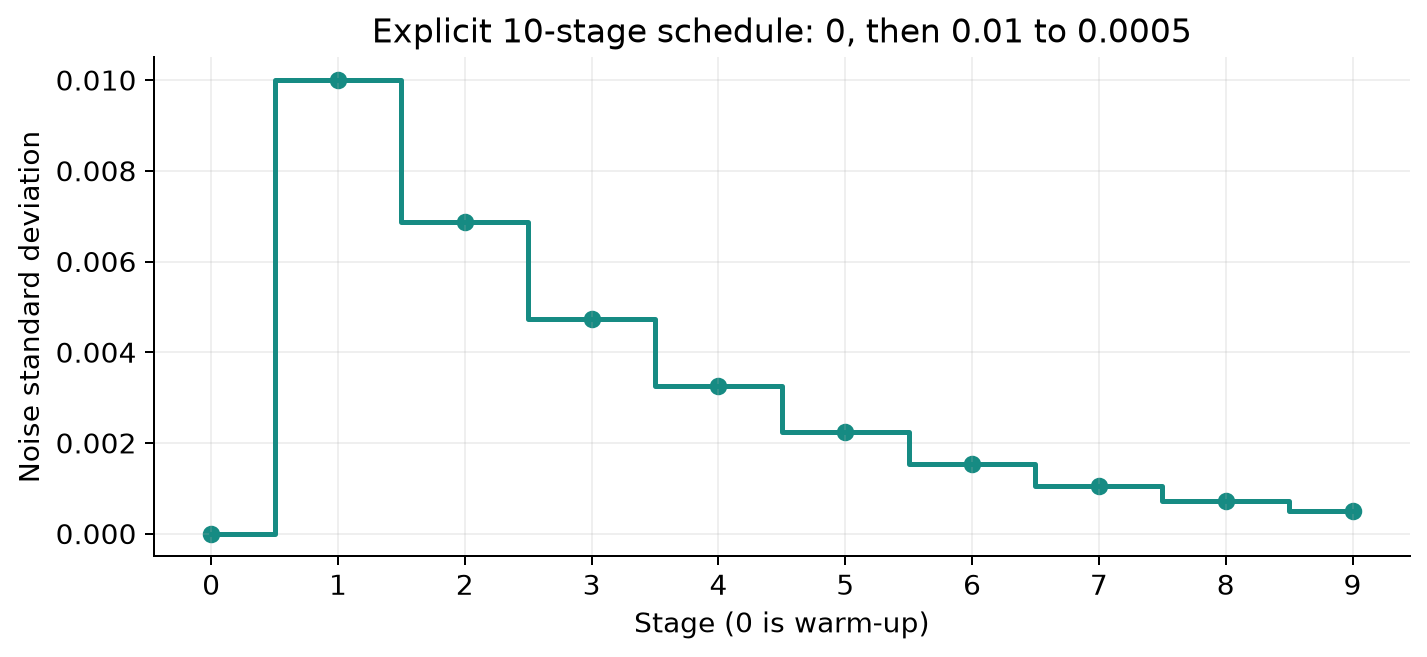
论文式 8 与算法 1 分别用了正阶段和带零阶段的描述,解释时需要统一下标。上面的十阶段约定包含九个正噪声等级,指数分母为八,因此起点和终点都能恰好取到。这是对论文日程的明确写法,不代表某个软件版本的实际运行记录。
论文中的数值也不完全相同:主文实验设置提到 0.05 到 0.0005,表 4 写 0.01 到 0.0005。分析与比较应注明使用哪组论文设置,不能默选一种后把它写成所有实验统一的参数。
6. 把随机状态写进训练算法
我更愿意用一份显式记录行为策略的算法来理解 QeRL。下面把散落在公式和正文中的决策放到同一个流程里,作为解释性整理;不声称原论文逐项记载了所有步骤。
算法 2:一次可追溯的生成与更新循环。
- 加载冻结的量化主干、当前适配器、归一化尺度、tokenizer 和生成配置。
- 根据已完成的更新步数与计划总步数,确定噪声阶段。
- 保存干净归一化尺度,枚举本轮真正需要注入噪声的模块。
- 使用记录的随机种子抽取噪声,并明确其持续范围:整个 rollout、一条回答,或单个 token。
- 由适配器版本、噪声状态、温度和支持集规则定义行为策略。
- 按问题生成回答组,保存 token mask 以及估计器所需的行为概率。
- 计算奖励与优势,将正常答错、答案解析失败和截断分别记录。
- 根据目标函数恢复干净尺度,或重放本轮约定的噪声状态。
- 用实际行为策略的分母计算概率比率,应用选定的裁剪损失。
- 更新可训练参数并同步生成引擎,让依赖旧状态的缓存失效。
- 记录混合奖励组比例、长度、熵定义、比率统计、分阶段时间与峰值内存。
- 用明确的部署策略评估,说明测试时是否关闭 AQN。
第 8 步决定了正在优化什么。可以把噪声视为条件输入,训练条件化的随机策略;也可以用带噪声的策略采样,训练最后希望部署的干净策略。这是两种不同的估计问题,不宜只用“量化精度一致”将其合并。
假设每条回答固定一个噪声状态 ,行为分布为
对噪声积分得到的边缘分布是
这是“乘积的期望”,一般不是“期望的乘积”。因为同一噪声作用于整个回答,不同 token 的条件分布通过这个隐藏状态相关。保存噪声可以使条件概率可计算,但训练目标也必须识别这个条件,不能一面使用条件概率,一面假装已经精确得到边缘策略。
若目标是用 noisy rollout 更新 clean policy,精确的轨迹重要性比率会涉及各 token 比率的乘积,长序列方差可能很大。GRPO 的 token 裁剪代理本身已经是实际可用性与精确轨迹校正之间的折中;新加入的、没有跟踪的噪声不应被说成“自动校正”。本文没有运行这个估计器,因此这里只指出需要明确的统计条件。
另一个边界来自 top-p。假如行为采样把某些 token 概率截为零,而目标干净策略仍对这些 token 赋正概率,重要性采样无法恢复从未被行为策略覆盖的概率质量。温度也会改变真正的采样分布。它们不是 QeRL 独有的问题,但引入 AQN 后,应更明确记录 log-probability 到底来自原始模型还是经过变换的采样器。
7. 实验结果应该怎样读
7.1 先区分训练协议,再比较数字
原论文表 1 使用 GRPO 在 GSM8K 上训练;表 2 使用 DAPO 和 BigMath 数据,再在四个数学基准上评估。二者不是同一轮训练的不同汇总。下面摘取能看出主要趋势的原始数值,不跨协议重新混合平均。
| 设置 | BF16 LoRA | NVFP4 LoRA | NVFP4 + AQN | BF16 Full |
|---|---|---|---|---|
| GSM8K,3B | 76.1 | 83.3 | 83.7 | 84.4 |
| GSM8K,7B | 88.1 | 88.5 | 90.8 | 91.2 |
| 四项均分,7B | 35.7 | 37.0 | 36.4 | 37.3 |
| 四项均分,14B | 40.2 | 40.5 | 42.0 | 43.3 |
| 四项均分,32B | 42.2 | 41.4 | 45.6 | 46.2 |
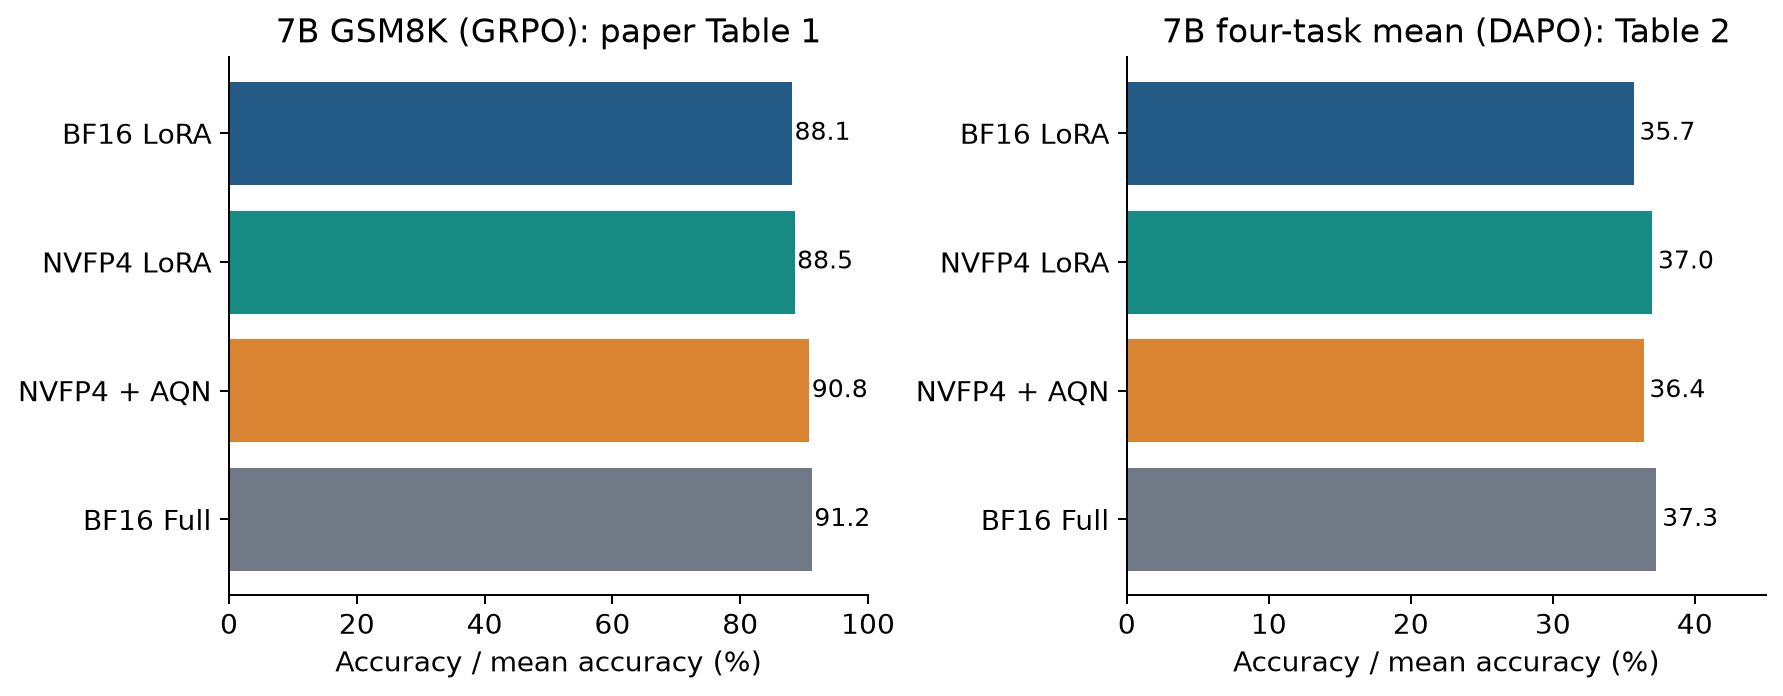
表 1 中 90.8 与 88.1 的差值为 2.7 个百分点,主文第 4.2 节却写为 1.7。这里应优先保留可追溯的原始单元格,再明确说明复算结果。发现这种局部算术不一致,并不意味着其他结果都不可信,但说明不能只复制正文中的概括。
表 2 的 7B 结果则揭示了一个更有研究意义的边界。加入 AQN 后,MATH500 从 76.8 到 77.4,AIME24 从 13.7 到 15.5,AIME25 保持 10.0,AMC23 从 47.5 到 42.5。四项变化相加再除以四,平均下降约 0.6。也就是说,AQN 的效果具有任务分布差异,不能把几个提高的指标压成“各基准均提高”。
对全参数更新的比较同样如此。QeRL 在 7B MATH500 上达到相同的 77.4,但这里列出的 7B、14B、32B 四项均分仍分别低于全参数更新。一个显存更省、质量接近的方案已经有价值,无须把“接近”改写成“全面匹配”。保留每个基准的向量,比只显示平均数更能帮助使用者判断。
7.2 学习率不是可以忽略的背景变量
附录 E 对量化方案使用 ,对 BF16 LoRA 使用 ,理由是较大的 BF16 更新可能在后期崩溃。附录 I 还比较了更大的学习率,显示稳定性有差异。这支持“最合适的训练配方随表示变化”的判断,却不是只改变量化噪声的单变量实验。
我会区分两类比较。若研究机制,应尽量固定学习率、数据顺序、组大小、优化器和评估协议,再观察量化或 AQN 的干预效果。若研究实用性,应允许每种方案调参,但要给相同的搜索预算、失败预算和选择标准。两类比较都合理,结论却不同。把调参后更快的奖励增长全部归因于熵,就会跳过学习率这个重要因素。
rank 也应一并记录。论文主实验通常用 32。论文的 rank 消融在一个设置下呈现相近趋势,不能推出所有模型与数据上都不敏感。较高 rank 既改变可学习的更新子空间,也增加生成时适配器的计算开销;因此 rank 的图最好同时包含质量、吞吐和内存,而不是只给奖励曲线。
7.3 训练曲线快,不一定等于更快达到部署目标
横轴为训练步数的奖励曲线,展示的是更新次数与训练奖励的关系。每一步可以生成不同数量或长度的 token,使用不同有效 batch,还可能因动态采样补充不同数量的问题。若只看步数,比较对象之间的实际计算预算可能已经不同。
更实用的做法是预先选定 held-out 目标质量,再记录达到目标所需的总生成 token、墙钟时间和 GPU-hours。没有达到目标的运行,应该记为给定预算内失败或删失结果,而不是依据前几十步趋势外推一个“预计收敛时间”。同时,评估应使用最终想部署的策略,明确是否仍带 AQN。
8. 系统记账:模型小了,整轮一定快吗
8.1 模型文件大小不是训练峰值显存
表 5 至表 8 给出的 BF16/NVFP4 模型大小依次为:3B 的 6.2/2.8 GB,7B 的 15.2/5.9 GB,14B 的 29.6/10.6 GB,32B 的 62.3/20.7 GB。这里沿用论文 GB 单位,不自行假定它实际使用 GiB。数字与理想 3.56 倍并不完全一致,因为模型里还有不遵循同一种打包格式的参数和分配。
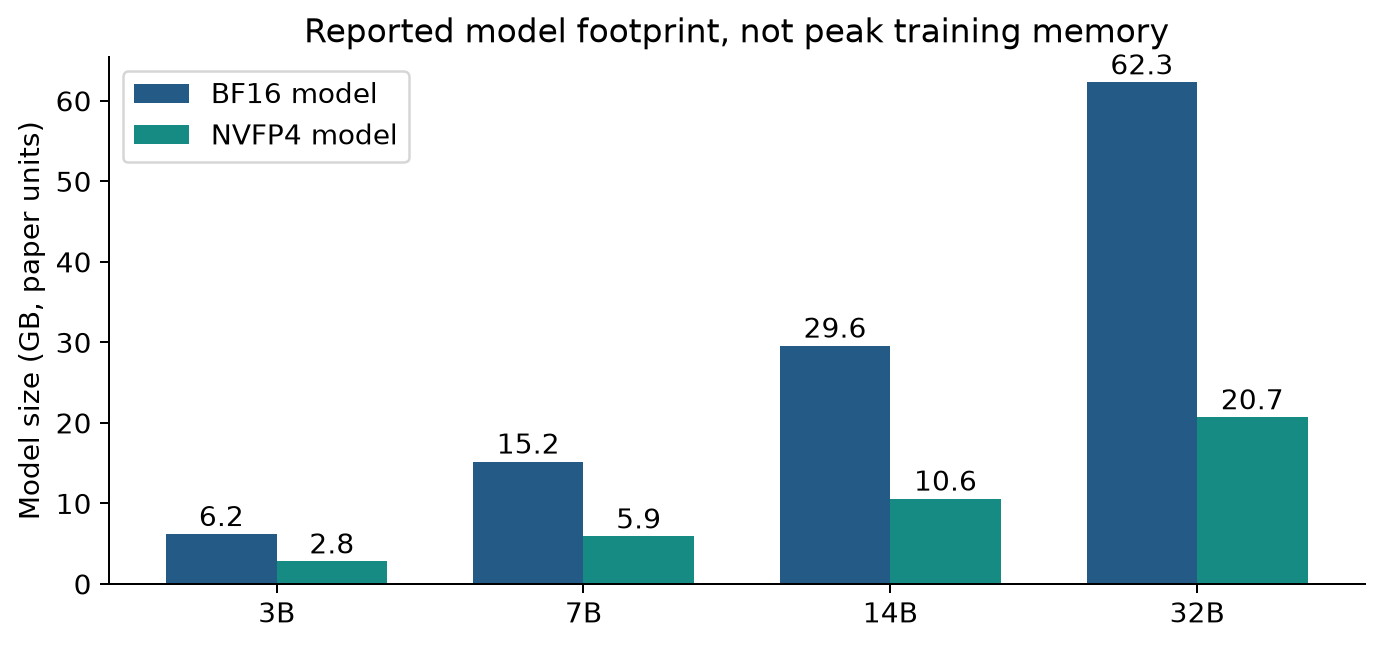
实际预算更接近
第一项必须按真实驻留副本计数,不能因为逻辑上只有一个模型,就假定物理上也只有一份。参考策略求值、共置的 rollout 引擎和训练引擎、同步缓冲区都可能占空间。压缩权重释放的预算又可能被 KV cache 用掉;如果框架预留固定比例的显存,最终看到的总保留量未必按权重比例减少。
梯度 checkpointing 则是以额外计算换取更少的保存激活。它可以让原本 OOM 的配置变得可运行,这很重要;但不能把这个事实说成它一定让本来已能运行的同配置更快。表 8 的 32B BF16 LoRA 为 OOM,QeRL 加 checkpointing 可以完成 step,正确的解读是该配置下的可运行性提升,而不是相对一个失败运行计算无限加速倍数。
8.2 每一个倍数都需要说清分母
把表 5 至表 8 中 batch 为 2 的 rollout 吞吐逐行相除,3B、7B、14B、32B 的 QeRL/BF16 LoRA 比率约为 1.04、1.31、1.46、1.76。这些是对论文数字的算术复算,不是本次机器上的性能测试。表 7 把 95.3/65.4 标为 1.3,但实际比值约 1.46。图 11 的约两倍标注则以更慢的 QLoRA 为参照,不能改写为“相对 vanilla LoRA 两倍”。
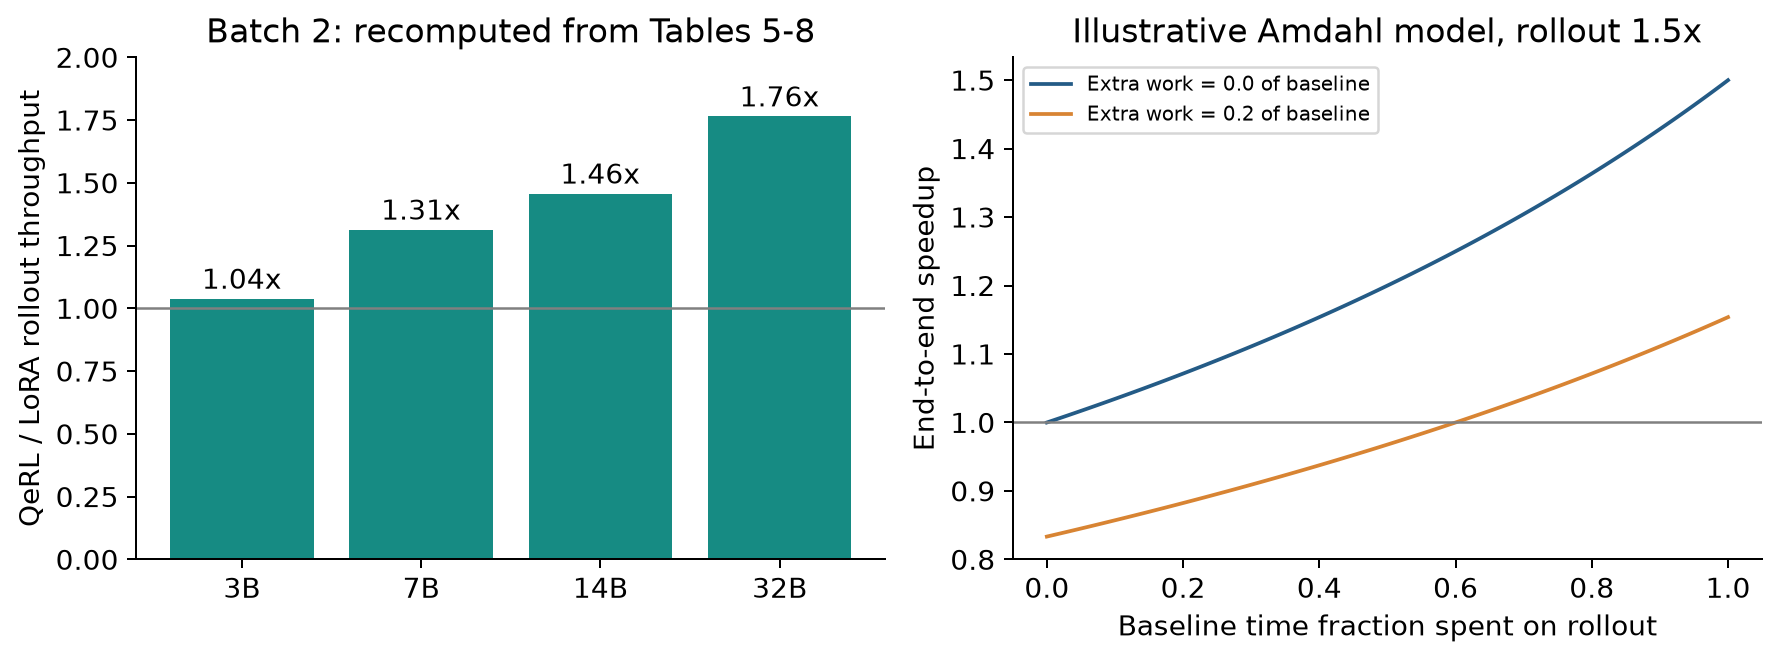
设基准一步耗时 ,其中 rollout 占比为 。若 rollout 加速 倍,新增其他开销为 ,则
用 代入,整步加速约 1.30 倍。如果增加了基准耗时 20% 的其他工作,整步只剩约 1.03 倍;若 rollout 原本只占 40%,同样的额外工作会使整步降到约 0.94 倍,即比基准更慢。由 整理得到盈亏边界
梯度累积也会改变生成与训练计算的比例。当 log-probability 计算和反向传播占比上升时,更快的 decoder 对总耗时的影响可能减弱。因此性能记录应拆出生成、概率计算、反向、优化器和同步,同时固定实际生成的 token 工作量。
如果更好的探索让回答变长,总时间增加并不必然说明 kernel 退化;反过来,如果模型更早输出结束符,吞吐或步耗时变好也未必说明计算实现更强。固定 token 工作量的系统测试,与允许回答自然变化的 time-to-quality 测试应同时存在,分别回答实现效率和学习效率的问题。
9. 噪声替换与噪声累积是两种不同的随机过程
下降的日程规定了每次抽样的尺度,却没有单独规定策略相对初始状态的总位移。下面用两个基本随机过程说明这一区别,帮助理解方法的数学条件。
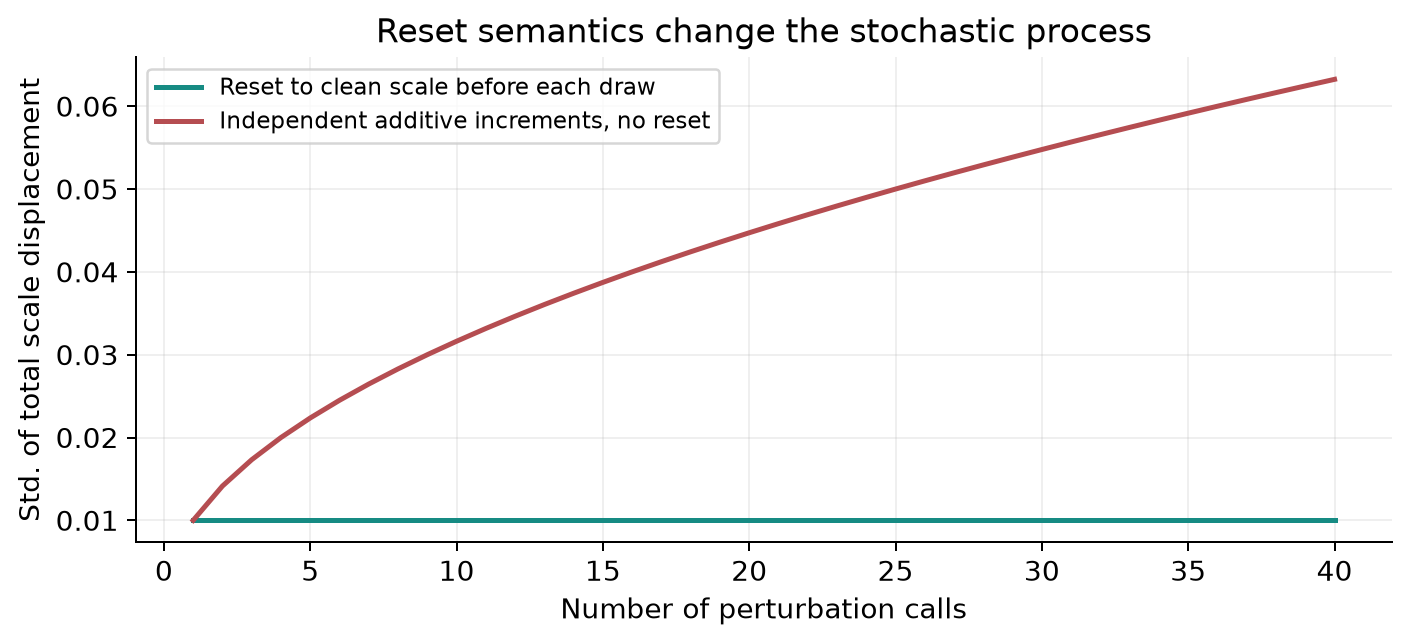
若每次恢复干净状态,位移方差为当次的 。若不恢复,且增量独立,则
后一个式子说明:即使每次增量越来越小,累计位移也不因此回到零。展示一张逐渐下降的 sigma 日程图,不能单独证明实际参数扰动正在退火。必须同时知道应用方式与恢复语义。
10. 怎样设计有区分力的复现实验
10.1 先回答机制,再回答最佳配方
一个最小但有区分力的矩阵,可以包含 BF16 LoRA、BF16 LoRA 加同类 RMSNorm 噪声、NVFP4 LoRA 不加 AQN、NVFP4 LoRA 加 AQN,再加入温度调节后的 BF16 基线,使其初始熵大致相近。这样可以分别观察压缩、结构化参数扰动与更热采样的作用。
先用共同学习率网格测试机制,再允许每种方法在相同预算下调参,比较各自可靠的最佳配方。两阶段的结果不要混成一个表格里的同一因果结论。若只有带结构的参数噪声在相近熵下有效,探索收益可能来自更一致的策略变化;若温度调整就能获得同等收益,较便宜的控制方法也值得采用。
数据顺序、奖励解析、超长回答处理、prompt 模板和评估策略应固定。训练种子需要多个,测试集可以重复抽样时也应报告相应不确定性。重复评估同一 checkpoint,不能替代独立训练种子;二者估计的是不同随机来源。
10.2 记录哪些指标才能解释成功或失败
我会把质量指标与系统指标分别保留。质量侧至少记录正确率、可解析答案率、组内奖励方差、混合奖励组比例、回答长度和明确口径的熵。系统侧记录各阶段墙钟时间、总生成 token、GPU-hours、峰值 allocated memory、reserved memory 和缓存配置。
一个典型失败可能是“熵更高,但有效答案率下降,混合奖励组并未增加”;另一个可能是“有效组增加,学习步数变少,但 logits 反量化与同步开销吃掉了整轮加速”。这两类失败需要完全不同的修复。如果只保留最终平均分和总时间,就难以判断该改噪声、奖励还是 kernel。
部署评估也应说明是否关闭 AQN。如果训练用 noisy policy,部署使用 clean policy,就应同时报告二者质量差异,而不是把训练时受益直接等同于最终无噪声模型受益。若部署时保留噪声,则还需讨论多次请求的稳定性和随机状态复现。
10.3 本次实际完成的验证
本笔记用 float64 数值计算核对了 50 组随机矩阵的 RMSNorm 等价关系,最大绝对误差约 ;熵导数与中心有限差分的最大误差约 。日程端点、表格差值和吞吐比率也完成了直接复算。九张静态图均为原创解释图或注明数据来源的重绘图。
这些检查支持本文使用的代数、算术和图示,不代表训练结果已经复现。本次分析依据完整 arXiv v1、NVIDIA 格式说明与会议记录。
11. 论文已经展示的边界
实验主要覆盖 Qwen2.5-Instruct 的 3B 到 32B 数学强化学习。代码生成、工具调用、多模态任务、广义语言质量、更大模型及 MoE 并未由这些表格建立同等证据。方法可能可以迁移,但奖励稀疏程度、无效回答类型和模型对扰动的敏感性都可能改变。
表格没有提供足够广泛的多训练种子不确定性分析,使每个微小差异都能被判为稳定收益。论文提到多次评估,但不能把它当作多次独立训练。尤其在较小基准上,少数题目的变化便可能改变百分比;需要逐题结果、评估抽样设定和置信区间。
单 H100 的可运行性与最终分数也应分开。主文第 4.1 节说明,最终评估模型为提高实验效率使用八张 H100 训练;单 GPU 速度测试则使用特定较短输入、输出和 batch 设置。因此论文并没有证明全部 headline accuracy 都来自展示的单卡配方。一个回答“能不能跑”,另一个回答“采用这种方法能达到什么质量”,两者相关但不相同。
模型大小不能代替峰值内存,早期若干步的平均时间也不能代替整个训练过程中长度持续变化的时间分布。主表和附录的效率呈现存在重叠与差异,应通过机器可读配置、原始 timing 和实际 token 数对齐,不能挑出最大的 multiplier 作为所有环境的预期。
12. 独立批判性分析
12.1 从相关曲线到因果链,中间还缺一次干预
论文最需要补强的解释,是“量化提高熵,熵改善探索,探索加速学习”这条链。量化同时改变初始精度、校准误差、激活几何、适配器需要补偿的方向和稳定学习率范围。这些因素都能影响奖励曲线。观察到更高熵与更快学习同时出现,不能单独判断熵是不是关键中介变量。
我倾向于先固定主干,再一次只改变一个随机来源,比较固定量化残差、变化的通道尺度噪声、输出温度。除熵外,重点测组内奖励是否更有区分度。如果所有方法都增熵,但只有某一类改善有效组比例,就说明真正有用的是探索结构或覆盖方向,而不是“随机性更多”本身。
12.2 应把结构化扰动作为方法本体来研究
RMSNorm 共享向量的自由度远少于独立权重噪声,并且耦合多个投影。它之所以有效,可能恰恰来自这种限制。将它藏在一般加性噪声解释后,会弱化论文最有意思的设计选择。
一个具体改进实验是显式计算或估计每层输出扰动的协方差,在相同输出变化预算下比较共享与独立噪声。另一个是按尺度大小或 logit 敏感性分配噪声,限制少数高敏通道的影响。这些是待验证方案,不是本文已经证明的改进。额外超参数也有调参成本,因此要与简单全局日程做相同预算比较。
12.3 系统目标应是单位预算获得的有效学习
我希望最后看到的是质量、时间、峰值内存之间的 Pareto 前沿。一些配置中,QeRL 让原本装不下的实验可以运行;另一些配置中,BF16 LoRA 可能因 logits 或反向占主导而更快。前一种收益并不会因为后一种边界而消失。好的结论应说清收益发生在什么模型、长度和负载范围。
更进一步,AQN 可以尝试根据“有效混合奖励组比例”调节,而不只根据步数衰减,同时用熵、无效输出率和比例偏移作约束。这样才是对学习状态作反馈的自适应控制。但在引入控制器前,应该先把这些信号可靠地记录下来,再与固定日程比较稳定性和额外开销。
13. 结论
我的整体理解是:QeRL 给出了一条有实际价值的组合路径,用压缩冻结主干降低资源门槛,用低秩更新承担策略适配,用结构化扰动尝试改善探索。在所测数学 RL 设置中,它展示了值得复现的质量与资源折中,尤其适合权重驻留和自回归 rollout 是主要瓶颈的场景。
但现有证据不支持“量化总会提高熵”“AQN 对每个任务都更好”或“所有训练相对 BF16 都快两倍”。本文的推导与表格复算,说明这些更强说法分别缺少什么条件。若要在真实训练中采用,我会先核实噪声与概率语义,再按完整显存预算比较达到 held-out 目标质量的总成本。这样才能知道收益来自表示、探索,还是某个更合适的训练配方。
参考来源
- Huang 等,QeRL,arXiv v1:方法、表 1 至表 9、附录 E 至 K。论文为 CC BY 4.0;本笔记全部图为原创解释或标明来源的数据重绘。
- NVIDIA,Introducing NVFP4 for Efficient and Accurate Low-Precision Inference,2025-06-24:格式与尺度开销。
- ICLR 2026 会议记录:作为参考记录;数值仍以本文注明的 arXiv v1 为准。