笔记日期: 2026-09-12
作者: Zhongzhu Zhou
阅读论文: Data Scarcity and Model Sparsity: Mixtures-of-Experts Overfit More to Repeated Data
论文作者: Atindra Jha, Margaret Li, Jure Leskovec, Percy Liang, Luke Zettlemoyer
arXiv: 2609.11917v1
状态: 2026 年 9 月预印本
1. 这篇论文在问什么
高质量文本逐渐稀缺后,训练语料被重复使用已经不是例外,而是常态。这里必须区分两个预算:总训练 token 数决定计算量,独特 token 数决定模型真正接触到多少独立信息。
MoE 又引入了第二组分离:每个 token 只激活少数专家,所以活跃参数量近似决定单 token 计算,而总参数量决定可存储容量。论文把两组分离放在一起研究:总 token 与独特 token、活跃参数与总参数。
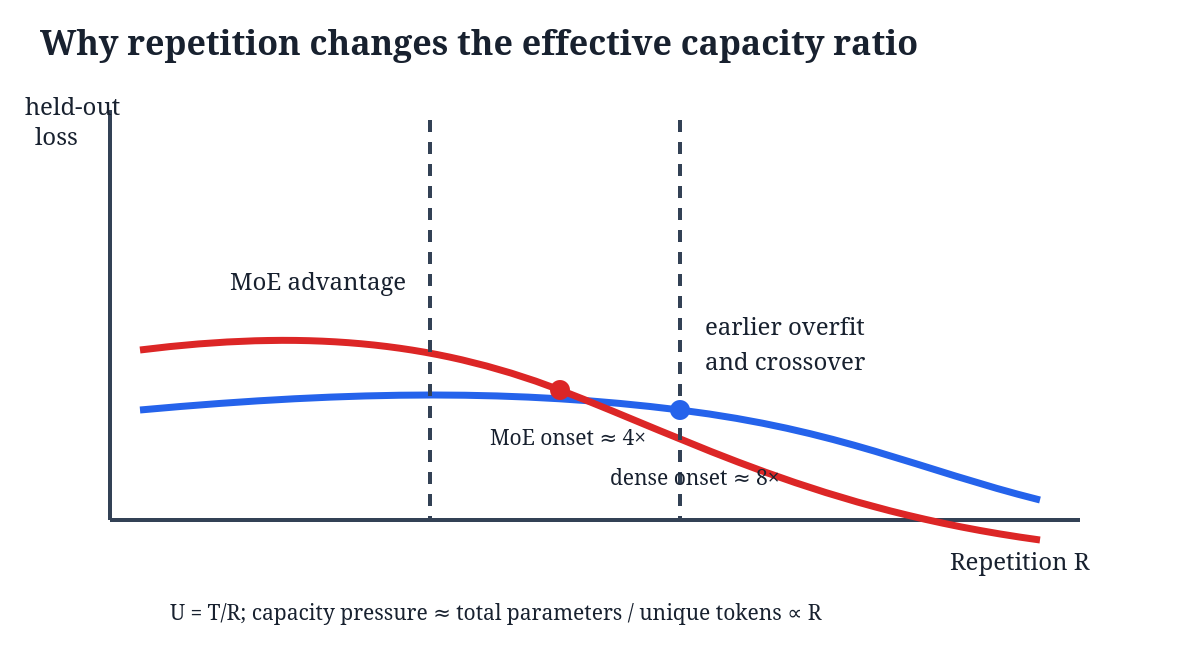
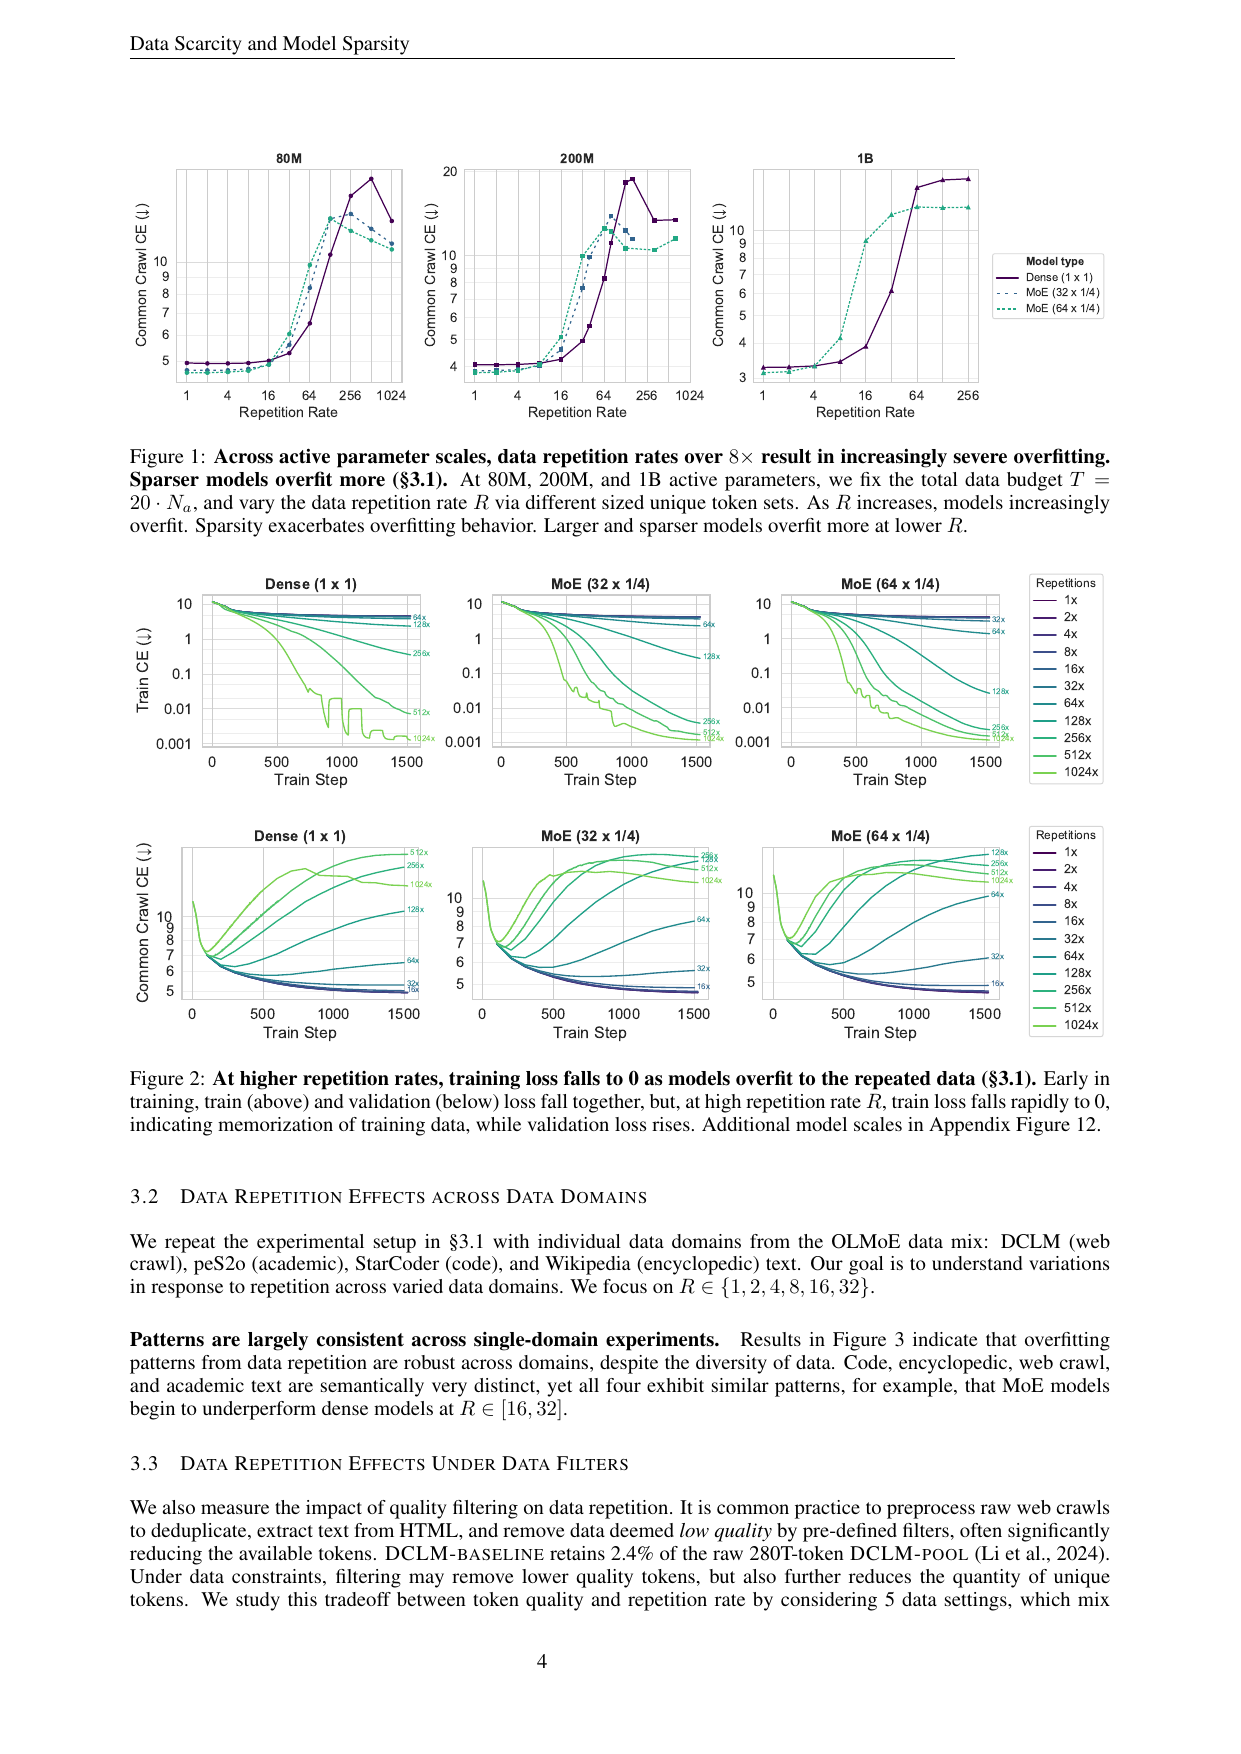
核心发现非常清楚:数据全部独特时,同活跃计算量的 MoE 优于稠密模型;重复率升高后,MoE 更早过拟合,并可能反而显著弱于稠密模型。80M 活跃参数实验中,MoE 在约 4 次重复时已出现退化,稠密模型约在 8 次才明显受损;到 32 次左右,排名可能反转。强 dropout 或输出遮蔽能够推迟崩溃,却无法凭空补回缺失的信息多样性。
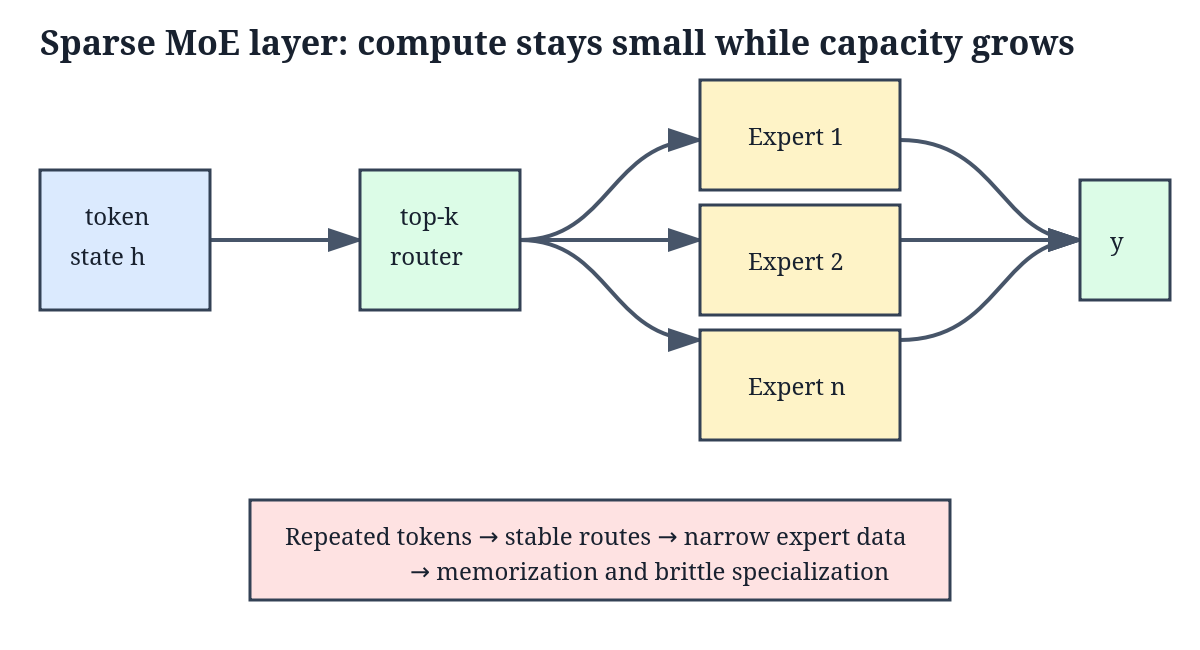
这条链条是我对论文证据的概括。需要提前说明:论文对“重复率与稀疏度的交互”给出了扎实证据,但对“路由固化导致过拟合”主要提供相关性和局部干预证据,还不是完整因果证明。
2. 前置知识
2.1 稠密 Transformer 的 FFN
Transformer 每层通常包含注意力与逐 token 前馈网络。以 SwiGLU 为例,可简写为
每个 token 都使用整套 FFN 权重,因此稠密模型的总参数与单 token 活跃参数基本一致。增大参数通常同时增加容量和计算。
下一个 token 的交叉熵为
在 个验证 token 上取平均,
这个式子来自最大似然:最大化概率连乘,取负对数后就成为可加的损失。若训练损失继续下降而验证损失上升,模型更擅长记住训练流,却更不擅长预测未见文本,这就是本文识别过拟合的主要信号。
2.2 稀疏 MoE
MoE 用 个专家 替代一个稠密 FFN。路由器先计算
选择集合 后,门控权重为
MoE 输出为
虽然设备上存有全部 个专家,但每个 token 只运行 个。若每个专家宽度是稠密 FFN 的 倍,并设置 ,活跃专家容量近似与稠密 FFN 相同;总专家容量则随 增长。
可定义稀疏倍率
这解释了为什么“80M 活跃参数”MoE 可以有数亿总参数,而单 token 不需要支付全部计算。
2.3 重复率
设总训练 token 为 ,独特 token 为 ,重复率是
论文固定计算预算,也就是固定 。因此
重复率翻倍,独立信息约减半。MoE 的总容量与独特信息之比是
所以增大 会线性提高“每个独特 token 面对的总参数容量”。这不是过拟合定理,但给出了为什么总参数量可能比活跃参数量更能预测退化的直觉。
3. 实验设计如何排除混杂因素
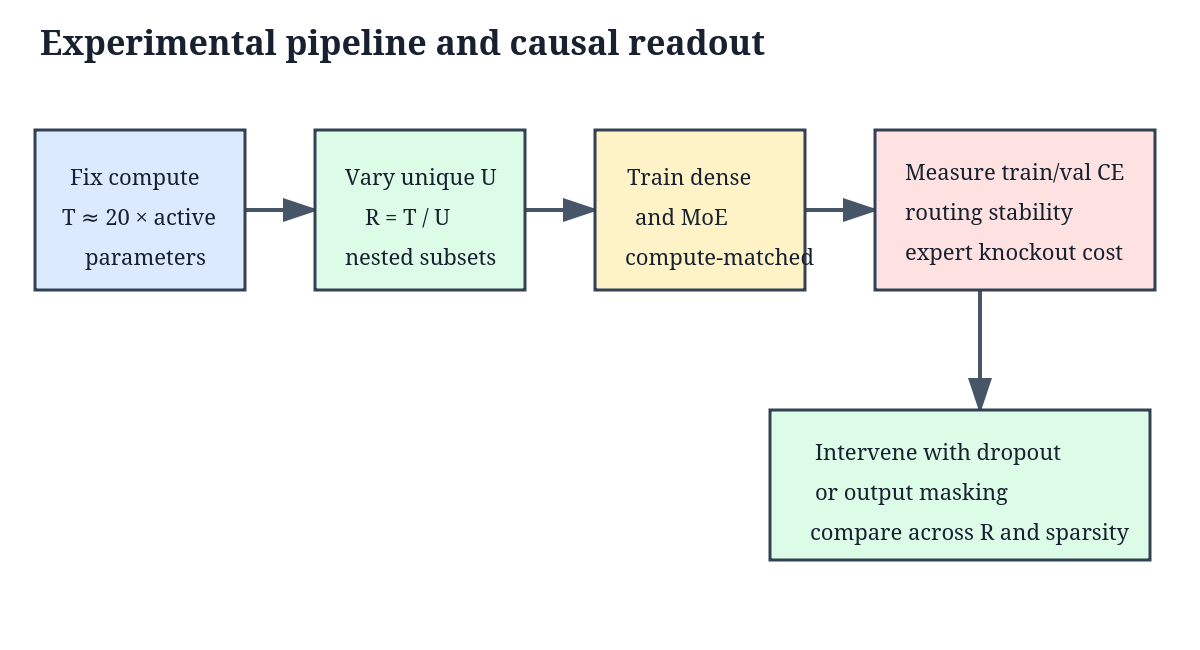
论文训练 80M、200M、1B 三档活跃参数规模的稠密与 MoE 解码器模型,最大 MoE 达到 8.5B 总参数。默认训练预算遵循
其中 是活跃参数量。核心实验把 从 1 扫到 1024,在固定 下令 。
专家数取 ,专家粒度取 ,并设置 。这样既能单独考察增加专家数,也能考察放大单个专家。
数据包括 OLMoE 混合语料,以及 DCLM 网页、StarCoder 代码、peS2o 科学文本和 Wikipedia 百科四个单领域。验证覆盖对应领域、多个语言模型语料和 BoolQ、HellaSwag、MMLU。
3.1 算法 1:构造嵌套重复数据
若每个 都独立抽样,样本质量差异可能被误认作重复率效应。论文用一个固定随机排列构造嵌套子集。
算法 1:嵌套独特 token 扫描
输入:语料 D,活跃参数 Na,重复率集合 R_set
1. 设总 token 预算 T <- 20 * Na。
2. 对 D 生成一次固定随机排列 pi(D)。
3. 对每个 R:
4.     计算独特预算 U <- floor(T / R)。
5.     取排列前 U 个 token 得到 D_U。
6.     将 D_U 重复 R 轮,每轮重新打乱序列次序。
7.     保证每次实验恰好处理 T 个 token。
8.     使用相同训练日程训练候选架构。
9.     记录训练 CE、验证 CE 与下游指标。
10. 返回按模型、规模、R 索引的结果。
为什么有效。 当 时,保证 。高重复实验确实只是信息更少,不是换了一份无关样本。
明显替代方案。 每个 重新随机抽样,实现简单,却把语料难度与重复率混在一起。
边界。 嵌套只保证单个排列内部可比。论文对部分配置重复了五个初始化种子,但没有对多个独立数据排列做同等规模复验。
3.2 “同计算量”并不等于“同系统成本”
同活跃参数近似控制每 token 神经网络 FLOPs,但增加专家会提高显存、优化器状态、检查点 I/O、路由开销和 all-to-all 通信。因此论文证明的是“相近活跃计算下的统计行为不同”,不是“所有资源成本相同”。
一旦 附近 MoE 验证损失反而更差,它通常还承担更高内存和通信代价。此时 MoE 的质量优势与系统优势可能同时消失。
4. 主要结果:稀疏性放大重复数据损伤
低重复率时,MoE 验证损失低于稠密基线;随着 上升,MoE 曲线更早向上弯折。约到 ,稠密模型可能反超。
定义泛化间隙
比较 :
严重重复时,第一项为正,第二项为负,所以 强烈增大。也就是说,优化没有失败:模型反而把重复训练流拟合得更好;失败发生在泛化。
极端重复区间还出现非单调现象:验证损失先恶化,随后短暂改善,在更大 又恶化。这提醒我们不能只用窄区间拟合简单单调规律。可能存在从“部分记忆”到“几乎完全拟合”的相变,但论文没有给出确定机制。
4.1 关键轴是总参数
两组架构扫描互相印证:
- 固定粒度、增加专家数,总参数变大,重复敏感性增强;
- 固定专家数、扩大专家,总参数变大,敏感性同样增强;
- 总参数相近的曲线更相似,即使其专家分解方式不同。
可用下面的量理解:
增大重复率或总参数都会降低每个参数可获得的独特信息。注意, 是解释性指标,论文没有拟合出跨架构通用阈值。
4.2 领域与过滤
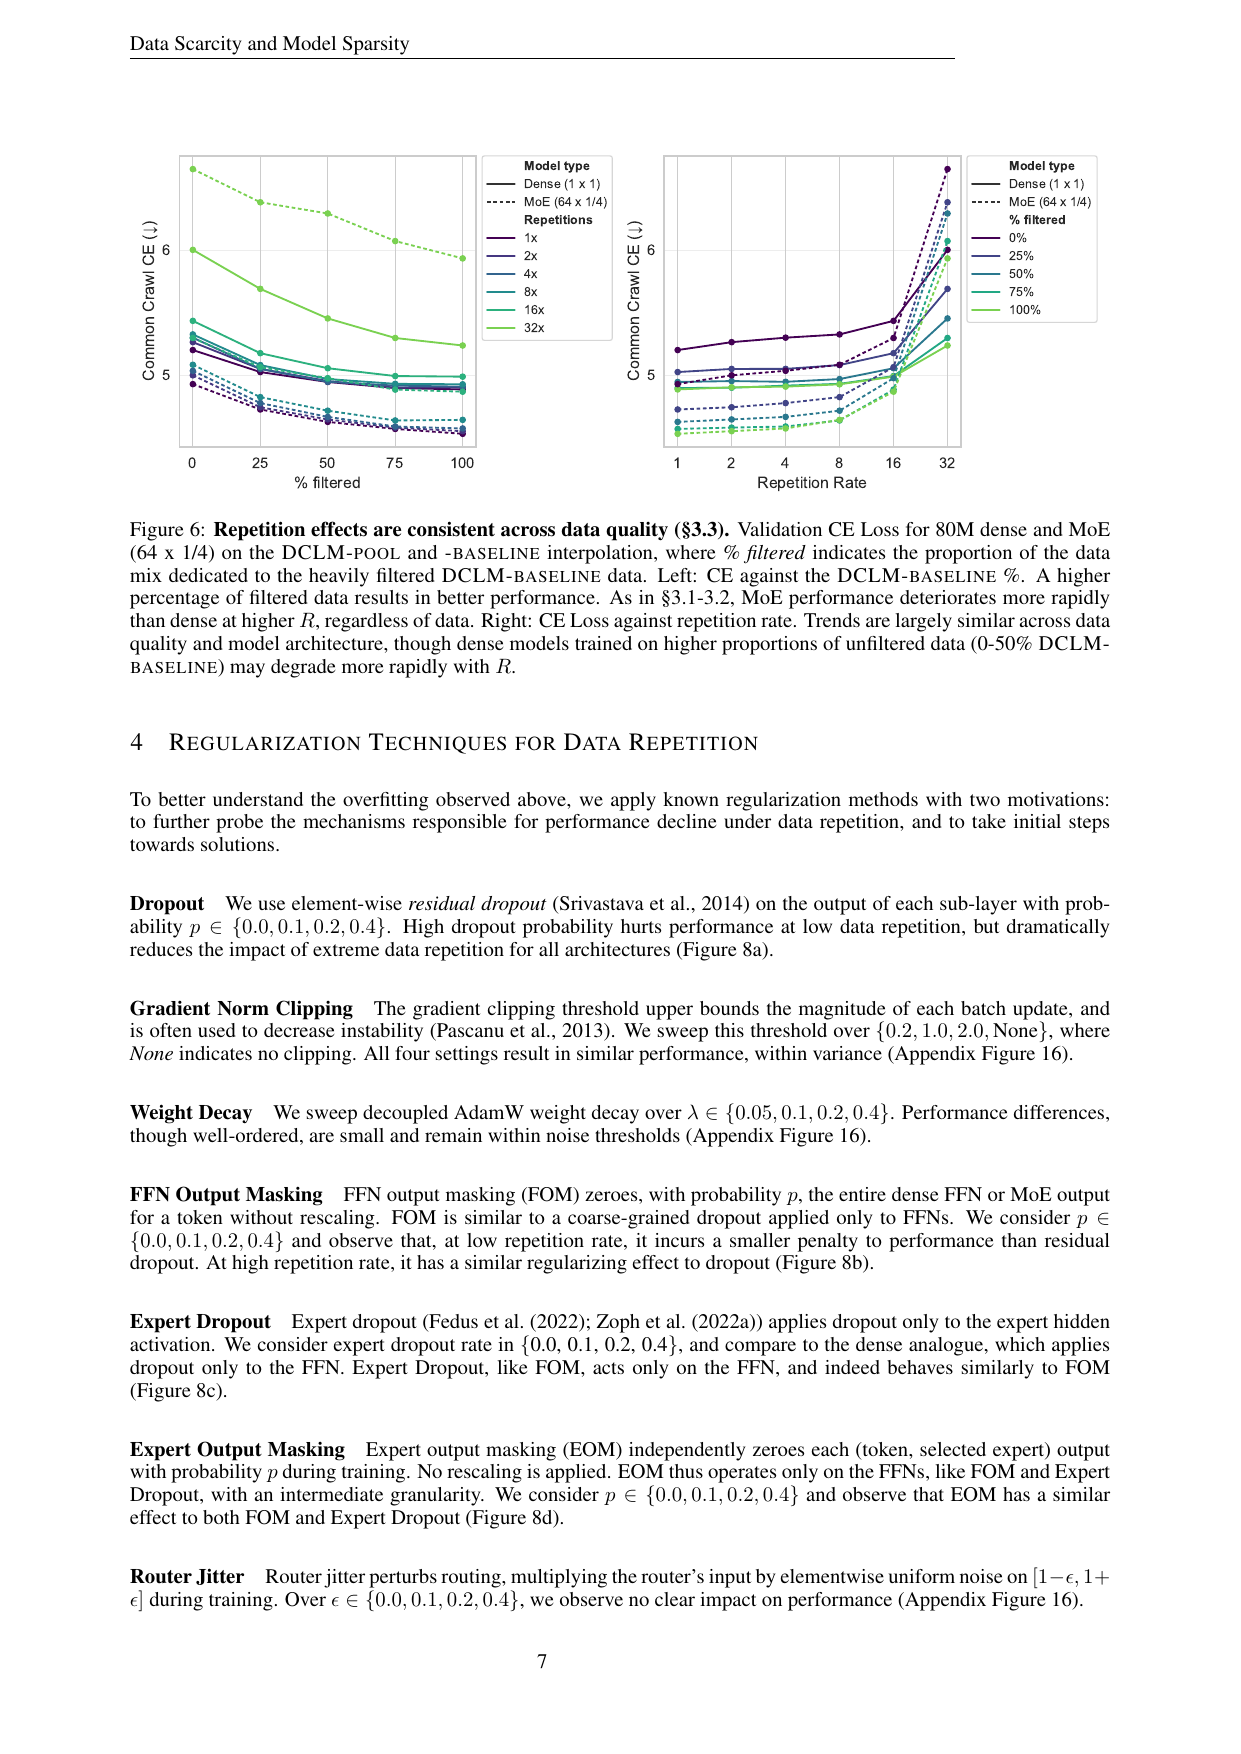
网页、代码、科学文本、百科四个领域都出现相似趋势,MoE 通常在 到 之间开始失去优势。这说明结果不只是网页模板或某个语料清洗流程的偶然产物。
严格质量过滤降低绝对损失,却没有消除 MoE 的重复敏感性。DCLM-BASELINE 只保留原始池约 2.4%。在论文的一组对照中,对大规模未过滤语料训练一轮优于把高度过滤子集重复 32 轮。正确结论不是“不要过滤”,而是必须联合优化质量与独特数量。
4.3 混合领域
当重复 StarCoder 或 peS2o 与不重复 DCLM 混合时,损伤主要集中在重复领域。不重复网页文本对重复科学文本有一定正则作用,对代码则较弱。论文猜测语义相近的独特领域更能共享表示,但没有把“语义相似度”本身作为受控变量。
为什么这种设计好。 每领域 更接近真实预训练配比。
替代方案。 全部领域使用同一 ,更整洁,却看不出哪个领域造成退化。
边界。 只测试少量二元混合,差异也可能来自 tokenizer、文档长度、熵或梯度方向。
5. 正则化:哪些干预真正有效
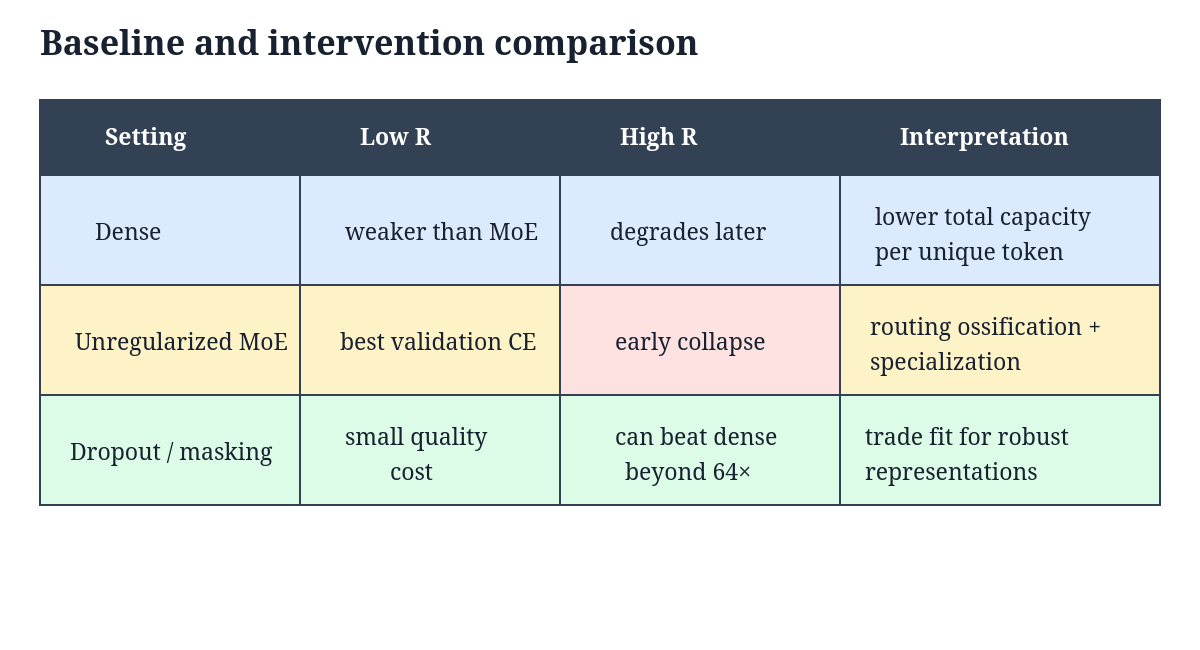
论文扫描残差 dropout、梯度裁剪、权重衰减、路由抖动、专家 dropout、FFN 输出遮蔽与专家输出遮蔽。最稳定的结果是:随机删除激活或整个输出分支,在高 下有效;梯度裁剪、测试范围内的权重衰减和路由抖动作用有限。
倒置 dropout 令 :
其期望保持不变:
但是每一步看到的是随机子网络。同一个重复样本无法在每轮都依赖完全相同的共适应特征路径。
FFN 输出遮蔽更粗粒度:
论文实现不做重缩放,所以期望分支幅度变成 。它迫使残差流在 FFN 整体消失时仍保持可用。
5.1 算法 2:按重复区间选择正则化
算法 2:面向独特数据约束的正则选择
输入:概率集合 P,重复率集合 R_set,稠密基线
1. 对每个正则化家族 q:
2.     对每个概率 p:
3.         分别在低重复与高重复训练匹配模型。
4.         记录验证损失 L(q,p,R)。
5.         计算低 R 代价 C_low。
6.         计算高 R 收益 G_high。
7.         丢弃只改善训练损失的配置。
8.         保留低代价、高收益的 Pareto 配置。
9. 与同活跃规模的稠密模型比较。
10. 根据生产环境预计 R 选 p,而不是固定一个全局默认值。
为什么有效。 它明确显示强 dropout 的交换:独特数据充足时略损质量,数据重复严重时显著恢复泛化。
替代方案。 只在 调参再复用,通常会为重复语料选择过弱的正则。
边界。 最佳 随规模和训练日程变化,80M/200M 结果不能原样搬到超大模型。
5.2 为什么梯度裁剪不够
梯度裁剪为
重复记忆不一定依赖异常大梯度;大量方向一致的小更新都低于阈值,也能持续刻画同一批样本。
AdamW 的解耦权重衰减近似为
它抑制大权重,却不直接增加特征或路由多样性。论文扫描的 可能不够强,因此只能说“此范围内效果小”,不能说权重衰减原则上无效。
6. 机制探针:路由固化与专家专门化
6.1 路由稳定度
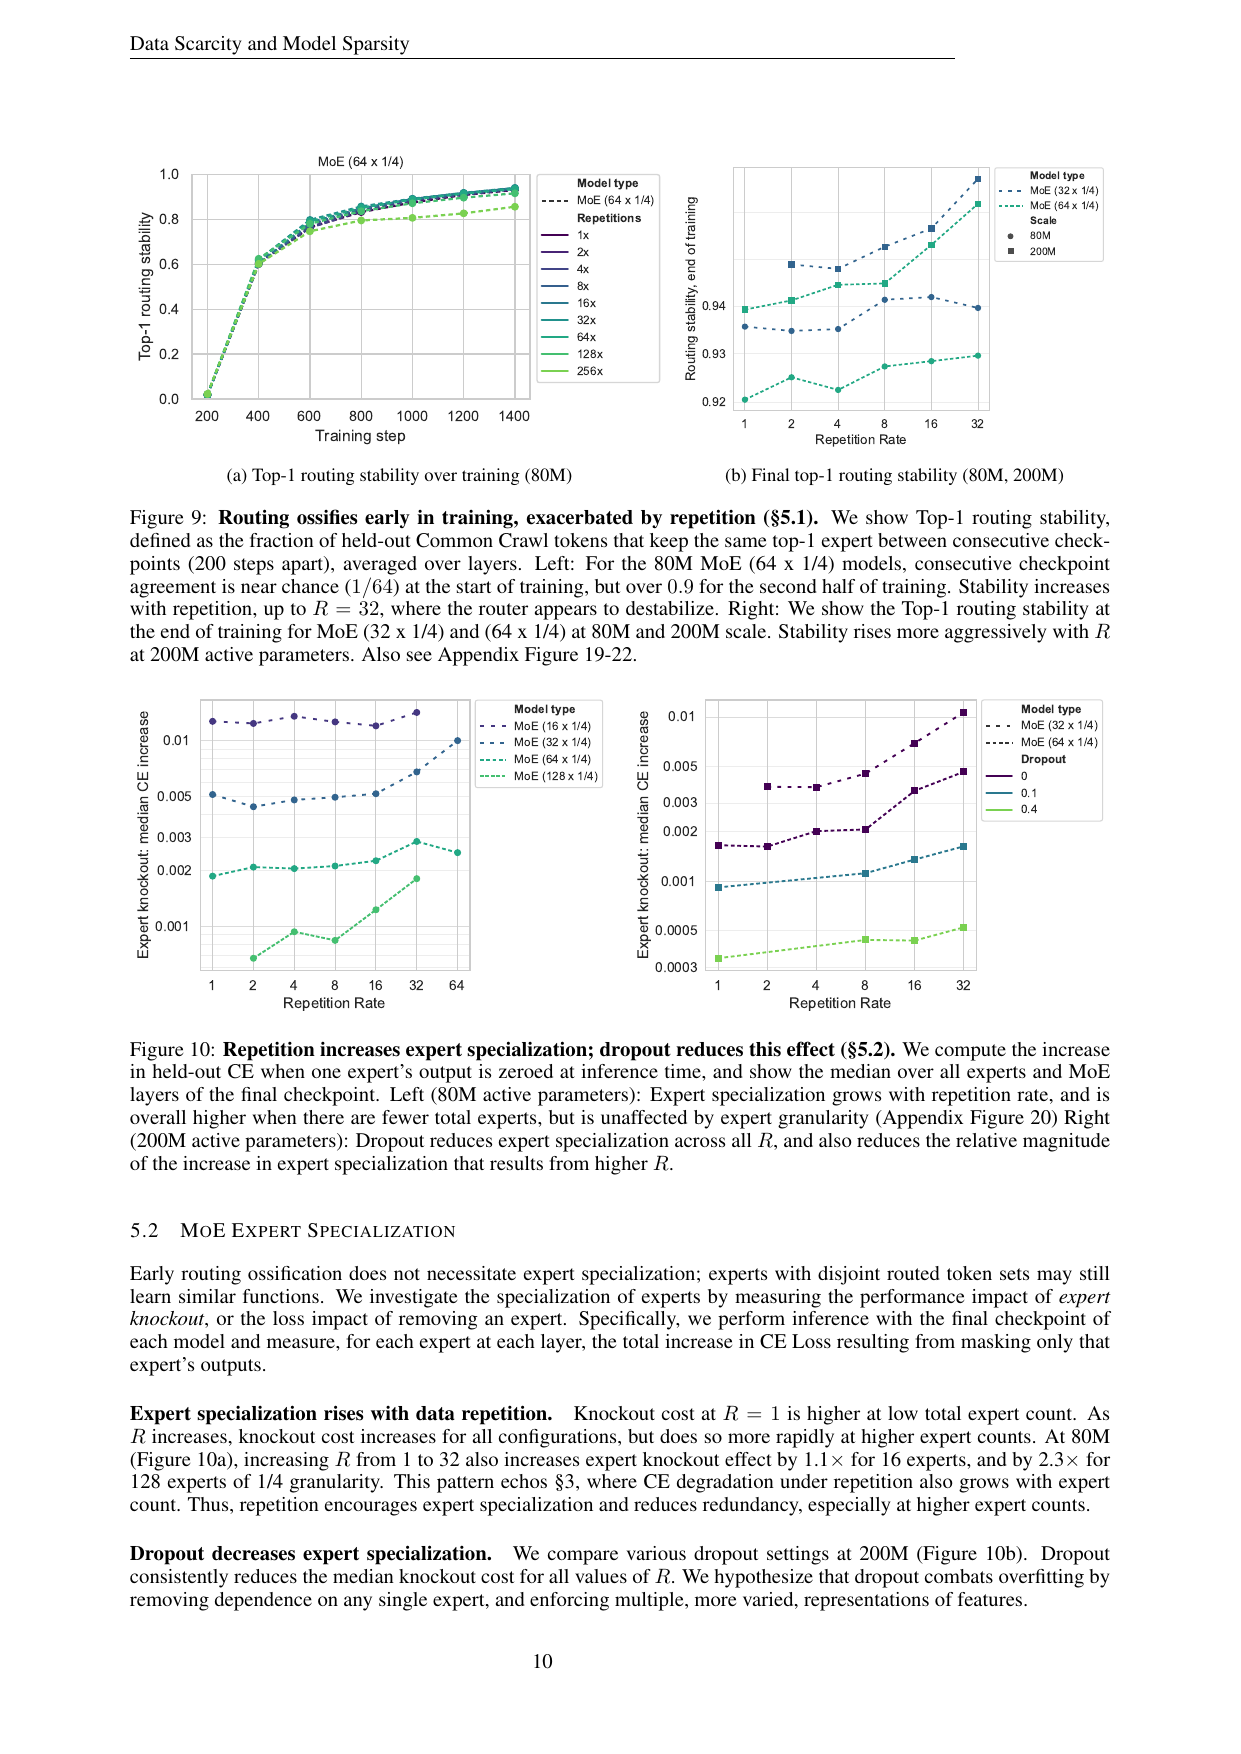
固定验证批次,记 为检查点 时 token 在第 层的 top-1 专家。相邻检查点稳定度是
它就是 token-层二元组在两个检查点间保持首选专家不变的经验概率。路由在训练前约 10% 阶段就快速稳定,重复率会进一步小幅提高最终稳定度。
6.2 算法 3:测量路由固化
算法 3:相邻检查点 top-1 路由稳定度
输入:检查点 theta[0..M],固定验证批 X,MoE 层 1..L
1. 关闭所有训练期随机正则。
2. 对每个检查点 t:
3.     用模型处理固定批 X。
4.     保存 top1[t,x,l] <- argmax_i router_score_i(x,l)。
5. 对 t 从 1 到 M:
6.     matches <- 0。
7.     遍历每个 token x 与层 l:
8.         若 top1[t,x,l] 等于 top1[t-1,x,l],matches 加一。
9.     stability[t] <- matches / (|X| * L)。
10. 返回稳定度曲线与最后若干区间均值。
为什么有效。 输入固定,路由变化主要来自参数变化,而不是样本变化。
替代方案。 用门控分布 KL 散度,可观察软分数,却可能在执行 top- 不变时仍报告变化。
边界。 top-1 忽略其余活跃专家及权重;检查点间距也会改变数值,只能比较相同间距的实验。
6.3 专家敲除
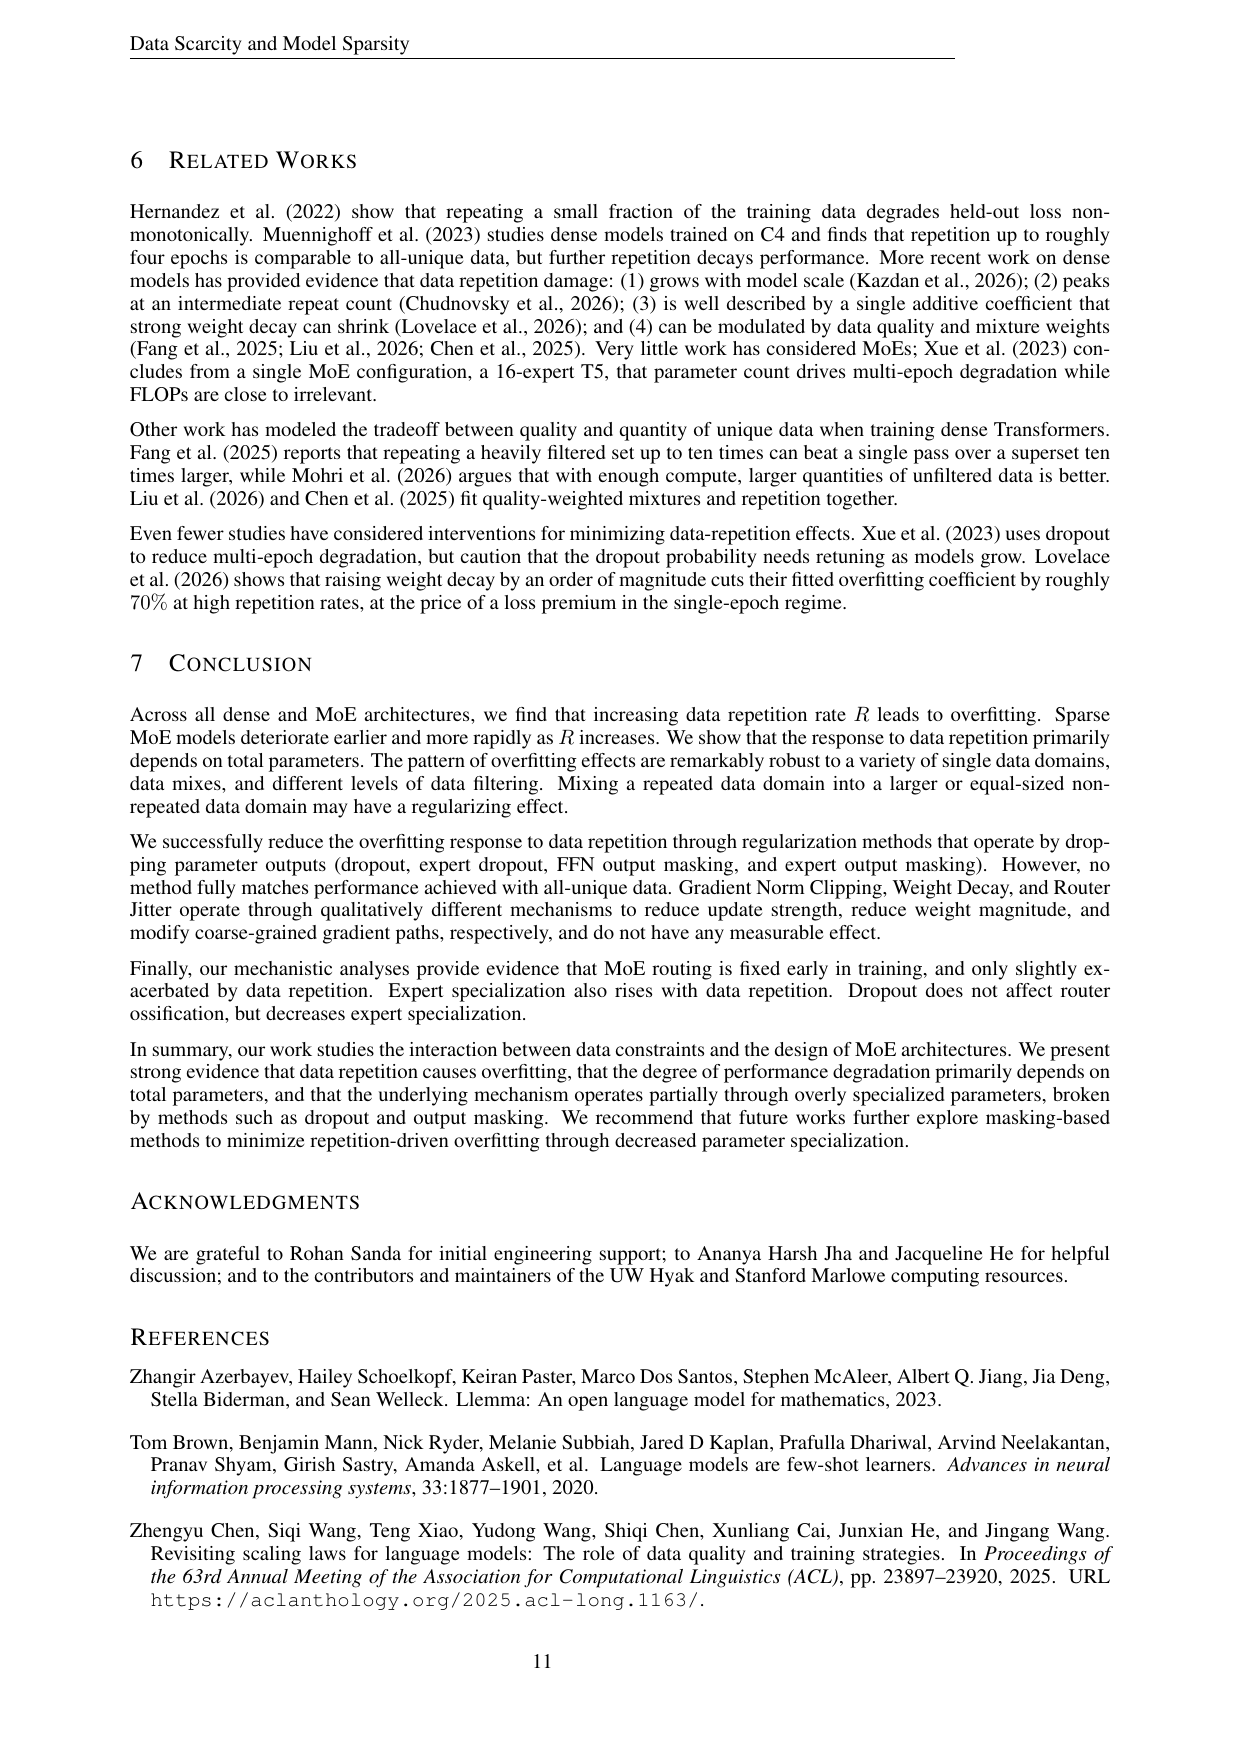
最终检查点中,把某层某专家输出置零,其他路由与门控不变。若基线损失为 ,敲除后为 ,定义
越大,剩余网络越难补偿该专家。随着重复率增加,中位敲除代价上升。80M 规模从 到 时,16 专家配置约增大 ,128 专家配置约增大 ;dropout 会降低该代价。
6.4 算法 4:专家敲除审计
算法 4:用输出敲除测量专家专门化
输入:最终模型 theta,固定批 X,所有专家位置 (l,e)
1. 在 X 上计算基线验证 CE:L。
2. 对每个 MoE 层 l:
3.     对每个专家 e:
4.         保持路由分数和选择集合不变。
5.         将该专家输出替换为零。
6.         不重新归一化其余门控权重。
7.         计算 L_minus[l,e]。
8.         K[l,e] <- L_minus[l,e] - L。
9. 汇总所有层和专家的中位数与最大值。
10. 比较不同 R、专家数和 dropout。
为什么有效。 这是对模型函数的干预,不只是观察路由统计与损失相关。
替代方案。 比较专家权重或输出余弦相似度,便宜但不等同于功能冗余。
边界。 不重归一化会同时改变函数与输出幅度。更严格的实验应加入门控重归一化和路由到下一候选专家两个版本。
6.5 专家共激活熵
统计每层中无序专家对 同时进入 top- 的次数,并归一化成 。Shannon 熵为
个专家共有 个无序对,可用最大熵归一化。值越高,专家组合越多样;值越低,少数固定组合越常见。dropout 提高共激活熵,同时降低敲除代价,符合“随机删除迫使多组专家形成可替代表示”的解释。
6.6 证据链与因果缺口
可以把论文证据排成六步:
- 高 减少独特 token,但更新次数与计算不变;
- 路由很早稳定,熟悉 token 反复流向相似专家;
- 单专家看到的有效数据集比全局语料更窄;
- 专家敲除代价上升,功能冗余降低;
- 总容量更大的配置更早出现验证退化;
- dropout 与输出遮蔽降低专门化并改善高 损失。
第 2—4 步有测量,第 6 步有干预,但尚未完全识别因果。共享注意力层的特征学习可能同时驱动稳定路由与专门化。更强的实验应在训练中途重置、冻结或随机扰动路由器,同时保持其他状态不变。
7. 数字结果如何解读
五种子附录给出 80M 活跃参数的平均语言模型验证损失:
- 稠密,:;
- 稠密,:;
- MoE (64 × 1/4),:;
- MoE (64 × 1/4),:。
低重复时 MoE 优势为
到 ,MoE 劣势变成
相对位置总摆幅达到
个交叉熵点,远高于种子标准差。与此同时,稠密训练损失从 4.57 降到 4.27,MoE 从 4.26 大幅降到 3.17。MoE 正是在更好拟合训练流时,产生更差泛化。
C4 上,稠密从 4.86 变 5.27,MoE 从 4.53 变 6.04;Dolma Stack 上,稠密从 4.65 变 6.68,MoE 从 4.23 变 7.46。因此不是单一语料拉坏平均值。
这些小模型在若干下游准确率上接近随机水平,离散准确率不够敏感;下游损失更敏感,却方差更大。这也是方法学提醒:能力准确率处于地板区时,平滑验证损失往往更能揭示退化。
8. 从论文结果到训练决策
实际项目应估计有效重复率
其中 需要折扣近重复、模板文本和信息狭窄的合成变体。
推荐流程:
- 选稀疏度前先去重并聚类;
- 同时报告原始 token 与独特 token;
- 按领域计算 ;
- 用小代理模型扫描同样的 ;
- 联合监控训练/验证 CE、路由稳定度、敲除代价;
- 在低 与高 两端调 dropout;
- 若生产区间超过 MoE 交叉点,考虑稠密或更低稀疏度模型。
定义 MoE 对稠密的质量优势
则交叉点为
论文中的 常在 32 左右,但随规模、架构、领域和正则改变,不能直接当生产常数。
9. 复现笔记
论文披露了较完整的训练细节:50K 词表、序列长度 2048、batch size 512、峰值学习率 、2000 步 warmup、余弦衰减、SwiGLU、dropless token-choice 路由、 路由 z-loss 与 负载均衡损失。
9.1 最小复现实验
我会先用 80M 活跃参数,只做三种架构:稠密、MoE (32 × 1/4)、MoE (64 × 1/4)。重复率取 ;然后只对 64 专家配置增加 dropout 。
每个检查点记录:
- 当前训练流 CE;
- 固定验证集 CE;
- 固定间距下的 top-1 路由稳定度;
- 每专家 token 数、路由熵与负载均衡损失;
- 检查点 ID、数据排列哈希、独特文档数。
最终对固定批做专家敲除。复现成功标准应是曲线形态:MoE 更早向上、约在论文区间交叉、强 dropout 降低高 损失,而不是强求完全相同的小数。
9.2 容易忽略的复现风险
“独特 token”不等于独特语义。模板网页、近重复文档和合成改写都会让有效多样性下降。tokenizer、文档切分、packing 与语料版本必须冻结。
分布式 MoE 内核也可能引入专家容量上限和 token 丢弃。论文使用 dropless 路由;若复现系统会丢 token,重复样本造成的路由热点可能与真正过拟合混在一起。
10. 局限与适用边界
规模边界
最大模型为 1B 活跃、8.5B 总参数,足以做控制实验,却仍小于前沿 MoE。超大规模的路由、优化器和数据混合可能改变规律。
训练日程边界
论文固定总 token 与活跃参数成比例。真实团队可能使用按 epoch 调整的学习率、早停、课程式重放或阶段正则,本文并未覆盖所有重复训练策略。
数据边界
数据以英文文本为主。多语言、多模态、带仓库依赖的代码和合成推理轨迹可能以不同方式重复。精确重复也只是低多样性的一种形式。
架构边界
结论针对 token-choice、dropless、top- MoE。expert-choice、共享专家、sigmoid 门控、无路由哈希、稠密模型 upcycling 都可能改变单专家有效数据。
机制边界
早期路由稳定与敲除代价上升只是与退化同现,尚未证明路由固化是损失上升的必要或充分原因。
11. 批判性分析
11.1 论文自身的弱点
第一,经验主结论强,机制主张弱。top-1 稳定度忽略其余活跃专家与门控权重;敲除代价也不能单独证明路由固化导致泛化损失。
第二,“同计算量”缺少系统成本报告。MoE 的优化器显存、all-to-all 字节、吞吐、能耗和检查点成本没有与稠密基线并列,这削弱了部署含义。
第三,主要使用一个固定语料排列。多初始化种子只能验证优化稳定性,不能验证高 下恰好保留哪些文档的敏感性。
第四,混合领域部分用“语义相似”解释 peS2o 与 StarCoder 差异,却没有直接控制或量化语义相似度。
11.2 作者低估或遗漏的限制
论文没有真正区分精确重复与有效重复。词面不同的合成样本可能信息高度相同,仅用 会低估风险。
正则化扫描并不对等。dropout 扫到 0.4,而权重衰减只在相对温和范围内变化;因此只能比较本次搜索空间,不能宣布遮蔽方法全局最优。
专家敲除后不重归一化门控,会把功能独特性与幅度缺失混在一起。高权重但可替代的专家也可能显得“专门化”。
此外,论文研究从头预训练。先在独特数据上训练、再进入重复领域适配的 MoE,可能拥有更成熟路由,失效模式并不相同。
11.3 可执行的改进建议
- 路由器因果干预: 在匹配检查点重置、置换、冻结或调温路由器,观察验证损失是否恢复。
- 完整 top- 指标: 增加选择集合 Jaccard、门控向量 Jensen–Shannon 散度、token 与专家互信息。
- 数据抽样复验: 高 实验使用多个独立文档排列,而不只是多个初始化种子。
- 功能敲除对照: 同时比较直接置零、门控重归一化、路由到下一候选专家。
- 系统账本: 报告 tokens/s、all-to-all 字节、峰值显存、能耗和检查点大小。
- 有效多样性: 用文档聚类数、嵌入熵与精确 unique token 共同拟合退化。
- 自适应正则: 让 dropout 随领域重复率 或专家累计曝光量变化。
- 更多架构: 测试共享专家、expert-choice、sigmoid 门控和 upcycled MoE。
12. 总结
这篇论文补上了稀疏模型 scaling law 中常被忽略的一条轴。活跃参数解释计算,总参数代表可用于记忆有限语料的容量。当数据开始循环,单看“总 token / 活跃参数”已经不够,“独特 token / 总参数”成为更有解释力的诊断量。
我认为有三条结论证据充分:
- 独特数据充足时 MoE 占优,重复率升高时却更早过拟合;
- 损伤严重程度随着总容量增加,在专家数和专家宽度两种变化下都成立;
- dropout 与输出遮蔽可把 MoE 优势延伸到更高重复率,但不能替代独特信息。
机制解释则仍是“很有希望但未定论”:路由很早稳定,专家敲除代价增大,dropout 同时降低专门化和高重复损失。这些现象符合“稳定路由让专家记忆狭窄 token 子集”的故事,但下一步仍需要真正的路由干预实验。
对训练实践而言,最重要的动作不是盲目增加 dropout,而是在选 MoE 稀疏度之前先数清独特数据。按领域报告重复率,在代理模型上覆盖生产区间,联合观察泛化损失、路由稳定度与专家冗余。只在全独特数据基准上胜出的 MoE,一旦真实语料循环几十轮,可能就是错误架构。