笔记日期: 2026-09-11
作者: Zhongzhu Zhou
阅读论文: LOCUS: Task-Aware Low-Rank Post-Training for Token-Efficient Language Generation
论文作者: Dongfang Zhao
arXiv: 2609.11739
发表状态: arXiv v1,2026 年 9 月 10 日
1. 这篇论文要解决什么问题?
大模型每多生成一个 token,解码器通常就要再经过一次完整的 Transformer 前向计算,同时增加调度开销和 KV Cache 占用。偏好优化又容易把“写得长”误当成“回答好”:更长的回复有更多机会出现与人工偏好相关的词句,却不一定增加真正的信息价值。
LOCUS 提出一个很有针对性的问题:保持 DPO、DrDPO 或 SamPO 的原始训练目标不变,只改变参数更新所在的低秩子空间,能否让模型更简洁?
它的做法不是在 loss 中加入长度惩罚,而是:
- 冻结基础模型;
- 在多个低秩配置下训练 adapter;
- 在开发集上测量生成长度和偏好效用;
- 在效用下降不超过 1 个百分点的候选中选择最短者;
- 用独立确认集复核,失败就退回 baseline;
- 部署时可把 adapter 合并回权重。
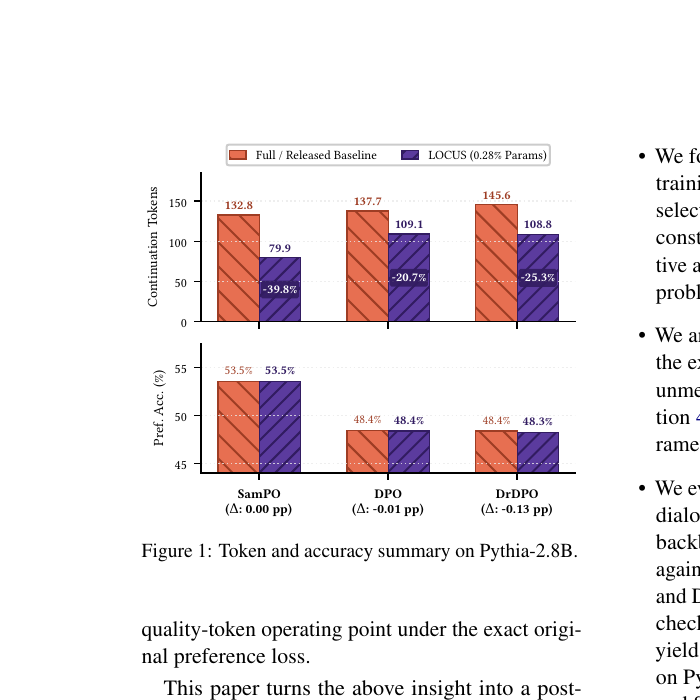
核心数字是:Pythia-2.8B 上减少 20.73%–39.84% 的平均续写长度,Qwen2.5-3B 上减少 14.87%–17.58%,训练参数只占模型的 0.24%–0.28%。
2. 前置知识
2.1 自回归生成为什么按长度付费?
给定输入 和输出 ,语言模型概率分解为
取对数后得到
这说明长度同时进入两个地方:生成成本大致随 增长;序列级偏好分数又由 token 对数概率累加而来。粗略写成
实际吞吐还受 batching、显存带宽和 kernel 影响,但减少无效 token 通常能直接改善服务容量。
2.2 DPO 的基本形式
每条偏好数据写成 ,其中 是被选择的回复, 是被拒绝的回复。DPO 相对参考策略定义隐式奖励
先构造偏好 margin
再最小化
当模型相对参考策略更偏向 时, 增大, 趋近 1,loss 下降。LOCUS 的关键约束是:这里不加入 一类长度项。
DrDPO 用稳健的 log-sum-exp 聚合微批次中的样本损失:
当 时,聚合会更接近困难样本的极值行为。LOCUS 同样完整保留这个目标,因此实验更接近在问“更新空间是否改变生成长度”,而不是“新的正则项是否有效”。
2.3 LoRA 到底限制了什么?
对 ,LoRA 写成
其中
因为 ,更新不能任意走遍整个矩阵空间。全量微调暴露 个参数,LoRA 只暴露
个因子参数。
通常令 、 随机初始化,因此初始时
训练从原模型函数精确起步,不会先产生随机行为跳变。
显然的替代方案是全量微调。它表达能力更强,但“自由度更多”不等于“更容易学到简洁”。LOCUS 的实验正显示:限制更新几何形状,可能让优化落到不同的行为轨迹。
2.4 论文中的效用不是人工质量评分
候选配置 的效用定义为
这个指标可复现、成本低,但只回答“模型给已标注 preferred response 的序列概率是否更高”。它不能直接证明事实性、完整性、安全性或用户满意度不变。理解后面的实验时必须一直保留这个边界。
3. LOCUS 的整体流程
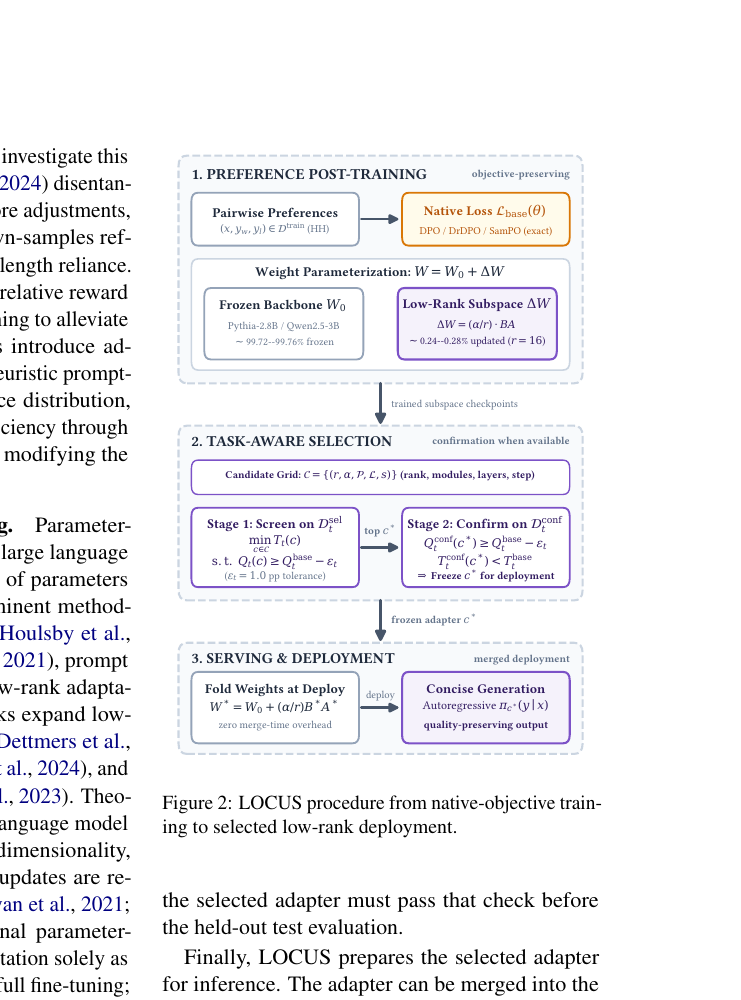
流程可以拆成三层:
- 训练层: 冻结 ,只训练低秩因子,loss 完全不变;
- 选择层: 比较不同 rank、模块、层范围和 checkpoint;
- 部署层: 冻结胜者,单租户合并权重,多租户保留 adapter。
真正使用“长度”的地方是选择阶段,而不是训练阶段。这避免了把“越短越好”直接写进梯度,但也意味着开发集指标承担了更大的责任。
3.1 候选空间和约束问题
候选配置写成
这里 是秩, 是缩放系数, 选择 等模块, 选择层, 选择训练步数。把 checkpoint 也放入配置很重要,因为长度并不随训练单调变化。
令 为任务 上的平均续写 token,LOCUS 解
并满足
把候选画在 平面上:先删除低于效用横线的点,再取最靠左的点。它是一个受约束的 Pareto 选择,而不是把两个目标混成一个 loss。
3.2 算法 1:训练、筛选、确认
编号伪代码
- 在 selection split 上计算 baseline 效用 。
- 对每个 ,从规定的起点用原生偏好目标训练 adapter。
- 在 selection split 上生成,记录 与 。
- 建立可行集合
。 - 集合为空则返回 baseline。
- 在可行集合中选择 token 最少的 。
- 没有确认集时,只能把它标记为“未确认候选”。
- 有确认集时,在独立数据上同时评估 和 baseline。
- 只有当效用下降不超过 且长度严格下降时才接受。
- 任一条件失败就回退到 baseline,否则冻结 。
为什么要第二个 split?因为搜索很多候选后,最优者会包含“运气好”的成分。独立复核能减轻 winner’s curse。替代做法是只用一个开发集选完就汇报,那会更容易高估效果。剩余边界是每个 split 只有 256 条,噪声仍然很大。
3.3 算法 2:计算偏好诊断
- 对每个 ,teacher forcing 计算 的 token 对数概率总和。
- 用相同方式计算 。
- 若 ,记 1,否则记 0。
- 对整个 split 求均值。
- 汇报时明确 selection、confirmation、test 身份,不混用结果。
这里有一个容易忽略的问题:序列 log probability 是 token 项的求和,因此它本身也可能带长度效应。这个指标适合协议内复现,却不是真正独立于长度的质量尺度。
4. 为什么低秩参数化会改变啰嗦程度?
LoRA 没有预先定义“简洁方向”。影响来自优化几何。设 ,则
因子的微小变化诱导
所以一阶更新只能位于当前因子附近的切空间,而不能任意选择 维方向。rank、模块位置与训练时刻改变可达方向,进而改变结束符概率、重复倾向和答案展开方式。
这个解释不能升级成“找到了语义上的 verbosity singular vector”。论文没有做这样的因果或谱分析。它证明的是不同子空间对应不同经验行为。
4.1 参数量命题的完整推导
一个 矩阵全量微调需要
LoRA 两个因子分别有 和 个元素:
参数更少当且仅当
等价于
对方阵 ,条件化成 。取 :
单个投影的因子参数量缩小 80 倍。
但因子坐标不是唯一的。任取可逆 :
这带来 维换基冗余,因此满秩位置附近,rank- 矩阵流形的局部维数是
优化器仍要存储 的所有元素与状态,所以“实现参数量”和“几何自由度”不能混为一谈。
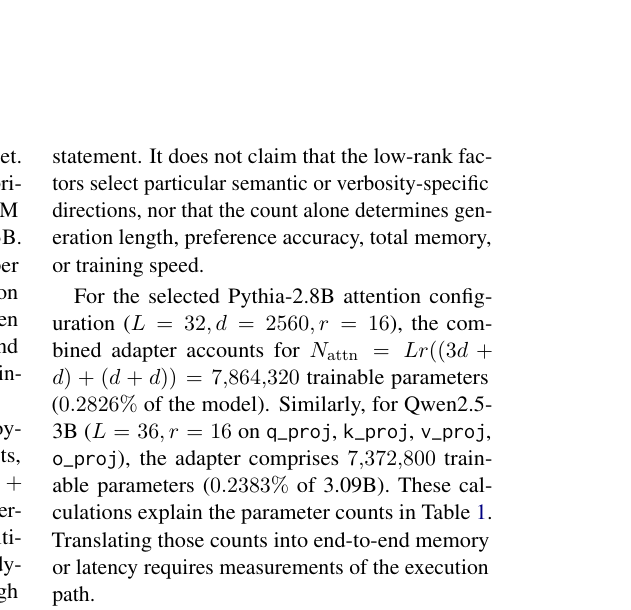
Pythia 有 32 层、hidden size 2560,在 fused QKV 和 attention output 上放 rank-16 adapter:
占模型 0.2826%。Qwen2.5-3B 的独立 q/k/v/o 投影总计 7,372,800,占 0.2383%。
4.2 算法 3:部署前合并 adapter
- 关闭 adapter dropout,切换到 inference mode。
- 读取冻结权重 和训练后的 。
- 用合适的累加精度计算 。
- 构造 。
- 用单个线性层替换双分支计算。
- 按数据类型或量化器容差比较 logits。
- 保留未合并因子,便于回滚和多租户复用。
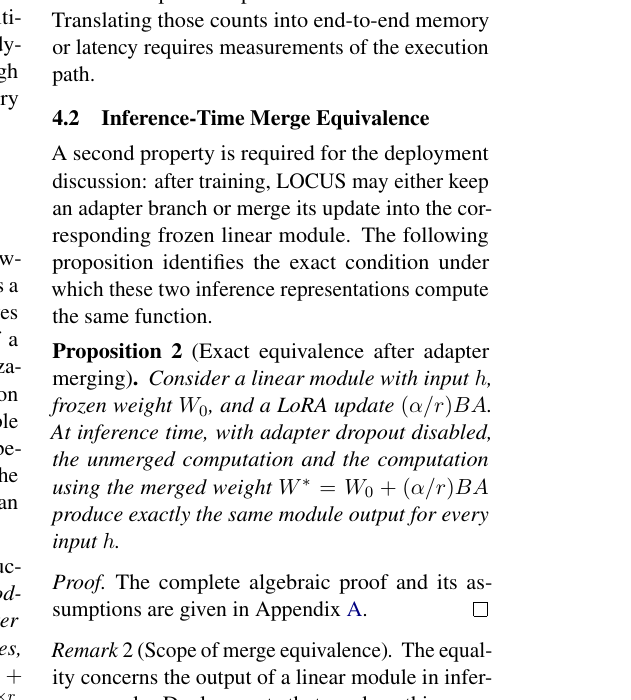
未合并输出是
利用结合律和分配律:
这个等价性要求 dropout 关闭,并假设精确算术。量化、不同计算顺序和有限精度会带来微小误差。多租户服务也可能故意不合并,以便共享一个 backbone。
4.3 设计选择:筛选,而不是长度惩罚
**为什么有效:**训练仍然优化原始偏好目标,长度只用于挑选 operating point,避免模型被直接奖励“尽快结束”。
**显然的替代:**在 loss 中加入 。优点是只训练一个模型,缺点是 很难跨任务设定,过大可能导致答案不完整。
**失败边界:**如果效用指标看不见质量损失,筛选依然会 Goodhart;如果候选网格太大,选择成本和过拟合风险都会上升。
4.4 设计选择:优先 attention adapter
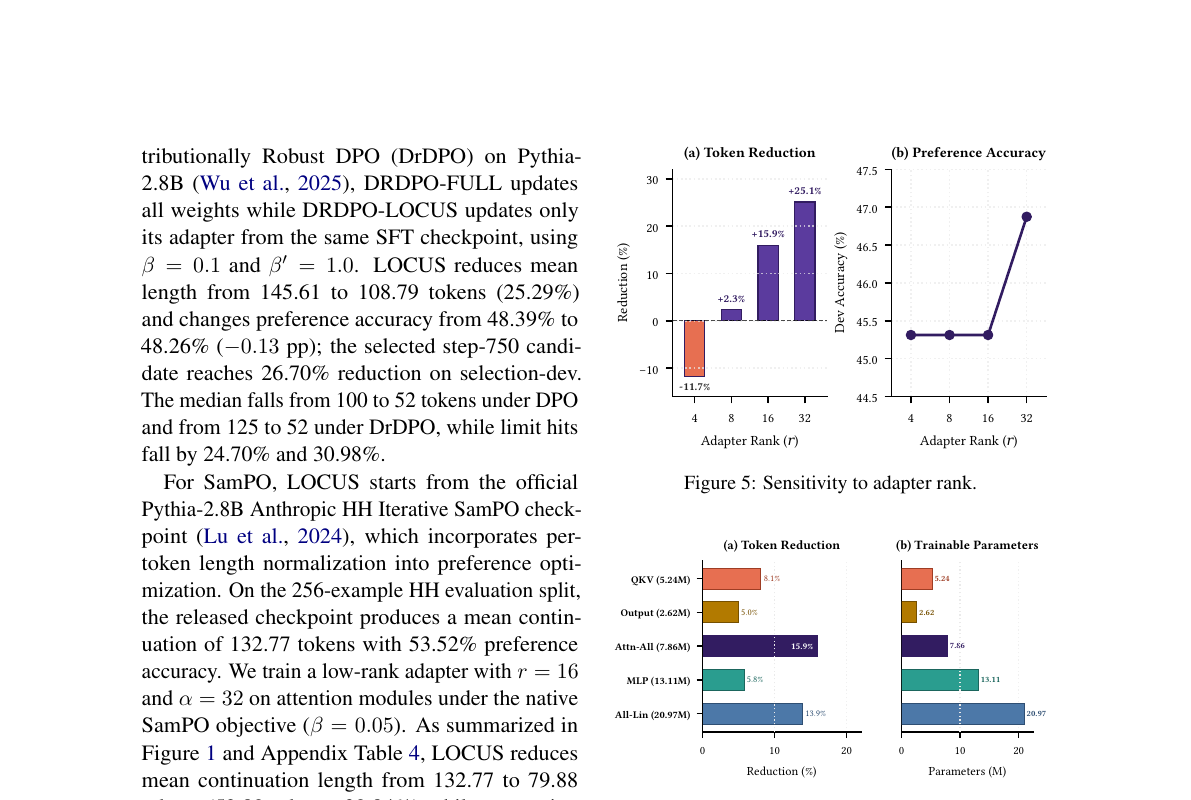
论文消融显示 Attention-All 用 7.86M 参数获得 15.95% token reduction;All-Linear 用 20.97M 参数却只有 13.88%。MLP-only 有 13.11M 参数,也只有 5.75%。
这说明容量不是唯一解释。attention 投影直接影响 token 间的信息路由和 next-token logits,更新位置可能比更新规模更重要。边界是不同模型的 QKV 布局不同:Pythia 的 fused QKV 与 Qwen 的 GQA 不能简单视为同一个子空间。
5. 实验设置与结果
5.1 公平比较是怎么做的?
模型包括 Pythia-2.8B(32 层 GPT-NeoX,hidden size 2560)和 Qwen2.5-3B(36 层,GQA、SwiGLU、RMSNorm)。训练和推理使用单张 NVIDIA A100 PCIe 80GB、bfloat16;全量 DPO/DrDPO 使用 activation checkpointing 和 512-token 序列。
核心数据是 Anthropic Helpful and Harmless。受控 DPO/DrDPO 的 full branch 与 LOCUS branch 共享 SFT 起点、训练池、原生目标和 split。最终测试集有 8,552 对;selection 与 confirmation 各 256 条。SamPO 从官方 checkpoint 继续训练,因此不能当成同起点的全量对照。
生成采用 greedy decoding,最多 256 个新 token,不统计 EOS,另外记录撞到 256 上限的次数。这个协议很可复现,但没有覆盖聊天产品常见的 temperature 和 top-p sampling。
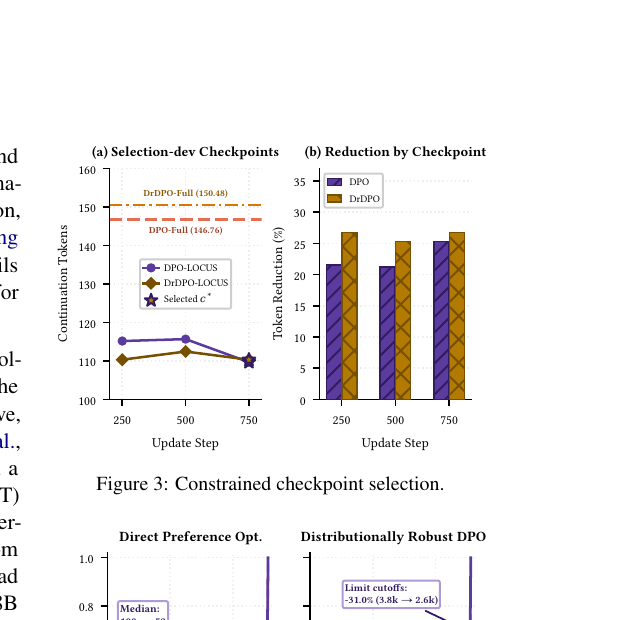
5.2 checkpoint 选择
DPO 和 DrDPO 都评估 250、500、750 步。最终 Pythia 配置选择 step 750。图中最值得注意的不是某个绝对值,而是训练更久并不保证持续变短:checkpoint 本身就是超参数。
传统 early stopping 常看 validation loss;LOCUS 看的是效用约束内的 token operating point。显然的替代是直接选 loss 最低的 checkpoint,但 loss、偏好准确率和生成长度不一定同向。
5.3 Pythia 主结果与长度分布
| 目标 | Baseline 平均 token | LOCUS 平均 token | 减少 | 偏好指标变化 |
|---|---|---|---|---|
| SamPO | 132.77 | 79.88 | 39.84% | 0.00 pp |
| DPO | 137.67 | 109.12 | 20.73% | -0.01 pp |
| DrDPO | 145.61 | 108.79 | 25.29% | -0.13 pp |
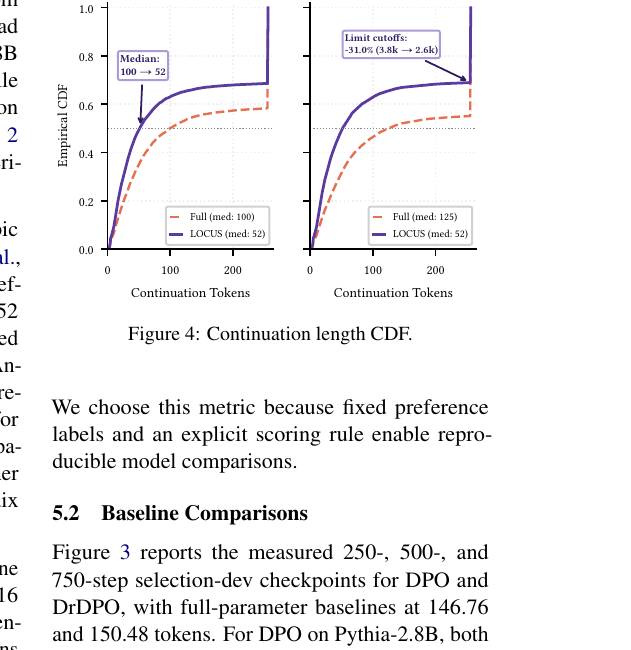
DPO 的中位数从 100 降到 52;DrDPO 从 125 降到 52。撞到 256-token 上限的比例分别下降 24.70% 和 30.98%。同时看 mean、median、CDF 和 cutoff hit,比只报均值更可信。
若把 DPO 差异换算成一百万请求:
这还不是美元或吞吐数字,因为论文没有测 batching 和硬件利用率,但它说明行为层面的变化可以积累成很大的服务量。
5.4 Rank sensitivity:低秩并非越低越好
固定 attention placement 和 后, 对应的 token reduction 约为 。负 reduction 表示 rank 4 让输出膨胀。
如果“参数少”本身就导致简洁,最小 rank 应该最好,实际相反。更合理的解释是 rank 改变了可达更新方向;太小的空间可能能拟合部分偏好,却不能稳定学会在合适位置结束。
内部偏好指标在 rank 4、8、16 上都为 45.31%,rank 32 为 46.88%。长度大幅变化而指标几乎不动,也暴露出效用代理对这种行为维度不敏感。
5.5 模块位置消融
| 目标模块 | 可训练参数 | Token reduction |
|---|---|---|
| QKV only | 5.24M | 8.09% |
| Attention output only | 2.62M | 4.96% |
| Attention-All | 7.86M | 15.95% |
| MLP | 13.11M | 5.75% |
| All-Linear | 20.97M | 13.88% |
All-Linear 参数是 Attention-All 的 2.7 倍,长度收益反而更小。这排除了“只要 adapter 更大就更简洁”的简单解释。更新在哪里,比更新多少更重要。
5.6 跨任务和跨 backbone
Pythia DPO 在 HH 对话、Harmless 和 Orca DPO 上的长度减少分别为 20.73%、25.29%、79.97%;偏好指标变化分别是 -0.01、+1.17、+13.67 pp。
79.97% 非常抢眼,但 Orca 行只有 256 条开发集数据,并非独立 test claim。它可能来自任务结构、baseline 特别啰嗦或选择过拟合。论文正文有说明,但读图时很容易过度推广。
Qwen2.5-3B 上,DPO 从 108.26 降到 92.16 token,减少 14.87%,偏好指标 -0.05 pp;DrDPO 从 111.58 降到 91.97,减少 17.58%,偏好指标 -0.09 pp。跨架构结果增强了证据,但两个模型仍都只有约 3B。
6. 一个手算选择例子
假设 baseline 的效用是 49.0%,平均长度 140; pp,所以效用底线为 48.0%。
| 候选 | Rank | 模块 | Step | 效用 | Token | 可行? |
|---|---|---|---|---|---|---|
| A | 4 | Attention | 250 | 49.2% | 151 | 是 |
| B | 8 | Attention | 500 | 48.7% | 126 | 是 |
| C | 16 | Attention | 750 | 48.3% | 104 | 是 |
| D | 32 | All-Linear | 750 | 47.5% | 82 | 否 |
D 最短,但违反效用约束;LOCUS 选择 C。若确认集上 C 为 47.8%,baseline 为 49.1%,则
C 失败,系统回退 baseline。这个例子也揭示相对约束的边界:baseline 本身很差时,效用底线也会很低。
6.1 256 条数据能支持 1 pp 的门槛吗?
对 的二元准确率,若 ,标准误约为
粗略 95% 区间约 pp,比 1 pp 容忍度宽很多。baseline 与 candidate 在同一批样本上的 paired difference 会降低方差,但论文没有给 paired confidence interval。
更稳妥的做法是对 prompt 做 paired bootstrap:
- 有放回抽样 256 个索引;
- 同时计算 baseline 与 candidate 的长度差和效用差;
- 重复 10,000 次;
- 用置信区间而不是点估计决定是否可行。
6.2 算法 4:带不确定性的 LOCUS
- 按原算法训练并生成所有候选结果。
- 对每个候选做 paired bootstrap。
- 估计效用差下界 与长度差上界 。
- 仅当 且 时判为可行。
- 在可行集里最小化平均 token 或高分位 token。
- 在独立确认集重复同一检验。
- 任一置信条件失败就回退 baseline。
这个改进不需要额外训练,只需重采样已有输出。边界仍是开发 prompt 必须代表真实流量。
7. 系统视角:参数少不等于端到端更快
7.1 训练内存
Adam 类优化器通常为每个可训练参数维护梯度和两个 moment。粗略记每项字节数为 :
若参数、梯度各 2 字节,两个 moment 各 4 字节,约为每个可训练元素 12 字节。7.86M adapter 元素对应约 94 MB 的这部分状态,而 2.8B 全量元素会达到数十 GB。
但是冻结 backbone 不会消除前向 activation,也不会完全消除反向传播。梯度仍需穿过冻结层到达 adapter。因此论文谨慎地只报告参数量,没有声称已经实测训练速度或峰值显存收益。
7.2 推理开销
单租户可以把 adapter 合并,运行时不再增加分支。多租户服务通常保留多个 adapter,共享 backbone,此时仍有 adapter 的存储、调度和矩阵乘法。
未合并计算为
额外计算量近似随
增长。低 rank 时通常远小于 ,但并非零。更短序列能否抵消 adapter 开销,需要结合 batch、kernel fusion、内存访问和 p99 latency 实测,论文没有提供这些系统指标。
8. 复现实验应该怎么做?
8.1 算法 5:最小可复现流程
- 固化 train、selection、confirmation、test 的 example ID 清单。
- 在论文指定 HH 训练池上训练一个共享 SFT checkpoint。
- 从同一 checkpoint 复制 full branch 和 LoRA branch。
- DPO 设置 ;DrDPO 额外设置 。
- 在全部 attention 投影放置 adapter。
- 保存 step 250、500、750 候选,保证数据顺序和生成协议一致。
- 在 selection split 用 greedy decoding、256 新 token 上限评估。
- 应用 1 pp 效用约束并选最短候选。
- 在独立 256-pair confirmation split 复核。
- 在触碰 8,552-pair test set 之前冻结选择。
- 汇报 paired mean、median、cutoff-hit rate 与偏好指标。
- 保存逐 prompt 输出,供人工检查是否因删掉必要内容而变短。
8.2 复现审计清单
- 统一 tokenizer、chat template 和 stopping condition;
- 一致地排除 EOS;
- 明确 prompt 是否进入序列分数;
- 公布随机种子与候选总数;
- 不把 SamPO continuation 当作同起点 full-vs-LoRA;
- 加入外部 judge 与人工盲评;
- 测 tokens/s、TTFT、ITL、p50/p99、峰值显存和能耗;
- 测不同 temperature、top-p;
- 审查变短回复是否漏掉条件、证明或安全解释;
- 报告全部候选和 GPU-hours,而非只报胜者。
8.3 预期中的“非代码故障”
rank 4 可能让输出更长;selection 胜者可能在 confirmation 失败;Pythia 的 fused QKV 配置不能原样映射到 Qwen GQA;量化后合并权重也可能不再 bitwise 相同。这些都不是实现必然出错,而是方法边界。
正确处理方式是扩大或重构开发集候选,不能反复查看 test set 调参。
9. 局限性与适用边界
论文明确承认:
- 只测试了两个约 3B 的 decoder-only 模型;
- 只测试 greedy decoding;
- rank 与模块网格较粗;
- 没有连续 rank allocation、细粒度 layer selection;
- 部分跨任务结果只在开发集;
- 参数量下降不等于端到端系统加速。
我还会补充以下边界。
**指标边界:**内部 pairwise accuracy 不等于事实性、完整性、安全性或用户满意度。
**搜索成本:**多个 rank、placement、layer 和 checkpoint 的累计训练成本可能高于一次全量训练,论文没有完整核算。
**流量边界:**HH 对话不能代表工具调用、代码、检索、多语言与长推理流量。
**截断边界:**256-token cap 会右删失长度分布,虽然 cutoff hit 下降是好信号,但观测均值不是无上限均值。
**对话边界:**单次回答变短可能引发更多追问,总会话 token 反而增加。
**因果边界:**实验说明“被选中的低秩轨迹更简洁”,没有证明存在通用的 verbosity 低秩语义子空间。
10. 批判性分析
10.1 这篇论文特有的弱点与缺陷
第一,论文使用“utility-preserving”表述,但真正保持的是很窄的内部指标。48%–53% 左右的 chosen-vs-rejected accuracy 接近随机,而且变化极小。指标可能本来就缺乏分辨率,无法发现回答质量下降。
第二,统计精度与门槛不匹配。selection 和 confirmation 各 256 条,却用 1 pp 作为效用容忍度。若没有 paired interval 或显著性检验,点估计很难支持如此精细的判定。
第三,搜索成本缺失。候选 tuple 包含 rank、scale、module、layer 和 checkpoint;只强调最终 adapter 占 0.28%,会隐藏找到它之前训练了多少候选。部署便宜与发现成本便宜是两回事。
第四,SamPO 的 39.84% 容易被误读。LOCUS 是从官方 SamPO checkpoint 继续做低秩适配,并没有同起点的 full-parameter SamPO 对照。这个结果有效,但证据级别不同于 DPO/DrDPO 受控实验。
第五,论文没有展示足够的生成样例,也没有人工或外部质量评价。短答案是在正确回答后停止,还是提前停止,单看均值与内部偏好指标无法判断。
10.2 作者弱化或遗漏的问题
**多重比较:**尝试的候选越多,selection 上出现“幸运短模型”的概率越高。独立确认能缓解,但论文应公布候选总数,并对选择偏差做校正。
**效用指标的长度耦合:**序列 log probability 是 token 求和,天然与长度相关。若约束指标本身受长度影响,它就不是完全独立的质量坐标。
**任务完成成本:**一次回复变短后,用户可能追加问题。生产环境应测完成一个任务或一段会话的总 token,而非单请求长度。
**必要解释:**安全拒答、数学证明和复杂诊断有最低说明长度。任务感知不能只表示“每个任务另选 adapter”,还应加入最低完整性条件。
**可迁移性:**两个 3B 模型不足以推断 7B–70B,也不足以推断 tool use、code generation 和 long-CoT。
**系统收益:**LoRA 合并等价是已有代数事实,不是吞吐证据。没有 p99、tokens/s、能耗和 KV 峰值,就不能把 token reduction 直接写成系统加速。
10.3 具体改进建议
- 增加盲测人工评价:正确性、完整性、安全性、无效啰嗦分别评分。
- 用 paired bootstrap 的置信下界决定效用可行性。
- 公布完整候选网格、失败候选、随机种子和总 GPU-hours。
- 同时报告长度归一化、校准后的偏好指标。
- 加入 matched length-penalty baseline 和简单 checkpoint-selection baseline。
- 测 7B–70B、多语言、工具、代码和长推理。
- 测 temperature 与 top-p,而不仅是 greedy。
- 发布逐 prompt 的 baseline/LOCUS 输出对,标注删掉了什么。
- 实测 throughput、TTFT、ITL、p99、KV Cache 与能耗。
- 对需要解释的任务加入 minimum-information 或 completeness constraint。
- 测不重新选择时的跨任务迁移,区分通用子空间与任务特定搜索。
- 在最终测试前预注册 和候选预算。
11. 我从这篇论文得到的认识
最有价值的思想是:PEFT 不只是全量微调的廉价近似。它改变优化几何,因此即便 loss、数据和起点相同,也可能改变生成行为。rank 和 placement 可以成为长度—效用前沿的控制旋钮。
最有说服力的证据不是最大 39.84%,而是多组控制:同 SFT 起点的 DPO/DrDPO、rank sensitivity、module ablation、CDF、第二个 backbone。这些控制共同排除了“只是参数更少”或“只是少数长样本”的解释。
最薄弱的环节是“效用”。更准确的说法应是:在本文协议下,LOCUS 保持了 chosen-vs-rejected 内部诊断,而不是已经证明用户可见质量完全不变。
12. 总结
LOCUS 在不修改偏好 loss 的前提下训练多个低秩 adapter,并选择效用约束内最短的配置。两个约 3B 模型上,平均续写长度降低 14.87%–39.84%,训练参数少于 0.3%。rank 和模块位置呈明显非单调效应,部署时还可代数等价地合并权重。
如果把它用于生产,我会保留 baseline fallback,但把效用约束升级为带置信区间的人工与自动联合评估,并补上 sampling、系统指标和总搜索成本。否则,模型可能只是学会了“更早结束”,而不是“更高密度地表达”。
这篇论文留下的更一般结论是:优化子空间本身就是行为控制器;而控制器是否可靠,最终取决于选择它的指标与验证设计。