笔记日期: 2026-09-09
作者: Zhongzhu Zhou
阅读论文: Jacap: Robust KV Cache Eviction via Jacobian-Based Nonlinear Information Capacity Preservation
论文作者: Jiaming Yang, Chenwei Tang, Liangli Zhen, Chenyang Zhang, Jiancheng Lv
arXiv: 2609.08131
状态: Preprint (2026)
1. 这篇论文要解决什么问题
自回归解码每生成一个 token,都要查询此前全部 token。为了不重复计算,推理引擎在每一层保存历史 key 和 value,这就是 KV Cache。上下文越长、批量越大,缓存越容易先于算力耗尽显存。
淘汰问题看似简单:若 (N) 个历史 token 只能留下 (B) 个,应该删谁?最近使用、累计注意力、key 范数、几何差异都能提供信号,但大多是逐 token 打分,没有解释 Softmax 归一化所带来的竞争,也难以识别 value 方向之间的冗余。
Jacap 把保留后的注意力看作一个带噪非线性通信信道:未来 query 是输入,KV 子集定义信道,注意力输出是观测。好子集应保留尽可能多的 query 相关信息。论文先在代表性 query 周围用雅可比矩阵局部线性化,再推导高斯互信息,最后把昂贵的集合目标近似成可在线计算的分数。
我的判断是:论文找到了 CapKV 一类线性容量方法遗漏的 Softmax 敏感度,推导清楚,高压缩率结果也有说服力;但算法把理论中最有特色的非对角竞争项删掉了,并且只围绕单一 query 中心展开,因此“非线性竞争得到保留”这一叙事比实际算法更强。
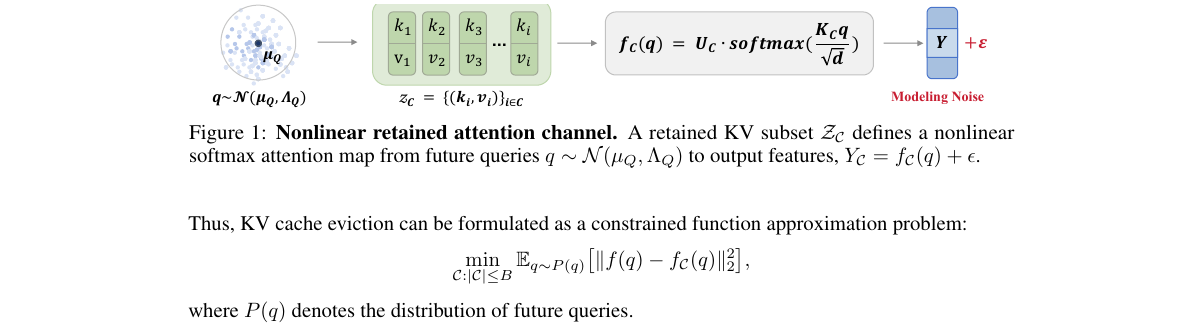
2. 前置知识:注意力与 KV Cache
对单个注意力头,第 (t) 步有
注意力权重与输出为
若模型有 (L) 层、batch 为 (b)、KV 头数为 (H_{kv})、长度为 (T)、头维度为 (d_h)、每个标量占 (s) 字节,则缓存近似占用
量化降低 (s),淘汰降低有效 (T),二者可以组合。
2.1 为什么逐 token 独立分数不够
设两个历史 token 的 value 几乎相同。逐项重要性可能都很高,但同时保留并没有增加新的输出方向。另一个注意力中等的 token,value 却可能指向缓存尚未覆盖的方向。合理淘汰至少要同时回答:
- **可达性:**未来 query 会不会激活这个 key?
- **敏感度:**query 小幅变化时,其概率会不会变化?
- **多样性:**该 value 是否增加新的输出方向?
- **相互作用:**保留它是否让另一个 token 变得冗余?
Softmax 还会产生竞争:所有权重之和为一,提高某个 logit 必然压低其他概率。因此注意力不是一组互不相关的线性通道。
论文中的压缩率 (c) 越高,删除越激进,保留数为
当 (c=0.9) 时仅保留 10%。轻度压缩时大量冗余能掩盖错误,高压缩时一次误删就可能丢掉唯一证据。
2.2 未来 query 的统计模型
Jacap 假设
(\mu_Q) 表示 query 常出现在哪里,(\Lambda_Q) 表示围绕中心沿哪些方向变化。实践中使用对角协方差,使每个 key 的响应方差可线性计算。
3. 相关方法与缺失环节
- **SnapKV/历史注意力:**便宜且有 query 信息,但过去被关注不等于未来有用。
- **KNorm:**大范数只是影响力代理,忽略 query 方向与 value 冗余。
- **KeyDiff:**key 不同不代表最终输出方向不同。
- **Expected Attention:**估计未来注意力,但主要仍是逐 token 评分。
- **CapKV:**以线性高斯容量为目标,用杠杆分数刻画输出多样性。
最接近的 CapKV 假设
容量为
它能奖励 query 响应和输出多样性,但真实注意力在 (K_Cq) 与 (U_C) 之间还有 Softmax。Softmax 会饱和,也会耦合所有 token。Jacap 的核心主张是:Softmax 的雅可比矩阵补上了这层局部几何。
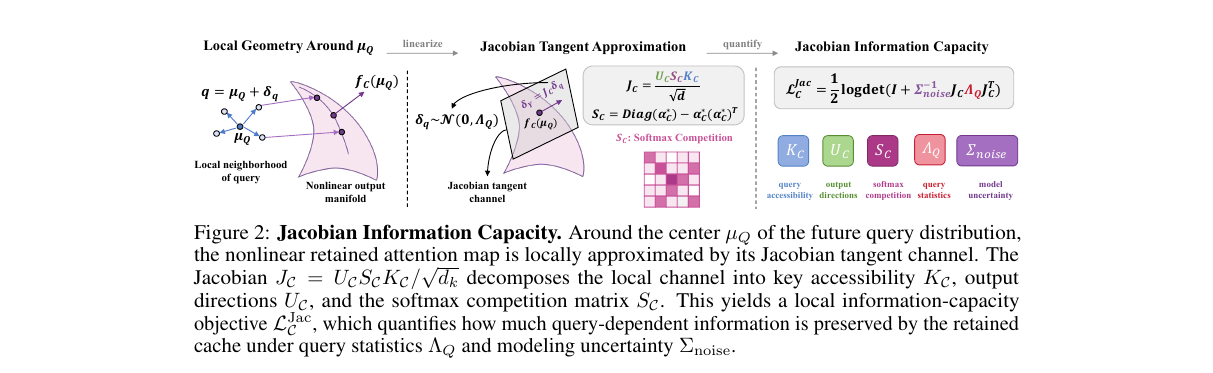
4. 把非线性注意力写成局部信道
对保留子集 (C),把 key 按行组成 (K_C),把投影后的 value (u_i=W_Ov_i) 按列组成 (U_C):
加入建模噪声:
理想效用是
它衡量看到输出后,对未来 query 的不确定性能减少多少。非线性互信息难以直接求闭式解,因此令 (\delta q=q-\mu_Q),在中心附近做一阶泰勒展开:
这是一张切平面:局部便宜准确,离中心越远、曲率越大,余项越不可忽略。
4.1 逐步推导注意力雅可比
定义
由于 (\alpha_i=e^{z_i}/\sum_j e^{z_j}),对 (z_j) 求导:
矩阵形式为
而
对 (f_C(q)=U_C\alpha(q)) 使用链式法则,并在 (\mu_Q) 处取值:
其中
(K_C) 把 query 扰动映射成 logit 扰动;(S_C) 把 logit 变化映射成相互竞争的概率变化;(U_C) 再把概率变化映射到输出空间。
5. 雅可比信息容量的完整推导
局部线性化后,
常数偏置不影响互信息。条件协方差与边缘协方差分别为
高斯变量的微分熵为
边缘熵减去条件熵,常数项抵消:
利用
得到
代入雅可比:
5.1 敏感、饱和与竞争
对角元素为
当 (\alpha_i^\star\to0) 或 (1) 时趋近于零,在 (1/2) 处最大。几乎不被关注与完全支配的 token,对“小幅 query 扰动”都不敏感。
非对角元素为
提高一个 logit 会压低其他概率,因此是负值。还有
这表示给全部 logit 同加常数不会改变 Softmax。
若概率是 ((0.5,0.5)),
若概率是 ((0.99,0.01)),各项绝对值仅为 (0.0099)。所以高注意力不等于高局部信息增益。但这里要提前提醒:低导数也不等于删除无害,后文会专门批判这一点。
6. 从定理到可执行分数
精确搜索所有子集是组合爆炸,而且 (\alpha_C^\star) 本身依赖未知子集。Jacap 做了四步近似。
6.1 先在完整候选池计算注意力
温度 (\tau) 控制尖锐程度。这解决了循环依赖,但淘汰后 Softmax 会重新归一化,实际概率可能明显变化。
6.2 对角化 Softmax 竞争与 query 响应
把稠密竞争矩阵替换为
把 key 响应协方差替换为
组合后得到单 token 权重:
三个因子分别体现中心相关性、Softmax 敏感度与未来 query 扰动下的响应方差。
6.3 用杠杆分数补回输出多样性
取 (u_i=W_Ov_i),或用 (v_i) 作为廉价代理,构造
最终分数为
如果某个方向已被许多 value 覆盖,(A_{\mathrm{Jac}}) 沿该方向较大,逆矩阵会降低重复 token 的分数;稀缺方向获得更高杠杆。
7. 算法 1:一次完整淘汰
**输入:**候选 ({(k_i,v_i)}_{i=1}^N)、预算 (B)、(\mu_Q,\Lambda_Q,\tau)。
**输出:**保留集合 (C),且 (|C|=B)。
- 计算中心 logit:(z_i=k_i^\top\mu_Q/(\tau\sqrt{d_k}))。
- 归一化得到 (\bar\alpha=\operatorname{softmax}(z))。
- 计算响应方差 (\kappa_i=k_i^\top\Lambda_Qk_i)。
- 计算 (w_i=d_k^{-1}[\bar\alpha_i(1-\bar\alpha_i)]^2\kappa_i)。
- 取 (u_i=W_Ov_i),或使用代理 (v_i)。
- 累加 (A=I+\sum_iw_iu_iu_i^\top)。
- 对 (A) 做一次 Cholesky 分解,对每个 token 解 (Ax_i=u_i)。
- 得分 (r_i=w_iu_i^\top x_i)。
- 保留得分最高的 (B) 项。
- 工程上先扣除 sink、系统前缀和最近窗口,再分配弹性预算。
不要显式求 (A^{-1});分解加线性求解更稳定,也能复用。
7.1 杠杆分数为什么来自容量增量
向矩阵 (A) 加入秩一信息 (w_iu_iu_i^\top),矩阵行列式引理给出
因此对数容量增量是
当增量较小时,(\log(1+x)\approx x),于是得到 (r_i)。固定 (A) 时,用 (x) 或 (\log(1+x)) 排序相同;但 Jacap 的 (A) 来自完整候选池,选中 token 后并不更新。逐步贪心会更接近集合优化,却显著更贵。
7.2 一个二维手算例子
设三个输出方向为
令 (w_1=w_2=1)、(w_3=0.7)。逐项权重会优先选 1、2,但它们近乎共线;1、3 则覆盖两个轴。杠杆分数会降低 (u_2) 的边际价值。这正是纯注意力分数没有的“结构多样性”。
7.3 复杂度
头维度为 (d_h)、候选数为 (N) 时:
- logit 与权重:(O(Nd_h));
- 容量矩阵:(O(Nd_h^2));
- 分解:(O(d_h^3));
- 全部杠杆分数:(O(Nd_h^2));
- top-(B):(O(N\log B)) 或线性选择。
主要复杂度为
启发式方法通常只有 (O(Nd_h)) 或 (O(N))。论文强调 (d_h) 常为 128,且小矩阵可在 GPU 上并行;但线上服务还要考虑 kernel 启动、同步、分层调用与连续批处理。
8. 设计选择:为什么、替代方案、边界
8.1 一阶局部几何
**为什么有效:**这是保留 Softmax 敏感度、又能获得高斯闭式容量的最低成本工具。
**替代方案:**二阶 Hessian 修正,或 Monte Carlo 估计非线性互信息。
**边界:**多峰、快速漂移的 query 可能离单一切平面很远,误差随曲率和位移平方增加。
8.2 对角化竞争
为什么有效:(\alpha_i(1-\alpha_i)) 以逐 token 成本保留饱和信息。
**替代方案:**保留精确的秩一修正 (-\alpha\alpha^\top)、分块竞争或 top-(k) 交互。
**边界:**相关 token 组与归一化重分配会被误判;被删掉的恰好是定理强调的竞争结构。
8.3 选前概率
**为什么有效:**在子集未知时也能一次打分。
**替代方案:**逐步选择并重新归一化,或先取 top-(2B) 再做第二次评分。
**边界:**90% 压缩后竞争者大量消失,完整池中的小概率 token 可能重新变得重要。
8.4 用 value 代理输出方向
**为什么有效:**直接使用 (v_i) 避免淘汰时额外乘 (W_O)。
**替代方案:**真实 (u_i=W_Ov_i)、低秩投影,或残差流空间中的多样性。
边界:(W_O) 会旋转、混合和压低不同头的输出,投影前不同不保证投影后不同。
8.5 温度约为十
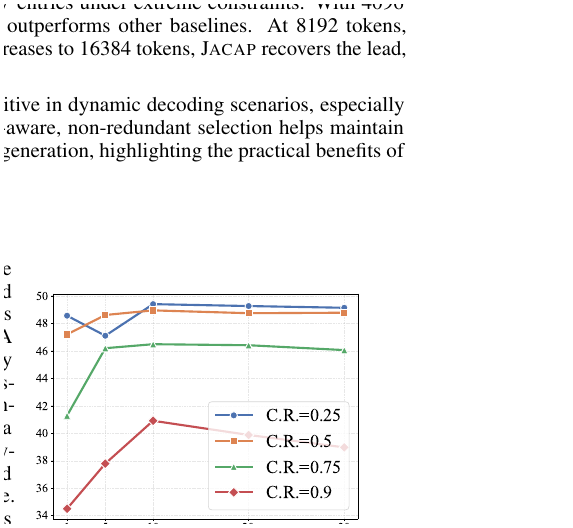
**为什么有效:**温度防止中心先验过尖;消融在 (\tau\approx10) 最好。
**替代方案:**根据注意力熵、层深、上下文长度、头角色或压缩率自适应。
**边界:**在 Qwen3-8B LongBench 上调出的固定值,不一定适配不同 logit 尺度。
9. 实验设置
论文从四个角度评估:
- **LongBench:**覆盖单文档问答、多文档问答、摘要、few-shot、合成任务与代码。
- **Needle-in-a-Haystack:**同时改变上下文长度与 needle 深度,检查稀疏远程证据。
- **AIME25 在线解码:**生成过程中动态淘汰新产生的 KV,测试数学推理。
- **运行时间:**输入 8K 至 64K,压缩率 0.6/0.8,生成 100 token。
LongBench 模型是 Qwen3-8B、Qwen3-14B 与 Llama-3.1-8B;AIME25 使用 Nemotron-7B。基线包括 CapKV、SnapKV、Expected Attention、KeyDiff、KNorm。附录报告环境为四张 RTX Pro 6000 与 Ubuntu 22.04,运行时间用单卡。
覆盖面设计不错:LongBench 看总体质量,NIAH 暴露特定长度/位置的灾难区域,AIME 看生成 KV。但论文没有报告多次运行方差、实际节省字节、并发请求吞吐、p99 延迟,也没有把 prefill 与 decode 成本拆开。
10. 实验结果逐项阅读
10.1 LongBench
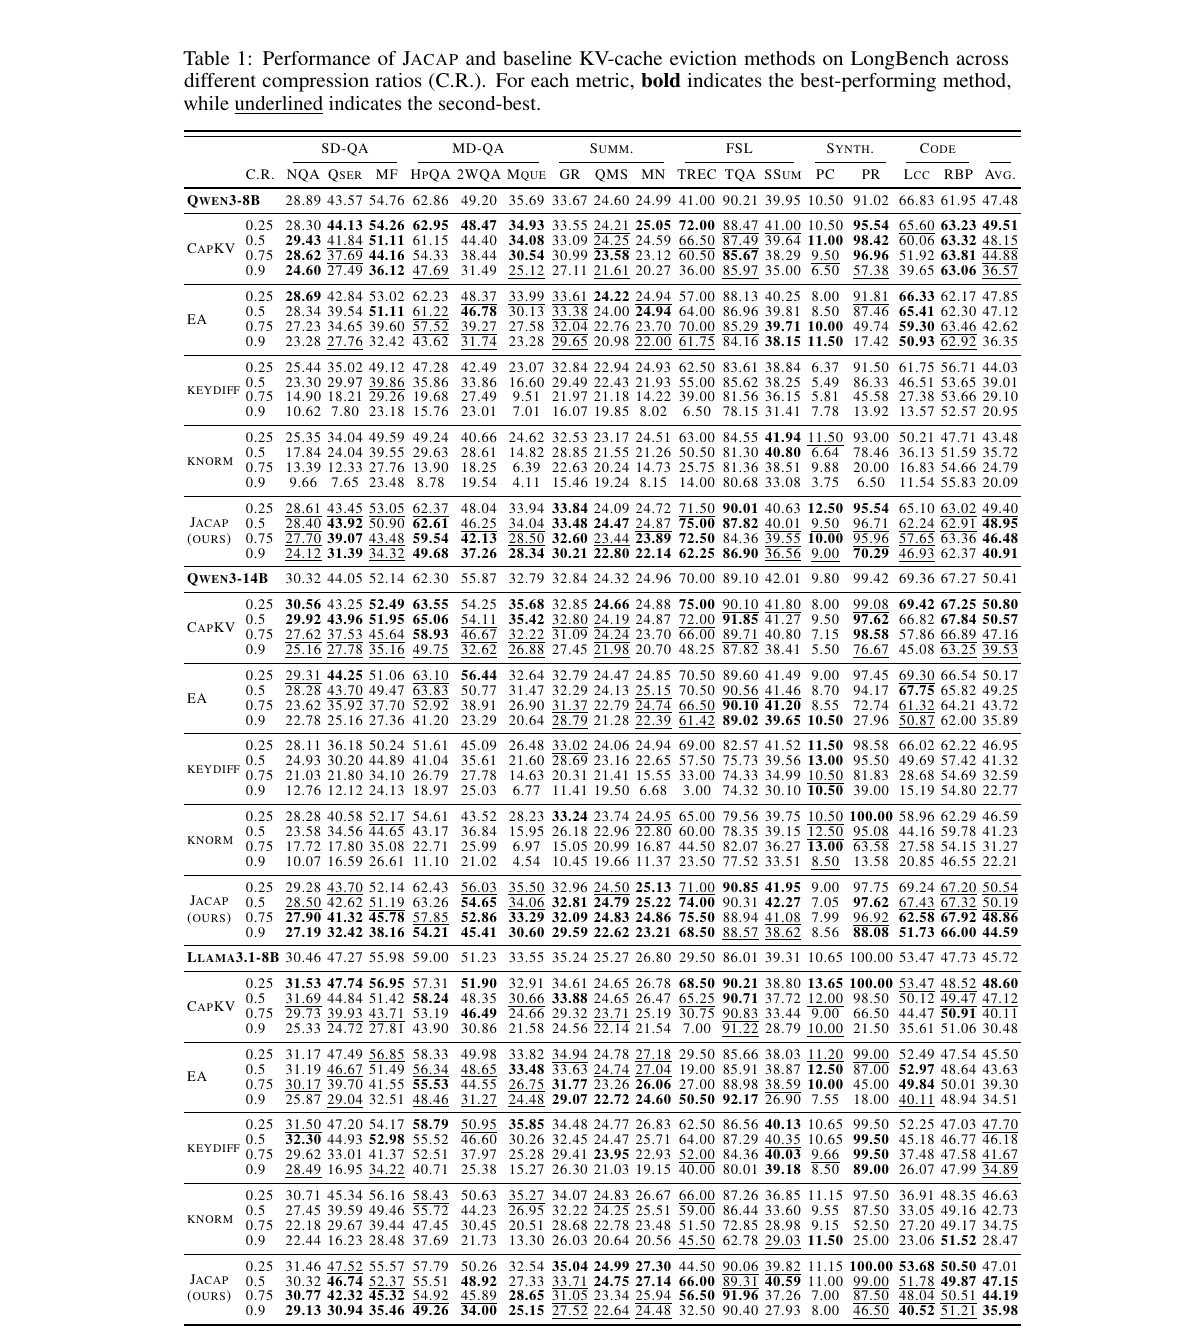
Qwen3-8B 在 (c=0.75) 时,Jacap 平均 46.48,CapKV 为 44.88,绝对提升
到 (c=0.9),Jacap 40.91、CapKV 36.57:
差距随压缩加剧而扩大,符合“预算越紧,非线性敏感度越重要”的解释。Qwen3-14B 在 (c=0.9) 时领先 5.06 分;Llama-3.1-8B 同设置领先 5.50 分,说明不是只适配一个模型。
但“平均最好”不等于所有任务都赢。中等预算下,个别列会由其他方法领先;轻度压缩时也容易接近天花板。因此证据最强的结论是“高压缩下更稳”,不是“所有场景绝对统治”。
10.2 Needle 检索
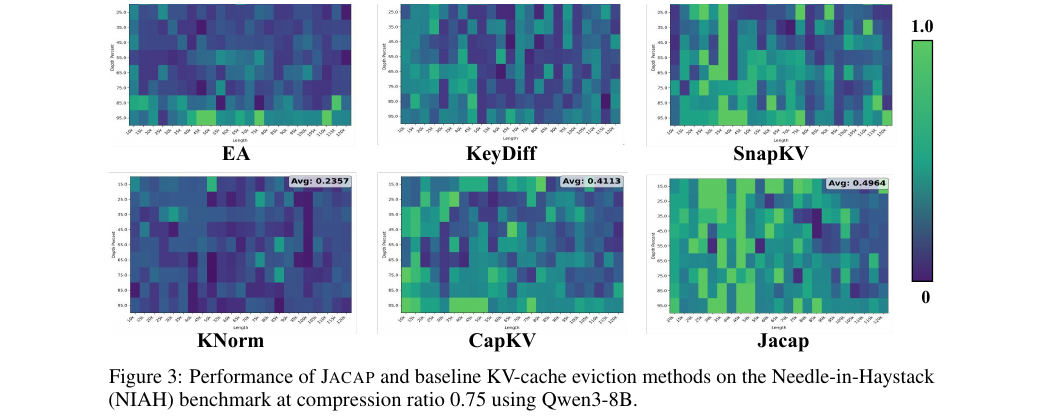
Qwen3-8B、(c=0.75) 时,Jacap 在更长上下文和更深 needle 位置仍保持较完整的热力图。KNorm、KeyDiff 大面积失效;注意力方法与 CapKV 较强,但会出现明显空洞。
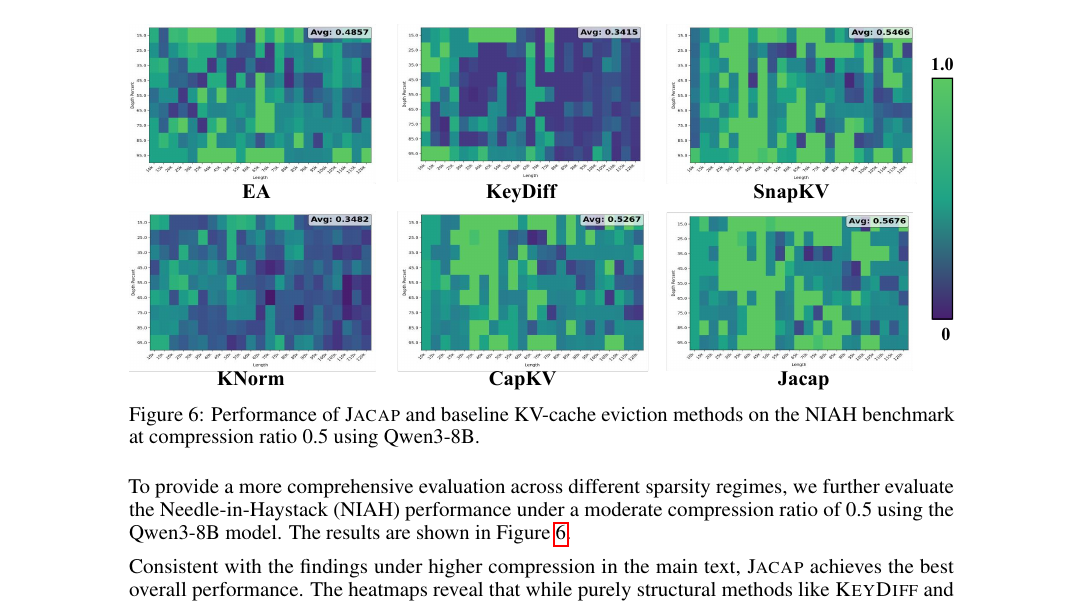
附录在 (c=0.5) 下复现实验,Jacap 仍最均匀,说明结果不只出现在极端压缩点。
10.3 AIME25 动态解码
保留 2048、4096、8192、16384 token 时,Jacap 得分分别为 0.30、0.50、0.53、0.73;CapKV 是 0.20、0.50、0.73、0.67。
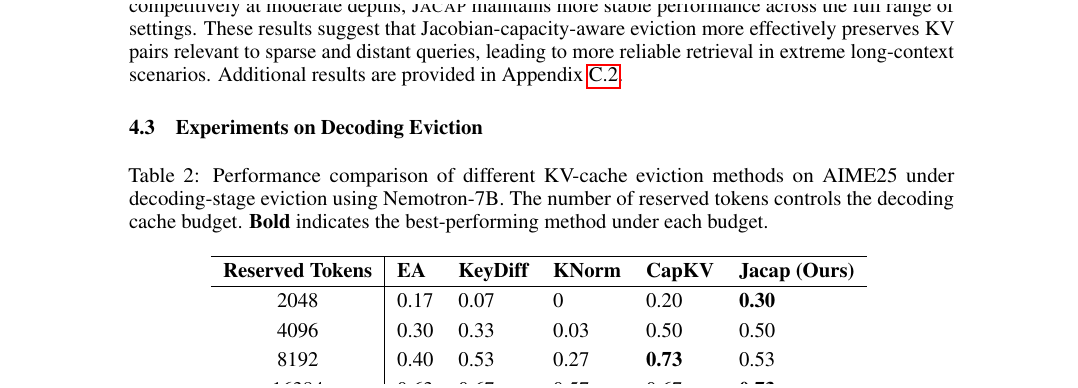
8192 的反转很重要,它反驳了“理论更完整就必然处处更好”的简单叙事,可能来自敏感度与预算、推理阶段或统计估计的交互。AIME 样本量小,几个题就会显著改变比例,而论文未给置信区间。
10.4 运行时间
64K 上下文时,各方法总时间处于相近量级。尽管理论复杂度更高,Jacap 没出现不可接受的单卡生成开销。
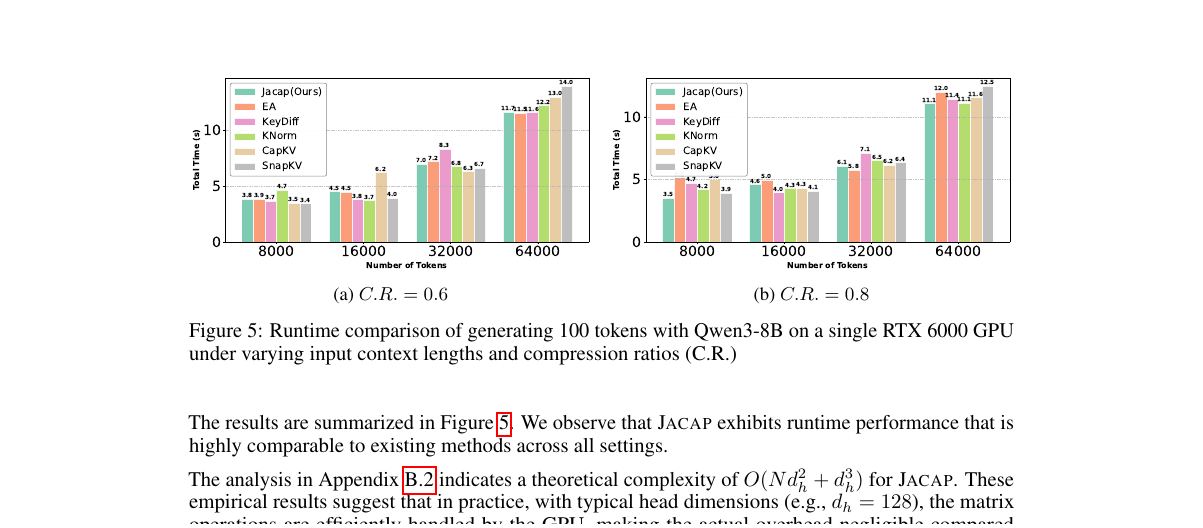
但“单请求总时间相近”不等于生产可用。仍缺 batch、并发、峰值临时内存、淘汰频率、数据搬移、p50/p99 延迟等指标。
11. 算法 2:面向服务系统的完整接入流程
论文算法只给评分核心,实际引擎还需要控制逻辑:
- 为每层初始化 query 均值与对角二阶矩。
- 解码时以指数滑动平均更新统计,不要跨租户混合请求。
- KV 使用量到达高水位前正常追加。
- 先保护系统前缀、attention sink 与最近滑动窗口。
- 只对剩余候选区域运行算法 1。
- 用 Jacap 分数填满弹性预算。
- 压缩或重映射物理 KV page,但保持逻辑 token 位置不变。
- 继续解码,并记录淘汰耗时、token 年龄分布、注意力熵与显存。
- 到下一高水位或固定间隔再触发,不要每 token 都运行。
- 若分解失败或超过延迟 deadline,回退到滑动窗口策略。
均值可按
更新,二阶矩为
对角协方差估计为
(\beta) 体现稳定与适应的取舍:大 (\beta) 平稳但滞后,小 (\beta) 灵敏但噪声大。论文没有充分明确这部分,复现时必须记录。
12. 可复现性清单
至少固定以下项目:
- 模型 revision、tokenizer 和 prompt 模板;
- 生成温度、采样参数、最大长度;
- 压缩哪些层、哪些 KV 头;
- 淘汰 prompt KV、生成 KV,还是两者;
- 压缩率定义、受保护 token 和窗口大小;
- (\mu_Q,\Lambda_Q) 的更新规则;
- (\tau)、(A) 的正则、计算精度与噪声尺度;
- 使用 (v_i) 还是 (W_Ov_i);
- 淘汰周期、高水位与 page 重映射;
- 随机种子、数据版本和评测器版本。
基本单元测试应检查:
- 加单位阵后 (A) 对称正定。
- 所有 (w_i\ge0)。
- bf16/fp16 下分数有限,分解可用 fp32。
- 扣除保护区后保留数精确等于预算。
- 缓存重排不改变 RoPE 位置和因果语义。
- 全缓存模式复现原模型输出。
- 把敏感度设为常数后,退化到接近 CapKV 的结构项。
论文的数学部分比系统复现说明更完整。若公开代码、query 统计更新与配置表,复现门槛会明显降低。
13. 局限与适用边界
作者明确承认一阶局部近似与对角竞争近似。我认为还要补充以下边界。
13.1 query 分布漂移
长推理会经历读题、规划、计算、验证等阶段。单一中心可能平均掉多个不相容模式。验证阶段才需要的 token,可能在规划阶段显得无关并被提前删除。
13.2 头与层的异质性
不同头可能负责分隔符、实体复制、归纳模式或位置锚点。统一温度与预算会过度压缩“平时沉默、关键时刻有用”的头。局部头容量也不等同于最终任务效用。
13.3 Softmax 饱和不等于无用
若 (\alpha_i\approx1),局部导数很小;但直接删除这个支配 token 可能造成巨大离散变化。雅可比测量“小 query 扰动下的响应”,不是“移除该 token 的反事实损害”。局部平坦可以与全局重要并存。
13.4 选择前后几何不一致
分数使用完整池注意力,容量矩阵也包含全部候选。一旦删掉 90%,归一化和已覆盖输出方向都改变了;一次性杠杆分数是在已经不存在的几何上计算的。
13.5 线上负载成本
单卡单请求图不能证明连续批处理吞吐。小矩阵分解可能与 decode kernel 串行,临时矩阵会占显存,物理 page 压缩还可能触发数据搬移和碎片。
13.6 评测覆盖有限
LongBench 与 NIAH 是有用代理,但没有覆盖多轮 agent、带语义干扰项的检索、多模态缓存、多语言长生成或对抗性证据。AIME25 样本较小,比例容易被少数题改变。
14. 批判性分析
14.1 论文自身的弱点与缺陷
第一,理论招牌在算法里被删除。 论文用稠密非对角项 (-\alpha\alpha^\top) 解释 Softmax 竞争,实际算法却把它对角化。实验真正验证的是“平方敏感度权重加杠杆分数有效”,并未证明保留了完整竞争结构。
第二,消融过窄。 主要只扫描温度。更关键的因子实验应包括:CapKV 加敏感度、敏感度不加杠杆、完整/对角 query 协方差、(v_i)/(W_Ov_i)、静态/动态统计、一次选择/二次重评分。
第三,统计报告不足。 缺少置信区间、重复种子、配对显著性检验与 NIAH 区域汇总。AIME 比例尤其应给题目数和不确定性。
第四,理论到实现的接口不完整。 理论中有 (\Sigma_{\mathrm{noise}}),实践却吸收到权重尺度;(\mu_Q,\Lambda_Q) 估计、正则、淘汰周期、保护 token 策略说明不够。
14.2 作者轻描淡写或遗漏的限制
- **低导数与删除损害不等价:**饱和 token 的雅可比小,但 leave-one-out 损害可能最大。
- **RoPE 位置依赖:**超长上下文中相对位置改变 query-key 几何,平稳高斯先验难以描述相位旋转。
- **GQA 共享:**一个 KV 头服务多个 query 头,各自分布不同;聚合统计可能牺牲少数头。
- **策略改变未来分布:**token 被删除后,后续隐藏状态和 query 轨迹也变化,淘汰策略会改变自己的输入分布。
- **安全性:**对抗提示可操纵敏感度,让干扰项长期保留或让策略关键内容被删除。
- **能耗与临时显存:**评分缓冲和反复构造矩阵可能抵消部分缓存收益。
- **层间标定:**不同层的 logit 尺度与熵不同,统一 (\tau) 未必可比。
14.3 具体改进建议
保留秩一竞争修正。 由于
被忽略部分有明确低秩结构。可以直接高效计算 (Sx),无需显式生成 (N\times N) 矩阵,并测试低秩感知评分。
使用多中心 query 模型。 维护若干中心与对角协方差,根据当前 query 选择模式,再用加权或最坏情况容量汇总,以覆盖规划到验证的切换。
做两阶段重评分。 先保留 top-(2B),在候选子集内重新归一化、重建容量,再选 (B)。它比一次评分贵,但直接缓解选择前后几何不一致。
保护全局重要的饱和 token。 将局部敏感度与历史注意力或 leave-one-out 代理混合:
这能避免把“局部平坦”误解成“可以删除”。
按头按层分配预算。 在总显存约束下,根据边际质量或容量自动分配,而不是所有层使用相同压缩率。
加强实验。 增加更难的长上下文评测、多轮 agent 轨迹、语义干扰检索、连续批处理吞吐、p50/p99、峰值临时内存、质量—显存 Pareto 曲线,并至少报告三个随机种子。
发布融合实现。 提供构造加权 Gram 矩阵与批量 Cholesky 求解的 Triton/CUDA kernel,才能真正检验系统效率主张。
15. 下一步最值得测什么
可以把总误差拆成
用真实注意力输出变化与 (J_C\delta q) 的差测 (E_{\mathrm{Taylor}});用完整/对角雅可比协方差差测 (E_{\mathrm{diagonal}});在小缓存上比较一次 top-(B)、逐步贪心与穷举,测 (E_{\mathrm{selection}})。
这种分解能把“非线性容量有效”变成可证伪结论:收益到底来自敏感度、结构多样性,还是某个未被控制的超参数?
16. 工程迁移要点
如果要把论文思想用于推理引擎,我会按以下优先级落地:
- 先保护系统前缀、sink 与最近窗口,避免纯评分破坏基本稳定性。
- 用未来 query 统计替代纯 key 范数。
- 加入 Softmax 饱和项,避免“注意力越高越该留”的单调假设。
- 用输出多样性去重,避免多个 value 重复占预算。
- 用稳定分解和批量小矩阵运算,避免显式求逆。
- 评估端到端延迟与峰值内存,不只看渐近复杂度。
- 分布漂移明显时,使用带保护下限的混合分数。
对研究者而言,最有价值的思想是把 KV 淘汰写成“局部信息几何”。雅可比把注意力机制与容量连成了一条可解释链。真正开放的问题是:能否在可接受成本下保留竞争结构,而不只保留对角敏感度。
17. 总结
Jacap 把 KV Cache 淘汰从经验排名推进到机制化目标。它从非线性注意力出发,得到
再得到局部容量
实践分数结合 query 变化、Softmax 敏感度与基于杠杆的输出多样性。三种模型上的 LongBench 优势在 90% 压缩时最大;NIAH 热力图更完整;AIME25 同时呈现优势与一个值得追问的中间预算失利;单卡运行时间在论文设置下与基线大致相当。
论文最强之处是推导和高压缩质量,较弱之处是完整竞争结构在近似后并未保留,生产服务评测也不足。低秩竞争修正、多峰 query 统计、二次重评分与更强消融,是最具体的后续方向。
18. 推导路线速查
完整逻辑可以压缩成八步:
- 保留注意力是非线性映射:(f_C(q)=U_C\operatorname{softmax}(K_Cq/\sqrt{d_k}))。
- 在 (\mu_Q) 附近线性化:(f_C(q)\approx f_C(\mu_Q)+J_C\delta q)。
- 链式法则引入 (S_C=\operatorname{Diag}(\alpha)-\alpha\alpha^\top)。
- 高斯扰动与噪声导出 log-det 容量。
- 对角化敏感度与 query 响应,得到 (w_i)。
- 构造 (A=I+\sum_iw_iu_iu_i^\top)。
- 用 (w_iu_i^\top A^{-1}u_i) 奖励边际输出多样性。
- 取 top-(B),同时牢记重归一化与局部性边界。
这八步也是复现、质疑和改进 Jacap 时应逐项检查的路线图。
19. 补充推导:log-det 到底在奖励什么
设白化后的有效信道协方差为
因为 (G) 半正定,可写成特征值分解,其特征值为 (\lambda_1,\ldots,\lambda_r)。容量于是变成
这说明 log-det 不只关心总能量 (\sum_\ell\lambda_\ell),还关心能量是否覆盖多个独立方向。举例来说,两种候选子集都有总特征值 10:
- 子集 A:((10,0));
- 子集 B:((5,5))。
忽略系数 (1/2),两者目标分别为
所以 B 的容量更大。它不是简单保留“最强”的方向,而是倾向覆盖多个可区分方向。这也解释了为什么杠杆分数会惩罚共线 value。
噪声协方差也有明确含义。若某个输出方向噪声大,白化后的对应增益会降低。若假设各向同性噪声
则
(\sigma^2) 越大,所有信道方向的收益越被压低。实践中把它吸收到权重尺度虽然方便,却也失去了“不同方向有不同建模不确定性”的表达能力。
19.1 局部导数与删除反事实的区别
雅可比回答的是
也就是固定子集时,query 小变化造成什么影响。淘汰真正关心的却是
也就是删除 token 后函数本身改变多少。两者不是同一个问题。支配 token 可能处在 Softmax 饱和区,第一项很小,但删除反事实很大。因此更稳健的目标应同时包含局部信息容量与删除敏感度。
20. 三类具体失败案例
20.1 延迟调用的密码或约束
系统提示中的一条约束长时间不被关注,在最终输出校验阶段才需要。近期 query 统计会认为它不可达,提前删除后无法恢复。保护前缀是比纯分数更可靠的系统措施。
20.2 两个互为竞争者的证据
两个 token 的 key 都与当前中心接近,value 分别支持相反结论。非对角项本应描述“提高一个会压低另一个”,对角近似却独立评分。若其中一个因轻微分数差被删,模型可能失去比较能力。
20.3 推理阶段突变
模型从自然语言规划切换到数字计算,query 分布迅速漂移。较大 (\beta) 让统计滞后,较小 (\beta) 又可能受单个异常 query 干扰。多中心模型或阶段变化检测,比固定滑动平均更合理。