笔记日期: 2026-09-01 阅读论文: RRC: Unlocking Generative Reward Models in LLM Reinforcement Learning via Ranking-Based Reward Construction 论文作者: Chenglong Wang, Ziming Zhu, Yifu Huo, Bei Li, Qiaozhi He, Yan Ding, Xiaoyang Hao, Yuxin Gao, Tianhua Zhou, Xiaojia Chang, Tongran Liu, Jingbo Zhu, Zhengtao Yu, Tong Xiao(东北大学 / 小牛翻译 NiuTrans Research / 中科院心理所 / 昆明理工大学) arXiv: 2608.06310 状态: arXiv 预印本,2026 年 8 月 6 日提交
1. 这篇论文到底想解决什么问题
做过 RLHF 或 RLVR 的人都知道,整条 RL 训练流水线离不开一个奖励信号。很长一段时间里,这个信号来自判别式奖励模型(Discriminative Reward Model,DRM):拿一个预训练 LLM 骨架,把输出头换成一个线性投影层,直接吐出一个标量分数。简单、快、久经考验——但代价是几乎完全放弃了骨架模型「用自然语言生成、推理」的能力。
**生成式奖励模型(Generative Reward Model,GRM)**想把这个能力保留下来。给它一对候选回答,让它”写”出一段判断——可以带显式的思维链(CoT)——再给出最终结论(哪个更好)。在纯粹的两两排序榜(RM-Bench、JudgeBench)上,GRM 的优势非常明显:论文里同一骨架、同一训练数据训出来的 GRM,比 DRM 在 RM-Bench 上高 7.5%,在 JudgeBench 上高 4.2%。GRM 在”判卷”这件事上,实打实地更强。
于是论文开篇就抛出一个矛盾:既然 GRM 判得这么准,为什么把 DRM 换成 GRM 塞进 RL 循环(GRPO、PPO、DAPO……)之后,训出来的策略模型质量提升却很有限——有时候几乎在噪声范围内?论文自己复现了这个现象(论文 Figure 1(b)):用 GRM 做 RL 相比用 DRM 做 RL,在 AlpacaEval2 上只领先 1.3%,跟排序侧的优势完全不成比例。
论文给出的诊断不是”训练配方需要微调”,而是架构层面的错配:现有 RL 算法(GRPO 等)需要每个采样回答对应一个标量奖励,而从 GRM 里提取标量的常规做法,从根本上就跟 GRM 真正擅长的事情不匹配。常见做法(GenRM、GRAM 等前作用的方式)是给 GRM 一个参考回答 ,和候选回答 一起塞进判卷 prompt,读出模型给” 更优”这个偏好 token 分配的 softmax 概率,把这个概率当作标定好的标量奖励来用。论文指出这种构造方式有两个具体问题:
- CoT 会导致概率坍缩。 一旦允许 GRM 先推理再给结论,它最终偏好 token 的概率往往会饱和到接近 0 或 1(论文附录 Table 6 直接测量了这一点:88.3% 的样本落在极端区间 ,只有 11.7% 落在有信息量的中间区间)。一个近乎二元的奖励,根本无法区分”略好一点”和”好很多”。
- 置信度不等于偏好强度。 即便概率没有饱和,它反映的是模型对自己判断的信心,跟两个回答之间真正的质量差是两件不同的事,甚至可能就是纯噪声。
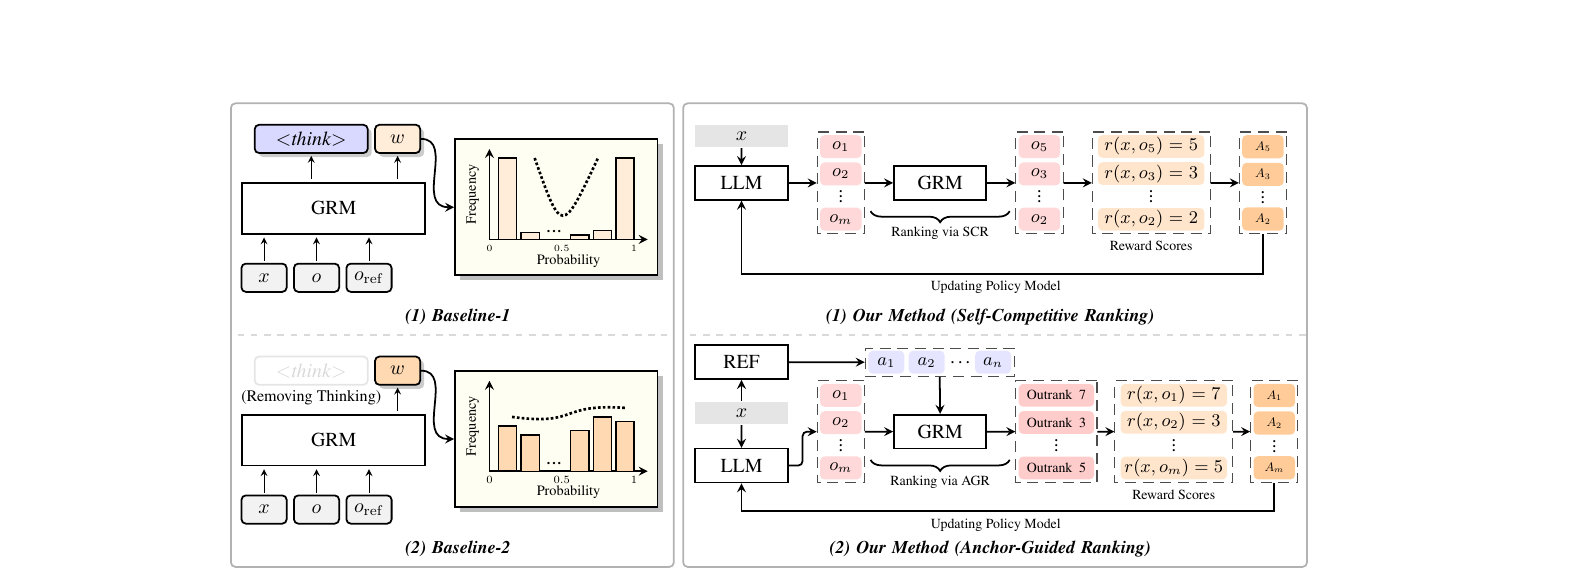
RRC 给出的修复方式说起来很直接:干脆不让 GRM 输出标量分数。 只让它做力所能及的事——两两比较判断——然后从大量这样的比较里(通过胜场计数和排序聚合)事后构造出 RL 需要的标量奖励,而不是从模型自身不确定性的单一读数里去凑一个数字。
2. 前置知识
2.1 奖励模型:判别式 vs 生成式,讲细一点
奖励模型是一个函数 ,给定输入 和回答 ,输出一个分数。目前生产环境里实际用的架构分两大类。
判别式奖励模型。 基于 Transformer 骨架(可以是纯编码器,或者去掉 softmax 输出头的解码器)。把拼接后的 序列的最后一层隐状态映射到一个标量。训练用经典的 Bradley-Terry 模型(Bradley & Terry, 1952):
其中 是偏好数据集,含标注了 的三元组, 是逻辑斯蒂函数。直觉上,这个损失把两个标量分数的差推过 sigmoid,要求这个差能预测偏好——跟成对比较上的逻辑回归几乎一模一样。训练好之后, 可以对任意单个回答直接调用得到一个数;这个数天生被设计成”跨不同回答对之间可比”,因为训练损失只见过相对差,模型必须学出一个全局一致的标度。
生成式奖励模型。 不用标量头,而是直接用 LLM 自身的生成能力。给定一段自然语言指令 描述判卷任务,以及三元组 ,GRM 预测一个偏好 token 指出哪个回答更好,可以在此之前先写一段自由文本思维链。训练用标准的下一 token 交叉熵:
是真实偏好标签。注意跟公式 (1) 的关键结构性差异:GRM 的训练信号永远只在成对条件下出现——它从来没见过单个回答被单独打分,也从来没学会给一个回答赋一个绝对数字。它会做的一切都是比较性的。这正是全文论证的根基,值得停下来体会:GRM 的”词汇表”字面意思就是”A 或 B”,不是”一个自身就有意义的 0 到 1 之间的数”。
2.2 RL 是怎么消耗奖励的
RLHF/RLVR 的策略优化目标是
PPO(Schulman et al., 2017)用一个学习出来的 critic 估计优势,但 critic 本身昂贵且容易训练不稳。GRPO(Shao et al., 2024)——DeepSeekMath、DeepSeek-R1 这类训练背后的主力算法,也是 RRC 接入的算法——完全去掉了 critic。它对同一 prompt 采样一组 个回答 ,把每个回答的优势定义为组内归一化奖励:
这是理解全文后续内容的关键细节:GRPO 需要每个采样回答都有一个标量 ,好去算组内均值和标准差。DRM 天生就能免费提供这个东西——它的训练目标就是让它输出这个数。GRM 从来没被训练成要输出一个数;必须有人硬凑一个出来。
2.3 现有(有缺陷)的桥接方式:基于概率的奖励构造
强行让 GRM 承担这个角色的标准做法:选一个参考回答 (通常是当前策略贪心解码 的结果),把 拼成一个判卷 prompt ,定义
即模型预测候选回答 (在 prompt 里标记为”Response A”)比参考回答更优的概率。这正是 GenRM(Zhang et al., 2024)用的机制,也隐含被 GRAM(Wang et al., 2025b)引用。听起来是个合理的取巧办法——确实产出了一个 里的数——但它悄悄塞进了一个 GRM 训练过程从未真正保证过的假设:这个概率的行为就像一个标定良好、跨回答可比的标量分数。论文第三节(以及后面的 Figure 1 和 Table 6)系统性地展示了这个假设是站不住的。
3. 诊断实验:排序能力 vs 打分能力(论文第 3 节)
在提出修复方案之前,作者先做了一个受控对照实验。用同一个骨架 LLaMA-3.2-3B-Instruct、同一份偏好数据 HelpSteer3(4.05 万条带人工撰写理由的样本,理由被用作 GRM 的 CoT 监督)训练一个 DRM 和一个 GRM。然后在两种截然不同的设定下评估:
- 两两排序:RM-Bench、JudgeBench——标准的成对判卷准确率榜。
- RL:用预测偏好 token 概率(公式 5)构造奖励,接入 GRPO,在 AlpacaEval2 上跟踪训练步数曲线。
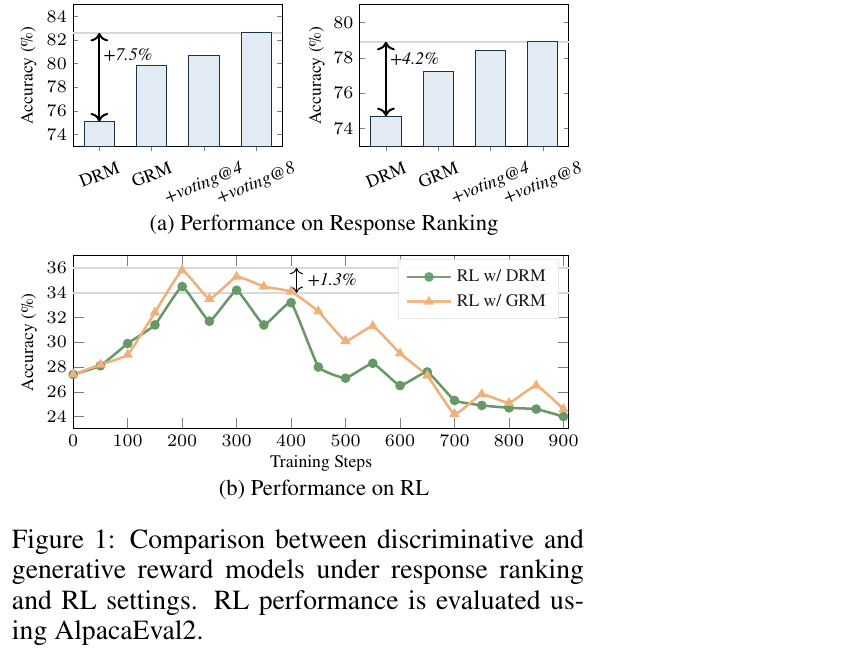
结果就是全文核心矛盾的浓缩版:在排序任务上,GRM 把 DRM 甩得很远(RM-Bench +7.5%,JudgeBench +4.2%,加上多数投票之后差距还会更大)。但同一个 GRM 用基于概率的方式接入 RL 之后,它相对 DRM 的优势坍缩到只剩 1.3%(AlpacaEval2)——而且注意图 1(b) 里这个差距根本不是单调的,RL-w/-GRM 和 RL-w/-DRM 曲线反复交叉,两条曲线在第 400 步左右之后都大幅退化,论文没有细谈这一点,但这本身就是一个信号:基于概率的奖励是很嘈杂的学习目标。
这背后的机制是什么。 回到公式 (5)。GRM 被要求给单个成对比较 输出一个概率 。这里会出两个问题:
- 如果 GRM 显式推理(先写 CoT 再定结论),论文观察到最终偏好 token 的概率倾向于饱和:一旦 CoT “说服自己”得出了结论, 上的 softmax 就会坍缩到接近 0 或 1,几乎跟两个回答实际有多接近无关。一个近乎确定性的 0.97 对 0.99,一旦在 GRPO 组内归一化之后,跟 0.97 对 0.60 携带的梯度信息几乎一样——顺序保住了,幅度被抹掉了。
- 即便没饱和,这个概率反映的是判断本身的置信度,不是潜在的质量差。GRM 可能对一个真实很大的质量差只有 60% 的信心(如果这个比较的论证本身不好表达),也可能对一个很小的质量差有 95% 的信心(如果一个回答存在明显表面缺陷)。把置信度当质量用,是一种范畴错误。
这两点正好对应论文接下来要提出的两个硬性要求(第 4.1 节,下面正式展开)。
4. 奖励构造需要满足的两个性质(第 4.1 节)
论文提出任何一个能用于 RL 的奖励函数 都需要满足两个性质——值得精确记住,因为 RRC 全部设计都是围绕机械地满足这两点展开的。
性质 1(序保持,Order Preservation)。 对同一输入 下采样的任意两个回答 :。
这是较弱的性质——只是说奖励函数不该反转真实偏好顺序。几乎任何理智的奖励构造方式都能轻松满足。
性质 2(幅度感知,Margin Awareness)。 奖励差要跟潜在的 oracle 偏好幅度成比例:
其中 是一个不可观测的”oracle”质量函数,代表真实的偏好强度。这正是基于概率的构造方式违反的性质:当概率饱和时,两个截然不同的质量差会映射到同一个(饱和的)概率差,破坏了这个比例关系,即便顺序还保留着。
4.1 为什么幅度感知很重要:一个完整的策略梯度论证(对应论文附录 A 的完整推导)
这一点在正文里只是提了一句,但在附录 A 里有严谨证明——我觉得值得完整走一遍,因为这才是论文真正的理论核心,很多读者可能会一眼扫过”我们证明这对 RL 很重要”而没意识到为什么。
先用 oracle 质量函数直接定义理想 RL 目标:
由策略梯度定理,
实际中,GRPO 类算法用一组采样 和公式 (4) 里的组归一化优势来估计这个梯度。忽略 PPO 式裁剪,得到的更新方向是
第一步——设定仿射变换假设。 假设实践中用的奖励函数 是 oracle 质量的一个仿射(线性加偏移)变换,对固定的 :
这是我们能希望 相对 “做对了事”的最弱条件——它说 保留了质量差的相对大小(差一个正的缩放和一个平移),这正是幅度感知(公式 6,比例系数为 )要求的内容。
第二步——证明组归一化会精确抵消这些仿射干扰项。 为 oracle 质量定义对应的组统计量:,,。在仿射假设(公式 10)下:
代回公式 (4) 的组归一化优势:
这就是整段推导的核心: 偏移量 和正缩放 在组归一化下精确抵消。换句话说,只要仿射映射是”忠实”的(即公式 2 里的比例系数 对所有回答是一个常数,不随回答变化),GRPO 的归一化优势对奖励的任意仿射变换都是不变的。
第三步——结论:忠实仿射的奖励能精确复原 oracle 梯度。 把 代回更新方向(公式 9):
这恰好就是 oracle 策略梯度(公式 8)的组归一化估计量。实践中用的奖励函数 ,尽管本身是 的一个未知仿射变换,却诱导出与直接拥有真实 oracle 质量时完全相同的 RL 更新。
第四步——幅度感知失效会发生什么。 反过来看这个结论才更有实用价值:如果 不是对 忠实仿射的——比如基于概率的构造在 边界附近饱和——那么诱导出的 在每个组内都不会等于 ,策略梯度各项之间的相对权重会系统性地偏离 oracle 梯度本应赋予的权重。具体来说:一个在两端被压缩(饱和)的基于概率的奖励,会低估那些真实质量差很大的回答对的更新权重(因为它们观测到的奖励差在饱和之后被人为压小了),也可能高估那些真实质量差很小、恰好落在概率区间中段未饱和区域的回答对。这是一种严格意义上”RL 信号被系统性扭曲”的说法,不只是”变噪声了”——这种扭曲有明确的方向,而且这个方向跟论文自己的诊断实验(Figure 1b)观察到的现象是一致的。
设计取舍备注: 这个推导只要求 对固定 prompt 是 的仿射函数,且 不随回答变化——它不要求 在不同 prompt 之间是仿射的,也不要求知道 的绝对量级。这是一个刻意设定得很弱、很容易达到的要求,也正是 RRC 排序式构造要瞄准的目标(下面第 5 节会展示),而基于概率的构造之所以失败,是因为饱和使得有效的""变得隐式地依赖回答本身(在概率区间的边界附近,它会收缩到零)。
5. RRC:基于排序的奖励构造(第 4.2 节)
RRC 的核心动作:完全不向 GRM 索要概率。只向它索要成对偏好判断——” 比 好,是或不是”——然后通过统计胜场数,把大量这样的判断汇聚成标量奖励。它有两种变体,在比较结构与代价之间做权衡。
5.1 自我竞争排序(Self-Competitive Ranking, SCR)
一句话概括: 把同一个 prompt 下采样的 个回答视为互相竞争的选手,跑完所有 对两两比较,用每个回答的胜场数打分。
对采样组内的每一对 ,向 GRM 查询一个偏好关系:
这些两两判断构成一张锦标赛图(一个完全有向图,边从赢家指向输家)。回答 的奖励就是它的胜场数,乘一个缩放常数 :
为什么胜场计数能同时满足两个性质。 序保持(性质 1)是显然的:一个真的比更多竞争者强的回答,只要成对判卷本身是序保持的(一个训练良好的 GRM 应该在期望意义上做到这点),就会赢更多的比较,得到严格更高的胜场数。幅度感知(性质 2)是更有意思的说法,论文直接给出了证明:
这是 相对 、在剩余组内的净胜场差。直觉上,如果 明显比 强,它会倾向于打败那些 会输给的对手——拉大胜场差。如果 和 质量接近,它们对剩余组内的胜场也会接近。关键是,这个幅度信息的产生完全不需要 GRM 去内省自己有多确信——它是从许多独立的二元决策里聚合出来的,正好对应 GRM 训练目标(公式 2)真正在优化的能力。
复杂度。 SCR 需要跑全部 对成对查询(论文正文里松散地写作 ,但精确的计数其实是二次的 ;这个记号上的不严谨在下面的批判性分析里会展开)。
5.2 多数投票稳定排序
一次成对查询是一次随机采样——特别是涉及显式 CoT 推理时,同样的输入重复查询,模型的思维链可能会走向不同的结论。RRC 用多数投票来稳定这一点:对每一对 ,独立查询 GRM 次,取多数票的赢家作为最终偏好。这是用额外的推理时计算(论文明确把它类比为测试时扩展,跟 Muennighoff 等人的 s1 是同一种思路)换取更低方差的成对判断。
5.3 冲突感知排序调整(CARA)——Kemeny 规则聚合
独立查询得到的成对偏好不保证全局一致,可能出现循环不一致:
这违反了传递性——一个存在环的偏好图,是无法压成一个单一全序(排序)的。RRC 用一种基于 Kemeny 规则的聚合来解决这个问题——这是社会选择理论里把不一致的两两投票转化为”最小错误”一致排序的经典工具。
性质 3(论文附录 A 中给出证明,这里完整走一遍)。 给定不一致的成对偏好,及其支持权重 (比如多数投票中支持 的票数),Kemeny 规则聚合能恢复出一个全局一致的全序,使其与所有成对偏好的加权一致度最大化。
证明思路。 把回答集合建模成一张加权有向图 ,,对每个观测到的偏好 ,画一条权重 的有向边 。一个全序 如果把 排在 前面,就说它跟边 “一致”。定义 的加权一致度和不一致度:
因为对任意无序对 ,在一个全序下 或 恰好只有一个成立,且每一对无论 怎么排都固定贡献 :
于是 :最大化一致度和最小化不一致度是完全同一个优化问题。这正是经典 Kemeny 最优聚合目标的加权版本——最小化成对不一致的总权重,等价于寻找一个最小权重反馈边集,去掉它就能让图变成无环图。因为最优解 本身就是一个全序,它天然就是传递一致的(如果 且 ,则必然 ),证明到此完成。
实际算法。 精确 Kemeny 聚合一般是 NP 难问题,所以 RRC 用 Davenport & Kalagnanam (2004) 的贪心启发式:反复挑选权重失衡程度 最大的未决对,按多数方向固定其顺序,并通过传递闭包传播维持无环性(即拒绝任何会跟已固定关系形成环的新关系)。CARA 处理之后每个回答的最终奖励,就是它在结果全序 中的位置换算成的胜场数:
5.4 SCR 完整算法:编号伪代码
论文的算法 1(我如实还原,并稍微展开了几步以便理解):
算法 1:带多数投票和 CARA 的自我竞争排序(SCR)
输入:prompt x;回答集合 O = {o_1, ..., o_m};生成式奖励模型 GRM;
      投票预算 V;缩放系数 alpha;是否启用 CARA 的标志位 use_CARA
输出:奖励 {r(x, o_i)}_{i=1}^m;总序 pi

 1: 初始化 w[i][j] <- 0,对所有 i != j
 2: 对每个满足 i < j 的无序对 {i, j}:
 3:     c_ij <- 0   // 支持 o_i > o_j 的票数
 4:     c_ji <- 0   // 支持 o_j > o_i 的票数
 5:     对 t = 1 到 V:
 6:         向 GRM 查询 (x, o_i, o_j) -> 得到一个偏好
 7:         若 o_i > o_j:c_ij <- c_ij + 1
 8:         否则:       c_ji <- c_ji + 1
 9:     若 c_ij >= c_ji:
10:         w[i][j] <- c_ij ; w[j][i] <- c_ji
11:     否则:
12:         w[j][i] <- c_ji ; w[i][j] <- c_ij
13: 若 use_CARA:
14:     初始化偏序 Omega <- 空集
15:     只要存在未决对 (i, j):
16:         选取使 |w[i][j] - w[j][i]| 最大的 (i, j)
17:         若 w[i][j] >= w[j][i]:把关系 "i 在 j 之前" 加入 Omega
18:         否则:                把关系 "j 在 i 之前" 加入 Omega
19:         执行传递闭包;丢弃任何会形成环的新关系
20:     pi <- 对 Omega 做拓扑排序
21: 否则:
22:     pi <- 按胜场数 sum_j 1[w[i][j] > w[j][i]] 降序排序
23: 对每个 o_i in O:
24:     r(x, o_i) <- alpha * |{o_j != o_i : i 在 pi 中排在 j 之前}|
25: 返回 {r(x, o_i)}_{i=1}^m, pi
用文字复述一下:第 2-12 行穷举每一对,把 次随机投票聚合成一个多数决定的有向权重。第 13-20 行是可选的 CARA 步骤——先固定权重失衡最大(也就是”最有信心”)的对,逐步贪心解决冲突,并拒绝任何会跟已固定关系形成环的新关系。第 22-24 行把最终得到的排序(CARA 的拓扑序,或者退化情形下的简单胜场数)转换成最终标量奖励。
5.5 锚点引导排序(Anchor-Guided Ranking, AGR)
当采样组大小 增大时,SCR 的 查询代价会变得难以承受——而现代 RL 配方恰恰喜欢更大的 ,因为这有利于探索和梯度估计的稳定性。AGR 的解法是用一个小而固定的锚点回答集合替代全对比较。
给定一个由参考策略 (不是当前策略——这个区分很重要,见下面 5.6 节)生成的、规模较小的锚点集 (实践中 ),把每个采样回答 跟所有锚点比较:
幅度感知的论证跟 SCR(公式 17)结构上完全一样,只是把”剩余组”换成了锚点集:
如果 稳定地赢过那些 输给的锚点,奖励差就会拉大——这次衡量的是”比一个共同、固定的标尺好多少”,而不是”比当前的竞争队友好多少”。
5.6 AGR 完整算法:编号伪代码
算法 2:带多数投票的锚点引导排序(AGR)
输入:prompt x;回答集合 O = {o_1, ..., o_m};锚点集 A = {a_1, ..., a_n};
      GRM;投票预算 V;缩放系数 alpha
输出:奖励 {r(x, o_i)}_{i=1}^m

 1: 对每个回答 o_i in O:
 2:     s_i <- 0
 3:     对每个锚点 a_k in A:
 4:         c_ik <- 0   // 支持 o_i > a_k 的票数
 5:         c_ki <- 0   // 支持 a_k > o_i 的票数
 6:         对 t = 1 到 V:
 7:             向 GRM 查询 (x, o_i, a_k) -> 得到一个偏好
 8:             若 o_i > a_k:c_ik <- c_ik + 1
 9:             否则:       c_ki <- c_ki + 1
10:         若 c_ik >= c_ki:
11:             s_i <- s_i + 1
12:     r(x, o_i) <- alpha * s_i
13: 按 r(x, o_i) 降序排列所有回答
14: 返回 {r(x, o_i)}_{i=1}^m
5.7 设计取舍:为什么用参考策略生成的锚点,而不用当前策略的锚点?(性质 3 的完整推导)
这可能是全文最微妙的设计决策,也是附录 A 里专门证明的一点。一个自然而然的替代方案是从当前策略 (比如同一组采样里挑一部分)直接采样锚点。RRC 刻意拒绝了这个做法,选择用一个固定的、与被训练参数无关的参考策略 来生成锚点。
为什么这在机制上很重要。 把 AGR 下、采样自 的奖励写出来,明确标出锚点生成分布对 的依赖关系:
RL 目标对 的完整梯度,必须同时考虑 如何影响采样回答的分布,以及——如果锚点也依赖 —— 如何影响用来给这些回答打分的锚点:
情形 A——同策略锚点()。 第二项非零:
每一次策略更新都同时在做两件事:(1)把概率质量向更好的回答 上转移,并且(2)改进了用作比较基线的锚点集,因为锚点本身就是从正在改进的策略里采样出来的。这正好制造出一个移动目标问题: 更强的锚点 偏移的奖励 会因为跟策略实际质量无关的原因而改变。这违反了让随机梯度上升良好运作所依赖的平稳性假设,也会放大梯度方差。
情形 B——参考策略锚点(,与 无关)。 此时 恒成立,梯度收缩为只剩策略改进项:
策略更新现在只影响哪些候选回答会被采样;作为评估基线的锚点在整个训练过程中保持不变。优化目标不再随训练漂移,满足随机优化的标准平稳性假设。
替代方案及其边界。 显而易见的替代方案——用当前策略的锚点——之所以有吸引力,是因为锚点能自动”跟上”策略当前的能力,可以想象一旦策略已经大幅提升之后,这样能改善区分度(一旦策略远远超过陈旧的参考策略锚点,比较陈旧的锚点就会变得没有信息量)。论文没有定量探讨这个失效模式,但这正是它的自然边界条件:参考策略锚点很稳定,但训练后期可能变得太容易打败,此时对大多数采样回答 ,奖励信号会从另一个方向饱和(人人都能打败陈旧锚点,区分度就没了)。周期性刷新参考策略(一种迭代式/自博弈式的锚点更新)是自然的缓解方案,但正文里没有讨论。
5.8 SCR vs AGR:结构对比(还原论文 Table 3)
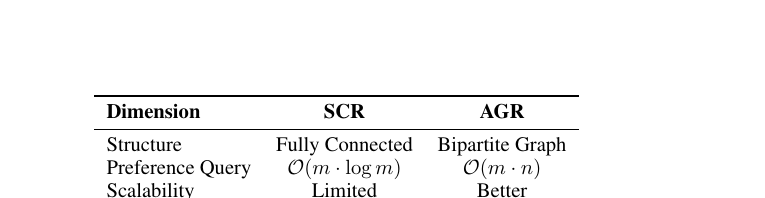
| 维度 | SCR | AGR |
|---|---|---|
| 比较结构 | 全连接锦标赛图 | 双部图(回答 vs 锚点) |
| 偏好查询次数 | ||
| 可扩展性(大 时) | 有限(二次增长) | 更好(对固定 ,随 线性增长) |
查询代价推导。 精确的查询次数是 ,。两者之差:
只要 ,这个差就是正的——实践中这是常见情形(论文里锚点数 ,采样组大小 或 ,所以只要 就很容易满足;即便在 时,,说明在这个特定的小规模下 AGR 反而每对比较更贵,但把锚点集是”预先算好一次、跨所有 prompt 和所有训练步复用”这个事实算进去之后,AGR 的整体效率优势就体现出来了,而 SCR 的比较是 prompt 特定的,每一步都要重新做)。忽略常数因子,这个差距在 时的量级是 ——这是”AGR 随采样预算 增大而扩展性更好”这句话的正式表达。
6. 实验
6.1 实验设置
骨架模型。 奖励模型:LLaMA-3.2-3B-Instruct 和 LLaMA-3.1-8B-Instruct。策略模型:主表用 LLaMA-3.1-8B-Instruct,另外用 Qwen2.5-7B-Instruct(论文 Table 2)交叉验证骨架泛化性。
数据。 奖励模型训练:HelpSteer3(4.05 万条带人工理由的标注样本,理由被用作 GRM 的 CoT 监督;DRM 只拿到二元标签,保证对照公平)。RL 训练:6K 条 SFT 数据,7.5K 条 RL 数据,沿用 Bhaskar 等人(2025)的设置。
RL 算法。 GRPO,学习率 ,batch size 128。主表里组采样大小 ,锚点集大小 。训练了两种策略变体:显式 CoT(“w/ Thinking”)和不带 CoT(“w/o Thinking”)。
评估。 开放式对话:AlpacaEval2(相对 GPT-4-1106-preview 参考答案的长度控制胜率,用 GPT-4o 判卷,另用 GPT-5 做复核)、ArenaHardV2(500 个真实世界高难度问题,同样的评测协议)、WildBench(1024 条 prompt,逐点 0-100 打分)。推理/知识:MMLU-Redux、MATH-500,用 evalscope 自动评测。
基线。 PRC(基于概率的奖励构造,公式 5),及去掉显式思考以缓解饱和的”Removing Thinking”变体;DRM;同样数据训练的离线偏好优化基线 DPO 和 SimPO。
6.2 主结果(还原论文 Table 1)
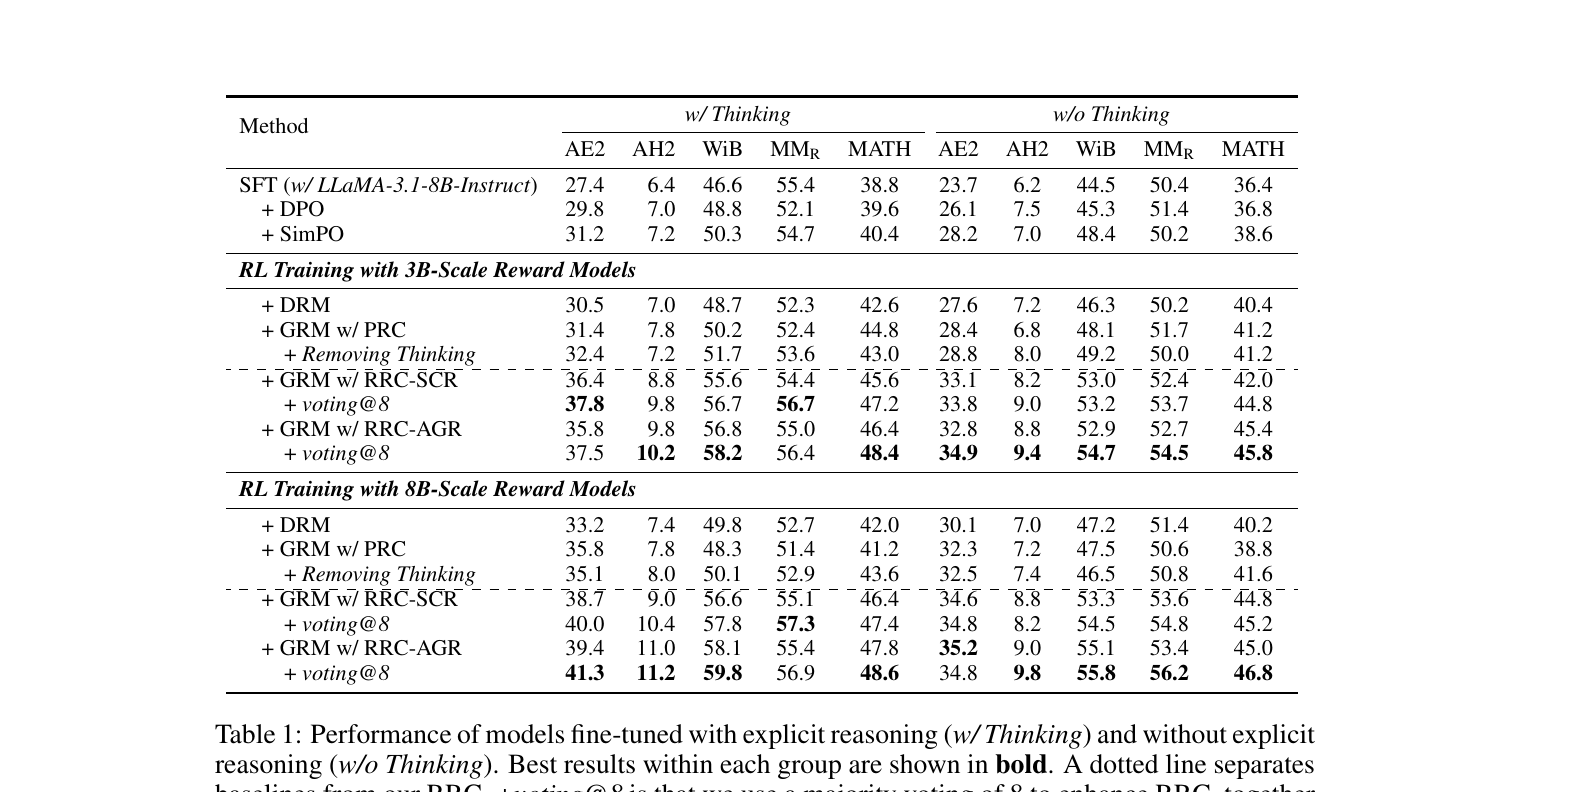
摘取最重要的一组:8B 规模奖励模型、带思考、AlpacaEval2:
| 方法 | AE2 |
|---|---|
| DRM | 33.2 |
| GRM w/ PRC | 35.8 |
| GRM w/ PRC + Removing Thinking | 35.1 |
| GRM w/ RRC-SCR | 38.7 |
| GRM w/ RRC-SCR + voting@8 | 40.0 |
| GRM w/ RRC-AGR | 39.4 |
| GRM w/ RRC-AGR + voting@8 | 41.3 |
三个值得单独拎出来讲的观察:
- PRC 相比 DRM 优势很小(35.8 对 33.2),跟第 3 节的诊断实验一致——基于概率的构造方式浪费了 GRM 大部分的排序优势。
- RRC 在几乎所有榜、所有规模(3B/8B)、所有思考模式下,相对 DRM 的提升幅度大约是 PRC 的两倍以上。
- 在这个规模上,多数投票几乎是免费的午餐:voting@8 对每个 RRC 变体都有提升,Table 1 里没看出明显代价(代价体现在 Table 4 的训练时间里)。
Qwen2.5-7B-Instruct 交叉验证(论文 Table 2,这里不单独还原为图)显示了同样的顺序和大致相同幅度的收益,这是论文用来说明这不是 LLaMA 特有的现象的证据。
6.3 RRC 的扩展行为(第 6.1 节,Figure 3)
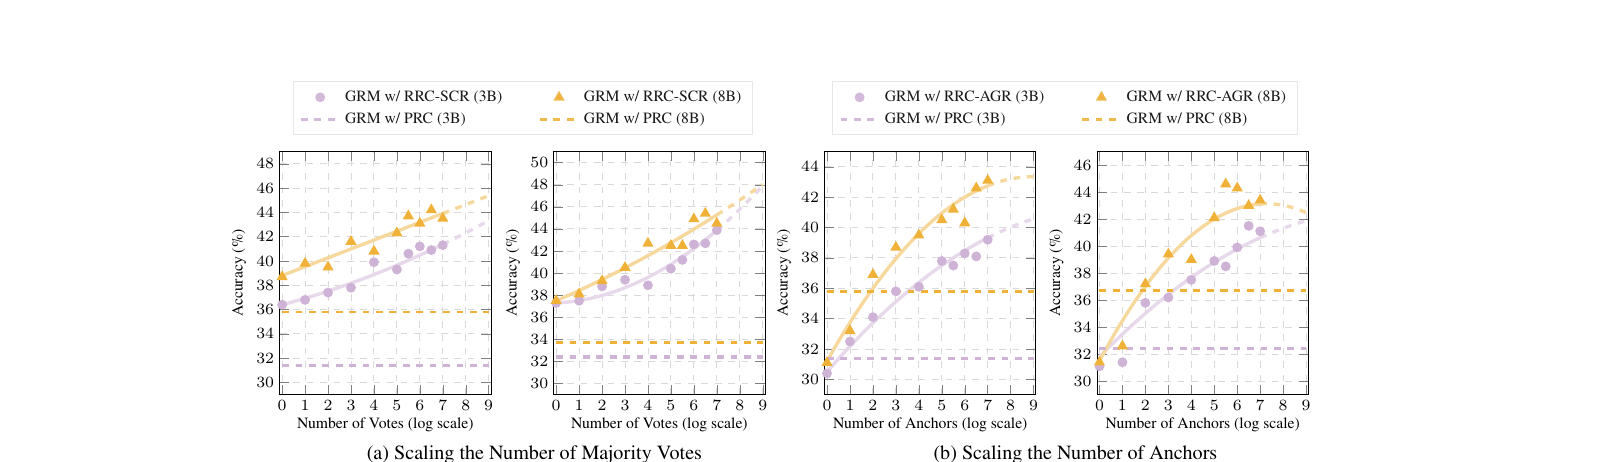
两条形状很干净的类似标度律曲线:准确率随投票次数(a)和随锚点数量(b)单调上升,随着两个预算变量继续增大,收益递减的现象都很明显——标度律的典型特征(论文明确引用 Kaplan 等人 2020 年的框架)。一个具体且实用的发现:相对小的锚点数量(8-16)就已经能拿到大部分可获得的收益;推到 256 个锚点甚至出现轻微退化,论文把这归因为多样性问题——在非常大的锚点采样规模下,很难维持足够多样的锚点回答,导致很多锚点变成冗余、低信息量的重复,而不是提供新的比较信息。
6.4 消融实验(对应论文 Figure 4 的 和 CARA 消融)
对缩放因子 的敏感性。 在 范围内扫描,性能在 区间内保持平稳,超过 之后逐渐退化。论文给出的机制解释(跟第 4.1 节的推导直接对应):GRPO 的组归一化(公式 4)理论上对奖励的任意正仿射缩放都是不变的,所以温和地改变 理论上根本不该有影响——但一旦 大到跟数值裁剪/其他 RL 稳定化手段(论文没有细讲具体是哪些)产生交互,噪声就会被放大,训练就不稳。这是一个理论(第 4.1 节公式 13 的精确不变性)某种程度上理想化了的例子,而实证消融很诚实地展示了这个理想化在哪里失效。
CARA 的贡献。 去掉冲突感知排序调整会在 AlpacaEval2 上损失 0.6-1.9%,在 MMLU-Redux 上损失 1.3-1.5%,在 3B 和 8B 两个骨架上都一致。幅度不大但稳定——生成式奖励模型给出的成对判断中的循环不一致确实存在,用 Kemeny 规则聚合解决它可以带来可衡量的收益,尽管这不是主导性的杠杆(胜场计数本身,也就是 RRC 的核心思想,才是主导杠杆;CARA 只是叠加在上面的一个精细化改进)。
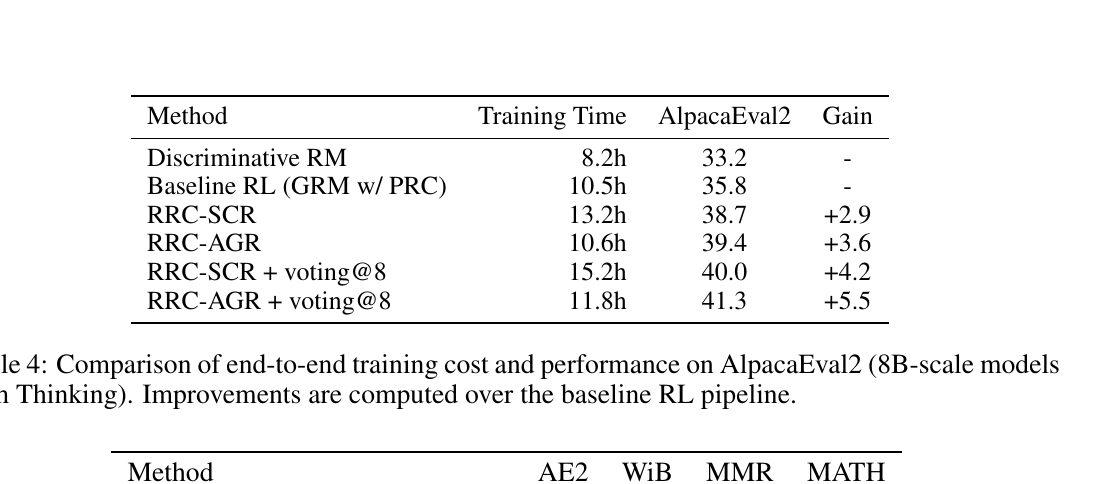
6.5 效率:性能与训练成本的权衡(还原论文 Table 4)
| 方法 | 训练时间 | AlpacaEval2 | 增益 |
|---|---|---|---|
| 判别式奖励模型 | 8.2h | 33.2 | – |
| 基线 RL(GRM w/ PRC) | 10.5h | 35.8 | – |
| RRC-SCR | 13.2h | 38.7 | +2.9 |
| RRC-AGR | 10.6h | 39.4 | +3.6 |
| RRC-SCR + voting@8 | 15.2h | 40.0 | +4.2 |
| RRC-AGR + voting@8 | 11.8h | 41.3 | +5.5 |
对实践者来说,这张表比 Table 1 更重要:AGR 拿到了比 SCR 更大的准确率增益,几乎没有额外训练时间开销(相对 PRC 基线 10.6h vs 10.5h),因为锚点集是预先算一次(论文里报告用 16 张 GPU 约 1 小时)然后在整个训练过程中复用,而不像 SCR 那样每一步都要重新做成对比较。SCR 单位算力的准确率增益是真实存在的,但确实带来了明显的时间成本(13.2h,比基线增加 26%)。读这张表的字里行间,论文自己的建议其实相当清楚:“除非有特殊理由,否则默认用 AGR”。
6.6 相对更强 PRC 基线的算力对齐对比(还原论文 Table 5)
对 Table 1 里的头条数字,一个自然的质疑是:也许 RRC 赢只是因为多数投票给了它比普通 PRC更多的推理时算力,跟排序-vs-打分的核心思想本身没关系。论文直接构造了一个算力对齐的 PRC 变体来控制这个变量:不再对离散的 A/B 标签做多数投票,而是对多次带 CoT 的 GRM 查询给出的连续偏好概率求平均(称为”软聚合”),使用跟 RRC 相同数量的 GRM 调用次数。
| 方法 | AE2 | WiB | MMR | MATH |
|---|---|---|---|---|
| GRM w/ PRC + 多数投票 | 32.8 | 52.1 | 52.8 | 45.2 |
| GRM w/ PRC + 软聚合 | 30.1 | 51.4 | 48.2 | 44.8 |
| GRM w/ RRC-SCR | 36.4 | 55.6 | 54.4 | 45.6 |
| GRM w/ RRC-AGR | 35.8 | 56.8 | 55.0 | 46.4 |
软聚合没能稳定超过普通的多数投票 PRC(在这里 4 个榜里 3 个反而更差),两个 PRC 变体都明显落后于 RRC,尽管调用 GRM 的次数完全对齐。这是一条很干净的证据,说明收益不只是”更多测试时算力”——具体来自于比较信号是怎么聚合的(结构化、序保持的胜场计数,vs 独立的成对概率平均——后者即便做了平均,仍然继承了底层概率信号的饱和/置信度混淆问题)。
6.7 定性观察:RRC 具体改变了输出的什么(论文 Table 7-8)
论文给出了两个完整的定性对照案例(一个摇滚歌词创作任务,一个网页代码生成任务),展示 RRC 训出来的策略(分别用 SCR 和 AGR)比 PRC 基线更忠实地遵守 prompt 里的具体约束(第一个案例是韵律格式 + 要避开的陈词滥调词表;第二个案例是精确的按钮 hover 过渡 CSS 行为),而 PRC 基线倾向于产出更泛化、更陈词滥调、或者只部分符合要求的输出。这只是单个示例式的展示而不是系统性证据,但它是一个有用的合理性检验,说明汇总的基准测试数字对应着真实的、能定性观察到的行为差异,而不是某种针对榜刷分的假象。
7. 系统梳理设计取舍:为什么这样做 / 明显的替代方案 / 边界在哪
把上面散落的讨论汇总成一张表,这是论文五个影响最大的设计决策,各附上它隐含拒绝的替代方案,以及可能失效的边界条件:
| 设计选择 | 为什么这么做 | 显而易见的替代方案 | 可能失效的边界 |
|---|---|---|---|
| 用胜场计数代替概率作为奖励 | GRM 被训练成做比较判断,不是给出标定好的标量预测(公式 2 对比公式 1);胜场计数天然满足序保持和幅度感知(第 5.1 节) | 保留基于概率的构造,尝试去饱和(例如对 logits 做温度缩放) | 如果底层的成对判卷本身就弱/噪声大,胜场计数会放大而不是纠正这种噪声,除非配合投票/CARA |
| AGR 用参考策略锚点 | 从策略梯度中去掉了移动目标/基线漂移项(公式 25-27),得到一个平稳的优化目标 | 用同策略锚点,能自动跟随当前策略能力 | 训练后期参考锚点会变得”太容易”, 饱和;需要周期性刷新(论文没探讨) |
| CARA / Kemeny 规则聚合 | 成对 GRM 判断不保证传递性;Kemeny 聚合是有干净证明的原则性解法(一致度最大化即不一致度最小化,公式 19-20) | 忽略环,直接用简单胜场数求和(RRC 自身的非 CARA 退化选项) | 精确 Kemeny 是 NP 难的;贪心启发式(Davenport & Kalagnanam, 2004)不保证最优,只是实证效果好 |
| 对单次查询做多数投票 | 单次 GRM 判断是随机的,尤其带 CoT 时;投票降低判断方差(第 5.2 节) | 单次确定性(温度为 0)查询 | 收益递减,且确实增加推理成本(Table 4);只能修方差,不能修系统性偏差 |
| 用 AGR 作为默认推荐(从 Table 4 隐含得出) | 相对 PRC 基线几乎零训练时间开销,锚点算好之后准确率相当或更好 | SCR,能拿到略大的原始准确率增益(Table 5),但训练成本更高 | 当算力/时间不是硬约束,或者采样组本身携带的信息量是锚点替代不了的(任务特定的、上下文内竞争动态) |
8. 局限性
论文自己对局限性的讨论比较薄(大多隐含在消融实验里,而不是专门写一节),下面是从数据本身能读出来的内容:
- 大规模锚点时的多样性退化(第 6.3 节):锚点数很大(256)时性能会饱和、甚至轻微退化,论文归因于冗余,但没有做机制层面的诊断或缓解。
- 敏感性超出测试范围(第 6.4 节):理论(第 4.1 节)预测在仿射变换下应该精确不变,但实证消融显示 时确实会退化,论文只笼统归因为”放大噪声”,没有钉死具体机制(跟 GRPO 裁剪的交互?跟优化器数值稳定性的交互?)。
- 参考策略的陈旧问题没有被处理:如上面第 5.7 节/表格所讨论的,AGR 的稳定性保证(性质 3)是以锚点不随策略提升而适应为代价换来的,论文从未测量这个差距在比报告的训练更长的运行里会扩大到什么程度(Table 1 的曲线只跑到约 900 步 GRPO)。
- 仅在开放式对话 + 一小片推理任务上评估:AlpacaEval2/ArenaHardV2/WildBench 都是偏”有用性”的开放式基准,由其他 LLM 判卷;MMLU-Redux 和 MATH-500 是仅有的偏推理的检验,两者都不是真正的长程 agent 或可验证奖励(RLVR)场景——而后者的奖励作弊动态可能截然不同。
- 骨架和规模范围较窄:3B/8B 规模的 GRM,7-8B 规模的策略模型。概率饱和问题(因而 RRC 的收益)在前沿模型规模(70B+ 的 GRM,或从更强判卷者蒸馏出的 GRM)下会持续、恶化还是缩小,都没有测试。
9. 批判性分析
(a) 论文本身的具体弱点和瑕疵
- SCR 查询代价的渐进符号不严谨。 论文正文(第 4.2/5.1 节)陈述 ,但几行之后给出的精确公式,以及附录 C.1 里再次给出的公式,都是 ——真正是二次的,不是 。这不是一个微妙的细节:它直接影响读者该如何理解 SCR 在大组规模下的可扩展性,而论文自己的对比表(Table 3)把 SCR 的可扩展性正确标注为”有限”——跟 而不是 是一致的。这看起来像是早期草稿留下的痕迹(也许早期 SCR 是通过一种真正 的锦标赛/排序网络结构实现的,后来改成全对比较实现,但复杂度声明没有全文同步更新)。
- 仿射忠实性证明(第 4.1 节)里假设了一些没有被完全证实的东西。 附录 A 里干净的推导证明了:如果 精确地是 oracle 质量 的仿射变换(公式 10),GRPO 的梯度就能精确复原。但论文从未真正证明 SCR 或 AGR 的胜场计数奖励(公式 16/22)确实是 的仿射函数——它只展示了较弱意义上的幅度感知(公式 17/23:奖励差跟质量差相关,不是这个映射精确仿射)。这两个说法相关但不等价;胜场计数是一个有界、整数值、会饱和的函数(一旦一个回答赢了/输给了所有对手就饱和),这本身就是论文指责 PRC 的那种饱和问题的一个变体——只是在更粗、更不严重的粒度上(被 或 而不是 所限界)。
- 正文所有表格里没有任何误差条,也没有报告随机种子数量。 Table 1(还有 2、4、5)里的每个数字都是单点估计。已知 GRPO 训练存在明显的跑与跑之间的方差,而报告的一些增量(比如 CARA 在某个基准上的 0.6% 提升)完全可能落在单次种子的合理噪声带内,这实质性地削弱了对较小消融增量的信心(RRC 相对 PRC 的头条差距——3 到 6 个百分点——大概足够大,能撑过种子方差,但更细粒度的对比——SCR vs AGR、有无 CARA、voting@4 vs voting@8——正是读者最想要误差条却完全没有的那些数字)。
- 判卷模型依赖问题没有被压力测试。 RL 奖励信号(正在训练/使用的 GRM)和最终评测(AlpacaEval2/ArenaHardV2 的 GPT-4o/GPT-5 判卷者)都是基于 LLM 的判断。论文没有检查 RRC 的收益是否是训练时 GRM 和评测时判卷者之间相关偏差的产物(比如两者都偏好更长、更结构化、或者措辞更自信的回答)——这是 LLM 判卷式 RLHF 评估领域普遍存在、广为人知的混杂因素,而这篇论文相对该领域当前的最佳实践,在这方面并没有格外谨慎(例如没有报告互换判卷者或人工核验的交叉检查)。
(b) 作者低估或遗漏的局限性
- 论文完全从”排序准确率能否转化为 RL 收益”这个角度来讨论 GRM vs DRM,但从未正面处理成本这一侧:一次 GRM 查询(生成 + 解析一段判断,可能还带 CoT)比 DRM 单次前向到标量头,单次调用成本要贵得多。Table 4 报告了墙钟训练时间,隐含地把这个成本算进去了,但论文从未明确给出单次查询的成本比,让读者很难判断如果 GRM 推理成本是当前设置的 10 倍,RRC 的收益是否还值得,或者在算力预算紧张、一个更便宜的 DRM 集成方案也许更划算的场景下该怎么权衡。
- AGR 的锚点质量依赖是真实存在但探讨不足的问题:论文展示了参考策略锚点比同策略锚点更稳定(性质 3),但从未展示这些锚点的绝对质量足够高,能起到有用的区分标尺——如果参考策略本身很弱,AGR 的奖励可能会普遍偏高(人人都能打败一个差的参考),区分力很低,这跟漂移论证是两个独立的问题。
- 论文的相关工作部分把自己定位为第一个从”GRM 输出标量奖励”转向”GRM 输出排序式奖励”的工作,但顺带承认 Song 等人(2025)也研究过”生成式奖励模型的基于参考的奖励构造”——论文用”Song 等人仍然从参考比较中派生标量奖励”来区分自己的贡献,但没有给出足够的技术细节让读者能独立核实这个区分究竟有多实质。
(c) 具体、可执行的改进建议
- 在第 4.2、5.1 节和附录 C.1 全文统一修正 SCR 复杂度符号为 ,同时明确提出(或直接实现)一个真正 的、基于锦标赛排序网络的 SCR 变体(例如用从 GRM 查询得到的比较器做归并排序式的两两比较),这样 Table 3 里”SCR:可扩展性有限”这一行才是一个工程选择,而不是硬性的数学上限。
- 至少在消融表格(CARA 开/关、voting@V 扫描、 扫描)里报告多种子结果和误差条/置信区间,即便主表 Table 1 的头条对比因为算力限制仍保持单种子——考虑到 GRPO 跑与跑之间的方差已经被文献充分记录,这应该是 RL-for-LLMs 这个领域该给自己设定的标准。
- 为 AGR 加一个周期性锚点刷新的消融:用每 步 GRPO 就刷新一次参考策略锚点的方式训练(对若干个 值,包括 作为当前的”永不刷新”设置),报告这是否能在训练后期挽回额外的收益,同时又不会重新引入完全同策略锚点的移动目标不稳定问题——这样能直接检验第 5.7/第 8 节标出的边界条件,把一个已知的理论局限变成一条经过实证刻画的权衡曲线。
- 对至少一部分 AlpacaEval2/ArenaHardV2 评测,报告一次判卷者互换或留出人工偏好交叉核验,用一个跟训练时 GRM 和主评测判卷者在架构上都无关的判卷模型,来排除相关偏差对报告收益的虚高影响。
10. 可复现性说明
- 已开源代码:
https://github.com/wangclnlp/RRC(摘要中给出链接)。 - 骨架模型给出完整规格:奖励模型用 LLaMA-3.2-3B-Instruct / LLaMA-3.1-8B-Instruct;策略模型用 LLaMA-3.1-8B-Instruct 和 Qwen2.5-7B-Instruct。
- 数据:HelpSteer3(公开,4.05 万条)用于奖励模型训练;SFT(6K)/ RL(7.5K)数据集沿用 Bhaskar 等人(2025)的设置——这些下游数据集本文没有独立重新给出具体划分,完整复现还需要另外获取那篇前作的确切数据划分。
- 给出的超参数:奖励模型训练学习率 ,batch size 256,训练 1 个 epoch;GRPO 学习率 ,batch size 128;RRC 缩放因子 ;组采样大小 ( 只在扩展行为研究 Figure 3 里用到);锚点集大小 (主表),在 Figure 3 里扫描到 256。
- 未完全说明 / 会阻碍精确复现的部分:主表 Table 1 数字对应的确切 GRPO 训练步数(Figure 1 的曲线跑到 900 步,但 Table 1 除了”每 100 步存一次 checkpoint,在 500 条验证样本上按 AlpacaEval2 协议用 GPT-4o 打分选最佳”之外没有说明具体用的是哪个 checkpoint);GRM 判卷时用的确切 CoT 提示模板;随机种子(如批判性分析部分指出的,一个都没报告);除了”8 张 GPU、8 个模型实例”之外,奖励服务并行部署的确切 vLLM 配置。
- 算力:报告的训练时间(Table 4)是 8.2-15.2 小时/run,隐含在某个固定但正文没有以 GPU 数量/型号明确给出的硬件预算下;只有锚点生成这一步明确给出了”16 张 GPU、约 1 小时”。
11. 总结
RRC 的核心主张范围不大,但论证扎实:阻碍生成式奖励模型把强大的两两判卷能力转化为强大 RL 训练信号的瓶颈,不在 GRM 本身,而在于把 GRM 判断桥接成 GRPO 类算法所期待的标量奖励接口时所用的具体机制(基于概率的标量提取)。把这个桥接机制换成基于排序、结构化聚合的方式——全对成对比较的胜场计数(SCR),或者对一个小而稳定的锚点集做胜场计数(AGR),再用多数投票稳定、用 Kemeny 规则冲突解决(CARA)让结果全局一致——就能收复大部分差距,把相对判别式基线的 RL 侧收益大致提升到三倍以上(在 AlpacaEval2 上从 +1.3% 提升到 RRC 最佳配置的 +5.5%),而且完全不需要改变 GRM 自身的训练目标。理论核心部分(第 4.1 节里,仿射奖励变换在 GRPO 组归一化下精确抵消的证明)确实很有启发性,就我所能判断,推导本身是正确执行的——这是那种能讲清楚”为什么”一整类工程修复应该有效,而不只是报告”某个修复恰好有效”的、小而锐利的推导。差距主要在证据的严谨程度上(单种子表格、一处不精确的复杂度声明、对锚点陈旧问题探讨不足),而不在核心思想本身——核心思想读下来是对当前非常活跃的生成式奖励模型文献一个扎实、有用的贡献。