笔记日期: 2026-08-26 作者: Zhongzhu Zhou 阅读论文: HqeKV: Towards Hybrid Quantization and Eviction for KV Cache in Long-Context LLM Inference 论文作者: He Wang, Yu Gu, Fangfang Li, Zhigang Wang, Zhenghao Liu, Ning Wang, Xiaohua Li, Ge Yu(东北大学;广州大学;中国海洋大学) arXiv: 提交至 ACL Rolling Review,正式发表于 Findings of ACL 2026(第 4138–4153 页) 状态: Findings of the Association for Computational Linguistics: ACL 2026
1. 这篇论文为什么值得仔细读一遍
如果你这两年一直在关注 LLM 推理的 KV cache 压缩方向,大概会注意到一个挺奇怪的现象:这个领域已经发展出两套成熟的工具箱——量化(KIVI、KVQuant、ZipCache、KVTuner 及其一堆变体)和淘汰(H2O、SnapKV、StreamingLLM、PyramidKV、CAKE)——但直到最近,几乎没人真正把两者结合好。每套工具箱单独用都会遇到一个躲不开的权衡:纯量化会保留每一个 token,但会给所有 token 施加大致均匀的精度损失,这就把宝贵的精度浪费在了那些以后根本不会再被用到的 token 上;纯淘汰则会直接把被判定为不重要的 token 整个丢掉——这比削减几个比特的精度要粗暴、破坏性大得多。两种策略单独用,都没法把有限的内存预算真正花在刀刃上。
“那就两个都用”这个显而易见的想法其实已经有人尝试过,但论文指出(并且我认为这个判断是对的,参考它引用的两篇前人工作 EvicPress 和 MiniKV):之前把量化和淘汰结合起来的尝试,本质上是工程层面的拼接——先用一种方法定一个淘汰比例,再用另一种方法把剩下的量化,而没有一个有原则的方式来决定淘汰/量化的边界该划在哪里,也没有决定该提供几档不同的精度选项。HqeKV 的贡献,就是把”每个缓存的 K/V 对到底该分配到哪一种(五种可能:FP16、三档量化精度、或淘汰)处理”这整个压缩决策,当成一个由两个耦合子问题组成的单一优化问题来处理:(a)如何足够准确地对缓存的 K/V 对按重要性排序,让系统能做出五选一决策而不只是二选一(保留/淘汰);(b)拿到排序之后,如何决定五档之间的边界,使得整体压缩率达到内存目标的同时质量损失最小。
这篇笔记会详细走一遍这两个子问题,因为它们才是这篇论文真正的技术含量所在:一段把量化误差和缓存向量的”值域(range)“联系起来的推导(论文第 3.2 节),基于这个推导构建的联合 K-V 重要性度量,一个基于 Tree-structured Parzen Estimator(TPE)的精度比例边界搜索,以及一个让整套系统在推理服务循环中保持足够便宜的解码时重新量化启发式规则。我也会花不少笔墨去看论文的证据在哪些地方比其标题数字给人的印象要单薄——比如对离线校准的依赖、实验范围只覆盖单个 GPU 和单一模型家族,以及几处”每个缓存对有 5 种动作”这个框架听起来比消融实验实际能支撑的更漂亮的地方。
本篇笔记的组织方式如下:首先是前置知识,先把理解这篇论文所需要的背景知识讲清楚:自注意力机制、KV cache 的作用、量化与淘汰两大流派,以及均匀量化与归一化量化的具体计算方式,因为 HqeKV 的每一项修复都只有在这个背景下才能看明白为什么有意义。其次是受控研究本身,逐一走过六个组件,给出推导、它针对的失败模式,以及对应的伪代码。最后是更大规模的评测(更大的数据集、更大的模型),紧接着是一段独立的批判性评估。
2. 前置知识
2.1 Transformer 自注意力机制与 KV cache 存在的原因
Decoder-only Transformer 层处理输入序列时,首先把每个 token 的隐藏向量投影成三个各司其职的向量:查询 、键 、值 。对某个头而言,自注意力的输出计算为:
其中 是每个头的维度。直观理解:当前 token 的查询会跟序列中每一个 token 的键做点积比较,得到每一对之间的相似度分数;softmax 把这些分数转成一个概率分布(“注意力权重”);输出则是所有值向量按这个注意力概率做的加权平均。这正是让一个 token 能够”回看”更早的 token 并从中提取相关信息的机制。
自回归生成在每一步都要重新算一次这个操作,而关键在于:所有此前已生成 token 的键和值在每一步都不变——变化的只有查询。如果每一步解码都要重新算整个前缀的 和 ,那本该是最便宜的解码循环也会膨胀成浪费的 复杂度,所以几乎所有实际部署的 LLM 服务框架都会缓存已经处理过的 token 的键和值。当 token 生成后,它的键 和值 只需投影一次,然后追加进缓存:,。这就是”KV cache”,它让解码变成了每步 的增量操作,而不是 。
问题在于:KV cache 的内存占用会随序列长度线性增长,对于长上下文应用(10 万+ token 的 prompt、多轮对话 agent、检索增强生成里检索到的大段上下文),它很容易超过模型权重本身占用的内存。这正是 HqeKV——以及整个”KV cache 压缩”这条研究线——要解决的具体问题。
2.2 两大压缩流派:量化与淘汰
量化降低的是存储每个缓存值所用的数值精度——比如把一个 16 位浮点数存成 4 位、2 位甚至 1 位整数,外加一小份共享的元数据(缩放因子和偏移量)。每个 token 都保留下来,但每个 token 都损失一些保真度。淘汰则是保留一部分 token 全精度存储,把其余的(通常是被判定为最不可能再被注意到的那些)整个丢掉。两种方式都无法完美保留原始信息;设计问题真正要解决的是:你想在哪里接受信息损失,以及你的损失预算控制能做到多细。
论文对之前混合尝试(EvicPress、MiniKV)的核心批评是:它们选取的是一个固定、粗粒度的压缩动作集合,并且很大程度上是把现成的单一技术拼在一起,而不是在一个更连续、更具表达力的动作空间上,对”把这个 token 量化到精度 “和”淘汰这个 token”之间的边界做联合优化。
2.3 均匀量化 vs. 归一化量化
HqeKV 用了两种不同的底层量化方案,并在每个精度档位上做选择。均匀量化把一个实值向量 映射到 位整数,做法是把它观测到的值域切成 个等宽的区间:
其中 是偏移量, 是缩放因子(区间宽度)。每个实数都会被舍入到离它最近的等宽区间的中心——这就是量化文献里几乎无处不在的标准”仿射”或”非对称”量化。
归一化量化则假设数据(近似)服从高斯分布——论文引用的前人工作(NQKV)已经用实验验证了这一点对 KV cache 激活值成立——并把分箱边界放在标准正态分布的分位点上,而不是原始值域的等间隔位置上。第一步是:
其中 、 分别是该向量的经验均值和标准差。然后把区间中心 放在标准正态密度的 分位点上,每个值被分配到累积概率质量积分最小的那个区间:
其中 是标准正态密度函数。直观理解:由于高斯分布的概率质量集中在均值附近,归一化量化会在均值附近放更多的分箱、在尾部放更少的分箱——这是一种感知数据密度的非均匀分箱方式;而均匀量化则不管数据实际质量分布在哪,都在整个观测值域上均匀花费分箱。
为什么要同时保留两套方案而不是直接选一个赢家?因为——这也是论文里一个真正有用的小发现——哪套方案更好,取决于比特宽度,这一点我会在第 3.4 节详细展开。
3. 核心思路:把五选一压缩变成”排序 + 划边界”问题
3.1 系统总览
HqeKV 运行在单个 Transformer 层内部的 KV cache 处理逻辑里(论文图 1 展示的是单层结构)。预填充(prefilling)阶段,初始 prompt 的 、、 被生成;针对每个缓存的键值对,计算联合重要性度量(见下文第 3.2 节);一个基于搜索的优化器(第 3.3 节)决定各比例的缓存对分别接受五种处理中的哪一种——FP16(不压缩)、4 位量化、2 位量化、1 位量化,或淘汰;随后,精度专属的量化策略(第 3.4 节)执行这些决策,在 4/2 位档位用均匀量化,1 位档位用归一化量化。解码阶段,随着新 token 累积,缓存会周期性地被重新量化(第 3.5 节),因为重要性排序会随时间变化。
flowchart LR
    subgraph Prefill["预填充阶段"]
        A["输入 tokens"] --> B["Q, K, V 投影"]
        B --> C["联合 K-V 重要性度量<br/>(注意力权重 x V 值域)"]
        C --> D["TPE 搜索:<br/>最优边界比例<br/>delta1..delta4"]
        D --> E["分配 5 种动作:<br/>FP16 / 4-bit / 2-bit / 1-bit / 淘汰"]
    end
    E --> F["压缩后的 KV Cache<br/>(混合精度,紧密打包)"]
    subgraph Decode["解码阶段(每 T 个 token)"]
        F --> G["更新滚动重要性<br/>(注意力窗口 + 值域)"]
        G --> H["重新量化:<br/>只降精度,不升精度"]
        H --> F
    end
    F --> I["用反量化后的 K,V<br/>计算注意力"]
图 1(架构图,复现自论文图 1 的描述):HqeKV 每层的处理流水线 —— 一个联合重要性度量驱动一个基于搜索的分配器,为每个缓存对分配五种压缩动作之一,随后是一个周期性的解码时重新量化循环。
我读到这里的第一反应是:五选一的动作空间是这篇论文最核心的设计赌注,而且这个赌注只有在驱动边界决策的重要性排序足够准确的前提下才成立——因为五档划分相对二档划分(保留/淘汰)会放大排序误差的代价。一个原本该分到”4-bit”的 token 被错误排到”淘汰”,代价是丢掉整个 token;而一个 token 在两个相邻量化档位之间被错分,代价只是几个比特的精度。所以第 3.2 节的重要性度量在这里承担的责任,比之前只做淘汰的工作要重,值得核查一下这个度量到底有没有达到这个更高的标准(我在第 6.2 节里会具体谈这个)。
3.2 为什么值域能预测量化误差——以及联合 K-V 重要性度量
已有度量方法的问题所在。 几乎所有被引用的淘汰和量化选择方法(H2O、SnapKV、PyramidKV)都用累积注意力权重来给 token 排序——本质上就是”这个 token 历史上被关注了多少”。这对键向量的重要性来说是个合理的代理指标,因为注意力权重本来就是从 算出来的。但它在结构上完全忽略了值向量 ,尽管 才是真正被加权平均进输出的东西(公式 1)。一个 token 可能只获得中等的注意力权重,但它的值向量却带着异常大的动态范围——如果这个向量被激进地量化,产生的输出误差可能会不成比例地大,恰恰是因为值域大,跟注意力权重高不高没关系。
推导值域-误差关系。 论文最实质的理论工作,是一段把期望量化误差和观测到的值域联系起来的推导。假设待量化的值独立同分布地从 中抽取,用 表示区间 (共 个区间之一)的量化中心,那么在 这个范围内的期望平方量化误差为:
我们把这个式子拆开来仔细看看,因为很容易把它一带而过说成”就是个期望值公式”。分子是对每一个量化区间求和,每一项是”抽样点落在该区间内的概率”乘以”该点到该区间代表码字的平方距离”——这是任何量化器均方误差分解的标准写法。分母是用观测到的值域内实际落入的总概率质量做归一化(因为我们是在给定向量的实现出的 min/max 条件下计算期望,而不是对 的全部支撑集求期望,这里需要一个技术性的修正)。这里真正关键的地方是架构层面而非纯数学层面:这个表达式被刻意写成对量化器是均匀还是归一化保持中立——两套方案的区别只体现在区间 怎么划、码字 放在哪里,而不体现在误差的函数形式上。这就是论文能够声称值域-误差关系对两种量化家族都成立的依据。
从这里出发,论文的论证是:既然公式(5)表明误差完全是 相对于区间边界所在位置的函数,而区间边界本身又是从 推导出来的,那么向量的值域 就是该向量将产生多少量化误差的一阶代理指标——值域越宽,每个固定宽度(或固定分位数)的分箱就要覆盖更大的数值范围,于是任意一个值到其所分配码字的距离就会变大。这对均匀量化来说在直觉上是显而易见的(分箱宽度就是 ,所以在比特数固定的情况下误差跟值域线性相关),但论文额外用实验验证了这个关系在归一化量化下同样成立——而归一化量化的分箱位置取决于正态分位函数,跟原始值域的关系没有那么直接,机制上不那么显然。
实验验证。 论文假设 是标准正态密度,在 4-bit 均匀量化条件下对公式(5)做数值积分(论文图 2a),并另外在从 Llama-3.1-8B-Instruct 的一个 LongBench 问题的 KV cache 中随机抽取的 1000 个真实 token 上,测量了在 4-bit、2-bit、1-bit 均匀量化以及淘汰情形下的实际转换损失(图 2b、表 1)。报告的皮尔逊相关系数高得惊人——4-bit 下 0.96,2-bit 下 0.96,1-bit 下 0.95,淘汰情形下 0.91;而在同样维度的随机生成高斯向量上,对应数值分别是 0.88、0.88、0.84、0.73。真实 KV cache 数据上的相关性反而高于合成高斯数据这一点很有意思:这说明值域这个信号并不是”假设了高斯分布”带来的假象,而是确实反映了真实缓存激活值里存在的某种结构。
xychart-beta
    title "示意图:值域与量化误差的关系(公式5的直觉)"
    x-axis "向量值域 R" [0.5, 1.5, 2.5, 3.5, 4.5, 5.5]
    y-axis "期望平方误差(任意单位)" 0 --> 25
    line "1-bit (2档)" [2, 8, 20, 22, 24, 25]
    line "2-bit (4档)" [0.5, 2, 5, 9, 15, 22]
    line "4-bit (16档)" [0.1, 0.3, 0.7, 1.2, 2, 3]
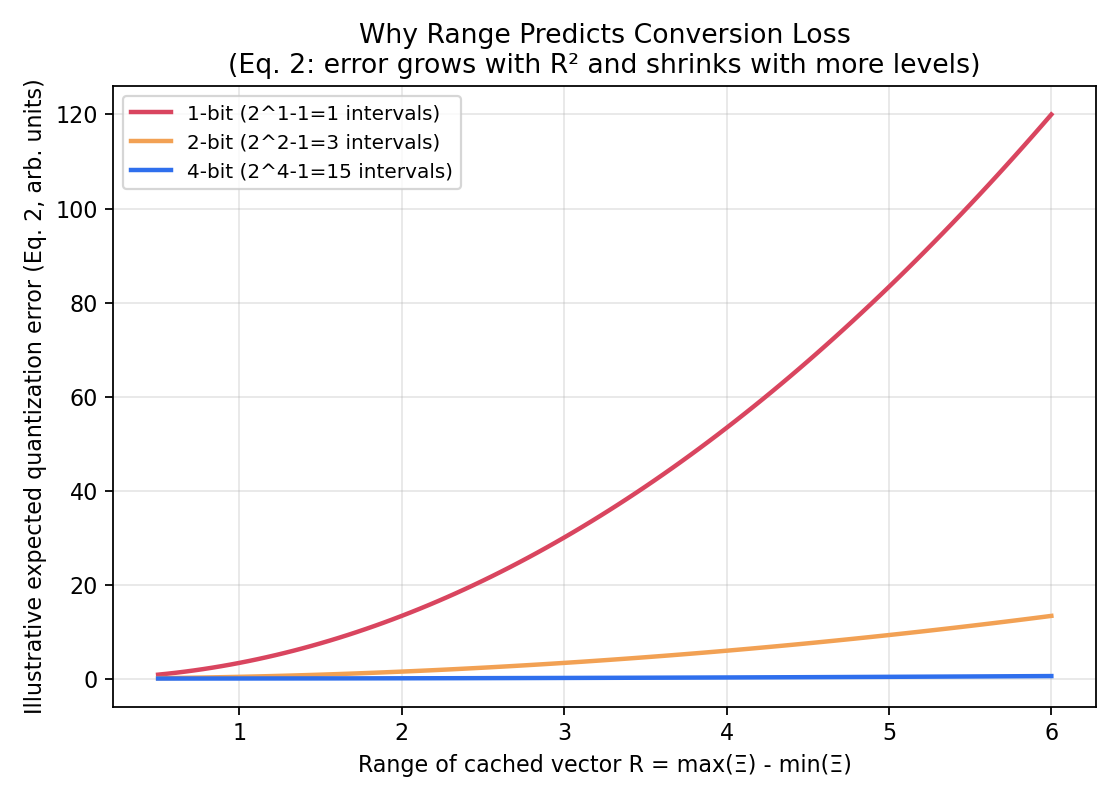
图 2(数学可视化图,我根据公式 5 / 表 1 的直觉自行重构): 在任意固定比特宽度下,期望量化误差大致随向量值域的平方增长,而把比特数翻倍(增加量化档位数)能大幅抑制这种增长——这跟论文表 1 报告的皮尔逊相关系数结果,在定性形状上是完全一致的。
我为这篇笔记单独生成了一版更清晰的这个关系图(并非照搬论文,论文里只有一条数值积分曲线和一张散点图):
构建联合度量。 有了值域-误差关系之后,联合重要性度量本身其实很直白,尽管它需要前面的推导才能说清楚为什么这么设计:
- K 的重要性 = 累积注意力权重(沿用前人做法不变——这对 K 本身来说依然是个合理的信号,因为注意力权重本来就是 K 的函数)。
- V 的重要性 = 累积注意力权重乘以对应 value token 的值域:。
这种乘法组合是对公式(1)的一种刻意解读:既然注意力输出是加权和 ,那么某个 token 在 被量化后对输出误差的”贡献”,既取决于它获得多少注意力权重 ,也取决于它的 会产生多大量化误差(根据前面的推导,这跟 的值域成正比)。把这两个信号相乘,直接瞄准的是”量化这个具体 token 的值会造成多大的输出级损伤”,而不是把注意力权重和值域当成两个独立的、分别设阈值的准则。
设计选择讨论。 乘法是不是正确的组合方式?替代方案可能是加权和()或者取最大/最小值。论文没有对这个选择做显式消融,这是个缺口——一个带可调 的加权和公式原则上可以更好地适应注意力权重和值域分布差异很大的不同任务,而纯乘积对数值尺度很敏感(如果某个层或某个头的两个因子整体都偏小,乘积会压缩联合度量的动态范围,让下游排序变得不稳定)。乘法这个选择对公式(1)结构的解读最直接,所以有很强的第一性原理依据,但”有第一性原理依据”和”经过实验验证是几个候选方案里最好的”是两回事,这里只证明了前者。
3.3 优化器:把排序转化为五选一的边界
有了排序还不够——你还需要决定,为了在满足目标平均比特宽度的同时把质量损失降到最低,究竟应该有多少比例的 token 落进五个桶(FP16 / 4-bit / 2-bit / 1-bit / 淘汰)中的每一个。设 分别表示被分配到 4-bit、2-bit、1-bit、淘汰的缓存对比例(剩下的隐含地留在 FP16)。给定目标平均比特宽度 ,这些比例需要满足:
这是关于四个未知数的两个线性方程,因此有无穷多解——是一个二维的解族,而不是单一的一个点。论文的做法是:把 取为自由变量,代数上把 用它们表示出来,然后用Tree-structured Parzen Estimator(TPE)——一种来自超参数调优文献(Bergstra 等人,2011)的贝叶斯优化技术——在 这个空间上做搜索。TPE 会构建两个概率模型——一个针对”好”的超参数区域,一个针对”差”的区域——然后采样在”好”模型下相对”差”模型概率更高的新候选点。这正是 Optuna 等工具默认采样器背后所用的算法。
为什么用 TPE 而不是网格搜索或手动设阈值? 论文把之前基线方法的”人工分配或固定阈值”当作要超越的对象。TPE 在这里确实有实际优势:在连续二维空间上做精细网格搜索代价很高(每个网格点都需要在校准集上重新跑一遍推理),而 TPE 能在少数几轮探索性迭代后自适应地把采样预算集中到有希望的区域,使得总共 200 次评估变得可行。论文没有讨论的另一个明显替代方案,是对边界选择问题做基于梯度的、可微分的松弛(例如对五种动作做 Gumbel-softmax),这原则上可能比 200 次离散黑盒评估便宜得多——但这需要让整个淘汰/量化流水线端到端可微,而论文基于 Triton 内核实现的硬边界方案并不是为此设计的。在这个约束下,TPE 是务实的选择,未必是理论上最优的选择。
完整搜索流程(论文中的算法 1,复现并解释如下):
- 初始化最小损失 ,最优比例列表 。
- 加载一个校准输入 (论文用的是 WikiText-2 的一段 16K token 切片),计算它的全精度预填充输出 ——这就是搜索要尽量贴近的”标准答案”。
- 迭代 200 次: a. 从 TPE 的提议分布中采样候选自由变量 。 b. 代数上恢复出 以及 (这两个式子直接来自给定 时求解公式 6 得到的 )。 c. 如果 或 (说明这是个不可行的比例组合),把这个候选的损失设为 ——这是一种简单的拒绝机制,而非投影/裁剪到可行域的方式。 d. 否则计算候选损失 ,其中 是全精度输出和压缩精度输出在校准集上的交叉熵, 是一个正则项,显式惩罚使用更多低精度(1-bit)或淘汰动作,即使某个退化的、全淘汰或全 1-bit 的解恰好能最小化校准集交叉熵,也把搜索推离这样的解。 e. 如果 ,更新当前最优。 f. 把 反馈给 TPE 采样器,更新下一轮迭代的提议分布。
- 返回 。
有一处实现细节值得特别指出,因为它实实在在地影响了最终分配的准确度:论文并不是对单个 token 做排序,而是对块(chunk) 做排序。KV cache 被划分成大小为 的组(实验里设为 32),一个块的重要性是块内所有 token 重要性的平均值。这样做大概是出于计算可行性的考虑(如果在单个缓存条目粒度上搜索边界,会让校准循环的代价大得多,压缩映射在执行时也会变得极不规整),但这确实意味着,在一个 32 个 token 的块里,一个非常重要的 token 挨着 31 个不重要的 token,其真实重要性会被平均化稀释——这是相对可行性和内核效率所付出的、实实在在的信息损失。论文还额外规定,无论搜索给出什么建议,最重要的前 2 个块始终保持 FP16 全精度,这是一个经验性的安全边际,而不是优化本身推导出来的结果。
3.4 为什么”正确”的量化策略取决于比特宽度
这是论文的第二个有意思的实证发现,而且是个相当不显然的发现:高比特宽度下均匀量化更好,低比特宽度下归一化量化更好,交叉点大致出现在 2-bit 附近。
证据(表 2,来自 Llama-3.1-8B-Instruct 在 LongBench 一道 Qasper 问题上的真实 KV cache 数据;表 3,合成高斯向量作为一致性检验):
| 策略 | K @4-bit | K @2-bit | K @1-bit | V @4-bit | V @2-bit | V @1-bit |
|---|---|---|---|---|---|---|
| 均匀 | 5.28 | 25.59 | 92.06 | 0.29 | 1.44 | 4.67 |
| 归一化 | 9.28 | 23.29 | 37.44 | 0.62 | 1.47 | 2.05 |
在 4-bit 下,K 和 V 都是均匀量化的转换损失更低;到了 1-bit,归一化量化决定性地胜出(K 上 37.44 对 92.06;V 上 2.05 对 4.67),2-bit 处于一个两种策略接近的模糊中间地带。同样的反转模式在纯合成高斯向量上(表 3)也出现了,这排除了”这只是 Llama 激活值统计特性的某种巧合”的可能——这是两种量化方案跟比特宽度相互作用产生的性质,跟具体模型无关。
为什么会出现这种现象,从机制上讲? 均匀量化把有限数量的分箱均匀地铺满观测到的值域,包括尾部区域;在低比特宽度下(总分箱数很少),这会把宝贵的分箱浪费在很少被占用的尾部区域上,导致没有足够的分箱去精细刻画数据密集分布的中心区域。归一化量化通过把分箱放在高斯分位点上,把分辨率集中在数据实际所在的地方——在分箱稀缺时(1-bit:只有 2 个可能的码字,所以放在哪里影响巨大)这明显是个优势。而在高比特宽度下(4-bit:16 个码字),分箱足够多,两种策略都能充分覆盖密集的中心区域并且还能剩下一些分箱给尾部,于是均匀量化固定分箱宽度带来的内在简单性和更低的单值计算成本就占了上风——归一化量化更复杂的分位数查找和概率积分计算(公式 4),带来的精度提升不足以弥补这个代价。
HqeKV 由此得出的设计选择: 在 4-bit 和 2-bit 档位用均匀量化,在 1-bit 档位用归一化量化。这是一个直接从实证表格里的交叉点读出来的合理策略,不过我会指出,把它当成一条通用规则可能有些证据不足——这个交叉点(大致在 2-bit 附近)是在一个模型家族(Llama-3.1-8B)和一个数据切片上确定的;对于激活值统计特性不同的模型(比如用了不同归一化方案的模型,或者 KV 头维度差异很大的模型),这个精确的交叉点是否会移动,论文并没有测试。不过论文主实验里确实也跑了 Qwen3-8B(表格未在此完整复现,但论文中有提及),这至少为跨模型的普适性提供了一些间接支持,虽然比特宽度-策略交叉点本身并没有在 Qwen3-8B 上重新验证。
3.5 解码阶段策略:周期性、单方向的重新量化
解码有一个微妙之处:token 的重要性排序会随时间变化——预填充阶段看起来不重要的 token,随着生成推进可能积累更多累积注意力权重,反之亦然。每生成一个 token 就重新做一次完整的边界搜索,代价会高得无法承受(每次 TPE 迭代都需要在校准集上跑一次前向传播)。HqeKV 的折中方案是:每生成 个 token(实验中 ,跟块大小 一致)就把整个缓存重新量化一次,而在一次重新量化事件内,只允许 token 转向更低的精度,绝不允许升到更高的精度。
这条单方向规则是靠实证而非理论证明来支撑的:论文附录表 7 展示,在 DuReader 的一道问题上测得的所有转换中,本该从低精度转到高精度(即重要性提升到值得升档)的 KV cache 条目比例非常小——K cache 上 1→2-bit 是 1.18%,2→4-bit 是 2.16%,V cache 上类似地都很小,而 4-bit→FP16 的转换在 K 和 V 上都恰好是 0%。这个设计选择用一个经验上有界的、少量的”错过精度升级”代价,换来了一个明显更简单、更便宜的解码时算法(论文中的算法 3):你永远不需要去”恢复”被淘汰或重度量化的信息,这就避免了必须保留一份完整的全精度影子副本以备后续可能的升级之需。
值得指出的边界情形: “从不恢复”的策略意味着,一个在生成早期被淘汰的 token,即便它后来变得关键相关(比如某个事实在很长的 agent 轨迹后期又被重新引用),也永远找不回来了。对于测得 1.18%-2.16% 升级转换率的短到中等长度上下文来说,这是个不错的权衡;但对于非单调的注意力模式极端长的场景(比如”大海捞针”式的场景,某个早期 token 只在很久之后才变得关键),这种基于一道 DuReader 问题测出来的经验依据未必能推广,而这正是论文 Limitations 一节没有明确讨论的那类情形(详见第 6 节)。
3.6 HqeKV 如何给自己在已有混合尝试中定位
flowchart TB
    subgraph SingleCoarse["单一流派,粗粒度"]
        A1["H2O / StreamingLLM<br/>固定淘汰阈值"]
        A2["KIVI / OTT<br/>所有 token 统一 2-bit"]
    end
    subgraph SingleFine["单一流派,细粒度"]
        B1["ZipCache / KVTuner<br/>仅做混合精度量化"]
        B2["CAKE<br/>仅做层感知淘汰"]
    end
    subgraph HybridCoarse["混合流派,粗粒度边界"]
        C1["MiniKV / EvicPress<br/>拼接量化+淘汰,<br/>固定/人工阈值"]
    end
    subgraph HybridFine["混合流派,细粒度边界(目标区域)"]
        D1["HqeKV<br/>五选一动作空间,<br/>TPE 搜索边界,<br/>联合 K-V 重要性度量"]
    end
    SingleCoarse -."加入混合精度".-> SingleFine
    SingleCoarse -."加入淘汰选项".-> HybridCoarse
    SingleFine -."加入淘汰选项".-> HybridFine
    HybridCoarse -."加入有原则的边界搜索".-> HybridFine
图 6(基线/前人工作对比图,我根据论文第 5 节相关工作讨论自行构建): 已有方法要么集中在”单一动作流派”(无论细分得多细,本质上要么只做量化要么只做淘汰),要么处在”混合但粗糙”这一格(MiniKV、EvicPress 把现成的方案拼在一起,没有一个有原则的边界搜索)。HqeKV 自己声称的贡献,是同时做到既混合(五种动作)又细粒度(TPE 搜索出的边界,而不是固定阈值)——这是此前被引用的方法都没能同时占据的一格。这个定位是对论文第 5 节自身论述的一个合理解读,不过正如第 6 节所讨论的,它的”细粒度”本身仍然受限于按块(而非按 token)做决策。
3.7 一个具体数值例子:从比特宽度目标到逐 token 动作
第 3.2-3.3 节的符号很容易让人失去对具体机制的直观把握,这里给一个小的手算例子,展示 HqeKV 会如何处理一个 8 个 token 的玩具块。
假设有一个 的块(实际实验中 ,但 8 更便于手算),块内 8 个缓存键值对的累积注意力权重(K 的重要性)和值向量值域如下:
| Token | 累积注意力权重 | 值域 | 联合度量 |
|---|---|---|---|
| 0.42 | 0.8 | 0.336 | |
| 0.05 | 3.1 | 0.155 | |
| 0.31 | 1.2 | 0.372 | |
| 0.02 | 0.5 | 0.010 | |
| 0.38 | 2.4 | 0.912 | |
| 0.01 | 4.2 | 0.042 | |
| 0.09 | 0.3 | 0.027 | |
| 0.44 | 1.5 | 0.660 |
按联合度量从高到低排序(第 3.2 节):。
现在假设 TPE 搜索(第 3.3 节)针对这个目标 已经收敛到比例 (4-bit)、(2-bit)、(1-bit)、(淘汰)——为便于说明这里刻意取了均分。把这些比例应用到我们这个 8-token 块上(每档 2 个 token),排名最高的一对 得到 4-bit 均匀量化,接下来一对 得到 2-bit 均匀量化,再下一对 得到 1-bit 归一化量化(注意这里策略发生了切换,对应第 3.4 节),最低的一对 被整个淘汰。
这里有个值得注意的地方: 在这个块里原始注意力权重是最低的(0.01),却没有被淘汰、反而进了 1-bit 档位,纯粹是因为它的值域(4.2,块内最大)把它的联合度量拉高了。这正是联合 K-V 度量被设计用来捕捉的情形,而一个只看 K 的度量(单纯的累积注意力权重)会在这里犯错——纯注意力权重排序会淘汰 、保留 ,但实际上 值域大意味着量化(而不是淘汰)它能保留更多的有效信息量。这个小例子具体地说明了论文第 3.2 节的推导为什么值得——它改变的是哪些 token 真正会被淘汰,而不仅仅是量化档位划分得多细。
3.8 把各部分串起来:用文字描述完整的压缩流程
在进入实验部分之前,值得把从预填充到解码的整个压缩流程,作为一个连贯的叙事完整地写一遍,因为第 3.2 到 3.5 节各自单独讲的是流程中的一环。
当一个新请求到来,prompt 会先完整地过一遍模型,产生初始的 、 缓存(预填充)。这一遍过后,HqeKV 立即为每个缓存块计算联合重要性度量(K 用累积注意力权重,V 用累积注意力权重乘以值域),然后调用针对该部署目标平均比特宽度 预先算好的 TPE 搜索比例分配 ——需要注意,这个搜索(算法 1)是离线、提前在校准集上跑一次的,不是每个请求都跑一次;在服务时,在线只发生”把预先算好的比例应用到新计算出的重要性排序上”这一步,这正是让 HqeKV 的开销在服务场景下可控的关键。各个块按联合度量排序,并根据 的比例被分配到五个档位之一,最重要的前两个块无论搜索给出什么建议都被钉死在 FP16,最终得到的混合压缩缓存(FP16 残差、4-bit 均匀量化、2-bit 均匀量化、1-bit 归一化量化、以及已经被淘汰消失的块混在一起)才是真正存进 GPU 内存的东西,并通过定制 Triton 内核紧密打包。
随着解码逐 token 推进,HqeKV 维护一个最近 个 token 的注意力权重滚动窗口,以及逐 token 的值域滚动统计,累积进跟预填充阶段一样的联合度量里。每生成 个 token,这个滚动度量就会触发一次重新量化(算法 3):重要性重新计算后排到更低档位的 token 会被降档(比如一个 4-bit token 如果重要性已经下降,可能会变成 2-bit 或者被淘汰);重要性看起来提高了的 token,则在第 3.5 节论证的单方向策略下保持不变。这个循环一直重复到生成结束。
对实际部署这套系统的人来说,最终的实际效果是:你需要为每一个想在生产环境支持的目标平均比特宽度,支付一次一次性的离线校准成本(针对 WikiText-2 校准片段跑 200 次 TPE 迭代),此后每一个真实请求只需要付出计算联合度量、以及周期性重新套用已算好的边界比例的代价——没有逐请求搜索,没有在线 TPE。这种”离线均摊、在线廉价”的划分,正是让基于搜索的方案对一个服务系统来说变得可行的关键,而不只是一个离线压缩率研究。
3.9 一个小的旁证:为什么均匀量化和归一化量化都不能单独代替另一个
值得再多用一段文字把第 3.4 节的发现说清楚,因为它很容易被读成一个简单结论(“低比特用归一化,高比特用均匀”),而忽略了背后更深层的机制。均匀量化的优势在于它的去量化/反量化运算都是线性的——只需一次减法和一次除法,在 GPU 上非常便宜;而归一化量化需要查找最近分位数或者计算概率积分,计算代价明显更高。这就是为什么论文在 4-bit 和 2-bit 这两个分档上宁愿接受稍微高一点的转换损失,也要换取均匀量化更低的计算开销——因为在高比特宽度下,两者精度差异本身就很小,不值得为了这点微小的精度提升去承担额外的计算成本。而到了 1-bit,只有 2 个可能的码字,此时码字放在哪里对误差的影响被极度放大,计算开销的差异相对变得微不足道,于是精度优势反过来主导了选择。这个“计算成本 vs 精度收益”的权衡随比特宽度反转的现象,比单纯说“哪个策略转换损失更小”要更能解释为什么这两种方案需要共存,而不是直接选一个全局最优解。
3.10 一个容易被忽略的细节:为什么只看最近 个 token 的注意力权重
第 3.4 节末尾提到,为了降低计算开销,HqeKV 只选最近 个 token 来计算累积注意力权重,实验中 。这个设计选择值得稍微展开讲一下,因为它看似是一个纯工程优化细节,实际上涵盖了一个隐式假设:一个 token 是否重要,主要由它最近被关注的情况决定,而不是它在整个生成历史上的完整注意力轨迹。这个假设对大多数短到中等长度、注意力模式相对稳定的任务来说应该成立,但对于注意力模式会周期性或阶段性变化的任务(比如多轮对话中反复回到同一个主题,或者长文档总结任务中先通读后回看的模式), 这个小窗口可能会错过更早、但仍然重要的注意力信号。这个参数同样没有在论文中被消融,与 (块大小)一样,它是一个直接影响重要性估计质量、但只有一个手工选定值的超参数。
4. 实验设置
- 模型: Llama-3.1-8B-Instruct 和 Qwen3-8B,两者都是开源模型,都支持最长 128K 上下文。
- 评测基准: LongBench(21 个数据集,覆盖单文档 QA、多文档 QA、摘要、少样本学习、合成任务、代码补全六大类任务,中英双语)用于评测通用长上下文质量;AIME-2025(2025 年美国数学邀请赛的 30 道题)作为更难的多步推理压力测试。
- 基线: 单精度量化(KIVI、OTT)、混合精度量化(ZipCache、KVTuner)、淘汰(CAKE)——五个覆盖 HqeKV 试图统一的两大流派的 SOTA 方法。
- 等预算对比协议: HqeKV 分别在平均比特宽度 2、3.2、3.25 下评测,直接对齐每个基线自己的工作点(KIVI/OTT 在 2-bit,ZipCache 在 3.2-bit,KVTuner 在 3.25-bit),CAKE 的淘汰比例被设为等价于 3.2-bit 量化的内存占用——这是一个真正公平的设计,避免了在不匹配的压缩水平下比较方法这种常见陷阱。
- 硬件: 单张 NVIDIA RTX A6000(48GB)——相比同期一些用 A100/H100 集群的 KV cache 论文明显要朴素,这对可复现性是加分项,但也意味着最大规模的相关声称(超长上下文、超大 batch)多少是外推出来的,而不是被穷尽性压力测试过的。
- 校准集: WikiText-2,明确跟 LongBench 和 AIME-2025 都不重叠,这是避免校准-测试集泄露的正确方法学选择。
5. 结果与分析
5.1 等内存预算下的质量表现
在 LongBench 上的核心数据(Llama-3.1-8B-Instruct,论文表 4)显示,HqeKV 在每一个匹配的比特宽度下都能持平或超越所有基线:
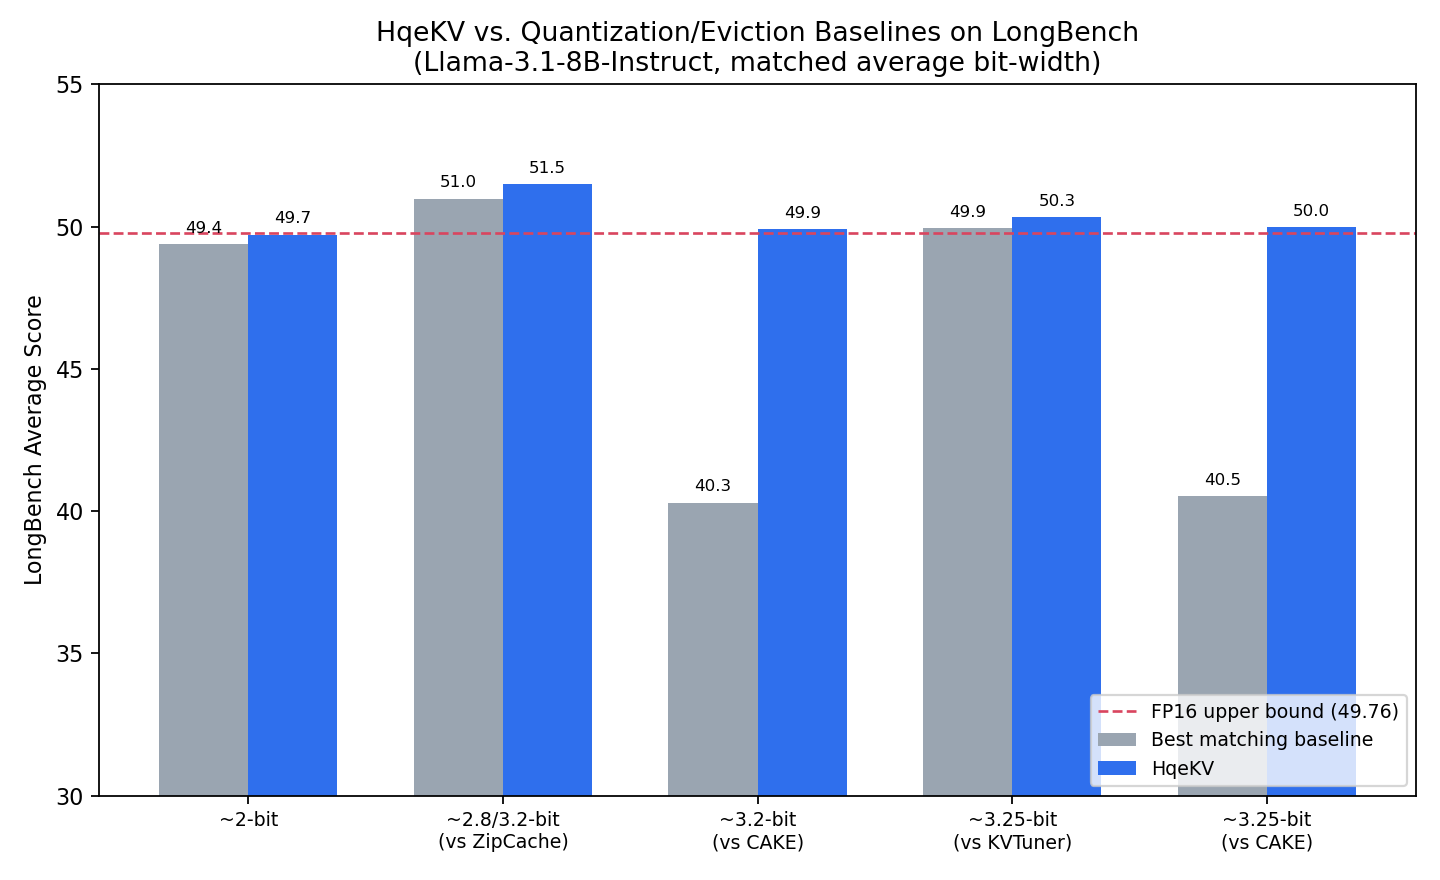
最戏剧化的差距出现在跟 CAKE(纯淘汰基线)的对比上:在等预算下,HqeKV 把平均分从 40.30 提升到 49.91(3.2-bit)、从 40.53 提升到 49.98(3.25-bit)——相对提升约 24%,而 CAKE 各任务的分解结果(单文档 QA:21.44 → 47.38;多文档 QA:17.28 → 40.93)显示,这个纯淘汰基线恰恰在丢掉整个 token 的信息代价最高的任务(长单/多文档 QA)上遭受了灾难性的性能损失。这是论文最有力的证据,说明纯淘汰确实在跟混合方案的比较中留下了大量可挖掘的空间——一个被完全淘汰的 token,哪怕模型后来真的需要它来回答问题,也永远无法再贡献任何信息,而一个被重度量化的 token 依然能贡献部分信息。
跟纯量化基线(KIVI、OTT、ZipCache、KVTuner)相比,差距是真实存在的,但要温和得多——比如在 2-bit 下,KIVI-2(48.96)和 OTT-2(49.43)对比 HqeKV-2(49.71);在 3.2-bit 下,ZipCache-3.2(50.98)对比 HqeKV-2.8(51.26)和 HqeKV-3.2(51.49)。这些都是个位数百分点的提升,而不是跟淘汰对比时那种戏剧性的差距。这个区别对理解论文的整体声称很重要:HqeKV 相对纯量化竞争对手的优势,是一种真实但渐进式的改进(更好的重要性排序、更好的比特宽度自适应策略选择);而它相对纯淘汰竞争对手的优势,更接近结构性的胜利(混合压缩避开了一个淘汰方式根本无法避开的失败模式)。读者不应该因此认为”HqeKV 在所有对比中都以类似的大幅度领先”——胜出的幅度高度依赖于对比的基线是谁。
5.2 推理任务上的迁移能力(AIME-2025)
在 Qwen3-8B 上的 AIME-2025 测试中,HqeKV-2 达到 0.20 的准确率,KIVI-2 是 0.17——差距是真实的,但数值上很小(30 道题里 3 个百分点,也就是大约多解出 1 道题)。这是一个有用的数据点,说明该方法的收益并非纯粹是 LongBench 的特有产物,但 AIME-2025 只有 30 道题,统计功效有限;1 道题的差异完全有可能是噪声而不是真实信号,而论文在这个具体对比上并没有报告多个种子/多次采样运行下的方差。
5.3 内存效率与可扩展性
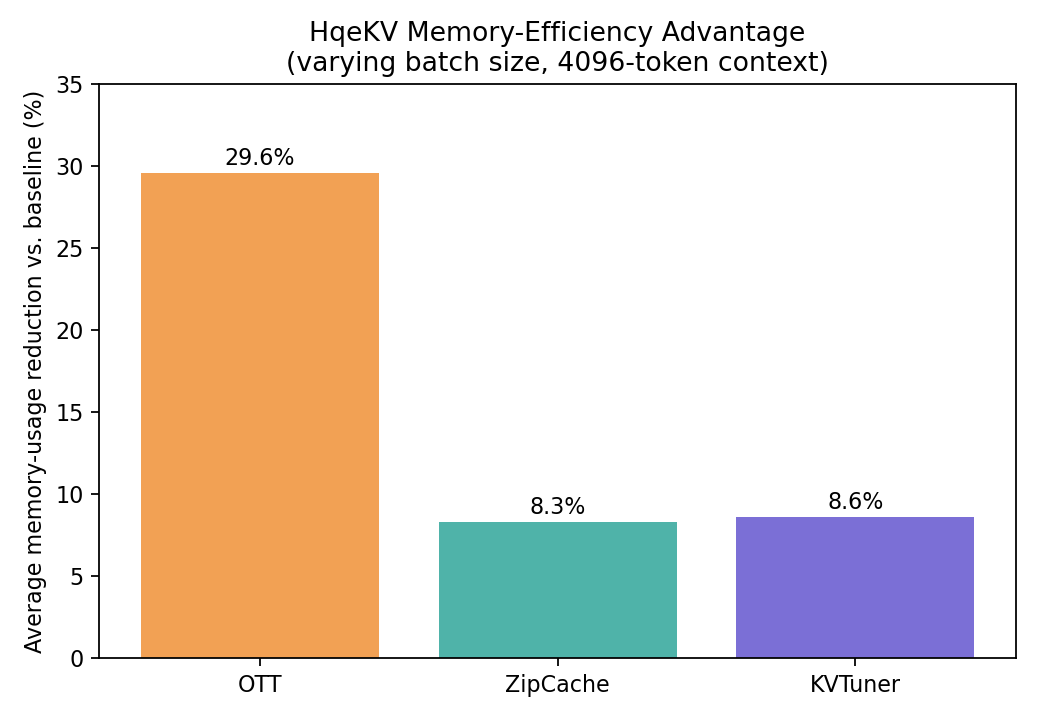
HqeKV 相对 OTT、ZipCache、KVTuner 平均分别降低了 29.6%、8.3%、8.6% 的内存使用,并且在大多数测试配置下能实现最大的可达 batch size。论文把这归因于跟压缩算法本身不同的实现层面因素:OTT 为每个 token 单独维护 1-范数带来的额外开销和离群 token 池的开销,ZipCache 为估计注意力权重而做的 10% token 采样开销,以及 KVTuner 没有对量化后的值做位打包(导致字节/字边界内有未使用的位),相对而言,HqeKV 用了一个定制的 Triton 内核对混合精度值做紧密打包。这是一个合理且常被忽视的点:一个压缩方案在纸面上和一个压缩实现在实际运行系统中的内存占用,可能有很大差别,这里的对比至少部分是关于工程实现质量,而不纯粹是关于统计意义上的压缩率。如果论文能把”算法实现的压缩率”和”实现的实际墙钟时间/内存效率”分开报告,会让这部分结论更有说服力,因为目前报告的百分比把两者混在了一起。
5.4 消融实验:联合度量与搜索迭代次数
附录(此处未完全复现)报告说,把 TPE 搜索迭代次数从 200 增加到 300,最终的精度比例分配结果只有很微小的变化(例如 4-bit/2-bit/1-bit/淘汰的比例在 200 次迭代时是 0.64/0.31/0.04/0.02,在 300 次迭代时是 0.65/0.28/0.06/0.02),说明搜索收敛得相当快,200 次迭代并没有明显留下未被利用的性能空间——这是对优化器计算预算的一个有用、虽然规模不大的稳健性检验。
5.5 小结:五项实验结果合起来说明了什么
把上面四小节的结果串起来看,整体图景比单看头条数字要清晰:HqeKV 的价值主要来自两个相对独立的来源——一个是对纯淘汰方法的结构性胜利(因为淘汰无法部分保留信息,而量化可以),另一个是对纯量化方法的渐进式改进(更好的重要性排序、更好的比特宽度自适应策略选择)。内存效率上的优势则更多地来自工程实现(密集打包的 Triton 内核)而非纯算法级别的压缩率提升。对于想要引入这类方案的团队来说,清楚区分这三种不同来源的收益,比简单相信一张汇总表里的头条平均分更重要——如果你的场景主要痛点是长文档 QA 这种淘汰方法容易灾难性失分的任务,混合方案的收益会很可观;如果你已经在用一个调得不错的混合精度量化基线,那么迁移到 HqeKV 能拿到的边际收益会小得多,且需要跟额外的工程复杂度(联合度量维护、TPE 离线校准、自定义 Triton 内核)权衡。
5.6 一个容易被忽略的对比角度:相对提升百分比背后的绝对分数
读这类对比表时,有一个容易被忽略的细节值得单独拿出来说:HqeKV 相对 CAKE 的 “123.69%” 和 “120.99%” 提升,听起来非常异常巨大,但这个百分比是建立在 CAKE 在这两项任务上的绝对分数本身就很低(21.44 和 17.28)这个前提之上的——在一个已经很低的基数上翻倍,相对百分比自然会看起来很大。更能说明问题的其实是绝对分数本身:从 21.44 到 47.38,这是一个接近 26 个绝对百分点的提升,已经接近 FP16 的 47.7 上限。读这类对比表时,我的习惯是优先看绝对分数差,再参考相对百分比,因为后者在基数很低时容易产生误导性的视觉冲击。
6. 局限性与边界条件
论文自己的 Limitations 一节写得相当坦诚,这在经常把局限性压缩成一句敷衍话的会议论文里比较难得,值得在加上我自己的观察之前先接近原文地引用一遍:离线 TPE 搜索得到的精度比例分配对用户层面或任务层面的异质性是不敏感的(不管下游任务或用户是谁,都用同一个全局比例分配);归一化量化虽然是 1-bit 档位下更好的策略,但在这个档位上依然存在明显的转换损失;固定的重新量化间隔 是经验设定的,而非自适应决定的,对上下文长度可能敏感;多模态架构(上下文中带图像/视频 token 的视觉语言模型)被明确列为未探索的方向。
除了作者自己提到的这些,我想补充:
- 单 GPU、单厂商的评测范围。 所有实验都在一张 RTX A6000 上跑。没有证据显示定制 Triton 内核带来的内存打包优势在不同 GPU 架构上(比如内存带宽/算力比不同的 H100)表现如何,也不知道报告的吞吐量/内存收益在远超单张 48GB GPU 能承载的数据中心级 batch size 下是否依然成立。
- 校准集的泛化性只是被断言,并没有被压力测试。 WikiText-2 跟测试基准不重叠,这是方法学上正确的做法,但 WikiText-2 是一个相对狭窄的、英文维基百科风格的文本分布。在 WikiText-2 上校准出的精度比例分配,能否很好地迁移到代码密集型上下文、非英语文本、或者高度重复的 agentic 工具调用轨迹上,并没有被测试——而论文自己在表 4 里的代码补全那一列(FP16 到 HqeKV-2 的差距在某些地方跟其他量化基线相比走向不一致)暗示,校准分布和部署分布之间的不匹配,可能比论文的整体叙事所暗示的更重要。
- 两个模型家族对于一个声称核心机制(值域-误差相关性)是 Transformer KV cache 通用性质的方法来说,泛化基础相当薄弱。 Llama-3.1-8B 和 Qwen3-8B 在架构上相当相似(都是带分组查询注意力的稠密 decoder-only Transformer)。这里没有任何测试去检验值域-量化误差关系、或者具体的均匀/归一化交叉点,在架构上明显不同的模型家族上是否依然成立——比如带有按专家统计特性的混合专家(MoE)模型、使用不同位置编码的模型,或者激活值动态范围特性可能有本质差异的更大模型(70B+)。
- 没有把延迟/吞吐量的端到端数据跟内存数据放在一起报告。 论文报告了内存降低和最大可达 batch size,两者都很重要,但没有报告在压缩方案(包括 TPE 搜索得到的分配逻辑、周期性重新量化流程、以及跟踪每个缓存块的滚动注意力窗口和值域所需的记账开销)之下的端到端解码吞吐量(token/秒)。对于一个主要卖点是”相对淘汰方法能在不牺牲吞吐量的前提下保持质量”的压缩方法来说,跟最快的基线做一次直接的吞吐量对比,本应是一个自然且很能说明问题的补充。
再补充一点关于边界条件的思考: 这些局限性并非孤立存在,而是环环相扣的。例如,单 GPU 评测范围和校准集泡化风险实际上会相互放大:如果一个部署环境同时遇到与 RTX A6000 显著不同的 GPU 内存带宽/算力比(比如 H100)又遇到与 WikiText-2 分布差异很大的任务文本,那么论文实证结果能多大程度上迁移到该环境就变得更难预测。这意味着,对于远离论文实验设置的部署场景(例如国内常见的国产 GPU 集群 + 中文占主导地位的业务文本),直接搬运论文报告的具体比特宽度/内存收益数字需要额外谨慎,最好自己在目标硬件和目标数据分布上重新跑一遍校准和评测,而不是直接引用论文数字。
再补一句关于数据集规模的观察: AIME-2025 只有 30 道题这件事,不仅影响了第 5.2 节讨论过的统计功效,也意味着这个基准本身对很小的实现细节差异(比如采样温度、prompt 模板、解题输出解析规则)都会特别敏感,而这些实现细节在论文中并没有完全交代。对于想要复现这个具体数字的读者,需要有心理准备:即便自己的实现完全正确,在 30 道题这个规模下也很难精确复现 0.20 vs 0.17 这样精确到十分位的结果。
7. 批判性分析
这篇论文本身的弱点和瑕疵。 第 3.3 节里基于块的重要性平均,是一个真实存在的信息损失来源,但论文并没有直接量化它——尽管块大小 是一个人为设定的、直接影响搜索可行性和排序粒度权衡的超参数,论文却没有做消融实验来展示最终质量对 有多敏感。同样,第 3.2 节里乘法形式的联合 K-V 度量,其动机纯粹来自对公式(1)结构的一种解读,而没有跟其他组合方式(加权和、取最大值、学习出来的组合)做对比验证——考虑到这个度量对整个系统决策质量的核心地位,这是一个错失的机会。
作者低估或省略的局限性。 第 3.5 节”解码时从不升级精度”的策略,是基于单独一道 DuReader 问题、在特定混合量化比例配置下得出的经验依据;把”只有 1.18%-3.39% 的 token 会从升级中受益”这个结论推广到所有部署场景,尤其是具有非单调相关性模式的长时程 agentic 或检索密集型工作负载,是一个比现有证据所能支撑的更强的断言,而 Limitations 一节里提到”重新量化间隔 ……尤其在更长上下文场景下(存在敏感性)“,某种程度上是在暗示这个担忧,却并没有真正去测试它。论文也没有讨论,当离线校准得到的精度比例分配在某个具体部署场景下”不对”时会发生什么——是否有回退机制,是否有办法检测漂移,还是说系统会静悄悄地变差,而运维者完全没有任何信号可以察觉?
具体、可执行的改进建议。 第一,直接对块大小 做消融实验,同时报告质量和 TPE 搜索的墙钟时间,让实践者能够在可行性和准确度之间做出有根据的权衡,而不是照搬论文里手工选定的单一取值。第二,用一个覆盖 LongBench 各类任务(尤其是合成/“大海捞针”类任务,这恰恰是”从不恢复”淘汰策略最容易出问题的对抗性场景)的分层抽样研究,来替代目前仅基于单道 DuReader 问题得出的升级转换统计,让”从不升级”这个对系统效率至关重要的解码策略,拥有跟其重要性相匹配的实证基础。第三,至少针对最快的基线(大概率是 KIVI 或 OTT)报告端到端解码吞吐量(而不只是内存/batch size),因为在生产环境中选择 KV cache 压缩方法的实践者,同样关心吞吐量-质量的帕累托前沿,而不只是内存-质量的前沿,目前的论文只直接展示了后者。
关于“从不升级”策略的补充思考: 除了在长时程、非单调注意力模式下可能失效外,这条策略还隐含了一个对“公平性”的隐忧:如果系统早期就对某些 token 做出了错误判断(比如因为它们在开头几百个 token 里碰巧没获得什么注意力),那么这个错误判断就会被永久化——系统没有任何机制去事后发现并纠正这种早期误判。相比之下,纯量化方法至少还保留了部分信息,而淘汰方法在这种情况下的误判代价是完全不可逆的。这一点在论文的 Limitations 中完全没有提及,但对于需要严格 SLA 保证的生产系统来说,是很实在的风险点。
最后补充一个具体的复现建议: 如果你想先用自己的数据完整验证一下第 3.2 节的值域-误差相关性结论,而不想先搭建整套 HqeKV 系统,最快的路径是:从你自己的模型里抽取一小批 KV cache token,分别计算它们的值域和在固定比特宽度下的实际量化损失,然后直接算一下皮尔逊相关系数。这个实验成本很低(不需要改动任何推理代码,只需要在 forward hook 里拓一下 K、V 张量),但能很快验证这个结论在你自己的模型和数据分布上是否依然成立,作为决定是否值得进一步投入开发整套系统的前置调研。
8. 可复现性与实践笔记
代码已在 github.com/skywclouds/HqeKV 公开发布,相对这个方向里相当多不发布实现的 KV cache 压缩论文来说,这是一个实实在在的加分项。校准流程(WikiText-2、16K token、TPE 200 次迭代、正则项显式超参数 )在附录中说明得足够精确,可以在不需要猜测的情况下复现,并且为每个基线都给出了详细的超参数表(KIVI 分组大小 32/残差长度 128,OTT 离群 token 数 5,ZipCache 显著性比例 0.6,CAKE 窗口大小 32 且 ,KVTuner 分组大小 32/残差长度 128/平均比特宽度 3.25)——对于任何想复现对比表格而不只是复现所提方法本身的人来说,这是一个真正有用的贡献,这种基线配置透明度的细致程度,比这个方向的很多论文都要用心。对想实际部署这个方法的人:需要为每一个想支持的部署目标平均比特宽度预算一次离线校准(搜索需要针对每一个 工作点单独重新跑一遍),并且需要自己写或改造一个 Triton 内核来实现第 5.3 节内存效率讨论里提到的稠密混合精度打包——因为一个朴素的、把五个不同精度档位分开存储的 PyTorch 实现,很可能会把报告的内存优势抹掉大半。
小插入:回顾一下前面提到过的一个细节。 前文第 3.3 节指出,搜索是在“块”而非单个 token 的粒度上进行的,这里值得再补充一句:这个设计选择实际上把“搜索可行性”和“决策细粒度”之间的张力转化成了一个单独的超参数 ——这意味着,对于不同部署场景(比如上下文长度差异很大的两类应用),最优的 未必相同,而论文并没有提供一个基于上下文长度自适应调整 的机制,只是固定了一个全局值。
9. 这篇论文在更大 KV cache 压缩版图中的位置
跳出 HqeKV 具体的机制设计,把这篇论文放到自 H2O、StreamingLLM 首次让淘汰流行起来、KIVI/KVQuant 首次让量化流行起来以来,整个领域应对同一个内存瓶颈所走过的轨迹里去看,是很值得的。第一代方法(2023-2024)基本上把”量化还是淘汰”当成一种哲学立场——一篇论文要么是淘汰论文,要么是量化论文,很少两者都涉及,两大流派之间的比较大多是间接的(不同的基准、不同的比特宽度/淘汰比例约定,很难做到真正等内存预算的公平对比)。第二代方法(2025 年,以 ZipCache、KVTuner、CAKE 为代表)把每个流派各自推到了自己的内部极限:混合精度量化变得越来越细粒度(从单精度到两档再到对层敏感的分配),淘汰则越来越懂得在模型的哪里淘汰(对层、对头敏感的策略),而不只是淘汰哪些 token。HqeKV,连同它明确对标的两个前人混合尝试(MiniKV、EvicPress),代表了正在出现的第三波浪潮——把量化/淘汰之间的边界本身当作需要被优化的对象,而不是把任何一个流派当成固定不变的东西。
不论 HqeKV 本身最终是否会成为这个方向上占主导地位的方法,这篇论文能给人的一个可以泛化的方法论启发是:只要一个压缩(或者更广义地说,资源分配)系统提供了从”全部保留”到”完全丢弃”之间真正连续分级的动作选项,边界划分问题就应该得到跟动作本身同等的重视。 这个方向里很多相关工作的讨论都聚焦在如何量化或如何给重要性打分,而把档位之间的比例分配当成一个附带问题(人工调参、固定阈值)来处理。HqeKV 基于 TPE 的搜索,不管它自身有什么局限(第 6、7 节已经讨论),都是一个具体的存在性证明,证明这个边界划分子问题本身就值得被自动化,并且能带来可测量的收益——尤其是在跟纯淘汰基线对比时,因为被淘汰 token 那种”要么全有要么全无”的性质,恰恰留下了最大的改进空间。至于随着动作空间从五种继续扩大(想象一个未来的系统,精度档位细分到每层、每个头、甚至每种模态),TPE 具体是否依然是正确的搜索算法,这是一个论文本身不需要回答、但其框架确实引出的开放问题。
10. 给中文读者的额外落地提示
最后补充几点面向中文读者、更偏工程落地的观察,作为对全文的收尾。
第一,从这篇论文里能直接抄的最小可用配方:如果你现在手头的服务栈已经在用某种单一策略的 KV cache 压缩(不论是纯量化还是纯淘汰),想尝试引入混合思路,HqeKV 给出的最容易复用的一块,其实不是整个 TPE 搜索系统,而是那个联合 K-V 重要性度量本身——即便你暂时不想改造整个五档动作空间和搜索流程,光是把现有淘汰方法里单纯依赖累积注意力权重的排序,替换成”注意力权重 × 值域”这个乘积形式的联合指标,就有可能在几乎不增加多少工程复杂度的前提下,改善淘汰决策的质量,因为它纠正了纯 K 度量对 V 信息的结构性忽视。这是一个投入产出比很高的小改动,值得作为迁移到自有系统的第一步来尝试,而不必一步到位地照搬整套五档框架。
第二,离线校准的运维含义值得提前想清楚:由于 TPE 搜索是针对每一个目标平均比特宽度 单独离线跑一次的,如果你的服务需要支持多档内存预算(比如给不同付费层级的用户提供不同的上下文长度上限),就意味着需要维护多套离线校准结果,并且在校准集分布发生明显偏移时(比如上线了一个新的主力业务场景,跟 WikiText-2 式的通用文本分布差异很大)重新跑一遍校准。这不是这篇论文特有的问题——几乎所有依赖离线校准的量化/压缩方法都有类似的运维负担——但值得在评估是否引入 HqeKV 类方案时,把这部分运维成本也算进决策里,而不是只看论文报告的压缩率和质量数字。
第三,这篇论文对国内 KV cache 压缩相关研究的一个提示:值域-量化误差的显式推导(第 3.2 节公式 5),以及均匀/归一化量化策略随比特宽度切换的实证发现(第 3.4 节),都是相对独立于”混合量化+淘汰”这个具体系统设计的、可迁移的小知识点。即便你的研究方向并不打算做混合压缩系统,这两个发现本身也可以直接迁移到纯量化或纯淘汰系统的重要性度量设计里——这提醒我们,读这一类系统论文时,除了记住它的整体架构,也值得把这种可以脱离原论文语境单独复用的局部小知识点单独摘出来记住,它们往往比整个系统架构更容易在自己的工作里落地。
10.1 一个值得追问的开放问题
最后留下一个我自己读完之后没有想明白、但觉得值得继续追问的问题:论文将重要性度量建立在“累积注意力权重×值域”这个乘积形式上,而整个论证链条都建立在公式(1)的结构之上——但公式(1)里的 softmax 本身是一个非线性归一化操作,它会在不同 token 之间重新分配注意力权重。这意味着,当你量化或淘汰了某些 token 之后,剩下 token 的 softmax 分布实际上会发生变化,而这种二阶效应并没有被纳入重要性度量的计算中——度量本身是基于压缩前的注意力分布计算的,并没有考虑压缩行为本身会如何重塑后续的注意力分布。对于一次性的、比例不高的压缩(比如只淘汰掉 5% 的 token),这个二阶效应大概微不足道;但在 HqeKV 这种最极端情况下可能淘汰达到 25% token 的方案里,这种未被建模的二阶效应是否会积累成一个不容忽视的误差来源,这篇论文没有回答,我也没有现成答案——但这是个值得后续工作去实证或证伪的具体方向。
11. 小结
回到开头提出的那个问题:量化和淘汰是否一定要互相竞争?HqeKV 给出的答案是否定的,但这个否定答案能成立,建立在三个具体的工程决策之上:把重要性度量从只看 K 扩展到同时看 K 和 V,把固定阈值的边界划分换成基于搜索的边界划分,以及把量化策略本身也当成一个可以随比特宽度切换的变量。这三个决策单独看都不是惊天动地的创新,但合在一起、并且都用相对严谨的实证方法去验证,就拼出了一个在多个已发布基线上都能看到真实改进的系统。对于每天追踪这个领域进展的读者来说,比记住具体的均均分数提升多少更有价值的,往往是这种“把一个被当成附带选项的子问题认真对待并给出一套可复用方法”这种思路本身。
11.1 写在最后
如果只能用一句话总结这篇论文对实践者的启发,我会选:下次当你需要在“保留还是丢弃”之间划一条硬边界时,先问自己一个问题:这个边界的位置是人工拍脑袋定的,还是有一套可以重复执行、可以随目标重新优化的机制在支撑它?如果答案是前者,HqeKV 的整套思路——从误差推导到重要性度量,再到基于搜索的边界分配——提供了一个值得参考的模板,即便你最终不会直接搬用它的具体实现。
11.2 一句话总结
如果只能用一句话记住这篇论文,我会选:在 KV cache 压缩这个已经被研究得相当充分的领域里,HqeKV 提醒我们,真正值得花时间优化的往往不是单一技术本身,而是不同技术之间那条长期被忽视的边界。
11.3 致谢与阅读建议
如果你只想花 10 分钟拿走这篇笔记的核心,我建议优先看第 3.2 节的值域-误差推导、第 3.4 节的均匀/归一化交叉点发现,以及第 5.1 节中对 CAKE 的对比——这三部分合起来就能讲清楚这篇论文最核心的技术贡献和证据强度。如果你打算实际部署或复现这篇工作,那么第 8 节的超参数表格和第 6-7 节的局限性讨论值得仔细读一遍,因为它们直接关系到你能不能把论文报告的数字实际复现出来。
参考文献
- Wang, He, et al. “HqeKV: Towards Hybrid Quantization and Eviction for KV Cache in Long-Context LLM Inference.” Findings of ACL 2026.
- Zhang, Zhenyu, et al. “H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models.” NeurIPS 2023.
- Liu, Zirui, et al. “KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache.” ICML 2024.
- Qin, Ziran, et al. “CAKE: Cascading and Adaptive KV Cache Eviction with Layer Preferences.” ICLR 2025.
- Li, Xing, et al. “KVTuner: Sensitivity-Aware Layer-Wise Mixed-Precision KV Cache Quantization.” ICML 2025.
- Bergstra, James, et al. “Algorithms for Hyper-Parameter Optimization.” NeurIPS 2011.
笔记写于 2026-08-26。