笔记日期: 2026-08-19 作者: Zhongzhu Zhou 阅读论文: KV Cache Compression Through the Lens of Transform Coding 论文作者: Hannah Laus, Claudio Mayrink Verdun, Hao Wang, Flavio du Pin Calmon, Felix Krahmer(达姆施塔特工业大学 / 慕尼黑工业大学 / 慕尼黑机器学习中心;MIT;红帽 AI 创新团队 & MIT-IBM Watson AI 实验室;哈佛大学) arXiv: 2608.14191 发表状态: 预印本(cs.LG),2026年8月
1. 这篇论文真正在问的问题
绝大多数 KV Cache 量化论文,其实是在隐式地回答一个”听起来对但其实不太对”的问题:“如何用尽量少的比特表示缓存的 key 和 value,同时让它们尽量接近原始数值?“——这是一个重建误差问题。AATC(Attention-Aware Transform Coding,注意力感知变换编码)从一开始就问了一个不同、也更精确的问题:“如何用尽量少的比特表示缓存的 key 和 value,同时让注意力输出尽量接近全精度情形下本该得到的结果?“这两个问题的答案并不相同,而 AATC 的改进空间恰恰就藏在这两者的差距里。
为什么这个区分在实践中很重要?因为注意力机制并不会对每一个 key-value 对、以及每个 key-value 对里的每个通道一视同仁。当前 query 几乎从不读取的某个 key 通道,即使量化得再粗糙,也不会移动注意力输出分毫;一个几乎拿不到注意力权重的 token,它的 value 也完全可以随便量化而不产生任何后果。最小化重建误差的量化器看不到这种不对称性——因为它们的目标函数里根本没有出现 query、输出投影或注意力权重这些量。AATC 的核心贡献,是给出一条定理,把这种不对称性写成一个闭式的、可以拿去做优化的显式表达式:它把注意力输出失真分解成 key 和 value 两部分的加法组合,而每一部分又进一步分解为”token 相关因子”和”通道相关因子”的乘积。有了这个分解之后,比特分配问题就变成了一道教科书式的率失真问题,论文用的是 1950 年代就有的老工具——变换编码和逆水填算法——只不过给这个老工具装上了一个 2020 年代的新准星:这里要压缩的”信号”,不是原始的 KV 数据本身,而是经过 query 和输出投影”感知”之后的 KV 数据。
这里先用一句话总结这个区别对实际部署的启示:如果你只评估重建误差,你很可能得到一个在离线指标上看起来很漂亮、但在真实下游任务上表现平平的量化方案,因为重建误差小并不自动意味着下游任务精度高;而若直接优化注意力输出失真,你优化的就是你真正在乎的东西。
这篇笔记分三部分展开。第一部分补齐前置知识:KV Cache 到底存的是什么、量化对它做了什么、变换编码和逆水填算法是什么(如果你读过经典信息论教材可以快速跳过,但值得精确地过一遍,因为 AATC 几乎原样搬用了这套机器)。第二部分详细推导论文的核心定理,因为这个定理才是论文真正的贡献,算法本身只是定理的一个相当机械的推论。第三部分走一遍算法、实验结果和作者做出的(以及没有做的)设计选择,最后给出独立的批判性评价。
2. 前置知识
在正式进入推导之前,先把这篇笔记的阅读地图交代一下:第 2 节补齐 KV Cache 、量化、变换编码的背景知识;第 3 节完整推导论文的核心定理;第 4 节把这个定理放入现有文献的坐标系;第 5 节走一遍算法本身及其设计取舍;第 6 节看实验结果;第 7–9 节分别是可复现性、局限性和批判性分析。如果你已经熟悉变换编码和逆水填,可以直接跳到第 3 节;如果你只关心结论和实际可用性,可以先跳到第 6–9 节,再回头看第 3 节的推导确认结论的来源。
2.1 KV Cache 为什么存在、为什么会越长越大
Decoder-only 的 Transformer 逐 token 生成文本。在第 层,每个 token 的隐藏向量会被线性投影成一个 query 、一个 key 和一个 value 。自注意力机制对当前 query,计算它与迄今为止所有 key 的相似度打分,经过 softmax 变成一个概率分布,然后返回对应的 value 加权平均:
在自回归解码过程中,第 个 token 的 query 需要关注 这些历史 token 的全部 key 和 value,而不只是最新的那一个。如果每一步解码都重新计算所有历史 token 的 ,每步就要多做 的冗余计算,所以实际做法是把每一个算出来的 key 和 value 都缓存下来:第 步的 KV Cache 是 ,每层一对不断增长的矩阵。这个缓存的显存占用随处理过的 token 数线性增长,在长上下文场景下(论文提到现代部署已经出现超过百万 token 的上下文)它的体积会远远超过模型自身权重占用的显存。因此,在不损害生成质量的前提下压缩这个缓存,是 LLM 服务系统里投入产出比最高的工程问题之一,这也是为什么每一个主流推理框架(vLLM、SGLang、TensorRT-LLM)都会内置某种形式的 KV Cache 量化或驱逐机制。
为了后面推导读起来更顺,这里先把全文会反复用到的符号集中列一下: 是 token 的注意力权重, 是它的 key 和 value, 是量化后的版本,、 是量化误差; 是未受扰动的注意力输出, 是受扰动(量化后)的输出; 是输出投影矩阵, 是其第 行; 是当前解码步的 query 向量, 是其第 个分量; 分别是 key 和 value 对失真的贡献; 是 key/value 量化噪声方差的上界; 是第 层、第 个变换后通道分到的比特数; 是 key/value 的总比特预算。后面推导中出现的大多数符号都可以对照这一段回来查阅。
具体拿数字说话:Llama-3.1-8B-Instruct 有 32 层、8 个 KV head、每个 head 维度 128,每个 token 因此贡献 个 FP16 数值,即每 token 128 KB。仅仅一个 32k token 的上下文,单个并发请求就需要大约 4 GB 缓存——比一个完全量化后的 7B 模型自身权重还大——而这个数字会随服务端同时承载的并发请求数线性放大。这正是论文第 6.2 节报告的、从 1.07 GB(FP16,针对一个较短的代表性序列)压到 184 MB(在其主打的 5.82 倍压缩比操作点)的量级,也解释了为什么在很多场景下,决定一张 GPU 能同时撑住多少个长上下文并发请求的瓶颈,不是算力,而是显存预算。
2.2 标量量化,精确地讲
论文用的是标准的均匀标量量化器。给定尺度 和零点 ,一个 比特量化器把一个实数 映射成一个整数编码再映射回来:
只要 落在裁剪范围内,重建值 就满足 ——这是一个基本保证,让我们可以把量化误差当成一个有界的、近似均匀分布的随机变量来分析。逐元素地把这套机制用在 key 和 value 上,就得到量化后的缓存 、,误差向量记为 、。尺度 可以按 per-tensor、per-token 或 per-channel 粒度共享;现有方法比如 KIVI 就混用了这几种粒度(key 用 per-channel、value 用 per-token),因为经验上 key 和 value 的离群值结构不一样。
2.3 从头推导:变换编码与逆水填算法
这部分是这套工具箱里真正有 70 年历史的部分,值得完整推导一遍,因为 AATC 的”创新”很大程度上是往这台机器里塞了什么量,而不是机器本身。
假设你有一个零均值随机向量 ,协方差为 ,你想用平均每维 比特来表示它,使得均方误差 最小。如果你在原始基下独立量化 的每个坐标,就是在浪费比特:高度相关的坐标携带着冗余信息,你实际上是在为同一份信息重复付费。变换编码用两步解决这个问题。
flowchart LR
    subgraph Step1["第一步:去相关"]
        X["相关信号 x\n协方差 Sigma"] --> U["正交变换\ny = U^T x"]
        U --> Y["去相关系数\n方差 sigma_1^2 >= ... >= sigma_d^2"]
    end
    subgraph Step2["第二步:分配比特"]
        Y --> W["逆水填算法\n对能量地形 log2(1/sigma_i^2) 倒灌水"]
        W --> B["每个系数的比特数 b_i*\n低于水位线的记为零比特"]
    end
    B --> Q["独立量化每个 y_i\n使用 b_i* 比特"]
    Q --> R["重建: x_hat = U y_hat"]
图 1 画出了这套经典两步流水线,AATC 几乎原样沿用了它;唯一改变的是水填算法里”系数方差”这个位置该填入哪个量。
第一步——去相关。 应用一个正交变换 ,让协方差对角化,即 。因为 是正交的,它精确保持平方误差失真不变:量化 再逆变换回 ,得到的失真和直接量化 完全一样。对于高斯信号源,最优的 选择是 Karhunen–Loève 变换——也就是 的特征基,恰好就是 PCA 的基。实践中 是从校准样本估计出来的。
第二步——分配比特。 现在坐标 已经去相关,方差为 ,把总共 个比特分配给它们。在标准的高码率近似下,用 比特量化方差为 的坐标,能达到的失真约为 (其中 是与量化器有关的常数)。在约束 、 下最小化 ,是一个凸优化问题,它的解就是经典的**逆水填(reverse waterfilling)**分配:
其中水位线 的取值要满足 。直觉上可以这样想象:把一定量的”比特预算”当作水,倒进一个底面高度为 (能量地形取反)的容器里——水会稳定在一个共同的水位 ,而位置 处水面高出底面的深度,就正比于分配到那里的比特数。方差低于水位线的坐标获得零比特——直接重建为零,也就是彻底丢弃。这正是论文里”比特分配的副作用等价于秩缩减”这一现象(原文 Remark 5)的来源:一旦解出分配方案,某些变换后的维度就是没有分到任何比特,这在数学上等价于一种数据自适应、且不需要事先决定秩大小的低秩截断。
关于这个经典解,有两点值得留意,因为 AATC 都对它们做了修改。第一,每个被保留的系数最终都被量化到相同的失真水平 ——这正是”水位”这个直觉的精确表达:比特哪里能最大程度降低失真就往哪里去,直到边际收益处处相等。第二,整个推导假设你要最小化的是 本身的重建失真。但如果你真正关心的是 的某个下游函数——这里就是从 计算出的注意力输出——那么该代入公式 (3) 里的""就不应该是坐标的原始方差,而应该是一个加权方差,反映这个坐标对下游函数到底有多重要。这正是 AATC 要补上的空缺。
2.4 在 AATC 之前,已有方法都在优化什么
在 AATC 之前,KV Cache 压缩方法大致分为几个流派,论文把它们放在同一个坐标系里做了梳理(原文 Table I,下文第 4 节会复现):
- 标量量化(KIVI、KVQuant):独立量化每个 key/value 坐标,用 per-channel 或 per-token 尺度,有时加上非均匀码本和离群值处理——但分配给每个通道的比特是均匀或启发式调出来的,不是从一个显式的、面向输出的失真目标推导出来的。
- 向量量化(A2ATS、CommVQ、TurboQuant):用学到的码本联合量化一组坐标。
- 低秩/变换类方法(PALU、Eigen Attention、xKV):沿特征维度去相关,然后直接删掉低能量子空间——一种提前决定好、固定秩的硬截断,不会随可用比特预算自适应调整。
- 变换编码类方法(KVTC,是与 AATC 最接近的前作):去相关缓存,然后用逆水填分配比特,做法和 AATC 一模一样——但它们最小化的失真目标是原始的重建误差 、,而 KVTC 作者自己也承认这只是真正关心的量的一个代理。
- 驱逐类方法(H2O、SnapKV、StreamingLLM):基于注意力分数衍生出的重要性打分,整个丢弃某些 token。
- 旋转类方法(OSCAR,以及一系列 query-aware 旋转工作):在量化前施加一个正交变换,专门选择使 query 方向的几何结构更适合量化。
AATC 的定位主张是:上述所有方法其实都在优化同一个底层失真量的不同投影,只是切入角度不同;一旦你把这个量的闭式表达式写出来,就可以同时针对它的所有结构做比特分配,而不必挑一个轴单独优化。
3. 定理 1:推导注意力感知失真
这是论文的数学核心,值得完整走一遍推导过程,而不是只抄结论——理解为什么这个分解是加法形式(key 和 value 误差之间没有交叉项),才能真正信任由此得到的比特分配公式。
3.1 设定与假设
固定单个解码步,为了简洁省略层下标。当前 token 未受扰动的注意力输出为 ,其中 是公式 (1) 给出的(未受扰动的)注意力权重。量化把 、,产生受扰动的输出 ,其中 是用受扰动的 key 重新计算出的注意力权重。
整个分析建立在两条假设之上:
- 假设 1(白噪声量化模型)。 量化误差 (下标 表示通道)零均值、跨 token 和跨通道相互独立、key 与 value 之间独立、且分布对称(所有奇数阶矩为零)。这是率失真分析里对量化的标准理想化假设;已知它只在高码率极限下才精确成立,但论文自己的实验表明,即使降到 2–4 比特,这个失真度量仍然具有预测力。
- 假设 2(key 量化误差有界)。 存在常数 ,使得对每个 token 和通道 ,几乎必然有 ,其中 。这条对第 4 节描述的均匀标量量化器(公式 2)自动成立,因为量化步长会按每个 token 的最大元素值缩放(见”合适的尺度”这一处理细节)。
3.2 第一步——把输出误差拆成三块
记 为 key 误差引起的注意力权重扰动。展开 并减去未扰动项,输出误差可以拆成三个加法项:
刻画的是 key 量化通过被扰动的注意力权重产生的效应——softmax 的非线性正是在这里介入的。 刻画的是 value 量化的直接效应(value 是线性进入输出的,这里没有非线性插手)。 是一个二阶交叉项。由于 ,展开这个平方会产生两个”纯”项 、,再加上三个交叉项 、、。
3.3 第二步——key 与 value 误差的交叉项精确消失
这一步是”加法分解为 key + value”这个结论成立的关键,而且值得指出:其中两项的消失不是近似,而是精确的代数事实。因为 只依赖于 key 扰动 ,而假设 1 保证 key 和 value 误差相互独立,所以对任意 都有 (利用 )。把这个结果代入两个交叉项 和 ——两者都是包含因子 的求和——它们精确地(不只是在主阶近似意义上)变为零。剩下的交叉项 和”纯”项 不能精确消失,但论文把两者都界定在 量级,其中 是 key 引起的对数几率(logit)扰动的一个逐点上界——这个界在噪声尺度 上是四阶及以上的,相对于只有二阶的主导项 和 ,确实是名副其实的高阶余项。
3.4 第三步——value 失真项(精确,无需展开)
因为 value 是线性进入输出的(没有 softmax 挡在中间),这一项完全不需要近似。展开 ,利用 token 独立性和零均值,所有 的项都消失,只留下对角线部分:
其中 是输出投影矩阵的第 行。从左往右读这个公式:value 通道 、token 贡献的失真,等于注意力权重的平方 (这个 token 有多重要),乘以该通道的量化噪声方差 (你把它量化得多粗糙),乘以输出投影对应该通道那一行的范数平方 (该通道的误差在传到输出的路上被放大了多少)。这三个因子各自独立地有意义,而 AATC 之前的标量量化器都没有用到第三个。
这里也值得做一个小对比:如果你只看重建误差 (也就是 KVTC 类方法真正优化的目标),你会得到一个不包含 也不包含 的目标:它会均匀地对待所有 token 的所有 value 通道,即使某个 token 几乎拿不到注意力()、或者某个通道在输出投影中几乎不被读取(),重建误差目标依然会把它们当作同等重要。公式 (5) 告诉你,这种均衡对待在数学上是次优的:若一个通道对输出几乎没有影响,把比特花在它上面就是纯粹的浪费,这部分浪费掉的比特本可以留给真正影响输出的通道。
3.5 第四步——key 失真项(需要对 softmax 做泰勒展开)
因为 key 误差是通过 softmax 起作用的,这一项需要更细致的处理。首先把每个 value 用(常数)输出 重新居中:定义 。因为 精确成立(无论 还是 ,都是求和为一的概率分布),所以可以在 内部把 替换成 而不改变任何东西。接着沿着从未扰动 logits 到受扰动 logits 的射线,对 softmax 响应做泰勒展开(其中 是 key 误差在 token 处引起的标量 logit 扰动):
其中 是注意力加权平均扰动, 是二阶之后的精确泰勒余项。直观上可以这样理解公式 (6):softmax 是一个光滑的非线性函数,当输入 logits 受到一个小扰动 时,输出概率分布也会跟着变化,而泰勒展开就是把这个变化按扰动大小分层拆解:线性项 可以读作“token 的 logit 相对于平均水平高出或低于多少,它的注意力权重就按比例地增加或减少多少”——这是 softmax 在局部的一阶行为,跟普通线性回归的斜率项很像。二次项 描述的是更细微的修正:当扰动足够大时,权重的变化不再与扰动大小严格成正比,而会出现二阶的修正项。论文证明这个二次项对最终失真的贡献恰好为零,意味着只需要线性一阶项就能完全捕捉主导阶失真,这大大简化了后面的推导。线性项 贡献主导阶失真;二次项 对 key-失真交叉项的期望贡献恰好是零(对应原文公式 (23) 的推导:交叉项 化简为 的三阶矩之和,而每一项要么是独立零均值因子的乘积,要么因假设 1 的对称性使 ——所以精确消失,不是近似消失)。泰勒余项 由一条softmax 尾部界(原文 Lemma 1)逐点界定: 对每个 token 都成立,证明方法是沿射线一致地界定 softmax 响应的三阶导数,再对泰勒余项积分公式做积分。
把线性主导项 代入 ,利用 (因为 就是这样构造来居中的)消掉含 的项,再用 (跨 token 独立)以及 (源自通道独立性,对应原文公式 10),可以得到:
同样从左往右读:key 通道 、token 贡献的失真,等于注意力权重的平方 ,乘以如果注意力质量移到或移出 token ,输出会变化多少——残差项 ——乘以该 key 通道的量化噪声,乘以该通道上 query 的分量平方 (当前 query 实际读取该方向的强度)。这个残差项 很微妙,容易被忽略:它衡量的不是”token 的贡献有多大”(那是 的职责),而是”token 的 value 和当前输出有多不同”——一个 value 恰好和输出很接近的 token,对 key 误差是宽容的,因为把注意力错误地分配到它上面或从它上面移走,几乎不会改变输出平均值。
3.6 汇总
其中 , 是绝对常数。余项 随量化噪声减小而渐近消失,在论文测试的比特宽度(2–5 比特)下经验上可忽略不计。从公式 (5) 和 (7) 里能直接看出的关键结构性事实是:失真分解为 token 相关部分和通道相关部分的乘积:
这个分解是定理真正的价值所在:它意味着“哪些通道分配多少比特”这类通道级设计,和“驱逐哪些 token、用多大的滑动窗口”这类 token 级设计,可以互不干扰地独立设计,因为任何一方的最优解都不依赖于另一方。AATC 只利用了这个分解的通道那一半;token 那一半(驱逐)被明确排除在范围之外,作者也明确指出这是未来可以结合起来的工作方向。
值得偷偷提一下这个分解的数学本质:它能成立,根本上是因为在白噪声量化模型下,量化噪声 只依赖于分配给通道 的比特数,与它是哪个 token 无关。正是这个“噪声方差只依赖通道、不依赖 token”的假设,让公式 (5)(7) 里的双重求和可以干净地拆成一个对 token 求和的因子乘以一个对通道求和的因子。如果量化噪声还依赖于具体 token(比如因为不同 token 的数值范围差异很大,导致实际量化步长逐 token 不同),这个因子化就会失效,失真会变成一个 token 和通道两个索引无法分离的联合量,逆水填这套局部、逐通道的机制就无法直接套用了。
值得多说一句的是,公式 (8) 里的余项 并不是一个可以随意忽略的技术细节,它的界定直接依赖于 ——也就是说,余项的大小随着 query 的 范数、key 量化噪声尺度 ,以及量化器的有界性常数 三者乘积增长。在低比特宽下(比如 2 比特), 本身就已经不小, 可能并非微小量,这意味着定理中“余项可忽略”这个前提在极端压缩下并不自动成立。论文在实验部分(第 6.4 节)的处理方式是经验性的:它不依赖这个理论余项界在极端比特宽下依旧成立,而是直接在 1 比特、 1.5 比特这样的真实操作点上跑下游任务并报告实际精度误差,相当于用经验探索代替了理论保证失效后的空白。
4. 在已有工作坐标系里的位置
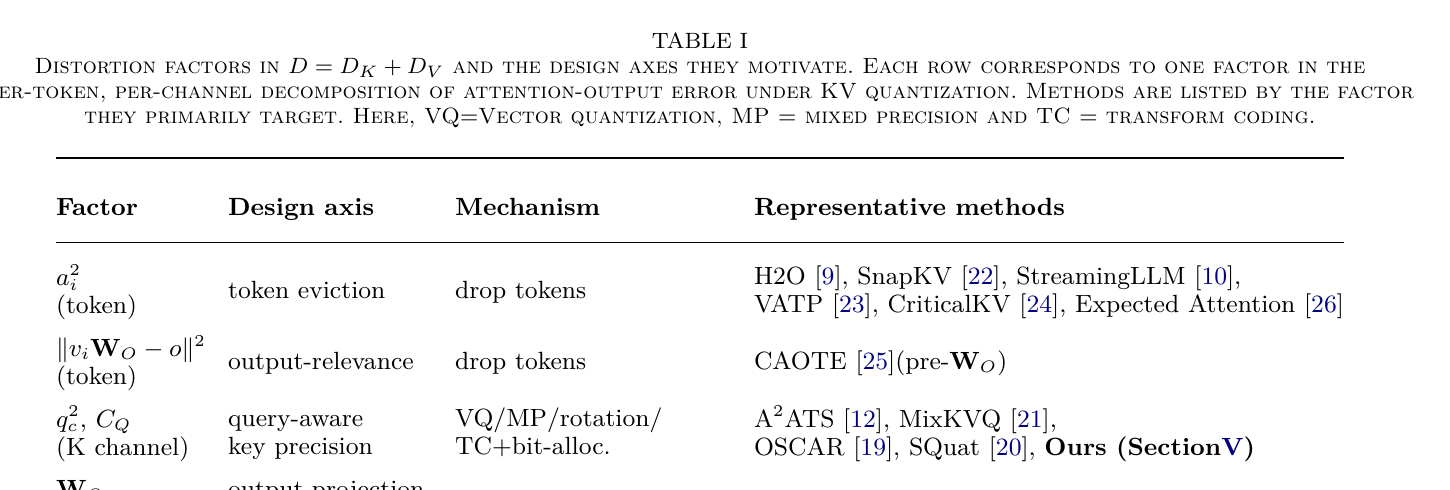
原文 Table I(即上面的图 2)把整个 KV 压缩文献映射到公式 (5) 和 (7) 里出现的五个因子上:token 级的注意力权重 (由 H2O、SnapKV、StreamingLLM 等驱逐类方法针对);token 级的输出相关性残差 (几乎只有 CAOTE 独家针对,不过它是在 之前的 value 空间里操作);通道级的 query 对齐度 (由 A2ATS、MixKVQ、OSCAR、SQuat 通过各种旋转/混合精度机制针对);通道级的输出投影敏感度 (论文声称没有任何前作把它显式当作分配因子——它只在 KVQuant 的 Fisher 敏感度权重里以隐式、与其他梯度纠缠在一起的形式出现);以及经典的逐通道量化敏感度 (几乎所有标量/向量量化方法都针对它,包括 KIVI、KVQuant 和 KVTC)。
这里用一张表更紧凑地总结各代表性方法对 Table I 五个因子的覆盖情况,以及各自的核心机制:
| 方法 | Token 轴(注意力权重 / 相关性) | 通道轴(query / 输出) | 逐通道敏感度 | 分配依据 |
|---|---|---|---|---|
| StreamingLLM / H2O / SnapKV | 按注意力大小硬驱逐 | — | — | 启发式阈值 |
| CAOTE | 输出相关性残差( 之前) | — | — | 闭式驱逐分数 |
| A2ATS / MixKVQ / SQuat | — | Query 感知旋转或投影 | 通过旋转隐式体现 | 旋转后固定精度 |
| OSCAR | — | Query 协方差特征旋转 | 通过旋转隐式体现 | 旋转后均匀 INT2 |
| KIVI | — | — | 逐通道(K)/逐 token(V)尺度 | 固定均匀比特 |
| KVQuant | — | 隐式(纠缠在 Fisher 梯度里) | 非均匀码本、离群值处理 | 敏感度加权码本 |
| PALU | — | — | SVD 截断(固定秩) | 固定秩截断,无比特分配 |
| KVTC | — | — | 全局跨层 PCA + 分配 | 对重建误差做逆水填 |
| AATC(本文) | 未覆盖(留作未来工作) | 显式 与 | 逐层白化 + 加权方差 | 对输出感知失真做逆水填 |
看最后一列最能看清 AATC 的真正主张:它不是第一个用逆水填的(KVTC 早就用了),也不是第一个用 query 感知的(A2ATS、OSCAR 早就用了),更不是第一个暴露通道敏感度的(KIVI、KVQuant 早就用了)——它是第一个把这三种信号全部塞进同一个闭式分配目标里的方法,而不是像之前那样分散到不同机制里(旋转负责 query 感知、码本负责敏感度、PCA 负责去相关)。
这里可以用驱逐类方法作一个反面例子来加深理解:H2O、SnapKV 这一类方法完全不碰通道级的比特分配,它们工作在完全不同的粒度上——整个 token 要么保留全精度、要么直接丢弃。这意味着它们和 AATC 实际上处理的是失真分解的两个正交维度(token 维 vs. 通道维),而不是竞争关系——这也是为什么论文在第 8 节把“与驱逐类方法组合”列为未来工作,而不是把它们当作竞品去对比精度的原因:两者真正合理的关系是叠加,而不是二选一。
这个综合主张是具体且可证伪的:AATC 是第一个把全部四个通道级因子(、,以及两个逐通道敏感度)整合进单一闭式分配准则的方法,而不是挑一个因子用专门机制单独解决。这套综合到底能不能在实证上带来收益(而不只是好看的统一但没有实际效果),正是第 6 节 “AATC var-only” 消融实验要验证的问题——剧透一下:确实有收益,而且恰好体现在压缩比更激进、模型更难压缩的场景里。
5. AATC 算法
5.1 设计概览
flowchart TD
    subgraph Offline["离线校准(每个模型只做一次)"]
        A["校准激活值 X\n(FineWeb + OpenR1-Math)"] --> B["计算输入协方差 Sigma_X\nCholesky 分解: Sigma_X = L L^T"]
        B --> C["白化投影: W_tilde = L^T W\nSVD: W_tilde = U S P^T"]
        C --> D["因子化 W = A B\nA = L^-T U sqrt(S), B = sqrt(S) P^T"]
        D --> E["前向传播: 记录逐通道\n方差 sigma_c^2、query 权重 q_c^2、\n输出权重 ||W_Oc||^2"]
        E --> F["逆水填算法:\n求解比特分配 b*_l,c\n(key 和 value 分别求解)"]
    end
    subgraph Online["在线推理(每个解码步 t)"]
        G["新 token 隐藏状态 x_t"] --> H["投影到去相关基:\nh_t = x_t A"]
        H --> I["每个通道按预分配的\n比特宽度 b*_l,c 量化"]
        I --> J["追加进压缩后的 KV Cache"]
        J --> K["读取时重建:\nK_i = h_i_hat B"]
        K --> L["计算注意力,\n得到输出 o_t"]
    end
    F -."比特表 b*_l,c 已固化".-> I
图 3 完整描绘了这条流水线:左半部分(离线)是定理的全部机器——白化、SVD、公式 (5) 和 (7) 里 query 和输出投影相关的权重、以及逆水填算法——被消耗掉,产出一个单一的产物:一张固定的、逐层逐通道的比特数表。右半部分(在线)故意设计得很简单:它和任何 KV Cache 量化方法都一样,是投影-量化-追加-重建的循环,唯一的区别只在于每个通道用多少比特,而这个区别在推理时不额外花任何代价,因为这张表已经在离线阶段算好了。
AATC 分两个阶段运行,沿用第 2.3 节的变换编码蓝图,只是把失真目标换掉了:
- 离线校准(每个模型一次)。 对每一层,用校准激活值白化 key 和 value 投影,得到去相关变换 ,使原始投影因子化为 。在校准数据上做前向传播,估计融合了公式 (5)、(7) 中 query 项和输出投影项的逐通道加权方差。求解逆水填问题(公式 3 的加权版本),得到逐通道比特分配。
- 在线推理(每个解码步)。 不缓存原始的 key/value 投影,而是缓存变换后的表示,按预先计算好的比特分配量化每个变换后的通道,在计算注意力之前实时重建原始 key/value。
5.2 第一步:基于白化的特征去相关
给定校准激活值 和一个投影矩阵 (可以是 或 ),定义经验输入协方差 ,及其 Cholesky 分解 。白化后的权重矩阵是 ——它把输入的相关结构吸收进了投影矩阵,所以 的 SVD 给出的奇异向量,是针对实际缓存的激活值去相关,而不只是针对原始权重矩阵。把 因子化,其中 、,缓存就存储变换后的表示 (value 同理为 )而不是原始的 key/value 投影,重建时通过 恢复原始 key。 各维度是去相关的,并按奇异值 ——输入方差与投影幅度的综合效应——排序;高索引(小奇异值)的维度对输出贡献很小,是低精度或零比特分配的天然候选。
论文证明(其 Proposition 1)这种基于白化的 SVD,在得到的变换上等价于直接对 (实际缓存的激活值)做 PCA。这个等价关系很重要,因为它意味着 AATC 的去相关步骤与 KVTC(最接近的前作)的做法完全一致,所以 AATC 和 KVTC 之间任何经验上的差距,都一定完全来自分配步骤,而不是变换步骤——这为定位论文贡献的真正落点提供了一个干净的分割方式。
5.3 第二步:通过水填算法做注意力感知比特分配
有了变换之后,key 的逐通道比特分配问题是求解:
逐通道权重 在校准 token 上估计得到(value 有类似的问题,,完全不依赖 query——这与公式 (5) 一致,value 的通道因子就是纯粹的 )。这正是第 2.3 节的加权逆水填问题,只不过被分配的”能量”不再是原始的通道方差 ,而是注意力感知的加权方差 。闭式解和公式 (3) 形式一致:
有一处细节值得明确指出:在压缩阶段,公式 (5)、(7) 里的真实逐 token 注意力权重 和残差 都是拿不到的——推理还没开始跑。论文的解决办法是把 token 相关因子从分配准则里彻底去掉(回忆第 3.6 节的分解:token 级和通道级两个设计轴是相互独立的,所以这是一个有原则的简化,不是权宜之计),然后在校准 query 上对剩下的通道相关因子 取平均。因此这个分配方案是真实逐 token 失真的一个注意力无关的代理——在校准分布上平均而言表现好,但对任何单个解码步具体的注意力模式必然是”盲”的。
一个具体的数值例子。 为了让公式 (11) 更直观,考虑一个玩具场景:某一层只有 个变换后的 key 通道,key 的总比特预算 比特(平均每通道 1.5 比特)。假设校准得到的加权能量为 (;通道 1 携带最多的 query 加权方差,通道 4 最少)。逆水填要找到水位线 ,使得 。先试 :通道 1 得到 比特,通道 2 得到 比特,通道 3 得到 比特,通道 4 因为 ,拿到零比特(直接丢弃——它的能量低于水位线)。总计 比特,不到 6 比特预算,所以 要调低。再试 :通道 1 得到 ,通道 2 得到 ,通道 3 得到 ,通道 4 这次超过了(更低的)水位线,拿到 ——总计 ,又超过了预算。真正的解就在这两次试探之间;精确求解 (此处四个通道都在水位线以上,因为预算足够宽裕)可以得到 ,对应的分数比特数约为 ,在论文实际使用的离散求解器里,会被舍入到 约束下最接近的可行整数分配。定性结论在舍入之后依然成立:通道 1(能量 8)得到的比特宽度大约是通道 3(能量 1)的 8 倍,而通道 4(能量 0.25,比通道 1 小 32 倍)是第一个被判定为零比特截断的候选——这正是固定精度量化器(会给所有四个通道分配相同的 1.5 比特)无法表达的、按能量比例自适应分配的行为。
5.4 完整算法
算法 1:面向 KV Cache 压缩的注意力感知变换编码(AATC)
输入:模型权重 {W_K^(l), W_V^(l), W_O^(l)};校准数据 X;比特预算 B;最小比特数 b_min
输出:带有注意力感知比特分配的压缩 KV Cache

  ── 校准阶段(离线,每个模型一次) ──
  1: for 每一层 l do
  2:     计算 Sigma_X^(l),Cholesky 因子 L^(l)
  3:     对白化后的 W_K^(l) 做 SVD:得到 A_K^(l)、B_K^(l)        // 对应第 5.2 节
  4:     跑一次前向传播;为每个通道 c 记录隐变量方差 (sigma_{l,c}^(K))^2
  5:     计算 w_{l,c}^(K) <- (1/T) * sum_i ( (B_K^(l))[c,:] . q_i )^2   // query 感知的 key 权重
  6:     计算 B_V^(l)、sigma_{l,c}^(V)、w_{l,c}^(V) <- || (B_V^(l) W_O^(l))^T[:,c] ||_F^2  // 输出感知的 value 权重
  7: end for
  8: 在所有 (l, c) 上做全局逆水填分配比特:
         { b_{l,c}^(K) } <- argmin_{sum b_c <= B_K}  sum_{l,c} w_{l,c}^(K) * (sigma_{l,c}^(K))^2 * 2^(-2 b_{l,c})
         { b_{l,c}^(V) } <- argmin_{sum b_c <= B_V}  sum_{l,c} w_{l,c}^(V) * (sigma_{l,c}^(V))^2 * 2^(-2 b_{l,c})

  ── 推理阶段(在线,每个解码步 t) ──
  9: for 每个新 token,在步骤 t do
 10:     for 每一层 l do
 11:         投影:  h_t^K <- x_t A_K^(l),   h_t^V <- x_t A_V^(l)
 12:         按已校准好的比特分配,逐通道量化 h_t^K、h_t^V;追加进缓存
 13:         重建: K_i <- h_i^K_hat B_K^(l),   V_i <- h_i^V_hat B_V^(l)
 14:         计算注意力权重 alpha_{t,i} <- softmax(q_t K_i^T / sqrt(d))
 15:         输出: o_t <- sum_{i<=t} alpha_{t,i} V_i
 16:     end for
 17: end for
逐步用文字讲解一遍:第 1–7 行只跑一次、离线执行,它们的任务完全是刻画每一层 key/value 在注意力感知加权下的统计特性——Cholesky/SVD 给出去相关的基,在校准数据上的前向传播给出逐通道方差以及驱动分配的 query/输出投影权重。第 8 行用公式 (11) 的闭式解,求解两个独立的逆水填问题(key 一个、value 一个,对应论文”分开设预算”这一设计选择,下文会讨论),产出一张固定的、逐层逐通道比特数表,固化进部署的模型里。第 9–17 行是真正的服务循环:每个新 token 被投影到去相关基里,按预先分配好的逐通道比特宽度量化,追加进压缩后的缓存,在注意力需要读取它的任何时刻实时重建(乘回 )。关键在于,分配这一步(第 8 行)在推理时从不运行——它在校准阶段就已经烤进模型里了——所以推理时唯一新增的开销,就是每层每 token 两次矩阵乘法(变换和逆变换),外加任何量化方法本来就要付出的标准量化/反量化运算。
用一个具体的时间线来看这个算法在实际部署中的生命周期:模型上线前,先跑一次离线校准(算法 1 的 1–8 行),耗时与 256 条校准序列的前向传播成正比,一般在单张 GPU 上是分钟级;校准产出的变换矩阵 和比特表 随模型权重一起分发。模型上线后,每个推理请求的每个解码步都只执行算法 1 的 9–17 行,这一部分完全不依赖任何网络请求或等待,与现有服务框架(vLLM、SGLang)里的标准量化接口完全兼容,只是把固定的每通道比特数换成了一张预先算好的表,而不是在每次前向传播中重新计算。
论文还额外用了一个近期窗口机制:最前面 个 token 和最近的 个 token 始终保持全精度(这是与 KVTC、StreamingLLM 共享的标准技巧,因为注意力汇聚点和刚生成的近期 token 往往格外重要,而保留它们全精度的代价很小)。窗口填满后,最旧的 16 个 token 被量化,窗口重新填充——这是一个驱逐式的批处理细节,避免每个 token 都重新量化一次。
5.5 设计选择讨论
为什么 key 和 value 用独立的比特预算,而不是共用一个池子? 因为公式 (5)、(7) 表明 key 和 value 在失真中是通过结构完全不同的通道权重进入的——key 是 query 对齐度 ,value 是输出投影敏感度 ——把两者塞进同一个水填问题里,会隐式地假设这两个量纲完全不同的量处于同一数值尺度上,而实际上如果不做仔细的归一化,它们并不在同一尺度。显而易见的替代方案是用一个跨 key/value 共享水位线的联合分配;论文没有直接报告这项消融(下文批判性评价里会提到这是一个空缺),但这个设计选择在架构上是站得住脚的:key 和 value 在注意力计算里确实扮演着不对称的角色,强行走同一个预算需要额外的校准步骤才能让两个权重尺度可比。
为什么用逐层变换,而不是像 KVTC 那样用一个全局的跨层变换? 论文给出的理由是,每一层在系统架构上本来就维护自己独立的 KV Cache,所以逐层变换是”自然的粒度”。值得注意的边界条件是:全局跨层变换原则上可以捕捉层与层之间的相关性(比如残差流的连续性意味着相邻层的激活值并非独立),而逐层变换在结构上做不到这一点。论文确实加了一个跨层归一化步骤(在做全局比特分配之前,先用每层自己的 95 百分位数归一化 ),专门用来修正”浅层激活值幅度天然更小,如果不修正就会系统性地分不到比特”这个问题——这也间接承认了纯逐层处理确实存在一个需要打补丁的真实失效模式。
为什么用基于白化的 SVD,而不是直接求解理论上最优的(注意力感知)变换? 论文明确说明它没有单独针对 query 感知去优化旋转方向(对应第 4 节讨论的原文 Section IV-B/C):白化变换只根据输入统计量做去相关,query 感知只通过比特分配这一环节引入,而不通过旋转引入。作者指出这是刻意避免重复计数的设计:像 OSCAR 这样既做 query 感知旋转、又对旋转后的通道均匀分配比特的方法,是用不同机制针对同一个 query 对齐信号,把两者(query 感知旋转 和 query 感知分配)结合起来,是留给未来工作的一个开放组合方向。边界条件是:如果白化得到的基恰好和 query 实际读取的方向对不齐,再聪明的比特分配也无法在固定基内完全弥补——分配步骤可以在固定基内重新加权重要性,但无法旋转基本身。
为什么用 0 到 16 比特的整数逆水填分配,而不是连续/学习式的比特分配? 逆水填给出闭式解,校准成本很低,不需要任何基于梯度的训练——这是一个真实的实践优势,因为整条流水线在部署时每个模型只跑一次,而不需要昂贵的、基于学习的分配训练循环。替代方案(比如用一个小的学习网络,类似超网络的思路,来预测逐通道比特数)原则上可以更精细地适应非高斯的通道分布(此时逆水填背后的高码率近似会失效),但代价是需要带标签的优化数据,并且失去闭式解的干净可解释性。
把这五个设计选择放在一起看,一个贯穿的主题浮现出来:AATC 在每一个分叉口都选择了“闭式、信息量充分但不完美”的方案,而不是“理论最优但工程代价昂贵”的方案。分开预算、逐层变换而不旋转、整数逆水填而不学习——每一项都是一个在“更精确但更昂贵”和“足够好但带能部署”之间的权衡,而论文每次都偏向后者。这本身不是缺点——一篇面向实际部署的论文做这样的取舍很合理——但对读者来说值得明确意识到:论文真正的创新在于第 3 节的失真分解定理,而第 5 节的具体工程选择大多是工程实用主义的产物,未必都是从定理中必然推导出来的唯一最优选择。
6. 实验
6.1 实验设置
AATC 在 Llama-3.1-8B-Instruct 和 Qwen-2.5-7B-Instruct 上,与三个基线做对比:KIVI(逐通道 key / 逐 token value 标量量化)、PALU(基于 SVD 的低秩截断)、KVQuant(非均匀、敏感度加权量化)。评测集覆盖长上下文理解(LongBench,对七个英文子任务取平均)、多长度长上下文检索(RULER,4k–32k),以及推理密集型任务(GSM8K、MMLU-Pro 数学/计算机科学子集、MATH-500)。校准使用 256 条长度为 2048 的序列,FineWeb(通用网页文本)和 OpenR1-Math-220k(数学推理轨迹)各占一半——这个混合比例是刻意选择的,目的是同时覆盖通用领域和结构化推理的激活统计特征,沿用了 KVTC 的校准协议。一个重要的消融变体 AATC var-only,使用完全相同的变换和逆水填机制,但去掉了注意力感知的权重 和 ,只按量化误差方差分配比特——论文证明这个变体在数学上等价于一个逐层版本的 KVTC,所以它精确隔离出了注意力感知加权相比最接近的前作变换编码方法,到底能多带来多少收益。
为了公平对比,论文对三个基线都做了针对性的复现和统一化处理,这部分实现细节本身也值得记一笔,因为它直接影响到最终数字能不能拿来做头对头比较。KIVI 按原始实现复现,key 用逐通道非对称量化、value 用逐 token 量化,配 128-token 的近期窗口(每 32 个 token 刷新一批),并保留最前面 4 个 token 全精度。PALU 使用其 Fisher-uniform 实现,head-group 大小设为 4,分解方法用 whiten,低秩部分同样配 128-token 滑动窗口(步长 16)并保留前 4 个 token,量化时对低秩部分额外用了 Hadamard 旋转。KVQuant 按原论文复现,key 在 RoPE 之前逐通道量化、value 逐 token 量化,用敏感度加权的非均匀码本( 个信号点,通过 Fisher 敏感度加权 k-means 得到),并实现了其“稠密+稀疏”分解机制(将幅值前 1% 的离群点保留在全精度)。为公平起见,三个基线都与 AATC 保持相同的 128-token 全精度近期窗口预算,确保差异仅来自量化方法本身,而不是近期窗口配置不一致。
6.2 主要结果
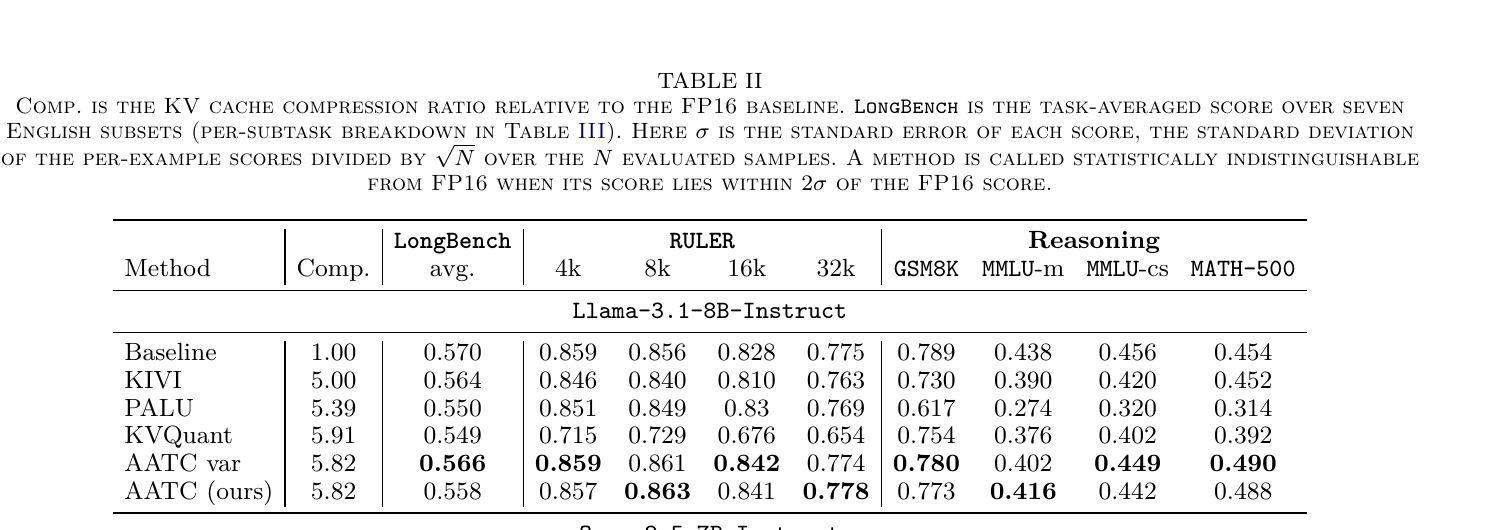
在一路看具体数字之前,先回忆一下评估协议:论文对每个 benchmark 都计算了标准误差 σ(即逐样本得分的标准差除以 √N,N 为评测样本数),并将误差落在 FP16 基线两倍标准误差以内的方法定义为“与 FP16 无法区分”。在这个严格的统计定义下,在其主打的 5.82 倍压缩操作点(平均每元素约 2.5 比特),AATC 把 Llama 的显存预算从 1.07 GB 降到 184 MB。两个骨干模型对压缩的反应差异很大,这本身就是一个有信息量的结果:在 Llama 上,即使朴素的标量基线 KIVI 也能保持近乎无损,AATC 和它的 var-only 消融版本几乎全程打平——因为可供挑选的失真空间已经很少了,注意力感知在这里带不来额外收益。在 Qwen 上,作者认定它明显更难压缩(KIVI 崩溃到 LongBench 均分 0.351、RULER 低于 0.28,而 FP16 基线是 0.574/0.720),AATC 是长上下文检索(RULER-32k,比最强基线高出 7.2 分)和 MMLU-Pro 数学(高出 16.8 分)上唯一表现最好的压缩方法。PALU 只在短上下文有竞争力(在 Qwen 的 RULER-4k 上最好),但它的 LongBench 均分是所有方法中最弱的(0.483),论文将其归因于固定秩低秩参数化丢失了长距离检索和精确匹配式代码补全所依赖的细粒度、逐 token 信息。
再往细处看,论文附录还报告了一份按 LongBench 子任务拆解的表格,揭示了 PALU 在 Qwen 上均分垫底的具体原因:退化几乎完全集中在两个代码补全子任务上(RepoBench-P 从 FP16 的 0.67 掉到 0.34,LCC 从 0.61 掉到 0.48),而摘要类任务(QMSum)几乎无损(0.237 对 0.234)。这正是低秩截断的典型信号特征:被截断掉的低能量子空间恰好携带着代码补全和长距离精确检索所依赖的细粒度、逐 token 信息,而摘要这类更依赖全局语义的任务对丢失这些细节不敏感。反过来看,这也解释了 AATC 为什么在 RepoBench-P、LCC 这类任务上相对 PALU 有更大优势——它没有做硬性截断,而是让每个通道按其真实的注意力感知能量连续地获得或多或少的比特,细节最丰富的通道不会被一刀切地清零。
6.3 隔离出注意力感知的贡献
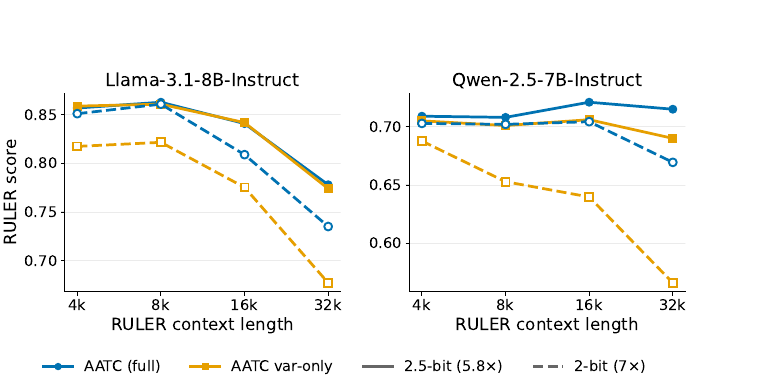
在主打的 5.82 倍操作点,AATC var-only 在 Llama 上和完整版在统计上无法区分——这立刻引出了作者自己提出的问题:注意力感知加权到底是不是必要的?图 5 用一个更激进的约 7 倍压缩(2 比特预算,虚线)来回答这个问题。在 2.5 比特(实线)下,两个变体在 Llama 的所有上下文长度上都无法区分。在 2 比特(虚线)下,完整方法在两个模型的所有上下文长度上都保持接近基线的 RULER 精度,而 var-only 消融版本随上下文变长急剧退化——最戏剧性的是 Llama 在 32k 长度处,var-only 跌到约 0.68,而完整版 AATC 保持在约 0.78 附近。这是一种诚实且干净的消融呈现方式:作者没有挑一个自家方法表现最好的操作点来展示,而是主动去寻找两个变体会分道扬镳的区间并如实报告。发现本身回头看很直观:注意力感知加权最重要的场景,恰恰是压缩激进到必须牺牲某些通道的时候——加权的全部工作就是决定牺牲哪些通道,而当比特预算足够所有通道都够用时,这个选择就无关紧要了。
6.4 不同比特预算下的鲁棒性
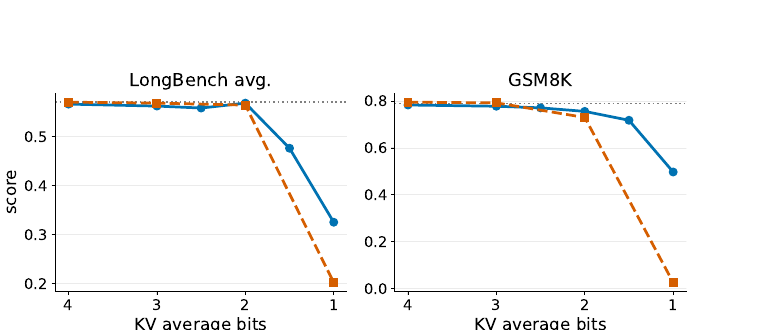
把平均比特预算从 4 比特扫到 1 比特(图 6)可以看到 AATC 退化得很平缓:LongBench 均分在 4 比特到 2 比特之间基本贴着 FP16(噪声范围内),GSM8K 平稳下降,只有到 1.5 比特及以下才出现明显跌落。在极端的 1 比特设置下,AATC 依然比 KIVI 稳健得多(LongBench 0.33 对 0.20;GSM8K 0.50 对 0.03)——这个巨大的差距说明,一旦固定精度量化撑不住了,基于变换加分配的自适应压缩方式在实际中价值有多大。论文自己对两个设计轴(分配策略、校准语料)在 2 比特操作点做的消融,把这种鲁棒性大部分归功于自适应分配本身:换成所有通道共享单一全局分配方案会损失 8.6 个 LongBench 点,仅仅去掉 query 范数项 就损失 3.8 个点,而去掉输出投影项 或改用逐层(而非逐通道)分配,损失都不到 2 个点——这为判断设计中哪些部分承担了大部分的实证权重提供了有用的信号。
把 6.2 到 6.4 的证据串起来看,一个稳健的因果链条浮现出来:注意力感知的加权(区别于 var-only)在压缩比温和时不带来任何可测量的收益,只有当压缩比推进到 2 比特左右、且模型本身就比较难压(Qwen 而非 Llama)时才开始显现优势;而这个优势的来源被消融实验精确定位到了自适应分配本身,而不是某个具体的因子。这意味着如果实际部署场景只需要 4-5 倍压缩比,选择 var-only(即退化为逐层版 KVTC)几乎不会有任何损失,却能省下计算 和 权重的额外校准开销——这是一条对工程决策直接有用的经验法则,但论文本身没有把它明确总结出来。
从注意力权重到失真贡献的一个直观小例子。 为了让公式 (7) 里的残差项 不那么抽象,设想一个只有 3 个 token 的极简解码步:token A 的注意力权重 ,其 恰好和输出 几乎重合(残差趋近于零);token B 的权重 ,其 与 相差较大(残差较大);token C 的权重 ,残差同样较大。按照公式 (7),尽管 A 拿到了最大的注意力权重(,远大于 和 ),但由于它的残差项趋近于零,A 的 key 量化误差对最终失真的贡献反而可能小于 B——因为哪怕把注意力错误地从 A 移到别处,由于 A 的 value 本来就和输出差不多,输出几乎不变;而 B 尽管权重小,但一旦注意力错误地移动到它身上,会显著拉偏输出。这正是论文强调的一点:决定 key 通道分配多少比特,不能只看注意力权重 本身有多大,还要结合这个 token 的 value 相对输出到底有多”特立独行”——两者相乘才是真正驱动失真的量。
7. 可复现性说明
为了方便后续复现工作直接对照,这里把论文报告的关键超参数汇总成一张表:
| 超参数 | 取值 | 备注 |
|---|---|---|
| 校准序列数 | 256 | FineWeb 与 OpenR1-Math-220k 各 128 条 |
| 校准序列长度 | 2048 token | 两个语料混合后打乱 |
| 白化用语料 | WikiText-2 | 与率失真校准语料不同 |
| 全精度近期窗口 | 128 token | 满了后批量刷新 16 个 |
| 全精度前缀 | 4 token | 对应注意力 sink |
| 每通道比特范围 | 0–16 | 整数逆水填搜索空间 |
| 前三层额外加持 | value 平均比特 / key +1 | 补偿浅层激活幅度偏小 |
| Llama head-group | 2 | 对应 8 个 KV head |
| Qwen head-group | 1 | 对应 4 个 KV head |
论文精确报告了校准超参数(256 条序列 × 2048 token,FineWeb/OpenR1-Math-220k 各半,用 WikiText-2 做白化)、近期窗口配置(前 4 个 token + 后 128 个 token 全精度,16-token 批量刷新),以及对前三个 Transformer 层的特殊处理(给它们分配平均的 value 比特数、外加一比特额外的 key 比特,以补偿它们系统性偏小的激活幅度)。没有完全给出、需要向作者索取或自行重新推导才能精确复现的部分包括:超出所述 0-16 范围之外的实际 bmax 上限取值细节、(Llama)与 (Qwen)这一 head-grouping 选择在”匹配 KV-head 数量”之外的完整理由,以及论文重新实现的 KIVI/KVQuant(论文明确说”为公平起见”重新实现了两个基线并加上了近期窗口)是否与原论文报告的数字足够接近,以排除重新实现带来的差距—这是任何重新实现自己基线的论文都普遍存在、且经常没有充分说明的风险。本次复审所见版本没有引用训练代码或公开仓库,因此完整的数值复现需要根据论文给出的公式重新实现白化-SVD 流水线(第 5.2 节)和逆水填求解器(第 5.3 节)——这些公式足够精确,可以据此实现,但工程上并不轻松,尤其是“先逐层归一化、再做全局分配”这一步,很容易在细节上出错。
对想自己从零实现一个 AATC 原型的读者,一个实际的建议是先从单层、单个 head-group 的白化-SVD-重建管道写起,并用一个小型模型(比如 GPT-2 small)验证重建误差为零(即未量化情况下,变换再逆变换应该完全恢复原始 key/value),确认白化-SVD 分解本身实现正确之后,再引入比特分配和量化误差,而不是一开始就在完整多层、多 head-group 的设置上调试,这样能大大降低定位 bug 的难度。
7.5 一个端到端的小型数值演算
为了把前面所有公式串起来,这里做一个完整的、从头到尾的小型手算例子。假设我们只看某一层、某一个头,key 变换后有 2 个通道,校准得到的方差为 、,对应的 query 加权项为 、(即通道 1 方差大且 query 对它的关注度也高),比特预算为 比特(平均每通道 1 比特)。
第一步,计算加权能量 :通道 1 为 ,通道 2 为 。第二步,解逆水填方程 ,化简为 ,即 ,解得 ,。第三步,代回去求每通道比特数:通道 1 得到 比特,通道 2 得到 比特。四舍五入到整数后,实际部署中可能取通道 1 = 2 比特、通道 2 = 0 比特(因为 0.26 比特在整数约束下向下取整往往直接变为 0),总比特数仍为 2,与预算匹配。这个结果直接验证了前面的定性结论:既方差大、query 又关注的通道拿到大部分比特,而另一个通道完全被舍弃。
8. 局限性
作者对若干局限性相当坦诚。假设 1 里的跨 token 独立性被明确标注为一种理想化:自然语言在相邻 token 的 KV 表示之间存在非平凡的相关结构,而利用这种相关性需要一个计算上不可行的逐 token 变化的比特分配——所以论文接受这个理想化是实践上的必要妥协,是几乎所有前作量化方法共享的假设,而不是声称它符合现实。在系统层面,实现明确没有做生产级优化:没有专门的 CUDA 内核,作者指出这是方法真正部署前必须补上的一环。评测只覆盖了两个模型家族(Llama 和 Qwen),作者标注在更广泛的架构上(包括分组查询注意力之外差异更大的注意力变体)做测试,留待未来工作。最后,论文把”结合 AATC 与 token 驱逐方法”(回忆第 4 节的观察:token 级和通道级设计轴相互独立、因此可组合)以及”把逐层分配扩展到 KVTC 那种全局跨层缓存”都列为开放方向。
9. 批判性分析
这篇论文特有的弱点。 第一,“没有前作把 当作显式分配因子”这个招牌式主张,虽然看起来合理,但建立在一个论文自己表述得略显宽泛的文献梳理之上——KVQuant 的 Fisher 敏感度加权被描述为”只隐式地、与其余下游梯度纠缠在一起”包含 ,这个说法本身没错,但作为区分性主张也有些难以证伪:任何使用端到端损失梯度的方法,其敏感度信号里都会必然纠缠着每一个下游权重矩阵,所以真正有意思的问题是,像 AATC 这样显式地把 解耦出来,相比纠缠在一起的 Fisher 敏感度做法,在相同压缩比下是否能产生可测量的、更好的分配结果——而论文并没有直接做这项对比(KVQuant 是作为完整流水线被比较的,而不是就这一个具体因子单独做对照)。第二,“AATC var-only 是 KVTC 的逐层版本”这一等价性主张(第 5.2 节,Proposition 1)只是变换层面的等价,不是完整流水线的等价——KVTC 是在全局跨层缓存上运行、有自己的分配准则的,所以论文正文 Table II 里 AATC 与”KVTC 实际实现”的直接对比,本该比论文用来替代它的内部 var-only 消融,更直接地检验”逐层是否有帮助”这个问题;但 KVTC 完全没有出现在论文主实验 Table II 里,只出现在相关工作讨论中——考虑到论文全篇都在明确地把自己定位为相对 KVTC 的改进,这个缺失相当显眼。第三,论文对 var-only 消融的解读也有一处值得推敎的地方:它将 var-only 在 Llama 上与完整版无法区分解读为“注意力感知在具体此处不必要”,但同样的数据也可以解读为“Llama 本身就非常容易压缩,以至于任何合理的分配方案都能近乎无损”——这两种解读对方法本身的价值判断完全不同(前者说明方法设计得很好但环境不需要它,后者说明环境本身无法区分任何方法的优劣),而论文只采用了前一种解读,没有讨论后者的可能性。
作者低估或省略的局限性。 论文”率先暴露 、率先统一全部四个通道级因子”的招牌主张,是一个关于显式程度的定位主张,而不是关于最终效果的主张—而第 6.4 节的消融本身就显示,去掉 (论文最独特的单项创新)只损失不到 2 个 LongBench 点,相比之下去掉整个自适应分配会损失 8.6 个点—也就是说,论文自己报告的数字表明, 是被消融的各个组件里贡献最小的一个。论文虽然自己报告了这个数字,但没有像一个想要判断”从零实现时到底该采纳哪个洞见”的读者所希望的那样,把”这是我们的核心理论创新”和”这是影响最小的消融项”之间的张力讲得足够清楚。第二,校准流程依赖一个特定的混合语料(FineWeb + OpenR1-Math),这意味着报告的鲁棒性有可能部分归功于校准分布和评测分布本身就比较接近(两者都包含通用文本和数学推理,对应评测集里的 GSM8K/MATH-500/MMLU-Pro-math);论文自己的校准消融显示 GSM8K “不受任何校准变体影响”,这是令人安心的,但一个真正跨域的校准测试(比如只用代码做校准,却在数学上评测)没有被报告,而这样的测试能更直接地压力测试“方法能否泛化到校准分布之外”这个主张。第三,论文对 GSM8K “不受任何校准变体影响”这个结果的解读也值得谨慎:这可能意味着校准语料对数学推理能力真的不敏感,也可能只是因为 GSM8K 本身的任务难度在 5.82 倍这个温和的压缩比下对所有校准变体都不敏感——要区分这两种解释,需要在更激进的压缩比(比如 1.5 比特或以下)下重新跑一遍同样的校准消融,而论文目前只在 2 比特操作点做了这项消融。
从系统工程视角补充一点。 论文报告的 5.8 倍压缩比是一个理论显存数字,实际部署时还要考虑量化/反量化本身引入的计算开销、以及变换矩阵 的存储代价(虽然它们只依赖模型、不依赖序列长度,可以一次性常驻显存,但对多模型多租户的服务场景仍是额外开销)。
具体的改进建议:(1) 在两个骨干模型、相同压缩比下,直接与真实的 KVTC 流水线(而不只是内部 var-only 代理)做头对头对比,用实证而不是”等价性证明+代理消融”的组合来验证所声称的”逐层优于全局变换”的优势。(2) 明确跑一次联合 key-value 预算的消融实验(用适当的权重归一化,把 key 和 value 塞进同一个逆水填池子),用数据而不仅仅是架构层面的推理来证明”分开设预算”这一设计选择的合理性。(3) 增加一项真正跨域的校准鲁棒性测试——在一个领域(比如代码,或单一语种)上校准,在一个不相交的领域(比如另一种语言的长文档问答,或数学)上评测——用来界定”近乎无损”的结果到底在多大程度上依赖于校准分布与评测分布的重叠,因为目前的校准混合语料和评测套件本身就有相当程度的领域重叠。(4) 提供承诺中的 CUDA 内核,或者至少在真实服务栈(vLLM 式批量解码)下给出墙钟延迟/吞吐量测量,因为在此之前,5.8 倍的显存压缩主张还无法转化为对应的服务吞吐量或延迟主张,而后者才是 KV Cache 压缩最终要解决的问题。
10. 结语
回顾这篇笔记整体走过的路径:从重建误差到输出感知失真的转变,看似只是一个目标函数的替换,实际上带来了三个相互独立又相互支撑的改变:它让 query 和输出投影第一次以闭式、可推导的方式进入比特分配公式;它把之前分散在驱逐、旋转、量化三个领域的相关方法统一到了同一张坐标系里;它也为后续工作留下了一个明确的开口——token 级和通道级设计可以相互独立地组合,意味着未来完全可以在不重新推导任何东西的前提下,把 AATC 的通道分配与任何一种 token 驱逐方法直接拼接在一起。
对于真正关心工程落地的读者,最值得带走的一句话可能是这样:在压缩比不是极端情况(比如 4-5 倍以内)时,不要花额外的校准开销去计算 和 ,直接用 AATC var-only(等价于逐层版 KVTC)就够了;只有当你需要推到 2 比特左右、又正好遇上一个本身就难压缩的模型时,完整版 AATC 才真正能发挥作用。这个结论本身不应该被看作对 AATC 的负面评价——相反,它正是论文证明自己实验设计严谨的侁证:作者没有只在自己方法最有利的操作点上报告数字,而是诚实地把方法优势的边界划得清清楚楚。
AATC 的贡献更准确地说是一次推导,而不是一次发明:变换编码和逆水填这套机器已经有几十年历史,针对 KV Cache 的逐通道比特分配也已经在 KVTC 里出现过。AATC 真正补上的,是一个严谨的、闭式的答案,回答了”到底该针对哪个量去分配比特”这个问题——证明了在标准白噪声量化模型下,注意力输出失真可以精确地加法分解为 key 项和 value 项,且每一项都能干净地分解为 token 相关和通道相关两个因子的乘积。这个分解本身的价值独立于 AATC 具体的算法:它为整个领域提供了一套共同的数学语言(Table I 的五个因子),让驱逐类方法、旋转类方法、量化类方法这些原本看起来互不相干的技巧,可以在同一个坐标系里被比较。建立在这个分解之上的算法,是把逆水填直接应用到新推导出的加权方差上——没有学习式组件,没有奇特的码本——这对于一旦有了生产级内核之后的可部署性来说是真正的优势;而实证故事(在 5.8 倍压缩比下近乎无损,在 7 倍及以下比固定精度基线明显更稳健)也报告得相当诚实,包括那项清楚显示”注意力感知恰好在你预期它会起作用的地方——激进压缩、长上下文、每一比特都很紧张的场景——真正起作用”的消融实验。