笔记日期: 2026-11-13(UTC)
作者: Zhongzhu Zhou
所读论文: DictLLM: Post-training Compression of Large Language Model with Dictionary Kernels
论文作者: Jinho Park、Se Young Chun、Mingoo Seok
arXiv: 2611.08082v1,2026-11-05
先看清楚:究竟在共享什么
压缩两个相邻的 Transformer 层时,可以分别做低秩分解,也可以让两个层用同一组输入方向,但允许它们以不同的方式组合这些方向。第二种做法就是这篇论文的起点:用一个共享字典存下组内共用的方向,每层仍保留自己的系数矩阵。每个输出只用一部分字典项时,字典可以比单靠低秩压缩时更宽。论文再做一步很实用的修补:系数剪完以后,把这些系数固定住,重新拟合一次字典。最后,两类因子分别量化。
阅读时我把摘要和附录的两组数字分开记。约 5.1 倍是按论文的投影参数与 NVFP4 格式口径计算的表示压缩;相应的 WikiText-2 困惑度从 5.68 到 8.48。1.24 倍则来自附录 A8 的 FP16 解码计时,在指定 GPU、批大小为 1、有稀疏后端且不计预填充的条件下成立。两者回答的问题分别是「能表示得多小」和「这一套执行路径快了多少」。全文 24 页及附录 A1 至 A10 都纳入本笔记。下面的小矩阵是我用来检查推导的算例,模型和硬件结果均来自论文。
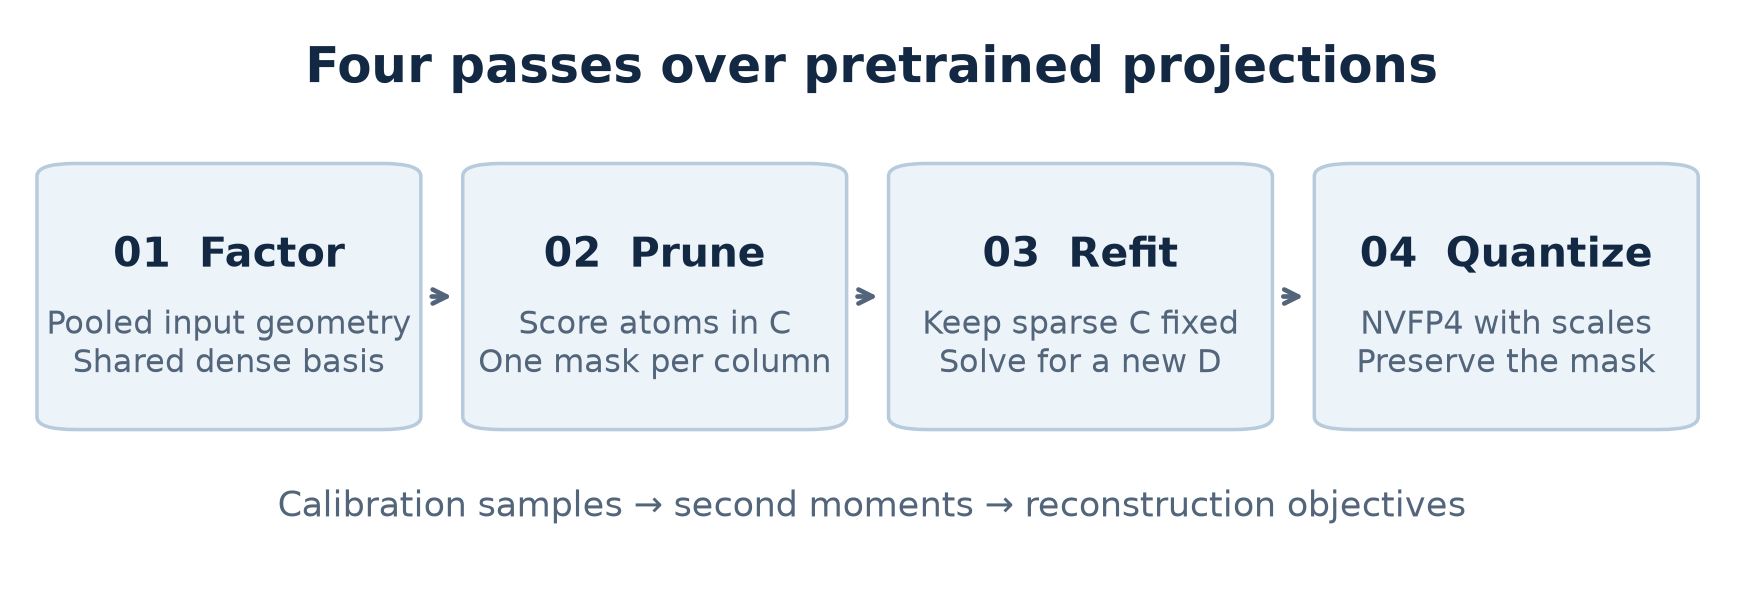
图 1:依据原文第 3 节自绘。剪枝改变了每个输出列能够访问的字典项;重拟合在支撑固定后重新寻找共享方向。
前置知识:把投影拆成两次乘法
设一层的输入 每行对应一个 token,权重 的形状为 。原始层输出是 。按论文的矩阵方向,字典 的每列都是一个输入方向,系数 的每列说明一个输出通道如何组合这些方向。组 的字典宽度记为 :
共享的是 的参数。即使两层先后执行,输入也已经被中间的注意力、残差或非线性改变,两层的 不能互用。共享能够减少静态容量;能不能少从显存读取一次,还取决于字典在两次访问间能否留在较快的存储层。部署若把两因子预先乘回完整矩阵,便失去这条节省路径。两次乘法也可能增加一次中间特征的写回。
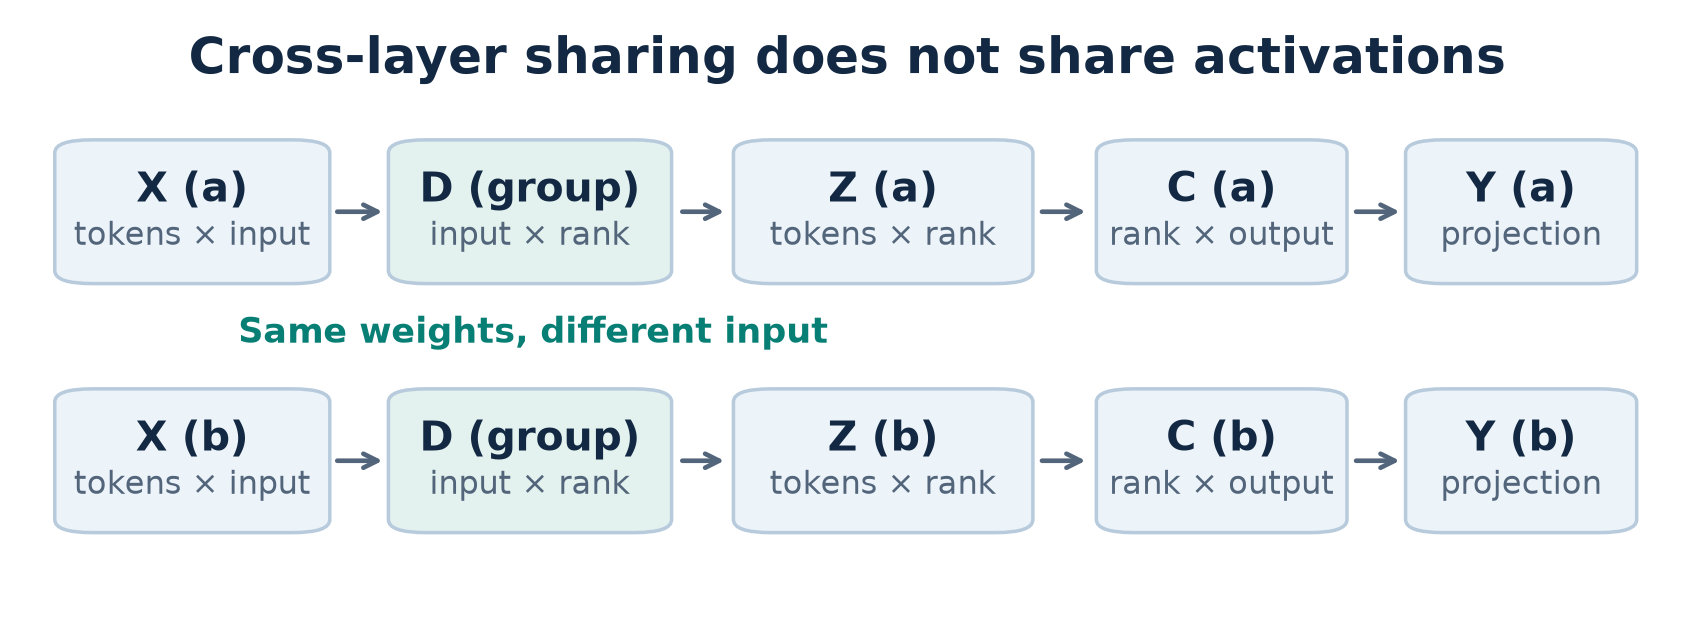
图 2:依据论文图 2 自绘。箭头表示两个层各自的计算流程;两个 D 方框指同一份参数。
低秩和稀疏是两道不同的限制。低秩规定所有输出列都落在同一个至多 维的子空间。稀疏规定每个输出列在这个子空间里只准选少量字典项,列与列可以选不同的项。四个字典项的两个输出列分别用第 1、3 项与第 2、4 项,仍然可以在整张系数矩阵中覆盖四项。系数中的零通常不会在乘回权重后仍是零。做部署估算时,要数稀疏乘法真正访问的系数,而不是按还原权重的零值数推断。
SVD 的作用是从许多方向中找出值得保留的方向。普通截断 SVD 在 Frobenius 平方误差下选最大的 个奇异值,剩余奇异值的平方和就是最优误差。权重误差不一定等价于输出误差。例如一批输入的两个通道总是一起变化,把某输出的第一个权重加一点、第二个减一点,模型在这批输入上的输出可以完全不变。这正是输入统计有用的原因。写成矩阵,若某一列误差为 ,它造成的输出平方误差是 。论文称 为输入协方差,这里是未经中心化的二阶矩;减去均值会改变要保持的输出。
还要区分三种预算。第一种按非零参数计数,方便推导该选多大秩。第二种数真实字节,要算量化尺度、掩码、稀疏索引、补齐和未压缩的嵌入及输出头。第三种是延迟或吞吐,除了读权重,还要算索引访问、写中间结果和调度开销。第一种预算下的胜利不能直接折算为第三种。
从参数预算反推字典宽度
先只看一组形状相同的 个投影。压缩前共有 个权重值。字典存一份,占 ;每层系数占 ,剪去比例 后只计保留的值。于是
是削减比例, 是原大小除以压缩后大小。若只做分解,还没剪枝,就令 。把目标削减比例 移到等式左边,剩下的预算等于 ,解出:
这条式子很适合拿 LLaMA-7B 的形状检查。4096 宽的方形 Q 投影,分解先减 20%,独立分解时可选秩 1638;两层共享可选 2184。两层情形下,忽略取整误差,字典占分解后参数的三分之一,系数占三分之二。所以剪掉 19.4% 系数,只会额外削减压缩前组大小的约 ,最后共减少约 30.35%。附录 A1.2 给出的 Q、K、V 约 30.36%。形状为 的 down 投影单独分解,同样的 20% 先减预算只给秩 2388。即便统一使用 ,各类投影的最终削减比例也不同;不能把某个 Q 层的数字当成整个模型的比例。
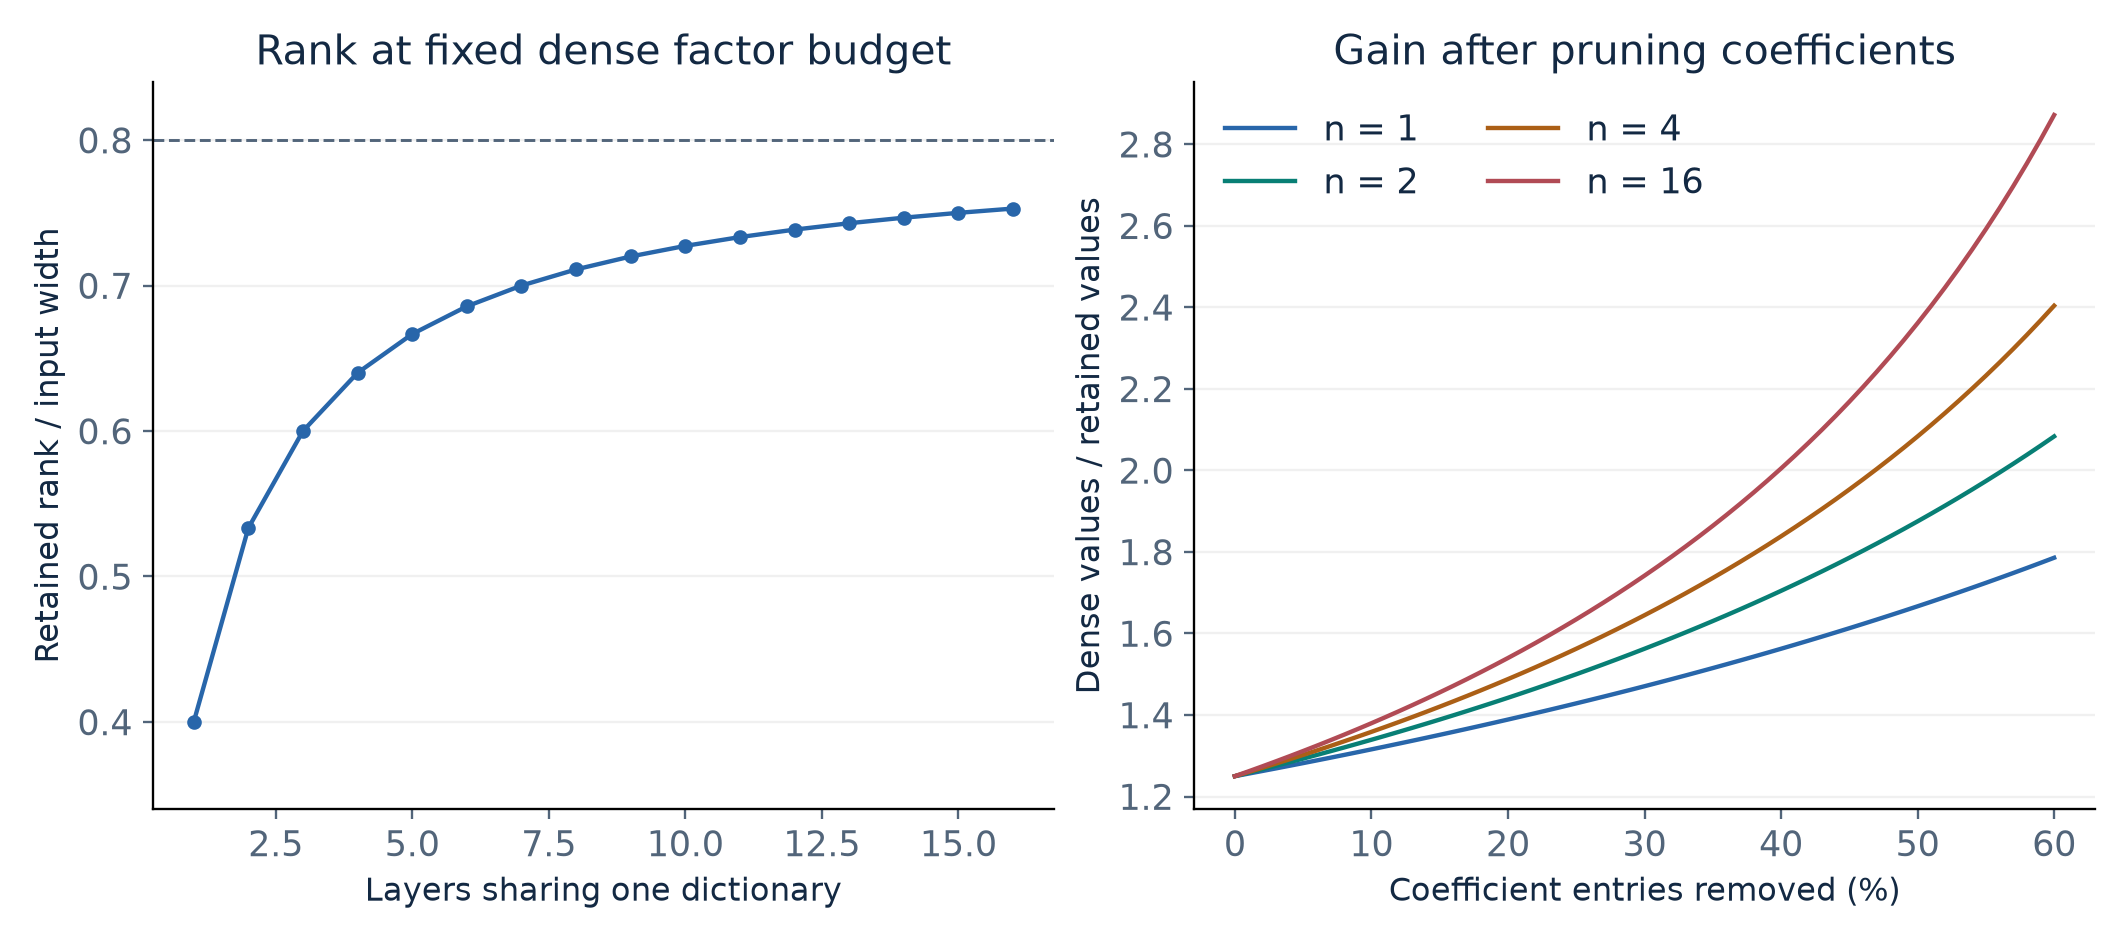
图 3:由式(2)和(3)计算的方阵示意,固定分解削减 20%。右图只计非零值;索引、尺度和其他固定部分另算。
组越大,每个参与层分摊的字典成本越低,但这条曲线很快变平。方形投影的秩比例是 ,组大小从 1 变 2 相当有用,从 8 变 16 的新增空间少得多。相比之下,多拉几层进组可能带进截然不同的激活方向。原文把输出投影和 down 投影通常留为独立字典。附录 A6 特意改变这点,把组扩大到 4、8、16,固定字典秩并剪掉 60% 系数,再对全部投影做 LoRA。论文报告 2.9、3.5、3.9 倍对应 10.26、12.32、15.89 的困惑度。这个附加实验说明更强共享有路可走,也显示了质量代价,并不能算作主流程的无微调结果。
秩选定以后,剪系数还有一个下限:即便极端地把所有系数都删除,字典本身也要留下。刚才的两层方阵至少还要保存原值数约 26.67% 的字典,何况那时已经没有有用输出。这个下限在输入很宽、输出很窄时更明显。实际配预算时,我会优先在共享收益较大且激活误差小的投影上做组内摊销,然后针对其他层单独选秩和稀疏率。
第一步:在输入度量下分解
原文式(2)表达的是逐层输出误差。设 ,将 与 分别按列拼成 和 。初始化的做法是用组内输入二阶矩的和 ,给拼在一起的所有权重列使用同一个度量。写出来就能看到原目标和计算时用的近似差在哪:
展开最后一行,会出现用第 层的统计量评估第 层的误差,其中 。如果每层的 相同,两者只差一个常数。即使所有度量只差一个标量,逐层目标也会按该标量给各层残差加权,合并目标却对各层残差用同一度量。更一般时两个最优解不必相同。共用度量省去每层独立分解与逆矩阵,这就是它的计算价值和近似来源。
假定 正定,先令 ,把字典变成 。因为左乘可逆矩阵不改变秩,问题变成在普通 Frobenius 范数下用一个秩至多为 的矩阵逼近 。取其截断分解 。把奇异值留在字典一侧,再解回原坐标:
使用 Cholesky 分解 时,左乘的变换可以取 ,回代用解线性方程。若校准样本没有覆盖某些方向, 可能接近奇异;这些方向在不加阻尼时几乎不计误差,却可能在真实请求中重要。阻尼一方面稳住求解,一方面改变被优化的度量。附录 A2 报告协方差和 Hessian 运算的默认阻尼为 。对只在某阶段使用阻尼的变体,后面的正交关系要重新检查。
我复算了一个两维例子。令 、。直接看权重会选 1.5 的方向;在校准输出上,丢掉第一个方向产生平方误差 4。先左乘 ,对角线变成 2 和 1.5,秩一选择改为第一个方向,输出误差降到 2.25。这比「激活感知通常更好」具体:它解释了两种度量为什么会选不同方向,也提醒我们若上线流量的输入二阶矩反过来,优势也可能反过来。
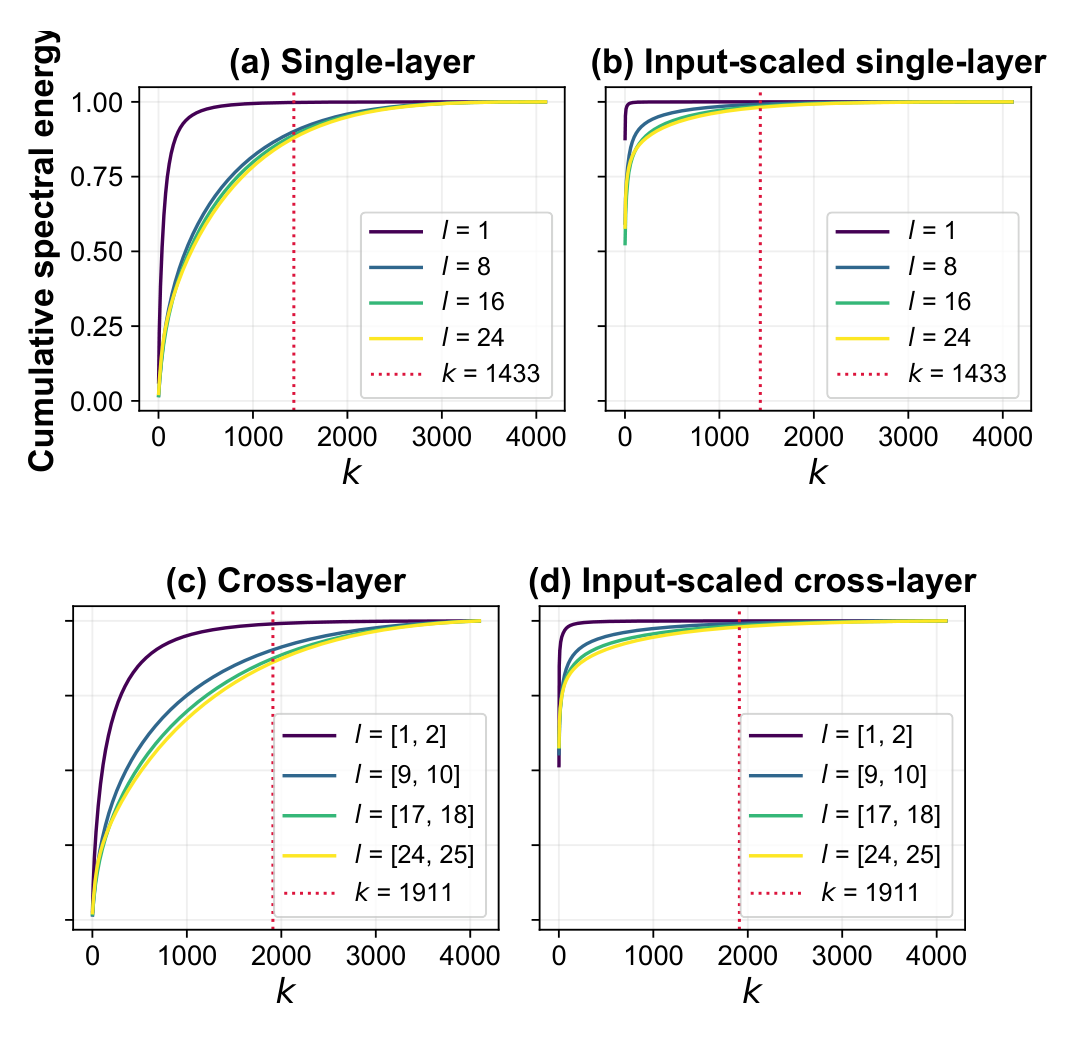
图 4(论文图 A1):裁自 v1 第 19 页。按图内标题读,(a)、(c) 是未缩放,(b)、(d) 是输入缩放。虚线标出同样分解削减率下独立或共享所用的秩。
图 A1 的早层和深层曲线不一样,附录图 A2 也按 K、V、gate、up 和 O、down 分开看。输入加权后能量集中,说明可以较低秩保留校准集上的平均作用。它不能直接证明两层应该配成一组:两个层的谱都可以衰减很快,却各自集中在不重合的方向。选组应看共同拟合之后逐层残差有多大,尤其是预算固定时与独立字典的差距。另一条路线是经典 k-SVD,交替做稀疏编码与逐个字典项更新,表达更灵活,但在大模型许多输出列上反复求解成本较高。论文图 3 的比较只取 LLaMA-7B 一处 Q 投影,能说明分阶段设计有动机,不能代替全模型对照。
第二步:删掉系数时怎样补偿
暂时固定字典。取系数矩阵的一列 ,改变 会让原投影的这列改变 。把它放回校准样本中,平方输出变化可以写成
这里 是系数坐标中的 Gram 矩阵。严格地说,平方误差的 Hessian 是 ;常数 2 不改变无阻尼时的最优更新。还要留意参照点:上式问的是「相比剪之前的因子输出,变了多少」。如果原分解已经偏离稠密模型,直接对稠密目标计算新增误差,还会多出与旧残差的交叉项。保留已有分解的行为是合理近似,但不能据此保证每剪一项都对原权重最优。
要把第 项设成零,约束是 , 为单位坐标向量。加正阻尼后令 、。给 加上乘子项 ,一阶条件是 。先解 ,再从约束得到 。代回平方误差,得到删项的代价与整列的补偿向量:
对角情形下,删一项只动该项,分数等于 ;系数绝对值相同也可能有完全不同的代价。如果 有非对角项,允许未删除坐标改变可以把损失压低。图 5 用我构造的两维问题说明:从 出发,把第一个坐标清零时,第二项保持 1 的损失是 2;允许移到 1.8 时,损失降到 1.36。两者都满足第一个坐标必须为零。这个算例没有使用模型权重。
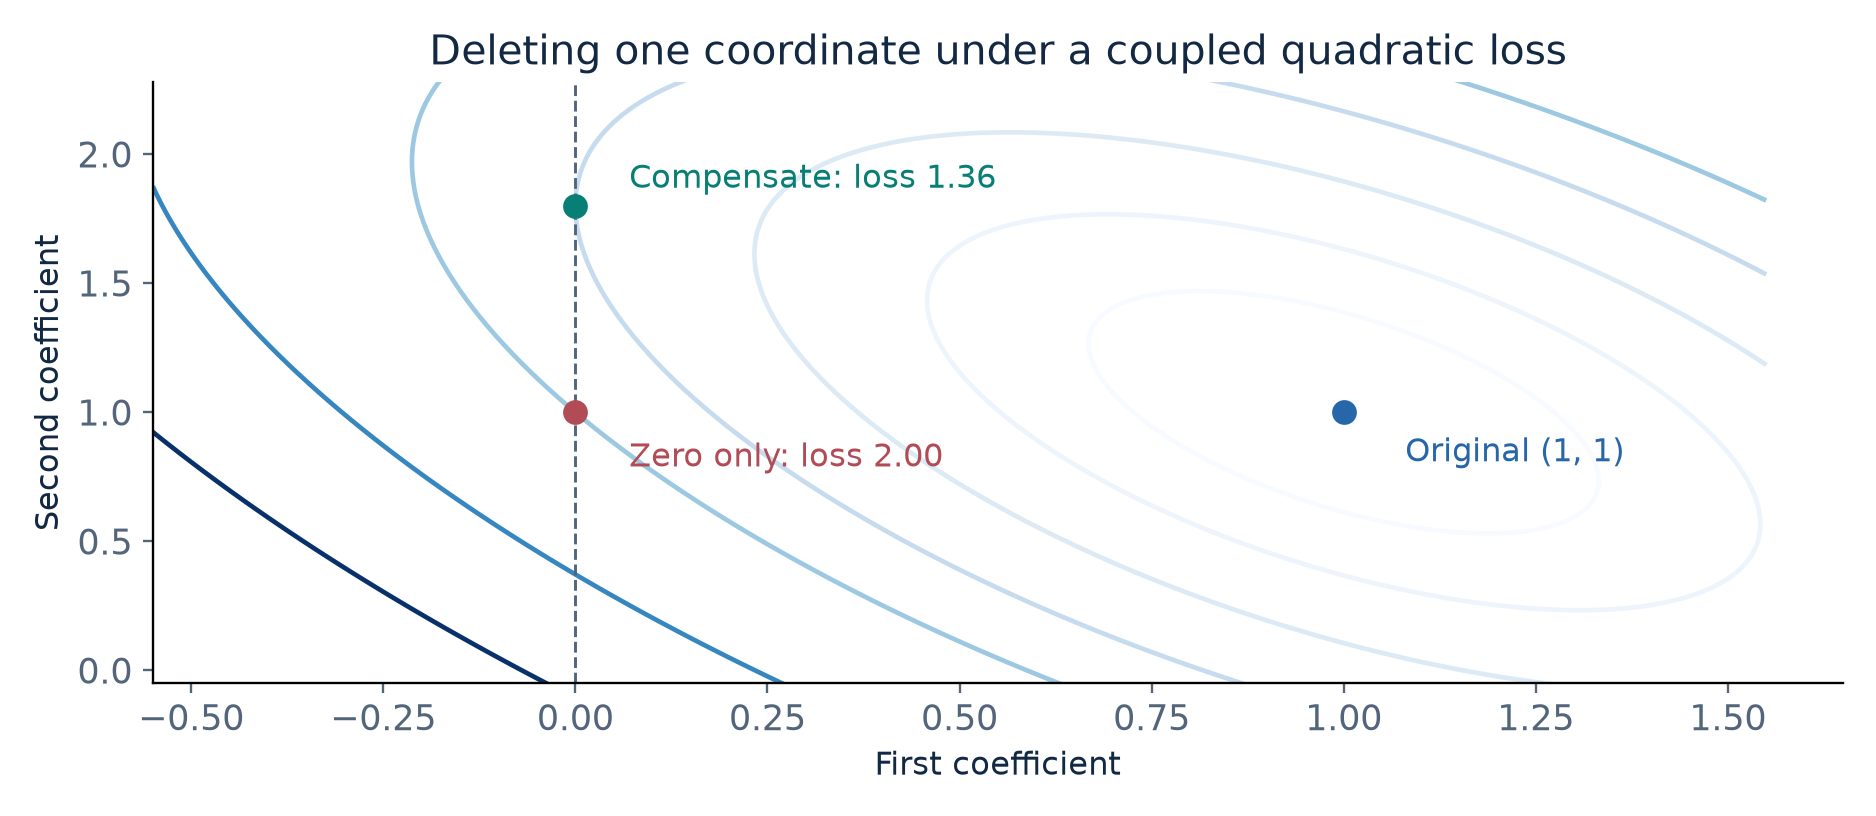
图 5:说明性复算。曲线是等损失线,虚线是硬约束;绿色点是该约束下的最优解。
字典压缩在这里有一个容易漏看的细节。若式(5)的变换与后续打分严格使用同一个 ,便有 。加各向同性阻尼也仍为对角。在这个理想条件下,组内的二阶分数已经能用奇异值重标定后的幅度表示,跨系数补偿退化为只删当前项。每层各自的 、度量不一致或剪后重新拟合字典,都可能打破对角性。论文的效果对照验证了整套打分与更新相对简单幅度剪枝的表现;它没有单独量出非对角补偿贡献了多少。我不会把图 5 当成新分解的组级 Hessian 必然有耦合的证据。
算法 1:用固定逆矩阵分块剪系数
以下按论文算法 2 改写。列块负责组织计算;每个输出列独立排序。块开始时排好顺序,实际补偿用当前系数,最后统一施加掩码。
1. Form P from the damped coefficient Gram; read its diagonal.
2. Split output columns into blocks of at most B columns.
3. In each column sort rows by c[i]^2 / P[i,i], lowest first.
4. Mark the first floor(p*k) rows in that order.
5. For every marked row i, read the current value c[i].
6.     Subtract P[:,i] * c[i] / P[i,i] from the column.
7. Apply the mask: all marked coefficients become exact zeros.
若一次删除集合 ,用 收集被删坐标的单位向量,把标量约束换成 。一阶条件给出 ,约束确定乘子,得到
这也说明固定逆矩阵的逐项修正为什么未必等于一次联合求解。对非对角情形,删后面一项可能重新挪动前面已经清零的值。最终硬掩码保证可行,但恢复可行不等于找到了给定支撑下的最优点。可以按保留子空间重算逆,也可以选定支撑后解一次多约束问题;两者都增加离线成本。表 3 的对照里,两种 Hessian 方法的 PPL 都四舍五入到 9.89;全量求逆 13.49 小时,固定逆更新 55.6 分钟,复算比值约 14.56。单靠幅度的 44.6 分钟更短,但 PPL 为 47.43。这是一次指定设置的离线时间与质量比较。
第三、四步:把字典拟合到剩下的系数
剪完以后,把各层系数拼成 ,其中的数值与零都冻结。现在只求 。对使用共同左度量的目标求导,梯度是 。如果 正定,令梯度为零就能从左边消去它。为避免有些字典项完全闲置时的奇异性,可对右边的系数 Gram 加阻尼:
这等价于在经过输入变换的坐标中做岭回归,或者在加权残差旁惩罚 。如果改成直接惩罚未变换的 ,一般会得到不同的方程。若保留逐层不同的度量,令各层梯度相加也会变成另一个问题:
这是不加阻尼的驻点式。不同的 不能从求和里统一消去。式(9)省事,足以作为逐层拟合的起点;如果有一层在合并度量下始终吃亏,可以考虑迭代解式(10),而不改变线上张量形状。
用一个小例子直观地算一遍。目标权重的三列依次是 、、。系数矩阵的三列是 、、。以单位阵为字典时误差平方和为 8。固定系数后,第一列字典同时服务第 1、3 个输出,因此取两列目标的均值 ;第二列字典只服务第 2 个输出,取该目标的一半 。相乘后只剩第 1、3 个输出各 0.5 的首坐标误差,总平方误差降为 0.5。我用矩阵乘法也核对了这个结果。压缩格式不必多存一个系数。
算法 2:从稠密投影生成可部署的因子
对应论文算法 1。量化字典时看原始输入;量化系数时看字典变换后的输入。论文算法把剪枝阶段的系数度量传给量化,若用重拟合后的字典重新算度量,应作为单独的对照。
1. Collect input Gram matrices with the original model.
2. Group compatible projections by type; sum input Grams.
3.     Set k from the dense factor budget.
4.     Factor scaled weights and split coefficients by layer.
5.     Form the dictionary-induced Gram for coefficients.
6.     Prune each coefficient matrix using Algorithm 1 here.
7.     Freeze sparse coefficients and refit the dictionary.
8.     Quantize the dictionary with its input Gram.
9.     Quantize coefficients with their Gram and fixed mask.
10.    Store the factors, scale data and coefficient support.
量化误差也不是简单地把两份误差加起来。写 、,减掉原分解的输出得到
对字典而言, 描述误差的输入侧,但末端还有由系数决定的右侧权重。对系数而言,输入是 ,其 Gram 正是系数度量。两者一起量化,还会有第三项和各项之间的相互抵消或放大。分别处理的价值在于每次只面对一个可解的子问题。原文用 NVFP4 的组内尺度表示两种因子,并把系数掩码固定为零;附录 A2 给出掩码量化的相对阻尼 0.1。这个近似值得和「先量化字典,再按新字典修正系数的尺度与误差」作对照。
实验读法:先看预算相同的比较
论文主实验以 256 段 WikiText-2、每段 2048 token 采集校准输入。语言建模用 WikiText-2、PTB 和 C4;推理侧用七项零样本选择题。附录 A2 说明任务取评测框架中的原始准确率而非长度归一化准确率,也写了 PTB 测试文本如何拼接。困惑度是每 token 平均负对数似然的指数。19.99 降到 10.59,放回同一个语料和分词口径下约少 0.635 nats/token,不能把差值 9.4 当成准确率增加了 9.4 个百分点。
看阶段图时,我先找控制变量最干净的一段。表 A7 从剪枝到字典重拟合,报告大小都为 2 倍压缩;WikiText-2 从 11.53 降到 10.59,C4 从 33.82 降到 29.12,七任务平均从 0.42 到 0.43。稀疏支撑和秩都没变,收益来自把固定系数重新对应到合适字典。图 5 的另一个实验先将分解参数减 20%,再扫稀疏率。剪一半系数时重拟合挽回 1.04 点困惑度;只剪两成时挽回 0.06 点。这符合「系数改得越多,旧字典越不合用」的解释。表 A7 其余阶段同时改变大小,因此不能像这两行一样当作固定预算的消融。
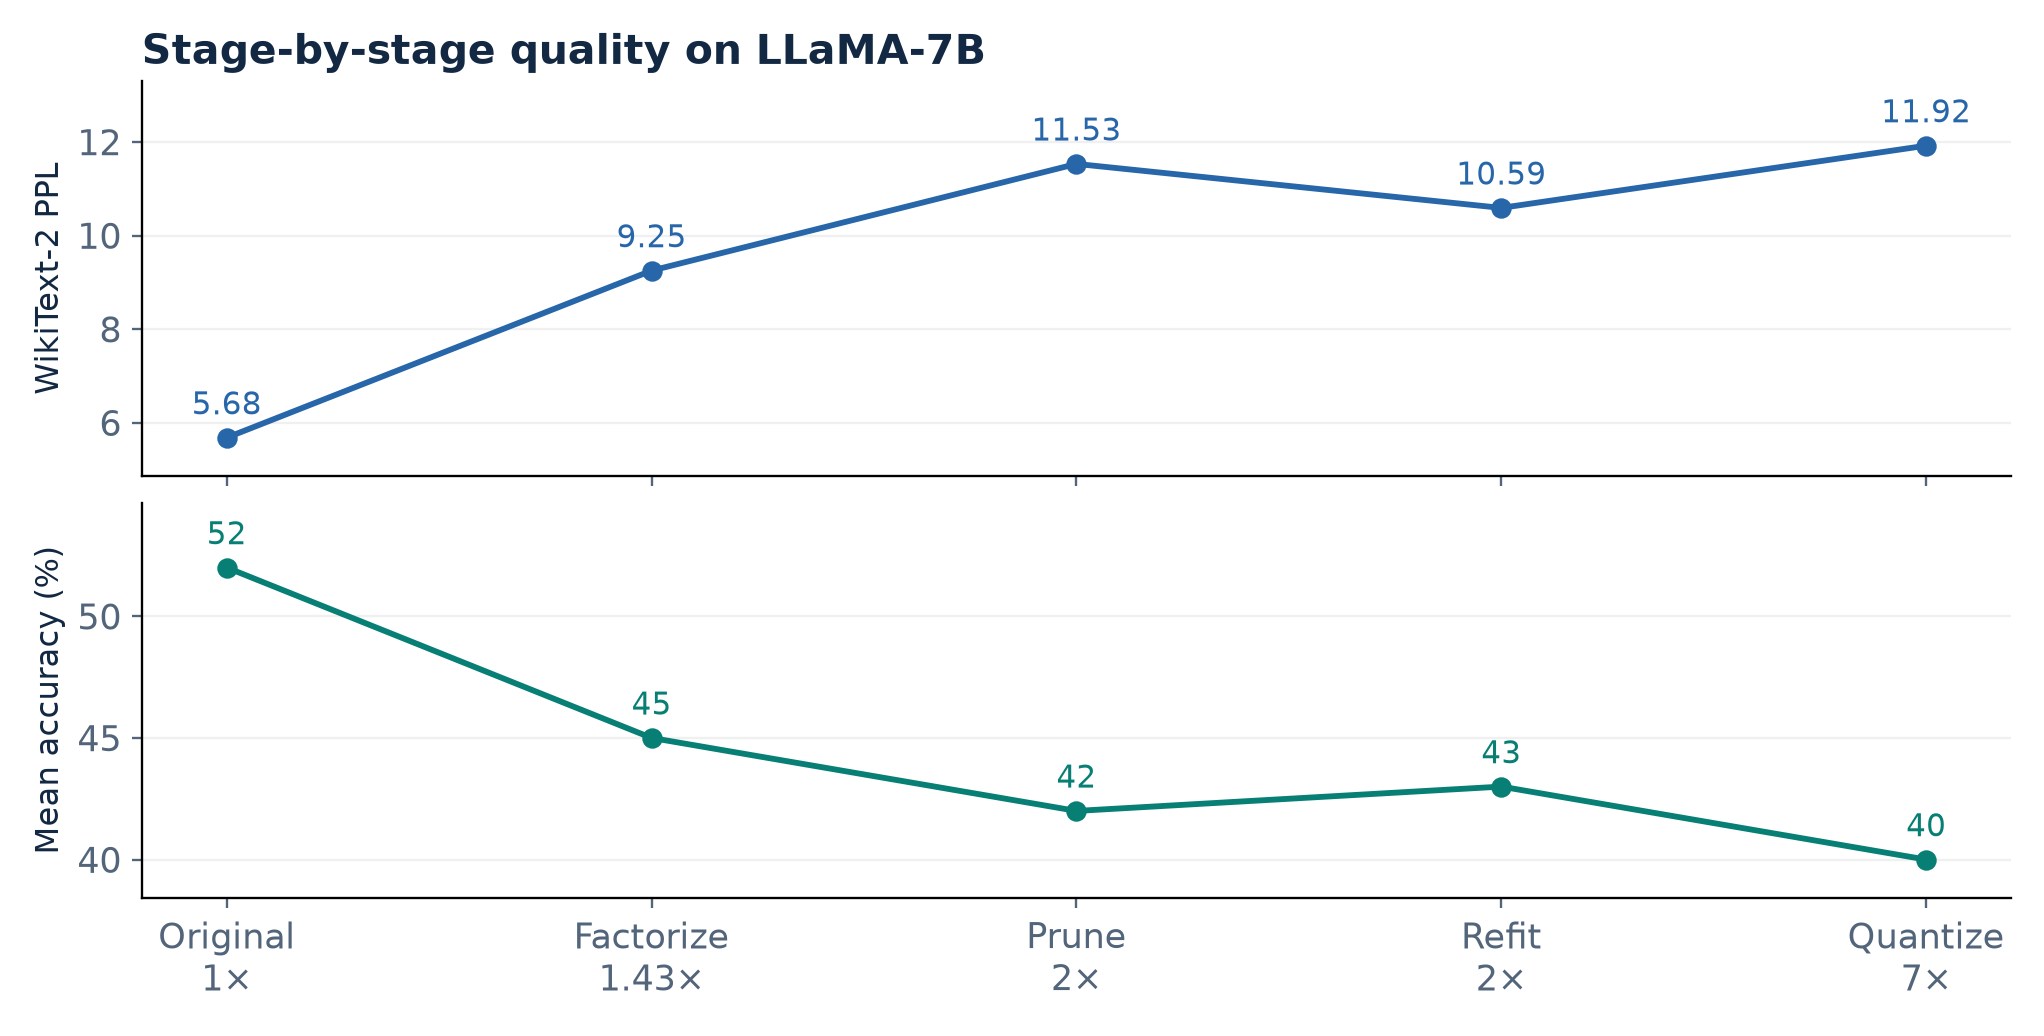
图 6:根据论文表 A7 重绘。只有剪枝到重拟合的两点大小相同;准确率按该表的舍入均值。
表 2 对照剪字典、剪系数、两边都剪。以 LLaMA-7B 的 1.43 倍压缩为目标,只剪系数得到 7.83,只剪字典得到 9.04,两边都剪得到 7.99,全稠密因子方案得到 9.25。全稠密那行靠更强的低秩截断达到同一预算,不是拿掉剪枝而其他参数完全不动。共享字典的扰动同时影响几层,留它稠密有直觉上的理由;结论仍局限在这组形状和预算。若某种硬件对字典侧稀疏提供更强的支持,公平的比较要纳入真实时延。
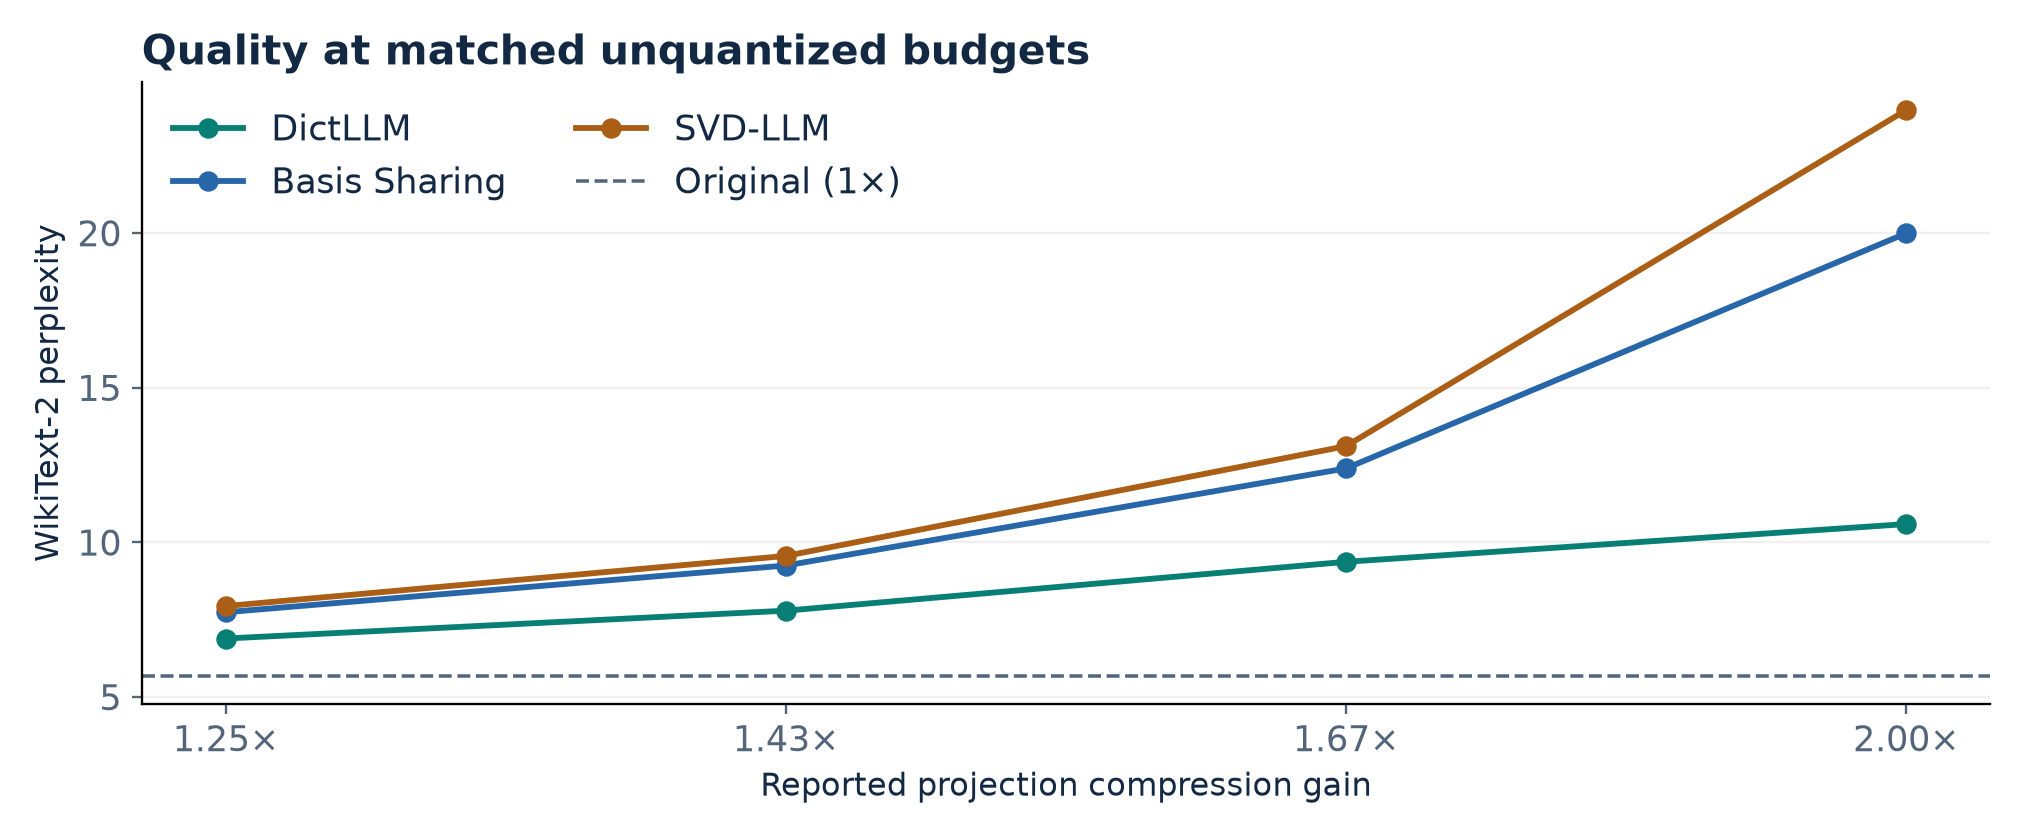
图 7:根据论文表 1 重绘。横坐标是实际测试的压缩档位,连线用于辨认同一方法的点。
在 2 倍压缩档,未量化 DictLLM 的三个语言建模 PPL 为 10.59、35.67、29.12,Basis Sharing 为 19.99、126.35、88.44。前者相对低秩基线优势明确,但稠密原模型为 5.68、8.35、7.34,尤其 PTB 和 C4 的绝对差距依然很大。选择压缩档位要从可接受的质量底线出发,不能只比较压缩模型谁领先。ASVD 在高压缩点下降很大,我主要把较接近的 Basis Sharing 当参照。SVD-LLM V2 在表 A11 被补进 20% 削减的对照;LLaMA-7B 上是 7.12 对 6.89,远比高压缩时某些较弱基线的差距小。
表 5 让 LLaMA2-7B、OPT-6.7B 和 Mistral-7B 都到 1.25 倍压缩。三者均优于该表的低秩基线,且模型类型所需的系数稀疏率不同。附录 A3 又纳入 Qwen3-1.7B、8B、14B;在 1.43 倍,DictLLM 对 Basis Sharing 的均值优势分别是 2.67、5.27、3.65 个百分点。8B 压到 2 倍还有 41.63% 对 34.31% 的比较。不过 1.7B 原模型有 54.05%,压到 1.43 倍后只有 39.37%。在小模型上挤掉相同的比例可能损失很多能力;压缩方案相对最优和达到产品质量线是两道题。
附录 A7 的好处是没有把对手限在低秩。约 5 倍时,DictLLM FP4 的 WikiText-2 PPL 是 8.48,Basis Sharing 加 4-bit AWQ 是 11.38,加 4-bit GPTQ 是 13.99。单剪枝的 SparseGPT、Wanda 要把原投影剪到 80.32% 稀疏,质量跌得很厉害。约 7 倍时,原文用两比特 GPTQ 和 AWQ 来接近预算,平均准确率分别为 32.00% 和 30.07%,DictLLM 为 40.39%。比较说明组合手段能提供不同的质量折中,不能据此把改善全部归给某一个环节。表 A13 的幅度剪枝对照更接近,但还同时改变重拟合;量化后的两行连量化方法也不同。另一个读表细节:主表的稠密七任务均值为 0.52,表 A9–A13 为 53.94%,细看原始任务值不全能用舍入解释,本笔记按各表自己的稠密行比较。
附录还有两组容易混淆的校准实验。图 6 在不重拟合的 1.43 倍配置里扫 32 到 256 个样本,回答的是分解和剪枝需要多少输入数据。附录 A6 中的表 A8 则扫 NVFP4 量化所用的序列数,16 个样本的 PPL 为 9.06,128 个为 8.88,但耗时约为前者八倍。固定样本数时,语料覆盖和序列长度仍会改变输入度量。表 6 的 LoRA 也使用未重拟合的基座,只训练 Q、V 适配器;2 倍处的 8.71 是这个单独方案,不能直接从主表的 10.59 相减来归因于「给完整主流程加 LoRA」。
三本账:非零值、打包字节和推理时间
NVFP4 把 4 bit 数据与组内尺度一起存。按常见的每 16 个值摊一个 8 bit 尺度,不计外层尺度、补齐和索引时,每值平均是 4.5 bit。对同一组值从 FP16 换过去,理论倍率是 。论文表 4 的分母是已经做过分解与剪枝的 FP16 模型。把约 1.43 倍的非零值增益再乘这个倍率,得到约 5.09 倍,与附录 A2 的 5.08 倍一致到舍入误差;2 倍的非零值档对应约 7.12 倍。摘要的 5.1 倍不能直接拿来估整模型的实测显存。未压缩的投影外权重、表示稀疏支撑的成本和暂存都要分开。
| 字典/系数精度 | 对因子 FP16 的倍率 | WikiText-2 PPL |
|---|---|---|
| FP16 / FP16 | 1.00× | 12.98 |
| NVFP4 / FP16 | 1.61× | 13.66 |
| NVFP4 / FP8 | 2.60× | 14.71 |
| NVFP4 / INT8 | 2.60× | 16.05 |
| NVFP4 / NVFP4 | 3.56× | 16.82 |
表格数据来自原文表 4。此处的起点是 30% 分解削减加 50% 系数稀疏,和摘要的 5.1 倍不是同一设置。只量化字典时,PPL 多 0.68;在这基础上把系数也压到 FP4,再多 3.16。FP8 和 INT8 两行的倍率一样,前者的 PPL 少 1.34。若设备有对应算子,而容量又允许稍放宽,混合精度可以先试;这组数没有证明别的模型或字典基也会出现相同顺序。
假设系数逻辑上有 个位置,稠密布局平均每个值 bit。稀疏布局保留比例 ,每个保留位置额外用 bit 记录位置,另外每个逻辑位置摊 bit 的开销。稀疏总位数是 。与稠密数组的 相比,从不等式解出:
在 的示意里,若每个保留值另记 8 bit 索引、其余开销暂计零,至少要剪到超过 64% 才省字节。若只用一位逻辑掩码且不为保留值单独存索引,门槛约 22.2%。19.4% 在这两个玩具格式里都达不到。实际可以用位图、受限的块稀疏或别的压缩布局;还必须让乘法内核能快速从掩码找到数据。这是为了展示索引成本可能吃掉低比特下的非零值收益,并非原论文所用的具体存储格式。
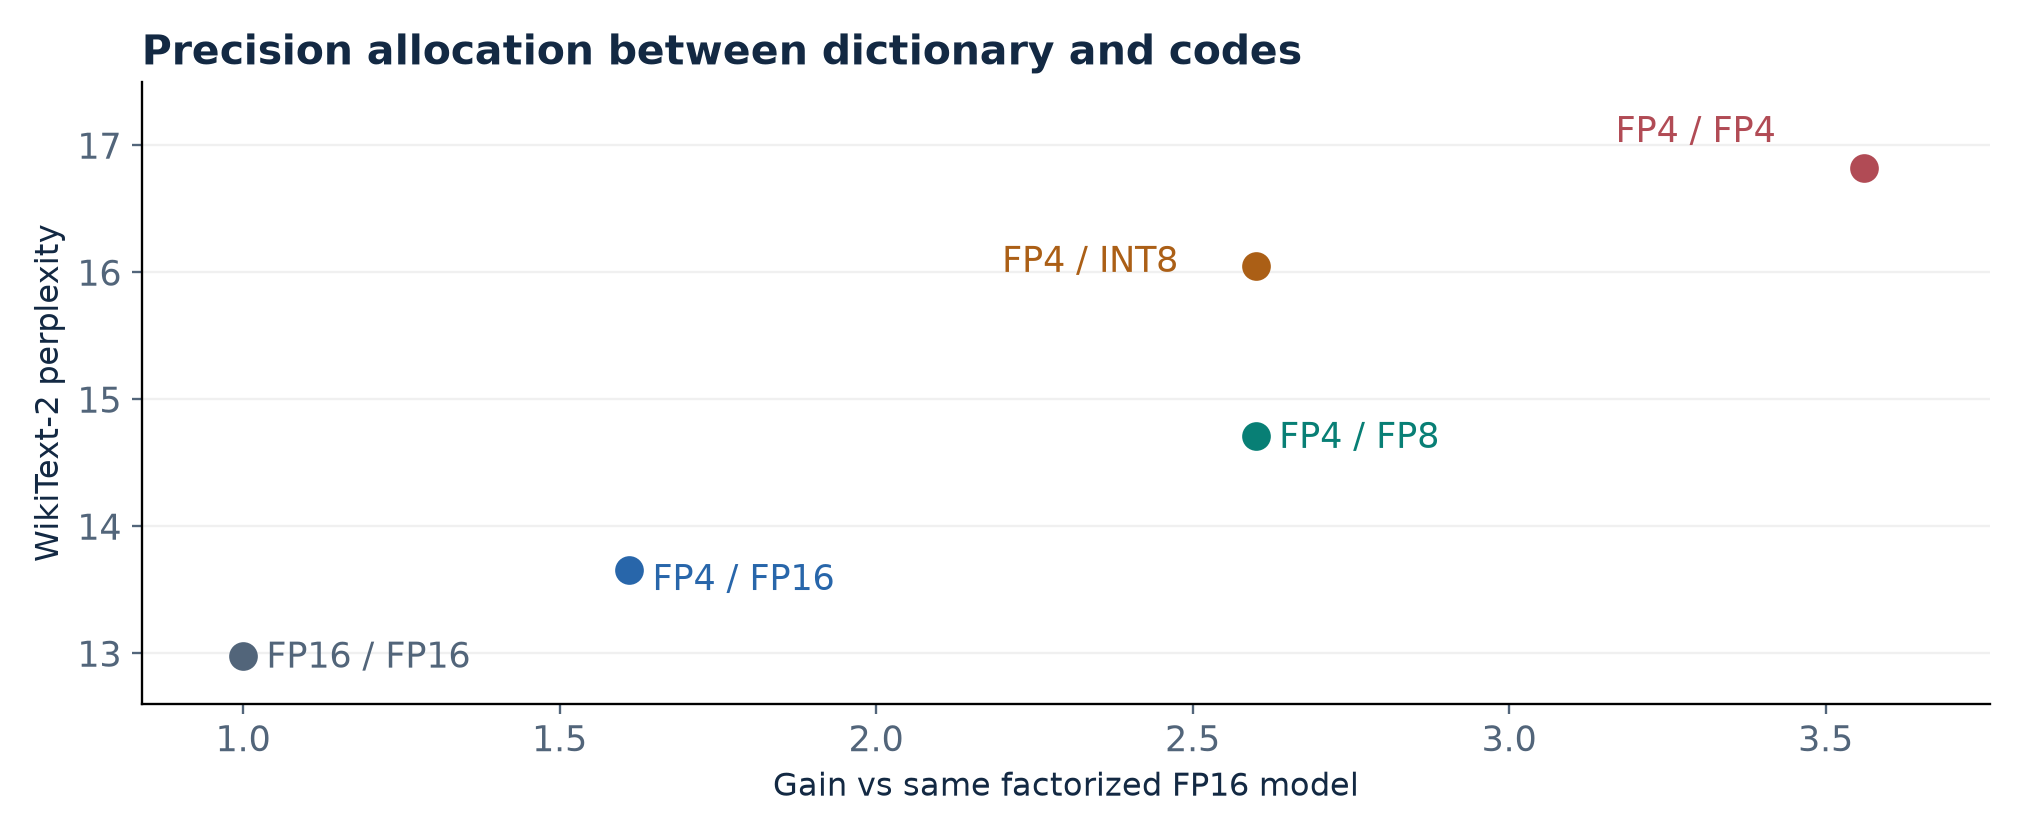
图 8:根据论文表 4 重绘。横坐标始终以同一因子化 FP16 模型为分母;标签前一项是字典精度。
附录表 A14 是最接近部署的证据。三种配置都在一张 RTX PRO 6000 Blackwell Max-Q 上用 FP16,批大小 1,输入 128 token 后计 100 次单步解码。热身 3 次、计 10 次,不包含预填充。DictLLM 用 MACKO 计算稀疏系数。表中原模型、Basis Sharing、DictLLM 依次为 102.35、113.59、126.81 tokens/s。复算相对前两者分别为 1.239 倍、1.116 倍。原模型权重显存 13.48 GB、DictLLM 7.82 GB;峰值 13.66 GB 对 8.02 GB。即权重约少 42.0%,峰值约少 41.3%。非零参数统计里的 2 倍,对上真实权重约 1.72 倍,口径本来就不同。表没有分项报告固定权重和稀疏索引各占多少,不能把全部差额都归给某项。
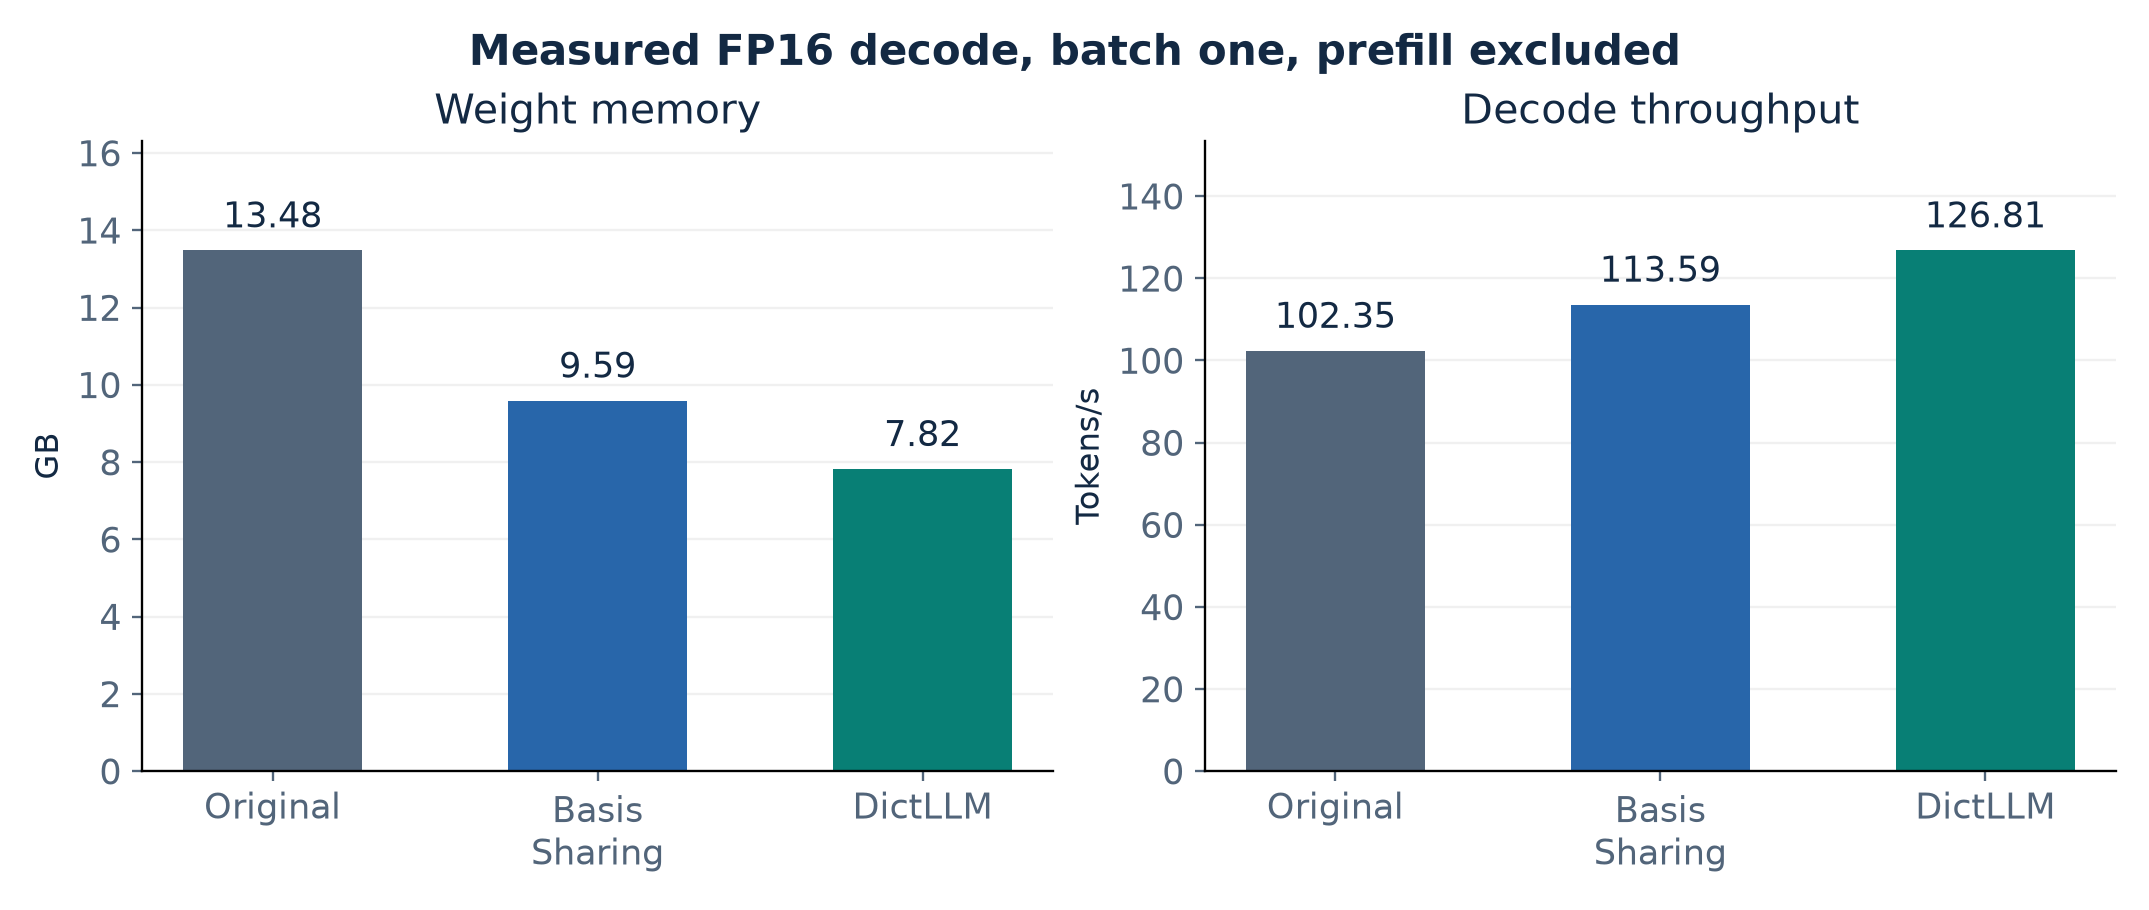
图 9:根据论文表 A14 重绘。该图不计预填充,也不代表 NVFP4 的吞吐。
用乘加数解释差距也很直观。一组稠密投影每 token 需要 次乘加;因子化执行每层都要乘字典,再乘系数,理想稀疏路径共 。字典容量账只算一次,计算账要算 次。刚才的两层方阵,、,理想乘加比例约 ,明显高于约 0.697 的保留参数比例。如果稀疏内核不能跳过所有零,实际差距更大。对于小批解码,读权重少一些可能就有效;到了长提示的预填充,密集算力利用率和中间写回可能比读权重更重要。长上下文的注意力或 KV 流量也不因投影存得更紧而自动下降。
局限:这些数字能回答哪些问题
原文附录 A10 明确指出,系数的非结构化稀疏要求后端处理不规则访问。它确实给出了一个可用的 FP16 路径,但没有提供 NVFP4 稀疏路径的端到端解码实测,也没有手机能耗测量。表 A14 的短提示、单序列和固定生成步数不足以说明持续批处理、长上下文或首 token 延迟。新设备要重新核对精度支持、低比特稀疏能否结合、字典留在缓存的概率,以及两次矩阵乘法之间有没有额外写回。单看权重容量无法回答这些问题。
校准还有另一层限制。论文的共享空间是在稠密模型、同一语料的短段上学出来的。部署中代码、中文、长提示和模型自己生成的历史可能给出不同的输入统计。某个低频方向只占很小的平均谱能量,仍可能在专门任务中决定结果。逐层激活重建也不包含下游层会如何放大误差。零样本任务均值适合比较表内设置,却可能掩盖单个任务退化;表里较小的差距也没有跨随机种子或逐样本的不确定性估计。
我还核对了原文的两处表述差异。图 3 的柱状图写 13.07 秒和 2.90 秒,直接相除为 4.51;相邻正文称快 3.4 倍,未给另一组计时口径。这里引用图上的读数,不用其中一组去解释另一组。图 A1 图注描述有无缩放的顺序与面板标题不一致,本文按面板标出的 (b)、(d) 为输入缩放来读。前者不影响表 A14 的吞吐实测,后者也不改变图中曲线本身。
批判性分析:怎样把优势拆成可检验的假设
先评估两层值不值得放在一组
相邻不保证输入统计一致,也不保证两个投影的主方向可共用。可以用一个反例判断式(4)里的差别有多大。设第一层的单输出权重为 ,第二层为 ,校准二阶矩分别是 和 。若字典只保留第一坐标,拟合完逐层系数后第二层的误差是 4;只留第二坐标则第一层误差是 9。逐层度量会偏向第一坐标。合并成 后,两种选择的误差变成 40 和 10,排序颠倒。原因是第二层的残差也被第一层的输入能量放大了。这个例子只比较两种字典候选,已经足以说明合并度量可以改变选择。
实用改法是先在留出的样本上比较成组与独立的拟合残差,而且按每层单列结果。光看组平均会让代价大的单层被掩盖。我会同时记最差层和逐 token 残差高分位,先找出哪些层适合共享;再在固定打包字节数的条件下比较相邻配对、按误差选择配对和私有字典。第一轮保持量化和掩码形式一致,以便把共享收益与格式收益分开。若跨层输入分布差异很大,可保留私有字典,或者在式(9)初始化后少量迭代逐层目标。这样做的收益是避免组内高能量层替另一层决定方向,代价是更多离线计算以及可能降低字典复用。
识别二阶打分里真正起作用的部分
我最想看到的对照是把「分数有权重」和「删项后补偿其他系数」拆开。第一组保持同一个新分解的字典,同一个剪枝比例,不重拟合,比较普通幅度和按 加权的幅度。第二组换为逐层度量,先量非对角项的大小,再对同一掩码比较直接置零、固定逆补偿、以及给定支撑后精确重解。第三组再统一重拟合字典,测前两组差距是否被重拟合吸收。若理想池化度量下几种补偿方案几乎一样,就没必要为逆矩阵更新支付太多成本;若逐层度量显著改善困难样本,才值得保留更多局部统计。
同一个分解乘积内部还可以换坐标。任意可逆 都有 。对角缩放不会改零的位置,而且在无阻尼的理想二次问题里,删项代价保持不变: 和 随尺度以相同的平方倒数改变。但真实的阻尼和每块共享的量化尺度不具备这种不变性。一组字典列被放大后,其系数可相应缩小;两边的动态范围却会改变。一般旋转还会改变哪些位置容易剪成零。一个有意义的改进是先保持稠密乘积不变,再选尺度或受限旋转,让掩码和量化格点更合适。不能只看字典误差;某一侧被调得更平衡,另一侧可能新生离群值。可以用留出激活上的联合输出误差决定是否接受换坐标。
让部署布局参与决定掩码
如果设备只对某种块稀疏有高效支持,先生成任意掩码再打包可能走不通。更直接的替代是剪枝时就约束支撑,再用同一个字典重拟合修补精度。受限掩码的选择空间更小,可能在相同非零数下更差;按真实字节数和内核耗时比较,结果却可能反过来。应加入带原生低比特算子的稠密基线、已测过的 FP16 非结构化路径和候选的结构化路径。先比较同字节预算下的质量,再比较同质量下的延迟,避免只挑一种有利口径。
要判断「跨层共享」本身给执行带来多少好处,还可以固定压缩权重与布局,只切换字典能否驻留在较快存储中,报告字典流量和中间特征写回量。如果权重文件变小而每层依然重新从显存加载字典,性能收益应归因于其他因素。最好分别看方形 Q 投影、较窄的 K/V 以及 FFN 大矩阵,因为它们的读写比例不同。最后再把小批短提示扩成多个预填充长度和并发点,单列首 token、后续 token 和峰值显存。只有实际做了板卡或整机计量,才可以把吞吐优势写成能耗优势。
用可量化的条件检查校准能不能外推
共同度量在训练语料上拟合得好以后,下一步不是重新画一张奇异值图,而是问上线输入是否仍然给相近的残差排序。设同一个投影残差矩阵是 ,校准、目标输入的二阶矩分别是 和 。可以先在实际使用的输入子空间里把目标二阶矩写成 。具体做法是对目标矩阵左、右各乘一次 得到 。若校准矩阵正定,或者明确只谈其正定支撑,而目标在该支撑内没有超出,那么 的最大和最小特征值给出误差转移范围。令 ,目标误差变为 。对 的每列施加 Rayleigh 商上下界,再按列相加,就得到
这个界解释了「校准误差小」何时是有用的证据:若目标二阶矩在所有相关方向上最多是校准度量的两倍,则目标重建误差也至多两倍。若最大的广义特征值很大,平均 PPL 之外就要看目标流量中具体哪类输入放大了哪些方向。若目标有校准完全没见过的方向,有限上界根本不成立。比如校准输入只有第一通道,残差完全落在第二通道;校准误差是零,一上线出现第二通道输入,目标误差可以任意大。给校准矩阵加阻尼可让计算有定义,但不等于这个方向已经得到统计支持。阻尼很小、目标权重很大时,得到的上界依然可能没有约束力。
我会用两级检查代替只比校准样本数。先选几个业务切片,在保留方向与丢弃方向上分别估计激活能量,再选高风险投影做留出重建。直接估全部广义特征值可能昂贵;可以先在高残差的列方向及字典的正交补里作探测。第二级再用相同切片看任务是否失败,区分「输出误差大但任务不敏感」和「低能量方向恰好决定某个决策」。输入统计只能界定线性误差,不会给最终任务成功率界;量第二级是为了检验下游残差放大和模型自身生成分布的变化。这个流程适合发现在哪些层该加秩,或者保留少数高风险输出的全精度残差,而不必把整个组都拉回稠密权重。
还可以把同样的思想用于重拟合的验收。先冻结系数支撑与校准规模,分别解共同度量的式(9)和逐层度量的式(10)。比较时保存各自拟合集残差与留出集残差,把代价高的逐层求解作为离线参照,而非默认替换。若逐层拟合只在拟合集改善,增加校准多样性可能比换求解器有效;若它在留出集尤其是最差层也改善,才有理由为各层维护不同的二阶矩。字典重拟合的成功标准可因此写得更具体:不增加打包预算、不改掩码,在指定留出切片上降低残差,并且不让原本已接近质量底线的层变坏。
给定掩码以后,允许系数重新拟合吗
原文的第三步保持系数值不动,只解共享字典。另一个自然选择是保留零的位置,却允许非零系数在新字典下再拟合一次。设一个输出列的稠密目标是 ,允许使用的字典子集为 。给定新字典时,最小化 。把范数展开,关于 的一次项是 ,二次项是 。令梯度为零即可得到
这和剪枝时保住旧系数的输出不同:目标直接是稠密权重的列。若去掉阻尼且使用同一个度量与同一固定字典,旧系数是一个可行解,所以精确求解在这批数据上不会变差。但每个输出列可能选了不同的 ,便有许多小线性系统,求解成本可能成为全流程瓶颈。如果布局约束令许多列共享支撑,可以用一个系数 Gram 分解处理多个右端项。这提供了一个有意思的共同设计空间:结构化掩码可能牺牲单列最优支撑,却让离线重解和在线打包都更规整。
也不能把拟合误差的下降当成端到端净收益。一次额外系数拟合可能引入更大的值范围,随后在 FP4 中造成难量化的离群项。可以按顺序比较只重拟合字典、字典后再重拟合系数、以及先固定量化字典再拟合系数三个设置;每个设置都用相同实际掩码,统一算量化前后残差、最终 PPL 和额外耗时。如果最后一种改善质量,应当再检查它是否来自按真实部署字典纠正了度量,而不是多使用了校准 token。这些实验不需要放开零位置,也不会改变解码张量尺寸,所以能把收益归到拟合目标上。
先算端到端的提速上限
还有一个比「参数少了多少」更有用的估算。设原始每 token 耗时中有比例 用在会被改写的投影,其余操作完全不变。若这些投影本身被加速 倍,每 token 时间按原时间归一后,未动部分仍是 ,改写部分变为 ;如果还有额外掩码解码和中间写回,再用同一时间单位记为 。整体倍率是
比如假设某服务的投影只占 45%,投影内核快 1.6 倍,并为额外工作支付原总时间的 3%,整体只能到约 倍。把同样的内核放进另一种更受 KV 访问限制的请求,若投影只占 20%,则约为 倍。两组输入都是示例,没有用来倒推论文实测的投影占比。它们说明服务端先做性能分解有用:应先找出在短提示、长提示和不同并发下真正占时间的算子,再决定优先优化字典复用还是系数乘法。
预填充与解码也可以按类似方式拆开。若一条请求原本需要 600 ms 预填充和 400 ms 解码,预填充不变且解码加速 1.24 倍,请求总时长约从 1000 降到 923 ms,约快 1.08 倍;如果预填充反而多花 80 ms,端到端几乎没有改善。反过来,短提示且生成很长的工作负载可能更靠近解码测得的倍率。要选真实部署配置,我会同时记录总延迟、首 token 延迟和稳态每 token 延迟,并用固定请求重放保持生成长度可比。一个形状上测得的有效稀疏后端应该作为测试起点,不能替其他形状承诺速度。
复现要点:先做小而可判定的对照
第一步只选一个真实投影,收集相同的校准输入和留出输入。分别算原始 SVD、共同度量 SVD 和逐层度量拟合,在相同秩与真实字节预算下量输出残差。记下 Gram 的条件数、阻尼、保留秩和稀疏掩码。剪系数时同时对比「偏离剪前分解多少」和「偏离稠密目标多少」。两者分离才能解释重拟合是在补剪枝误差,还是把旧的分解误差也压低。量化前后固定支持,记录重拟合前后的系数度量是否一致,避免无意改变两个变量。
到全模型对照时,固定 checkpoint、tokenizer、分割、上下文长度和评测版本。以附录 A1 和 A2 的设置起步,分别记录因子非零数、打包后的总字节、以及运行时峰值。准确率使用原文注明的字段,保留逐任务分数;若两个基准系列使用不同协议,各自保留完整稠密对照。时间账拆为离线收集、分解、剪枝、重拟合、量化,再单测预填充与解码。第一次解码对照可以复用表 A14 的 batch 1、128 输入 token、100 解码步和热身方案;跑通后再改变长度、并发或内核,每次记录实际发出的 token 数和峰值内存。这样才能识别是在同样的任务上更快,还是少执行了一部分工作。
本笔记实际核算了秩预算、输入加权截断、单坐标补偿、固定支撑最小二乘,以及图 3、表 3 和表 A14 的比例。小矩阵验算没有调用模型,不是对论文实验的重跑;复现设计是后续可做的对照。
结论
DictLLM 提供了一种有说服力的预算分配:先摊销输入侧的公共方向,再让每层自己挑系数,最后分别决定两边用多少位。最有解释力的证据来自剪枝后重拟合:维持原来的稀疏位置和秩,仍然能从相同表示规模里挽回部分质量。FP16 解码实测也表明,在论文给出的形状与后端上,部分容量收益确实转成了吞吐。若要采用这条路线,我会先确认共享是否改善留出样本上的逐层误差,再用实际打包和端到端延迟来决定稀疏模式和精度。摘要的表示倍率只适合作为估算起点。
参考资料
- Park、Chun、Seok:DictLLM,arXiv:2611.08082v1。正文、原图、表格及附录编号均据此。作者项目页。
- Wang 等:SVD-LLM、Basis Sharing。两种低秩比较方法,对应原论文参考文献 [8] 和 [9]。
- Frantar、Alistarh:SparseGPT,局部二次剪枝背景。另参照原论文参考文献 [16] 的 Blackwell 技术说明。