笔记日期: 2026-11-06(UTC)
作者: Zhongzhu Zhou
阅读论文: Differentiable Bit-Widths: Co-optimizing Pruning and Quantization via SVD for Ultra-Efficient LLM Compression
论文作者: Hankyul Kang、Jongbin Ryu
arXiv: 2610.06026
版本与日期: v1,2026-10-05
1. 我怎样理解这篇论文
读完 DBW,我最愿意保留的是一个很具体的想法:不要先决定丢掉多少个低秩分量,再研究剩下的分量用几位表示。可以让每个分量直接竞争精度预算,分到零位就删除,分到正整数位就保留。这样,裁剪和量化成了同一个分配问题里的两个结果。
这件事在极低位宽下尤其重要。假如先裁掉一个有用方向,后面的量化再精细也找不回来;假如为了保留所有方向而把精度摊得太薄,每个方向都会带来很大的数值误差。DBW 用校准数据上的重建误差,让优化过程在“少留几个、表示准确些”和“多留几个、表示粗一些”之间寻找平衡。它还允许不同矩阵争取不同预算,而不是要求注意力投影和 MLP 一视同仁。
论文报告,在 LLaMA-2-7B、1.61 有效位的设置下,八个基准的平均准确率为 49.06%,PTQ1.61 为 39.20%,FP16 为 63.19%。这三个数字必须一起看:DBW 明显改善了极端压缩的结果,但距离原模型仍有不小差距。我不会把“优于另一个低位模型”直接改写成“能力基本不受损”。真正要部署时,先得知道应用能承受多少损失。
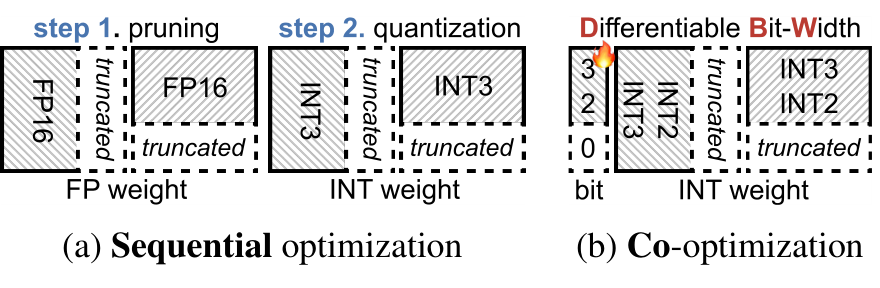
图 1(原论文 Fig. 1):截取自论文。顺序流程先裁剪、后量化;DBW 在同一次分配中选择零位或正精度。它解释的是决策方式,没有给出任何实测误差曲线。
本篇笔记基于完整 31 页 PDF,包括正文、A–F 附录和作者清单。下面的模型性能均来自论文;我自己做的数字换算与教学例子会明确标注,没有运行新的模型压缩实验。作者提供的资源入口可供以后开展研究时使用。
2. 前置知识:一个 SVD 分量究竟是什么
考虑权重矩阵 ,输入采用列向量约定,线性层输出为 。令 ,薄 SVD 可以写成一组秩一外积之和:
每个分量都先沿 读取输入,再沿 写入输出, 决定强度。删掉它,等于移除一整个输入到输出的方向映射,并非只把几个零散权重清零。保留前 项,就得到经典的秩截断。
等式右侧如此简单,依赖初始化 SVD 的正交性与精确算术。它说明截断在未加权矩阵误差下的性质。因素被量化、向量被继续学习以后,不应再把这条等式机械套上去,更不能由此推出语言模型误差也最小。
为什么实际激活有用?把一批输入排成矩阵 ,输出误差可以逐步展开为:
这里 是输入列数, 是这批数据的二阶统计。推导只用了平方范数与迹的关系,却已经说明一个关键问题:某个权重方向在矩阵范数里不显眼,在常见或关键激活上仍可能很重要。DBW 用真实 block 输出提供这种数据相关信号。因此,后文的谱熵直觉只是辅助解释,不能代替激活敏感度。
从计算角度看,低秩层先做 ,再乘以对角系数和 。中间维度由原来的完整维度变成 。秩足够小时,存储和算术都可能减少;但如果秩仍大,两个因子的总大小甚至可能超过原矩阵。低秩是一种表示方式,“已经分解”本身还不是节省保证。
3. 先把预算的单位说清楚
DBW 中最容易被混在一起的,是分量精度、原始权重的有效位宽和实际内存。一个保留分量包含长度分别为 、 的两个向量。如果它们都使用 位,暂时不算量化参数、填充和独立奇异值存储,净载荷是:
这是在上述存储约定下的记账恒等式,并不声称它逐字对应作者的导出布局。写出它,是为了提醒自己:因子元素和原矩阵元素的分母不同。以方阵为例,完整双因子有约两倍于原矩阵的元素;保留一半分量、每个因子元素三位,得到的净载荷约为每个原权重三位。不能省掉形状因子,只用“保留比例乘剩余精度”就解释所有 bpw 数字。
矩形矩阵还会改变这个换算。MLP 的 up/down 和注意力方阵既有不同的元素数,也有不同的因子开销。同样增加一个分量的一位,消耗的字节可能不同。因此,跨矩阵分预算时,标量的和保持不变,并不自动等于物理字节的和保持不变。
论文附录 A.2 明确区分了有效位与模型权重内存:embedding 等部分保留较高精度,量化尺度和偏置也计入实际权重开销。我在笔记中保留原表的标记,不自行把所有数量换成一个指标。按论文 LLaMA-2-7B 的 12.31GB 与 1.56GB 换算,权重压缩约为 7.89 倍;而 约为 9.94 倍。后者只是理想位宽比,不能取代前者。
运行时还要再往外看一层:KV cache、激活、低秩中间结果、累加缓冲、分配器余量都要占内存。权重变小后,缓存甚至可能成为新的主导项。论文的模型权重数字有参考价值,但不足以证明相同容量的设备可以完整运行所有目标工作负载。
4. 分量位宽怎样从连续数变成整数
DBW 为每个分量设置可学习参数 。它先经过 ReLU,归一化成一组比例,再把矩阵预算 按比例分下去。我把连续配额记为 ,避免将“可学习分数”和“已经分到的位数”混写:
当 时,连续配额的和正好是 。但向下取整会丢掉小数部分,整数总和一般低于预算。若 是整数,记差额为 ,Hamilton 方法把这 个单位分给小数余量最大的分量:
最后一个等式有条件:预算必须能整数化,分量必须有可行精度,归一化分母必须有效。如果允许的精度限制在零到五位,已经达到上限的分量不能继续领取差额;如果矩阵预算本身是连续数,也得先说明舍入策略。正文的简洁公式没有展开所有这些角落,未来复现应把它们写成明确约定。
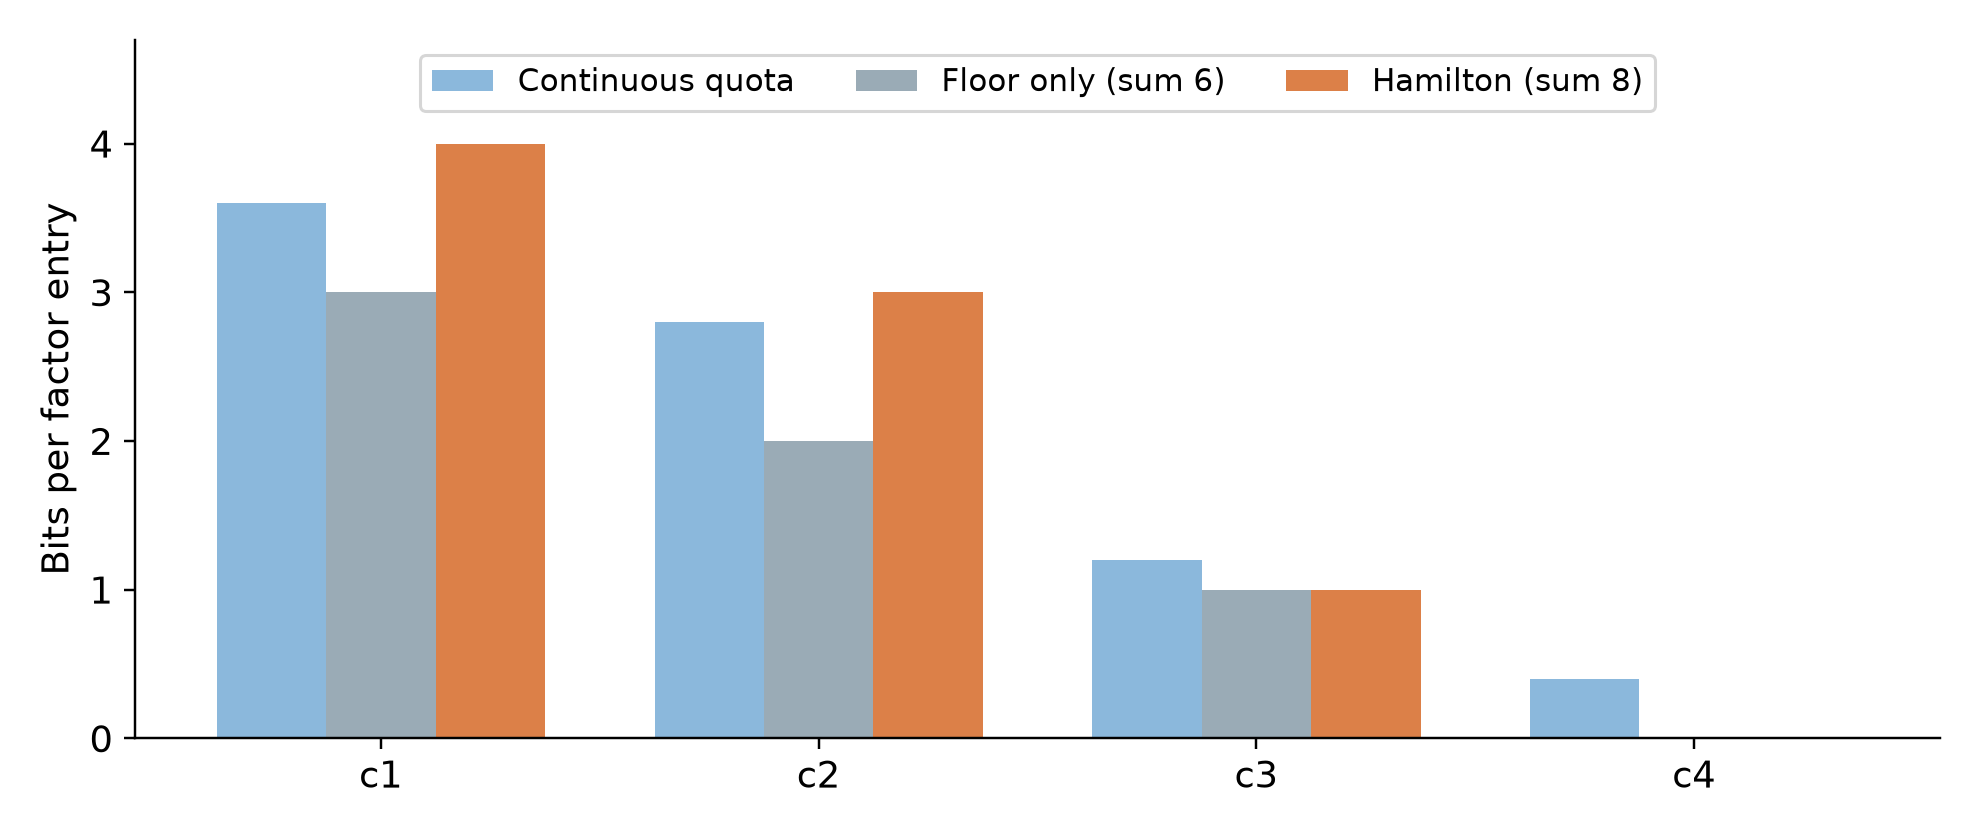
图 2:我构造的教学算例,不是模型实验。连续配额为 ,总和八。向下取整只花六个单位,再按余量给第二、第一分量各加一,得到 。
这个例子也直观展示了裁剪:第四个分量最终没有预算,直接被移除;第三个虽然没有领到额外一位,却依然以一位精度保留。零位并不是“极粗糙地表示一个小值”,而是结构上没有这一项。
算法 1:分量整数位宽分配
以下根据正文 2.2 节和附录 C.2 展开,加入显式前置条件和稳定的平局规则,方便理解。
1. 输入连续分数 beta、整数预算 A 与可行精度范围。
2. 要求 ReLU 后的分数总和为正,且预算可分配。
3. 计算 a[c] = A * relu(beta[c]) / sum(relu(beta))。
4. 令 k[c] = floor(a[c]),余量 r[c] = a[c]-k[c]。
5. 计算待补预算 R = A - sum(k[c])。
6. 按余量从大到小选 R 个可行分量;平局使用固定顺序。
7. 被选分量 b[c] = k[c]+1,其余 b[c] = k[c]。
8. 检查 sum(b) = A 与各分量上下限,返回 b。
附录 Table 11 比较了只取整、随机补足和 Hamilton。后者的 PPL 为 10.54、准确率 49.06,随机补足为 11.86、46.18。只取整版本根本没有花完预算,所以它变差不能单独证明 Hamilton 的排序更优;随机补足保持相同差额数量,是更有解释力的对照。
5. “可微”指的是近似学习信号
整数位宽关于连续分数,是分段不变、在边界跳变的映射。DBW 用直通估计器(STE)传递替代梯度。这里的可微是一种优化习惯说法,不能理解成真实离散映射在所有地方都有正常而有用的导数。
在相关 都为正的区域,对归一化连续配额求导,可以看清分量之间的竞争:
一个分数增大,自己的配额增加,别人的配额被挤走。所有分数一起乘同一正数,前向分配不变;这产生一个冗余的尺度方向。另一方面,当 很小时,梯度可能被放大。ReLU 的负区间还涉及一个实际问题:已经落到负分数或零位的分量,如何重新获得精度?需要明确边界附近的替代梯度,而不能只看前向公式。
附录说 Hamilton 对每个分量最多修正一位。这个结论约束的是前向数值,不是梯度误差。当两个余量几乎相等时,极小扰动就能交换领取者,而两者对输出的敏感度可能非常不同。论文的最终性能证明了测试设置中可以有效工作,却没有因此给出一般性的收敛保证。我更愿意把它看作经过实验证实的近似优化选择。
6. LBQ:让位宽进入数值缩放
只有整数分配还不够,重建误差必须能够向位宽分数传回信号。DBW 的第二部分是 learned bit-width quantizer,简称 LBQ。对某个向量或量化组,令最小值和最大值为 ,先把权重归一化到 ,再按 位所对应的整数范围进行缩放、舍入和还原。
这对应附录 C.3 的正位宽分支,前提是 、,且归一化值在范围内。恒定组需要单独处理;若还使用裁剪,导数也需要相应约定。论文主要设置的 group size 是 128。分组可以让数值范围更贴近局部分布,代价是更多尺度、偏置及相应存储开销。
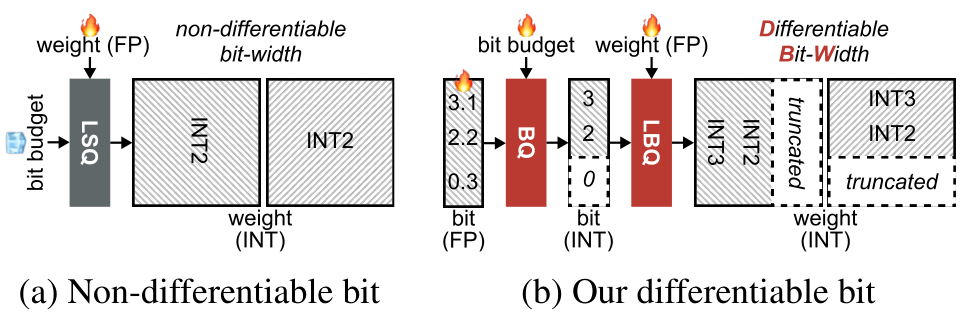
图 3(原论文 Fig. 2):截取自论文。BQ 将连续分数变成整数位宽,LBQ 用它量化因子。关键是位宽进入了缩放过程,而不仅仅出现在一个裁剪上界中。
我用一个局部推导理解它的学习信号。暂时把 固定,用 STE 将舍入导数近似为一,记 。对分子与分母同时求导:
因此,只要存在舍入残差,位宽就有机会获得信号,不必等到权重超出裁剪范围。这是我在明确假设下推导的替代梯度,不是离散量化的精确导数。如果最值也参与变化、分组边界改变或裁剪激活,完整导数还会有额外项。
零位尤其不能直接代入。此时 ,正分支的除法没有定义。论文明确把输出定义为零,意味着删除该分量。正位宽分支与零分支在前向上可以清楚区分,但如何在反向中跨越边界,仍需约定。公式中的 也提醒我们,靠近零的连续近似并不是自然平稳的。
可替代的路线是给每个分量维护多个候选量化器,用软权重混合后再硬化。这能提供另一种梯度,但计算、显存和最终选择成本都会增加。固定位宽量化更简单,却失去了精度竞争。DBW 的优势是用较少标量表达这个选择,适合大模型;相应代价是对代理梯度行为的依赖更强。
7. 矩阵之间也需要分配预算
只在分量内部优化,仍可能强迫所有矩阵使用相同资源。DBW 再引入矩阵级参数 ,把一个 block 的总预算 分给不同投影:
这是论文式(3),我把分配结果记为 。公式要求分母不为零;要得到合法非负预算,还需要合适的参数约束。附录 C.4 展示了若干矩阵预算没有塌缩到零的轨迹,并明确指出这是经验观察。重建损失会惩罚破坏必要矩阵,但不等于在可行域中加入了一个严格正下界。
这时再次要问预算的单位。如果 是原权重 bpw,物理总预算需要乘以该矩阵元素数;如果它是分量精度的和,则要使用式(4)里的另一组形状系数。不同单位直接相加,即使保持总和也不能自动守恒字节。Table 19 特意说明平均有效位要按矩阵元素数加权,这条注释对理解结果十分重要。
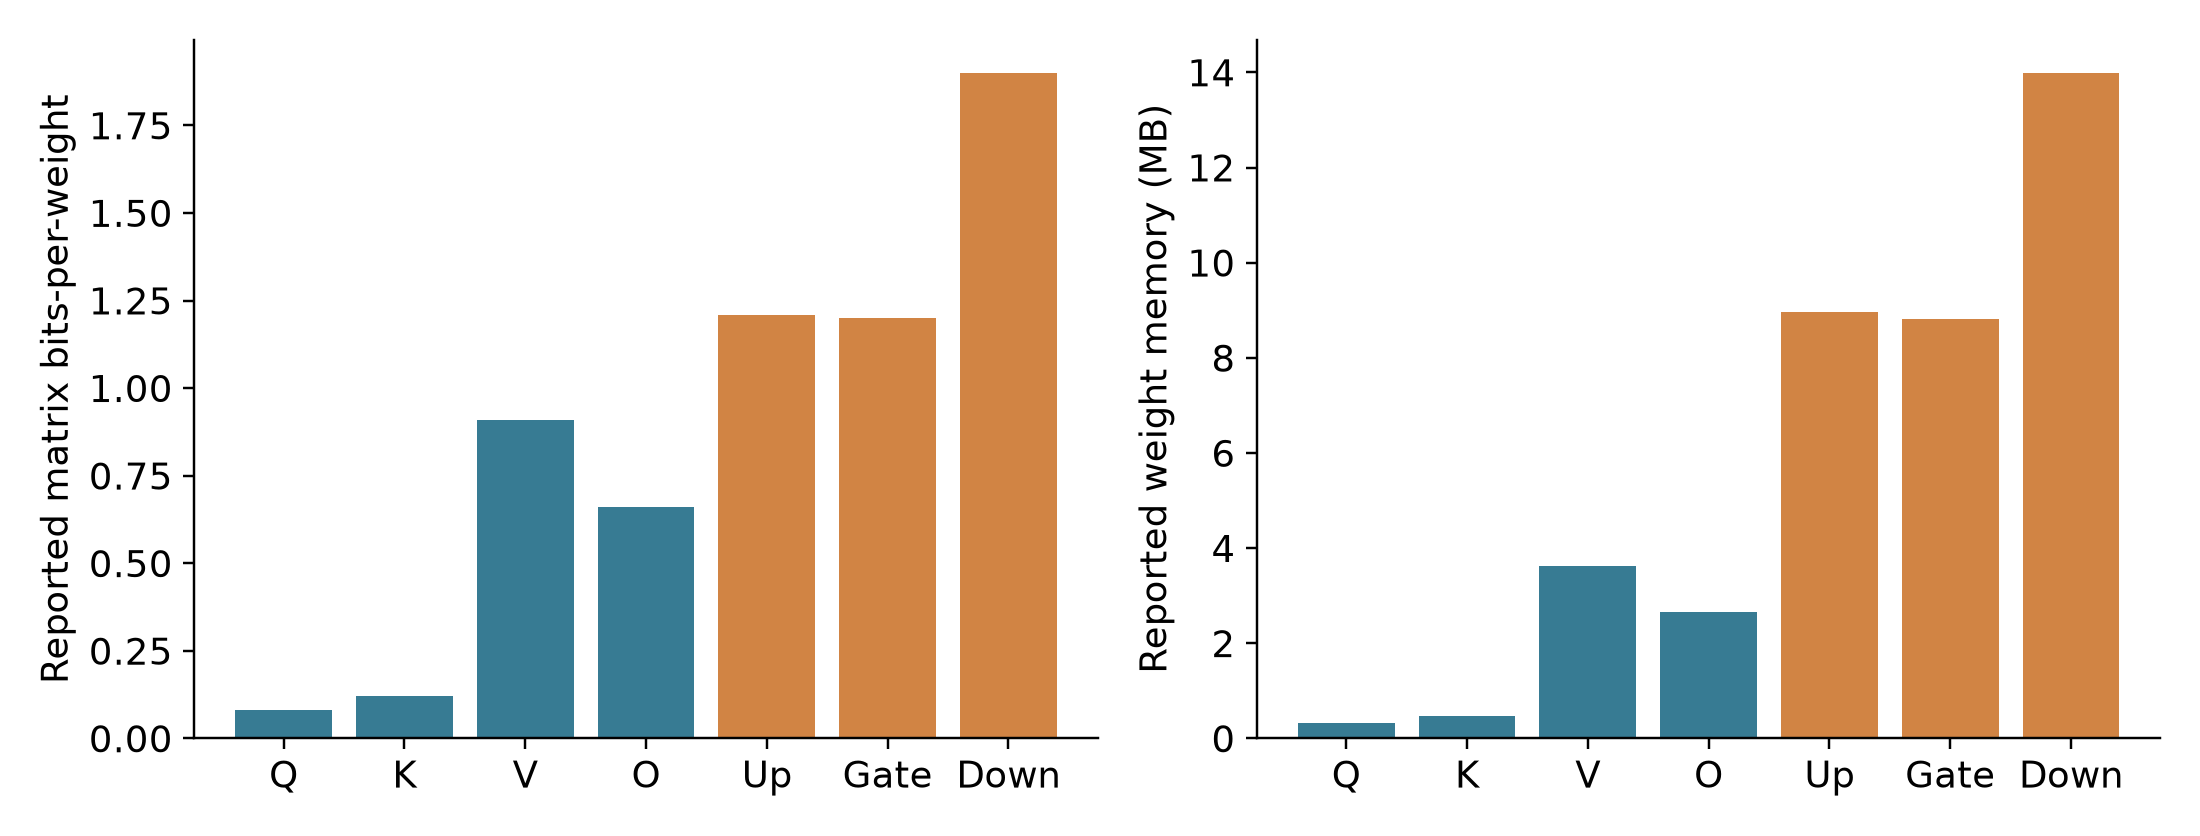
图 4:按原论文 Table 18 的 LLaMA-2-7B 数据重绘。Q、K 的报告位宽及内存远低于 MLP down。图表示的是实际表格趋势,没有证明谱熵是敏感度差异的唯一原因。
从结果看,矩阵级学习确实提供了额外自由度。Table 19 中 single-level 准确率为 48.77%,bi-level 为 49.06%,增益为 0.29 个百分点。这个增益值得记录,也应与“均匀分配到自适应分配”的大幅收益区分开,不能把所有改进都归给第二层预算。
一个很有价值的设计问题是:当 MLP 需要更高预算时,应从哪些矩阵取回资源?直接按谱熵排序是一种便宜替代,但会忽略激活和非线性传播。DBW 让 block 重建误差参与决定,是比纯规则更灵活的选择。不过,局部 MSE 的偏好是否与下游生成质量一致,仍由实验回答。
8. 熵正则在鼓励什么
论文还学习奇异值系数,并最小化它们归一化后的熵。设 、,则有:
当少数系数占主导,熵就比较低;很多尾部系数趋于零,裁剪更容易。这解释了正则项的直觉。但仅仅让分布集中,并不能保证保留下来的方向对任务有用。重建误差负责约束“不能为了集中而丢失必要输出”。
在所有系数为正的局部区域,先求 对 的导数,再代入链式法则,可以得到:
小概率系数往往受到继续缩小的压力,较大的系数则可相对增强。这里也存在数值细节: 在零处极限为零,导数却不温和。实际算法必须处理零值和很小的分母。它们不改变熵的定义,却影响学习是否稳定。
我对“奇异值熵”还有一个保留意见。初始化时,对角系数确实是原矩阵的奇异值;若后续同时更新 ,而没有保持正交,那么这些对角参数未必仍等于重建矩阵的真实奇异值。把一列因子放大、对角系数反向缩小,可能保持乘积不变,却改变系数熵。此时熵正则约束的是参数化,不完全是与表示方式无关的谱性质。
替代方案包括维持归一化或正交因子,或者直接对重建矩阵的真实谱施加约束,但都会增加计算或限制优化空间。更轻量的研究补充,是同时展示若干层的因子列范数、真实谱、系数熵和激活加权误差。这样就能判断“熵下降”究竟对应更可压缩的结构,还是部分来自尺度重分配。
9. 逐 block 校准:在局部输出上学习
DBW 每次只优化一个 transformer block,其余 block 固定。它在同一批激活上比较压缩 block 与原始参考 block 的输出,目标是重建实际功能,而不是逐元素逼近原权重:
包含投影、非线性和注意力等 block 内运算。这里固定参考参数 ,学习因子构成 。具体 MSE 是否还按 token 和特征维度平均,会影响它与各矩阵熵项求和时的相对尺度。论文写了相加的目标,复现时仍应报告 reduction 和正则尺度。
附录 A 的设置为:RedPajama-1T 随机抽取 4,096 条序列,长度 2,048,两个 epoch,batch size 为二,Adam 与 cosine 调度。权重及分量位宽学习率为 ,矩阵预算为 。主要实验使用 group size 128。之后还有一次较快的量化参数校准,用来减轻 block 之间的分布偏移。
算法 2:DBW 校准与导出流程
以下把论文 Algorithm 1 与 2.3 节导出过程连在一起解释,不代表我执行过该过程。
1. 保存目标 block 的校准输入与固定参考输出。
2. 为每个投影初始化 SVD 因子、对角系数和位宽分数。
3. 每轮更新先归一化矩阵预算。
4. 对各矩阵调用算法 1,得到分量整数位宽。
5. 量化两侧因子;零位分量在前向中输出零。
6. 在相同输入上计算压缩 block 的输出。
7. 求重建损失与系数熵之和。
8. 用替代梯度更新因子、系数和位宽分数。
9. 完成 block 后执行论文描述的快速参数校准。
10. 按位宽把保留分量分组,打包两侧因子。
11. 保存数值范围、偏置、维度与组边界。
12. 继续下一 block,最后评估完整压缩模型。
这样的局部训练把显存需求控制下来。论文描述用 24GB RTX 3090 与 256GB 主机内存进行校准,说明不必让所有训练状态同时驻留显卡。但它不是没有优化成本的格式转换。Table 9 中的 8,192 个 seen samples 来自 4,096 乘两个 epoch,而且对 block 重复,不能理解成整个大模型总共只消耗这些序列的计算。
逐 block 的边界也很实际:当前输出接近参考,不保证所有层串联后误差仍小。输入来自原模型还是逐步压缩的上游,会影响校准分布。全局端到端训练能够直接看到层间交互,却增加成本;在局部校准之后加一个短的全局纠偏阶段,是可以研究的折中。
10. 导出后,实际要计算两个因子乘法
校准结束后,位宽可能在分量之间交错分布。直接保持这种排列会让低位打包和调度很麻烦。论文先按位宽排序,把同精度分量放在一起。令 表示 位分量集合,对输入矩阵 ,每组可以这样计算:
论文说明对角缩放可以吸收进反量化参数。每组内部的两次乘法存在依赖,必须先有 ;不同精度组则可以重叠执行,最后累加部分输出。排序时必须对两侧因子和对应系数使用一致置换,否则表示的矩阵就变了。
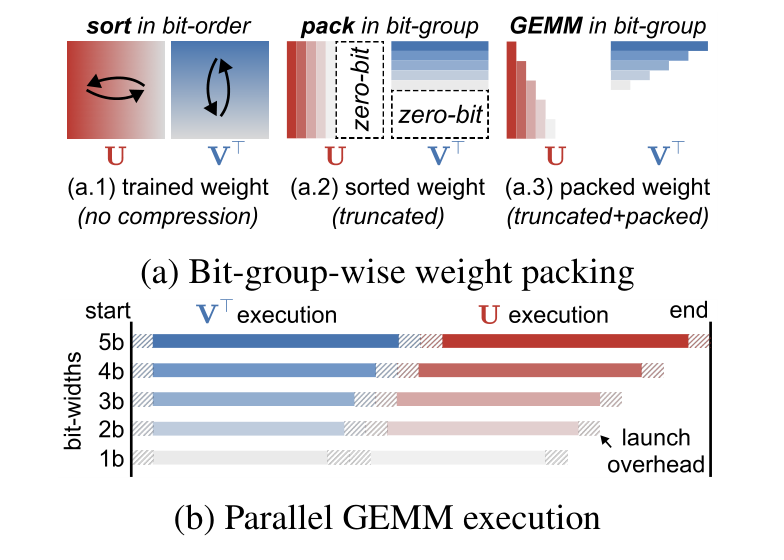
图 5(原论文 Fig. 3):截取自论文。同位宽分量形成规则密集子问题;与此同时,每个非空组也会带来启动、调度和累加开销,图中明确显示了这部分代价。
双因子乘法的近似 FLOPs 为 ,原密集矩阵为 。因此减少乘法量的条件是:
方阵的阈值就是 。所以,“裁掉了一部分分量”并不自动保证 FLOPs 比原矩阵低。矩形投影的阈值又不同。低精度可以减少权重搬运字节,但不必然以相同比例减少浮点乘加,必须分开讨论。
论文使用的是权重量化后按需反量化,再进行浮点计算的 GEMM 路线。不能把它描述成 GPU 原生执行任意三位矩阵乘。附录 C.5 对三位、五位这类不能整除 32 位字的精度,提出拆成可规则打包的位平面,例如三位拆成两位加一位,读取时再通过位操作组合。token 数较多时这类开销较容易摊薄,小组工作量较少时则更显眼。
另一个选择是先重建完整密集权重再乘输入,计算接口简单,却需要大临时张量,也可能失去持续压缩权重流量的优势。完全融合各位组则可能减少 launch 次数。作者把进一步融合列为可改进方向,不能把当前 CUDA streams 的分组方案写成已经完成的融合推理引擎。
11. 实验比较,哪些最能支持核心主张
正文覆盖 LLaMA-1/2/3,从 7B 到 70B。语言建模指标是 WikiText-2 和 C4 的困惑度,序列长度 2,048;准确率来自 PIQA、ARC-Easy、ARC-Challenge、HellaSwag、WinoGrande、RACE,以及两个 LAMBADA 版本。附录 A.2 给出 lm_eval 0.4.2 和 Transformers 4.40.1 等评估条件。这些条件很有意义,因为任务提示、截断方式和评测约定都会影响准确率。
八项均值是对基准等权平均,不是对真实工作流成功率的测量,也不能代表长文本推理、置信度、工具调用或指令遵循。Table 2 的跨模型 PPL 平均还会排除缺失与 NaN 项;如果不同方法缺失的模型不同,平均分的分母就不一致。看各模型行的比较,往往比只看整体平均更可靠。
最贴近论文中心问题的是 Table 5:顺序 SVD 加量化,与 DBW 放在相近报告有效位及权重内存下比较。LLaMA-2-7B 的 SVD-LLM 加 OmniQuant,PPL 为 77.10、准确率 29.35;DBW 为 10.54、49.06,两者报告权重内存都是 1.56GB。这说明测试配置中的联合流程明显更好,不只是提出了一个漂亮概念。
但这个比较仍包含多个变化。DBW 同时学习分量位宽、矩阵预算和对角系数,并用 block 输出重建。更严格的消融应尽可能匹配训练目标、可学习参数、校准计算和量化范围处理,只固定或开放“联合分配”这一因素。论文后面的控制实验在接近这个目标,但不能把所有差别都简化为一个开关。
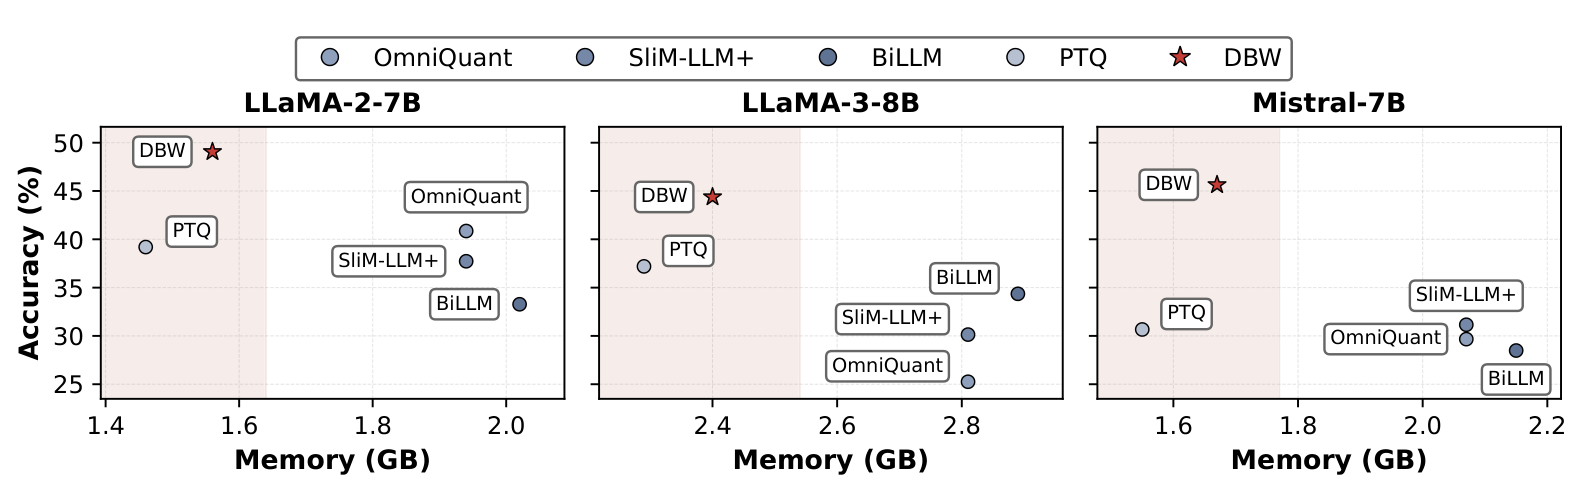
图 6(原论文 Fig. 4):截取自论文。DBW 在这些测试点上处于有利区域。横轴是权重内存,纵轴是基准均值;它没有纳入 KV cache 和运行工作区,也不是对所有可能方法的全局前沿证明。
Table 6 还比较了结构化裁剪方法,但基线保留 FP16 权重,DBW 使用低位因子。匹配裁剪比例有助于理解结构变化,却不等于匹配最终字节。作者明确列出了内存列,这一列应与准确率一起阅读。否则容易把不同量化成本带来的优势全部归给低秩结构。
12. 相对更好,与绝对可用,是两道问题
我认为 Table 3 最适合帮助读者判断取舍。它展示 LLaMA-2-7B 在不同位宽下的结果。表中的 PPL 是 WikiText-2 和 C4 困惑度的算术平均,不是把两个语料拼起来重新计算的 pooled perplexity。
| 设置 | 报告有效位 | 平均 PPL | 八项平均准确率(%) |
|---|---|---|---|
| FP16 | 16 | 6.22 | 63.19 |
| DBW | 2.0 | 9.56 | 51.90 |
| DBW | 1.61 | 10.54 | 49.06 |
| DBW | 1.0 | 14.97 | 39.66 |
| DBW | 0.5 | 27.68 | 30.93 |
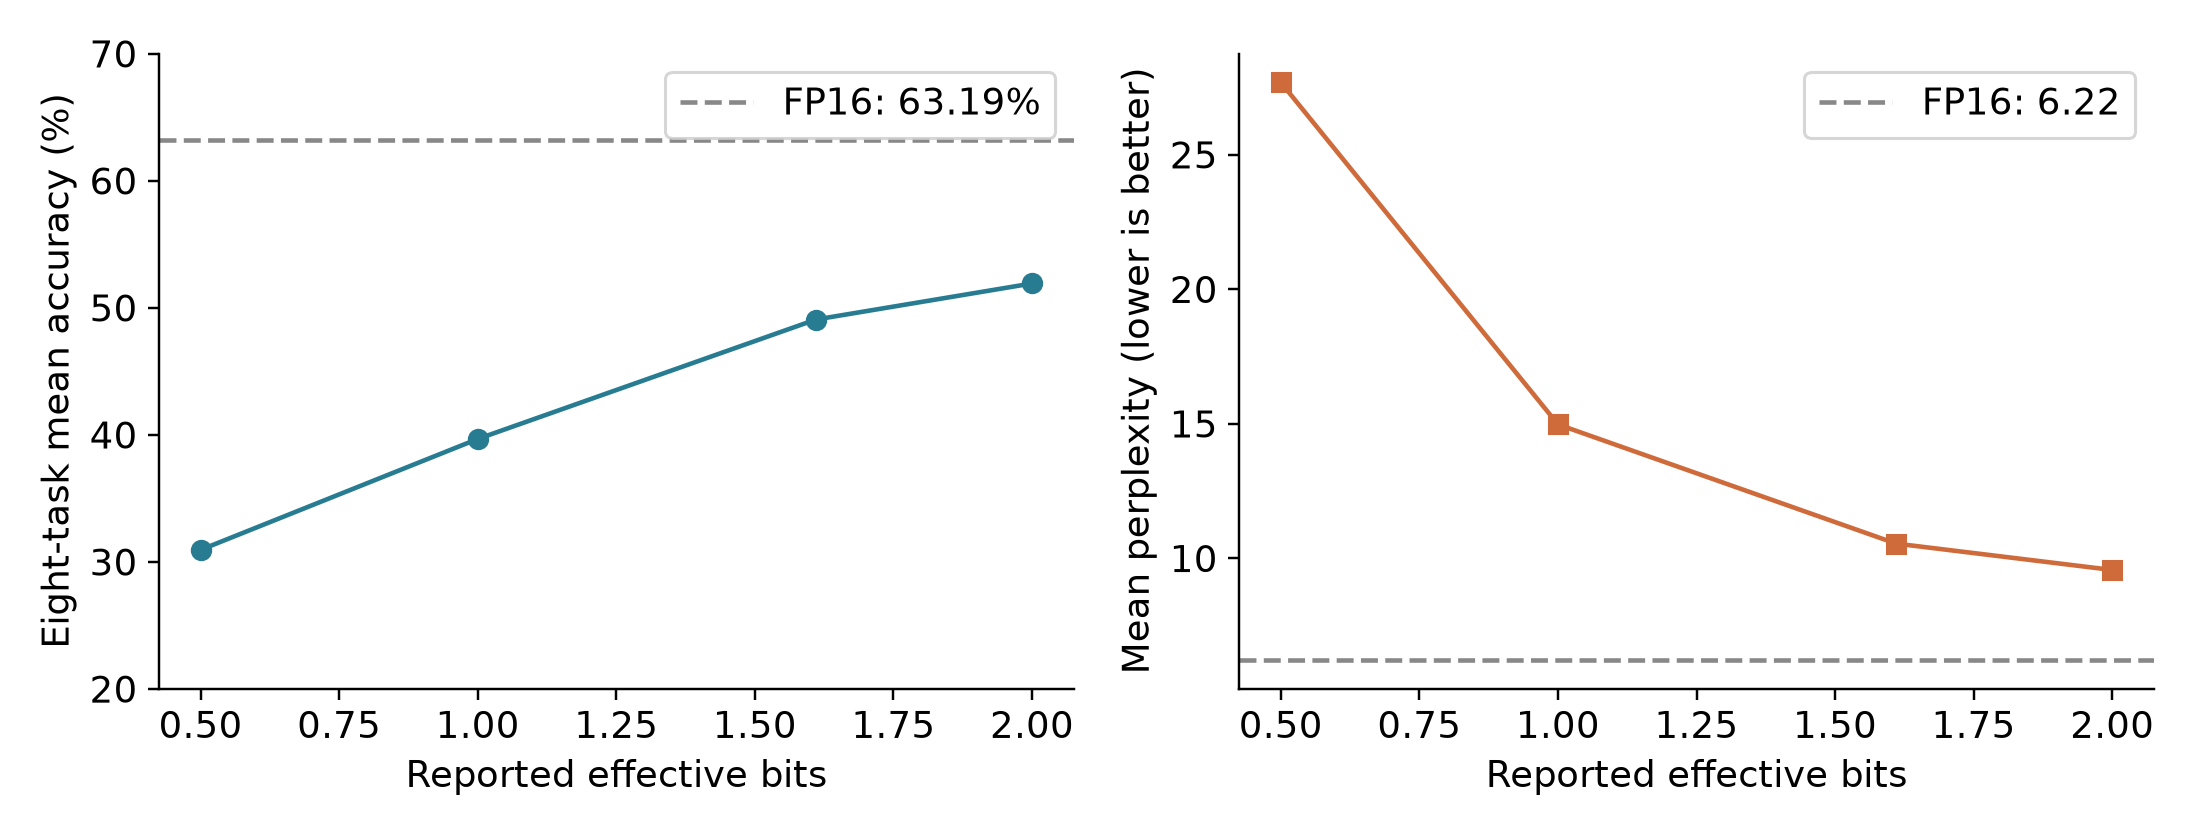
图 7:按原论文 Table 3 重绘。虚线保留 FP16 参考,避免只展示压缩方法之间的相对胜负。相邻点之间的线只是方便阅读,不代表中间位宽也做过实测。
由表格相减,1.61 位 DBW 相比 FP16 下降 14.13 个百分点;相比 PTQ1.61 提升 9.86 个百分点。这两件事可以同时成立。只讲提升会掩盖用户最终承受的损失。PPL 从 6.22 增至 10.54 也说明退化明显,但这两个算术平均 PPL 的比值,不能直接当作 token 错误率的比值。
对数学推理的判断更应谨慎。附录 D.2 中,1.61 位 LLaMA-2-7B 的 GSM8K 为 2.12%,PTQ1.61 为 0.61%;前者更高,但绝对表现仍然很低。同设置的 MMLU 为 23.89%。这些数据不足以支持“复杂推理能力得到可靠保留”的表述。论文基准更广,是优点;新增结果揭示了能力边界,也应同样保留。
非 LLaMA 的实验提供了一些外推证据,但绝对退化并不小。Table 4 的 Gemma-7B 从 PPL 8.82 变为 74.49,准确率从 66.37 变为 30.27。即使胜过被比较的 BiLLM,也不能说这个压缩点已适合应用。Mistral-7B、Qwen-2.5-7B 说明方法可以迁移操作,仍需更多架构和工作负载来判断稳定规律。
Table 14 加入 instruct、distill、chat 变体,说明压缩流程不限于基础预训练模型。这与“对话行为保持不变”是不同命题。八项均值没有直接检验结构化输出合法率、工具参数、拒答边界和多轮一致性。如果未来用在 agent 上,这些比单纯多选题更接近实际失效位置。
压缩方案的选择也应因此改变:不是先追求最小 bpw,再接受剩余质量;而是先确定应用的最低质量线,再寻找满足它的最小成本点。DBW 的连续预算机制很适合探索这样的曲线,只是论文当前主要展示固定压缩强度下的比较。
13. 消融显示,收益来自哪些部分
Table 7a 中,LLaMA-2-7B 的均匀分配准确率为 25.05,SVD 感知启发式为 45.10,可学习分配为 49.06。学习相对强启发式的增益是 3.96 个百分点。对理解论文而言,这比强调相对均匀分配提升二十多个点更有解释力:大部分收益在考虑分量重要性后已经出现,学习再进一步改善。
Table 7b 则逐步打开学习对象。只学习分量位宽,PPL 为 11.01、准确率 48.42;加入矩阵预算为 10.74、48.80;再加入奇异值系数学习为 10.54、49.06。各部分都有贡献,但增益尺度不同。LLaMA-1-7B 的最后一步还出现准确率上升、PPL 从 10.54 略增到 10.65,说明两个指标并非总是同向。
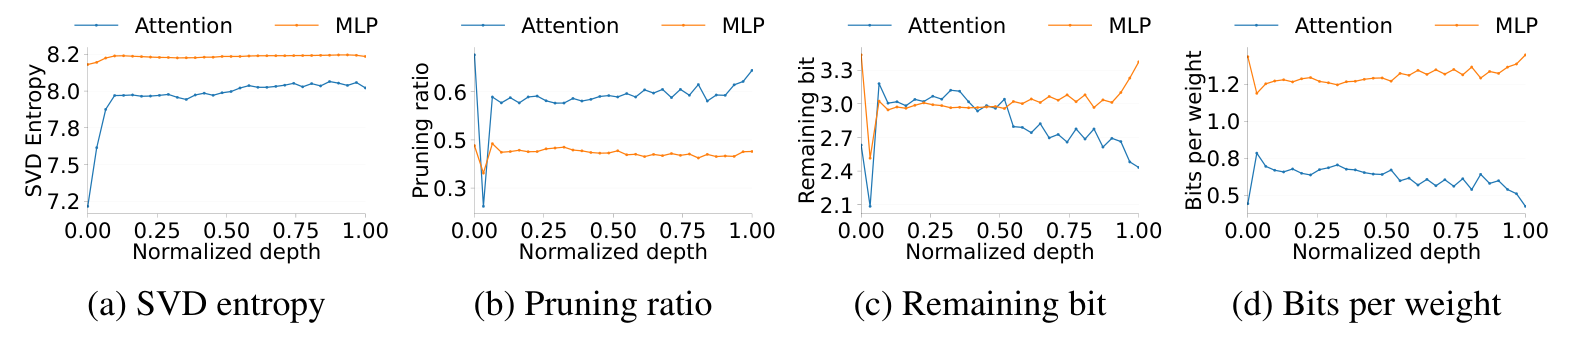
图 8(原论文 Fig. 13):截取自论文。Attention 与 MLP 的熵、裁剪率、剩余精度和有效位都不同。这说明分配具有异质性;输出敏感度和激活也同时变化,不能仅凭这些曲线断言熵是唯一原因。
附录 D.3 进一步搜索了顺序基线的裁剪比例和剩余位宽,比只比较某一个顺序配置更有说服力。极端 0.5 位附近,有一个顺序配置以 0.77 报告位宽得到 PPL 21.62,而 DBW 在 0.50 位得到 27.68。顺序配置花了更多预算,不能称为等位宽击败 DBW;但它很好地说明比较时必须同时看码率与质量。
附录 A.4 对 LLaMA-2-7B 重复三个校准种子,平均 PPL 为 10.58、标准差 0.04,平均准确率 49.32、标准差 0.23;标注的 95% 区间半宽分别为 0.09 和 0.57。其量级与小样本区间相符,但具体构造方法没有完全展开。一个模型的三个种子是有用的稳定性证据,不能推广成所有基准与所有架构的误差条。
阅读附录时,我还保留了几处表述差异。C.6 正文写 BiLLM 的 PPL 从 35.60 到 39.55,但 Table 13 在 group size 128 下列的是 33.10。Table 16 的 1.61 位行使用裁剪比例 47.21,而 Table 17 的 LLaMA-2-7B 行为 46.95。笔记按各表的标签使用数据,不猜测哪个才是作者想修正的版本,也不把它们拼成一个没有来源的新结果。
14. 延迟结果要连同工作负载一起读
原论文 Fig. 5 使用 LLaMA-65B,横轴 context length 从 64 到 512,十次预热后平均三十次运行。64 token 处 DBW 比 OmniQuant 略慢,工作量增大后 DBW 更快。这符合分组启动成本需要摊薄的直觉,也是论文结果的一部分,不能只留下最快点。
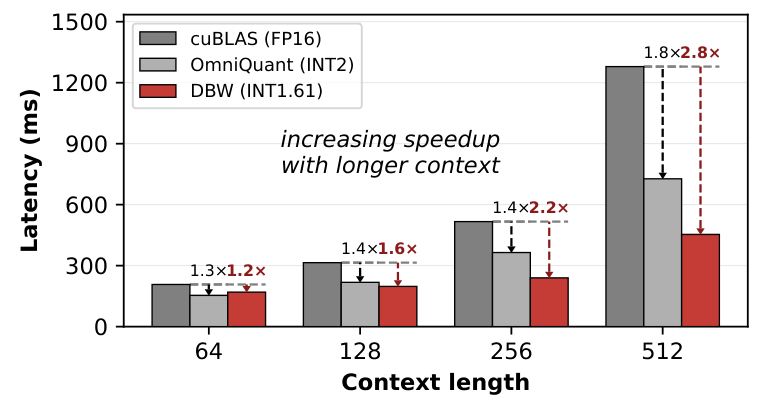
图 9(原论文 Fig. 5):截取自论文。512 处的 2.8 倍和 1.8 倍都以 cuBLAS 为共同参照。它们不是 DBW 相对 OmniQuant 的两个直接加速值。
按图中已经舍入的标注,512 处 DBW 相对 OmniQuant 的加速约为 。这是我根据图上数字做的换算,没有重新计时;因此不应给出看似精确的多位小数。论文的最大 2.8 倍针对 FP16 cuBLAS 参考,不应挪作另一种基线。
这里有一个值得明确追问的实验条件。附录 A.2 指定 24GB RTX 3090,而 Table 17 中 FP16 LLaMA-65B 权重为 121.11GB,显然无法完整同时驻留这张显卡。作者把图称作 end-to-end latency,但文本没有充分串联解释权重驻留、分层搬运,以及 FP16 参考究竟怎样计时。我保留这项不确定性,不自行补写 offloading 流程。没有澄清前,不能把结果直接外推为完整驻留服务的性能。
可以用一个诊断框架来理解,而不是把它冒充论文拟合模型:时间包含权重搬运、算术、反量化、launch 和输出累加。位组越多,启动和累加成本越大;token 越多,读取成本越容易摊薄,计算压力却更高。这解释了 bpw 不能单独预测延迟,也解释了 Table 12 中 INT3 虽然比 INT4 更省载荷,时间却可能更长。
正文没有覆盖并发请求、KV cache 压力、首 token 时间、逐 token 延迟尾部和长时间吞吐的完整服务实验。已有结果足以支持继续研究,尚不足以变成“实际服务吞吐提高某倍”或“总运行成本下降某百分比”的新结论。
15. 论文承认的局限
附录 F 给出了几个很清楚的范围边界:逐 block 训练没有显式捕捉所有层之间的全局交互;研究集中于语言模型和 sub-2-bit 权重压缩;没有联合处理激活量化与 KV cache 量化。正文也指出,视觉、语音和多模态架构仍需进一步验证。
硬件部分则是一个有优化空间的分组方案。每组都采用密集矩阵乘,不代表每组都足够大、足够高效。保留少量分量的多个小组,可能让启动和临时缓冲占据很大比例。完全融合是可能的改进方向,但需要额外设计,不能由数学上的分组自然推出。
通用文本校准还可能漏掉代码、罕见 token、数学中间状态和应用特有输入。局部输出 MSE 平均得很好,也不一定约束最差样本或离散行为失败。后训练变体的额外实验缩小了一部分不确定性,并没有覆盖所有实际行为。
权重压缩还会改变瓶颈。当模型权重从数十 GB 降下来,长上下文的 cache 可能成为主导,原先从权重流量推断的收益就会变小。因此最佳位宽并不是模型固定属性,也与并发数、上下文和设备容量有关。
16. 批判性分析:我希望怎样把论证做得更扎实
16.1 把守恒的对象从标量总和落实到字节
最值得补充的是一张从预算参数到存储字节的完整映射:矩阵形状、保留秩、两侧因子、位平面、分组尺度、偏置、embedding 和填充分别占多少。归一化仍然可以使用,但被归一化的每个量必须有明确单位。特别是方阵与 MLP 矩形矩阵,其一个分量的一位并不等价。
我会同时报告两种残差:一是整数位宽和与逻辑预算之差,二是实际序列化字节与物理目标之差。前者检验 Hamilton 是否分完了预算,后者检验方法是否真正满足存储约束。这会让“精确分配”和“固定内存”之间的关系更清楚,并不意味着现有内存测量就是错误的。
还应区分权重文件大小和加载后的权重驻留大小。打包张量、反量化参数、索引和缓冲区可能在不同阶段出现。把这些量以同一单位列出来,比只给一个理论压缩倍数更容易支持工程决策。
16.2 不把前向一位修正当作梯度保证
Hamilton 的每个分量最多加一位,是前向投影的性质;梯度会受到余量排序跳变、量化敏感度和零位边界共同影响。一个有针对性的实验,是保持相同离散导出和最终字节,只替换学习期间的松弛方式,再观察最终质量和分配轨迹。
除了最终 PPL,我会看接近平局时的位宽交换频率、损失突变幅度,以及分到零位后再也无法回来的分量比例。这样可以回答两个不同问题:学习轨迹是否稳定,以及稳定轨迹是否仍有系统偏差。只看终点,很难区分偶然收敛和可靠机制。
还可以把随机补足对照改成固定且可复用的随机规则,避免每步引入额外噪声,再与 Hamilton 比较。原实验已经表明 Hamilton 的最终表现较好,但这个更严格对照能够把“近配额投影”和“少了随机扰动”进一步分开。
16.3 检验系数熵是否代表真正的谱结构
初始化 SVD 的熵直觉很清楚,因子继续学习以后则多了尺度自由度。我希望同时比较系数熵、重建矩阵真实奇异值熵和激活加权误差。加入一个列归一化变体,可以观察去除部分尺度自由度后,正则的收益是否还在。
更进一步,MLP 获得更多预算可能因为谱更平,也可能因为非线性、激活分布或输出敏感度更高。论文图表证明这些现象相关,却没有隔离唯一原因。如果能在大致保持输出敏感度的同时改变谱分布,再观察分配变化,会更接近对机制的解释。
这里我并不要求一种昂贵理论替代有效启发式。真正需要的是限定解释范围:某个正则项有用,与其每个中间变量都具有表示无关的物理含义,是两种不同层次的结论。
16.4 让质量约束覆盖真实失败位置
GSM8K 的极低绝对值提醒我,压缩评估不应只围绕“同位宽比基线好多少”。更实用的问题是:在一组代表性任务上达到最低质量线,最少需要多少字节?对于数学、代码和指令行为,可以设置不同底线,避免平均分掩盖最差任务。
校准分布也值得控制。在相同 token 数与更新次数下,比较通用文本和文本/代码/数学混合校准,记录逐任务损失、生成答案质量、结构化输出合法率和最差任务退化。若采用生成评测,还要固定采样、长度上限与判分条件,防止输出变短或格式变化造成误读。
对 agent 而言,完整轨迹的工具选择、参数准确性和任务成功率,比单步多选题更接近使用场景。权重压缩是否会放大罕见错误,也值得用足够多样的任务观察。这些都是我提出的后续实验,没有在本次阅读中运行。
16.5 把延迟实验的驻留与计时边界写全
FP16 权重怎样放置、context length 表示什么、测量包含哪些阶段、是否发生主机与设备传输,应在同一处说明。可以增加一组较小模型在同一显卡完整驻留的对照,帮助区分压缩带来的核函数收益和大模型容量差异。
实际服务还应变化 batch size、提示长度、生成长度与缓存预算,并报告权重字节、峰值分配内存和延迟分位数。使用相同质量线的配置,才能回答“以同样可用性为前提,哪种方法更快”。只固定有效位,可能让速度与质量差异混在一起。
短上下文处 DBW 已经略慢于 OmniQuant,说明性能交叉点确实存在。后续工作的价值之一,就是把交叉点画清楚,让读者知道在怎样的形状和工作量下,额外位组会吃掉权重缩小的优势。
17. 复现要点与可操作的判断顺序
如果以后依据论文复现,我会首先固定模型家族与变体、4,096 条长度 2,048 的校准样本、两个 epoch、group size 128,以及两档学习率。参考 block 输出应保持固定,同时明确后续 block 接收的是原始上游激活,还是逐步压缩后的激活。这个选择会改变损失所学习的分布。
数学约定则应先于调参写清: 和 的单位,连续矩阵预算怎样整数化,精度上限怎样处理,余量平局怎样决定,分母为零与恒定组怎样定义,零位分支用什么反向约定。MSE 的平均维度和熵项尺度也应一并记录。否则看似相同的目标,实际正则强度可能差很多。
之后分别记录每个任务的准确率、两种困惑度、真实权重字节、运行峰值内存和精确计时范围,主要结果配合校准种子变化。把这些证据分开保存,才能发现是预算没兑现、质量没达标,还是运行开销抵消了理论收益。
本篇笔记做的是论文阅读、公式展开和数字口径检查。例如 7.89 倍、14.13 个百分点、约 1.56 倍都只是基于已报告数字的复算;图 2 是教学例子,图 4 和图 7 是标明来源的表格重绘。这些不构成模型或内核复现结果。
18. 结论
DBW 给出了一种值得继续研究的表述:每个低秩分量竞争零位或正精度,同一校准目标决定它是否存在,以及存在时如何表示。Hamilton 修复使整数前向分配在条件满足时守恒,LBQ 通过缩放提供替代梯度,矩阵预算和系数学习再增加灵活度。
我认为现有控制实验足以支持“联合分配在极端权重压缩中有价值”。同时需要带着四个边界阅读:预算单位仍须明确落实到字节;代理梯度不能直接升级为收敛保证;因子学习后的系数熵未必是表示无关的谱性质;相对低位基线更好,仍可能保留很大的绝对能力损失。
对应用而言,最后应当把质量底线、权重容量和实际工作负载放在一起选点。DBW 的价值,是让这个可选空间更灵活,而不是让所有模型在一个漂亮位宽下都自然变得可用。
参考资料
- Hankyul Kang、Jongbin Ryu,Differentiable Bit-Widths: Co-optimizing Pruning and Quantization via SVD for Ultra-Efficient LLM Compression,arXiv:2610.06026v1,2026。本文方法、实验、图表及附录讨论的主要依据。
- 论文 HTML 与附录 A–F。笔记中的原论文图表编号均指这篇论文。
- DBW 官方资源入口。本篇记录论文分析,没有新运行的模型实验。