笔记日期:2026 年 10 月 25 日。论文:VERSE: Verified Self-Evolving Optimizer for Agent Harnesses。作者:Zekai Wang、Yingqiang Ge、Zekun Wang、Hai Wang、Yuhui Xu、Joshua Frandsen、Shancong Fu、Ashia C. Wilson、Chandan K. Reddy。版本与日期:arXiv:2610.02616v1,2026 年 10 月 2 日。论文与 PDF · 作者资源入口。
本文依据论文全部 45 页及附录 A–L。实验数字来自作者报告;用于解释机制的假设算例、推导和后续实验建议均另作说明,不把它们写成新的复现结果。
1. 先把问题问准:改进者能否改进自己的工作方法?
一个编程 Agent 没有完成任务,并不一定是模型不会解题。它可能用了不对的 Python 环境,反复尝试无法连接的网络,在真正运行测试之前就耗光轮数,或者把本来正确的补丁送进 shell 时破坏了引号。围绕模型的工具接口、提示词和执行规则,确实能改变最后的结果。但知道这些地方可以修改,与知道下一次应该修改哪一处,是两回事。
VERSE 把注意力放在后者。它区分两套 harness:执行器的 harness 帮 Agent 做任务;优化器的 harness 帮另一个 Agent 阅读失败记录、提出修改、安排实验。优化器不仅改执行器,还可以改自己的提示词、技能、工具、钩子和笔记。真正值得研究的不是“允许它自我修改”这一动作,而是它凭什么判断自己新学到的经验是对的。
论文的起点很直接。在 Meta-Harness 上,只开放优化器自我进化、却不给提交前的执行检查,验证集最后选回了最初的执行器 harness。加入一个简单的草稿执行工具以后,同一组对照中最好的测试准确率变为 41.05%,固定优化器基线为 39.20%。后面的完整 VERSE 实验在同一 host 上得到 42.28% 的同分布结果和 37.69% 的新任务结果。这是两组不同配置的实验,不能把数字串起来,仿佛每增加一个组件都贡献了确定的增益。
我认为本文最有价值的观点是:自我改进首先要改进产生证据的方法。检查一个已经通过的任务有没有退步,把反复进行的轨迹检索整理成工具,区分“钩子被调用过”和“真正相关的分支执行过”,这些听起来很朴素,却比不断往提示词里追加宏大原则更容易产生可检验的收益。
也正因为如此,这篇论文不适合被概括为“让 Agent 修改自己就能越来越强”。主表中,完整 VERSE 相比没有这些组件的基线表现更稳,但与“只加工具、不让优化器自我进化”的版本相比,许多配置反而下降。能否从证据里学到恰当的规则,依然是一个没有被解决的问题。
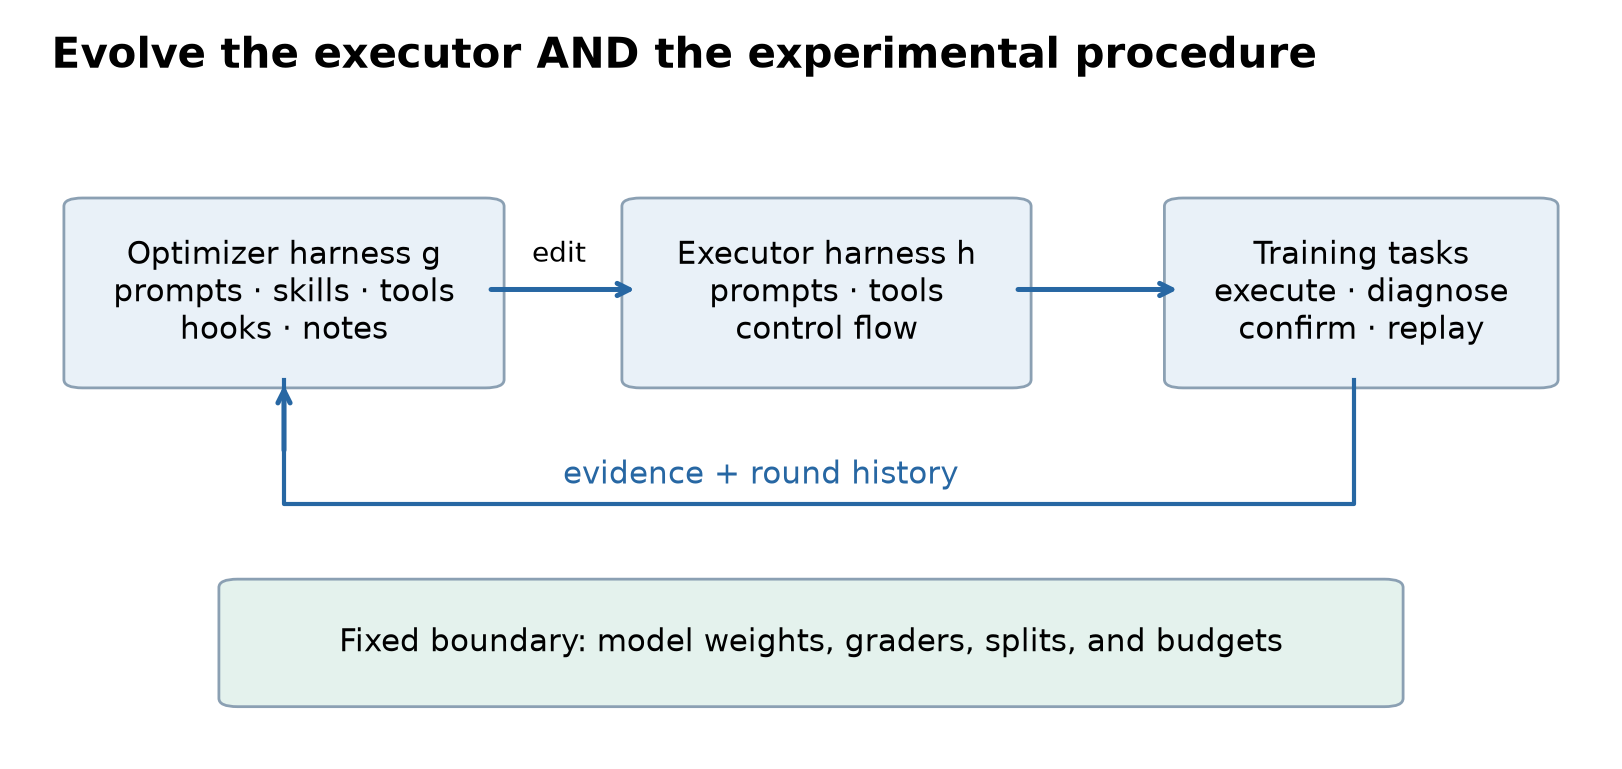
图 1. 根据正文第 2–3 节和附录 B 绘制的解释图。执行器 h 与优化器 g 在不同阶段改变;模型权重、评分规则、任务划分与预算保持固定。
2. 前置知识:执行、搜索和选择不是同一件事
2.1 Harness 到底控制什么
这里的 harness 指模型外部那套可执行配置:系统指令、工具、状态,以及在模型调用或工具调用前后发生什么的控制逻辑。执行器的钩子可能改写命令,或提醒 Agent 先测试再提交;优化器的钩子则可能限制无休止的日志搜索,给实验预留时间。同样叫 prompt、skill 或 hook,服务的对象不同,功能也完全不同。
记执行器模型权重为 ,配置为 ,任务为 。一次完整执行产生轨迹 ,包含模型动作和环境响应。论文用 表示这个过程,用 表示二元损失:成功为零,失败为一。真正关心的总体损失是
这个式子有两层平均。第一层问未来会遇到什么任务,第二层问相同任务执行时会出现什么结果。改 harness 是改变轨迹分布,而不是改变模型权重。即使模型采用贪心解码,运行环境、并发服务或任务执行仍可能带来变化。因此,“这次通过了”不能自动升级成“这个配置一定能通过”。
2.2 外层学习的对象是一套工作方法
优化器也有固定权重 ,但使用自己的 harness 。它负责在有限预算里为执行器生成候选。于是外层要学的对象,是以提示词、技能和程序等形式保存的优化方法,而不是新的神经网络参数。这里没有对环境反向传播,也没有通过策略梯度更新模型。
设第 轮、给定优化器配置时产生的候选集合为 ,概念上的两层目标是
第一层在训练任务上比较执行器候选;第二层希望改进产生候选的方法,让它以后找到验证表现更好的执行器。式子描述优化目标,不意味着作者能精确求出 的全局最优解。实际过程是语言模型根据一轮的观察修改自己的工作材料。
一个容易混淆的地方是“训练”这个词。论文里的训练任务供优化器观察、实验和筛选,不代表这些任务被用来更新 或 。同样,外层叫学习,也不意味着存在传统意义上的训练损失梯度。理解这一点,才能把它与联合更新 harness 和模型策略的工作区分开。
2.3 三种不确定性要分别处理
第一种是诊断不确定性:失败究竟来自命令参数、环境依赖,还是方案本身错误?第二种是执行不确定性:同一个候选再运行一次,还会不会成功?第三种是选择不确定性:面对几份都有噪声的成绩,筛选过程有没有留下真正能泛化的候选?
重放轨迹可以确认失败是否重现,但不自动指出原因。替换一个步骤可以检验局部因果猜测,但不等于证明新规则对所有任务都有益。验证集可以帮助选择,但如果每一轮都反馈结果,它也会逐渐参与训练。VERSE 值得精读,正是因为这些层次在论文中没有被压成一个最终准确率。
3. 数据边界:验证集没有原文,也不等于完全没参与优化
主要实验使用 SWE-rebench。训练集有 110 个任务,验证集有 50 个任务,来自一个包含 593 个历史任务的池。同分布测试使用 2026 年 3 月版本中可正常评分的 108 个 Python 任务。OOD 测试使用更新的 7 月版本,共 107 个可评分任务:Go 21 个、Java 17 个、Python 20 个、Rust 25 个、TypeScript 24 个。
这些分母不是随意挑选的展示数字。原本同分布测试池有 110 个任务,其中两个参考解在作者评分环境里也失败;OOD 原本有 111 个任务,其中四个 Java 任务同样被排除。理解这个过滤过程,才能正确解释百分比。附录还说明,同分布测试没有与训练、验证共享仓库;OOD 的 20 个 Python 任务中,有三个来自训练、验证出现过的仓库。
优化器能看训练轨迹,也能在训练任务上运行草稿、重放和扰动。验证集回传的是准确率、结果变化的任务标识、变化能否复现,以及有限的 harness 错误摘要;不会回传验证题目、测试内容和轨迹。测试集不参与两个优化循环。
这个设计比直接在同一基准上搜索再报分更可信,但不能把验证集称为完全未使用的最终留出集。任务标识加上结果变化,本身也携带信息。优化器可以利用这些信息调整下一轮候选,而验证集还要承担最后选轮次的任务。论文承认这属于自适应数据分析,并在附录里讨论反馈量与泛化误差之间的关系。
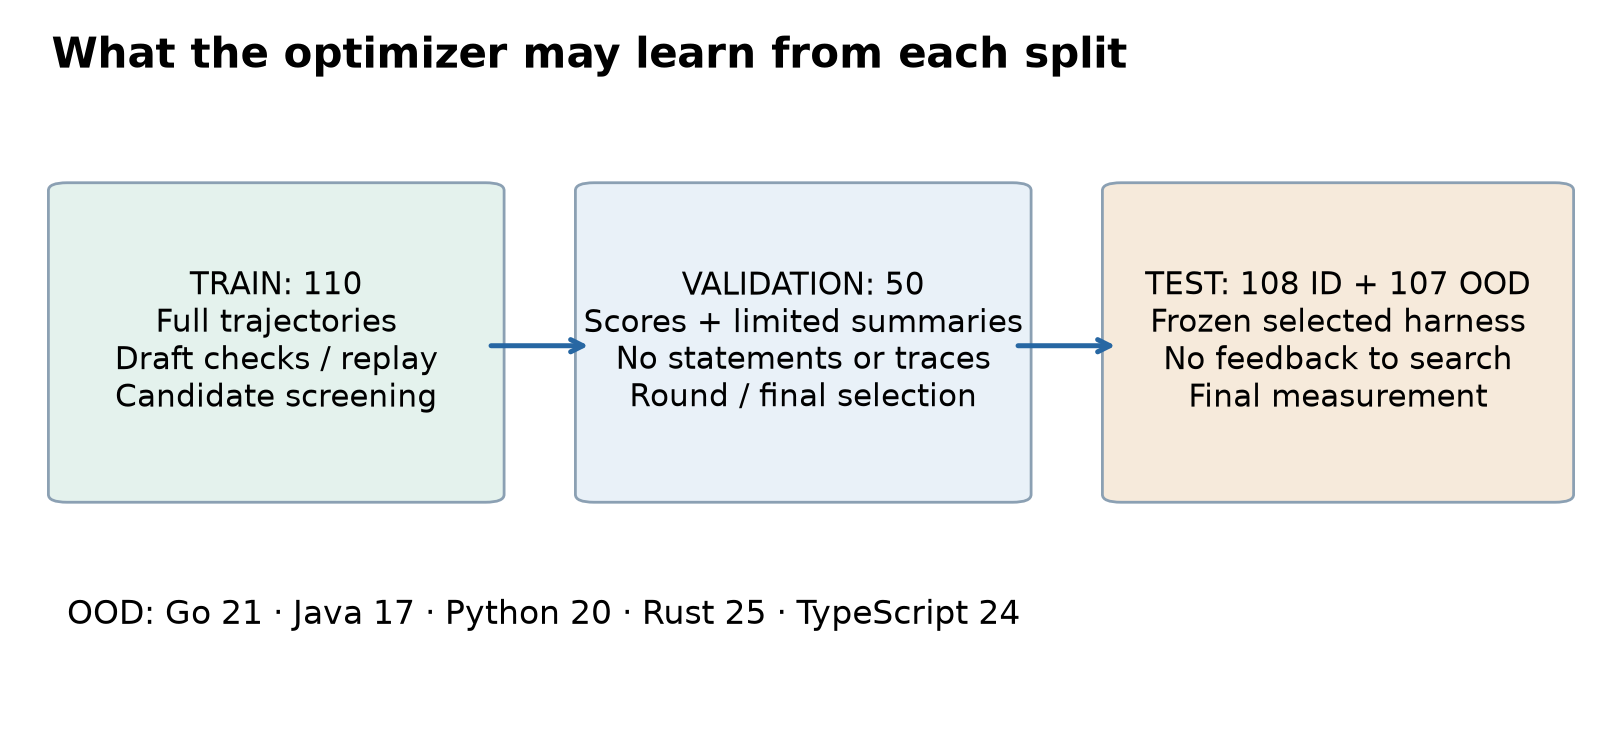
图 2. 根据正文第 2.2 节、附录 D 绘制。图中数字是任务数,不是重复运行次数;详细轨迹和可调用实验只来自训练集,最终测试前要冻结选中的 harness。
算法 1:把两个循环和筛选步骤连起来
下面是依据附录 B 改写的编号伪代码,突出证据和选择的先后关系,不是作者程序的逐行转录。
1  固定模型权重、评分器、任务划分与资源限制。
2  评估初始 h0 的验证表现,并保存初始候选。
3  每轮先固定优化器配置 g,再开始生成候选。
4    最多提出三个执行器 harness 候选。
5    候选按需从同一个预算池调用训练实验。
6    在共同训练子集(最多 12 个任务)上比较候选。
7    选择净修复数最佳者,平局时参考已确认通过数。
8    做基本运行检查,失败时最多修复三次。
9    对通过的最终版本做验证并存档。
10   根据本轮证据和受限验证反馈,更新优化器 g。
11  最后重新评估存档中最好的两个候选,再选一个。
12  冻结选中的 h,在封存测试任务上报告结果。
简化流程外还有几个不能忽略的细节。没有候选提交,或者修复后仍不能通过基本运行检查时,本轮保留上一版执行器并跳过验证,但优化器自我更新仍会进行。经过基本检查修复的候选,不会重新参加训练筛选,就进入验证。因此,先前比较过的版本和最终存档版本可能不同。论文的选择误差分析明确把这一点放进假设,而不是假装它没有影响。
主要实验做六轮,每轮三个候选,每个候选最多 60 个优化器轮次,自我更新最多 30 轮。实验预算按每个候选八个单位配置,实际合并为每轮共享的 24 个单位,候选和自我更新都从这里扣除。它不是三个彼此隔离的额度,不能让一个候选把其他候选预期可用的实验资源当成自己的。
验证一个目标任务消耗一个实验单位,首次成功后的确认包含在该单位对应的实验里;重放或扰动每次调用计一个单位。实验单位并不等于实际执行次数:确认会多跑一次,扰动也可能需要原始和修改后的两次重放。最后选出的也不一定是最后一轮:先从存档中取验证表现最好的两个,再复评并比较均值,平局偏向较晚的轮次。
这套协议提醒我们,搜索能力和选择能力要分别评价。一个过程可能找到过好候选,却被训练子集上的噪声筛掉;也可能最后一轮退步,但保留下来的早期候选很好。只报最后结果或只报最高结果,都会漏掉另一半问题。
4. 三种执行工具,分别回答三个问题
VERSE 并不是把基础优化器全部推倒重来。Meta-Harness 主要读原始轨迹,AHE 提供根因报告,Self-Harness 汇总弱点模式,HarnessX 按需提供轨迹摘要。论文在共同协议下重新实现这些证据接口,再加 VERSE。因此,比较对象是受控条件下的四种方法版本,不能直接等同于原始系统带着各自模型、预算和接受规则参加一场完整竞赛。
4.1 缩短轨迹,必须保留同一种失败
第一项补充是轨迹最小化:寻找更短的步骤子集,让重放仍能复现原来的结果。对于失败轨迹,要求不是“重放后随便报个错就行”,而是失败测试集合也要对应。附录有一个很好的例子:原轨迹 103 步,14 个测试失败;前两次候选分别保留 8 步和 12 步,却只复现了其中 5 个失败,因此都被拒绝。后来另一个 12 步子集才完整复现 14 个失败。
这个要求很关键。把一段程序删到无法启动,当然也能得到失败,但那不是原来需要解释的失败。最小化的目标是减少无关上下文,同时保留要分析的现象。它是一种帮助定位问题的实验变换,不是“短轨迹天然比长轨迹正确”的价值判断。
论文的独立重放研究里,失败轨迹的原始步数中位数为 129,保留下来的步数中位数为 8;每条轨迹压缩倍数的中位数为 14.4。这里不能拿 129 除以 8,再声称论文的 14.4 算错了:两个中位数的比值与逐条比值的中位数不是同一个统计量。成功轨迹的对应数字是 127、4 和 28.2 倍。
4.2 重放诊断、扰动诊断、验证修复
重放工具问的是:记录中的失败能否再次出现?扰动工具进一步移除或替换一个可疑步骤,看结果是否依赖这个步骤。验证工具则直接运行新草稿,检查它能否修复目标任务,返回失败测试和 harness 错误。一次最多检查三个目标任务;一个目标只有连续成功两次才被记为通过。
这三个问题不能互相替代。失败可以稳定重现,但模型对原因的解释仍然错;替换一步后结果变化,也可能同时改变了后续状态;草稿修复了一个失败任务,也可能破坏别的任务。真正有效的优化需要把这些证据联系起来,而不是把所有工具输出都压成一个“已验证”标签。
训练历史记录负责补上时间维度:哪些失败模式消失了,哪些回来了,哪些改动只是在不同任务之间转移问题。优化器每轮结束后据此修改自己的工作方法。固定验证工具本身不被它改写,但它可以写新的工具去组织和调用这些固定能力。
算法 2:一次草稿检查应该怎样解释
1  选定草稿,以及最多三个训练目标。
2  检查草稿能否应用、共享实验预算是否足够。
3  对允许执行的目标运行草稿 harness。
4    首次通过时,再执行一次确认。
5    记录确认通过、失败或无法判定。
6  区分原本失败的目标与原本成功的回归检查任务。
7  把结果、错误和成本交回优化器。
8  优化器在剩余限制内决定修改、再试或直接提交。
最后一步揭示了一个常被标题掩盖的事实:固定工具并不会因为检查失败就绝对禁止提交。优化器仍然可以提交,随后经过共同的筛选和验证过程。它后来自己写出的钩子可能增加提醒或局部拦截,但那是学到的工作规则,不是 VERSE 固定实验接口的定义。
一个原本成功的任务再次通过,只能说明这次没有在该任务上发现退步,不能算新修复一个任务。反过来,某个失败目标仍然失败,也不能推断整项机制毫无作用:它可能解决了接口问题,却留下另一处语义错误。好的记录应该保存“哪种猜测被检验、哪个分支实际执行、解决了什么、还剩什么”,而不只有通过或失败。
4.3 重放研究与实际工具还有一处区别
附录的独立重放研究允许 Agent 在保留动作执行完以后继续行动,直到结束;VERSE 在进化过程中使用的重放工具则只执行记录命令,不调用模型。前者测得的修复率,不能直接当作后者工具在每一次优化中都能达到的效果。
这不是无关紧要的实现细节,而是实验结论的适用范围。允许模型继续执行,意味着修复后的状态还会经过新的决策;只重放命令,更接近对记录动作的受控干预。两者可以共同支持局部诊断有价值,但它们不是相同的实验对象。
5. 逐步推导:为什么新证据比重复反思更关键
5.1 两种原因、两种修复
理论先考虑一个简化问题:真实原因 只有两种,分别对应正确修复 和 。已有证据在两种原因下的分布分别是 、,先验概率为 和 。当我们看到某个证据 时,最优决策会选择后验质量较大的一边;另一边的质量就是无法避免的错误。因此最小可能错误率为
注意这里说的是“利用全部现有信息,任何决策器能够做到的最好水平”。它不等于某个具体语言模型的实际错误率。模型可能没有读懂证据,也可能推理失误,但这些都在最优信息利用之外。
作者用 Bhattacharyya 系数描述两种证据分布的重叠:。两种分布完全相同时,系数为一;支持集完全分离时,系数为零。分布越难区分,单凭证据选择正确修复就越困难。
上界推导很短:对任意非负 ,有 ,代入两种先验加权质量并求和即可。下界则把 写成 ,再使用 Cauchy–Schwarz 不等式,得到
这个结果表达的不是“模型不够聪明”,而是“证据本身没有把原因区分开”。如果错误参数和超时都在日志里留下同样的表面现象,那么把同一份日志重新解释十遍,也不能凭空产生原本不存在的区分信息。
5.2 一次实验怎样改变这个界
第 次检查时,优化器根据历史 选择查询 ,环境返回 。优化器并不知道真实原因,所以查询策略不能直接依赖 ;但是环境在不同原因下可以对同一个查询产生不同反馈。
把新历史的联合概率展开,可以把新证据分布的重叠拆成两部分:旧历史还剩多少重叠,以及当前查询在两种原因下的反馈有多相似。用 上界后者,便有递推关系。再把优化器比最优决策器多出的错误记作 ,得到
这里其实有两个不同的改进方向。选择更能区分原因的实验,可以降低 ;更恰当地理解实验结果,可以降低 。自我进化可能同时影响这两件事:学会问更好的问题,也学会在问题得到否定回答时真正修改方案。
如果每次反馈在两种原因下分布都一样,重叠不会下降。重新排版、压缩或更仔细地分析日志,可能让一个不完美的优化器更容易读懂信息,因此降低实际的超额错误;但它不能降低“完整原始证据所允许的最小错误率”。因此,不能把这个定理误读成“总结和静态分析永远没用”。它限制的是信息上限,不是否定现实模型可以更好地利用已有信息。
5.3 为什么要连续通过两次
设草稿在正确原因下的通过概率为 ,在另一种原因下为 。一次二元检查的重叠系数是
如果第一次通过以后,再做一次独立确认,那么观察不再只有通过与失败,而有“首次失败”“先过后败”“连续两次通过”三种。把三个结果在两种原因下的概率分别相乘、开方、求和,可得
只要原检查确实有区分力,并且相关概率不退化,确认能进一步降低分布重叠。用一个纯粹用于解释的假设例子:令 、,则一次检查的重叠为 0.8,加入确认后为 0.72。错误修复碰巧通过的概率从 0.2 降为 0.04;与此同时,正确修复连续通过的概率也从 0.8 降为 0.64。
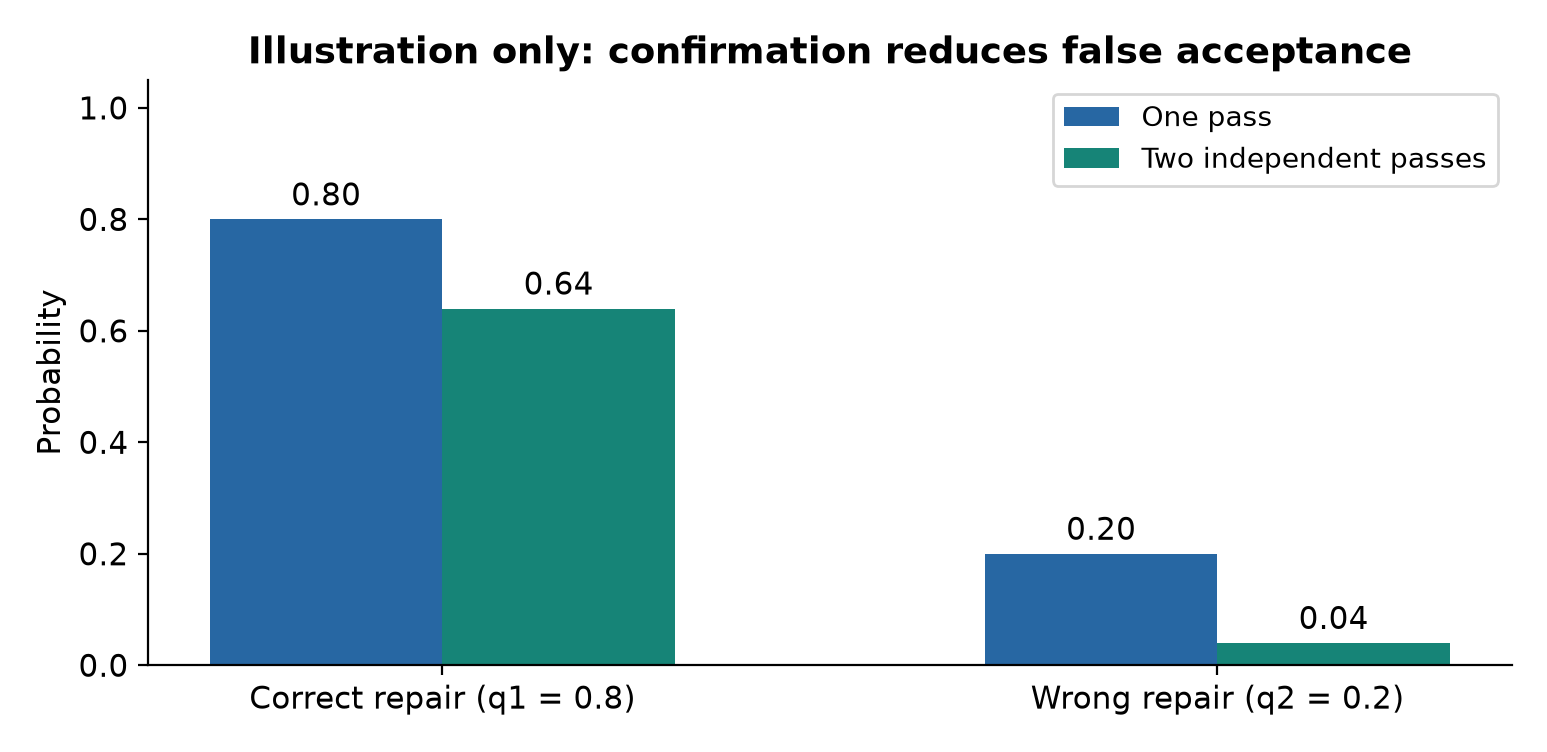
图 3. 依据附录 C.1 的独立重复假设计算,q1 = 0.8、q2 = 0.2 仅为教学算例。图中柱子不是 VERSE 的实测准确率。
这解释了为什么确认不是没有代价的“更可靠”。它会更谨慎地接受错误修复,也可能拒绝有用但表现不稳定的正确修复。如果环境损坏、缓存输出或评分器盲点使两次结果高度相关,那么平方概率的推导就不成立。两次相同的错误观察,未必比一次提供更多信息。
6. 从修好一处问题,到选出能泛化的最终版本
一个局部修复可以解决眼前任务,同时伤害其他任务。第二个定理因此把“好 harness”定义为总体损失不超过阈值 ,而不是“至少修好一个训练例子”。设第 个提案选择了一个值得修的问题,其正确修复能得到好 harness 的条件概率至少是 ;在确实选中这种目标后,提交错误修复的概率至多为 。
记 为前 个提案仍然没有找到好 harness 的事件。在 已发生的条件下,下一次成功至少需要“选中好目标”和“正确修复”同时发生,故有
它不要求所有提案独立,因为概率条件已经包括此前搜索没有成功这一历史。若找到好候选,候选中的最小损失至多为 ;若没找到,二元损失最多为一。最后再加上从候选中选错版本造成的期望差距 ,得到
这个分解把目标选择、修复可靠性、最终筛选分开了。假如把 提高 ,单次成功概率下界只增加 。当修复本身经常错时,优先级排得更聪明也很难充分兑现;反过来,修复非常可靠,但一直选择不具有泛化价值的问题,同样得不到好的最终系统。
这里最强的假设恰恰藏在 的定义中:它要求正确修复能改善总体损失,而不只是当前训练任务。现实中的回归、任务冲突、工具交互,都可能破坏这一点。定理提供了组织问题的语言,不能用来宣布每一个验证通过的补丁都会让搜索曲线单调向好。
6.1 两级筛选的误差怎样累加
每轮先在训练子集上选一个候选,最后再在验证集上选轮次。若所有训练估计距离相应总体损失至多 ,验证估计至多 ,两次比较经验最小值与真实最小值,会带来最多 的差距。每一步的两倍,来自“被选者的估计误差”和“真正最好者的估计误差”各一次。
但训练候选本来就是看过训练轨迹以后提出的,所以不能直接套一个独立抽样结论,自动宣布 很小。基本运行检查后的修复还会改变候选版本,让先前筛选分数对应不同程序。论文把这些都留在条件中,读者也应该保留这个条件性。
6.2 受限反馈依然会消耗验证集的信息
附录用可能的反馈序列集合 描述适应性。若验证集有 个任务,每个 harness 最多产生 个估计,优化共 轮,失败概率参数为 ,一个统一偏差界是
推导思路是先固定训练侧随机性,再枚举所有反馈可能触发的统计量,对每个固定统计量使用 Hoeffding 不等式,最后取并集界。反馈越丰富,搜索可能越有效,但能够依反馈选择的路径也越多,验证估计的乐观偏差成本随之增加。
这个式子并没有给当前实验发一张数值保证书。只有 50 个验证任务,而反馈包括任务标识和错误信息, 可能很大,界可能很松甚至没有实际约束力。它说明的是设计取舍:减少反馈会损失诊断能力,也会减轻验证集被反复利用的风险。
还有一项更细的偏差:协议只保留能够复现的验证结果变化,会让估计倾向维持父版本。附录把其均值偏移上界写为 ,其中 是任务失败概率。确认可以减少偶然翻转,但不意味着得到完全无偏的新运行准确率。“更稳”与“无偏”必须分开说。
7. 主结果:先看不同基础优化器,再看最高分
主实验优化器使用 Qwen3.8-Flash-Next,执行器使用 Qwen3.8-27B,权重均固定。表 2 的 avg@3 是同一个 harness 评估三次以后,任务解决准确率的平均值。它不是 pass@3,不是投票,也不是“三次中有一次成功”的概率。误差条是这三次测试评估的标准误,而每一行只有一次完整进化过程。
下面整理验证集选中轮次的结果。“仅工具”指不开放优化器自我进化的 VERSE,“完整”则包含自我进化。
| 基础优化器 | 同分布:基线 / 仅工具 / 完整(%) | OOD:基线 / 仅工具 / 完整(%) |
|---|---|---|
| Meta-Harness | 39.20 / 34.57 / 42.28 | 28.66 / 28.35 / 37.69 |
| AHE | 33.95 / 37.96 / 35.19 | 26.17 / 35.51 / 30.22 |
| Self-Harness | 29.63 / 40.12 / 34.88 | 29.28 / 31.78 / 30.22 |
| HarnessX | 32.72 / 38.89 / 35.80 | 27.41 / 27.10 / 37.69 |
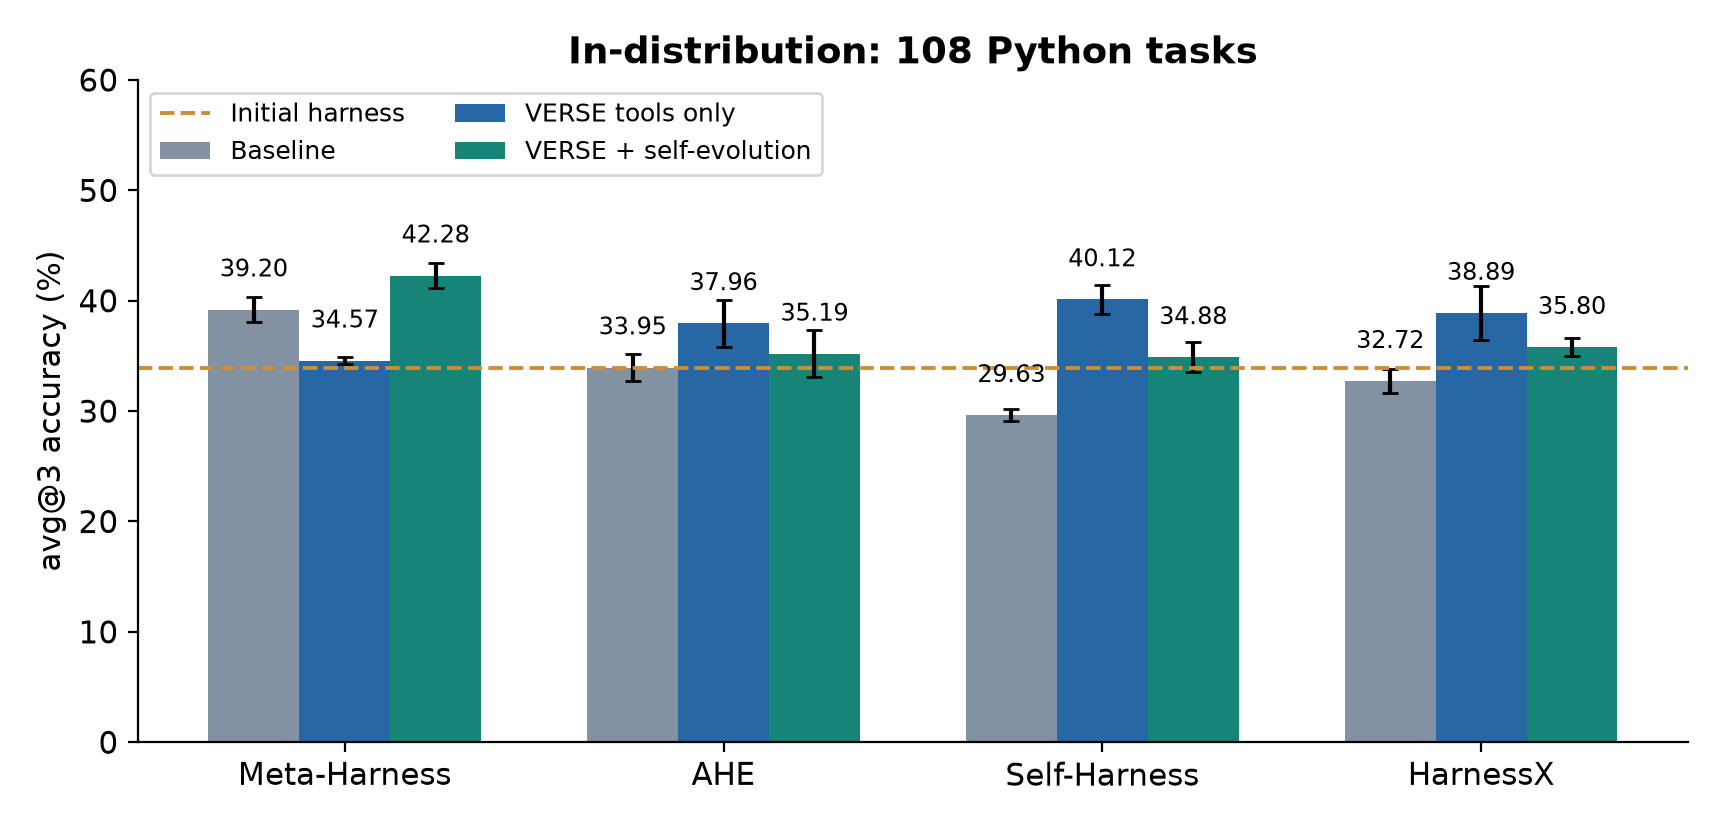
图 4. 根据论文表 2 重绘,108 个 Python 测试任务。误差条来自同一 harness 的三次测试评估,不代表三次独立进化的波动;初始 harness 为 33.95%。
完整 VERSE 在选中轮次上,确实同时超过四个基础优化器的同分布和 OOD 基线。把最后一轮也包括进来,共 16 项对应比较中,它的均值都高于未加组件的对应基线。这是论文可以支持的一个清楚结论。
但“超过原基线”不等于“自我进化本身在每个配置中都有增益”。只看选中轮次的八项比较,完整 VERSE 相比仅工具版本只提高了三项,另外五项下降。AHE 的仅工具结果为同分布 37.96%、OOD 35.51%,完整版本则为 35.19%、30.22%;Self-Harness 的同分布结果从仅工具的 40.12% 降到完整版本的 34.88%。
这些下降不是附带小事,而是理解方法的核心。基础优化器已经怎样处理证据、一次搜索碰到哪些问题、外层把什么经验写进长期材料,都会影响收益。完整系统在原基线之上更一致,与增加某个组件后单调改善,是两个不同命题。论文支持前者,不能直接推出后者。
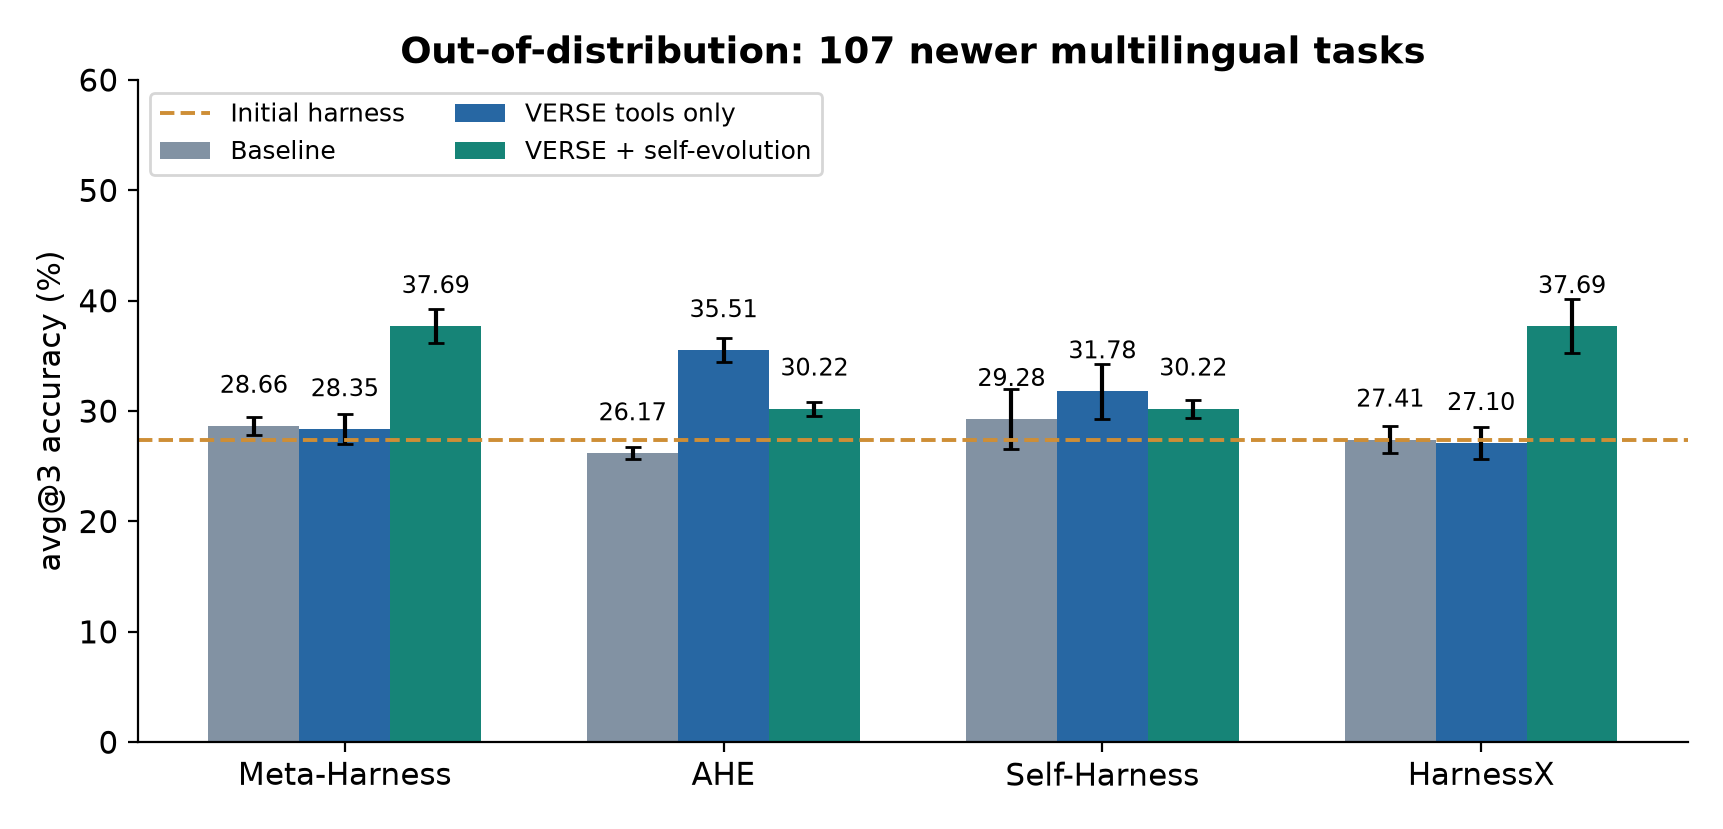
图 5. 根据表 2 的 107 个 OOD 任务结果重绘。使用与图 4 相同的验证集选中 harness;没有根据 OOD 成绩重新挑选轮次。初始 harness 为 27.41%。
还要区分“最强方法对最强基线”和“同一个 host 的前后变化”。OOD 最好的完整 VERSE 是 37.69%,最好的选中基线是 Self-Harness 的 29.28%,相差 8.41 个百分点。如果比较 Meta-Harness 自身,则是从 28.66% 到 37.69%,提高 9.03 个百分点。同分布的最高分比较是 42.28−39.20 = 3.08 个百分点。
摘要把它们四舍五入成 42.3/37.7 对 39.2/29.3,没有数值问题,但会隐藏参照对象的区别。实际采用某个 host 时,不能先看封存测试集上谁最高,再把这个选择说成没有使用测试信息。若 host 也是要调的超参数,就需要预先规定选择方法,或者另设开发数据。
论文也报告了最终轮次与选中轮次。主文同分布结果中,验证集选中的版本在 18 次运行里有 15 次不差于最后一轮,最多领先约 6.8 个百分点。这说明保存和选择历史版本有用,却不是说验证集永远能挑到总体最优。早期筛选已经丢掉的候选,最后选择阶段无法再救回来。
8. 日志告诉我们:优化器改变的是怎样做实验
8.1 大量草稿没有修好它声称要修的任务
论文统计的 170 次草稿验证里,17 次至少修好一个原本失败的目标;30 次只在原本已经成功、用于检查退步的任务上通过;112 次所有目标都没有通过;11 次无法确定。相同草稿重复检查会再次计数,所以不能把它解释成 170 个独立想法的成功率。
另一个统计是提交时预测的修复:286 个“预计会修好”的失败任务里,下一轮训练只有 28 个真的通过。还有第三个统计:557 个验证结果变化中,275 个重跑后不能复现。它们分别研究草稿实验、修复预测和结果翻转,分母不是同一种事件,不能合并成一句“系统有九成概率失败”。
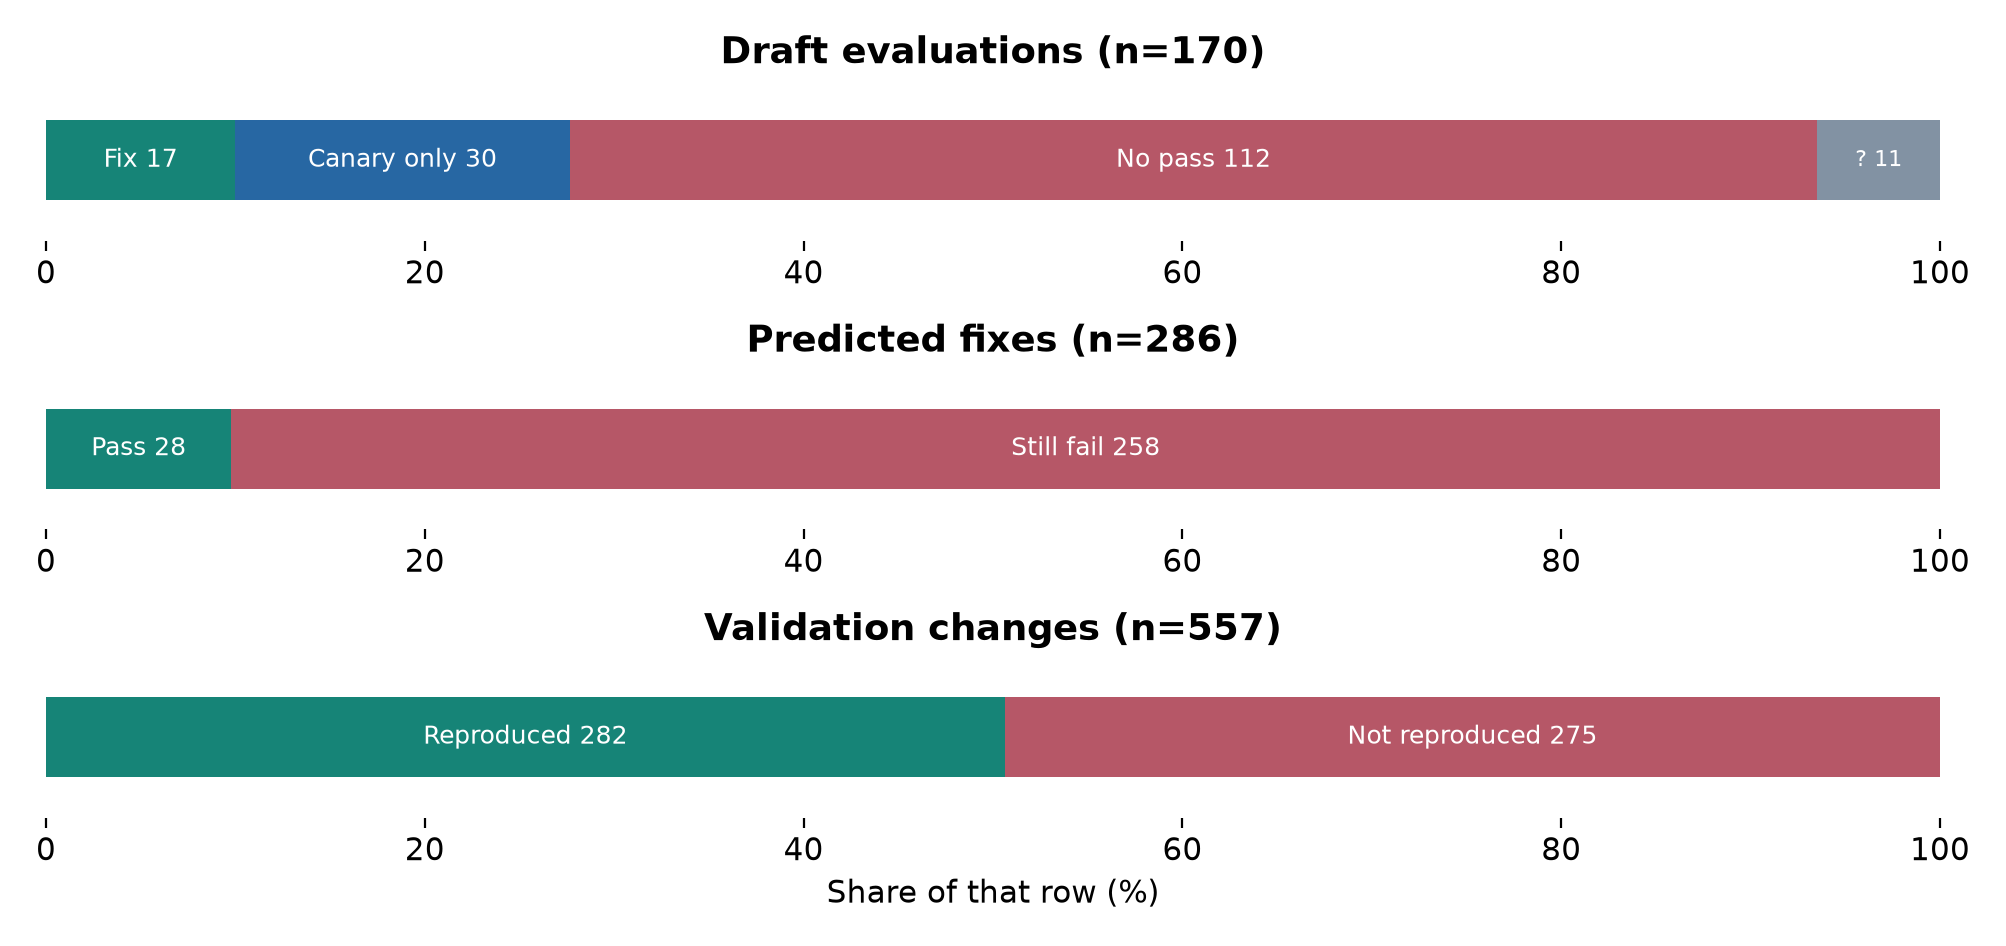
图 6. 依据论文图 5 和第 4.3–4.4 节重绘计数。第一行是草稿验证,第二行是预计修复的任务,第三行是验证集变化;各行分别归一化,不把它们混成总成功率。
这些数字最重要的意义,是说明“有说服力的解释”与“有效修改”之间距离很大。优化器在提交之前拿到否定反馈,至少有机会缩小改动、换假设或停止将猜测写成长期规则。如果直到一轮结束才知道错误,已经消耗了更多运行,也更难辨认是哪项修改造成后果。
8.2 自我进化没有显著提高每个草稿的即时命中率
自我进化组的 81 次草稿验证中,34 次包含已经通过的训练任务作为回归检查;固定优化器的 89 次里只有两次。这相当于约 42.0% 对 2.2%。当工具指出草稿没有修好任何目标时,自我进化组有 30/38 次在提交前修改,固定组为 42/74,约为 78.9% 对 56.8%。
然而,两组直接修好失败目标的频率接近:9/81 对 8/89。因此,最有证据的变化不是“每次生成的草稿突然聪明很多”,而是“更愿意测试会不会伤到旧能力,也更愿意在被否定以后继续修正”。这与理论里的实验信息量和超额决策错误相呼应,但日志本身还不能把每项行为变化精确分解成多少准确率贡献。
一个负面结果是否有价值,取决于优化器怎样使用它。如果把失败解释成“测试不重要”,它反而可能学到错误的逃避规则。如果把失败理解为“当前假设没有被支持”,再换一个更有区分力的实验,它才真正改善了搜索。工具可用与工具被合理使用,是两个处理条件。
8.3 一个具体例子:从回归学到更窄的规则
附录 L 展示了一个表现较好的 Meta-Harness 运行。第一轮主要处理环境问题,训练记录里的相关错误大幅减少,但验证集上也出现先前成功任务退步。优化器发现自己的检查只覆盖预计会被修好的任务,于是把“加入成功任务作为回归检查”写进提示词、技能和笔记。
到第二轮,三次验证调用全部包含成功任务;前一轮三次调用都没有。它还缩小了自动改写解释器的范围,避开那些已经明确使用自身环境管理方式的项目。这里形成了一个完整链条:具体退步暴露了实验盲点,实验盲点变成新的取样原则,新的证据又支持更窄的修改。
但同一个附录也指出,优化器笔记里存在错误:把初始训练准确率写成新 harness 的准确率,还描述了协议里不存在的第二次候选会话。附录 K 也记录过自写工具报错、读错轨迹,以及某些版本未通过检查而没有被加载。保存了一条“经验”,不代表它已经成为可靠知识。
算法 3:按回归风险阅读一个候选机制
下面是我从论文中提炼的操作框架,用于理解证据链,不是作者额外提出的算法。
1  写明要修的失败类别,以及预期改变的行为。
2  选择一个失败目标和一个先前成功的检查任务。
3  区分可复现失败与当前环境下无法判断的问题。
4  执行草稿,对有希望的结果做确认。
5  检查真正相关的条件分支是否被执行。
6  分别保存修复、退步、成本和未解决的不确定性。
7  只在证据支持的范围内保存新经验。
8  后续出现反例时重新审视这条经验。
最后两步决定了记忆会不会变成负担。早期有用的环境规避规则,在另一个组件改变以后可能开始误伤。若只保存“以后总是这么做”,却不保存成立条件、反例和检查对象,那么规则越积越多,组合后的系统反而越脆弱。
9. 消融、成本与迁移:不能只看加分的部分
9.1 单项消融不是组件价值排行榜
表 3 固定在 AHE 且不开放自我进化的条件下比较。完整工具组合得到 37.96% 的选中同分布准确率;去掉进化期间的草稿验证、保留最小化,得到 37.65%;去掉归因和最小化、同时失去训练历史,得到 35.80%;只去掉训练历史,得到 36.73%;原始 AHE 是 33.95%。
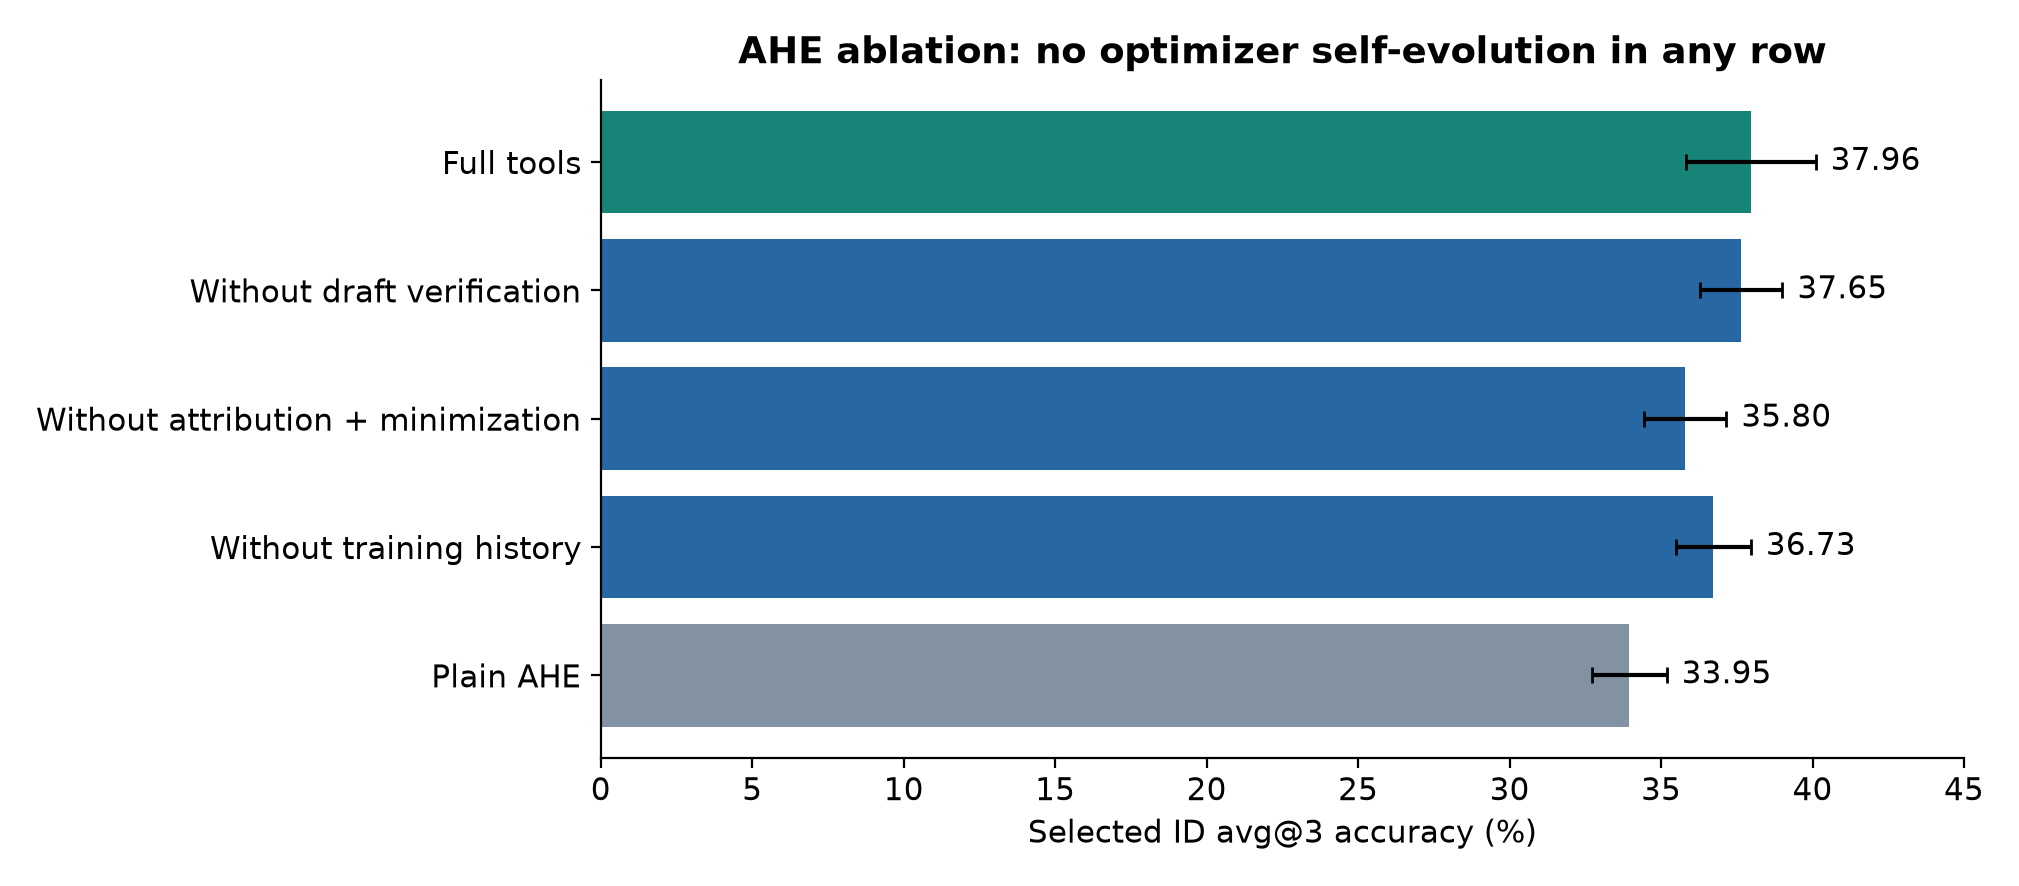
图 7. 根据论文表 3 重绘,所有行都不包含优化器自我进化。误差条仍是重复测试的标准误,不是独立进化运行之间的不确定性。
去掉草稿验证后几乎持平,不能证明验证工具没有用。在这一运行里,固定优化器最初九次调用都否定了草稿,第二轮以后就不再调用。但它同样限制了另一个说法:不能声称每个组件在每个 host 上都有清楚、独立的正贡献。可用但没被持续使用的工具,与被合理使用的工具,实验上并不是一个东西。
附录 H 换了一组模型,比较相同探测预算下的调度。由优化器自主选择实验时为 32.71%,随机安排为 30.86%,固定手写安排为 26.85%。另外,只允许自写提示词、只允许笔记和技能、只允许工具,都比完整可编辑空间的选中成绩低。这些结果提示,实验与当前假设是否匹配,以及不同工作材料如何配合,可能很重要。
不过每个消融条件只有一次进化,而附录的多次运行显示同一方法本来就可能相差数个百分点。所以应该把它们视作值得进一步重复验证的机制线索,不能给每个组件精确分配一个稳定的贡献值。较差的固定计划也不代表所有手工计划都会差,只能说明论文测试的那个计划没有同样有效。
9.2 验证只占少量执行,不代表总成本接近免费
论文把验证工具增加的 Agent 运行统计为总次数的 2–7%,但完整进化的墙钟时间达到对应基线的约 1.3–2.5 倍。以 Meta-Harness 为例,基线与完整 VERSE 的 Agent 运行次数分别是 1,326 和 1,453,执行器 token 为 5.50 亿和 6.34 亿,耗时为 21.6 和 38.0 小时。
由这些数值计算,次数增加约 9.6%,执行器 token 增加约 15.3%,耗时增加约 75.9%。它们衡量的是三种资源,不能互相替代。优化器 token 没有完整日志,因此表里只报告优化器调用轮数;不能仅凭这些数据算出完整美元成本或能耗。
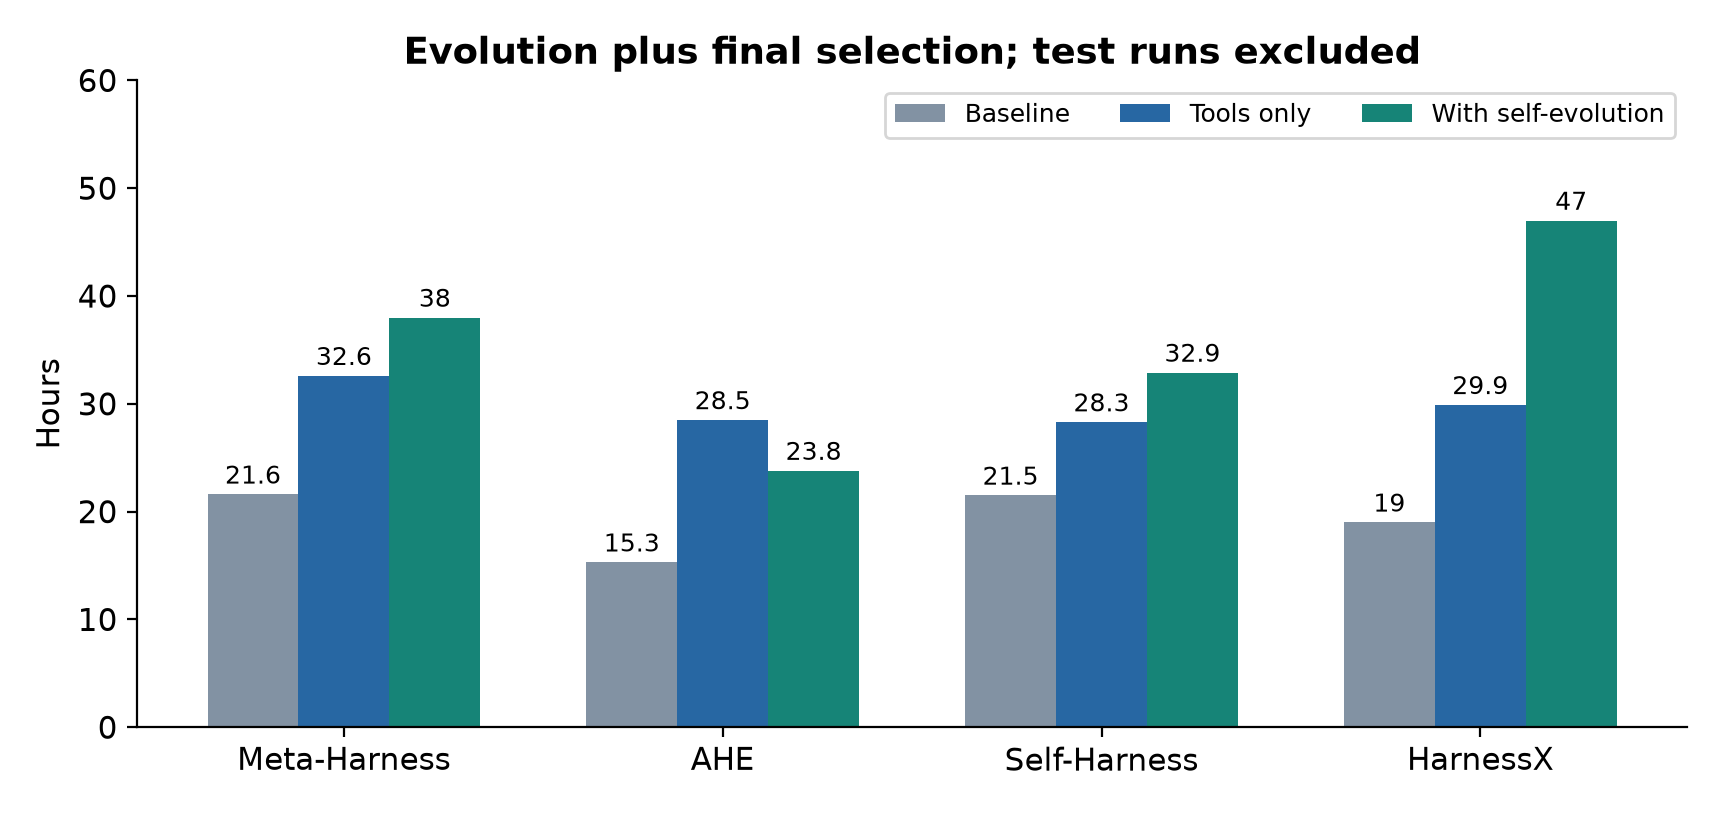
图 8. 根据表 4 的小时数重绘,包含进化与最终选择,不含测试评估。不同运行共享服务器时负载不同,所以这些是报告的运行成本,不是严格隔离的延迟微基准。
耗时差别不只来自等验证结果。演化后的执行器可能每个任务走得更久;基线候选失败时会跳过筛选和验证,而工具版本继续做了这些工作;共享服务负载也不一样。候选数和提案轮数相同,是有意义的控制,但不能被写成总算力完全相同。
从部署角度看,昂贵搜索也可能值得。如果最终冻结的 harness 会服务大量未来任务,一次性优化成本可以被摊薄。但论文没有提供足够的部署数据来计算盈亏平衡点。至少还需要每个任务的推理成本变化、未来使用规模,以及成功任务的价值或失败代价。这里不应凭空替作者补出“很快就回本”的结论。
9.3 换语言的泛化,不能等同于随便换模型也有效
OOD 同时改变了任务时间和语言构成。完整 VERSE 在 20 个 host 与语言组合中,有 16 个高于对应基线;对非 Python 任务也能保持明显提升。这支持它学到的规则不完全依赖训练中的 Python 任务。但每种语言只有 17–25 个任务,而且同时发生多种分布变化,不能据此精确区分“语言迁移”与“新时间任务迁移”的贡献。
附录 G 把迁移拆得更细:只搬运执行器 harness,与继承优化器工作方法后继续适应,是不同实验。面向仓库补丁的 harness 直接放到终端任务,可能明显低于目标领域初始配置;继承的优化器有时仍能在少数轮次内适应,尤其当执行器重新从初始版本开始时。
更换执行器模型后,结果并不一致。许多为某个模型优化的 harness 失去收益,两轮适应也不能保证恢复。下面从表 10 选出 DeepSeek V3.2 的几条曲线,展示这个边界,而不是把它当作所有迁移实验的平均成绩。
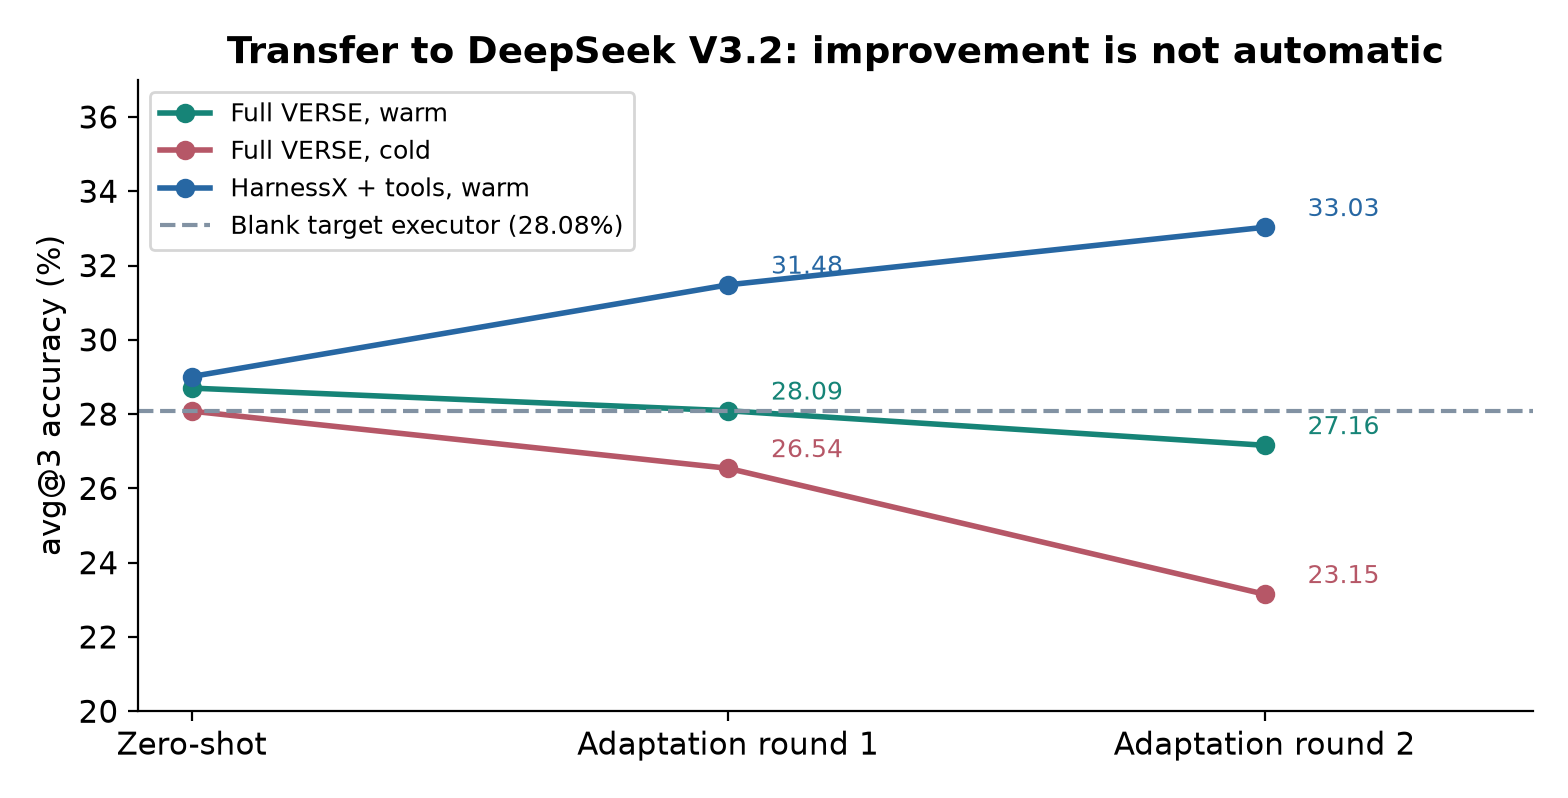
图 9. 来自表 10 的 SWE-rebench 部分结果。warm 同时继承原执行器与优化器 harness;cold 重置执行器 harness。虚线是目标模型的初始配置成绩,图示仅为明确标注的例子。
论文关于 shell 编辑的例子给出了一种解释:避免 heredoc 引号错误的编辑工具,可能解决多个模型共有的接口问题;针对某个模型习惯设计的行为提醒,则可能不适合另一个模型。能否迁移与机制处在哪个抽象层次有关。共享工具接口的修复,比一组高度依赖特定模型行为的指令更有希望复用。
因此,迁移结果最有用的读法不是“所有经验都能搬走”,而是区分哪些经验属于任务语义、哪些属于执行器习惯、哪些属于共同的环境接口。一个有来源和适用条件的经验库,比一个只按最终得分排序的提示词集合更容易做出这种区分。
10. 局限
完整进化过程的稳定性仍缺少充分测量。主表 1–3 每行只有一次进化,三次测试衡量的是已经生成的某个 harness 在评估时的波动。附录 F 对基线和 HarnessX 上的 VERSE 做了三次进化,但使用另一组匿名模型。它提供了有用补充,不能替代对主模型、所有配置的完整重复实验。对一个要自动改进系统的方法来说,“经常能变好”与“某一次能找到好版本”差别很大。
总计算成本没有严格匹配。额外探测、自我更新、更多被实际执行的筛选与验证,都可能影响结果。论文展示的是整套系统在相同提案控制下的表现,尚未完全排除“让固定优化器多花同样资源,也能达到相近效果”的解释。重复次数相同、候选槽位相同,不等于 token、时间和环境执行成本相同。
验证集小,而且承担双重用途。受限摘要比完整轨迹更节制,但仍会影响后续候选。理论明确指出反馈信息量的代价,却没有估计当前协议下能够收紧到什么程度。确认翻转还会改变估计对象,使它向父版本倾斜。因此,验证曲线看起来更稳,并不直接等于真实泛化曲线更稳。
理论中的原因与修复模型比较理想化。两个原因、两个正确修复便于分析;现实故障可能有多因交互,某一步扰动也可能通过新的状态改变整个后续路径。定理要求有些目标的正确修复能改善总体损失,这不能从几个训练任务通过自动推得。理论更适合解释搜索为何受限,而不是预测一次实际运行的分数。
泛化仍依赖任务、模型和接口条件。新语言结果较好,不保证换执行器、工具 API、上下文窗口或任务家族仍然有效。论文自身就给出不少负迁移。真正上线前需要在目标条件下重新评价,不能因为都叫“编程 Agent”就认为原来的验证结论自动成立。
优化器写下来的材料可能包含错误认识。工具文件存在、技能数量增加、笔记越来越长,都不是收益证明。附录里出错的工具和不准确的笔记恰好说明,自我修改也会把误解固化。固定评分边界能限制后果,但不会让内部叙事自动变成真实事实。
11. 批判性分析
11.1 最可信的贡献是实验方法,而不是递归层数
读完以后,我最认可的是“观察到具体退步以后,优化器改变了检查方法”这条证据链。它不是只展示最终分数更高,而是让我们看到为什么会加入成功任务、为什么要修改被否定的草稿、为什么把重复轨迹检索整理成可调用操作。这些变化能合理解释它为什么有机会做得更好。
理论将信息重叠与超额决策错误分开,也让这个故事更清楚:新实验负责带来原来没有的信息,优化器工作方式负责更恰当地使用信息。两者都可能改善,却没有任何一项因为叫“自我进化”就自动成功。
反而最不应保留的读法是:只要系统能修改自己,它就天然更强。主表已经反驳了这种简单解释。完整 VERSE 对原基线更一致,但它相对仅工具版本的收益并不一致。我会把它看成一个有说服力、仍需改进优化策略的组合设计,而不是所有 Agent 都应该直接开启自我改写的定律。
11.2 “Verified”需要按实验协议理解
在这篇论文里,它意味着可以运行草稿、重放失败、在指定任务上确认变化。它不意味着全局正确、没有回归,也不意味着任何因果叙述都已经证明。系统甚至允许优化器在检查不理想后继续提交。把这个词理解得准确,才能保留实际贡献,而不是用一个更强的承诺替代论文做过的事情。
和科学实验类比是有启发的,但必须保持局部性。实验只有在能区分竞争性解释时才真正提供信息。如果每次都找另一个容易通过的任务运行同一份草稿,就算验证调用数增长,也可能没有减少诊断歧义。更值得优化的是单位成本获得多少有效证据,而不是表面上用了多少次工具。
此外,某个任务上的通过并不一定验证了提出修改时的原始因果解释。修复可能通过意外路径生效。若要把它提炼为可复用经验,就需要记录实际被执行的条件和反例,而不是只因为最终成功便把所有叙述一起接受。这是从局部修复走向长期经验积累时很容易忽略的一步。
11.3 下一组实验应当分开三种解释
我最希望看到三组等成本对照。第一组给固定优化器同样的执行器与优化器总预算,让它做更多候选或确认。第二组把已经演化出的工作方法冻结,放到新的独立搜索运行中。第三组从同样的冻结工作方法出发,继续允许在线自我进化。
这三组可以帮助区分:收益来自多用计算,来自可复用的程序性经验,还是来自必须持续进行的在线适应。当前结果支持三者可能共同存在,却还不能精确拆分。这里是后续实验建议,论文没有报告这组完整实验。
另一个轴是验证反馈。可以比较只有分数、分数加可复现变化数量,以及当前带任务标识的摘要,在相同搜索预算下的表现。最终使用独立测试,才能判断更丰富反馈带来的搜索收益,是否抵消了更强的验证适应风险。仅仅因为不给题目原文,就把所有反馈都当成“没有泄漏”,是不够细致的。
最后,重复单位应该是整条搜索轨迹。需要统计从新工作区开始时超过初始 harness 的概率、最差退步幅度、成本分布,以及不同随机种子对最终选择的影响。一个用于自主改进的系统,尾部失败可能比最高的一次成绩更影响使用价值。
11.4 真正值得带走的工程原则
我会保留执行器状态与优化器状态的分离,固定任务评分规则,分别保存诊断、预测、实际观察和经验,并对并行候选明确共享预算。还会让经验的支持证据、反例和适用范围保持可追溯。这些原则并不只来自成功案例,更多来自论文承认的错误和退步。
我不会把基本运行检查当作行为改进证明,也不会把技能库变大当作泛化变好。可观察的目标始终是:冻结一个明确版本以后,它在新任务上是否持续改善。这个目标能让讨论保持清楚,即使优化器越来越擅长解释自己为什么应该有效。
12. 结论
VERSE 把 harness 优化向前推进了一层:不仅改做任务的配置,也改提出、检查和修订配置的方法。最有价值的部分,是把一次偶然成功或一段有说服力的诊断,转化成有区分力的实验,以及包含回归信息的长期记录。
论文报告了有意义的留出任务收益,也认真展示了失败检查、预测不准、额外成本和跨模型迁移不足。这些限制并没有削弱阅读价值,反而让我们更清楚地看到自主改进系统还需要什么。允许 Agent 修改自己,只是扩大了搜索空间;能否形成可靠改进,仍然取决于证据、实验和选择是否足够严谨。
参考资料与图表来源
- Zekai Wang 等,VERSE: Verified Self-Evolving Optimizer for Agent Harnesses,v1,2026 年 10 月 2 日。本文方法、理论与实验数字依据正文第 2–4 节、附录 B–L。
- 图 1–2 是解释性重绘,图 3 是明确标注的假设计算;图 4–5 对应原文表 2,图 6 对应原文图 5 的计数,图 7 对应表 3,图 8 对应表 4,图 9 选取表 10 的指定结果。重绘保留各自的指标、统计对象和误差约定。
- 作者仓库入口仅作为后续阅读资源。本文讨论论文的证据与适用范围,不声称独立重跑了作者的 Agent 实验。