笔记日期:2026-10-24 · 笔记作者:Zhongzhu Zhou
论文:Harness^2: Recursive Agent Harnessing for an Open World。论文作者:Ruiyao Xu、Yanfei Chen、Zhongying CuiZhu、Bhavana Dalvi Mishra、Yifei Ming、Han Yu、Rujun Han、Chen-Yu Lee、Tomas Pfister。版本与日期:arXiv:2610.14224v1,2026-10-09 提交。资料:论文与元数据、全文 PDF、作者项目页、官方资源入口。本文覆盖正文与全部附录;实验数字来自作者报告,文中的推算、解释性例子和后续实验建议另作说明。
1. 模型没有变,究竟是什么在进步?
一个 agent 做不好任务,不一定是模型不会。它可能反复打开无关文件,把关键证据淹没在工具输出里,用错表格的统计粒度,也可能把所有时间花在解释“准备怎么做”,最后没有交付文件。这些问题有一部分发生在模型知识之外:指令怎样进入上下文,工具怎样被调用,工作什么时候交给另一个上下文,哪些经验会被保留,都会改变结果。
本文把这套围绕模型的运行安排称为 harness。它不是某一句系统提示词的别名,而是提示、约束、记忆、技能、脚本和运行时逻辑共同构成的工作方式。Harness² 的出发点是:模型权重保持不变,也可以通过修改这套工作方式提高任务表现。
真正困难的问题在后面。如果面对的是一个新任务,没有参考答案,也没有一个随时可调用的可靠判分器,系统怎样判断修改值得保留?即使这一次修改有效,下一次怎样利用这段经验,又不把上一个任务的特殊条件误当成普遍规律?论文把这两件事拆成两层递归。
第一层发生在当前任务内部。系统提出若干 harness 修改,实际执行,观察行为变化,再选择性组合。第二层发生在任务结束以后。系统回看修改过程,把可复用组件和有证据支持的经验放进库里,用来指导以后怎样修改。
这里最值得先记住的一点是:下一个任务仍然从同一套基础执行 harness 开始。它不会直接继承上一个任务定制后的整个工作环境。继续积累的是供改进器使用的经验库,而不是把前一个任务的工作方式原封不动传下去。
这个重置动作有实际意义。为某份法律文书增加的规则,到了另一份文书未必成立;某个仓库里的路径和命名习惯,也不应该成为其他项目的默认假设。但重置并不能消除所有风险。经验库里仍可能存进错误归纳,新任务的编辑器也可能把一段看起来适用的经验用错地方。
因此,我更愿意把论文理解为“有执行证据的工作流程搜索,加上跨任务经验积累”。它没有证明系统获得了正确性裁判,也没有展示无限递归增长。模型权重冻结;同一任务内,改进器本身保持固定;跨任务的持久变化主要通过它的库来实现。先把这些边界讲清楚,后面的实验才不会被“自我进化”四个字带偏。
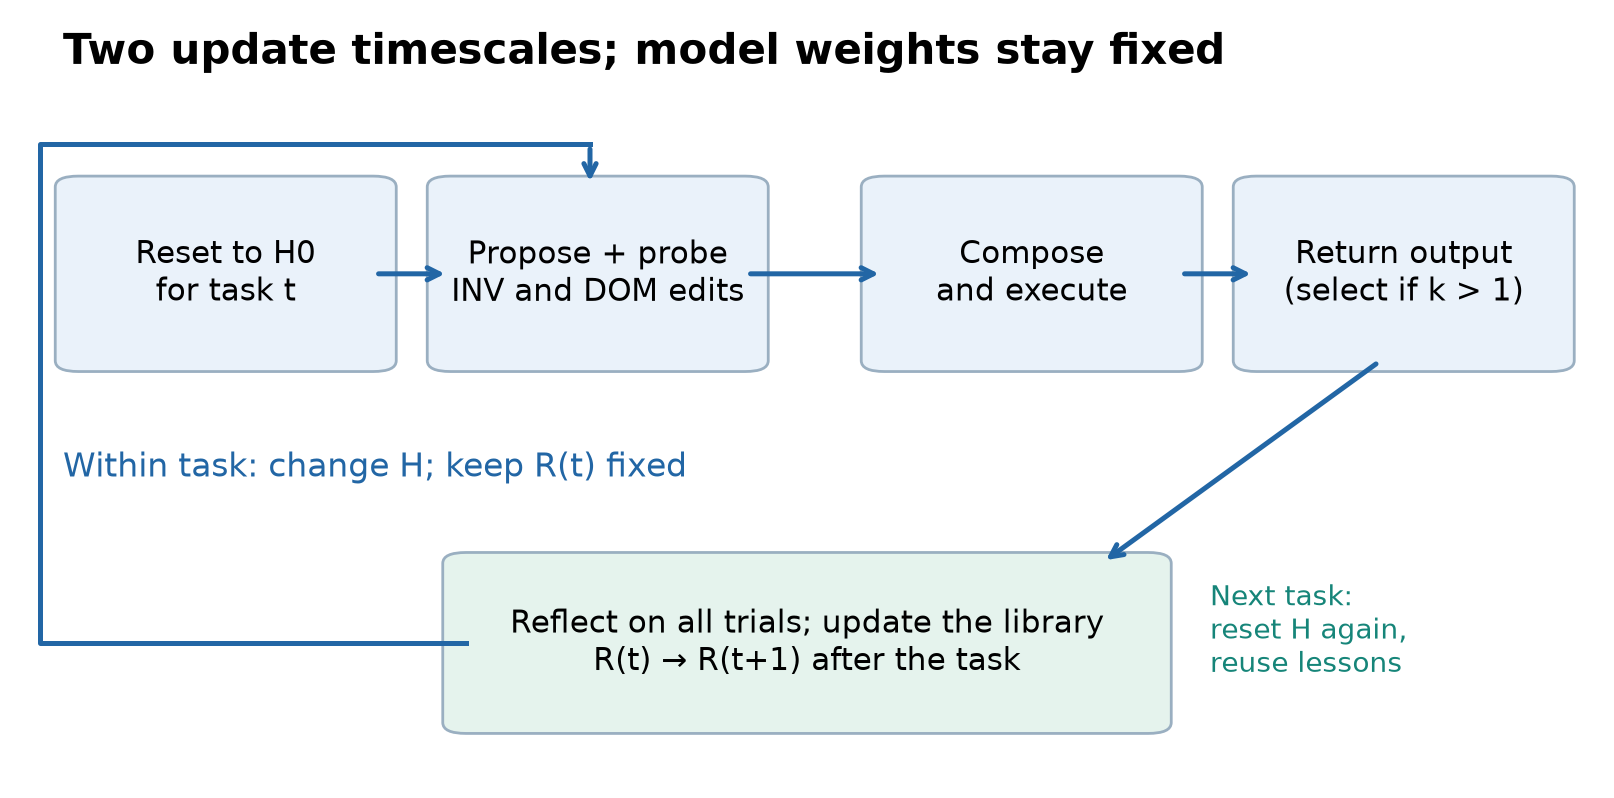
图 1. 根据论文第 2.1–2.3 节绘制。返回箭头表示经验对未来任务可用,不表示当前任务执行到一半就更新改进器。
2. 前置知识:执行轨迹、运行组件与证据
2.1 一次执行是一条轨迹和一个交付物
设冻结的模型为 ,任务为 ,执行 harness 为 。一次 agent 执行可以写为:
是轨迹,包括读了什么、调用了哪些工具、得到了什么结果、在哪一步作出决定; 是最终交付物。符号 强调它是一次采样。即使任务、模型和 harness 都不变,两次运行也可能走不同的路径,产生不同质量的结果。
这意味着“这次成功了”不能直接推出“这个 harness 总是更好”。一个候选可能恰好走到了正确分支,也可能只是碰巧没有触发原来的问题。反过来,一次失败也未必能否定一个本来有用的修改。阅读这种论文时,需要把一次运行的表现与一个配置的稳定性质分开。
Harness² 同时使用轨迹和交付物,原因正在这里。只看最终答案,最多能判断哪个更像好答案;看轨迹,还能寻找一个具体机制:新增技能是否真的被加载,脚本是否避免了重复手算,新的约束是否让 agent 补读了遗漏材料。这些观察比一句偏好更适合指导修改,但仍不能自动证明因果关系。
2.2 八类组件不是八种文件名那么简单
论文开放了八类可编辑组件。系统提示、guardrails、记忆和工具说明会在每次模型调用时进入上下文;skills 在被触发时加载;scripts 通过 shell 执行确定性操作;subagents 把有边界的工作交给独立上下文;plugin 则进入工具调用环节,可以在模型没有主动遵循文字建议时仍然起作用。
关键差别是“什么时候生效”和“代价在哪里”。把一个长流程写进常驻提示,每轮都会占用上下文;放进按需技能,可以少占常驻预算,但如果没有正确触发,它就等于不存在。脚本能稳定完成机械计算,但公式写错后也会稳定地产生错误。运行时 hook 比“请注意”更难被忽视,不过错误的触发条件也可能持续干扰正常任务。
附录对组件依赖有明确要求:技能必须有触发入口,引用的辅助脚本必须随同提供,格式不合法的 harness 会收到反馈并获得一次修复机会;再次失败则继承原来的 harness。这些规则保障的是提议可以被装载、可以运行。它们不负责证明提议里的业务假设正确。
例如,一段脚本能够成功打开表格,读出两列并算出平均数,只能说明它完成了这些操作。如果用户要求的是按销售额加权的比率,而脚本算的是逐行比率的简单平均,程序完全没有报错,结果仍然可能错。组件验证和任务验证是两层事情。
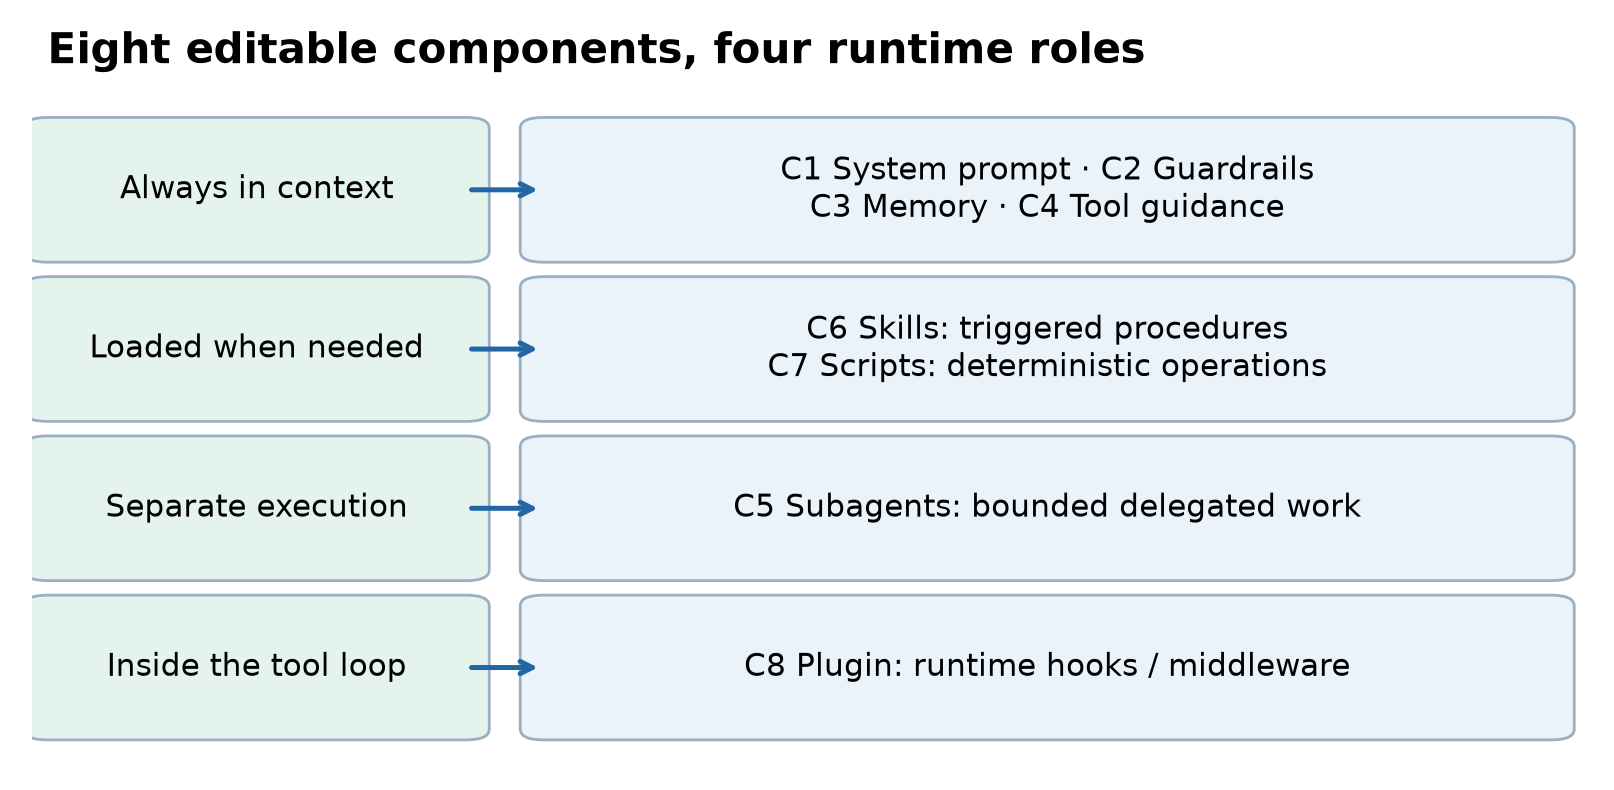
图 2. 根据原文图 2 与附录 D.3 绘制。图中强调常驻、按需、独立执行和工具环节四种作用方式。
2.3 行为变了,不等于答案被验证了
假设基础 agent 用每一行的佣金率做算术平均,修改后的 agent 改成“总佣金除以总销售额”。如果任务要求整体销售口径的佣金率,这是一个合理修复;如果任务要比较每位销售人员的平均比率,同一个修改就可能改变了问题。
所以,观察到某个动作发生,只是证据的一部分。还要知道任务到底要求什么,输入材料支持什么,哪些约束是用户明确提出的,哪些只是编辑器自行补上的。一次工具调用成功、一份文件格式完整、两个模型判断一致,都可能与答案错误同时发生。
论文所说的“没有 ground-truth verifier”,指改进流程不能使用隐藏的标准答案、评分规则和分数,并不是实验完全没有评测器。编辑器可以看用户请求和原始资料;研究者在流程之外再用基准评测结果。这种信息边界是方法的重要组成部分。
为了分析失败,后文会用 表示一个隐藏的质量函数。它只是本文解释问题时使用的记号,不是 Harness² 在运行时能调用的目标。系统依赖可见证据采取行动,论文再用不可见于系统的评测信息观察结果。两种视角必须分开。
3. 一次改进:先提出修改,再用执行结果组合
论文把一次对照改进写成:
是当前任务已经积累的执行和修改历史, 是此时固定的改进 harness,其中包括经验库。输出不仅有新的 ,还有它实际运行得到的 ,以及记录整个过程的 。也就是说,组合出来的新配置还要再执行一次,不是写好一个看似合理的方案就直接宣布改进完成。
3.1 两个编辑方向,分别寻找不同缺陷
invariant 编辑器关注跨领域反复出现的工作方式问题,例如计划、工具使用、上下文管理、预算和委派。domain 编辑器关注当前领域的知识、专业步骤和交付约束。二者读取相同的任务证据,但被要求从不同角度诊断。
这个划分的直觉很朴素。如果两个没有分工的编辑器都给出“更仔细地检查”这样的建议,第二个编辑器并没有带来多少新信息。有分工时,一个可能指出工具输出太大、关键信息被淹没;另一个可能指出对账必须在交易粒度上进行。前者适合改工具处理或脚本,后者适合写入领域技能,两种修改才有互补机会。
分工本身也有边界。领域知识会影响读取顺序,流程规则也可能暗含专业判断。它们不是严格独立的因素,更不是把两份建议相加就能得到更好系统。论文后面的 Compose 步骤需要处理冲突,这正说明职责划分只是帮助搜索的偏置。
3.2 Probe 的重点是定位行为变化
每个候选都在同一个任务上运行,模型和环境配置匹配,每次 rollout 使用独立的新容器。这样可以避免某个候选已经修改过工作目录,后一个候选却从它留下的状态出发。基础执行提供的是行为参照,不是正确答案。
有价值的比较不是“这次输出更长了”,而是修改想解决的问题是否真的在轨迹中发生变化。技能有没有被打开?新脚本有没有读取正确来源?约束有没有促使 agent 检查漏掉的文件?修改有没有造成额外重试、上下文膨胀,或者让任务最终没有产物?这些问题比一个笼统的好坏判断更具体。
不过,环境匹配并不能去掉随机性,更不能消除共享偏见。两个编辑器可能从同一个错误假设出发;一个候选只探测一次,也可能恰好表现不错。因此附录的反思规则保留了“混杂”这一归因类别:如果同时修改了多个组件,或者证据只有一次运行,不应该轻易说某一条编辑独立导致了提升。
3.3 Compose 不是投票,也不是把建议全部拼起来
组合器读取基础轨迹、候选 harness、差异和探测结果。它可以保留有证据的部分、修改冲突、选择某一个候选,也可以不改。保留现状不是失败,而是在证据不足时避免引入新风险的一种合法决策。
两个单独有用的修改,合在一起未必仍然有用。它们可能争抢上下文,使用不兼容的触发条件,或者对同一个字段给出相反要求。因此组合后的 harness 需要自己的执行记录。这一轮额外执行同时解释了方法为什么更有信息,也解释了它为什么更贵。
算法 1:基本的对照改进步骤
以下编号伪代码概括原文第 2.2.1 节,没有引入隐藏判分器。
输入:任务 q,当前 harness H,历史 E,固定改进器 R
1. 执行 H,得到基础轨迹和交付物 e0。
2. 根据 q、H、e0、E、R 提议 invariant 候选 HI。
3. 根据同一批证据提议 domain 候选 HD。
4. 验证候选结构;修复一次仍失败则继承 H。
5. 在独立的新环境中执行 HI 和 HD。
6. 比较基础执行、修改内容、探测和已有历史。
7. 组合 Hnew:合并、修订、选一个,或者保留 H。
8. 执行 Hnew,记录 enew 与各项决定的依据。
9. 返回 Hnew、enew 和完整步骤记录。
这套算法没有“选择得分最高者”这一行,因为流程看不到真实分数。判断仍然由 agent 完成。方法的价值在于给判断提供更具体的执行证据,而不是把判断替换成了一个已经被证明正确的优化器。
4. 递归有两种含义:增加宽度,或者增加深度
论文用同一个预算参数 描述两种不同的组织方式。并行递归中, 对应搜索宽度:先得到 次基础执行,再分别提出 个 invariant 和 个 domain 候选,完成探测后,由 个相互独立的组合会话产生后继 harness。每个组合器都能看到完整候选池。
这里并没有反复迭代 代种群。论文实际执行的是一次种群更新,增大 意味着这一代里有更多基础样本、候选和组合结果。把它理解成“同一个 harness 连续自我改进五次”,就会误读并行 。
记基础执行池为 ,带有探测结果的候选池为 ,并行组合写成:
顺序递归则让前一步修改后的 harness 成为下一步的起点:
最后一行只是表示追加历史记录,不是说实现中应当丢掉记录顺序。初始历史中已有 次基础执行,之后每一步继续加入本轮修改和执行证据。下一轮因此既能看最初的问题,也能看最新 checkpoint 的实际行为。
顺序方式的优势是有机会修复上一轮修改制造的问题,也能发现“先解决 A,B 的修改才有意义”这样的依赖。弱点是早期假设可能沿着整条链保留下来,而且后一步需要等前一步结束。并行方式更适合探索多个方向,但若所有编辑器共享同一个误解,更多候选也不一定覆盖真正不同的解释。
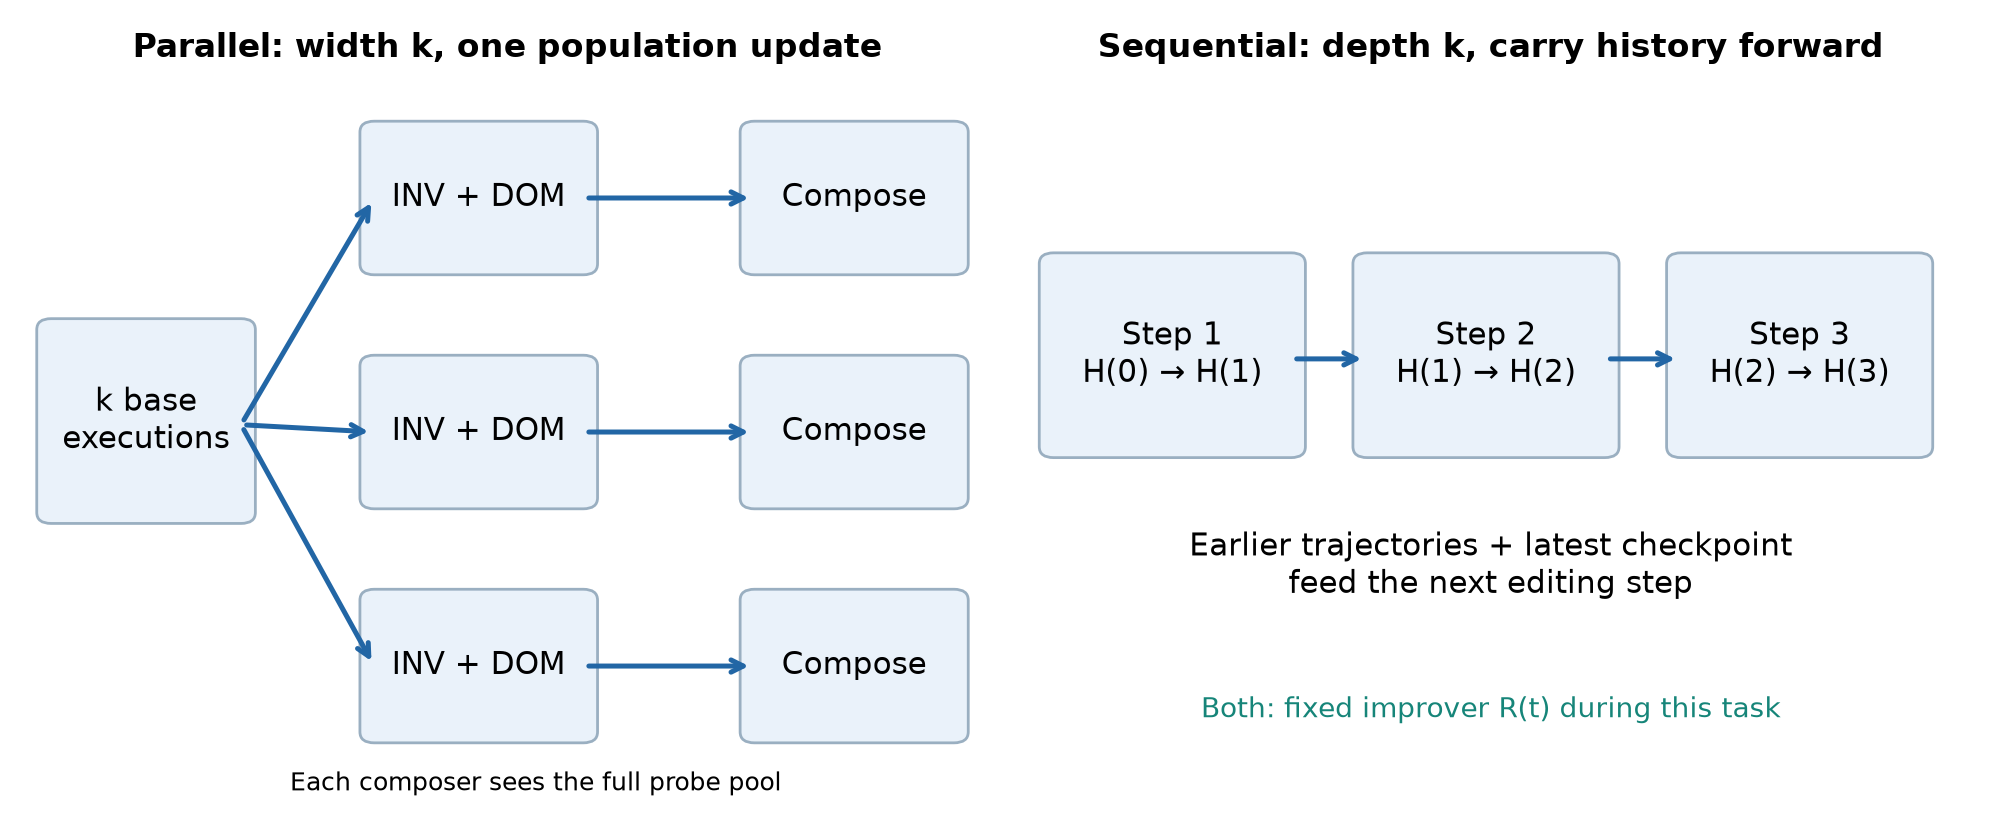
图 3. 根据第 2.2.2 节绘制。并行组合器共享探测证据,它们不是互相独立的正确性裁判。
算法 2:如何使用任务内预算
下面把 harness 搜索和最后的交付物选择拆开,以免把二者误认为同一件事。
输入:任务 q,基础 H0,固定改进器 R,预算 k
1. 在新环境中收集 k 次基础执行。
2. 若采用并行方式:
   a. 从 H0 提议并探测 k 个 INV、k 个 DOM 候选。
   b. 让 k 个组合器各自读取完整候选池。
   c. 执行它们产生的 k 个后继 harness。
3. 若采用顺序方式:
   a. 令 H = H0,历史初始化为基础执行。
   b. 重复 k 次对照改进。
   c. 将后继 H 和本轮记录传到下一步。
4. 若 k = 1,直接返回基本步骤的后继执行结果。
5. 否则,对可供选择的已有交付物匿名化。
6. 根据任务请求和来源材料选择一个。
7. 返回该交付物及其对应 harness。时,最终选择器只能看到匿名化的交付物,看不到它们由哪个 harness 产生。它必须从已有输出里选一个,不会再综合生成一个新答案。这样可以削弱“改得越复杂越应该被选中”的偏好,但不能避免选择器偏爱看起来更整洁、更完整的错误答案。
附录还明确允许选择未修改的 harness 所产生的输出。这一点很重要:如果系统预设“既然做了优化,就应该选优化后的”,它就失去了拒绝无效修改的能力。匿名化能减轻来源偏好,真正的判断质量仍然取决于选择器理解任务和检查材料的能力。
4.1 先把执行次数算清楚
并行流程的执行次数可以直接推导。基础执行 次,两类候选共 次,组合后的后继执行 次,所以理想完整调度中有:
因此 不是“只运行一次 agent”,而是四次 executor rollout; 则是二十次。这个数还没有算编辑器、组合器、选择器、反思器和结构修复的调用。它是根据论文流程得出的计数,不是作者实测的运行时间,也不是我做了一次复现实验。
二十次运行也不意味着费用一定严格是四次的五倍。不同 harness 会走不同长度的轨迹,某些失败会很早结束,另一些会反复调用工具。要讨论费用,应当把执行与改进都纳入,而不能只看最后一次成功交付用了多少步。
一个更完整的记账式子是:
反思发生在交付以后,究竟算本任务费用,还是算经验库建设费用,需要明确口径。论文的计算量—性能图统计交付之前花费的 token,包含执行与改进。这已经比表格里的 executor 步数全面,但部署时仍应把持续维护经验库的开销单独记清楚。
并行的直接价值是减少等待链条:如果资源足够,多条探测能同时进行。但它减少的是潜在墙钟时间,不是把 token 消耗变没了。顺序递归则用更多等待换取逐步修正的机会。论文在 Code 和 Office 的预算曲线上观察到并行 更强,但 Code 在 时顺序方式更高,不能推出某一种方式在任何预算上都占优。
5. 经验库究竟保存什么?
当前任务结束后,反思器看的是完整修改记录,不只是最后被选中的答案。这是一个容易忽略但非常合理的设计:最终选择比较的是交付物,某个被采用的 harness 可能夹带了毫无作用的修改;某个被淘汰的候选,也可能包含唯一真正修复了某种行为的组件。
因此,归因应该回到“具体编辑使哪一段轨迹发生了什么变化”,不能简单写成“赢家里面的东西都有效”。附录要求对每个改动分别标记帮助、伤害、未观察到影响或混杂,并把观察连接到具体执行位置。证据不足时可以不生成新的持久经验。
库里既有采用后的完整 harness,也有适用条件、操作经验和支持它的行为对照。后来的编辑器可以复用实际组件,也可以依据经验重新组织修改。如果某个技能依赖辅助脚本,复用时必须把依赖一起带走,而不是只复制一段说明文字。
用紧凑的记号表示跨任务更新:
是完整改进记录,星号表示被采用,不表示已经验证的最优解。这个式子是对第 2.3 节的整理,不是新增算法。它清楚地显示:执行 harness 在下一个任务重置,而指导编辑的材料继续增加。
算法 3:保守地保留跨任务经验
下面保留了附录中“观察”和“归因”的区别。
输入:采用的 harness Hstar,完整改进记录 D
1. 将每个候选的编辑与其对应基础配置比较。
2. 为每处编辑定位观察到行为变化的轨迹位置。
3. 标记:帮助、伤害、无影响,或证据混杂。
4. 将可复用步骤与本任务专有事实分开。
5. 对照足够支持时,最多写一条持久经验。
6. 证据不足则保留过程记录,不新增经验条目。
7. 将采用的组件与有支持的经验纳入库。
8. 下个任务从 H0 开始,重新核对复用的任务事实。
可以把这理解成两种不同的记忆。记住“对账前先核对交易标识符是否一一对应”可能有用;把上一个客户的交易编号当成今后任务的通用知识则危险。论文想保留的是前一种,但实际文本经验是否做到这一点,还要靠编辑与检索质量。
这也引出一个实验识别问题。库同时保存可执行组件和文字经验,性能提升究竟来自“拿到了一个好模板”,还是来自“学会了更好的诊断方式”?当前的去库消融把二者一起去掉,证明整个包有价值,却不能单独回答每一种机制贡献多少。后面的批判性分析会回到这个问题。
6. 先读实验口径,再读提升数字
主实验把两个执行模型 Gemini 3.5 Flash、GLM-5 与两套初始 harness OpenCode、Codex 交叉组合。主设置中的编辑和改进角色使用 Claude Opus 4.8。论文另外测试了编辑器与执行器使用同一模型的情形,用来判断收益是否完全依赖更强的编辑模型。
WorkBuddy-Bench 包含 Code、Web、Office 三类任务,完整集合分别有 80、70、50 个任务,按类别分半后,测试部分分别为 40、35、25 个。表格里的 Avg. 是三个领域分数的宏平均,即每个领域权重相同,不是把全部 100 个测试任务直接平均。
JobBench 共 65 个任务,采用固定的 31/34 训练测试划分。LAB 的原始集合有 1,251 个法律任务,实验从中分层抽取 100 个测试任务,另有 24 个开发任务供离线 Meta-Harness 基线使用。LAB 的 Partial 是评分条目的通过比例,不是“整件法律任务完全正确”的比例。
这个差别会影响直觉。一个交付物可能满足大多数小条目,却遗漏一项关键要求;另一个在主要逻辑上正确,但因为格式不符合多条规则而丢分。Partial 能细致观察变化,但不能直接替代整任务成功率,更不能直接解释成实际业务中的风险减少。
离线 Meta-Harness 可以使用训练部分。其他方法从空库开始,在测试任务流中积累经验。因此这里测试的是连续适应:第十个任务可能受益于前九个任务。它不是“每个测试样本都从完全相同且没有历史的系统出发”的独立评测。
作者报告三次独立运行,并打乱任务顺序。标准差因此同时受到运行随机性与顺序差异影响,不能自动当作覆盖所有真实世界任务的置信区间。若要判断经验库是否对某类任务顺序特别敏感,需要更细的序列分析。
WorkBuddy 的评估混合确定性检查与模型、视觉判断;JobBench 采用加权评分规则;LAB 采用条目级专业判断。这些评测信息不进入编辑流程。这个隔离值得肯定,不过任何分数都仍然依赖评测器如何读取交付物。文件里存在的信息,如果抽取路径读不到,也可能被算作缺失。
7. 主结果:增益明显,但不要把平均值读成全胜
表 1 中,四个基础配置的 WorkBuddy 宏平均分别为 72.4、74.5、64.2、64.4。一次 Harness² 改进后,分别变成 77.5、77.5、75.7、75.3。再加上表中报告的并行递归增量,可得 的 80.8、80.4、79.6、78.3。
图 4 重画这些均值。因为表中 是通过增量给出的,图里没有自行推算它的标准差,也没有画一组来源不明的误差条。均值能直接相加,标准差却不能在不知道协方差的情况下随意相加。
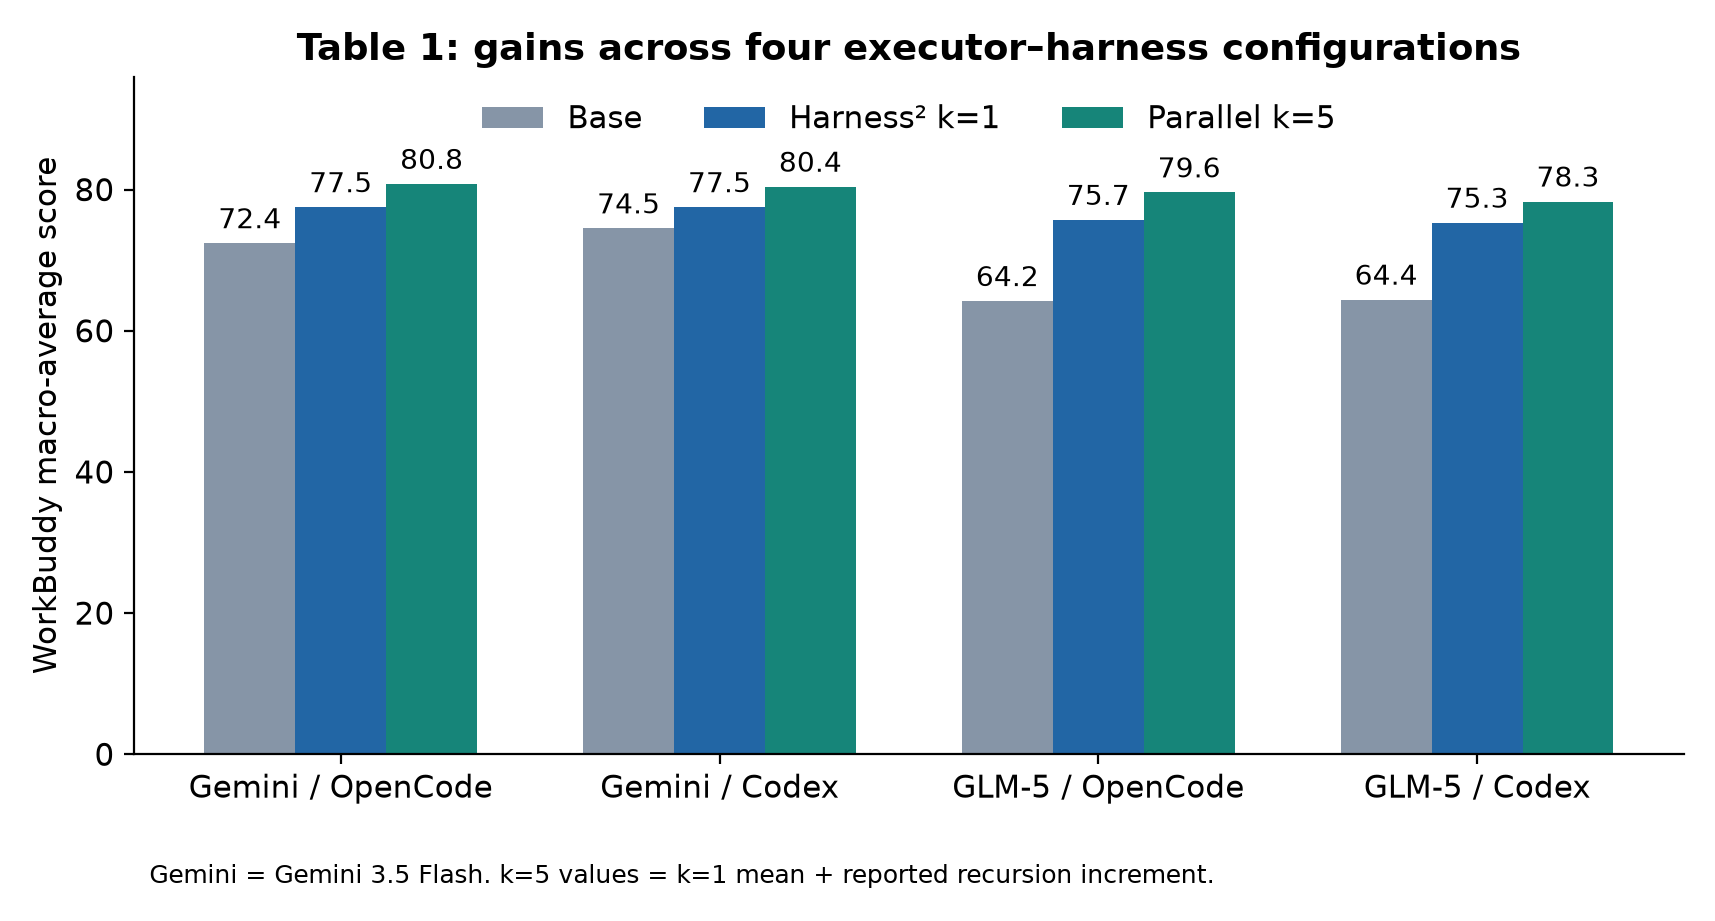
图 4. 根据表 1 重绘;k=5 数值由 k=1 均值加上论文给出的递归增量得到,不是新实验。
WorkBuddy 最大的一步增益来自 GLM-5/OpenCode: 分。JobBench 最大的一步增益来自 Gemini/OpenCode: 分。LAB 最大的一步增益来自 GLM-5/OpenCode: 个百分点。这三个最大值不是同一个设置上的三项平均收益,不能拼成一个统一的“提升幅度”。
用 Gemini/OpenCode 的领域分数可以实际算一遍宏平均与任务加权平均的区别。三个分数为 76.5、76.4、79.5:
第二个数是本文用已四舍五入的领域均值做的推算,不是论文新增结果。它说明为什么报告 Avg. 时必须说清权重。宏平均让小一点的 Office 领域与 Code 同等重要;按任务数加权则让任务更多的领域影响更大。两者回答的问题不同。
总体趋势支持方法有效,但细看表格并非处处最好。Gemini/Codex 的 LAB 一步设置中,Meta-Harness 高于 Harness²;GLM-5/Codex 的 Code 单项上,Meta-Harness 也高于一步 Harness²,虽然三领域平均仍由后者领先。用“所有单项都赢”概括这张表会过头。
递归也不总是缩小初始 harness 之间的差距。在 WorkBuddy 上,GLM-5 的 OpenCode 与 Codex 差距从 的 0.2 变成 的 1.3。两个系统都进步,差距仍可能扩大。更准确的结论是不同基础配置都能受益,而不是基础配置已经变得无关紧要。
8. 消融告诉我们哪些设计有用,也留下哪些疑问
表 3 分别去掉经验库、编辑方向划分和组合步骤。完整 系统在 WorkBuddy、JobBench 上是 77.5、36.0;去掉库后是 74.4、34.2;去掉方向划分后是 74.6、32.3;去掉组合后是 75.9、34.1。三项干预都造成下降,但影响大小在两个基准上不同。
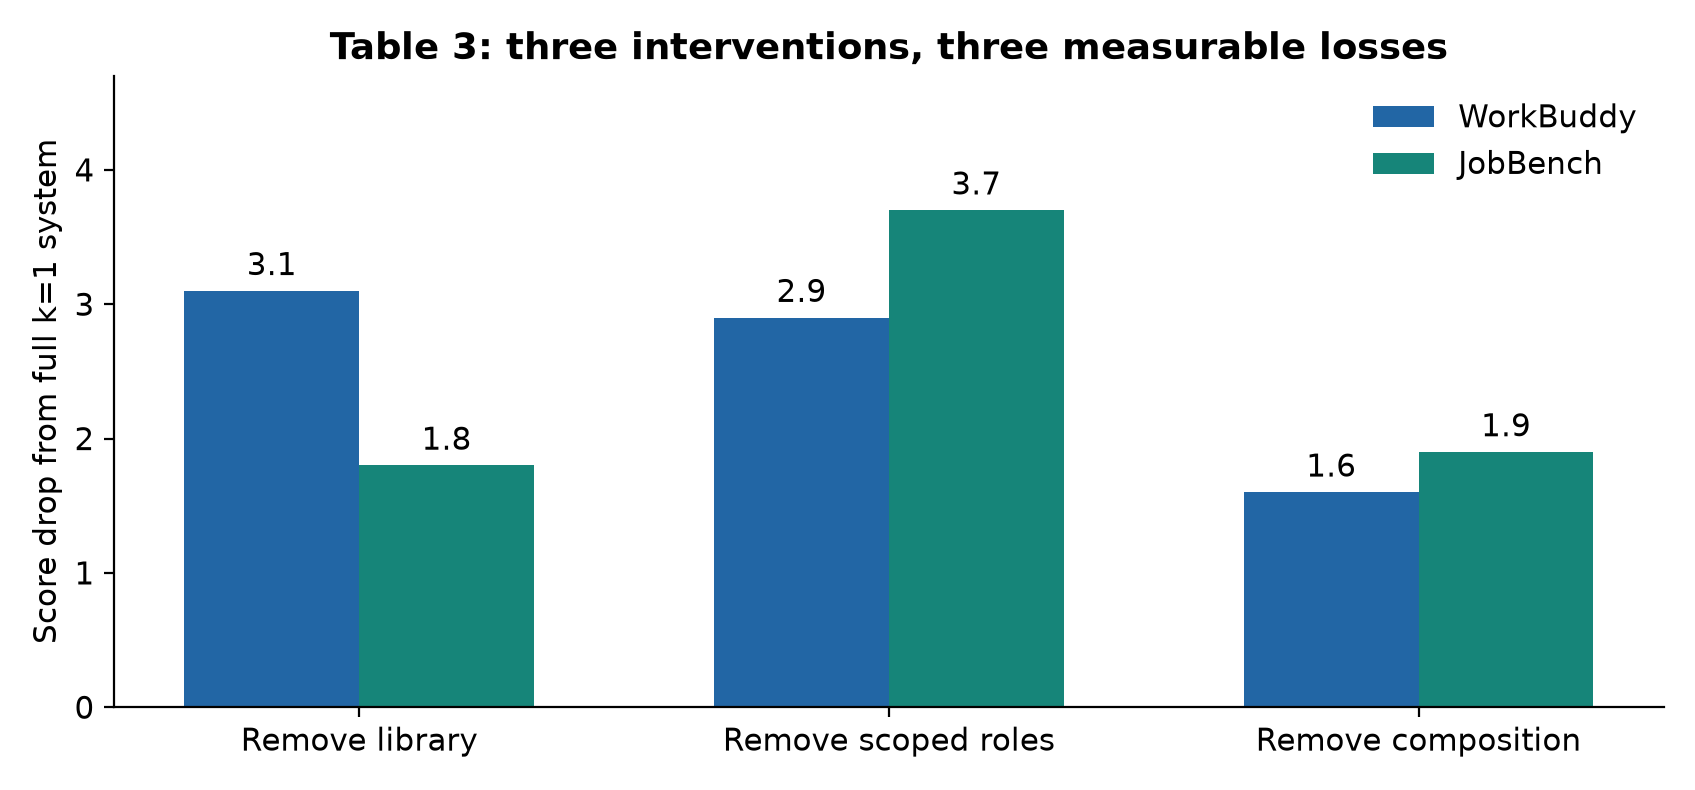
图 5. 用表 3 中完整系统减去各消融设置得到。每一组是单独干预,不能把三个损失相加当作总贡献。
去掉方向划分的实验尤其有意思。作者不是简单把两个编辑器变成一个,而是用两个通用编辑器替代 invariant/domain 分工,候选数保持不变。这削弱了“只是多问一次,所以变好了”的解释,支持不同搜索职责带来额外价值。
不过,它没有证明这两个方向是最优分工,也没有证明编辑器完全遵守职责边界。换一种任务分布,也许按检索、计划、验证来划分更合适。当前证据能支持的是,在所测设置中,带有这种职责偏置的双候选比两个通用候选更有效。
去掉 Compose 的版本仍然有两份候选和探测,但从中选一个,不再组合新 harness。性能下降说明“从执行证据里产生新的工作配置”有价值,不能把整个方法等同于答案投票。与此同时,这个干预改变了操作序列,不能不加说明地把它称为严格等 token 的实验。
库的作用还有第二种测试。除了在完整流程中去掉库,图 7 还尝试不做新的基础执行和候选探测,直接修改 harness。Code 领域在没有库时从基础 73.4 跌到 63.2;使用 建成的库时回到 73.8,使用 的库时达到 74.3。Web、Office 也能从更丰富的库中获益。
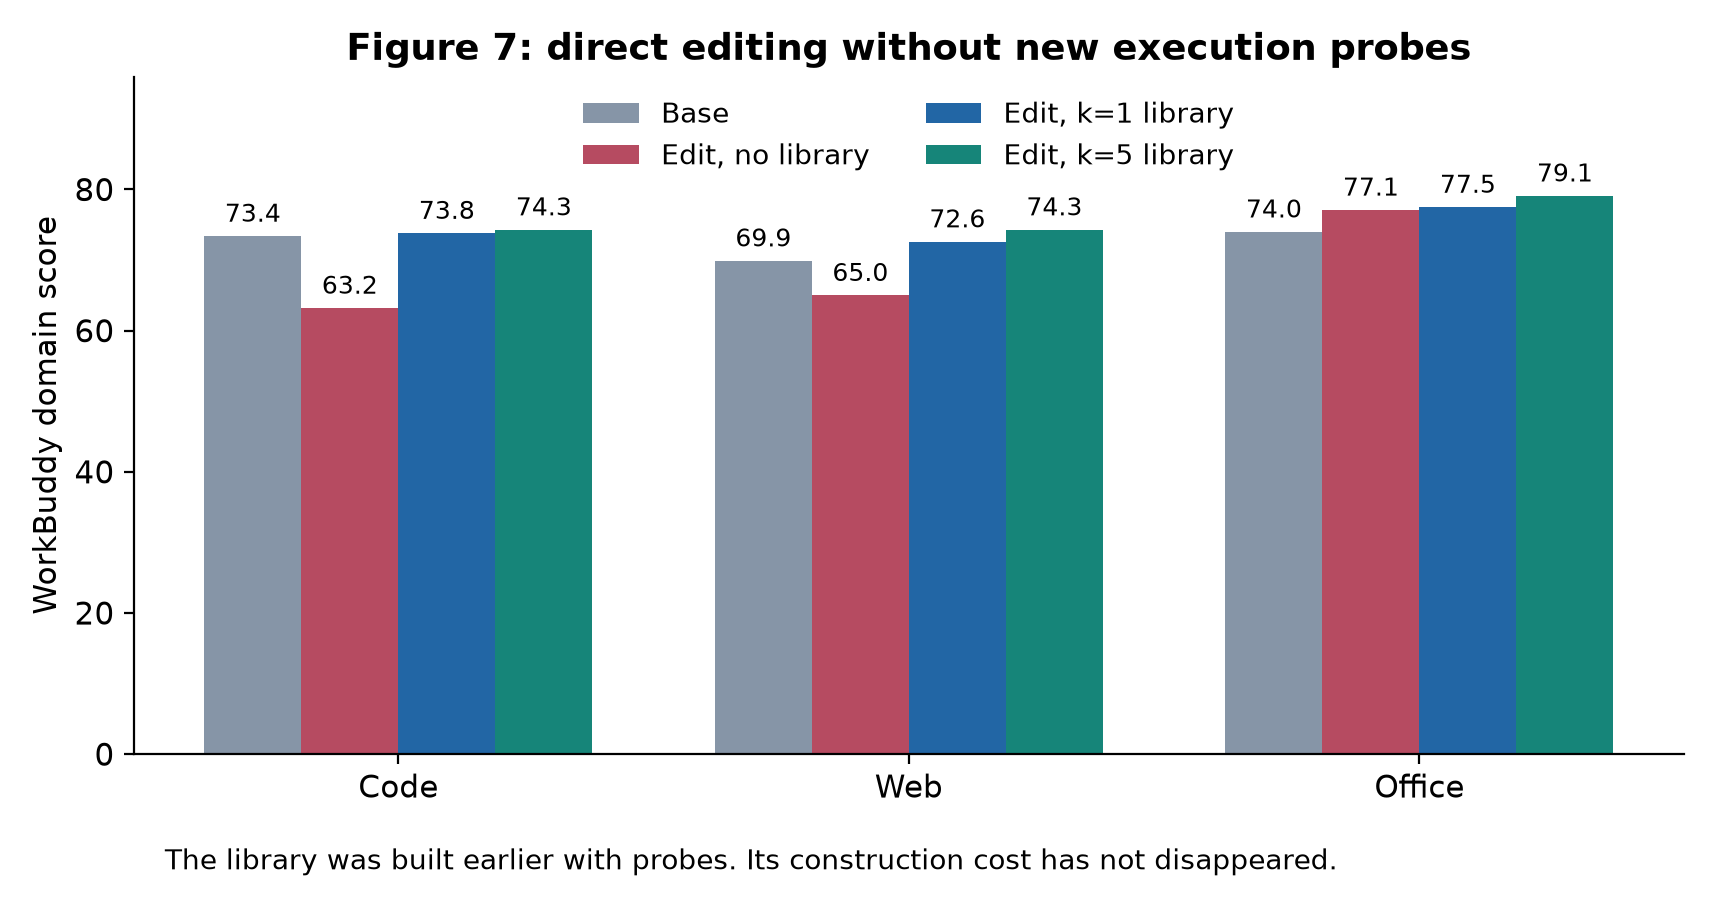
图 6. 根据原文图 7 重绘。“不做新探测”指应用阶段;此前建设经验库已经使用执行证据,相关成本并未消失。
这组结果提醒我们,编辑不是天然有益的行为。模型即使能写出一套看起来更规范的指令,也可能破坏原来尚且可用的流程。经验库让这种盲目编辑更有依据,但并不等于恢复了当前任务的全部信息:Code 上直接编辑的结果仍然低于完整探测系统。
从预算角度看,这是一个可理解的交换。已有经验减少了针对当前任务重新探索的需要,但也会失去识别新问题的机会。适合不适合,要看新任务与库里经验的相似程度,以及错误的代价。如果只看到“无探测也提升”,却忽略建库时的成本,就会错误地把过去支付的计算量当成免费知识。
附录 E.1 又换了一个问题:先获得优化后的 harness,再直接拿掉某类组件,且不重新优化。完整平均分 80.8;去掉技能变成 75.5;去掉脚本变成 77.1;去掉提示相关组件组变成 79.3。
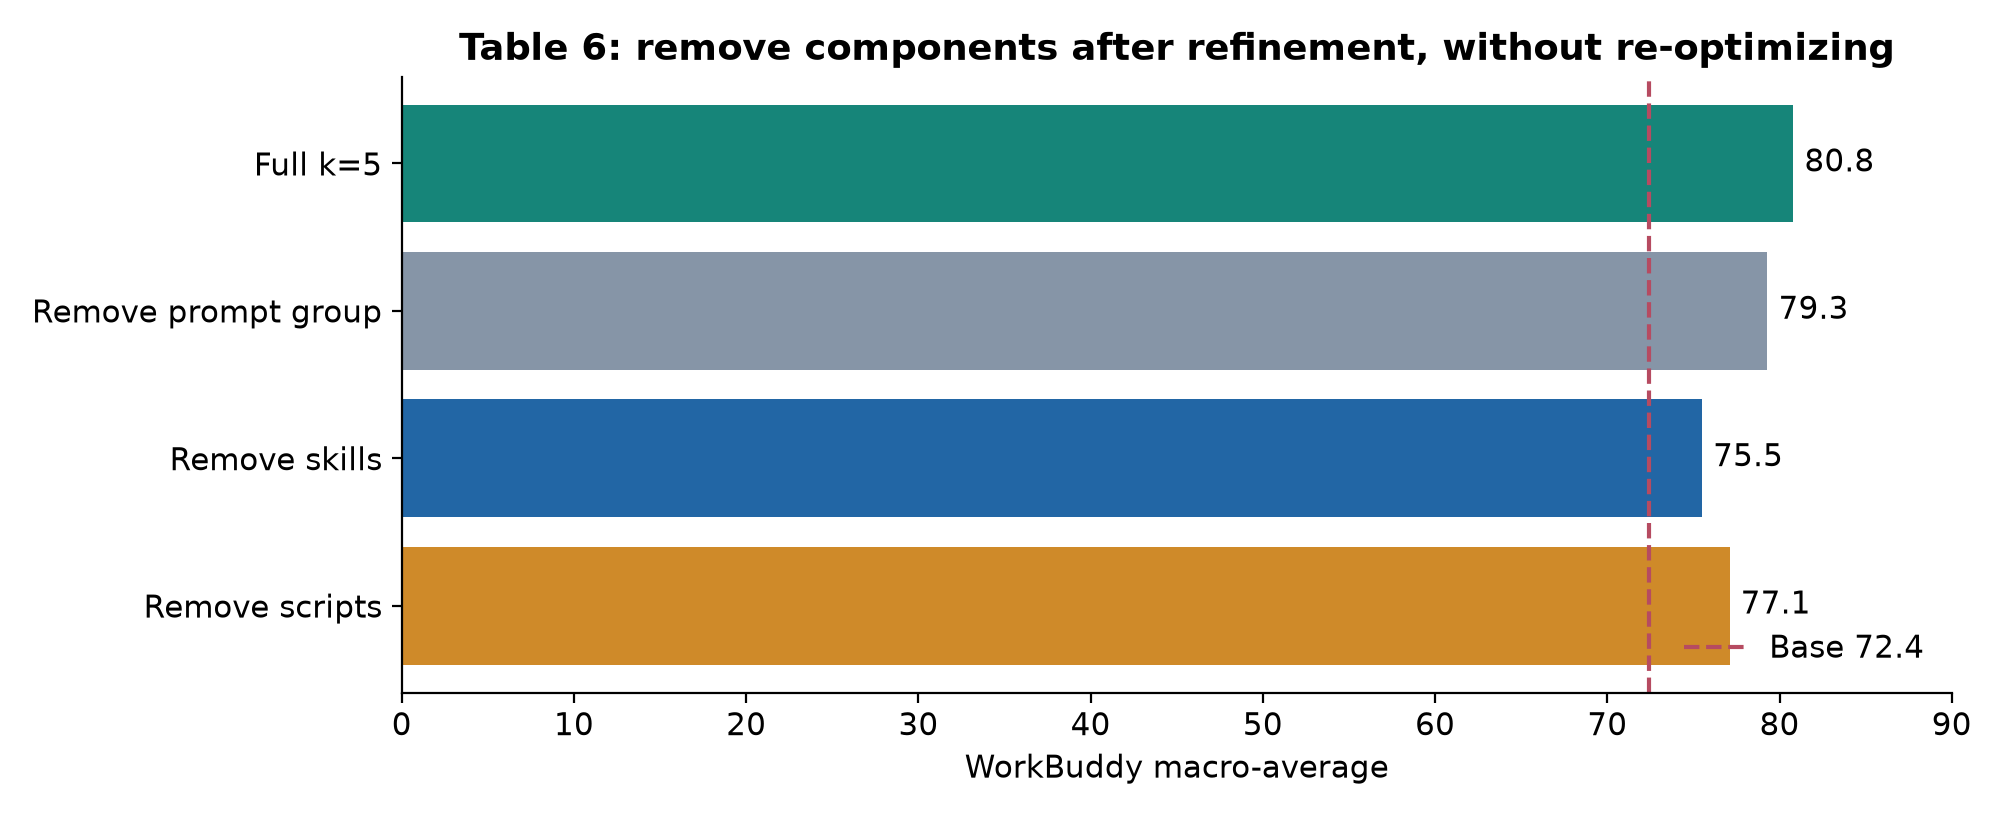
图 7. 根据表 6 重绘。删除发生在优化之后,系统没有机会为缺失组件重新寻找替代方案。
这可以说明最终配置实际用到了技能、脚本和提示组件,但不能直接给组件排一个适用于所有系统的价值榜。如果从一开始就禁止脚本,优化器也许会找到不同工具或更好的技能流程;如果同时删除技能和脚本,损失也不一定等于两项单独损失之和。
更稳妥的说法是:在已经学出的配置里,多类组件共同发挥作用,移走其中一类会破坏原来的配合。这个结论已经很有意义,没有必要再扩大成“技能永远比提示重要”这样的泛化口号。
9. 迁移与案例:结果怎样连接到具体机制?
9.1 不同迁移实验回答不同问题
把 JobBench 上积累的库转到 WorkBuddy,Code、Web、Office 分别得到 77.1、76.9、82.4,而对应的一般 设置为 76.5、76.4、79.5。这支持某些工作流程经验能够跨这些专业任务领域复用,尤其 Office 的差值较明显。但它并不保证任意库、任意任务分布都能迁移。
另一项实验用较晚形成的库回头重新执行早期任务,并排除该任务自己的条目。WorkBuddy 从 77.5 到 79.4,JobBench 从 36.0 到 37.7。这说明后来积累的经验对过去任务也可能有帮助,但这是回顾性复用:它用到了未来经验,还重新执行了任务。
因此,不能把这两个数当成最初在线流程当时就取得的成绩。现实里一个已经交付的答案不会因为经验库后来变好了就自动更新;如果需要重做,重做的费用和任务时效性都要计算。这不是否定实验,而是给收益放在正确的时间边界上。
跨模型迁移以及相同模型担任编辑、执行角色的实验,进一步削弱了“完全是强老师替弱学生做事”的解释。不过主结果中的改进器依然很强,而且技能是否有效与执行模型有关。某个模型缺少的程序性知识,另一个模型可能早就掌握;相同说明对前者是帮助,对后者可能只是冗余上下文。
图 10 的文件重合分析又是另一种指标。作者按修改文件与库条目的非样板行重合度分类,并去掉大量配置共有的模板行。这能描述材料被复用到什么程度,却不能直接测量概念学习。文本几乎不重合的编辑也可能沿用同一个想法;大段复制的组件也可能根本没有影响结果。
9.2 工具更可靠,不等于工具调用更少
表 7 显示三个基准的工具错误率都降低了,但调用次数变化不同。WorkBuddy 从平均 20.0 次降到 17.8 次;JobBench 从 27.4 次增加到 32.8 次;LAB 从 20.8 次增加到 25.2 次。一个更可靠的 agent 可能读取更多必要材料,也可能补做以前漏掉的检查,所以“调用更少”并不是可靠性的统一定义。
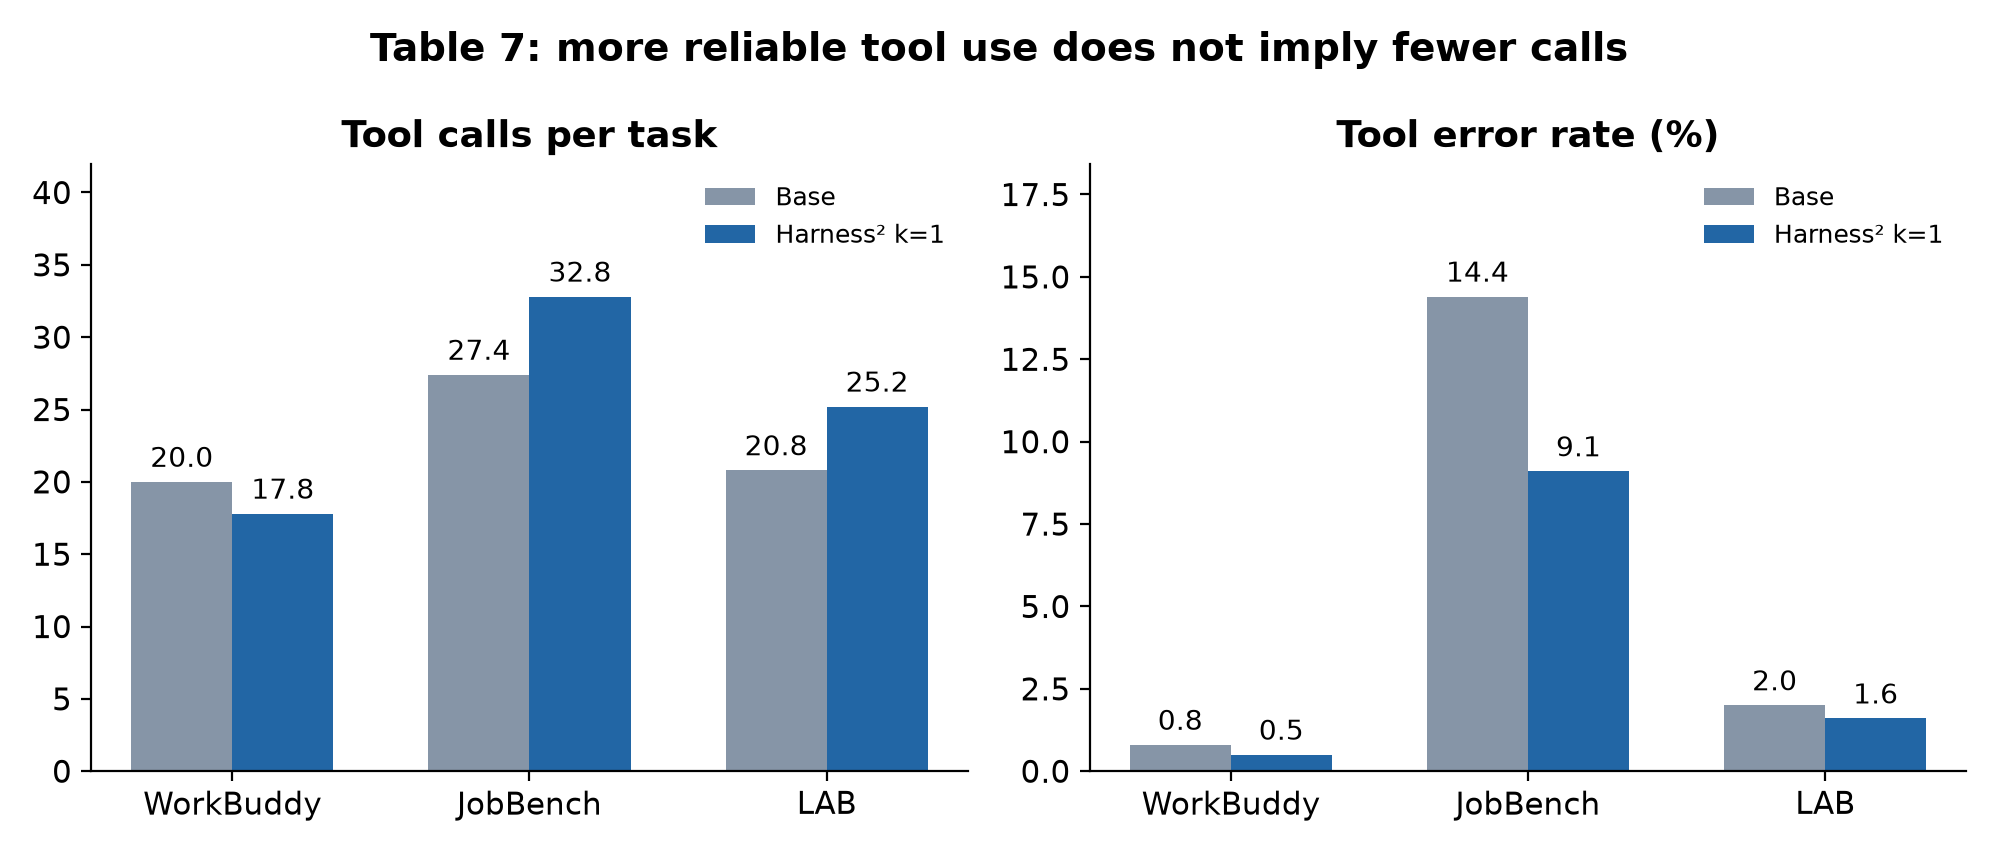
图 8. 根据表 7 重绘,配置为 Gemini 3.5 Flash/OpenCode,k=1。左图是每任务调用数,右图是调用错误率。
以 JobBench 为例,错误率由 14.4% 降到 9.1%。绝对差是 5.3 个百分点,相对下降则为:
这两个数字都不表示任务正确率提高了 36.8%。调用可以成功但读错文件,失败调用也可能被恢复而不影响最终结果。工具错误率刻画的是执行行为的一面,必须与任务结果一起解释。
还要注意汇总口径。把平均调用数乘以平均错误率,最多是一个粗略估算,未必等于平均每任务错误次数,因为各任务的调用数与错误率可能相关。若要比较绝对错误负担,最好直接报告逐任务或逐调用的原始汇总,而不是用两个均值再造一个看起来精确的指标。
9.3 案例最有价值的地方是“问题对应哪种组件”
一个代码案例通过修改工具说明,解决了模型只是写出类似工具调用的文字、却没有真正执行的问题,分数从 60 到 100。它修复的是语言与行动接口,不是给模型补充新的领域知识。一个 Office 案例通过技能和约束修正统计粒度,分数由 23.6 到 100;一个 Web 案例处理界面状态过期及验证问题,由 64 到 100。
这些是经过挑选的定性案例,不能当作平均增益。它们的用处在于把失败机制与承载形式连起来:重复的机械计算适合脚本,识别到某种文档后应当执行的流程适合技能,工具循环里反复出现的机械条件可以由 plugin 处理,而不是全部塞进系统提示。
附录包含一个使用八类组件的 JobBench 案例,其中 plugin 在连续 25 次工具调用仍没有输出产物时发出提醒。这里应读成“提醒”,不能写成“强制中止”或“绝对禁止”,因为两者给执行留下的自由度不同。运行时干预的效果不仅取决于规则内容,也取决于触发时机和约束强度。
法律 redlining 案例更需要谨慎。它的评分从 44.4 到 94.5,其中一个变化是把原来只存在于修订元数据里的内容,变成评测器的文本视图能读取的表达。这改善了可评估性,但不能直接推出所有法律文书都应该这样交付。专业流程要求保留的修订结构,可能与一个基准的文本抽取方式不同。
我的理解是,案例说明 agent 必须同时关注内容、载体和下游使用者。文件在视觉上可读、在程序里可导入、在评测器里可抽取,是不同属性。正确的 harness 应从真实请求决定交付形状,而不是把评测路径的方便程度偷偷变成用户需求。
10. 局限:哪些条件下会失效?
第一项局限是成本。多轮探测、编辑、组合、选择和库维护,都在最终 executor 会话之外消耗资源。固定预算会在简单任务上浪费计算,也可能在难任务上依然不够。并行能够缩短等待,只在资源和服务限额允许的情况下成立。
第二项是证据质量。独立容器可以减少运行之间的状态污染,却不能把单次探测变成因果实验。候选有随机性,编辑器也可能共享错误先验。十个候选如果都建立在同一个错误前提上,数量增加并没有增加十份独立证据。
第三项是选择错误。候选池里有好答案,只是成功的一半;最终选择器仍可能偏爱更简洁、看起来更完整但实际漏项的结果。选择器也是 agent,系统把一部分判断难题转移到了新的角色,并没有让难题消失。
第四项是经验库的长期污染。适用范围很窄的规则可能被泛化,单任务事实可能被当成稳定知识,旧流程可能在条件变化后继续被检索。论文采用相对简单的库组织,也承认随着积累增长,需要更好的检索、整理和陈旧经验处理。
第五项是评测与实际价值之间的距离。判分会话失败、交付物表示不匹配、某一项全有或全无的评分规则,都可能放大或遮蔽真实行为变化。附录没有把所有退步都解释成编辑失败,而是把这些情况也列出来,这是值得保留的谨慎。
这些局限并不意味着方法没有用。它们决定了结果可以外推到多远。论文已经展示了在若干专业任务流中,执行证据和经验积累能改善平均表现;要进一步声称它适合持续自主工作,还需要更强的停止条件、错误发现、回退机制和长期评估。
11. 批判性分析:这篇论文到底证明了哪一层进步?
11.1 好候选与好选择,应该分开计分
图 14 的一个 Code 失败很有代表性。五个候选的回顾性得分分别为 95、85、85、80、55,选择器最后选了 55;基础参照原本是 96。注意,这些分数是在事后评估时才知道,编辑器和选择器当时不能直接看分数选最大值。
设 是按隐藏评测标准衡量的候选池最优输出, 是实际选中的输出, 是参照输出。在最终变化里加上再减去 ,就可以得到:
右边第一项是候选池相对参照的潜在收益,第二项是选择损失。把案例数字代进去:
这只是本文用于解释的代数拆分,不是论文新增定理,也不是我又做了一次实验。它让问题变得清楚:这次大幅退步不是因为所有候选都很差,而是因为系统没选到池里已经存在的好结果。候选池最好的 95 也略低于参照 96,但这 1 分差距和选择造成的 40 分损失不是一回事。
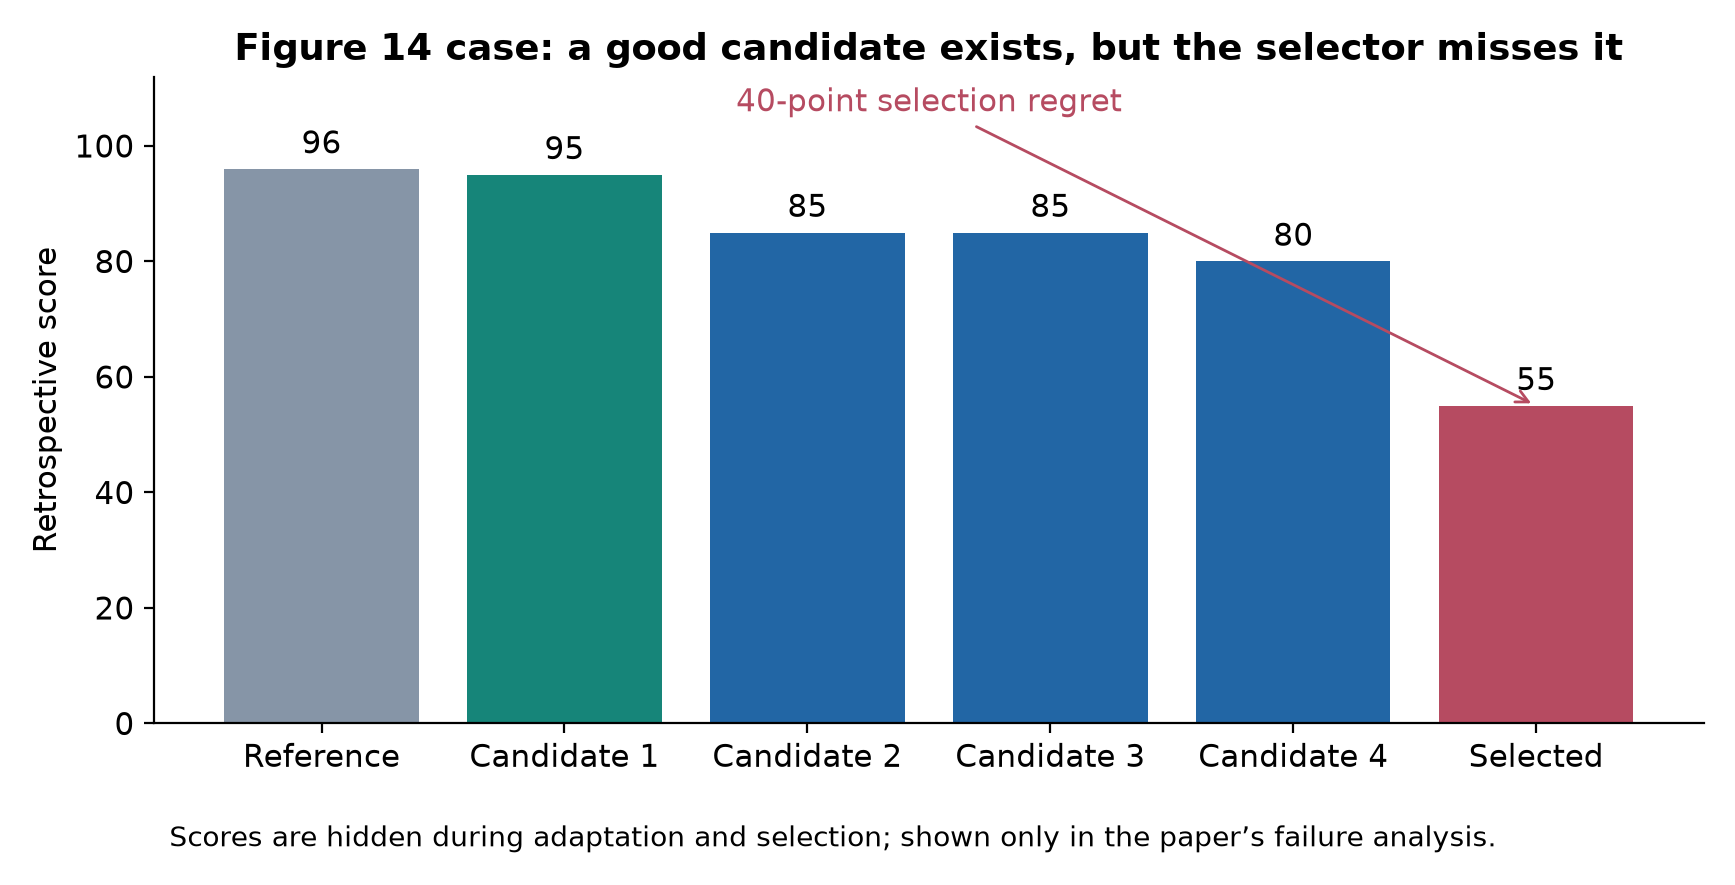
图 9. 根据原文图 14 的 WB-Code 失败重绘。分数只用于事后解释,运行中的选择器并不知道这些数值。
后续实验如果同时报告每种预算下的池内最优分、实际选择分和选择损失,会比单看最终均值更有信息。假如增大 后候选池持续变好,选择损失却也上升,那么下一笔计算预算也许应该投入选择器,而不是继续扩大搜索。
可以加入一个“事后用真实分数选择”的上界曲线,但必须明确它不可部署,只用于测量搜索已经创造了多少潜力。把这个 oracle 上界和实际系统混在一起,会重新引入论文努力排除的标准答案优势。
11.2 自己写的检查,可能反复确认自己的错误
另一个失败里,编辑器认为缓存按对象身份作为键已经足够,不需要按内容等价处理。它生成的检查脚本连续三次报告通过,但真实测试中的内容等价情形仍然失败。这是一个很直接的反例:增加验证动作的次数,不等于增加了独立验证。
如果检查脚本与修改来自同一个前提,它很可能只是证明“系统按照这个前提工作”。更有价值的问题应当挑战前提本身:对象身份变化而内容不变时会怎样?对象身份相同但内容变化时又会怎样?这里的反例设计是本文提出的诊断思路,不是声称论文已经做了这些额外实验。
原文的字面 header 键规则也有类似结构。严格保持大小写,看起来像一种谨慎的格式约束;如果任务真正需要规范化,这条规则却会让所有候选被同一个错误上限卡住。形式上的“严格遵守要求”,仍然依赖系统正确识别什么才是要求。
因此,对这类方法来说,最稀缺的并不总是更多候选,而是更能区分竞争解释的探测。一个能够推翻错误假设的小检查,可能比五次沿同一假设运行更有效。这也是为什么行为对照不能被包装成自动获得正确性。
11.3 第二层递归,是学会优化,还是找到了更好模板?
通过经验库发生持久变化,确实满足了一种系统层面的自我改进。不过当前结果把几种机制放在一起:检索可复用文件、回忆专业步骤、识别旧失败模式,以及改变诊断和编辑的方法。它们都可能有用,但不是同一种能力。
一个很直接的后续实验是四组对照:不存材料、只存组件、只存经验、组件与经验都存。尽量固定候选数、模型、检索额度和总 token 预算,再比较输出。这样可以检验:没有可执行模板时,经验是否仍然改善提议;没有解释性经验时,模板是否仍然可靠;两者共同使用是否出现额外收益。
如果“只存组件”已经接近全部效果,那么主要机制可能是模板检索和适配;如果“只存经验”在新任务上也明显提升,则更支持诊断策略发生了变化。二者都不是坏结果,但决定了我们应该怎样描述第二层递归,以及后续该优化什么。
还可以在任务流中某个时刻冻结库,与继续更新的版本比较。这样能够区分“拥有一个库”的收益和“不断更新这个库”的收益。再改变任务顺序或插入分布迁移,观察哪些旧经验继续有效、哪些开始产生负迁移,才能更接近长期自我进化的实际问题。
11.4 计算收益要放在正确的生命周期里看
计算量—性能前沿只适用于论文所测设置。离线优化可在大量部署中摊销,在线探测通常每个任务都要重新支付,库建设与维护另有周期;任务量、新颖程度、并发资源与错误代价会改变成本比较。
实际决策要比较本任务再做一次探测的预期收益与新增成本。一种可能的停止策略是:当新候选不再揭示新失败机制,或者证据无法区分候选时,停止编辑。但这种预期收益需要校准,不能靠模型一句“值得继续”决定。
这只是研究建议。论文没有建立经过校准的停止策略,也未证明系统能可靠判断何时证据不足。允许“不知道该不该改”,才能让 KEEP_BASE 成为严肃的决策分支。
我的总体判断是:论文把修改与执行证据连接得更紧,取得了超出单纯答案扩展的收益,也呈现了具体失败。任务内实验与跨任务保留的分离很有价值;如何把不完美的证据转化为可靠采用和持久经验,仍然是薄弱环节。
12. 结论
Harness² 给出了一种不改模型权重的 agent 改进方式:当前任务里,让不同职责的编辑器提出修改,实际观察影响,再组合并执行;任务结束后,留下可复用组件与有支持的经验,下一个任务重新从基础 harness 出发。
多种专业基准和模型—harness 组合上的结果支持这套设计有实际价值。但“自我改进”需要拆开理解。候选池变好,选择器仍然可能选错;检查脚本可以重复确认错误前提;可复用流程可能携带过时假设;最后执行的步数减少,也可能与总体计算量大增同时发生。
我最想保留的一点是:把修改绑定到可以观察的行为变化,同时始终承认行为变化与正确性之间的距离。这比把一切变化都称作进化更有研究价值。Harness² 沿着这个方向前进了一步,选择可靠性、因果归因、经验库维护和自适应预算仍然是需要单独解决的问题。
参考资料与配图来源
- Xu, R., Chen, Y., CuiZhu, Z., Mishra, B. D., Ming, Y., Yu, H., Han, R., Lee, C.-Y., and Pfister, T. Harness^2: Recursive Agent Harnessing for an Open World. arXiv:2610.14224v1,2026-10-09。方法见第 2.1–2.3 节;评估设置见第 3 节与附录 D;主结果见表 1–3;补充分析与失败见附录 E;局限见附录 F;各角色完整提示见附录 H。
- 作者项目页与官方资源入口。图 1–3 为方法解释图,图 4–9 重绘原文数据与案例,出处见图注。原文许可为 CC BY 4.0,所有图均不代表新增实验。