笔记日期:2026 年 10 月 11 日
笔记作者:Zhongzhu Zhou
论文:AutoHarness: improving LLM agents by automatically synthesizing a code harness
论文作者:Xinghua Lou、Miguel Lázaro-Gredilla、Antoine Dedieu、Carter Wendelken、Wolfgang Lehrach、Kevin P. Murphy
arXiv / DOI:2603.03329v1 / 10.48550/arXiv.2603.03329
版本与日期:v1;arXiv 页面记载 2026-02-10,PDF 首页日期为 2026-03-05,分别保留。
1. 先说清楚:究竟是谁在自我改进
一个模型会解释国际象棋规则,并不意味着它每一步都能走出合法棋。尤其在长对局里,状态追踪、坐标格式和特殊规则都会出错。AutoHarness 把这个问题拆开:让语言模型负责提出想法,再让一段可重复执行的程序负责检查规则;而这段程序也由语言模型根据环境反馈逐轮生成和修正。
这里改进的是模型外面的程序,没有训练语言模型的权重。模型充当程序编辑器,环境提供错误证据,搜索算法决定下一次修改哪个候选版本。因此,这篇论文可以作为理解 harness 自动改进的具体案例,但不能据此说基础模型已经实现递归自我升级。作者把专家程序蒸馏回基础模型、建立可复用程序库,都放在未来工作里。
论文讨论三种形态。第一种是动作过滤器:程序先生成一批合法候选,模型再挑选。第二种是动作验证器:模型先提议,程序不认可就要求重试。第三种是完整代码策略:程序直接决定下一步,运行时不再调用模型。主要实验围绕第二种,单人游戏最高平均奖励来自第三种。它们的推理成本和能力边界不同,不能统一写成“加一个检查器就完全超越大模型”。
阅读时还要把三个实验集合分开。附录表 1 的 145 个环境用于展示学到的 harness 的合法动作表现;实际智能体对局只选了 32 个游戏,包括 16 个单人和 16 个双人游戏;完整代码策略则只评估 16 个单人游戏。因此,145 是合法性测试的范围,不是完整策略在 145 个任务上都获得更高奖励的证据。
这篇论文最有价值的地方,是把每一步反复用自然语言推理的规则,变成一次生成、反复执行的程序。最值得追问的地方,也是这个转换过程:程序认定合法,究竟多大程度等于环境真的允许?附录给出了一组不应忽略的数据,某些“模型加 harness”的实际对局合法率仍低于 100%。这份笔记会保留这个差异,而不是只重复摘要里的最强表述。
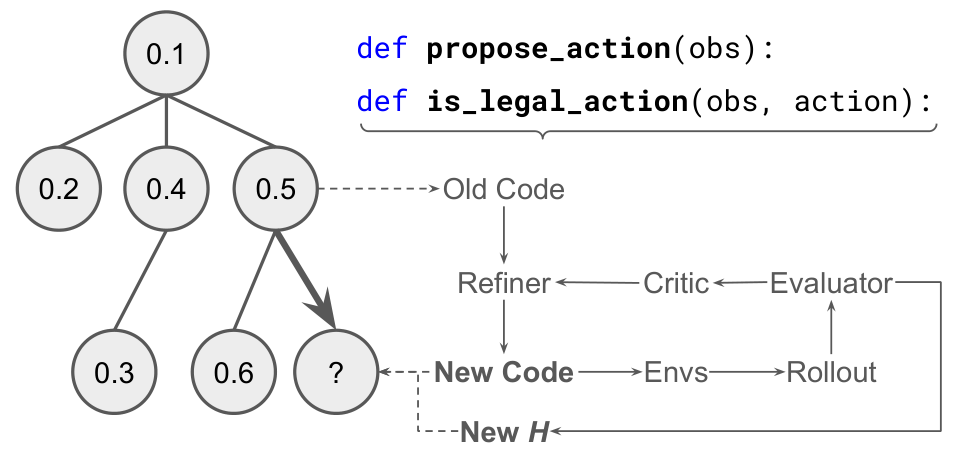
图 1(论文 Fig. 1):树中的节点是候选 harness 程序,子节点是经过反馈修改的新程序,不是棋局的下一步状态。环境执行结果进入 critic 和 refiner。原图裁剪自 AutoHarness v1,作者 Lou 等,CC BY 4.0。
2. 前置知识:合法、看得见、走得好是三回事
用 表示环境的真实状态,模型能看到的文本记为 。动作 是一个字符串,环境根据自己的规则解释它。真实合法性记为 ,允许就为 1,不允许就为 0。语言模型给出候选动作的分布是 ,学出来的检查程序则是 。
不要把 和 当成同一个东西。前者是环境真正执行的规则,后者只是根据可见信息作判断的程序。程序即使由强模型生成,也可能漏掉边界情况。让程序和模型互相同意,只能说明两者一致,不能替代环境对动作的实际判定。
合法也不等于优秀。象棋里把皇后送到能被吃掉的位置,可能完全符合规则;扫雷时点开未揭示格子可以是合法动作,但格子里仍可能有雷。反过来,战略想法不错,却把坐标写错,也会被环境拒绝。所以至少应区分字符串格式正确、符合行动规则、能获得更高奖励三个层次。合法性指标主要约束前两个层次,并不能直接给出第三个层次的答案。
另一个容易被忽略的问题是观测是否充分。如果两个真实状态在文本里长得一样,但某个动作在一个状态合法、另一个状态非法,那么只看该文本的程序不可能总是判断正确。精确的观测条件至少要求:
这是笔记为解释信息边界写出的条件,不是论文中的定理。例如,国际象棋当前棋盘未必包含王车易位权和吃过路兵需要的历史信息。完整观测可能提供了这些信息,但不能仅凭“程序解析了棋盘”就默认它掌握全部状态。模型再聪明,也无法从未提供的信息中可靠还原唯一答案。
最后,文中的训练主要指反复生成程序、执行环境、收集反馈。程序搜索没有对模型权重求梯度。理解这一点,才容易看清它的成本结构:前期付出搜索成本,后期依靠固定程序减少重复工作;如果环境换得很快,前期成本可能来不及摊薄。
3. 拒绝采样:到底是在什么条件下重新分布
论文把动作验证器理解为一种学出来的拒绝采样器。先暂时固定观测和提示词,假设每次提议都独立来自同一个分布。程序只接受 的动作。那么一次提议能被接受的总概率为:
某个动作既被提议又被接受的概率是 。要知道“已经接受的动作中,这个动作占多少”,需要除以全部接受事件的概率,也就是:
这个式子表达的是按检查器的接受集合重新归一化。只有检查器本身精确时,它才等于“在真实合法动作上条件化”。一旦程序误放行,非法动作仍有概率进入最终输出;一旦程序误拒绝,本来能获胜的合法动作也可能被永久排除。
重试不是免费的。在上述独立、同分布假设下,前 次失败而第 次成功的概率为 ,所以提议次数服从几何分布。把“至少还要再试一次”的尾概率加起来,可以得到平均调用次数:
接受率为 0.1 时,理想化的平均提议次数就是 10。只统计最终提交的那个动作,会把前九次左右的模型工作藏起来。这也是为什么“检查程序很短”不等于“整个系统开销小”:真正的成本可能主要来自反复调用模型,而非执行判断函数。
如果最多只允许 次尝试,那么一直没有通过的概率是 ,因此:
必须注意,论文实际描述的循环会在拒绝后追加警告,提示词发生变化,模型分布也随之改变。因此,上面的几何模型是帮助理解的分析基线,不是对论文真实运行次数的精确预测。真实系统应直接记录每个动作尝试了几次、耗了多少 token,以及重试到上限时如何处理。
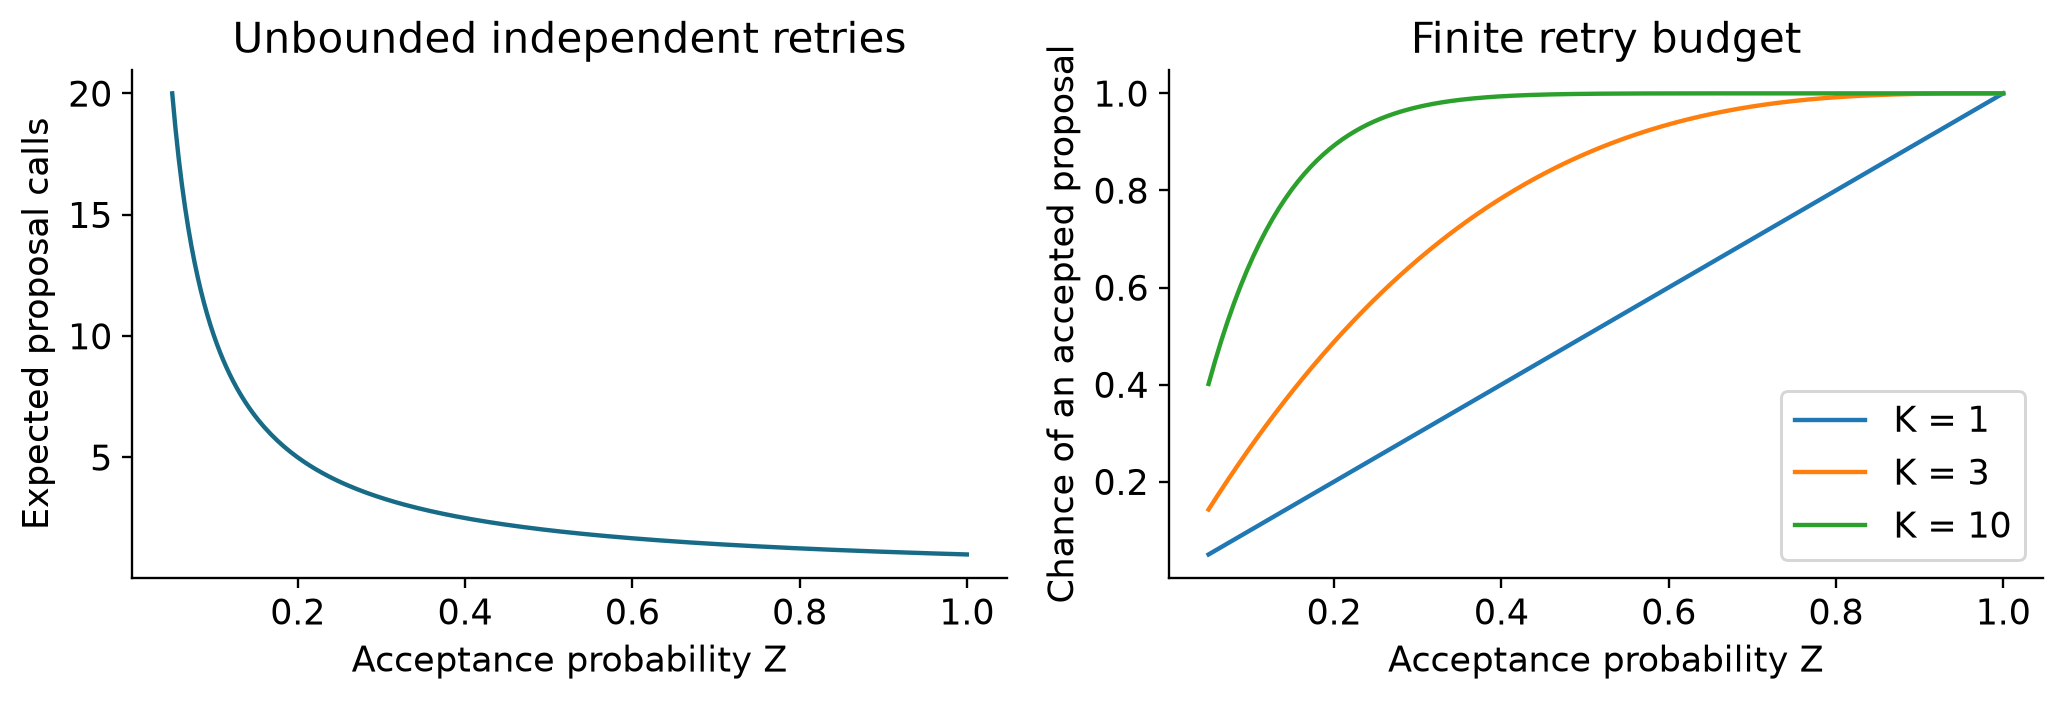
图 2:笔记根据式(4)和式(5)绘制的数学示意。左图给出固定接受率下的平均提议次数,右图给出有限重试预算下找到可接受动作的概率。曲线不是论文测量结果。
这里有一个具体的设计分叉:预算用完后,是停下来、使用另一个有明确规则的回退策略,还是把最后一次提议直接发出去?三者对奖励和非法动作率的影响完全不同。论文对整体方法的说明不能自动补齐每一种运行边界。后文讨论附录中剩余非法动作时,只能把这些列为可能需要调查的因素,不能直接认定其中某个就是实际原因。
4. 检查器的两类错误,影响并不对称
设模型原始提议合法的概率为 ,检查器错拒合法动作的概率为 ,错放非法动作的概率为 。这些概率取决于当前提议分布,换模型或换提示词后未必保持不变。被接受的动作来自两部分:合法且没有被错拒、非法却被错放。因此:
其中非法动作贡献的概率质量是 。除以全部被接受的质量,得到最终接受动作中的非法比例:
例如,假设 、、,则接受概率为 ,最终非法率约为 。这只是笔记算例,不是 AutoHarness 的实验数据。它说明,即使检查器拒绝了大部分错误,剩余的一点误放行在长任务中仍可能不可忽略。
误拒绝则有另一种代价:让策略丢失机会。设一个局面只有一步能获胜,检查器却把它拒绝了。系统之后每步都合法,仍可能必输。若合法性测试只让程序自己的提议器生成动作,而提议器恰好不产生那一步,测试甚至不会暴露这个问题。提议器和检查器可能共同避开难题,表现得相互一致,却没有真正覆盖合法动作空间。
因此,三种 harness 形态各有适用边界。先生成候选再由模型排序,可以省掉反复拒绝,但候选集必须包含好动作;先让模型提议再验证,可以保留模型的广泛搜索能力,但要承担误放行和重试开销;直接用代码决策,省去了运行时模型调用,却要求程序本身具备足够策略。不存在一种形态无条件占优。
算法 1:带明确重试边界的动作验证循环
提出动作、检查、警告后重试来自论文第 3 节。下面显式加入预算和退出行为,目的是说明系统边界,并不声称这就是论文逐行定义的运行策略。
1. 输入当前观测 o、固定检查器 v 和尝试上限 K。
2. 根据规则与观测构造模型提示词。
3. 对第 1 到第 K 次尝试依次执行:
4.     让语言模型提出一个动作 a。
5.     若 v(o, a) 接受,则把 a 交给环境。
6.     否则在下一轮提示中追加拒绝警告。
7. 所有尝试都失败时,停止或启用事先定义的回退策略。
8. 记录拒绝次数、回退行为与环境最终判定。
这里第 8 步尤其重要。系统只保存最后一个成功动作,会让开发者看不到频繁拒绝和偶发预算耗尽。一个平均奖励不错的智能体,也可能因为少量特别慢的状态而难以使用。合法性、覆盖率、重试次数和尾延迟应该一起观察。
5. 搜索树里保存的是程序版本
AutoHarness 的树不是在棋盘上向前搜索几步,而是在程序空间里保留不同假设。一个节点对应旧 harness,子节点对应模型根据反馈修改后的新 harness。保留分支的理由很直接:一次修复可能解决当前错误,却让另一类局面退步。如果每次只覆盖唯一版本,就会失去以后值得继续修改的候选。
论文使用 Thompson sampling 来选择继续改进哪个节点,并沿用 Tang 等人的搜索思路,heuristic weight 设为 1.0。但正文没有完整给出后验分布族、更新细节,以及具体如何把启发式值映射到采样概率。阅读笔记不应把熟悉的 Beta-Bernoulli 更新式直接补进去,再说这就是作者的方法。
在概念层面,Thompson sampling 可以理解成:根据已有证据,为每个候选采样一个“它可能有多好”的值,再选采样值最高的那个。形式上写作:
这里 是与候选 相关的评估证据。式(8)解释探索与利用的思想,并不是论文未披露细节的替代规格。不确定性较大的候选,有时会在抽样中超过当前高分者,因此仍有机会得到下一次修改。
程序搜索还有一层特殊性:当前版本的得分,和它的后代能改到多好,并不是同一个量。一个很弱的程序可能只差一个关键修复;一个已经很强的程序可能难以继续提升。论文展示了整个搜索方案有效,但没有独立分析什么不确定性模型最适合估计“值得修复的潜力”。这也是后续消融实验应当回答的问题。
6. 环境反馈怎样变成下一轮修改
验证器训练每轮使用 10 个并行环境,rollout 最多 1,000 步并自动重置。出现非法动作或程序执行失败时,相应 rollout 停止。最多抽取 5 个失败步骤交给 critic,由它归纳错误;再把旧程序和这些反馈交给 refiner 生成新程序。整个过程使用 Gemini-2.5-Flash,合法性启发式达到 1.0 或预算耗尽时结束。
这套流程的优点是反馈具体。模型收到的不是抽象的“你写得不好”,而是特定棋盘、特定动作以及环境错误。critic 对错误进行归纳,可以把多条相似失败压缩成更清楚的修改要求。但每轮只抽少量失败,也意味着稀有错误可能被普通错误淹没。反馈压缩节省上下文,与保留错误多样性之间存在取舍。
论文区分了两种修复情形。检查器说合法、环境却说非法时,提议器和检查器都可能需要改;检查器已经拒绝、动作确实非法时,重点是让提议器产生更好的动作。关键是最终标签来自环境。若让生成的检查器同时充当自己的裁判,就容易把两个函数之间的一致性误当成真实正确性。
算法 2:按论文描述重建 harness 合成流程
伪代码保留已说明的步骤;论文未完整定义的采样分布保持抽象。
1. 建立程序候选树,保存初始 harness 及其评估证据。
2. 用 Thompson sampling 引导选择一个待改进的程序节点。
3. 在 10 个并行环境中执行,rollout 最多 1,000 步。
4. 某条 rollout 遇到非法动作或执行失败时停止。
5. 最多抽取 5 个失败步骤,由 critic 归纳反馈。
6. 让 Gemini-2.5-Flash 根据旧程序与反馈生成修改版本。
7. 评估新程序,将其作为子节点加入候选树。
8. 用合法动作启发式更新搜索证据。
9. 达到目标或预算上限则停止,否则继续搜索。
10. 对选中的 harness 使用新的测试 rollout 评估。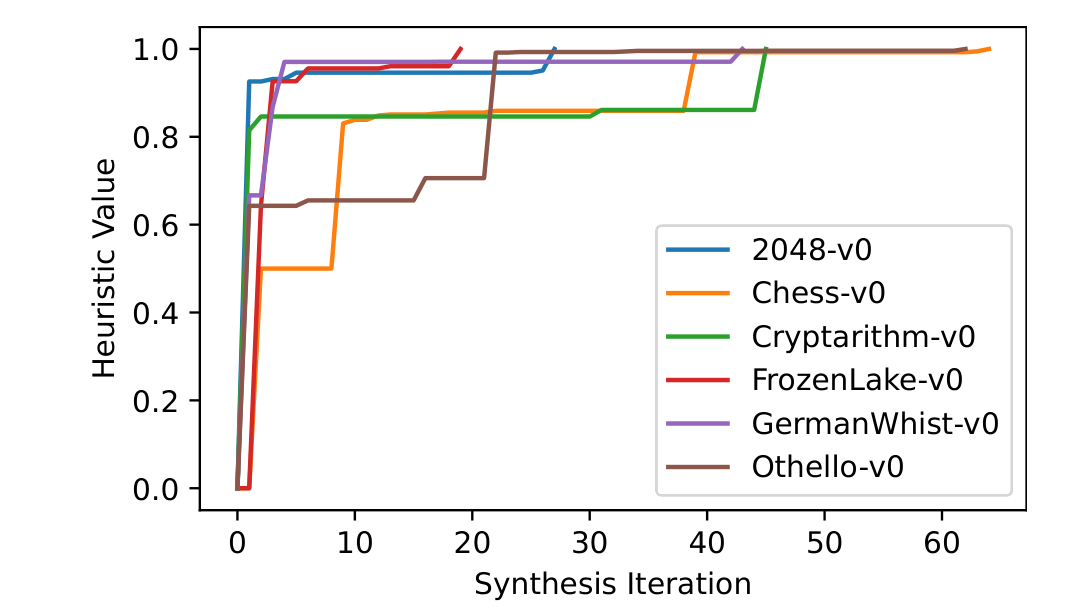
图 3(论文 Fig. 2):六个游戏的合法动作启发式曲线。有些规则需要经历平台期后才能被修复。曲线说明程序改进不是匀速过程,但不能单独证明 Thompson sampling 优于其他搜索方式。原图裁剪,CC BY 4.0。
为什么不直接人工写规则?在规则明确、长期稳定、任务数量不多时,人工规则或现成权威接口可能更简单。AutoHarness 的潜在价值在于需要适配很多环境、现成规则接口不可用,而环境又能给出廉价反馈的场景。为什么不直接微调模型?这里希望把可重复的机械约束放到可执行程序中,避免每次重新生成同一类推理;但这并不意味着所有战略知识都适合程序化。
一个合理的替代方案是只保留一条线性修复链,另一个是不断独立重新采样程序。树搜索同时保留多个修复方向,可能更有效,但也更复杂。论文没有在相同 token、环境步数和时间预算下充分拆解这些替代方案,因而目前更稳妥的结论是“整个反馈搜索流程有效”,而非“特定选点策略已被证实不可替代”。
7. 从检查动作到直接给出策略
完整代码策略改变了提议器的职责:不再随机给出一个合法动作,而是尽量给出能提高最终奖励的合法动作。论文实验中的策略只调用普通 Python 功能和 NumPy 等库,在游戏决策时不调用语言模型。因此,推理工作被提前放到程序合成阶段,后续任务通过运行程序完成。
策略训练不再只看动作是否合法,而是把终局奖励 加进启发式。论文第 4.3 节定义:
这意味着全程合法但没有获得奖励,也有 0.5;合法且高奖励最多到 1;一旦出现非法动作就回到 0。它优先鼓励规则遵守,然后在合法轨迹之间区分策略好坏。对稀疏终局奖励而言,这样的分层能提供比单纯胜负更明确的学习信号。
不过,单条轨迹被严格处罚,不等于平均目标就禁止一切违规。令 为一条轨迹全程合法的概率, 为合法轨迹的平均奖励。对式(9)取期望可得:
一个永远合法、奖励为 0.2 的假想策略,平均启发式为 0.6;另一个只有 80% 轨迹合法,但合法时奖励为 1 的策略,平均启发式为 0.8。后者反而更高。这个算例不是作者观察到的失败,而是说明目标本身仍允许用奖励换可靠性。若应用要求绝不能违规,应另设候选准入条件,再在满足条件的策略中比较奖励。
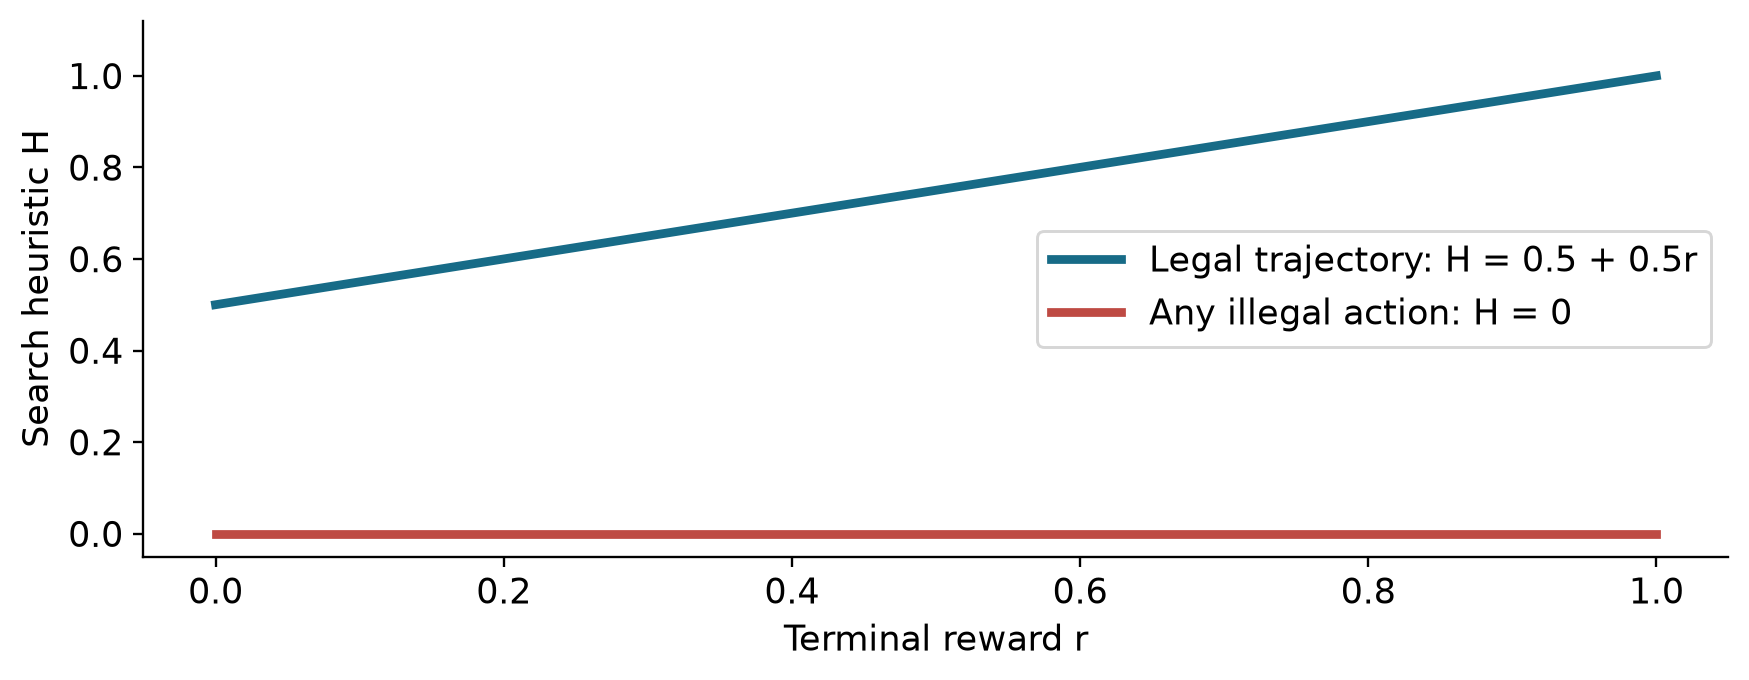
图 4:根据论文目标式(9)绘制。合法轨迹的得分随终局奖励变化,出现非法动作则为零。图示的是目标函数,不是实验训练曲线。
作者给代码策略最多 256 轮合成预算,平均使用 89.4 轮,平均启发式为 0.939。不要把它和验证器的 14.5 轮直接当成同任务下的快慢比较:策略目标更难,评估集合也不同。完整策略这里只覆盖 16 个单人游戏。双人游戏需要考虑对手策略,可能依赖更复杂的搜索与世界模型,论文没有展示同等级的完整代码策略实验。
算法 3:带奖励反馈的代码策略搜索
下面突出相对于验证器合成的变化,仍按论文描述重建。
1. 提供游戏规则、观测格式及动作接口。
2. 生成能直接提出较优合法动作的候选程序。
3. 执行轨迹,记录全程合法性和终局奖励。
4. 违规轨迹记 H = 0;其余记 H = 0.5 + 0.5r。
5. 将反馈交给程序搜索流程,生成新的策略候选。
6. 在预算内继续迭代,本实验最多 256 轮。
7. 固定所选策略,在新的游戏实例上测试。
8. 测试决策直接运行程序,不调用语言模型。
8. 实验范围:145、32 和 16 分别意味着什么
作者从 TextArena 的单人、双人游戏中选取任务,剔除九个动作是自由文本或对话的游戏,最后保留 145 个环境变体。某些观测中的可选动作提示被人工删除。附录的象棋例子很直观:棋盘和动作格式说明还在,但列出所有合法走法的一行被删去。否则程序只需复制列表,就无法体现学习规则的价值。
这使合法性问题更有意义,也限制了结论的适用面。这里有相对明确的动作语法,环境能够判断是否违法。开放式研究助手的情况不同:一段回答可能格式正确,但结论没有证据,或者操作时机不合适。被排除的自由文本游戏恰好缺少干净的二值合法性判定。把这套方法扩展过去,难点首先是可靠反馈从哪里来,而不只是让模型继续写程序。
独立 harness 测试使用新的 rollout,论文描述长度为 1,000、每个游戏覆盖十个随机种子。附录表 1 全部记为 1.0。实际奖励比较出于效率只用 32 个游戏:单人游戏每种方法每个游戏 20 局;双人游戏 40 局,先后手各一半。各模型使用同一个优化后的游戏提示词。这控制了部分提示差异,但没有自动对齐总 token、重试次数或前期程序搜索成本。
完整策略比较加入 GPT-5.2 和 GPT-5.2-High。因为成本高,两者每个游戏分别只重复 10 次和 5 次,其余方法重复 20 次。重复次数不等并不必然使平均值有偏,但不确定性会不同。特别是只有五次时,少量幸运或不幸局面就可能明显影响均值,也很难说明罕见失败率。
145 个环境也不等于 145 个毫无关联的新规则体系。表中有同一家族的多个难度或配置,例如许多 PigDice 变体只需要一轮学习。环境级覆盖很有价值,但若要论证跨规则泛化,还应增加游戏家族级统计。对同一种规则改变几个参数,与第一次理解全新规则,是不同强度的测试。
因此,应分别评价三条证据:广泛环境上的采样合法性、较小集合中的对局强度、单人游戏里的完整程序策略。把分母写清楚不会削弱结果,反而能让读者准确判断自己的问题与哪组实验最接近。
9. 平均奖励确有提升,但不是统一的胜率
16 个单人游戏上,论文报告 Gemini-2.5-Flash 平均奖励 0.673,Gemini-2.5-Pro 为 0.707,Flash 加 harness 为 0.745。相较 Pro,harness 方案在 8 个游戏上更好、5 个持平。这是一个明确的证据:在这组任务里,改善模型外围的程序,可以比单纯换一个更大的模型更有效。
相较原始 Flash,绝对奖励增加约 0.072;相较 Pro 增加约 0.038。这里说的是奖励值之差,不能直接改写成所有任务统一的成功率提高多少个百分点。不同游戏的奖励含义不完全相同,平均时又对各游戏赋予同样权重。任何相对提升都需要说明分母,更不能把这个比例当成通用智能提升。
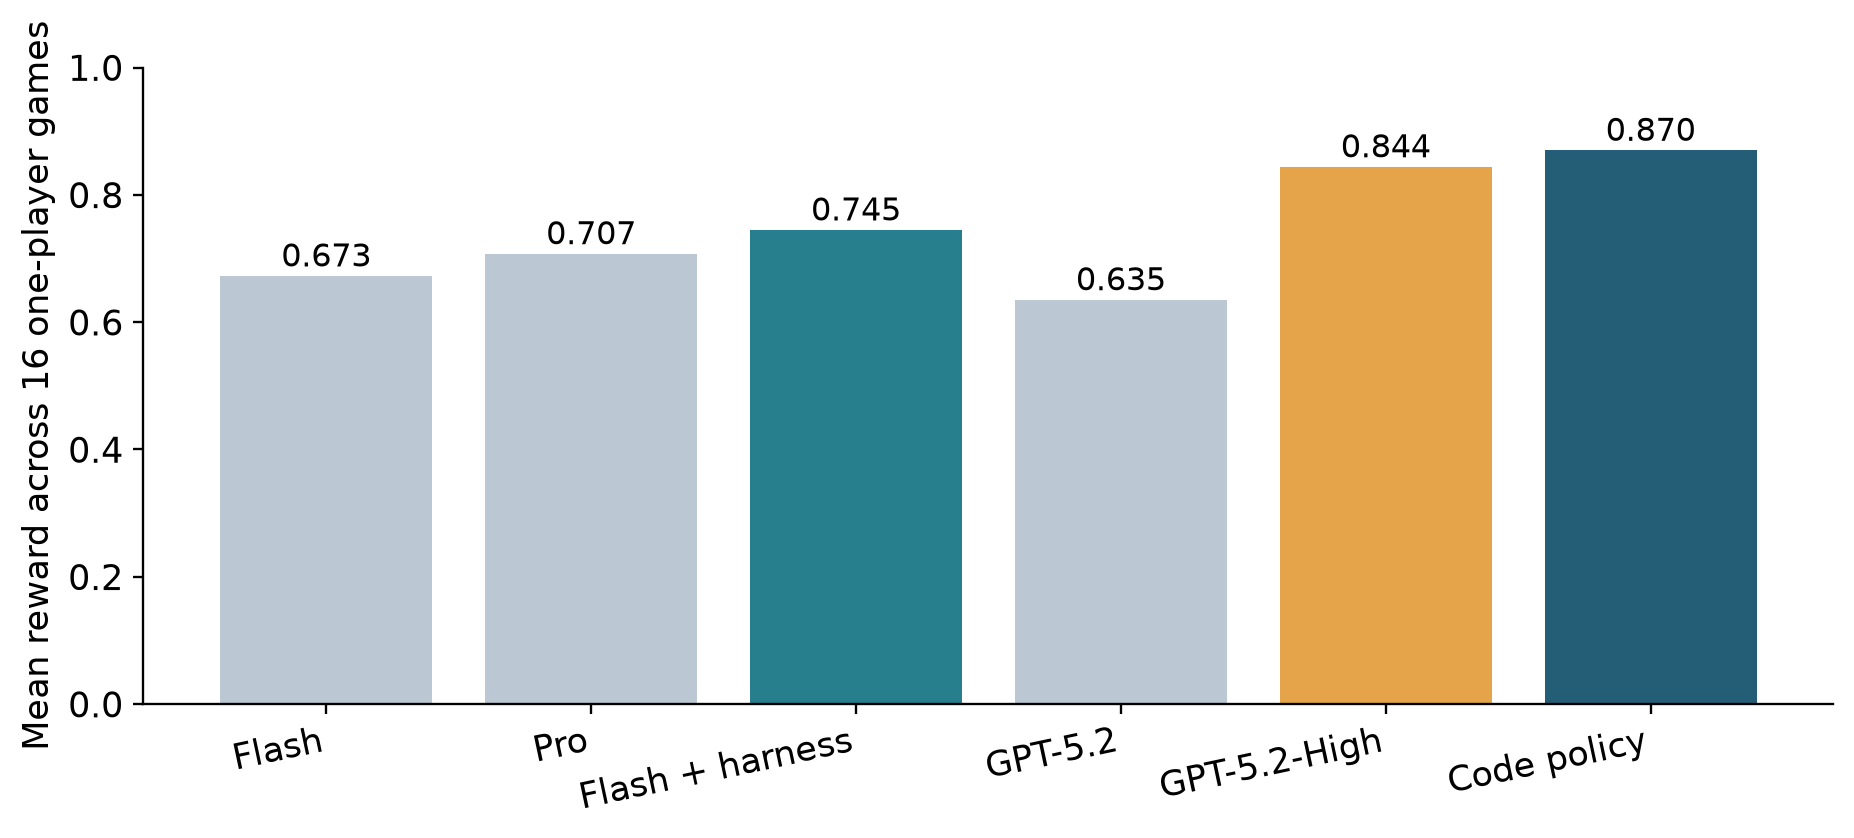
图 5:根据论文 Fig. 6 的逐游戏数值重绘,每个游戏权重为十六分之一。重算结果与正文的三位小数平均值一致。图中数据来自论文,不是本笔记新做的实验。
完整代码策略的平均奖励为 0.870,GPT-5.2-High 为 0.844。差值约 0.026,值得关注,尤其前者运行时不调用模型。但这个差距仍需要原始结果和区间估计,才能判断重复评测后排序是否稳定。现有证据支持“代码策略在该平均指标上很有竞争力”,不支持把它推广成对所有强模型的确定性胜出。
为了核对统计口径,我按附录 Fig. 6 的三位小数单元格逐项求平均。依图 5 顺序得到 0.6725、0.7074375、0.74475、0.635125、0.844 和 0.869875。这些算术复核确认了正文平均值,也说明该平均是游戏等权,而不是把所有对局简单堆在一起计分。对 GPT 系列重复次数较少的情况,游戏等权和对局等权尤其不能混淆。
但重新算均值无法还原局间波动。只知道一个游戏平均 0.8,不知道它是每局都接近 0.8,还是有些满分、有些完全失败。没有这些原始结果,就不能在笔记里编出标准误、显著性检验或者精确置信区间。数值核对解决的是算术一致性,不是统计可信度的全部问题。
10. 为什么平均分更高,却只赢三个游戏
双人游戏中,Flash 加 harness 对 Pro 的总体胜率为 56.3%,Pro 为 38.2%,其余为平局。在 16 个游戏的逐游戏比较中,harness 方案有 9 个占优;对普通 Flash,则有 12 个游戏占优,总体胜率为 64.8%。这里“占优游戏数”和“全部对局胜率”是两种统计。9 除以 16 碰巧接近 56.3%,不能因此把它们当作同一个定义。
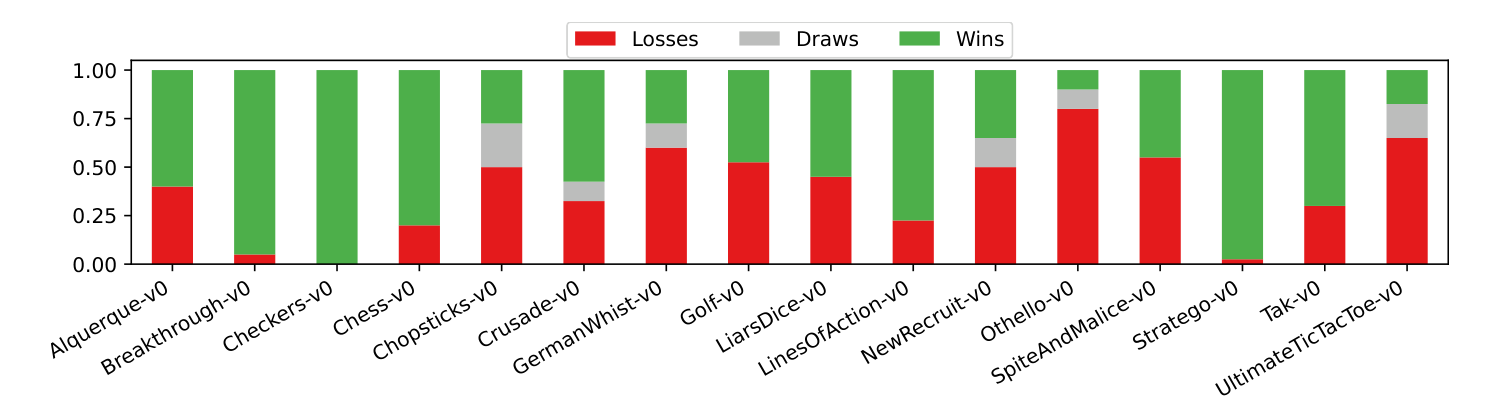
图 6(论文 Fig. 3):16 个双人游戏中,harness 方案对 Gemini-2.5-Pro 的对局结果。不同游戏差别明显,不能把总体优势理解成所有游戏上的战略优势。原图裁剪,CC BY 4.0。
单人代码策略的情况更有启发性。相较 GPT-5.2-High,它只赢 3 个游戏,输 5 个,另外 8 个持平;但平均奖励仍更高。原因不是统计矛盾,而是胜负幅度不同。在 PegJump 上高出 0.571,在 FifteenPuzzle 高出 0.414,在 2048 高出 0.167,三项增益较大。
相应损失是 Bandit 低 0.541、Blackjack 低 0.070、Minesweeper 低 0.060、Secretary 低 0.050、Sokoban 低 0.017。把这些显示值相加,总差为 0.414,再除以 16,得到 0.025875,正好解释平均优势的来源。
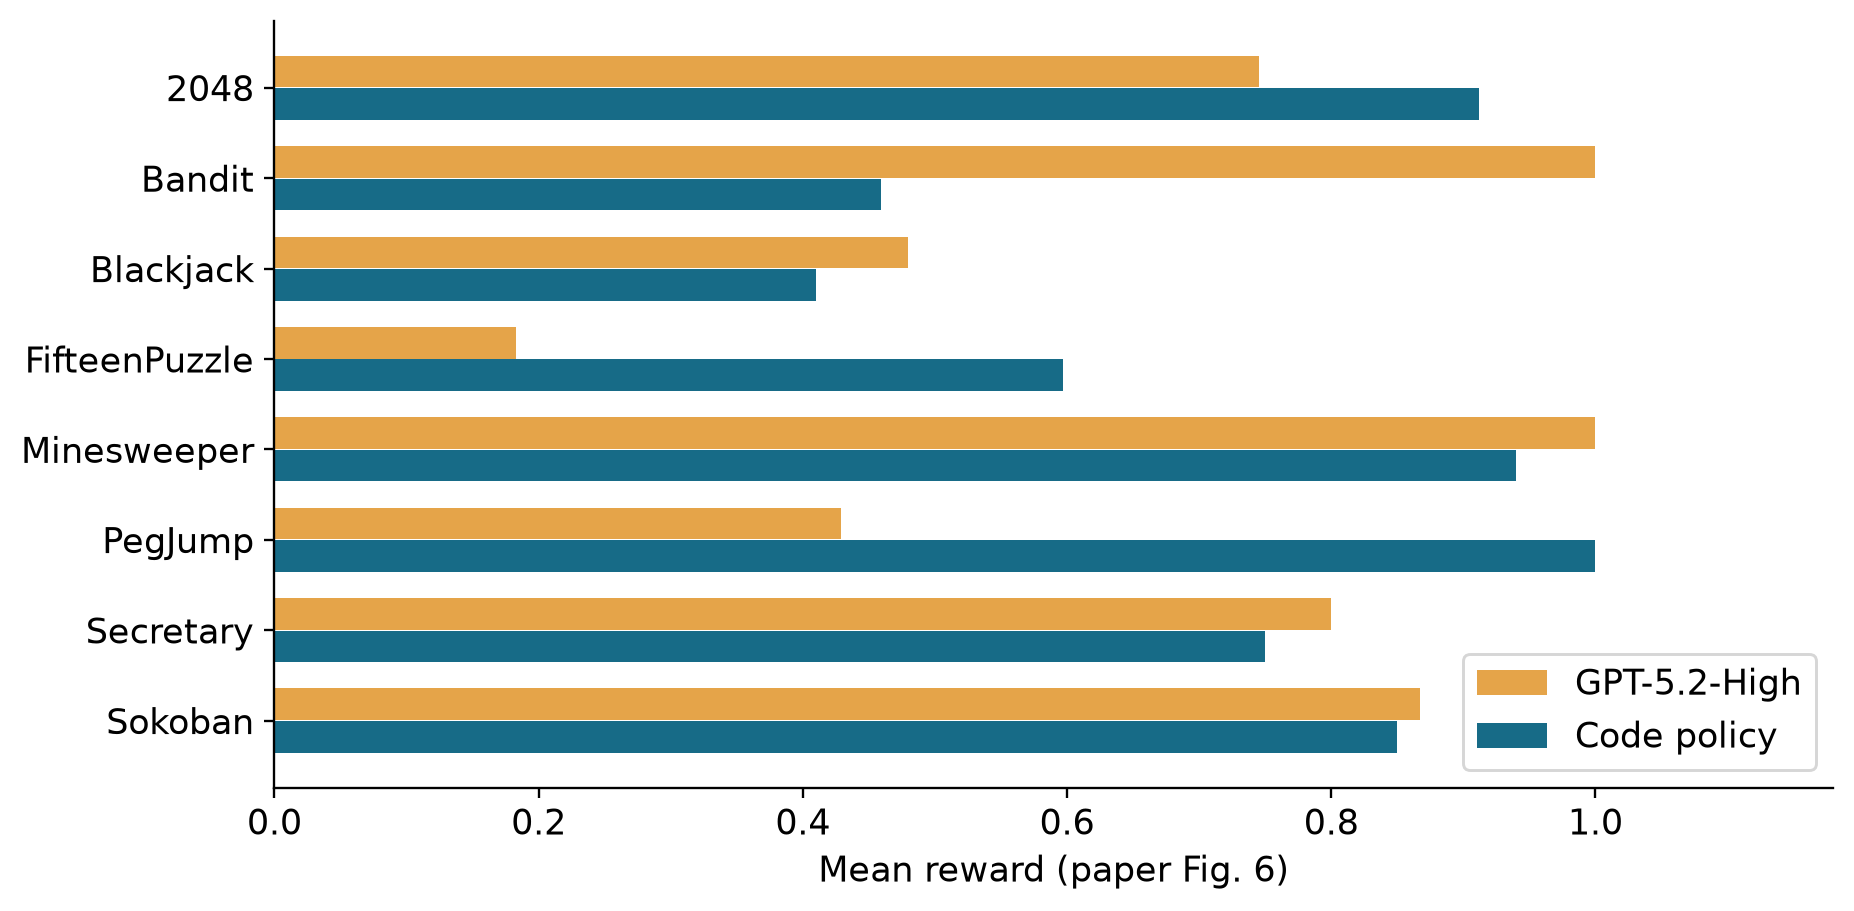
图 7:根据论文 Fig. 6 重绘,展示代码策略与 GPT-5.2-High 不持平的八个游戏,其余八个未绘出。少数任务的大幅增益,可以覆盖更多任务的小幅损失。
这对实际选型很重要。如果业务主要是类似 Bandit 的探索决策,平均值可能掩盖关键缺点;如果主要是可由确定性程序解决的谜题,正向结果就更有参考意义。一个合理猜测是,部分任务容易压缩成紧凑算法,另一些需要在线探索或对不确定性作判断。但论文没有逐项消融每个策略来源,因此这种机制解释应保留为推测,不能仅凭游戏名字就断言作者学到了某种特定求解算法。
附录展示的扫雷推导思路、象棋局部规则处理,可以帮助理解生成程序的风格,但片段并不能代表全部策略行为。决定性证据仍是固定智能体在新实例上的表现,特别是在启发式出错时会发生什么。本笔记讨论论文和附录,不声称重新运行并复现了作者的游戏成绩。
11. 独立测试零错误,为什么实际对局还有错误
附录表 1 的所有 harness 都记录为 1.0 合法动作率。但附录 Fig. 7 中,Flash 加 harness 在 2048 是 99.86%,Bandit 是 99.77%,FifteenPuzzle 是 96.59%,LightsOut 是 99.76%,PegJump 是 98.25%,RushHour 是 97.24%,Sokoban 是 98.48%。另外九个单人游戏是 100%。完整代码策略那一列,十六个游戏都为 100%。
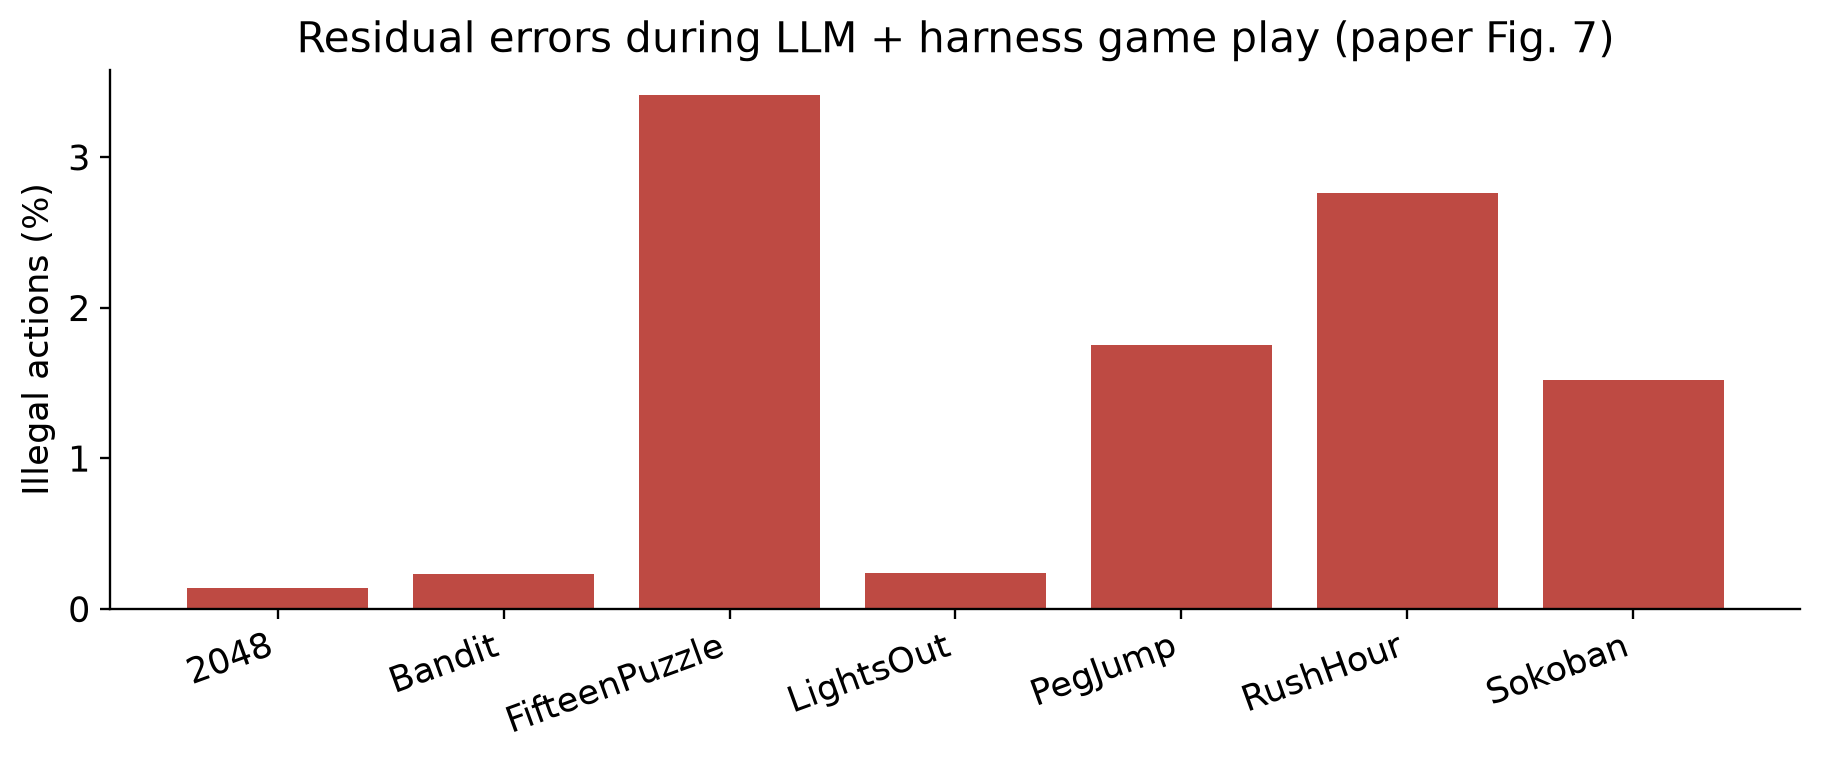
图 8:根据论文 Fig. 7,将 Flash 加 harness 的合法率从 100% 中扣除,得到非法动作百分比。只展示七个非零条目。它属于实际对局评估,与表 1 的独立 harness 测试不同。
两组结果不一定构成逻辑矛盾,因为它们可能走过不同的状态分布和控制路径。程序自己的提议器可以只产生某一小类动作,而模型可能生成奇怪格式、边界走法、罕见但合法的战略动作。模型引导的对局还可能进入随机合法提议不容易到达的状态。分布变化是合理解释方向,但论文没有提供足够的错误轨迹分析来确认具体原因。
同样,解析、重试上限和回退动作也可能影响最终结果,但不能没有证据就替作者指定根因。这里最稳妥的结论是:论文独立测试中的完美合法性,并没有在所有端到端“模型加 harness”结果中完全保持。这个发现不否认它显著减少错误,而是提醒我们不要把一个测试口径的 100% 扩展为所有使用方式的保证。
真正想测试检查器,应主动输入已知非法动作,而不是只观察自己的提议器是否一直给出合法动作。也应主动输入多样的已知合法动作,看检查器是否错误拒绝。尤其要覆盖模型偏爱的高价值动作,否则提议器与检查器共同漏掉一个好策略,也可能在合法性指标上显得无可挑剔。
还要区分按动作计数和按任务计数。长对局中的大量简单动作,会把按步计算的合法率推得很高;用户更在乎一整局能否不违规结束。若单步错误率为 ,并作很强的独立假设, 步都不出错的概率是 。实际错误常有相关性,不能直接套这个式子预测论文成绩,但它足以说明:接近 100% 的单步准确率,对长任务未必足够。
例如仅作说明,单步错误率 1% 时,100 步全程无错的概率在独立模型下约为 36.6%。因此,改进一个看似已经很小的剩余错误率,可能比把平均奖励再抬高一点更影响实际体验。测试报告最好同时提供非法动作率、每局是否出错、重试耗尽比例,以及错误集中在哪些局面。
12. 合成成本:便宜运行需要足够多次复用
正文说平均需要 14.5 轮修复,32 个游戏中有 19 个少于 10 轮。我按附录表 1 中带星号的 32 行重新计算,两项都能精确对上。若对全部 145 行求平均,则约为 10.30 轮。因此,14.5 的分母是选出的 32 个游戏,不是全体 145 个变体。把范围讲清楚,就能避免对训练成本的误读。
成本分布也很不均匀。Chess-v0 需要 64 轮,Othello-v0 62 轮,Cryptarithm-v0 45 轮,GermanWhist-v0 43 轮;全表的 Breakthrough-v0-small 达到 136 轮。另一方面,有很多变体只需一轮。若产品必须在见到新任务前就预留预算,只看平均数显然不够,还应看尾部。
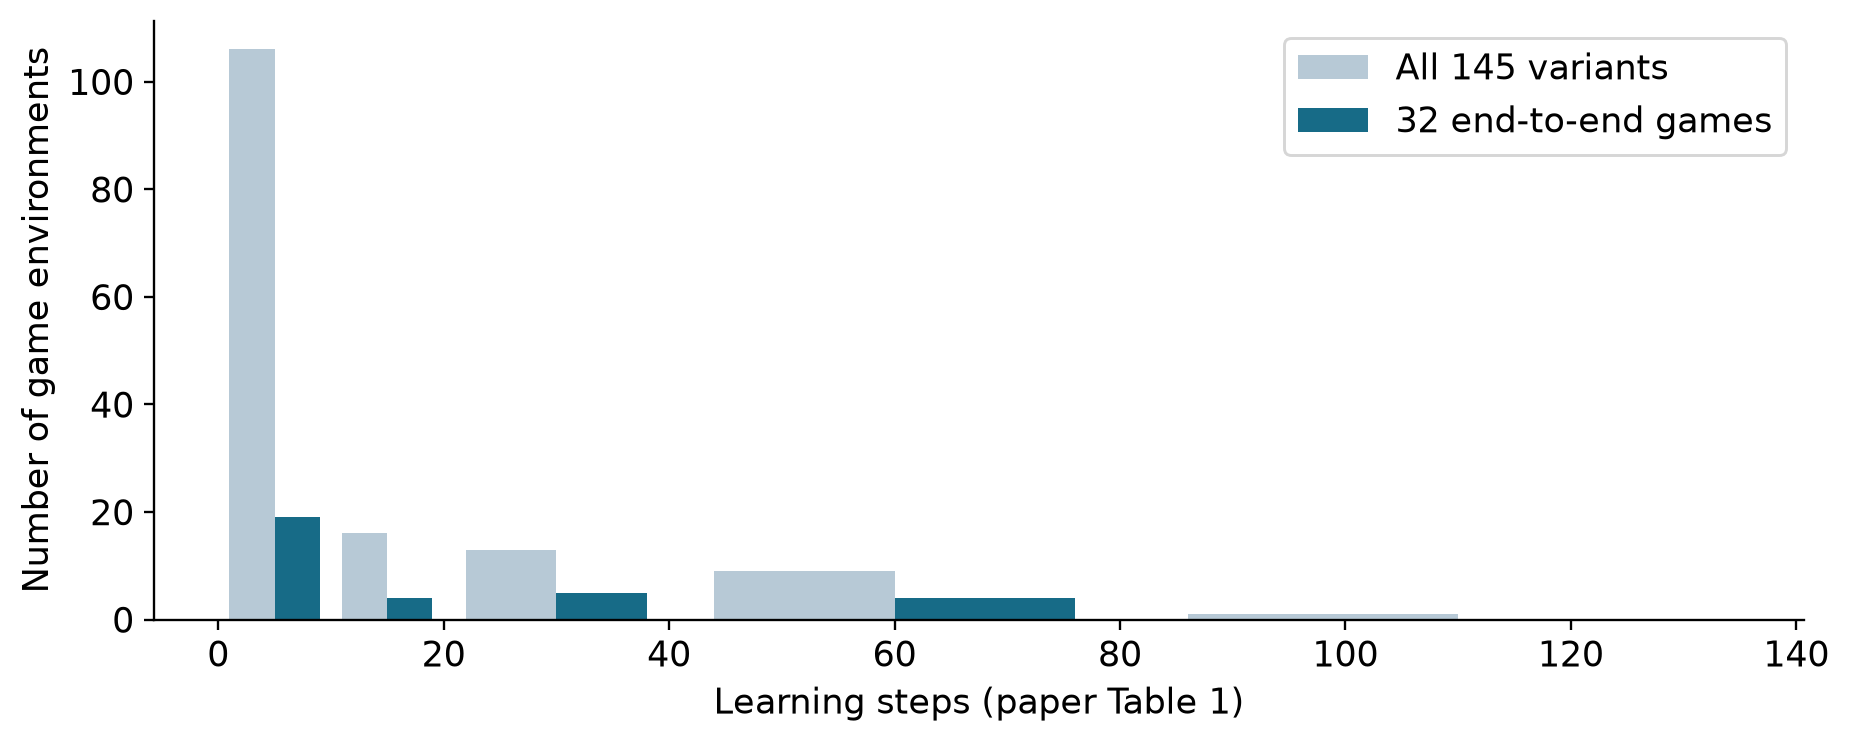
图 9:根据论文表 1 重算,比较全部 145 个环境与带星号的 32 个游戏。两组相互包含,不是独立样本;均值分别为 10.30 和 14.5 轮。
完整代码策略的吸引力是运行时不再调用模型。设一次合成成本为 ,原始系统每局成本为 ,新系统每局成本为 ,一共服务 局。新系统更便宜的条件是:
推导只是把固定成本放到一边,再除以每局节约的成本。它告诉我们,复用量才决定前期搜索是否值得。只玩一局时生成专用程序可能划不来,同一规则下反复玩几千局则可能很合适。如果环境规则频繁变化,需要反复修复,原本预计的摊销周期就会缩短。
对验证器形态还要特别小心:大量重试可能让 高于 。此时,在这个简单模型里,单靠运行成本永远不会回本;引入它的理由可能是降低错误或提高奖励,而非省钱。不能把完整代码策略的成本优势直接移植给保留模型调用的验证器。
论文报告 GPT-5.2 和 GPT-5.2-High 的相关实验共花费约 640 美元,并称代码策略测试成本接近零。这个对比说明了消除模型调用的结构性好处,但还不是完整成本账。生成候选、失败分支、环境执行、后续维护都需要计入,普通程序运行也不是物理上没有成本。应同时给出总费用、平均延迟和慢任务的尾延迟,再讨论实际是否值得。
13. 零次错误,到底能证明多少
假设一个固定检查器,在目标使用分布上接受了 次相互独立的测试。若真实错误概率为 ,完全没有观察到错误的概率就是 。要构造单侧 95% 上界,可以找出让零错误事件概率等于 0.05 的错误率:
中间近似来自指数函数的一阶展开:把 改写为 ,当指数足够小时,用 近似 。所以,1,000 次真正独立测试都无错,错误率上界约为 0.003,而不是零;10,000 次无错时,约为 0.0003。
这些是统计说明用的算例,不是根据 AutoHarness 原始轨迹计算的置信区间。论文没有给出足够完整的独立试验计数与依赖结构,不能把“十个种子、若干步”机械当成等量的独立伯努利试验。
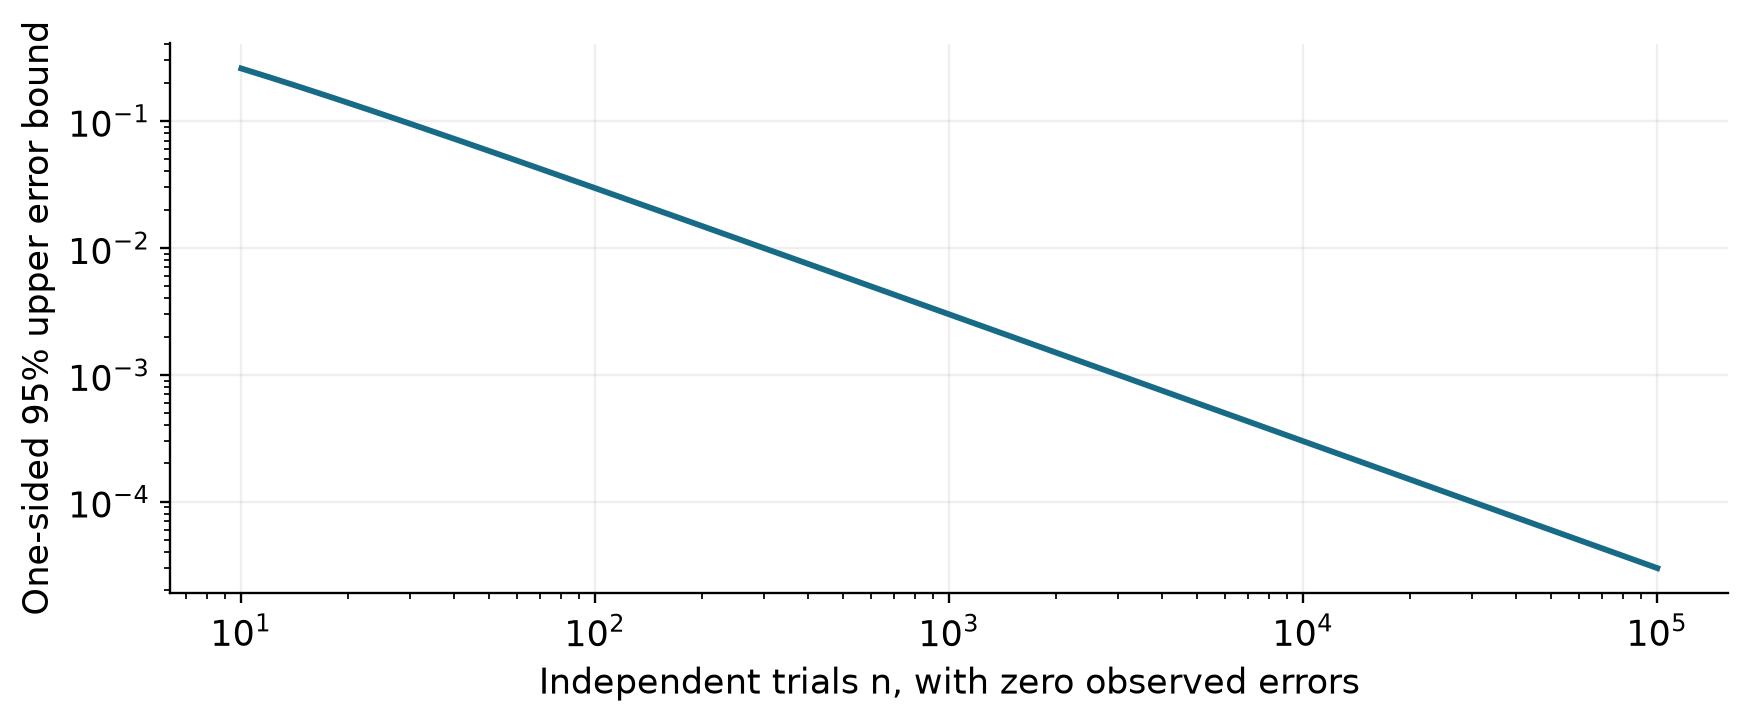
图 10:根据式(12)绘制的理论上界。前提是固定模型、固定测试分布、独立试验。游戏内连续状态、同族变体和自适应挑选候选,都会使名义步数高于有效独立证据量。
游戏里的错误往往集中在某条特殊规则上,相邻步共享同一棋盘与历史,不能认为彼此独立。不同难度变体也可能共享同一种规则知识。训练达到完美分数就停止,还会从多次尝试里挑出表现最好的候选。如果再把这些选择时用过的数据当成最终证据,会高估可靠性。论文使用新的测试 rollout 是一个积极设计,但仍不能直接升级为对全部状态的形式保证。
测试单位应该服从要回答的问题。想知道整局是否顺利结束,应把独立种子的完整对局作为重要单位;想知道能否迁移到新规则,应把游戏家族作为重要单位;想证明任何状态下都正确,则需要比采样更强的规格与论证。把一个测试跑得更长,并不自动补足另一个层次的证据。
奖励比较也类似。代码策略高出 GPT-5.2-High 的 0.026,是异质游戏均值再平均后的结果,而且两者重复次数不同。按游戏做重采样与按相同随机种子重复对局,可以分别分析跨游戏和局内不确定性,但仅有展示均值时无法可靠还原。笔记保留这种未知,比给出看似精确却无依据的显著性结论更有用。
14. 局限:哪些能力还没有被展示
每个环境仍需单独适配。 学到一个目标游戏的专用程序,与零反馈理解新游戏不是同一件事。作者提出未来积累可复用 harness 库、将专家能力蒸馏回模型,但当前结果还没有展示这条完整闭环。称其为程序层面的自动改进,比称其为模型的递归自我提升准确。
反馈要求较强。 方法受益于环境能及时告诉系统动作是否合法。自由文本任务不一定具有这种廉价、明确的判定。在开放助手里,动作可以被工具接受,却仍不符合用户意图。扩展方法时,需要重新定义可靠评价信号,而不是假设所有错误都像坐标越界一样容易判断。
搜索组件的贡献没有充分拆开。 多个分支、Thompson sampling、critic 总结、多个种子、不断重写程序,都可能带来收益。论文展示了组合流程的表现,但未以严格预算匹配的消融,说明每项到底贡献多少。未比较不代表一定无效,只代表结论还未被单独验证。
可靠性与成本报告仍不完整。 缺少足够的原始错误计数、时间分布、各方法全流程预算与不确定性分析。因此,可以相信展示出来的平均值,同时对普遍可靠、明确排名和全面省钱的表述保持范围限制。证据缺失并不等于负面结果,但也不能由读者代为补齐。
接口变化会破坏专用程序。 棋盘文本格式、动作语法、超时语义或隐藏状态表示一旦改变,旧程序可能不再适用。反馈搜索或许能修好它,但修复工作是生命周期成本的一部分。一个在固定版本上表现良好的程序,并不自动成为永远有效的环境规格。
15. 批判性分析:下一步最值得补的证据
把提议器与检查器分开评价
论文最值得追查的,是表 1 和 Fig. 7 之间的合法性差异。下一轮研究应给检查器三类输入:它自己的提议器产生的动作、多个固定语言模型产生的动作、专门构造的边界动作。第三类应覆盖语法错误、越界坐标、特殊规则,以及罕见但合法的战略动作,标签统一由环境给出。分别统计错放和错拒,才能知道它学到的是广泛的规则判断,还是只会处理熟悉的候选分布。
一个提议器如果永远绕过困难动作,可能让薄弱的检查器看起来毫无错误。二者共同工作时的高分,无法单独证明其中任何一个组件完善。把它们拆开测,不是为了否定组合收益,而是为了定位收益和剩余风险究竟来自哪里,也为更换模型后能否沿用同一个检查器提供依据。
评价“拒掉了哪些机会”
只强调没有非法动作,会鼓励过度保守。拒绝一切的检查器没有误放行,却根本不能玩游戏。小规模环境中,可以让评估端获得完整合法动作集合,测量检查器保留了多少动作、是否保留高价值动作。评估者能使用这些标签,并不意味着把合法列表泄露给行动智能体,因此仍能保留论文删去提示后的困难设置。
建议同时报告接受覆盖率、误拒率、重试耗尽率与最终奖励。假如减少非法动作只是靠排除大部分策略空间,这组指标会把代价显示出来。否则,一个“特别守规矩但经常无路可走”的系统,可能在单一合法性指标上获得过高评价。
给搜索方法做预算一致的比较
最有信息量的对照包括独立采样、单链修复、随机选节点的树搜索、Thompson 引导的树搜索。应对齐合成 token、环境执行步数和墙钟时间,再画出各预算下最佳候选的独立测试表现。只对齐迭代次数不够,因为一次修改可能消耗不同数量的推理 token 和反馈。
还应重复整个合成过程,而不只重复最终策略对局。前者测量是否依赖早期抽到一个幸运程序,后者测量固定程序面对不同局面的波动。把两个随机性来源分开,才能判断一个方案是否值得增加搜索复杂度。这是现有论文最容易通过补充实验增强的部分之一。
区分学规则、适应配置与解析文本
可以设计两组干预:一组在合成后修改游戏规则,一组只改观测格式、保留规则。前者测概念适配,后者测接口稳健性。再增加按游戏家族划分的测试,观察新反馈预算增加时表现如何恢复。这样比只在同一游戏里换随机种子,更能回答 harness 是否具备可迁移性。
如果把格式变化和规则变化混在一起,失败后很难判断是战略知识不够,还是一个解析假设失效。对自动改进系统而言,诊断清晰也影响反馈质量:知道错在输入解释,和知道错在规则推断,应该触发不同的修复目标。
把可靠性要求写进候选选择规则
式(10)说明平均启发式仍会在合法率和奖励之间交换。如果应用把合法性当成硬约束,可以先按预先声明的独立测试准入标准过滤候选,再在通过者里比较奖励。这个标准应包括重试耗尽和回退行为,而非只看最终成功动作。它仍不能保证未知分布上的正确性,但至少目标与选择方式更一致。
成本也应画成累计曲线:横轴是实际服务局数,纵轴包括前期搜索、后期运行和环境变化后的维护。再配合相同质量目标比较,而不是只选“代码运行很便宜”的那个终点。没有完成关键任务的便宜策略不一定有用;反过来,能长期复用的策略,也可能值得一次很昂贵的合成。
以上都是建议的实验设计,本笔记没有执行这些新增实验。我的判断是,AutoHarness 的方向值得继续,但下一步应把生成的 harness 看成可独立评价的决策组件,而不是因为它是一段程序,就自动赋予它比模型输出更强的正确性地位。
16. 复现实验时应先统一哪些口径
首先固定环境清单、删去合法动作提示的范围,以及合成、验证和最终测试的种子集合。写清非法动作率到底按所有提议、通过检查的提议、真正交给环境的动作,还是完整对局计数。相同执行日志换一个分母,就可能得到看起来差异很大的百分比;口径明确比多报几位小数更重要。
其次记录各候选的搜索父节点、已用预算、失败类别与独立测试得分。这样能看出修复是否只改善当前错误、却引入其他回归,也能区分选模型时用过的证据和最后评价用的证据。这是实验记录建议,不等于声称所有生成程序已经得到形式证明。
奖励比较尽量使用匹配种子,双人对局保持先后手平衡。除等权平均外,保留逐游戏结果,并在有真实部署分布时给出工作量加权结果。如果强基线因费用只能跑更少局,应明确这一点;有原始结果时再估计不确定性,不要把较小样本下的平均排序直接当成稳定事实。
成本报告应包含被拒绝的模型调用,而不是只记录最终动作。分别给出合成费用、每局模型费用、程序执行时间和尾延迟。平均任务很快但个别状态要长时间重试的服务,与固定代码直接决策的服务,用户体验并不相同。
最后,迁移能力至少有三个层次:同一游戏的新种子、同一规则家族的新配置、完全不同的新规则。AutoHarness 当前最扎实的证据,是面向目标环境生成专用程序后,在新 rollout 上取得较好表现。以后复现或扩展时沿用这个分层,能避免把适配成果写成更强的零样本泛化。
17. 结论
AutoHarness 给出的实用思路是:让模型先写一个程序,通过环境交互反复改进,再让程序承担运行时重复出现的规则约束。动作验证器提升了较小模型的游戏表现;完整代码策略在单人游戏中获得很强的平均结果,同时消除了决策时的语言模型调用。这两点都支持认真优化模型之外的 agent 程序。
最重要的边界也很具体:在一种 rollout 分布上看起来完美的检查器,放进模型驱动的智能体后未必仍然完美。论文附录已经让这个差异显现出来。下一步应直接测量它,再补上预算公平的搜索消融和完整成本摊销,才能更清楚地说明这种方法何时可靠、何时划算、何时仍应保留模型的在线判断。
参考资料与图表说明
- Xinghua Lou 等,AutoHarness: improving LLM agents by automatically synthesizing a code harness,v1。已阅读全部 21 页及附录 A-D;方法与实验主要对应第 3-4 节,逐项数据对应附录表 1、Fig. 6 和 Fig. 7。
- 论文全文。原图裁剪保留论文图号,重绘图注明数据来源;依据论文的 CC BY 4.0 许可署名使用。数学示意图为笔记自行绘制。
- Hao Tang 等,Code repair with LLMs gives an exploration-exploitation tradeoff,是 AutoHarness 引用的搜索前序工作。本文没有把未进一步核实的前序工作细节补写成 AutoHarness 的具体规格。
奖励与合法性测量均来自论文;自行复算和解释性推导已单独说明。本笔记没有新增游戏实验。arXiv 页面日期与 PDF 首页日期不同,故分别保留,不自行合并。