笔记日期: 2026-09-19
作者: Zhongzhu Zhou
阅读论文: Attention Residuals
论文作者: Kimi Team;Guangyu Chen、Yu Zhang、Jianlin Su 等,完整贡献者与排序见论文附录 A。
arXiv: 2603.15031v1,2026-03-16 提交。
本笔记依据 21 页 v1 全文,包括附录 A、B。
1. 我为什么把它理解成层与层之间的检索机制
读这篇论文时,我先把注意力放在一个很普通的问题上:下一层究竟收到什么?通常的答案是上一层输出,但把残差连接展开之后,答案其实是词嵌入加上所有前面子层输出的总和。每个历史输出都以系数一进入这个总和。后面的子层可以继续加工总和,却没有一个显式接口,让它单独取回某个早期子层的输出。
Attention Residuals,简称 AttnRes,把这个接口变成了可学习的检索。每个子层发出一个查询,对历史输出计算分数,再用 softmax 得到权重。于是两个不同 token 即使走过同一批层,也可以得到不同的历史混合。这里的注意力沿着网络深度展开,而不是沿着句子中的 token 位置展开;它不会替换原有的序列注意力。
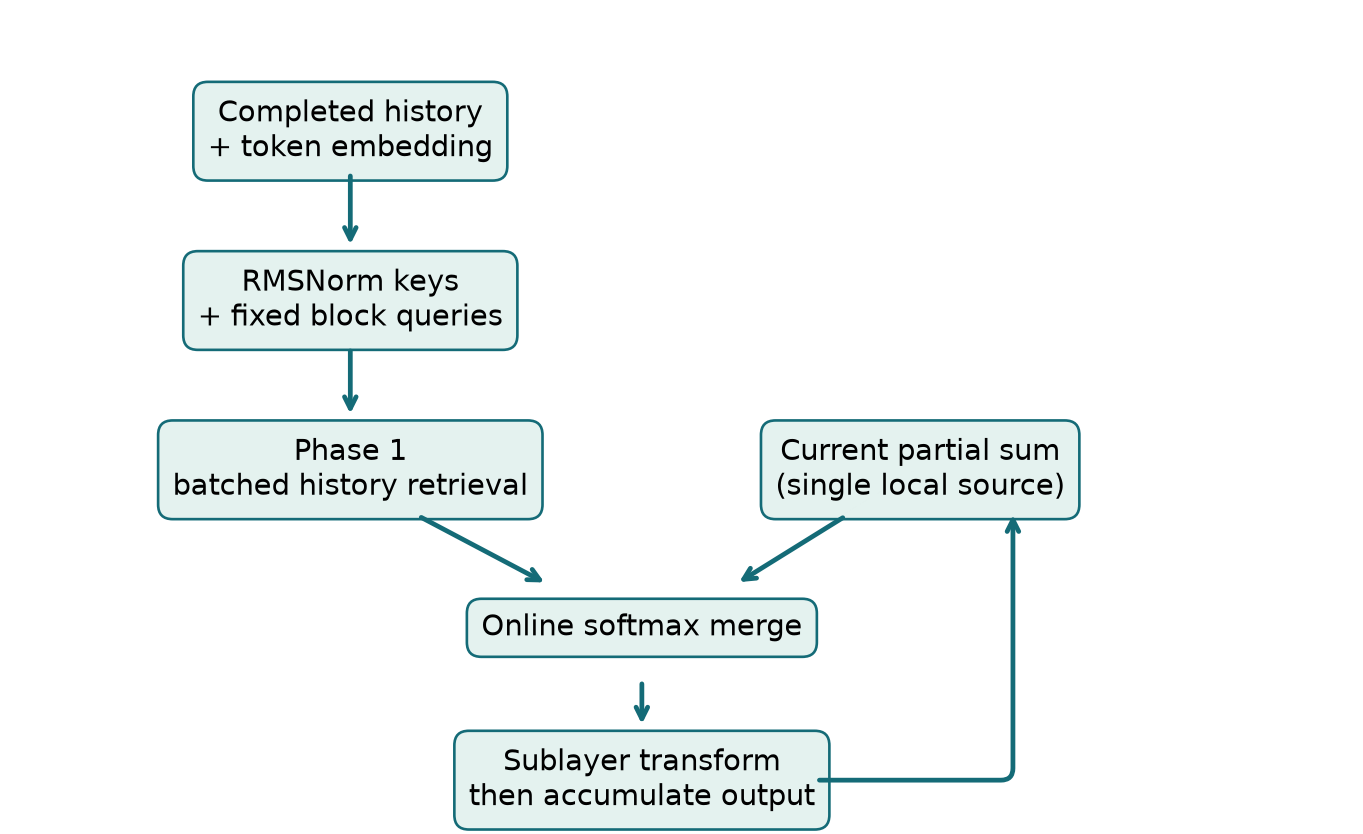
更有意思的是查询本身。论文默认使用每层一个固定的可学习向量,而不是从当前输入生成查询。训练结束后这个向量固定,但键仍由输入内容决定,所以权重依然随 token 改变。固定查询还有系统上的价值:只要历史表示已经完成,就可以提前为同一块内的多个未来子层一起计算历史检索。这让一个模型设计选择直接决定了哪些计算可以批处理。
我认为论文最完整的贡献,是把“全量保存每层输出”逐步转化成一个能在大模型中使用的方案。Full AttnRes 保留最细粒度的历史;Block AttnRes 把若干子层输出加成块摘要;流水线缓存减少重复传输;两阶段计算减少重复读内存。只看额外参数很少,会漏掉激活存储和通信这两项真正重要的成本。
主实验使用 48B 总参数、3B 激活参数的 Kimi Linear 架构,按相同的 1.4T token 配方比较。论文表 3 中,十五项任务有十四项提高,MMLU-Pro 在报告精度下持平。这个结果值得认真分析,同时也要区分三个问题:分块模型是否接近全量模型;同一个分块模型能否被等价地重排计算;这种重排在某个硬件上节省多少时间。它们需要的证据并不相同。
2. 前置知识:残差流、归一化,以及容易混淆的层数
设批大小为 、序列长度为 、隐藏维度为 ,隐藏状态张量形状为 。为看清层间混合,下面大部分公式只写一个 token,因此每个表示属于 。这个简化没有删掉序列交互:序列注意力仍然在子层函数内部工作,只是深度检索对每个 token 分别计算。
论文将一次 attention 和一次 MLP 分别算作一层。我用 表示这种子层数量,用 表示通常所说的 Transformer block 数量。比如消融中的 16 个 Transformer block 实际对应 32 个子层;若每个 AttnRes 块包含 个子层,就有八个残差块。这里的“块”至少有两种含义,不先区分,后面的内存估算会差一倍。
令 是进入子层 的向量, 是该子层变换。标准残差为
先展开一步,再继续代入,就得到
这个式子把残差的两种作用分开了。优化角度看,它提供绕过变换的路径;表示角度看,它规定所有历史输出以同样的系数累加。后一个规定通常被当作默认设置,但并没有理由认为所有目标层、所有 token 都需要相同的混合方式。
梯度方面,记 ,则
乘积展开后包含单位矩阵项,这就是直接梯度通路的代数来源。不过,有单位矩阵项不代表整个乘积的每个奇异值都接近一:其余项可能放大,也可能抵消。以后分析 AttnRes 时同样要谨慎,不能因为权重处于零和一之间,就推断整个网络的梯度一定稳定。
PreNorm 在子层变换之前做归一化,而残差累加本身仍可能持续增长。RMSNorm 的一个常见表达是
其中 是可学习的逐通道缩放, 防止零附近的除法问题。它控制的是送入某个运算的尺度,不会自动约束网络中所有未归一化的和向量。
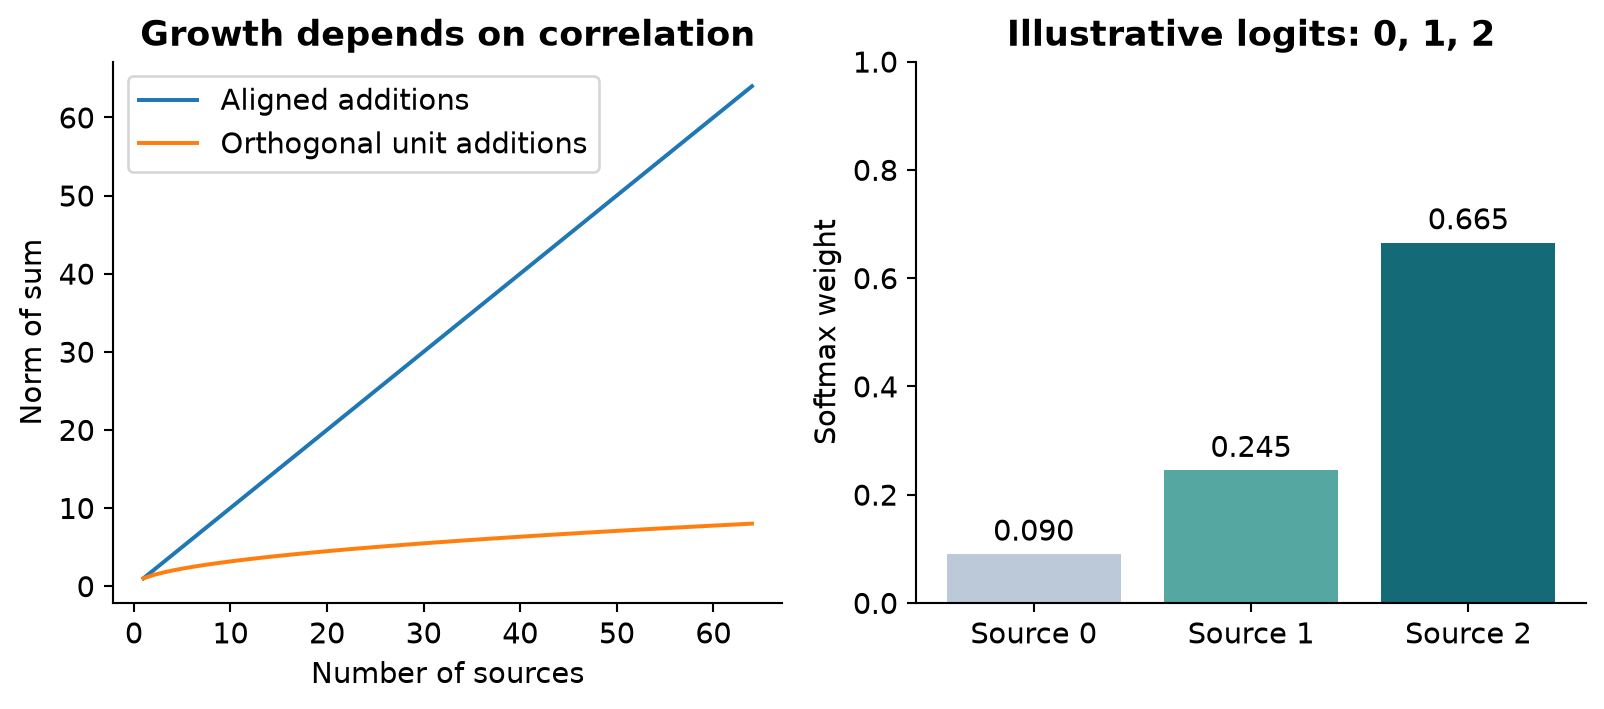
对于“残差随深度增长”,我更愿意保留条件。 个同向单位向量的和,范数是 ; 个彼此正交单位向量的和,范数是 ;有相反方向时还能相互抵消。真实网络的增长取决于输出相关性和训练后的幅值。论文图 5 确实展示了其基线模型中随深度增长的现象,但不能把这个观察推广成所有残差网络都必须服从的线性增长定律。
3. Full AttnRes:权重从哪里来,约束又在哪里
把词嵌入写成 ,把第 个子层输出写成 。第 个目标子层可以访问 。它拥有一个可学习伪查询 ,先计算
再沿着历史来源这一维做 softmax:
论文给出的打分式没有额外写 。查询是可学习的,能吸收某种缩放,但解释方法时仍应按原定义写清楚,而不是无意识地搬用序列注意力的习惯形式。另一个容易忽略的区别是:键经过 RMSNorm,值没有归一化。前者防止输出仅凭幅值大就获得更大的打分,后者保留了输出本身的尺度信息。
这也解释了为什么固定查询仍能实现内容相关选择。查询规定“这一层倾向于找什么”,不同 token 产生的键决定“这次有哪些内容符合要求”。同一个 与两组不同的历史输出做点积,当然可以得到不同的 softmax。被去掉的只是“查询必须等当前状态算完才能产生”这条依赖。
例如分数为 ,权重约为 。把三个分数同时加上十,公共指数因子会被分母消掉,权重不变;把它们都乘以十,则会显著变尖锐。因此 softmax 的平移不变性不能被误认为任意缩放不变性,查询范数和归一化方式仍然影响选择强度。
论文强调伪查询要初始化为零。这样所有初始分数相同,于是
初始得到的是平均,不是原始残差的求和。理想化 PreNorm 对公共缩放可能不敏感,但真实网络还有 、可学习尺度、非线性和最终输出。因此不能由零初始化直接推出:把一个已经训练好的标准残差模型替换成 AttnRes 后,函数会完全不变。本文的大规模结果来自对修改后架构的训练。
softmax 的非负性和归一化给出一个简单而有用的界:
第一步是三角不等式,第二步利用权重和为一。它说明混合不会比最大的源向量更大,但没有保证源向量本身有固定上界,也没有保证完整网络的雅可比范数有界。这是一个关于聚合操作的结论,足够解释它为什么能改变累加尺度,却不应被包装成普遍的训练稳定性证明。
算法 1:单个 token 的全量深度检索。
- 用词嵌入 初始化历史来源列表。
- 到达子层 时,对全部可用来源生成归一化键,保留原向量作为值。
- 用 打分,减去最大分数后计算指数。
- 用指数之和归一化,得到权重并求加权和 。
- 计算 ,把新输出追加到历史列表。
- 按深度顺序重复,最终输出也使用相应聚合。
来源访问总数是 。略去批和 token 因子,算术量为 ,历史表示占 存储。额外参数很少,与访问激活很便宜,是两个完全不同的判断。
4. 分块到底压缩了什么信息
假设 能被 整除,把所有子层分成 个连续块,每块 个子层。块 的完整摘要为
执行到块内第 个子层后,部分和记为
词嵌入继续独立保存为 。一个新块的第一个子层只看 ;后续子层再多看一个不断变化的部分和 。这里有一个小细节:第一层之前不存在部分和来源,不能随手给 softmax 加一个零向量占位。零值虽然不贡献分子,但仍然贡献分母,会改变其他来源的权重。
分块省下了保存每个子层输出的成本,但也主动丢掉了块内区分能力。如果一个完整块获得权重 ,展开可得
块内每个输出都获得相同的有效系数。Full AttnRes 可以加强其中一个、压低另一个;Block AttnRes 在求和之后已经做不到这一点。因此“块摘要”不是无损缓存格式,而是一项模型容量选择。它保留了较远历史的可访问性,代价是较粗的检索粒度。
用一个二维例子就能看清这种损失。设两个子层输出分别为 和 ,块摘要是 。全量检索给它们权重 、,可得到 ;对块摘要乘任意一个标量,都无法得到非零的第一维。键归一化不能恢复已经在求和中消失的方向。这个例子只证明有这种表达差异,并不声称真实模型经常发生同样的抵消。
算法 2:分块深度检索与摘要更新。
- 已完成历史列表初始化为 。
- 每个新块开始时,将部分和设为 ,局部子层序号设为一。
- 构造来源集合:包含所有已完成摘要;只有局部序号大于一时才加入 。
- 对来源键做 RMSNorm,用当前目标的伪查询打分,并对整个集合统一做 softmax。
- 求加权输入 ,再计算子层输出 。
- 更新 ,继续下一个子层。
- 到块边界时,将 存入已完成历史;最后一个不足整块的部分按实际长度保存。
- 全部子层完成后,对完整历史做最终输出聚合。
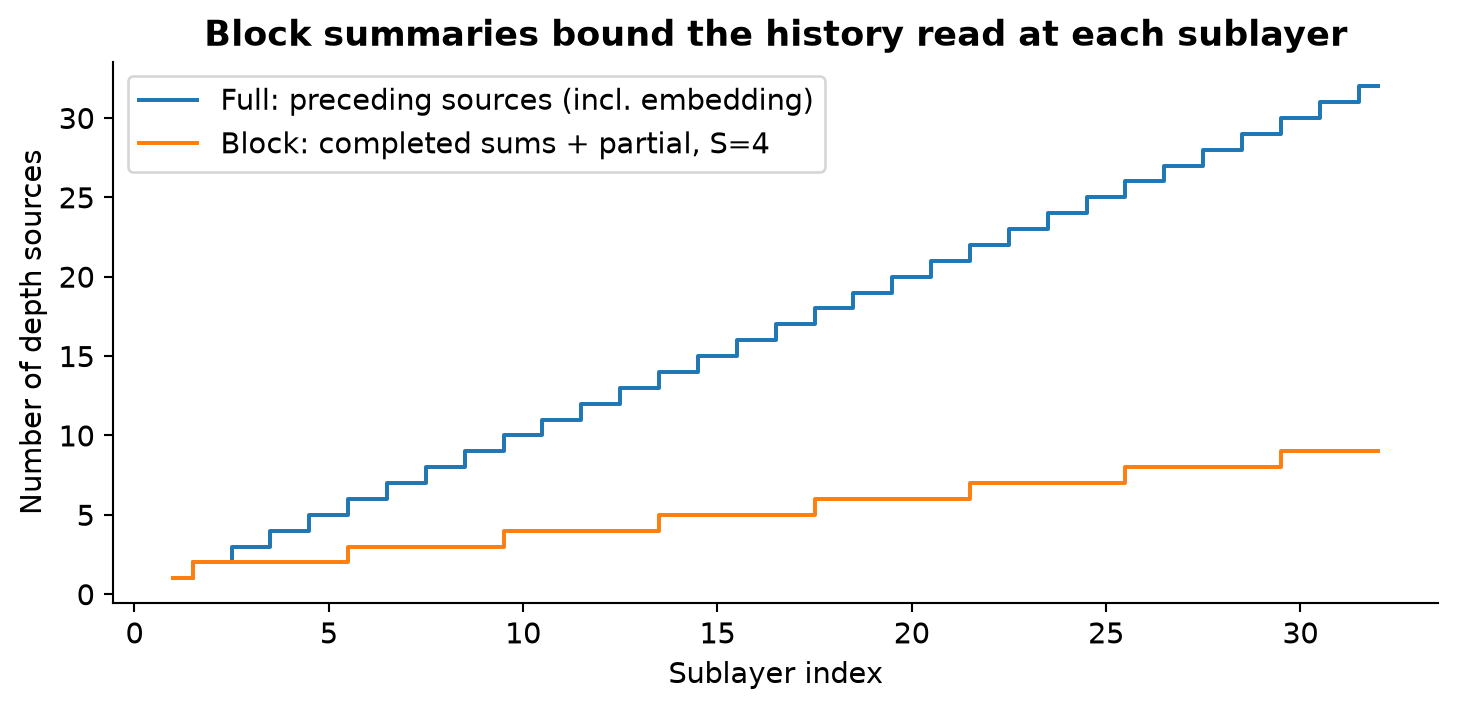
存储量变成每个 token 的 ,再加局部工作空间。算术量应同时保留层数和块数: 个子层,每个最多访问约 个来源,得到 。论文一处将其简写成 ,另处写成 。只有把 当作固定常数时,两种写法才只差常数因子。研究块大小的取舍时,我会保留 ,避免把一个正在改变的变量藏进常数。
两个端点也需要仔细解释。 时,每个摘要恰好是一个子层输出,确实恢复 Full AttnRes。 时,全部输出在单块内累加,但词嵌入仍独立存在,注意力仍对嵌入与部分和做归一化混合。这种结构接近残差累加,却不在一般条件下等于单位权重求和。论文把这个端点描述为恢复标准残差,我倾向于把它理解成结构类比;若要主张函数严格相同,需要额外说明缩放条件。
5. 两阶段计算为什么能等价:分母不能丢
一个块开始时,已经完成的历史全部已知,该块内所有伪查询也已知。所以第一阶段可以把这些查询堆起来,一次批量计算它们对历史的检索。但当前块的部分和还没产生,必须在第二阶段随着子层执行逐步计算。如何把两部分合起来,才不会改变原来的 softmax?答案是保留归一化统计,而不只是保留两个局部平均值。
对任意来源集合 ,定义
是尚未归一化的向量分子, 是缩放后的标量分母,局部输出是 。这里的 不是 log-sum-exp;真正的对数和为 。论文算法注释提到 LSE,但其除法与指数缩放公式对应的是这里的缩放和。解释算法时若混用二者,会得到完全不同的数值。
现在将两个不相交集合 合并,取共同的最大值 ,并写成
推导只有一步关键代入: 等于 。另一组也是同样形式,所以相加后就是整个并集的 softmax 分子;分母同理。因此在实数运算下,分阶段计算与一次性计算完全相同。浮点数归约顺序不同可能带来很小的数值误差,但这与模型分块导致的表达损失不是同一类近似。
考虑一个具体的标量例子。第一组来源的分数是 ,值为 。不做稳定缩放时,指数权重为 ,分子为 ,分母为 ,局部平均为 。新来源的值为 、分数为 ,它的分子和分母分别为 。正确合并结果是 。
这个例子中,两个局部平均的简单平均碰巧也是六,因为两组总指数质量相同。如果新来源分数改成 ,正确结果变成 ,简单平均仍然是六,就错了。这个反例说明保存局部输出还不够:必须知道每个输出背后对应多少归一化质量。
算法 3:一个残差块的两阶段执行。
- 将块内 个伪查询堆成矩阵 。
- 对已完成历史生成归一化键,批量得到每个目标的 。
- 初始化当前部分和 。
- 块内第一个子层直接使用 ,不引入空的局部来源。
- 后续子层计算 的分数 ;单来源的稳定统计为 。
- 按上述公式合并历史与局部统计,最后做一次分子除分母。
- 计算 ,并累加到 ,然后再进入下一个子层。
- 块结束时存下完整的 。
批量计算查询不等于并行运行所有非线性子层。第二阶段仍有不可绕开的因果依赖。节省主要来自历史数据只读一次、矩阵运算形状更合适,以及局部操作可与附近算子融合。理解这个差别,才能判断一种“更聪明的查询”会不会破坏系统优化的前提。
6. 分布式训练:先算通信量,再讨论能否被隐藏
在最简单的反向传播中,各层激活本来就要保留,Full AttnRes 可以复用这些信息。但大规模训练常使用激活重计算:普通模型会丢掉一些中间表示,之后再算;AttnRes 的后续子层却还要读取历史来源。此时“本来就在内存里”的前提不再自动成立。流水线并行又会让历史来源跨设备,通信成本随之进入设计。
设物理流水线 rank 数为 ,每个 rank 有 个虚拟阶段,总逻辑 chunk 数为 。按照论文的简化账本,用 表示每个 chunk 平均新增的块表示数量。第 次转换若发送全部历史,就要发送 个向量,合计
这是每个 token 的元素量,要得到实际字节数,还要乘批、序列长度和元素大小。实际块边界未必与流水线边界对齐,因此 只是平均会计量,不是每段都精确生成同样整数个摘要的保证。
缓存的想法很直接:同一个物理 rank 在较早的虚拟阶段已经收到的摘要,可以留在本地。下一次轮到它时,只发送它上次离开后新生成的摘要。第一次遍历照常积累,后续遍历发送增量,论文给出
当 ,朴素账本是 ,缓存后是 ,少六个单位。这对应简化模型中约 21.4% 的通信量下降,不能被说成八倍训练加速。 时两式相同,因为没有先前的虚拟阶段可供复用;这个端点也帮助检查公式的直觉。
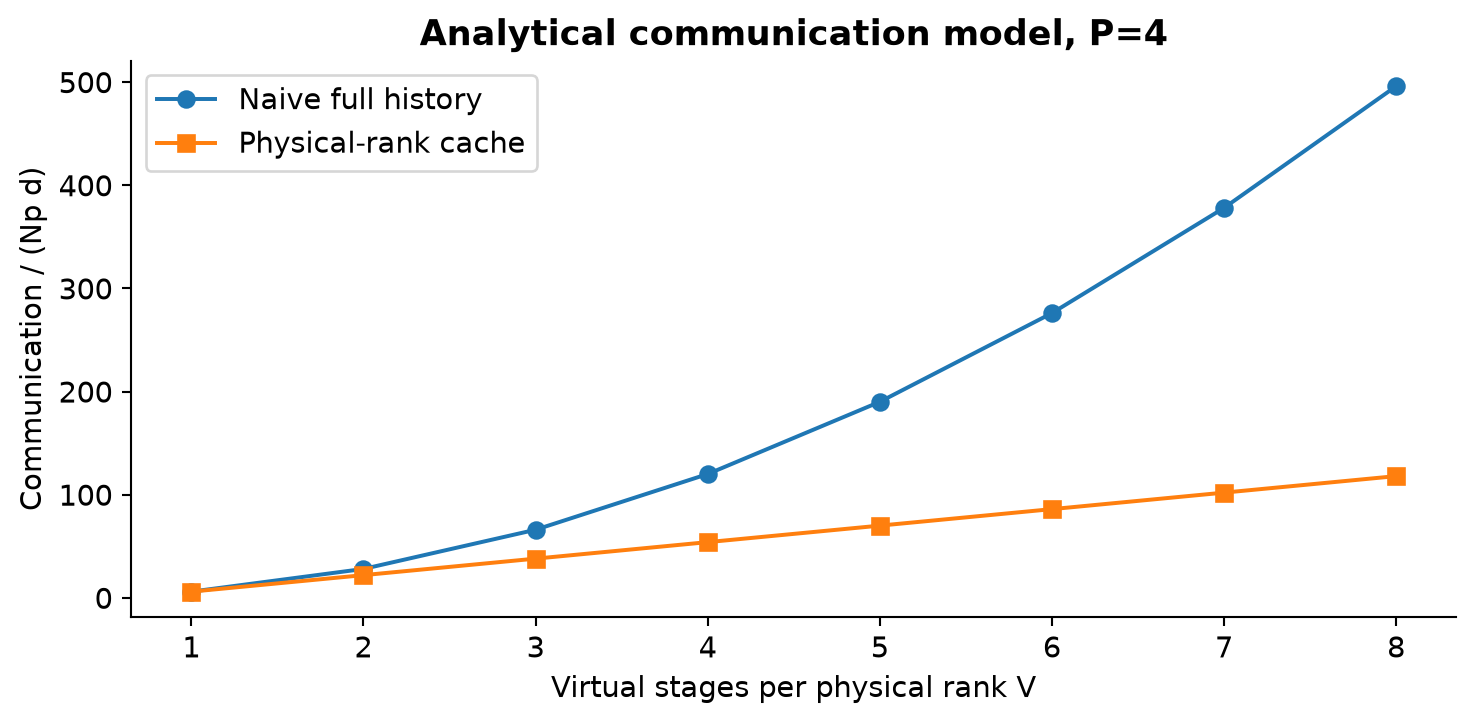
论文还指出,单次转换峰值开销的依赖可从 缩小到 。这可能使通信更容易与计算重叠,但“量少了”和“完全藏进计算时间里”仍有距离。带宽、消息延迟、微批大小、每段计算长度,以及流水线调度都会影响关键路径。报告给出的流水线训练额外开销小于 4%,应与其测试设置一起理解,不是任何集群都适用的硬上界。
从算法依赖关系看,缓存对象还必须区分微批和序列片段。两个对象同样叫第几个块,并不意味着它们属于同一个输入,也不能互换。反向传播还要汇总经历史来源传回的梯度。这些是数学数据流要求,不是对某个仓库写法的判断。缓存优化真正复用的是同一对象的重复传输,而不是跨样本借用表示。
7. 推理成本的三个口径:存多少、搬多少、花多久
论文表 1 比较的是残差机制引入的内存访问,不包含 attention 和 MLP 函数内部的读写。示例采用 ,mHC 使用四条残差流。标准残差是 个元素访问,Block AttnRes 是 ,优化调度后的 Full AttnRes 是 ,mHC 约为 ,最后一个数省略了较小的标量项。
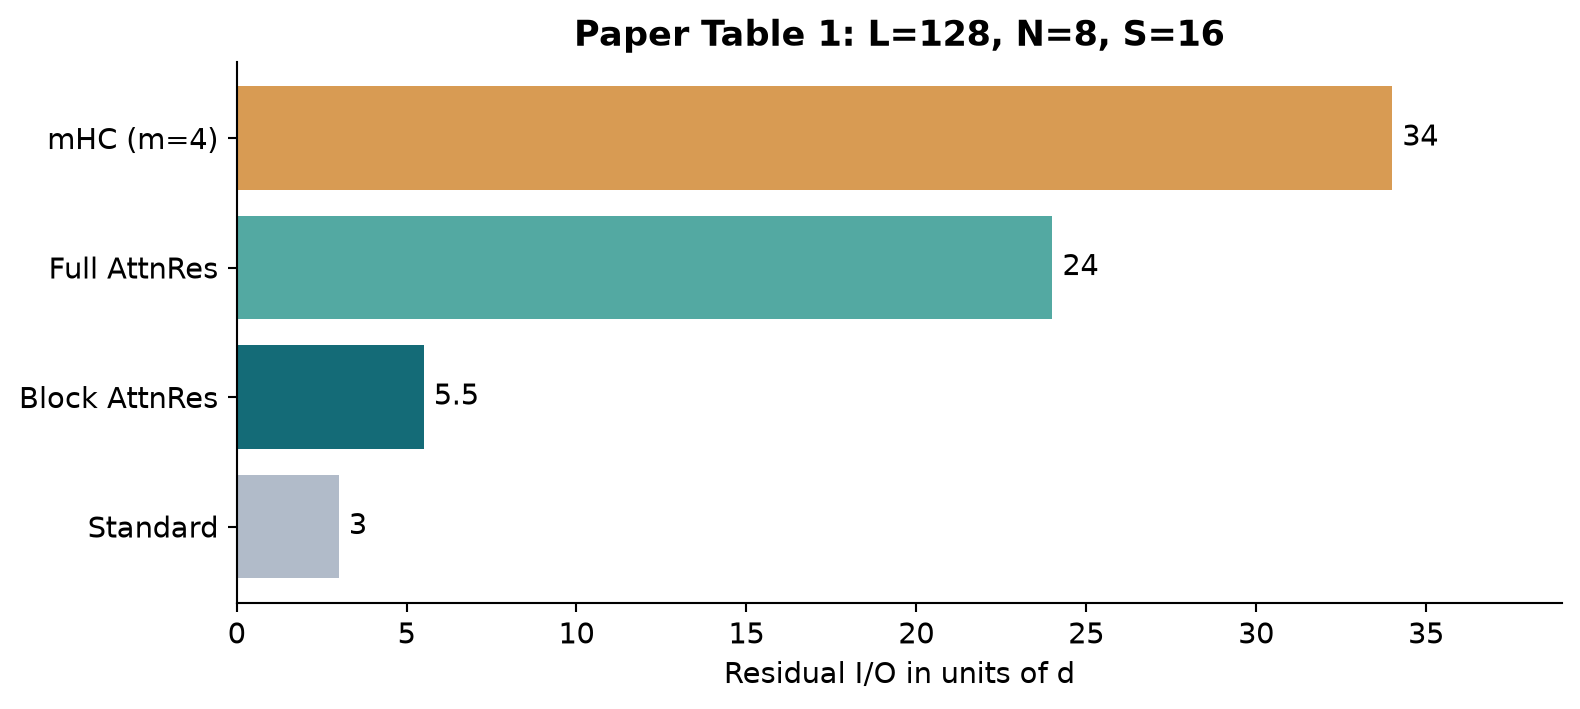
附录 B 推导了 Full AttnRes 的 。这里的分块只是调度方法,仍然保留每个子层的独立输出,和 Block AttnRes 的模型近似不同。在调度块 之前有 个历史来源,键和值合计读取 。对所有块求和,得到
当前块内部仍需顺序访问,局部第 个子层前面有 个来源,因此
全模型读取量为 ,除以总子层数 ,每层均摊读取为 。两个阶段各写一次结果,再加 ,于是总读写为 。代入八和十六,得到二十四。
这个式子还给出一个纯调度上的小结论:固定 ,访问因子是 ,对连续的 求导,得到 ,最小值在 附近。实际还要处理整数划分、硬件矩阵块、容量和局部串行长度,所以它不是现成的最优配置。尤其不能直接把这个调度最优值当成 Block AttnRes 的架构最优块大小,因为后者改变了模型可以选择哪些来源。
Block AttnRes 只保存块摘要,按论文账本,每层成本是 。示例中为 。它仍约为标准残差读写的 1.83 倍,但报告称典型工作负载下端到端推理开销小于 2%。两者不矛盾:残差访问只占完整模型工作的一部分,且批处理、融合和重叠会改变其时间占比。同样,也不能用 宣称模型相对 mHC 实测快了六倍。
长上下文 prefill 关注的另一个问题是存储容量。 个 token、每个保留 个摘要,需要 个元素;若每个元素占 字节,就需要 字节。沿序列切分到 个设备后,每设备变成 。论文中 128K 上下文、八个块的约 15 GB 示例,经八路切分降到约 1.9 GB;再用 16K chunk,活跃长度又缩小八倍,对应这一项约 0.234 GB。
这不是完整模型内存下降六十四倍。权重、序列注意力的 KV cache、线性注意力状态、通信缓冲区和峰值临时空间都不在这个孤立项中。深度历史和序列 KV cache 也不是同一个东西:前者让同一 token 跨层取回表示,后者让一个注意力层访问此前的 token。KDA/MLA 混合模型可能同时保有多种状态,内存核算时需要分别列出。
8. 缩放实验和主实验分别说明了什么
表 2 的五个规模是 194M、241M、296M、436M、528M 激活非嵌入参数,token 预算从 38.7B 到 119.0B。每个规模内,基线、Full 和 Block 使用相同配置,上下文为 8192,学习率采用 cosine 日程。跨规模配置和训练数据量都在变化,因此这是一组配对比较,不是固定 token 数只扫描参数量的实验。
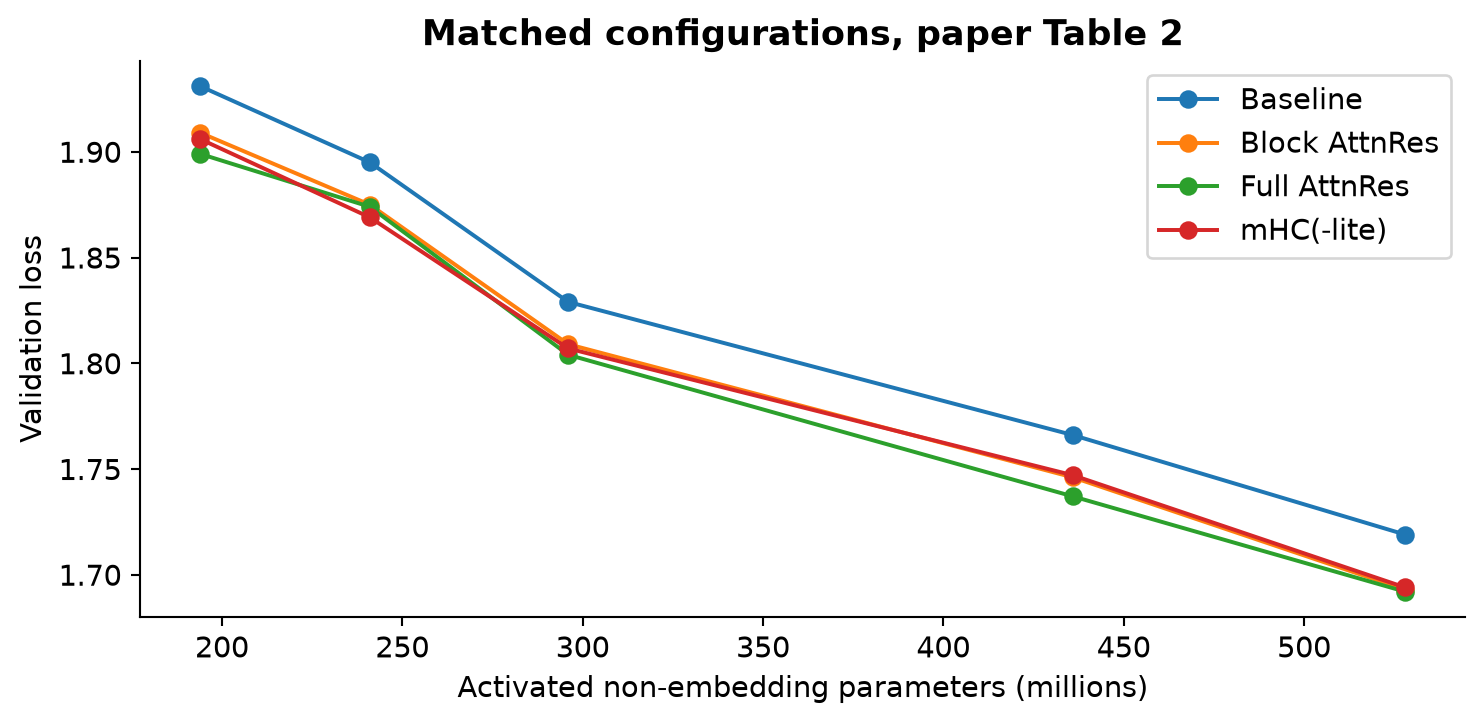
最大一组的基线、Block、Full 损失分别为 1.719、1.693、1.692。以损失降低量计算,Block 保留 的提升;436M 处则为 。因此“保留大部分收益”可以描述某些规模,但不是恒定的百分比,也不能不带条件地延伸到其他模型。
论文给出的三条拟合曲线为
的单位为 PFLOP/s-days。所谓计算优势,是在相同目标损失下反解各自需要多少计算。对一般曲线 ,有
这才是约 1.25 倍优势的含义,而不是计时器显示训练快了 25%。由于指数很小,反解会放大拟合参数的舍入误差,计算比也会随目标损失变化。论文没有在这里给拟合置信区间,所以应把它看成已测区间中的拟合估计,不是任何规模和硬件上都成立的常数。
大模型实验采用另一套配方,不能把缩放研究中的配置混进去。它有 27 个 Transformer block,即 54 个子层;总参数 48B、激活参数 3B;256 个路由专家中选择八个,另有一个共享专家;KDA 与 MLA 以 3:1 交错。AttnRes 每六个子层形成一个摘要,因此是九个摘要加词嵌入,共十个深度来源。
主训练使用 4096 上下文、Muon、8M token 全局批大小,先进行 1T token 的 warmup-stable-decay 预训练,再进行约 400B 高质量 token 的 mid-training。论文也描述了后续延长到 32K 上下文。这里的九块设置与小规模实验约八块的设置不同,而 128K 内存数字又是系统部分的独立示例,应分别标注。
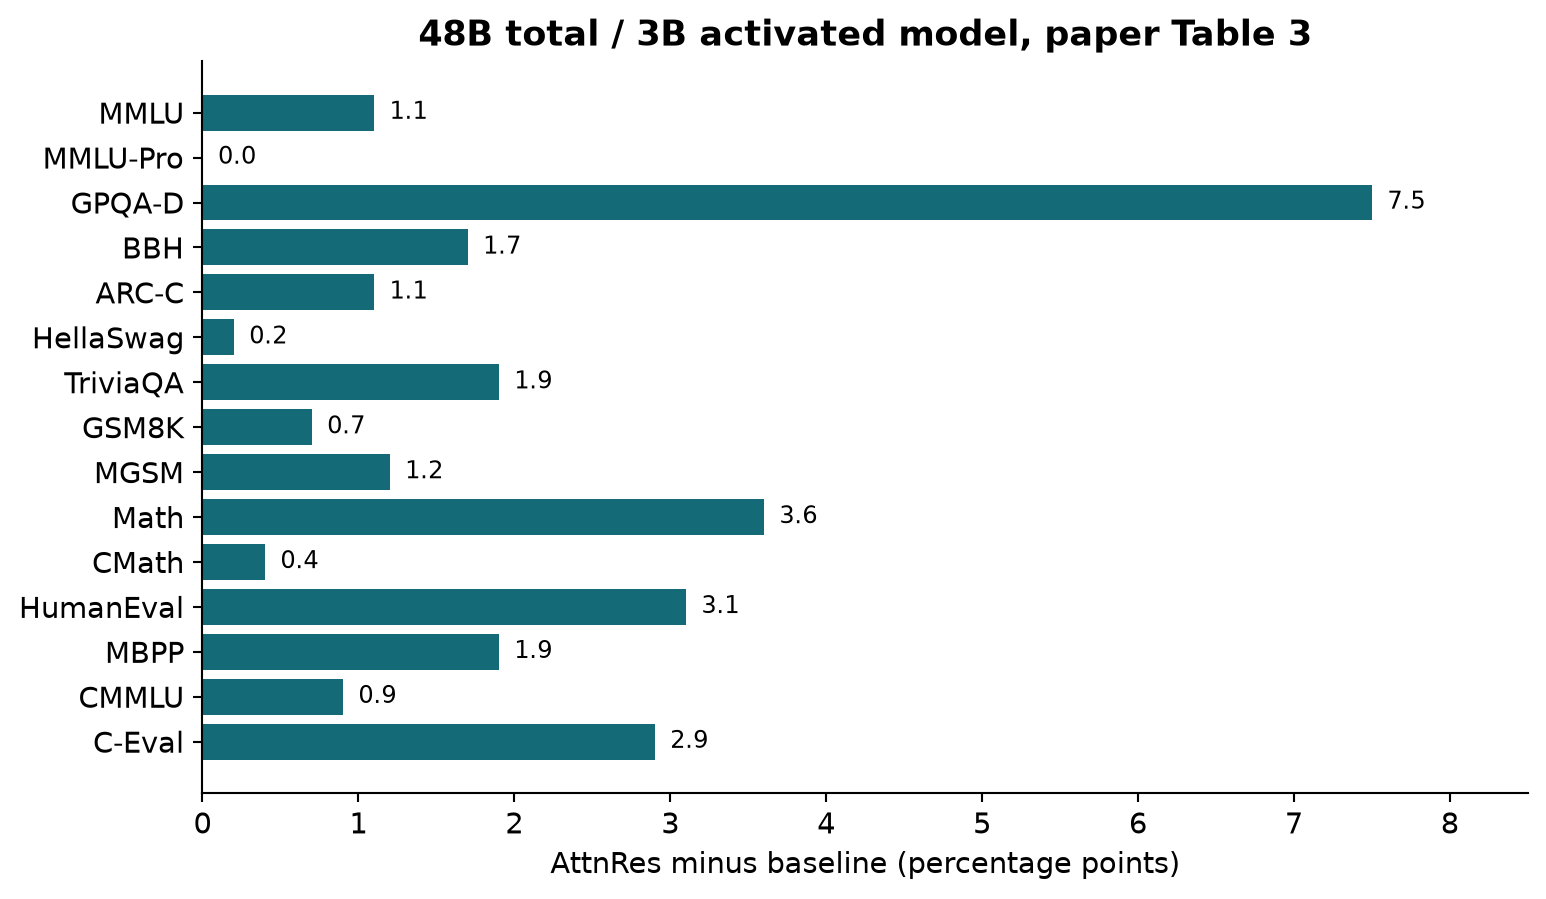
最显著的变化包括 GPQA-Diamond +7.5、Math +3.6、HumanEval +3.1、C-Eval +2.9 个百分点。MMLU 提升 1.1,HellaSwag 提升 0.2。组合推理和代码任务改善较大,与“后层更容易取回并组合早期信息”的假说相容。但架构同时改变了优化轨迹、表示尺度和检索方式,仅凭最终分数无法把收益全部归因于其中某一个机制。
训练曲线显示 AttnRes 的验证损失更低,输出幅值在块边界附近呈受控的周期变化,梯度分布也更均匀。这些是支持动机的观察,不是因果干预实验。尤其对于样本量较小的评测,单次大幅提高仍需要结合提示模板、解码方式和抽样波动来判断,不能直接当成一般推理能力增加了同样的百分比。
9. 消融里的取舍:更强的版本为什么没有成为默认
我很喜欢这组消融的一点是:论文没有把最方便部署的方案伪装成精度最优。输入相关查询的 Full AttnRes 损失为 1.731,固定查询版本为 1.737。默认选择后者,是为了避免每层额外的 投影,并保留提前批量处理历史的能力。这是用一部分已观察到的建模能力交换系统可调度性。
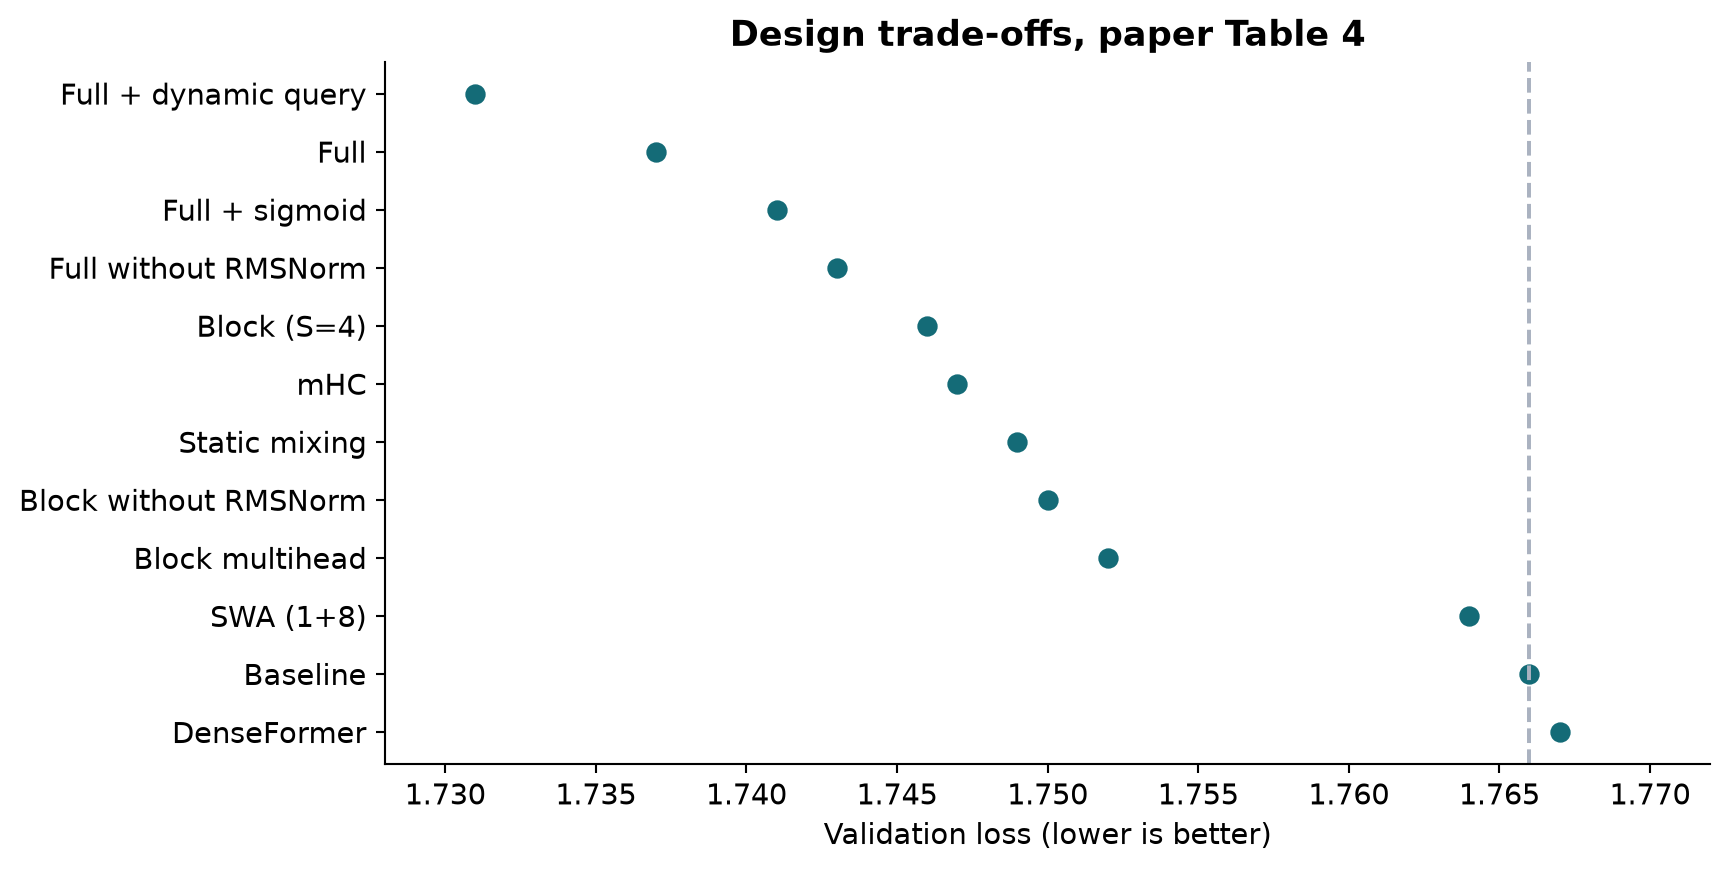
把内容相关权重换成静态可学习权重,损失变成 1.749;Full 为 1.737。这个比较支持在当前配方下使用输入相关选择,但不能证明所有静态混合设计都无效。DenseFormer 在本表是 1.767,也只是该设置的结果;优化参数和尺度匹配还可能影响比较。
把 softmax 换成 sigmoid,损失是 1.741。论文将差异解释为竞争式归一化的好处:一个来源占据更多概率质量,其他来源就相应减少。然而独立 sigmoid 门还会改变总权重和,因此选择性与整体尺度同时变化。若想更明确地识别原因,可以比较归一化后的 sigmoid 门,并匹配混合输出的范数。
去掉键 RMSNorm,Full 损失为 1.743,Block 为 1.750。这符合一个直觉:完整摘要与部分和包含的输出数量不同,若不处理尺度,较大幅值可能主导打分。但值仍是原向量,所以这项归一化只是减少打分中的幅值偏置,不能让输出信号与所有幅值无关。
分块多头版本采用十六个头,损失为 1.752,单头分块为 1.746。作者据此认为一层输出作为整体的相关性较重要。我会把它留作一种解释,而不是普遍结论。头宽、优化敏感性、通道间协调也可能参与其中;仅有一个多头配置不足以说明所有特征总该选择同一段历史。
另一个很有参考价值的对照是滑动窗口。它保留嵌入和最近八个子层输出,损失为 1.764,接近 1.766 的基线;块大小四的分块模型却达到 1.746。来源预算相近时,粗粒度保留远处历史似乎比只精细保留最近历史更有用。这条发现对内存受限的模型设计尤其值得追踪。
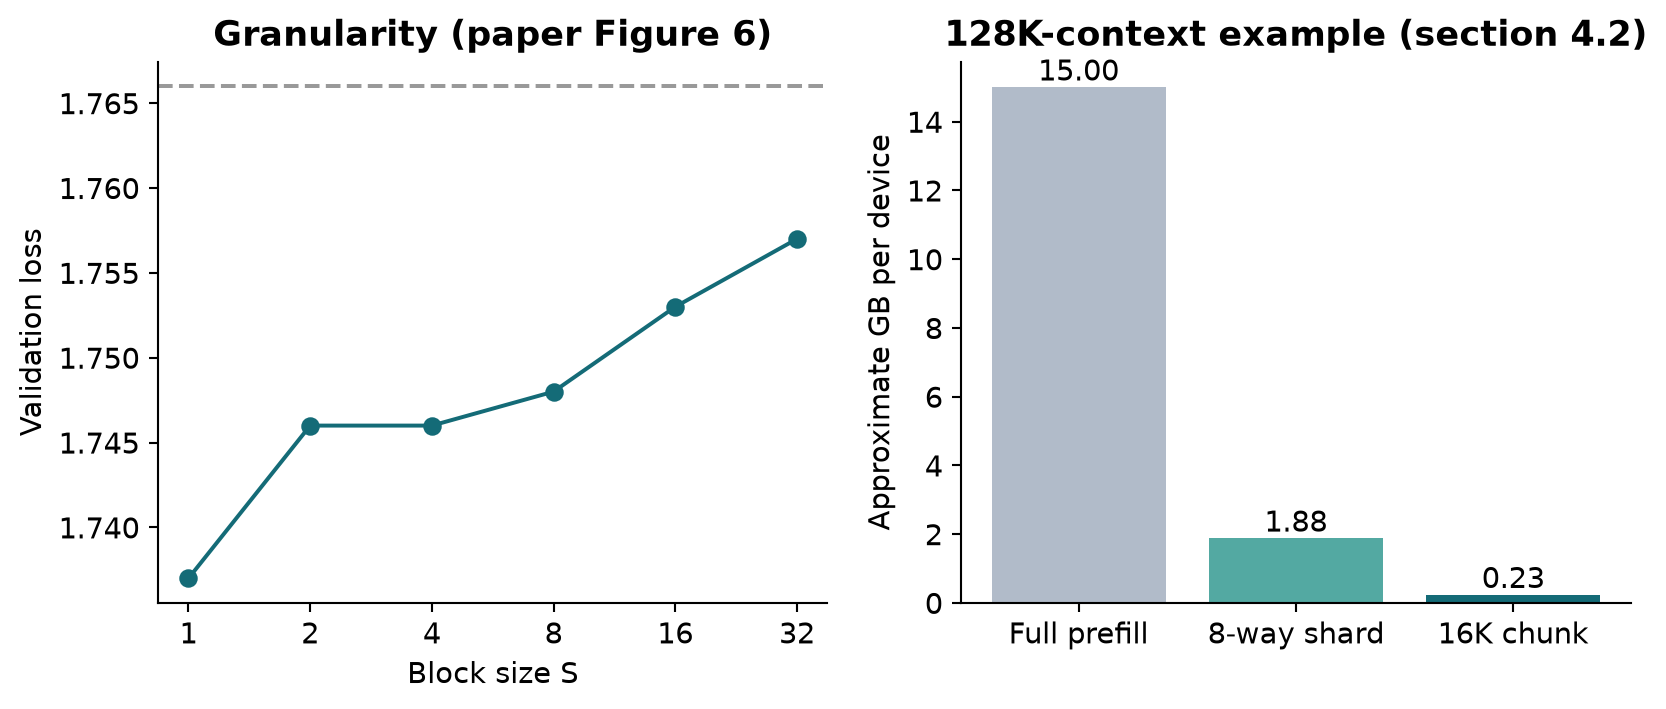
块大小 时,损失依次为 1.757、1.753、1.748、1.746、1.746; 的 Full 则为 1.737。从四减到二在报告精度下持平,继续减到一又有明显变化。它提示我们,粒度与质量之间未必是简单平滑的关系;嵌入来源、层类型排列、优化过程,都可能让某些边界比另一些更重要。
固定约 FLOPs、 激活参数的架构扫描中,最优宽深比从基线约六十移到 AttnRes 约四十五。这说明在该范围内,更深、更窄可能变得更划算。但推理需要按深度顺序执行,更深也可能更慢。因此训练损失最优点只能作为部署决策的一个输入,不能替代延迟、吞吐和内存约束。
10. 再向下一层:梯度公式与矩阵结构的边界
注意力热图看起来直观,但权重并不是完整的影响系数。即使先固定其他来源,只研究一个源向量 对混合结果的局部影响,也至少包含两条路径:它直接作为值进入加权和;它还作为键改变自己以及其他来源的权重。
先从 softmax 的导数开始。对任意 ,
将 对 求导,逐项代入可得
再考虑 ,用链式法则得到
第一项是值通路,第二项是路由通路。这还只是把其他来源当成固定量的局部偏导;完整网络里,后续来源本身也可能依赖 ,还会增加别的传播路径。因此 不能推出完整梯度范数不超过一;某来源平均权重很低,也不等于把它删掉就不会影响模型。
为理解归一化的作用,暂时省略 和可学习通道尺度,令 。对 求导,可写成
括号中的矩阵去掉沿 的径向分量,剩下的切向变化再乘 。这解释了为什么纯粹的正比例放大不会改变归一化键,也提醒我们小范数附近需要 。真实 RMSNorm 保留 后,零附近的表达有所不同;不能把这个便于理解的简化导数直接套到所有输入。
论文还从深度混合矩阵的角度比较各种残差方案。这里最好先问清楚“秩”指什么。标准残差展开后的系数矩阵是下三角全一矩阵,主对角线非零,所以普通矩阵秩已经等于 。它之所以能用一个很小的递归状态表示,是因为跨越某个深度切分的非对角子块只有秩一。这种结构与半可分离矩阵有关,和整张矩阵的普通秩不是同一个概念。
因此,Full AttnRes 的矩阵可以有普通秩 ,并不能单靠这一点证明它比标准残差更有表达能力。真正需要比较的是跨深度切分的结构限制、可独立赋权的来源,以及输入相关性。Block AttnRes 又让同块内来源共享系数,形成另一种结构约束。
此外,混合系数随输入变化,而每个 也由前面的计算产生。把所有关系写成矩阵形式,不意味着完整网络突然变成了一个固定线性算子。我认为第 6.2 节提供了有用的设计视角,但普通秩、半可分离秩与文中的有效秩讨论必须分别定义,才能避免由漂亮的矩阵图得出过强的容量结论。
11. 局限:现有证据还不足以回答哪些问题
首先,主要结果来自一类混合 MoE 架构。它没有直接证明同样收益会出现在任意 dense decoder、不同优化器、不同后训练目标或极深网络中。大模型采用九块,小规模研究约八块;主训练 4K 上下文,缩放训练 8K,系统内存示例 128K。将这些数字保留在各自语境里,才不会拼出一个论文并未实际测试的配置。
其次,表格没有给出随机种子波动和置信区间。任务评估沿用 Kimi Linear 的流程,但这份报告并没有重新列出所有提示模板、解码设置与计分细节。想做严谨比较,需要固定这些条件;若当前文档没有给全,就应承认仅凭这份文档还不能完整重建实验。这个信息缺口不否定结果,却限制了我们对小差异的解释。
第三,低于 2% 的推理开销缺少一张足够完整的工作负载矩阵来界定适用范围。批大小、序列长度、精度、设备、并行布局,以及 prefill 与 decode 的比例,都会影响残差操作占总时间的比例。这个结果令人有兴趣继续测试,但不能直接预测另一个服务的尾延迟或吞吐,更不能从理论读写量推断所有机器的时间收益。
第四,分块仍然会丢信息。来源预算固定意味着某些层间差异被压缩掉;更大的模型也可能拥有不同的历史使用模式。因此八块左右有效,是一个值得利用的经验起点,而不是长期稳定的最优常数。学习边界、使用不等长块或者保留少量例外来源,都可能改善表达,但它们同时会增加调度和训练的复杂度。
最后,token 平均热图会隐藏请求、任务和位置之间的变化。词嵌入长期获得权重,可能意味着原始信息有用,也可能是某种 attention sink,或者只是稳定的路由偏好。单看颜色无法在这些解释中作决定。真正更接近因果的证据,是干预一个来源,再测量损失、输出和各项任务的变化。
12. 独立批判性分析:我会怎样继续推进这项研究
先拆开“归一化平均”和“内容选择”。 零查询初始化已经把求和改成平均。一个更有解释力的对照,应包括标准残差、尺度匹配的固定平均、可学习静态混合和内容相关混合,并尽量保持归一化位置、存储来源和优化机会相当。这样才有机会识别收益中有多少来自更平稳的尺度,有多少来自确实选中了更合适的历史。
这个实验也要避免新的混淆。例如为了保留单位权重残差的幅值而乘一个随来源数变化的因子,会进一步影响梯度;只匹配某层的输出范数,还不代表整个训练轨迹相同。因此需要在设计阶段明确究竟控制哪些变量,并同时记录损失与幅值变化。把控制条件说清楚,比直接给所有变化统称“信息流更好”更有用。
把几个理论说法改写成可检查的定义。 是否严格恢复残差、复杂度何时可以写成 、矩阵秩究竟度量什么,都会影响后续读者如何使用这项方法。我会直接列出每一步来源集合,保留 的一般算术量,并给跨深度切分的非对角秩下定义。这样做并不会削弱实验收益,反而让设计依据更清楚。
对于全量与分块的关系,还可以加入一个明确的反例和一个充分条件:前面二维抵消例子说明一般情况下不等价;如果同块内所有全量系数恰好相同,而且块打分与归一化质量也相应匹配,才可能在那个输入上复现同样的贡献。后一个条件很强,不应被当成普遍事实。把“某些输入可近似”和“架构严格等价”分开,有助于解释为何少量摘要能保留大部分收益,却仍留有质量差距。
直接测量块摘要的瓶颈。 只比较 Full 与 Block 的最终损失,看不出信息在哪里丢失。我会统计块内抵消程度、不同任务的来源重要性,以及删除某块或换成同范数向量后造成的损失变化。在保存相同数量摘要的前提下,对比固定边界、按 attention/MLP 类型对齐的边界和可学习边界。如果更合理的边界就能缩小很大一部分差距,可能无需增加缓存容量。
这里还值得观察是否存在少量“关键独立来源”。比如绝大多数层可以按块求和,而某个早期输出需要长期单独保留。一个固定额外槽位的设计,可能比让所有块都变小更省。但这只是待测试的改进方向;来源选择必须在训练和推理中一致,额外槽位的更新规则也需要计算成本分析。
把动态查询放回质量与延迟曲线上比较。 动态查询在表 4 中损失最低,只是失去了当前固定查询的批处理优势。它不必被简单归入“不实用”。可以把动态 Full、固定 Full 和固定 Block 放在同一内存限制下,比较不同批大小的 prefill、decode、吞吐,以及达到同一验证损失的训练时间。离线任务与交互服务对延迟的权重不同,最佳方案也可能不同。
这种比较还应报告真实峰值内存,而不只是历史摘要的容量。某种方案少保存了摘要,却增加较大的临时矩阵或通信缓冲,就可能在峰值上失去优势。同样,若一个优化主要降低大批量吞吐成本,就不能用它代替小批量逐 token 延迟的结论。系统评估的对象应该是一组具体工作负载,而不是一个抽象的“推理速度”。
验证远处历史是否具有因果作用。 滑动窗口对照说明只保留最近输出不够,但并没有定位哪些远处来源有用。可在冻结模型上屏蔽某些历史来源,与移除相同注意力质量、相近源范数的随机屏蔽做比较;再对选定结构重新训练,区分即时依赖与重新适应后的能力。这里提出的是后续实验,并不是本笔记已经执行的模型实验。
给接近的比较补上不确定性。 241M 处 mHC(-lite) 为 1.869,Full 为 1.874,其他规模的顺序又不完全相同。直接说 Full 始终优于 mHC 超出了表格支持范围。多种子重复这些接近的设置,比仅增加更多单次排名更有信息。同理,MMLU-Pro 应保留为显示精度下的持平,不能把没有显示出来的小数当成确定胜负。
如果我要据此设计一轮研究,首先会固定数学架构和层数口径,然后列清训练配方、数据范围与硬件条件。能用小型确定性计算先确认的内容包括:softmax 公共平移不变性、两组来源的稳定合并、首层不加入空部分和,以及通信公式在 时的退化关系。它们确认的是解释和公式的内部一致性,不是模型训练质量已经被复现。
13. 结论
Attention Residuals 让我重新注意到一件被默认设置掩盖的事:层与层之间如何组合历史,本身也是模型设计。Full AttnRes 把每个历史输出变成可按内容检索的对象;Block AttnRes 用更少的摘要换取可承受的存储与通信;固定伪查询则让历史部分可以提前批量计算。系统部分并非附带优化,因为如果没有它,激活流量可能抵消这个参数很轻的改动带来的吸引力。
这篇论文给出的结果支持在其模型家族中继续探索这条路线。我最想保留的思路是同时考虑“保存了哪些信息”和“取这些信息要花多少钱”:摘要决定后来还能恢复什么,调度决定恢复一次有多贵。接下来的研究需要更清楚地区分尺度控制与内容选择,测量分块丢失的信息,并把质量提升放回具体训练和服务条件下判断。
参考来源与图表说明
- Kimi Team,Attention Residuals,arXiv:2603.15031v1,2026-03-16。本文的论文公式、实验数值和系统账本均指向此版本;完整作者与贡献顺序见附录 A,Full AttnRes 的 I/O 推导见附录 B。
- 论文提供的官方项目入口。
- 九张图均为原创解释图,或依据明确标注的论文数值重新绘制。假设向量、来源计数、通信与容量估算均有说明,没有把它们写成模型实测。原论文采用 CC BY-NC-ND 4.0;本笔记没有复制或修改原论文图像。
- 文中的数学例子和表格复算是独立解释性计算;没有声称完成模型训练、作者实验或生产环境延迟的独立复现。